WATCH REPORT
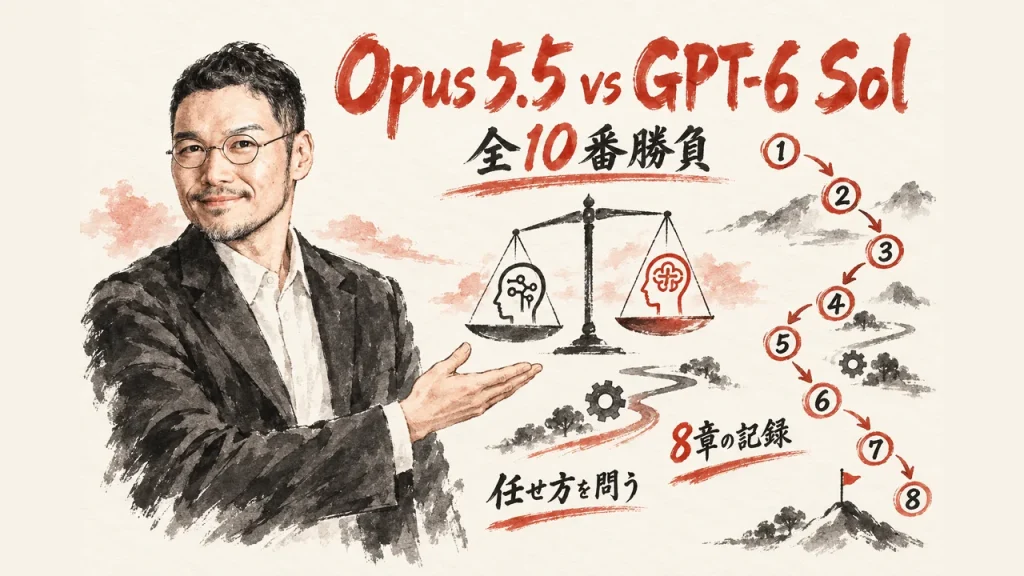
Opus 5.5とGPT-6 Solの10番勝負をNate Herkが検証。
AIの「任せ方」を考え直すきっかけになる回
2026.09.24
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。
今回は、YouTubeチャンネル「Nate Herk | AI Automation」を紹介するね。Claude Opus 5.5とGPT-6 Solを、10個の実務ユースケースで横並び比較した検証動画です。
テーマは「Opus 5.5とGPT-6 Sol、100ドル託すならどっちに?」。扱うのは、サイト制作から動画編集、ブラウザ操作、大規模コード修復まで。私は動画を全部見ました。「これは自分の仕事の任せ方そのものだ」と唸ったポイントを、私自身の実践と重ねてお届けします。
3行でわかるポイント
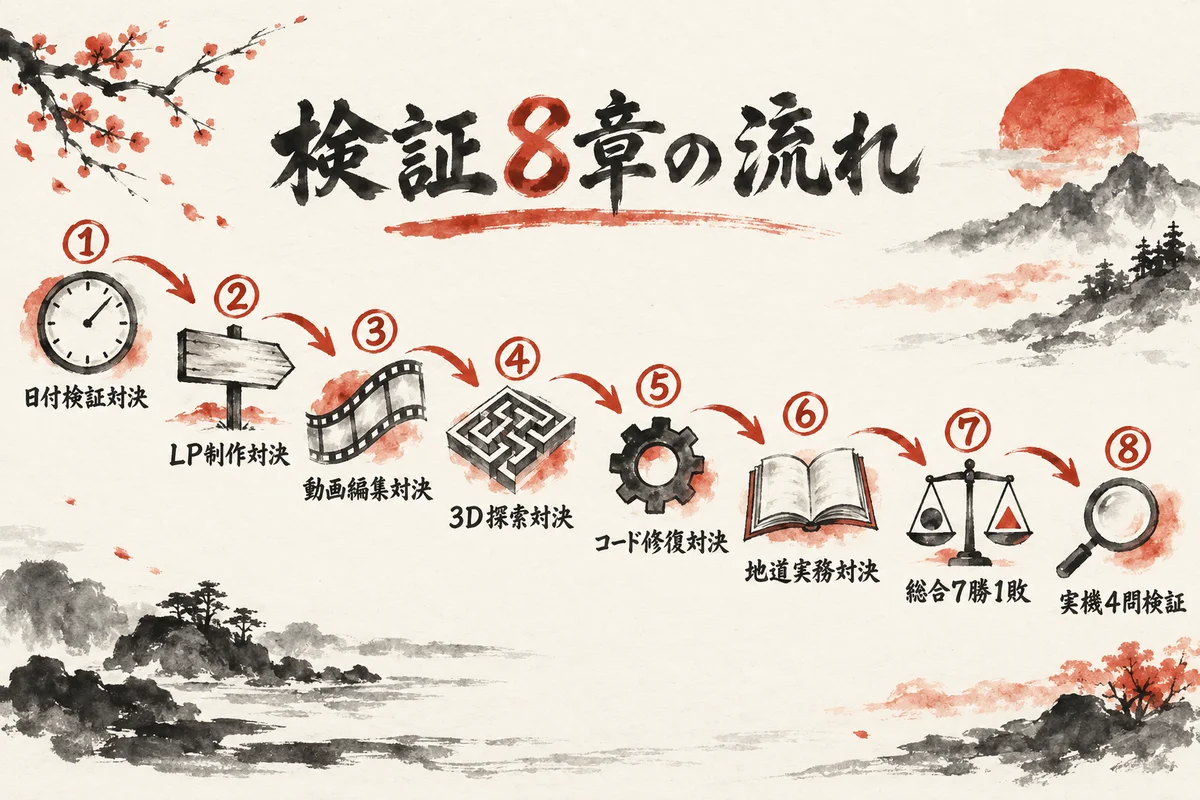
- 成績は7勝1敗2ノーコンテスト。Opus 5.5がほぼ全勝でも、コストは約3倍。値段で選ぶ話ではなかった
- 唯一の敗因は”止まらなかった”こと。大規模コード修復ではGPT-6 Solが安全機構で止まり、Opusは止まらずに押し切って逆転負け
- 料理に例えると、Opusは仕込みから盛り付けまでこだわる職人肌の料理人、Solは指示通りに手早く動く調理助手。厨房を1人で回そうとすると疲れるのは、AIの世界でも同じ
CAST
Nate Herk(Nate Herk | AI Automation)AI自動化・エージェント運用を実機検証するYouTubeチャンネルの運営者。今回はナレーション単独で登場。10のユースケースをOpus 5.5とGPT-6 Solに同時発注し、結果を横並びで採点しました。
出典: I Tested Opus 5.5 vs. GPT-6 Sol on 10 Real Use Cases。チャンネルはNate Herk | AI Automationです。
「100ドルをどっちに渡すか」——ウォームアップ検証でOpusだけが日付を正答した
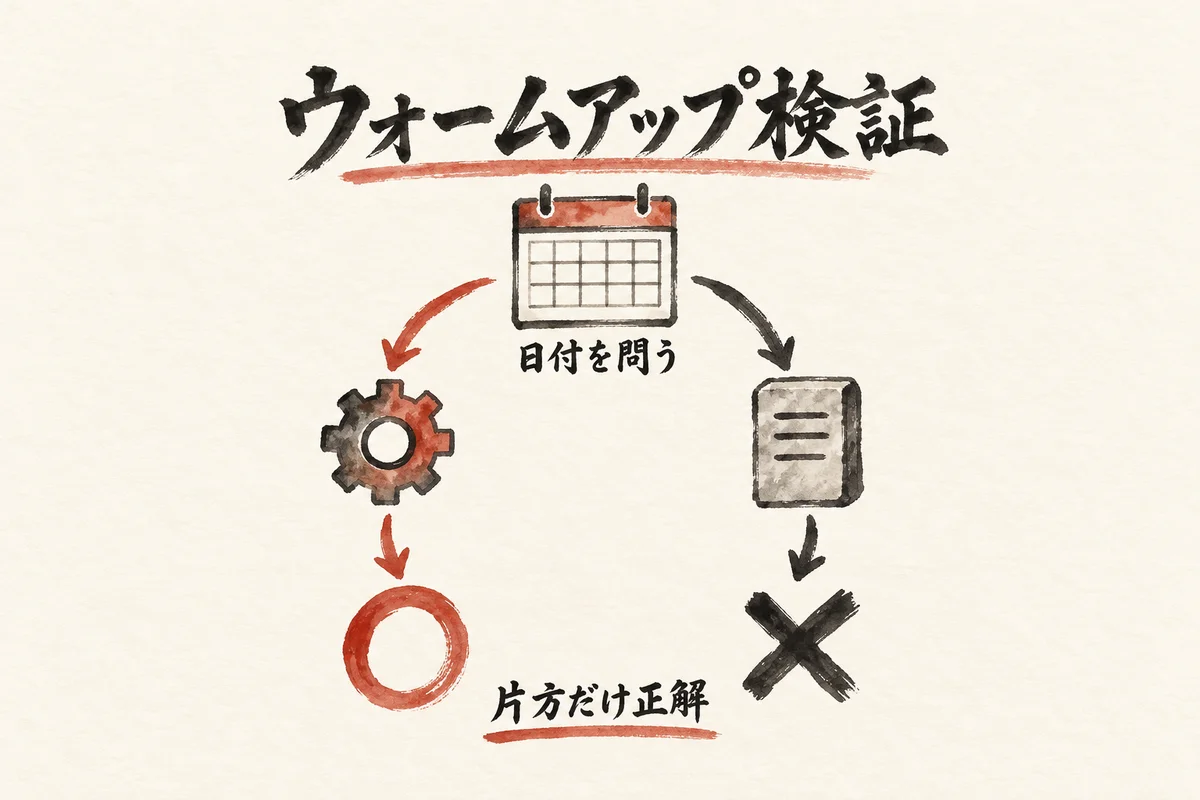
動画の冒頭、Nate Herkさんは価格の前提から見せます。Opus 5.5は入力$4・出力$20。GPT-6 Solは入力$2・出力$10。Opusはほぼ倍額です。その差を確かめるため、まずウォームアップ検証をします。両モデルにFireflies通話2本のwiki取り込みを頼み、同時に過去のQ&Aから「Nit(en)」に触れた日付を探させました(0:48頃〜)。Solの方が先に終わりました。でも日付は8/17と誤答。正解は9/14です。正しく引き当てたのはOpusでした。
この場面でNate Herkさんが立てた問いが、動画全体の軸になります。
正確さは、後からでは取り戻せません!
Nate Herkさん
「if I had a hundred bucks and I gave a hundred bucks to Opus and I gave a 100 bucks to Soul, which one would give me a better output or better quality for that 100 bucks?」(0:48)
速さより先に正確さで信頼を測る。この姿勢に私は強く共感しました。私もAI秘書の凛ちゃんたちのチームやAIエージェントに仕事を渡す時、真っ先に見るのは「速いかどうか」ではありません。「間違えた時にどれだけ被害が出るか」です。
委ねたい気持ちはあります。でも委ねた先が嘘をつく・逃げる・やらないなら、委ねられません。信頼できる仕組みが先。これが私の委任の現在地です。
今回のウォームアップ検証は、まさにその下見でした。値段より先に、この土台を確かめる。この順番だけは崩したくないなと、動画を見ながら思いました。ちなみに正確さを確かめずにAIの回答を信じてしまう危うさは、AIモデルJevの実装ガイド記事でも扱いました。
あなたが今使っているAIツールの中で、間違えたら一番困るタスクを1つだけ書き出してみてください。5分で終わります。その1個が、あなたにとっての「ウォームアップ検証」の対象です。
プロテインコーヒーのLP対決——コスト3倍でも「疑いなく」Opusが勝った初戦
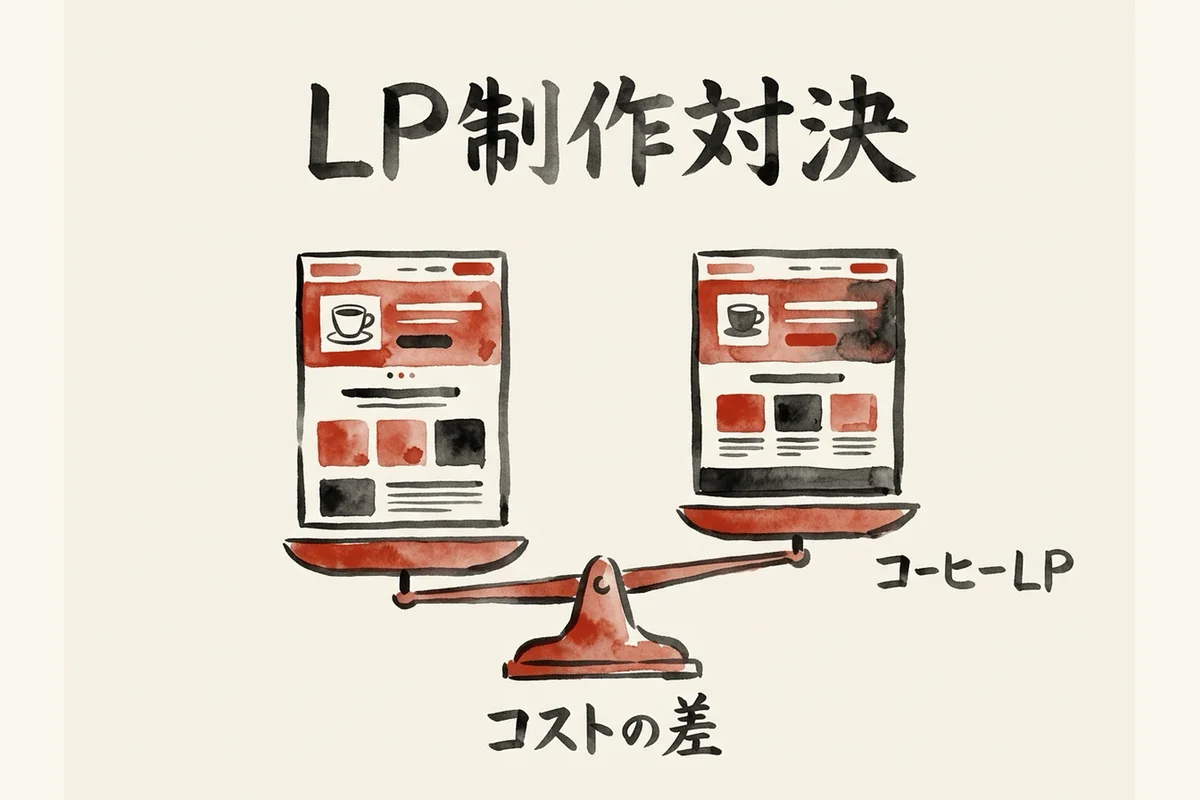
1個目の実戦は、プロテイン入りコーヒー系ドリンクのランディングページ制作です。両モデルに同じ発注をしました。所要時間はほぼ互角の約35分。でもコストはOpus $18.32・Sol $5.89と約3倍差がつきました(4:56頃〜)。判定の決め手はレイヤーアニメーションの完成度です。Opus版が明確に優位でした。
Nate Herkさん
「the winner of this experiment is going to Opus 5.5. No doubt.」(4:56)
「疑いなく」と言い切れる差が、いきなり初戦で出たわけです。私はこの判定の仕方に自分を重ねました。私はMaximizer(最上志向)が1位で、心の中では常に100%の仕上がりを求めています。ただAchieverは低い方なので、完了させる力は弱め。
だから「未完成でもいい、80%で出しちゃいなよ」というAI秘書の後押しが必要です。それでも譲れないのは、値段ではなく仕上がりの基準です。
Opusが選ばれた理由も「値段が安いから」ではありません。「仕上がりが基準を超えていたから」でした。値段は比べるための土俵。選ぶ理由そのものにはなりません。この順番を逆にすると、安いだけの成果物を量産することになります。
次にAIへ2案を作らせる機会があったら、値段を見る前に「どちらの仕上がりが自分の基準に合うか」を1行だけメモしてみてください。3分あればできます。判断の軸を先に決めておくと、後から値段に引っ張られません。
シズルリールとインスタリール編集——「演出のエネルギー」で差がついた2連戦
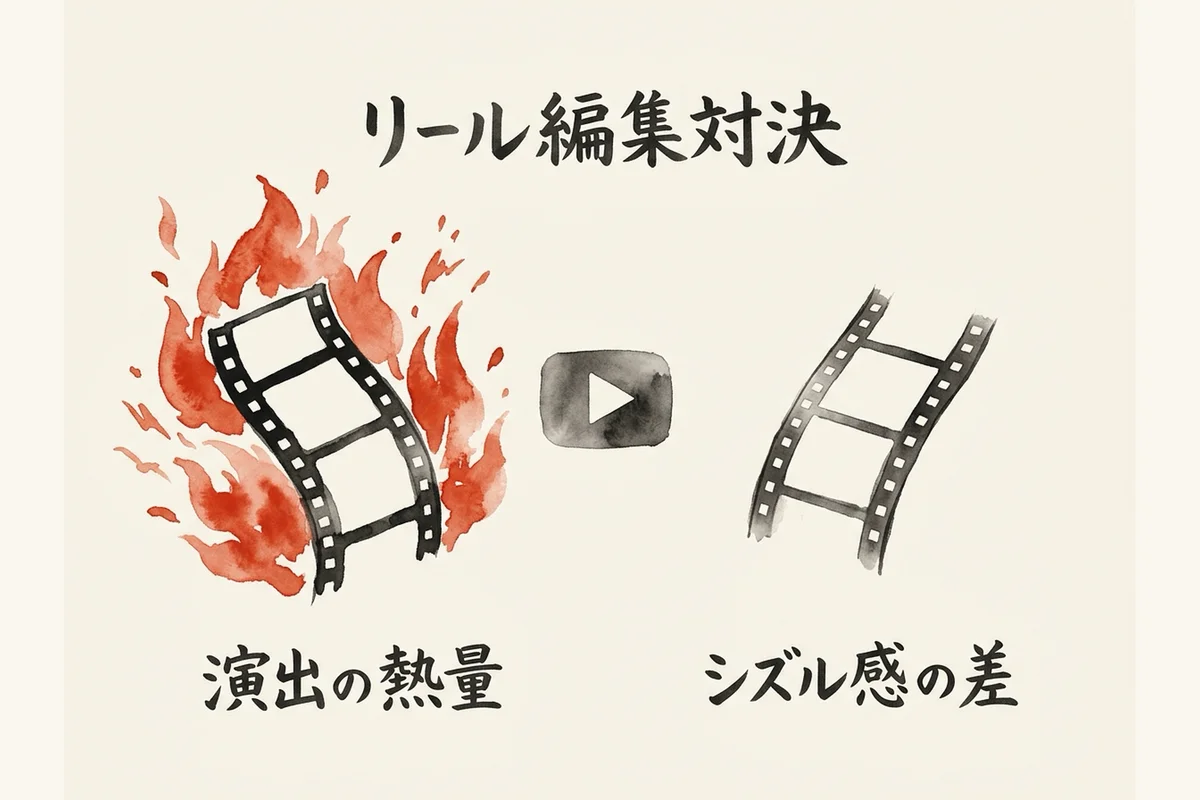
続く2戦は動画編集の実務です。ユースケース2「AIS Live」は、Frame.io上の100GBの動画素材から、30秒のイベント告知シズルリールを作る課題。Opus 31分32秒・$10.36、Sol 36分40秒・$5.07。エネルギー感の演出でOpusが優位と判定されました。
ユースケース3は、AI研究者を題材にした解説動画を、Instagramリール向けに編集する課題です。Sol版は音楽なしで単調と酷評されました。Opus版はタイピング演出と効果音付きで高評価を得ています(9:48頃〜)。
Nate Herkさん
「this is like without a shadow of a doubt significantly better than what we just got from GBD6 Soul.」(9:48、字幕は自動文字起こしのため「GBD6 Soul」表記のまま)
この2連戦で私が感じたのは、私自身の考えです。AIは横に広げます。でも現場の間合いや熱量は、五感で感じた人間にしか本当は掘れないはずだと思っています。
買い出しという現場、紙ノートという手の感触、朝LIVEという仲間との生の場。私のこだわりは全部「現場に身を置く」ことに繋がっています。
動画の間合いや効果音へのこだわりも、根っこは同じだと思います。
それでも今回はAI同士の対決でさえ、演出への”こだわりの量”に明確な差が出ました。タイピング音を足すか、音楽を選ぶか。そこまで詰めるかどうかは、指示の細かさよりも「どこまで手を抜かないか」という姿勢の差に見えます。
直近であなたがAIに出した動画や画像のプロンプトを1つ見直してみてください。雰囲気や間まで指定できていたか、5分で確認できます。指示の解像度を上げるだけで、こだわりの量を後から足せます。
BrightPathダッシュボードと3D探索ゲーム——「同じフォルダ」に入り込んで共倒れした2戦
ユースケース4「BrightPath」は、分析データからGoogleスプレッドシート・ピッチデック・ダッシュボード・ランディングページを、まとめて生成する課題でした。ところが両モデルが同一のプロジェクトフォルダに入り込みました。成果物がほぼ同一化してしまい、この回は勝敗判定が保留になりました。原因はプロンプト設計のミスです。
続くユースケース5の3D探索ゲームでも同様の事故が起きました。さらにマウスが画面外に出ると視点操作がロックされる不具合で、プレイ続行不能になりました(17:39頃〜)。
Nate Herkさん
「Wow. I mean, this is honestly unplayable because of this mouse thing.」(17:39)
この2戦の事故の原因は、突き詰めると1つです。「担当領域を分けずに、2つのAIへ同じ場所を任せた」こと。私の場合、抱え込みになる境界は、結果を自分だけで所有し完成させなければと執着した時だと気づいています。
今もまだこの戦いの最中です。現在進行形の課題として、外壁塗装リフォームの集客代行を一人で抱え込んでいます。本当はAIチームに手放して、クライアントに成果を届けたい。
今回の動画の事故も他人事ではありません。任せる時に境界線を先に引いておかないと、同じ場所を取り合って共倒れになる。そういう教訓に見えました。
複数のAIや人に仕事を振る時は、担当範囲を先に1行だけ書き出してから頼んでみてください。5分でできます。境界線を引く一手間が、後の手戻りを防ぎます。
大規模コード修復「Codebase」——GPT-6 Solが唯一勝った、”止まった”ことによる逆転勝ち
その後もOpusは勝ち続けます。ユースケース6は「過去動画100本を学べる3Dワールド」。Opus版「How AI Thinks」が複数の部屋にミニゲームを実装し、5勝目を挙げました。ユースケース7は世界旅行プラン可視化です。SF Tech Weekを正しく織り込んだリサーチ精度で、6勝目を挙げました。
ところが続くユースケース8「Codebase」の大規模コードベース修復では、流れが変わります。GPT-6 Solが独立チェック30項目中30項目パス・修復スコア100点満点。Opusは29項目パス・96.7点でした。
所要時間はOpus 40分・$19.82。Sol 22分4秒・$1.04で、約19倍のコスト差です(27:20頃〜)。決め手は”止まったかどうか”でした。Solは安全機構によって一時停止しました。Opusは停止せずに突き進みました。
Nate Herkさん
「But Opus didn’t stop. Soul stopped because of some sort of cyber security thing and safety thing.」(27:20、字幕は自動文字起こしのため「Soul」表記のまま)
本編で唯一のSol勝利が、”止まったこと”によって生まれた。ここが面白いところです。私は曖昧さへの耐性が高い方で、グレーゾーンは十分に許容できます。
ただし嘘・搾取・暴力というNGラインだけは明確です。そこだけは譲りません。止まるべき場面で止まる設計と、止まらずに押し切るリスクテイクも、同じ「境界線をどこに引くか」の話です。
どちらが優れているかという話ではありません。場面によって選ぶものだと、今回の逆転劇を見て思いました。安全機構が働いたSolの停止は「弱さ」ではなく「正しい境界線」でした。
あなたの仕事の中で、「AIに勝手に止まってほしい場面」と「止まらずに進めてほしい場面」を1つずつ挙げてみてください。5分でリストが作れます。この線引きを事前に決めておくと、Solのような安全停止をトラブルではなく成果として受け止められます。
Skool講座15本のアップロードとCanva画像再現——地道な実務作業で7勝目
残る2つのユースケースは、地味だけれど実務そのものです。ユースケース9は、ブラウザ操作でSkoolコミュニティ「AIS」に、15本の講座動画をアップロードする課題。説明・要点・引用・リンクを1本ずつ付けていきます。Opus版は講座全体をきちんとdraft化しました。
Sol版は各動画ページを個別にdraft化しましたが、一部リンクが重複するミスがありました。速さとコストでOpusが7勝目です。
ユースケース10はCanvaの描画ツールだけで、リファレンス画像を再現するブラウザ操作課題。Sol初回は禁じ手の画像生成機能を使って失格になりました。Opus版が高評価を得ています(31:45頃〜)。
Nate Herkさん
「we had 1 2 3 4 5 6 7 wins for Opus 5.5 and one win for Soul and then two that just like didn’t count because I guess I messed up.」(31:45)
この地道な作業の積み重ね方を見て、私は自分がObsidianにやっていることを思い出しました。自分の経験、価値観、口癖。すべてを1つずつ文字にしてObsidianに蓄積します。
要点も引用もリンクも、面倒でも1本ずつ丁寧に残す。これが分身AIの「魂」になります。「分身AIを育てる=自分が育つ」を体現しています。
講座動画に要点・引用・リンクを、1本ずつ丁寧に付けていくOpusの作業。私が日々の気づきを言語化して積み上げているのと、同じ構造に見えました。派手な一発逆転ではありません。地味な積み上げの精度が、最終的なスコアを決める。この点はAIでも人間でも変わらないようです。
AIに任せている定型作業を1つ選び、要点・引用・リンクまで揃った状態で出力できているかを確認してみてください。10分あれば1件チェックできます。
総合7勝1敗2ノーコンテスト——Opusを指揮者、Solを作業者にする構想
最終集計は、Opus 5.5が7勝、GPT-6 Solが1勝。2件はプロンプト設計ミスによるノーコンテストでした。合計作業時間はOpus 8時間40分・Sol 5時間51分。合計コストはOpus $213・Sol $74.46で、約3倍差です。
Nate Herkさんの結論はこうです。Opus 5.5は前世代のOpus 5から大幅進化した一方、GPT-6 Solは前世代の5.6 Solより後退した印象だった。
そのうえで、創造性や判断が要る仕事はOpusに、明確な手順が決まっている仕事はGPT-6系のワーカーに任せる構想を語ります。Opusをオーケストレーター、Solをワーカーとして組み合わせる発想です(33:10頃〜)。
Nate Herkさん
「Obus 5.5 is a major step up from Obus 5. GBD6 Soul is a step down from 5.6 Soul.」(33:10、字幕は自動文字起こしのため「Obus」「GBD6 Soul」表記のまま)
オーケストレーターとワーカーに分ける発想は、私の考え方とそのまま重なります。私の役割分担ではこうです。人間である私が、今ここで内側のワクワクを縦に掘る。五感や遊び探求という縄文型の源を生きます。
分身AIは計画・構造化・実行・計測・分析・改善という、弥生型のエンジンを担います。機能と価値判断は固定しません。状況・目的・内容で使い分けて、基本の判断も分身AIへ委ねて手放します。
Opusに指揮を任せ、Solに手を動かしてもらう構想。AIが1体だけの話ではありません。複数のAIをチームとしてどう組むか。私が毎日やっていることと、同じ地平にありました。
あなたが使っているAIツールを、指揮役と作業役に分けて紙に書き出してみてください。10分あればできます。1つのAIに全部を求めるのをやめるところから、あなたの「委ねるOS」も動き出します。
実際にOpus 5.5とGPT-6 Solへ4つのお題を投げてみた
動画を見るだけで終わらせず、うちのCockpit環境で実際にOpus 5.5(claude-opus-5-5)とGPT-6 Sol(gpt-6-sol)へ同じ4つのお題を投げてみました。ブログのH2一本執筆、SEOタイトル20案出し、LIVE告知文とX投稿文の下書き、そして優先順位が途中で変わる多段階指示。普段の私の仕事に近い、コンテンツ寄りのお題です。
いちばん面白かったのは、4つ目の「途中で優先順位が変わる指示」です。「AとBとCをこの順で説明して。次にDも。ここで変更、Bは無し、Dを最優先、CはBの後Aの前」という条件を渡すと、両モデルとも一字一句同じ結論にたどり着きました。
Opus 5.5・GPT-6 Sol 両方の最終回答(一字一句同一)
「1. D:読者の悩みのヒアリング項目の洗い出し/2. C:タイトル案の作成/3. A:見出し画像のプロンプト作成」
ブログのH2執筆課題では、同じ引用・同じ一人称エピソードを渡したところ、Opusが1,042字、Solが1,040字と、狙った900〜1,200字の枠にほぼ同じ長さで収まりました。私には「未完成でもいい、80%で出しちゃいなよ」というAI秘書の後押しが必要ですが、この程度の文章量なら、どちらの下書きも80%の出発点として十分使える手応えでした。SEOタイトル出しとLIVE告知文の下書きも、両モデルとも指定の字数・本数を守って形式面は問題ありませんでした。
あなたも普段使っている定型業務(タイトル出し・告知文・優先順位の入れ替え指示など)を1つ選んで、手元のAIに2パターン投げ比べてみてください。所要は10分。字数や指示の遵守だけでも、モデル選びの手がかりになります。
よくある質問
Q. Opus 5.5とGPT-6 Sol、結局どっちを使えばいいの?
A. 動画の結論は「勝率で選ぶ」ではなく「役割で分ける」でした。Nate Herkさんは、創造性や判断が要る作業はOpus、明確な手順があるワーカー的な作業はGPT-6系に任せる構想を語っています。私も分身AIチームで指揮役と作業役を状況に応じて使い分けていて、同じ発想です。
Q. コストが約3倍も違うのに、なぜOpusを選ぶ場面があるの?
A. 合計コストはOpus $213・Sol $74.46で約3倍差でしたが、Nate Herkさんは値段ではなく仕上がりの基準で判定していました。値段は比べるための土俵であって、選ぶ理由そのものではないという見方が参考になります。
Q. 両方のAIが同じフォルダに入り込んで事故った回があったのはなぜ?
A. ユースケース4と5では、担当領域を分けずに2つのAIへ同じプロジェクトフォルダを任せたことが原因でノーコンテストになりました。複数のAIやメンバーに仕事を振る時は、担当範囲を先に1行でも書き出しておくことが事故を防ぐ一歩です。
まとめ——モデルを比べるんじゃなくて、任せ方を分ける
34分の10番勝負を見終わって残ったのは、「どっちのAIが優秀か」という問いへの、私なりの答えでした。7勝1敗2ノーコンテスト。数字だけ見ればOpus 5.5の圧勝です。でも本当に大事なのは、唯一の敗因が”止まったこと”だったという逆転劇の方でした。速さでも値段でもありません。どこで止まり、どこで止まらないか。その設計が、最後は成果を分けていました。
で、その先にあるのが「指揮役と作業役に分ける」という発想です。1つのAIに万能を求めるのではなく、判断はOpusのような指揮役に、手順が決まった作業はワーカー役に振る。この線引きさえ決めておけば、あとは思い切って任せていい。あなたなら、今の仕事のどこを指揮役に、どこを作業役に任せますか。
COLUMN
職人肌の料理人と、手早い調理助手
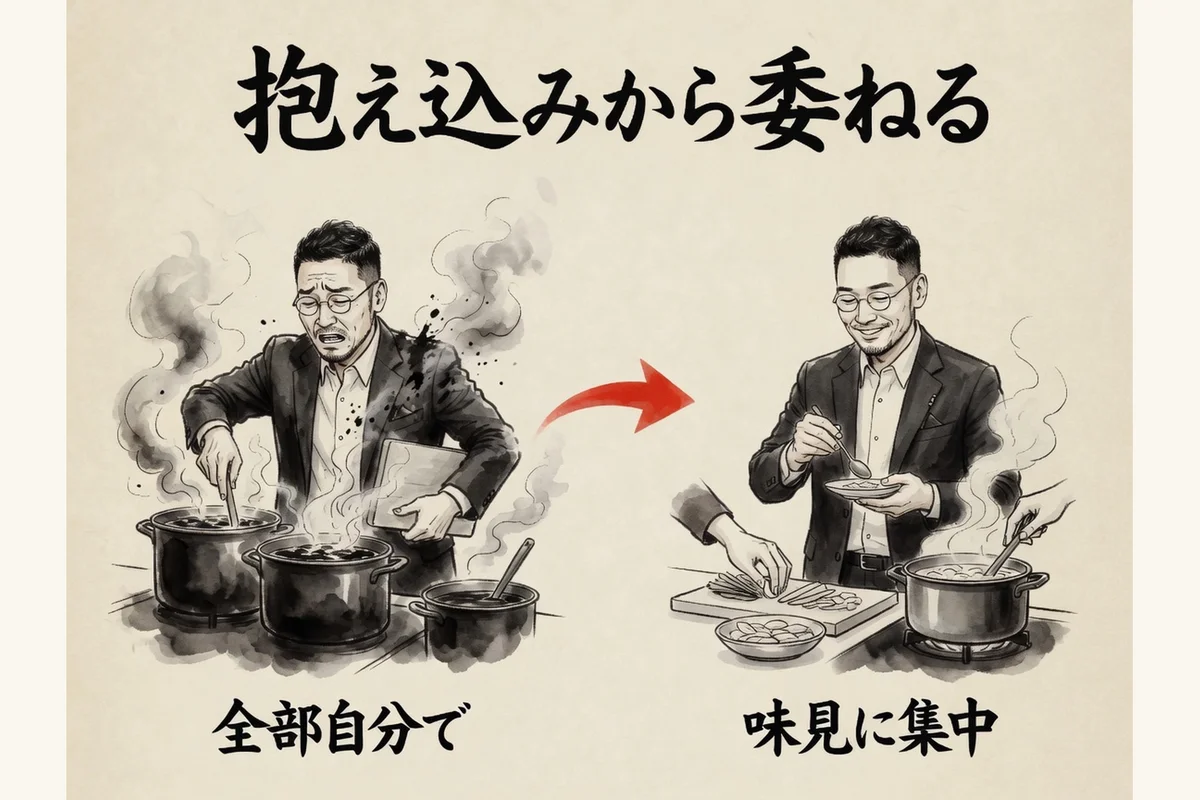
この動画を見ながら、私は自分の「抱え込みOS」のことを考えていました。1つのAIに全部を求めてしまうのは、厨房を1人で回そうとするのと同じです。仕込みも調理も盛り付けも全部自分でやろうとすると、新しいメニューを考える時間がなくなります。
料理に例えると、Opusは仕込みから盛り付けまで自分の基準でこだわる職人肌の料理人。Solは指示通りに手早く動く調理助手です。どちらが優れているかではなく、どの持ち場を任せるかという話でした。今日は職人に仕込みを任せ、明日は助手に量産を任せる。厨房のチームワークは、そうやって組むものだと思います。
ただ、任せ方を間違えると事故ります。まな板を2人が同時に使えばぶつかります。同じフォルダに2つのAIを放り込めば、動画のBrightPathや3D探索ゲームのように成果物が混ざって共倒れになります。担当を分けるのは、遠慮ではありません。安全のためです。
値段の違いにも同じことが言えます。私も「週間利用枠を見落として上位モデルで2回続けてコケた話」を分身AI日記に書いたことがあります。上位モデルのコストは、無駄遣いではなく「どこで止まらせないか」に払う対価です。逆に、AIが同じミスを繰り返す時は、値段より先に「原因の掘り方」を疑った方が早いこともあります。
未完成でもいい。80%で出して、指揮と作業を分けて、味見だけは卒業しない。それが私の「委ねるOS」の現在地です。👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね。
関連記事
「指揮役と作業役を分ける」を別のAIモデルで実践した回。今回のOpus/Sol対決とセットでどうぞ
複数のAIをチームとして動かす発想を、別の角度から掘った回
今回のSkool講座アップロードのような地道な積み上げ作業と地続きの一次情報の話
参考リンク
AI自動化・エージェント運用を実機検証するNate Herkさんのチャンネル
動画に登場したOpus 5.5を含むClaudeシリーズの公式サイト
動画に登場したGPT-6 Solを含むモデル群の公式ドキュメント
この記事の実機検証について(お断り)
実機検証セクション(08)の内容は、うちのCockpit環境でOpus 5.5・GPT-6 Solへ実際に同じお題を投げて得た実物の回答です。動画のようなブラウザ操作の録画・スクリーンショットは用意していません(文章生成タスクの比較には録画・スクショの対象になる操作画面が無いため)。声の質や構成の「どちらが優れているか」という主観評価は行っておらず、比較できたのは字数と、多段階指示への追従結果が一致したことの2点です。
📺 今回紹介した動画
| タイトル | I Tested Opus 5.5 vs. GPT-6 Sol on 10 Real Use Cases |
| チャンネル | Nate Herk | AI Automation |
| 出演 | Nate Herkさん(単独ナレーション) |
| 公開日 | 2026年9月23日 |
| URL | https://www.youtube.com/watch?v=eF3yeJuifoQ |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 6:30〜 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 6:30〜 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜 / 8:00〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!