AI音声・ナレーション
ElevenLabsとGemini 3.8 TTSの料金と声。同じ台本9行を自分の声で5本聴き比べた結果
2026年9月30日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくんです。講座動画のナレーションは、ElevenLabsで作っています。私の声のクローンと、AI秘書の凛ちゃんの声で、台本を1行ずつ読ませる形です。
で、9月の終わりに「Gemini 3.8 TTSに切り替えたら、メリットとデメリットはどうなる?料金は?」と調べてもらいました。答えは、乗り換えないでした。同じElevenLabsの新しい版、v4 Turboに替えています。
今回はElevenLabsとGemini 3.8 TTSの料金と聴き比べを、公式の単価と自分の講座動画の実測だけでお届けします!
3行でわかるポイント
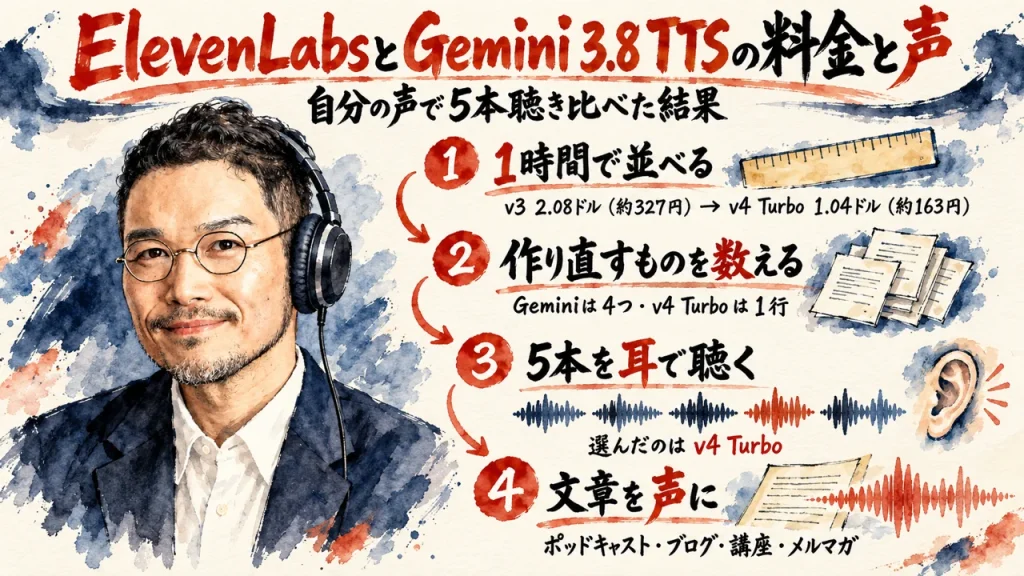
- 料金は1時間で並べる。いま使っていたElevenLabs v3は1時間2.08ドル(約327円)。v4 Turboは1.04ドル(約163円)、Gemini 3.8 Flash-Liteは2027年から1.08ドル(約170円)で、ほぼ同じ水準です。
- 聴き比べは自分の声で。同じ台本9行(448文字)を5本作って、文字起こしで台本と照らしました。読み間違いの差はほぼ無し。決め手は声でした。
- 結論は、コストパフォーマンスが良いのはElevenLabs v4 Turbo。5本を実際に全部聴いて、体感して選び取りました。v4はTurboでも品質は十分。Geminiより好みでした。変えたのはモデル名の1行だけでした。
「Gemini 3.8 TTSは安い」は本当か。1時間あたりで並べた
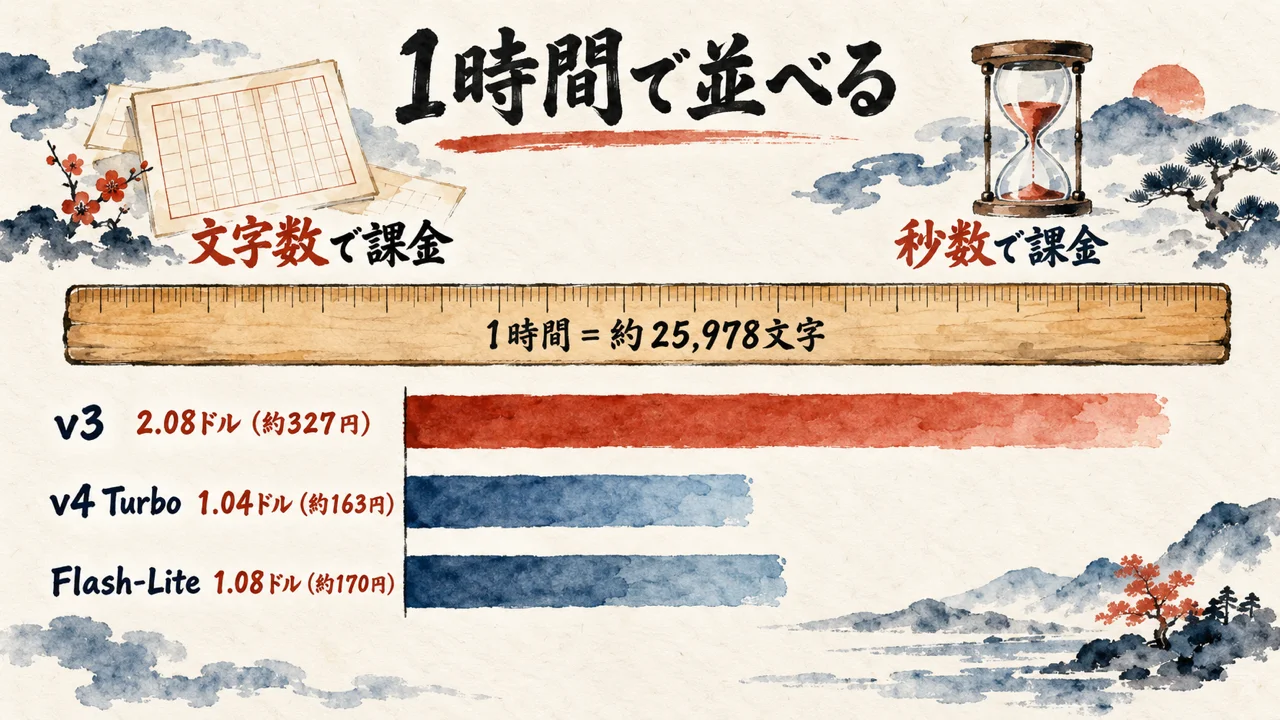
最初につまずいたのは、単価の単位が違うことでした。ElevenLabsは文字数で課金します。Geminiは音声の秒数で課金します(1秒=25トークン)。
この2つは、そのままでは比べられません。で、間に「日本語1分は何文字か」を挟むことにしました。
測ったのは、実際に公開した講座動画1本です。ElevenLabsに送った台本は2,711文字。できあがった音声は6分16秒でした。
割り算すると1分433文字、1時間なら約25,978文字です。
この1時間を各社の公式単価に当てはめたのが下の表です。単価はElevenLabsのAPI料金ページとGemini APIの料金ページから取っています。
| モデル | 公式の単価 | 1時間 | 講座1本(6分16秒) | 値上がり・割引終了 |
|---|---|---|---|---|
| ElevenLabs v3(9月まで使用) | 1,000文字 0.08ドル(約13円) | 2.08ドル(約327円) | 0.22ドル(約35円) | 記載なし |
| ElevenLabs v4 | 1,000文字 0.022ドル(約3.5円・通常0.08ドル(約13円)・10/12まで72%引き) | 0.57ドル(約89円) → 2.08ドル(約327円) | 0.06ドル(約9.4円) → 0.22ドル(約35円) | 10/12に割引終了 |
| ElevenLabs v4 Turbo(私の選択) | 1,000文字 0.011ドル(約1.7円・通常0.04ドル(約6.3円)・10/12まで72%引き) | 0.29ドル(約46円) → 1.04ドル(約163円) | 0.03ドル(約4.7円) → 0.11ドル(約17円) | 10/12に割引終了 |
| Gemini 3.8 Flash TTS | 音声100万トークン 9.00ドル(約1,413円) | 0.81ドル(約127円) → 1.62ドル(約254円) | 0.08ドル(約13円) → 0.17ドル(約27円) | 2027年1月1日に倍(18.00ドル(約2,826円)) |
| Gemini 3.8 Flash-Lite TTS | 音声100万トークン 6.00ドル(約942円) | 0.54ドル(約85円) → 1.08ドル(約170円) | 0.06ドル(約9.4円) → 0.11ドル(約17円) | 2027年1月1日に倍(12.00ドル(約1,884円)) |
1時間=約25,978文字=90,000音声トークンで計算。Geminiの入力テキスト代(100万トークン0.50ドル(約79円))は表に入れていません。円は1ドル=157円(欧州中央銀行の参考レート、2026年9月29日)で換算。為替で変わります。ひと月の定額プランに入っている場合、1本ごとの実際の支払いはこの表と違います。
「Geminiは安い」は、2026年の間は本当です。ただ、2027年1月1日に音声の単価が倍になるって、公式ページに書いてあります。
倍になったあとのFlash-Liteが1.08ドル(約170円)。ElevenLabs v4 Turboの通常価格が1.04ドル(約163円)。ほぼ同じです!いまのv3と比べれば、どちらも半分です。
つまり「安くしたい」だけなら、答えは2つあったんです。Geminiに乗り換えるか、同じElevenLabsの中でv4 Turboに替えるか。どちらも料金は半分。ここで分かれ目になったのが、次の「作り直すものの数」でした。
乗り換えで作り直すものを数えたら、Geminiの方がずっと多かった
私の講座動画は、台本を1行ずつ読ませて、つないで作っています。私の役は私の声のクローン。AI秘書の凛ちゃんの役は、凛ちゃん用に決めた声です。
固有名詞の読み方は辞書で直します。できた音声は文字起こしAIで聞き取って、台本と照らします。この仕組みのどこが変わるかを、乗り換え先ごとに数えました。
| ElevenLabs v4 / v4 Turbo | Gemini 3.8 Flash / Flash-Lite | |
|---|---|---|
| 声 | いまの声がそのまま使える | 既製の声は30種。自分の声は作り直し。保存した声は1年で期限切れ(1プロジェクト200声まで) |
| 掛け合い | 行ごとに声を変えて作る(今のやり方のまま) | 1回の生成で2人まで。作り方が変わる |
| 感情・間の指定 | タグを重ねて使える(今の台本の形式) | <sigh> <short pause> などの形式。台本のタグは全部書き換え |
| 日本語 | 対応。v4で品質の伸びが大きかった言語の一つ(同社の発表) | 対応。Flashは130以上、Flash-Liteは100以上の言語 |
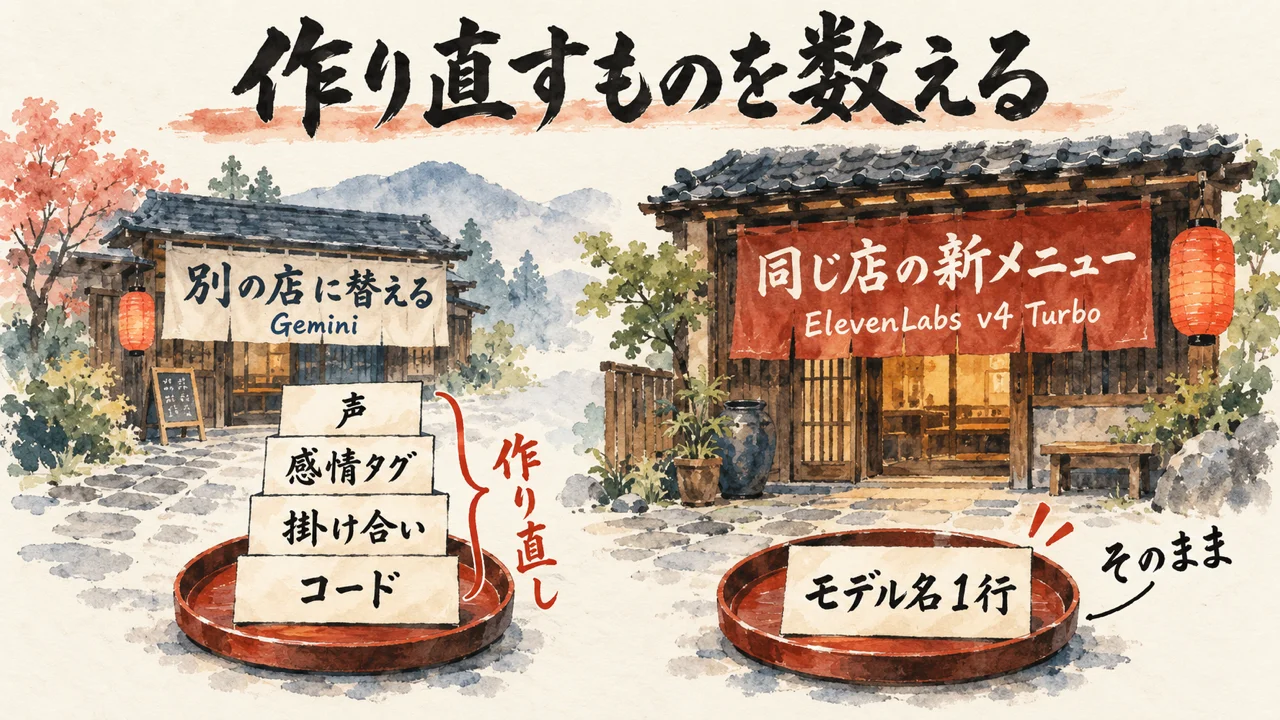
| 直すコード | モデル名の1行 | 読み上げ部分を書き直し |
Geminiの仕様はSpeech generationの公式ページ、ElevenLabs v4の内容はTechCrunchの発表記事(2026年9月28日)から。
Geminiに替えると、声・タグ・掛け合いの作り方・読み上げのコードの4つが変わります。声は1年ごとに作り直しも要ります。
一方でElevenLabsの中でv4 Turboに替えるなら、変わるのはモデル名の1行です。声も辞書も、文字起こしの確認もそのまま。
料理に例えると、こういうことです。通っている店を替えるか、同じ店の新メニューを頼むか、の違いです。で、同じ台本で聴き比べました。
同じ台本9行を、自分の声で5本作って聴き比べた
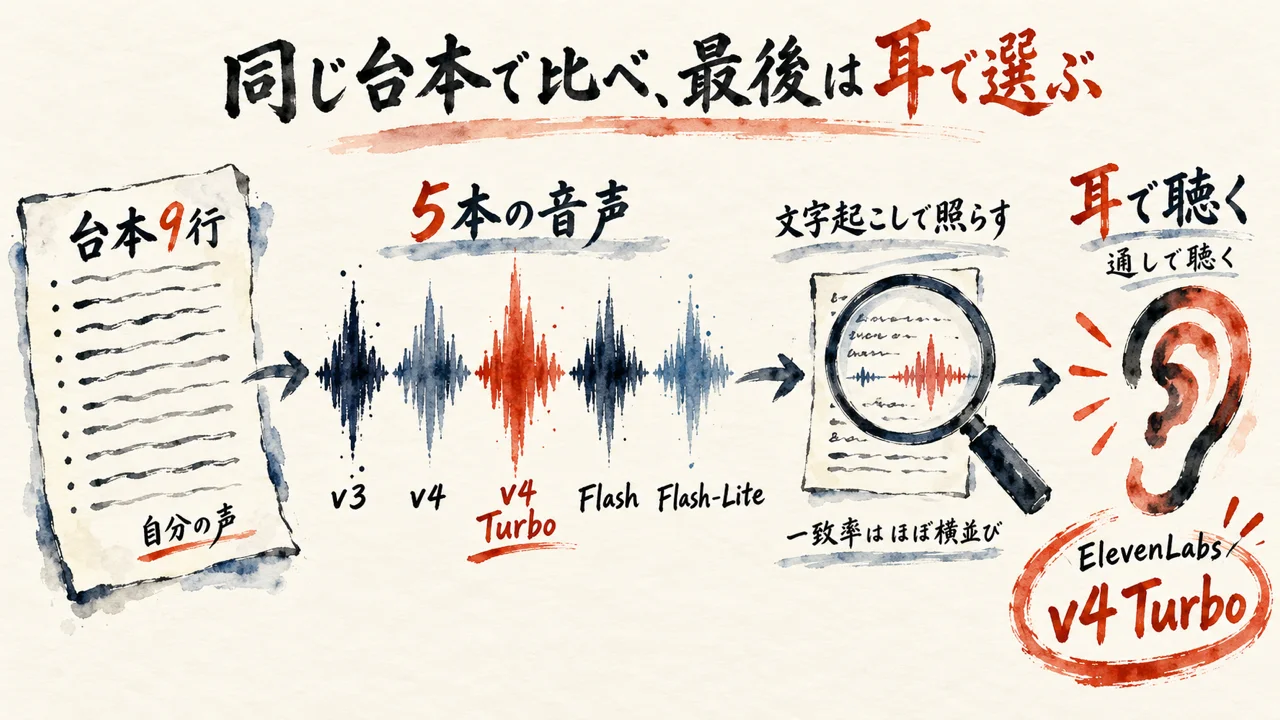
台本は、講座動画「Claude Codeの設定」の冒頭9行、448文字です。私とAI秘書の凛ちゃんの掛け合いで、[surprised] や [warm] のような感情タグが付いています。
v3の音声は本番で作ったものをそのまま使い、残りの4本を新しく作りました。Geminiの2本も、私の声のクローンです。Google側に保存してあった私の声を使っています。
数字も出しました。本番と同じ方法です。
文字起こしAI(Whisper large-v3)で5本を聞き取り、台本との一致率を行ごとに出す。0.75を切った行を「怪しい行」って数えます。
| モデル | 声 | 平均一致率 | 怪しい行(0.75未満) |
|---|---|---|---|
| ElevenLabs v3 | 私のクローン | 0.90 | 0行 |
| ElevenLabs v4 | 私のクローン | 0.93 | 0行 |
| ElevenLabs v4 Turbo | 私のクローン | 0.93 | 0行 |
| Gemini 3.8 Flash | 私のクローン | 0.92 | 1行 |
| Gemini 3.8 Flash-Lite | 私のクローン | 0.92 | 1行 |
5本とも、ここで聴けます。AIで作った音声です(ElevenLabs/Gemini)。声は私のクローンと、AI秘書の凛ちゃん用の声です。
ElevenLabs v3(9月まで使用)
ElevenLabs v4
ElevenLabs v4 Turbo(私の選択)
Gemini 3.8 Flash TTS
Gemini 3.8 Flash-Lite TTS
数字はほぼ横並びでした。差がはっきり出たのは、たった1行です。AI秘書の凛ちゃんが名乗る行でした。
台本(6行目)
[cheerful] お届けするのは、AI秘書の凛ちゃんと……(名乗りの1行。表記は台本のまま読み上げ)
v3だけ、AI秘書の凛ちゃんの名前が「ディント」と聞き取られました(一致率0.80)。v4、v4 Turbo、Geminiの2本は、全部、名前を正しく取れています(1.00)。9月まで使っていたv3が、いちばん名前を落としていたんです。
逆にGeminiの2本は、冒頭の1行目で崩れました。「SNSでそう騒がれた事件」が、Flashでは「SNSで捜査を上げた事件」(0.72)、Flash-Liteでは「SNSで捜査分かれた事件」(0.75)と聞き取られています。
一致率には、書き方の違いも混ざります。「ぜんぶ」を「全部」、「1行」を「一行」と書けば下がります。
「共創」が「競争」になった行は、5本とも同じ0.83でした。
で、5本を実際に全部聴きました。体感して選び取った結果、コストパフォーマンスが良いのはv4 Turboでした。5本の中で一番でした!v4はTurboでも品質は十分。Geminiより好みでした。
数字で並べると、v4とv4 Turboは同じ0.93。料金はv4 Turboが半分。
替えたのはモデル名の1行。戻し方も1行で用意した
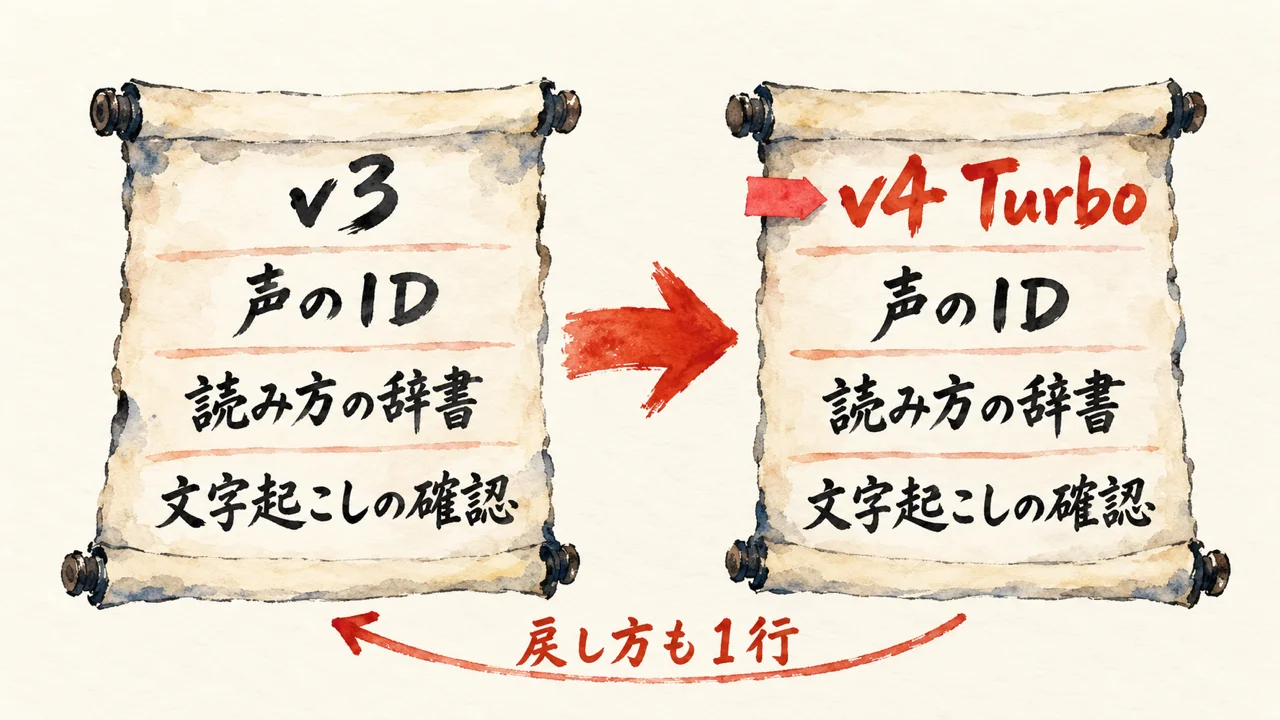
9月30日に、講座動画などのナレーションをv3からv4 Turboへ切り替えました。直したのは、読み上げを作る仕組みの中でモデル名を決めている1か所です。声のID、読み方の辞書、文字起こしでの確認は、1文字も触っていません。
切り替えてすぐ、1行だけ試しに作りました。3.5秒の音声です。文字起こしで「お届けするのはAI秘書のリンとヒロくんです」と取れました。ここまでで、本番の仕組みが新しい版で動くことが確かめられます。
次に、設定の漏れを点検しました。読み上げを作る入口は、講座動画、解説動画、朝のブリーフィング、掛け合いの生成など7つあります。全部が同じ1か所を通っていました。別の場所でモデル名を固定している所は0件。
ただ、説明書や手順書には「v3を使っているか確認」って書いた所が8ファイル残っていました。そこは「既定はv4 Turbo、v3は戻し用」に直しています。
感情タグも確かめました。[surprised] のようなタグが付いた8行をv4 Turboで作って、文字起こしにかける。タグを文字として読み上げた行は0でした。
戻し方は先に用意してあります。1回だけ戻すなら、実行時に「v3で」と指定する。ずっと戻すなら、あの1行を元に戻す。それだけです。
料金が変わる日付。ElevenLabsは10月12日、Geminiは2027年1月1日
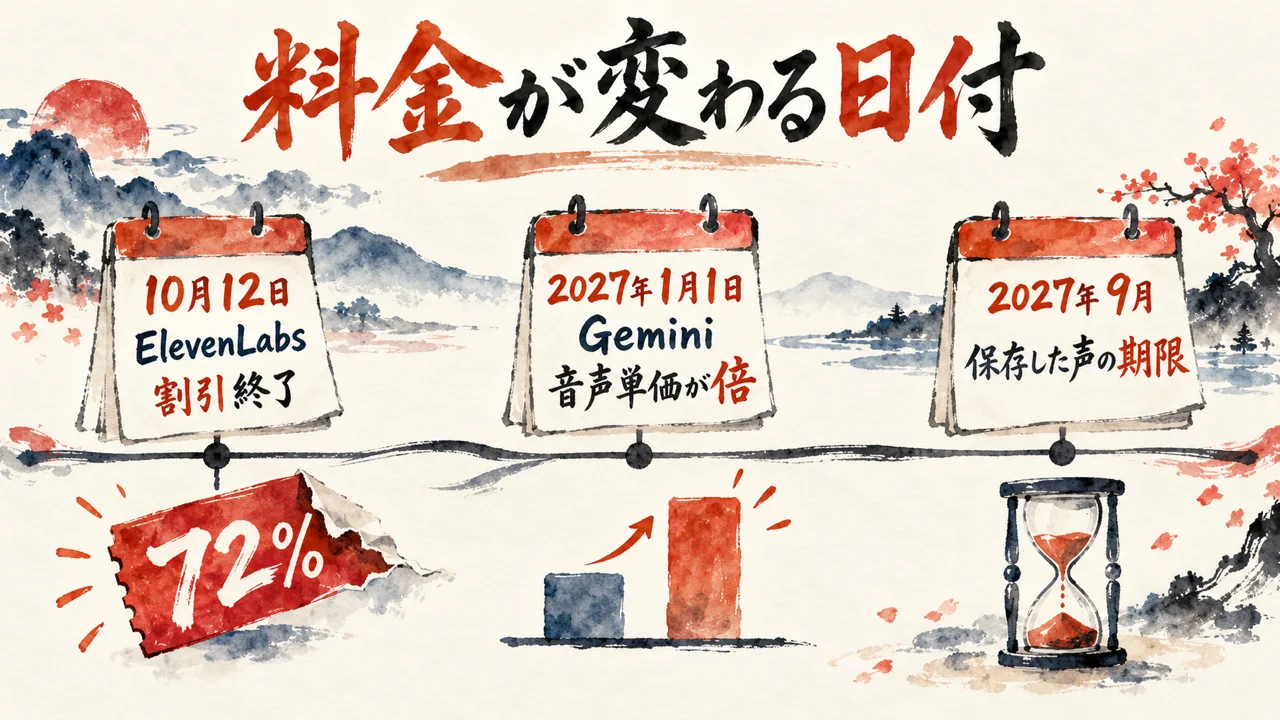
料金の前提は2つ変わります。ElevenLabsの72%引きは10月12日までです。そのあとv4 Turboは1時間1.04ドル(約163円)に戻ります。
Geminiは2027年1月1日に音声の単価が倍になります。どちらも公式ページに日付が書いてあるので、この記事の表はその日付で読み替えてください。
Geminiには、一括処理の料金(Batch)もあり、音声代は半額です。
私の講座は1本ずつ作って確認する流れなので、今回はそこを使っていません。
もう一つ。Google側にも、私の声のクローンは保存してあります。期限は2027年9月です。
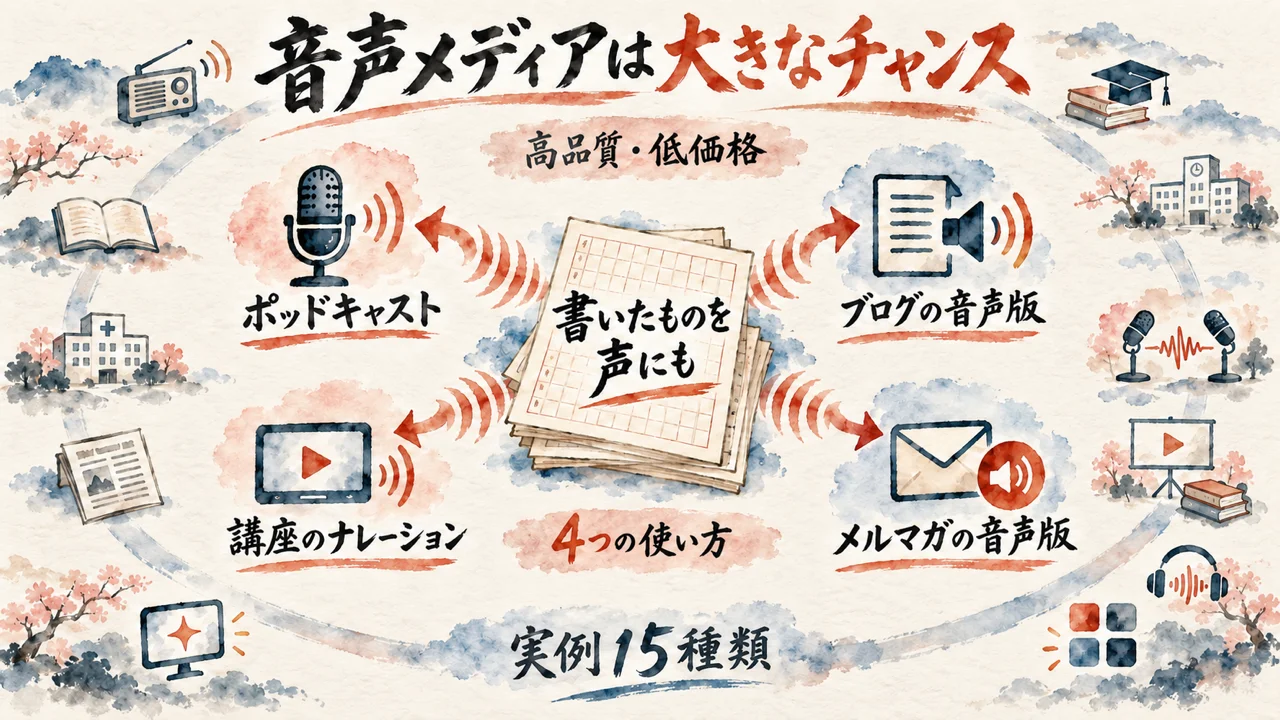
高品質で低価格。だから音声メディアは大きなチャンス。おすすめの使い方4つと実例15種類
ここまでは、料金と聴き比べの話でした。最後に、私の意見を1つ書きます。
ハイクオリティかつ低価格でできるので、音声メディアはかなり大きなチャンスがあると思います。
根拠は、この記事の2つの数字です。1分433文字。v4 Turboの通常価格は1,000文字0.04ドル(約6.3円)。この2つで、何を作るといくらか、全部計算できます。下の金額は割引が終わったあとの通常価格です。10月12日までは72%引きなので、さらに下がります。
1つ目は、ポッドキャストです。講座の台本や、LIVEで話した内容を10分の原稿にして、自分の声のクローンに読ませます。10分は約4,330文字。0.17ドル(約27円)です。週1回、1年で52本作っても、約225,000文字で9.01ドル(約1,415円)です!
2つ目は、ブログ記事の音声版です。記事の本文をそのまま読ませて、記事の中に置きます。3,000文字の記事なら約7分、0.12ドル(約19円)です。私も分身AI日記で、記事を声に変えて公開しました。台本を23パートに分けて、パートごとに感情のタグを付けて、3分11秒の音声にしました。
3つ目は、講座動画や解説動画のナレーションです。これは私が今やっている使い方です。台本を1行ずつ読ませて、動画に載せます。講座1本(6分16秒・2,711文字)で0.11ドル(約17円)。1時間分なら1.04ドル(約163円)です。録り直しは、台本を直して作り直すだけです。
4つ目は、メルマガの音声版です。書いたメルマガをそのまま読ませて、音声のリンクを本文に添えます。2,000文字のメルマガなら約4分半、0.08ドル(約13円)です。
4つに共通しているのは、新しく書かなくていいことです。講座、LIVE、ブログ、メルマガ。いま手元にある文章を、声に変えるだけです。書く仕事を1つ増やすのではなく、書いたものを声にも出す。それだけです。
声は、自分のクローンでも、既製の声でもかまいません。私は自分の声のクローンと、AI秘書の凛ちゃんの声で作っています。
実際に使われている音声AIの活用アイデア。国内外17件を15種類に分けました
私の4つは、自分の手元の話です。で、他の人はどう使っているのか。国内外の事例を調べて、ページ本文に引用がある17件だけを残しました。種類で分けると15。日本の事例から先に並べます。
- 地域番組のナレーション(株式会社ネット鹿島)
- 広報・教材のナレーション(横浜国立大学)
- 患者向け説明の音声(秋田大学医学部附属病院)
- 学校テストの読み上げ(光文書院)
- ニュースの音声配信(朝日新聞社、大分合同新聞社)
- 本人の声色のオーディオブック(オトバンク)
- 資料からのAI音声対談(Google NotebookLM)
- 失った声の復元(Ed Riefenstahl)
- 講座のAI共同講師(Cornell University / eCornell の Lutz Finger)
- 動画の多言語吹き替え(Drew Binsky、Vimeo)
- 話すアバター動画(DeepBrain AI)
- 製品に入った音声合成(Google)
- 学習アプリの音声講師(Brilliant)
- 講師の声での対話(MasterClass)
- 読み手を選ぶオーディオブック(Storytel)
各事例は、何をしたか。ページの言葉をそのまま。小さな事業でどう真似するか。この順で書きます。数字は、そのページに書いてあるものだけです。
1. 地域番組のナレーション
株式会社ネット鹿島は、2025年11月から、ケーブルテレビの情報番組のナレーションをAITalk声の職人で作っています。話者は、ページ上の「えみり」と「ひでと」です。
1日5回放送されるケーブルテレビ内の情報番組です。30分の枠の中で、地域のニュース・行政・イベント情報などを放送しています。
出典: エーアイ 導入事例(公開日の記載なし。採用は2025年11月)
小さな事業で真似するなら。小さな事業で真似するなら、30分番組のナレーションを読み上げソフトで作る、この形そのままです。ページに大きな配信の仕組みの話はありません。
2. 広報・教材のナレーション
横浜国立大学は、広報動画と教材のナレーションに、AITalk声の職人とAITalk Internationalを入れました。ページが挙げているのは、新入生歓迎会の動画と、学生向けの情報セキュリティ教材です。
広報動画や教材のナレーション作成として「AITalk 声の職人」「AITalk International」を導入しました。現時点では、大学の新入生歓迎会の様子を動画にしたものや、学生向けの情報セキュリティ教育教材のナレーションを作成しています。
出典: エーアイ 導入事例(2022年3月時点の記事)
小さな事業で真似するなら。広報動画と教材のナレーションを読み上げソフトで作る。小さな事業でもそのまま使える形です。ページに外部ナレーターの継続契約は出てきません。
3. 患者向け説明の音声
秋田大学医学部附属病院は、20分の手術説明スライドにAITalk声の職人の音声を付けて、患者さんに案内しています。ページはトライアルと書いています。
現在はトライアルで作成した20分間の手術の説明スライドにAITalk声の職人で作成した音声をつけて患者様に案内しています。
出典: エーアイ 導入事例(2022年3月時点の記事)
小さな事業で真似するなら。小さな事業で真似するなら、20分の説明スライドに読み上げ音声を付けてお客さんに渡す使い方です。ページはトライアルと書いています。
4. 学校テストの読み上げ
光文書院は、2024年4月から、小学校のテストの問題文を読み上げた音声を、先生や児童の端末で再生できるサービスを展開しています。ページは国語だけと書いていて、算数・理科・社会へ広げたいとあります。
光文書院が2024年4月より展開する「小学校のテストの音声読み上げサービス」は、テストの問題文を読み上げた音声を、先生の端末や児童の端末で再生できるというものです。
出典: エーアイ 導入事例(2024年8月時点の記事)
小さな事業で真似するなら。問題文を読み上げて端末で再生する使い方で、ページにAPI契約の話はありません。配信の主体は教科書会社です。
5. ニュースの音声配信
朝日新聞社は、編集者が選んだ主要ニュースをAIの音声が約1分半で読み上げる「ニュースの要点 きょうの3本」を始めました。どの音声合成を使っているかは、ページにありません。
編集者が厳選した主要ニュースを、AIの音声が約1分半で読み上げます。
出典: PR TIMES 朝日新聞社(2026年4月10日)
大分合同新聞社は、自社のプレミアムオンライン「Gate」で、朝夕刊の特定ニュースをAITalkの音声で読み上げています。2015年10月時点の記事です。
ご高齢の方、視力の弱い方、通勤・通学など、ニュースを見ることが難しいユーザーや状況において、音声でニュースを伝えることが出来るようになりました。
出典: エーアイ 導入事例(2015年10月時点の記事)
小さな事業で真似するなら。朝日新聞の形は、編集した短い原稿を約1分半で読み上げる。小さな事業でもできる形です。大分合同新聞のような自社サイトとアプリでの配信は、個人の店が同じ配信をする手順がページにありません。
6. 本人の声色のオーディオブック
オトバンクは、プロのナレーターの朗読をAIで山崎元さんの声色に変換した「AI本人オーディオブック」を、2026年3月5日に配信開始しました。作品は『がんになってわかった お金と人生の本質』(朝日新聞出版)。逝去した方の声を再現するオーディオブック制作はオトバンクで初の試み、とページにあります。
「AI本人オーディオブック」とは、プロのナレーターによる朗読音声を、AI音声技術を用いて特定の人物の声色に変換する制作手法です。
出典: PR TIMES オトバンク(2026年3月5日)
小さな事業で真似するなら。プロの朗読を特定の人の声色に変える制作です。権利者と技術会社の共同で、ページに個人が同じ許諾で作る手順はありません。小さな事業でそのまま真似するのは難しい形です。
ここから海外の事例です。引用は原文のまま、その下に和訳を付けました。
7. 資料からのAI音声対談
Googleは、NotebookLMに入れた資料をもとに2人のAIホストが音声で対話する、Audio Overviewを公開しました。
Today, we’re introducing Audio Overview, a new way to turn your documents into engaging audio discussions. With one click, two AI hosts start up a lively “deep dive” discussion based on your sources.
(和訳)本日、Audio Overviewを紹介します。資料を、聞きやすい音声の対話に変える方法です。ワンクリックで、2人のAIホストが、入れた資料をもとに活発な「深掘り」の対話を始めます。
出典: Google公式ブログ(2024年9月11日)
小さな事業で真似するなら。自分の資料をワンクリックで2人の音声対話にできる機能です。記事の時点では、ホストは英語だけを話すと書いてあります。
8. 失った声の復元
TCU Neeley School of BusinessのEd Riefenstahlさんは、けがの前の録音からElevenLabsで声のクローンを作り、授業で再生しています。2021年の転倒による外傷性脳損傷のあと、bulbar palsyと診断された、とページにあります。
“Hearing your voice again when you thought it was gone,” Ed shared, “it felt like a part of me was restored.”
(和訳)「戻らないと思っていた自分の声が、また聞こえた。自分の一部が戻ったように感じた」とEdは話した。
出典: ElevenLabsブログ(2024年12月17日公開・2026年9月6日更新)
小さな事業で真似するなら。個人の教員が、以前の自分の声のクローンを授業で使う形です。クローンはElevenLabs側が録音から作った、とページにあります。
9. 講座のAI共同講師
Cornell University/eCornellのLutz Fingerさんは、オンライン修了証講座「Designing and Building AI Solutions」に、ElevenLabsの声のAI共同講師S.A.I.を入れました。声はKenneth Cukierさんのクローンです。本人がサイトで同意するまで、代理でのクローン作成はvoiceCAPTCHAで止まった、とページにあります。引用は、クローンの声を奥さんが聞いた場面です。
She replied by saying she knew it wasn’t, but not because of the voice. The only ‘tell’? He used phrases he’d never normally say.
(和訳)妻は、本人ではないと分かった、と返事をしたが、声が理由ではなかった。見破れた点は一つだけで、普段は絶対に使わない言い回しを使っていたことだった。
出典: ElevenLabsブログ(2024年8月5日公開・9月22日更新)
小さな事業で真似するなら。本人が同意した声のクローンを、講座の掛け合い相手にする形です。代理人だけでのクローン作成は、ページ上voiceCAPTCHAで止まっています。
10. 動画の多言語吹き替え
個人でYouTubeチャンネルを持つDrew Binskyさんは、2024年6月、ElevenLabsのDubbing Studioでスペイン語、ポルトガル語、アラビア語、ドイツ語、イタリア語の音声を付けて動画を公開しました。YouTubeのMulti-Language Audioを使っています。
The results were clear: dubbed videos drew in up to 1 million extra views from non-English-speaking regions for mature videos (17% of total views) and already make up a significant share of views for newer videos with 300k views (23% of total views) of a total 1.3M views to date.
(和訳)結果は明確でした。吹き替えた動画は、公開から時間が経ったものでは、英語以外の地域から最大100万回の追加再生を集め(総再生の17%)、新しい動画でも30万回再生のうちすでにかなりの割合を占めています(総再生の23%)。その時点の合計は130万回です。
出典: ElevenLabsブログ(2024年11月4日公開・2026年9月16日更新)
Vimeoは、ElevenLabsの吹き替えを自社に組み込みました。お客さんが動画を複数の言語へ吹き替えています。AI LeadのAlberto Parravicini さんの言葉です。
Since we brought ElevenLabs dubbing into Vimeo, our customers have dubbed more than 1.4 million minutes of video into dozens of languages.
(和訳)ElevenLabsの吹き替えをVimeoに入れてから、お客さんが吹き替えた動画は140万分を超え、言語は数十に及びます。
出典: ElevenLabsブログ(2026年9月7日公開・9月20日更新)
小さな事業で真似するなら。Drew Binskyさんの形は、投稿者が追加の音声トラックを足すやり方で、個人チャンネルでできます。Vimeoの形は動画プラットフォームへのAPI組み込みで、ページの数字はVimeoの顧客全体のものです。
11. 話すアバター動画
DeepBrain AIは、AI Studiosで、写真のように見えるアバターと音声合成で動画を作ります。ElevenLabsを主要な音声合成として組み込み、用途に教育、企業の連絡、メディアを挙げています。CEOのSeyoung “Eric” Jangさんの言葉です。
With over 2,000 new custom avatars launched and powerful new API features rolling out, AI Studios is scaling faster than ever. Having ElevenLabs as our TTS partner gives us the confidence to localize globally without sacrificing quality or emotion. It’s an essential part of our stack.
(和訳)2,000を超える新しいカスタムアバターを出し、新しいAPI機能も展開する中で、AI Studiosはかつてなく速く広がっています。ElevenLabsを音声合成のパートナーにしているので、品質や感情を落とさずに世界へローカライズできる、と自信を持てます。私たちの基盤に欠かせません。
出典: ElevenLabsブログ(2025年7月16日)
小さな事業で真似するなら。短い動画からアバターを作り、音声を当てて研修・社内連絡・対外動画にする、とページにあります。2,000体はDeepBrain側の規模で、小さな店の件数ではありません。
12. 製品に入った音声合成
Googleは、2026年9月23日、Geminiの音声合成モデルを2つ公開し、Gemini NotebookとGoogle Vidsで使えるようにしました。この記事で聴き比べたGemini 3.8 Flash TTSとFlash-Lite TTSの発表記事です。
Today, we’re introducing two new text-to-speech models to the Gemini family, transforming voice generation from static presets into a dynamic creative studio. These models enable creators, developers, and enterprises to create richer, more expressive audio experiences, while enabling improved user experiences in products like Gemini Notebook and Google Vids.
(和訳)本日、Geminiファミリーに2つの新しい音声合成モデルを紹介します。音声生成を、決まった声のプリセットから、動かす制作の場に変えます。作り手、開発者、企業が、より表現のある音声を作れるようにし、Gemini NotebookやGoogle Vidsのような製品の使い心地も上げます。
出典: Google公式ブログ(2026年9月23日)
小さな事業で真似するなら。Gemini NotebookとGoogle Vidsの中で音声を作れる、とページにあります。特定の1社の導入事例ではなく、製品への搭載です。
13. 学習アプリの音声講師
Brilliantは、画面を見ながら問題を一緒に解く音声講師Kojiを出しました。声は、デザイナーが試作で読んだ録音とスタジオ作業を混ぜ合わせたもの、とページにあります。Chief Content OfficerのBlake Farrowさんの言葉です。
Gemini handled math notation beautifully, but occasionally hallucinated its lines. Koji confidently saying ‘nine’ when he should have said ‘five’ is catastrophic in a tutoring context.
(和訳)Geminiは数式の表記をうまく扱いましたが、せりふを時々幻覚しました。Kojiが「5」と言うべきところで自信たっぷりに「9」と言うのは、学習の場では破滅的です。
出典: ElevenLabsブログ(2026年5月29日公開・9月22日更新)
小さな事業で真似するなら。数か月かけて音声を比べ、社内の声を整えて講師にした、とページにあります。個人の店が同じ検証をする手順はページにありません。
14. 講師の声での対話
MasterClassは、講師の人となりが乗った声で対話するOn Callを提供しています。講師はGordon Ramsayさん、Mark Cubanさん、Chris Vossさん、Dr. Matt Walkerさん。音声はElevenLabsです。CPO & CTOのMandar Bapayeさんの言葉です。
The quality of the voice is like night and day. It is extremely critical for us to make sure that the personality of our instructors comes through in the voice – that means the pacing and tone needs to be right, and all of our instructor AIs should feel empathetic during the conversations. ElevenLabs delivered on all these attributes way above everyone else.
(和訳)声の質は別物です。講師の人となりが声に出ることが、私たちには極めて重要です。つまり、間と調子が正しく、講師のAIは会話の中で共感があるように感じられる必要があります。ElevenLabsは、これらの点を他のどこよりも高く満たしました。
出典: ElevenLabsブログ(2026年1月15日)
小さな事業で真似するなら。著名講師の人となりを対話の声に載せる製品です。小規模な講座が同じ講師の声を出す手順は、ページにありません。
15. 読み手を選ぶオーディオブック
Storytelは、聞き手がオーディオブックの読み手の声を切り替えられるVoice Switcherを、ElevenLabsの声で出しました。スウェーデンで2024年初めに始め、デンマークとフィンランドへ広げた、とページにあります。CPTOのJohan Ståhleさんの言葉です。
We were blown away by the quality. We had been interested in AI voices for a long time but they weren’t as good as what we saw from ElevenLabs.
(和訳)品質に驚きました。AIの声には長く関心がありましたが、ElevenLabsで聞いたものほどの出来ではありませんでした。
出典: ElevenLabsブログ(2026年5月27日公開・9月22日更新)
小さな事業で真似するなら。配信カタログの読み手を切り替える機能です。ページはStorytelの国ごとの展開で、個人商店が同じ切替を持つ話はありません。
17件のうち、小さな事業でそのまま真似できる形が11件、難しい形が6件でした。真似するなら、できる側から。手元にある原稿に近い形を1つ選んでみてください!
私が考える使い道。アナログなところにこそ、音声AI
ここからは、私の考えです。読み上げやポッドキャストは、文章を声に変える使い方でした。その先に、声で「やりとりする」使い方があります。
1つ目は、ゲームです。ゲームの中で、子どもたちがAIと声で対話する。文字を打つのではなく、話しかけて、声で返ってくる。
2つ目は、電話です。年配の方には、画面ではなく声で、AIが電話で応対する。
どちらも、まだアイデアの段階です。私がやっているわけではありません。で、共通しているのは、入口が画面や文字ではなく、声だということです。アナログなところにこそ、音声AIがうまく活用できるとよさそうだと思います。
ただし、くれぐれも悪用厳禁です。声のクローンは、本人の同意がある声だけに使います。他人の声を勝手に作らず、誰かになりすまして使わない。ElevenLabsも、利用規定でこう書いています。
Do not engage in unauthorized, deceptive or harmful impersonation.
(和訳)許可のない、人を欺く、または害をおよぼす、なりすましをしないこと。
出典: ElevenLabs Prohibited Use Policy(2026年8月17日更新)
同意のある声を、同意のある使い方で。ここを守って初めて、チャンスになります。
あなたが今日やるなら。台本1分を各モデルで作って、耳で決める
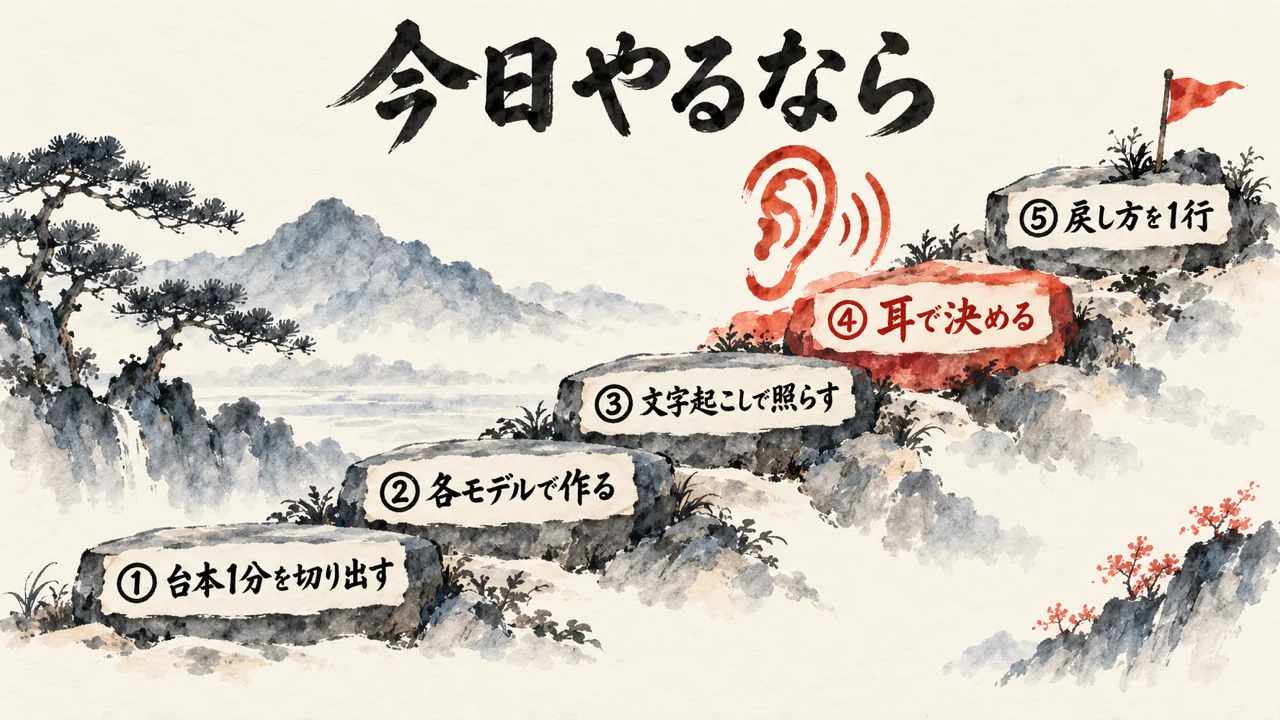
乗り換えを考えている方に、私がやった順番をそのまま渡します。難しい道具は要りません。
- いま公開している動画から、台本1分(400〜450文字)を切り出す。今の音声はもうあるので、新しく作らない。
- 候補のモデルで、同じ台本を作る。ElevenLabsなら同じ声で。Geminiなら自分の声を登録してから。
- できた音声を文字起こしにかけて、台本と照らす。崩れた行を数える。
- 音声と崩れた行を1ページに並べて、通しで聴く。ここだけは自分の耳で決める。
- 決めたら、替える前に戻し方を1行で用意する。
私の場合、ここまでで分かったのは「別会社に乗り換えなくても、同じ会社の新しい版で半分になる」でした。
でも、替えるのは料金だけじゃない。声も、辞書も、台本の書き方も一緒に替わる。その数を先に数えてから、耳で決めてみてください!
よくある質問
Q. ElevenLabsとGemini 3.8 TTS、結局どちらが安いですか?
A. 2026年の間はGeminiが安いです。日本語ナレーション1時間で、Gemini 3.8 Flash-Liteは0.54ドル(約85円)、ElevenLabs v4 Turboは割引中で0.29ドル(約46円)、割引が終わると1.04ドル(約163円)です。2027年1月にGeminiの音声単価が倍になると、Flash-Liteは1.08ドル(約170円)で、v4 Turboとほぼ同じになります。そのうえで、5本を実際に全部聴いて体感して選び取った結果、コストパフォーマンスが良いのはv4 Turboでした。品質は十分で、Geminiより好みでした。
Q. 自分の声のクローンは、Geminiでも作れますか?
A. 作れます。私もGoogle側に自分の声を保存して、今回の聴き比べに使いました。ただし保存した声は1年で期限が切れ、1プロジェクトに200声までという上限があります。ElevenLabsで作った声は、そのままGeminiには持ち込めません。
Q. v4とv4 Turboの違いは何ですか?
A. v4 TurboはElevenLabs v4の安い版で、通常価格が1,000文字あたり0.04ドル(約6.3円・v4は0.08ドル(約13円))です。今回の9行では、文字起こしの一致率はどちらも0.93で差がありませんでした。5本を実際に全部聴いて、体感して選び取った結果、コストパフォーマンスが良いのはv4 Turboでした。v4はTurboでも品質は十分でした。
Q. 台本の感情タグは、Geminiでも使えますか?
A. 形式が違います。ElevenLabsは [surprised] のようなタグを重ねて使います。Geminiは <sigh> や <short pause> のようなタグと、「cheerful and friendly」のような話し方の指定を使います。今回の聴き比べでは、台本のタグをGemini用の指定に置き換えて渡しました。
Q. 文字起こしでの一致率は、どれくらいなら合格ですか?
A. 私は0.75未満を「怪しい行」として止めています。1.00でなくてよいです。「ぜんぶ」と「全部」のような書き方の違いでも下がるので、5本で同じ値の行は無視して、1本だけ低い行を耳で確かめます。
Q. 低価格なTTSで何から始めるのがおすすめですか?
A. いま手元にある文章を、10分以内の音声に1本変えるところからです。講座の台本、ブログ記事、メルマガのどれでもよいです。10分は約4,330文字で、ElevenLabs v4 Turboの通常価格なら0.17ドル(約27円)です。私は講座動画のナレーションで使っていて、分身AI日記では記事を声に変えて公開しました。06章に、国内外17件の実例を出典付きで載せています。
まとめ。乗り換える前に、同じ会社の新しい版を耳で確かめる
ElevenLabsからGemini 3.8 TTSへの乗り換えは、2026年の間は料金で得です。2027年からは、ElevenLabs v4 Turboとほぼ同じ水準になります。
乗り換えると、声・感情タグ・掛け合いの作り方・読み上げのコードの4つが変わります。同じ会社の新しい版なら、変わるのは1行です。
私は同じ台本9行を自分の声で5本作り、文字起こしで照らして、実際に全部聴きました。体感して選び取った結果、コストパフォーマンスが良いのはv4 Turboでした。v4はTurboでも品質は十分で、Geminiより好みでした。1時間2.08ドル(約327円)が1.04ドル(約163円)になりました!
1分433文字と、1,000文字0.04ドル(約6.3円)。この2つで、ポッドキャストもブログの音声版も計算できます。10分で0.17ドル(約27円)です。
国内外17件の事例も、種類ごとに引用付きで載せました。小さな事業でそのまま真似できる形は11件です。
私が考える使い道は、ゲームの中で子どもたちがAIと声で対話すること。年配の方には、AIが電話で応対すること。アナログなところにこそ、音声AIです。くれぐれも悪用厳禁で、声は本人の同意がある声だけを使います。
使う人がよくて、受け取る人がよくて、世の中もよくなる。三方よしの使い方なら、音声AIは競争の道具ではなく、共創の道具になります。競争より共創。これが、この記事のメッセージです。
戻し方も1行で用意してあります。あなたも、台本1分から始めてみてください!
COLUMN
ひろくんコラム。調べるのはAIに、決めるのは耳に
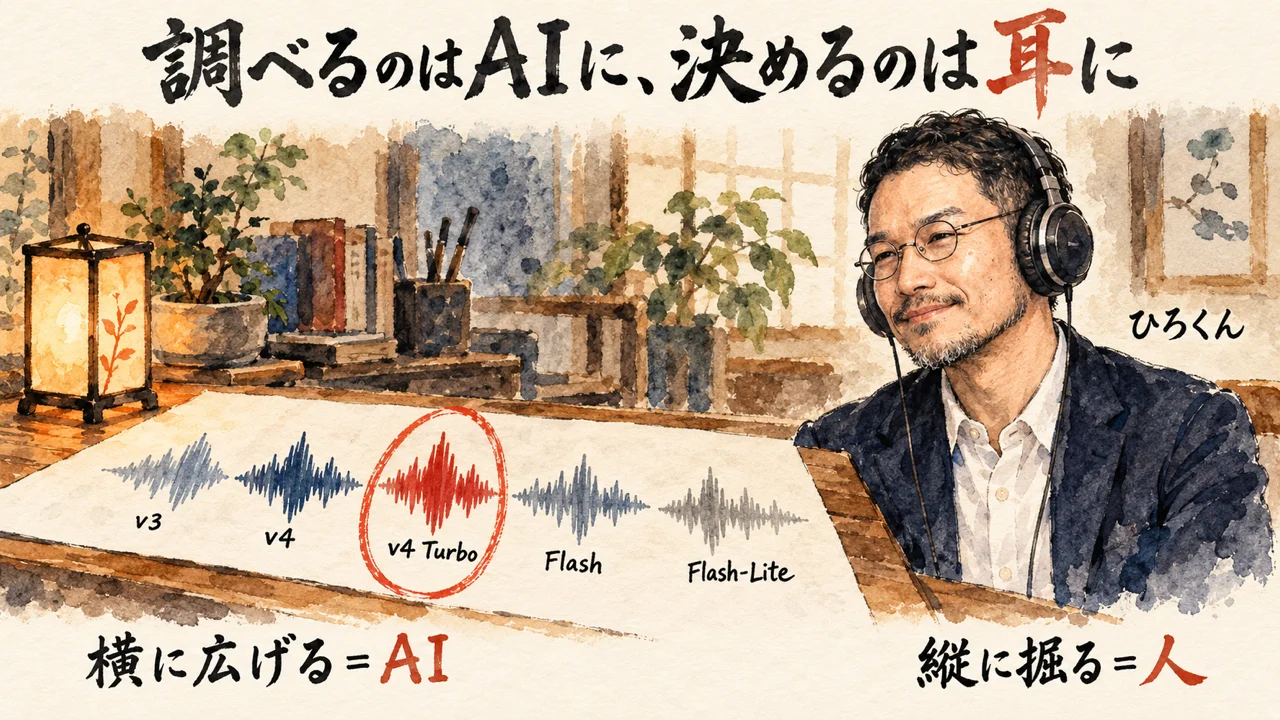
今回の調べものは、AI秘書の凛ちゃんに任せました。GeminiのTTSに切り替えるメリットとデメリット、料金も含めて調べてもらいました。
返ってきたのは、公式の単価と、自分の講座動画から測った1時間あたりの文字数と、5本の音声でした。
私がやったのは、5本を通しで聴いて、一番を選ぶことだけです。表を作るのも、文字起こしで照らすのも、設定の漏れを8ファイル直すのも、AIの仕事にしました。
人間は縦に掘る。AIは横に広げる。今回で言えば、横に広げた5本の中から、縦に1本を掘るのが私の役でした。
記事を声に変える仕組みは、分身AI日記の「分身AIが記事を声に変えた、リパーパスの裏側を全公開」で書いています。
あの頃から台本は23パートに分けて、パートごとに感情のタグを付けていました。
5本を実際に全部聴いて、体感して選び取ったのは私。コストパフォーマンスが良いのはv4 Turboでした。調べと点検は、AI秘書の凛ちゃんです。
声のAIは、使う人・受け取る人・世の中の三方よしで使いたい。競争より共創で、声のAIもその使い方で広げていきたいと思います。
👉 AIに任せる範囲と、自分に残す判断の話は、分身AI.comもチェックしてね!
関連記事
ElevenLabsの新音声モデルをニュースとして紹介した回
Gemini 3.8 Flash TTSが出た日のニュース。今回の乗り換え検討の出発点
声で聞く場面と文字で読む場面の分け方を話した回
参考リンク
v3・v4・v4 Turboの1,000文字あたりの単価と、10月12日までの72%引きの記載
Gemini 3.8 Flash TTS / Flash-Lite TTSの単価、2027年1月1日の値上げ、1秒=25トークンの記載
対応言語数、既製の30声、2人までの掛け合い、保存した声の1年期限と200声の上限、タグの例
記事の円換算に使った1ドル=157円の出どころ(2026年9月29日の参考レート)
v4の発表(2026年9月28日)。日本語の品質向上、10秒でのクローン、タグの重ねがけ
地域番組のナレーション。06章で引用
広報・教材のナレーション。06章で引用
患者向け説明の音声。06章で引用
学校テストの読み上げ。06章で引用
ニュースの音声配信。06章で引用
ニュースの音声配信。06章で引用
本人の声色のオーディオブック。06章で引用
資料からのAI音声対談。06章で引用
失った声の復元。06章で引用
動画の多言語吹き替え。06章で引用
動画の多言語吹き替え。06章で引用
話すアバター動画。06章で引用
製品に入った音声合成。06章で引用
学習アプリの音声講師。06章で引用
講師の声での対話。06章で引用
読み手を選ぶオーディオブック。06章で引用
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 金 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 土 | 7:00〜7:30 | ただっち | 愛紗さん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜のLIVEは無料視聴、7:30〜のZOOM LIVEは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!