READ REPORT
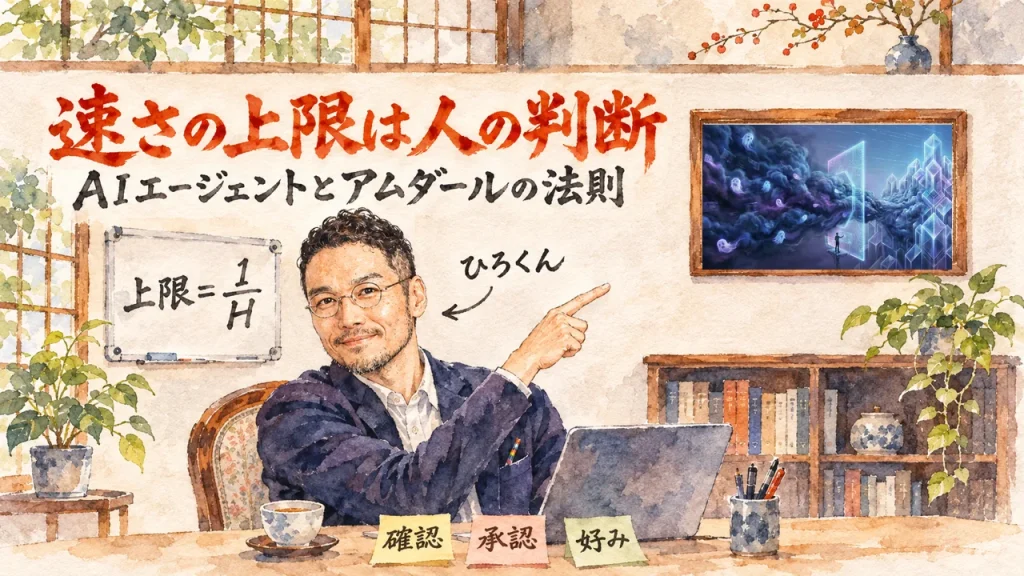
アムダールの法則とは。AIエージェントの速さの上限が人の判断で決まる理由を整理
2026年11月17日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回紹介するのは、私がブックマークした、ElectricSQLのKyle Mathewsさんの英語記事「Amdahl’s law for AI agents」です。2026年2月19日に公開された記事で、2026年11月17日に全文を読みました。
保存した理由は、AIエージェントを増やしても速くならない理由を、1967年の法則で説明している記事だったからです。ClaudeやChatGPTに仕事を任せはじめたあなたが、エージェントを増やす前に何を見ればいいのか。そこを整理したいと思いました。
読む順番は、アムダールの法則、AI版の1/H、自己清算、溜めて圧縮、適合テストの実例、並列と待ち行列、再発率と鋸歯の7つです。
AIエージェントを増やせば仕事は速くなる。そう考えるのは自然です。でも元記事は、速さの上限はエージェントの数ではなく、人の判断が要る割合で決まると書いています。この記事では、その筋を7つの章で順に整理します。
3行でわかるポイント
- 速さの上限は1/Hで、Hは人の判断が要る割合です。元記事によると、Hが40%なら2.5倍、10%なら10倍が上限になります。
- 人が手を入れるたびにテストや仕様を残して、同じ介入を要らなくするのが自己清算です。溜まったら、定期的に圧縮します。
- 並列を増やすと、人のレビューが待ち行列の窓口になります。見る指標は再発率で、Hは鋸歯のように上下する、と元記事は書いています。
ElectricSQLの共同創業者Kyle Mathewsさんが2026年2月19日に公開した英語のブログ記事。1967年のアムダールの法則をAIエージェントに当てはめ、速さの上限は人の判断が要る割合Hで決まること、人の介入を自己清算にする考え方、溜めて圧縮する循環、待ち行列、再発率が書かれている。2026年11月17日に全文を読んだ
アムダールの法則とは。AIエージェントを増やす前に知っておきたい、速さの上限の考え方
N(並列に動く処理装置の数)を無限に増やしていくと、速くなる倍率は1/Sに近づいていきます。仕事の10%が本質的に順番にしかできないなら、どれだけ並列にしても10倍は超えられません。
引用が言っているのは、こういうことです。仕事の中に順番にしか進められない部分があると、並列(同時に何本も進めること)で増やしても、その部分が速さの天井になります。
元記事の冒頭は、複数のAIエージェントを同時に動かす仕組みが、実際に成果を出している話です。
Geoffrey Huntleyさんの「Ralph Loop」は、要件書(PRD)の項目が全部終わるまで、コードを書くエージェントを自動で回し続けます。
whileループ、つまり終わるまで繰り返す仕組みです。
Steve Yeggeさんの「Gas Town」は、7つの役割に分けた20〜30体のエージェントを同時に動かします。Cursorは、8体のエージェントを並列に動かす仕組みを出しています。成果は本物です。
ただ、自動では付いてきません。Flaskの作者Armin Ronacherさんは、並列で走らせることはあるが前ほどではない、自分の頭でレビューできる量には限りがあるから、と話した。元記事はそう引いています。
そこで元記事が持ち出すのが、1967年のGene Amdahlさんの観察です。プログラムの速さは、順番にしか進められない部分の割合で頭打ちになる。式は、速さ=1/(S+(1-S)/N)。
Sが順番にしか進められない部分の割合、Nが同時に動く処理装置の数です。
大事なのは式より極限です。極限とは、Nをどんどん大きくした先の姿のこと。Nを無限に増やすと、速さは1/Sに近づきます。10%が順番にしか進まないなら、100個でも100万個でも10倍は超えません。
元記事は、これを並列化への反対ではなく、どこに力を入れるかの指針だと書いています。私は、エージェントを増やす話の前に、増やしても動かない部分を探す話なんだと受け取りました。
自分の仕事では、どこが順番待ちになりそうかな。
AIエージェント版のアムダールの法則とは。速さの上限は1/Hで、Hは人の判断が要る割合
AIエージェントで出せる最大の速さは、1/Hで頭打ちになります。Hは、仕事の流れのうち、人の判断が要る部分の割合です。
引用が言っているのは、一点です。AIエージェントの速さの天井は、人の判断が要る割合で決まる。その割合を、元記事はHと呼んでいます。Hが大きいほど、AIの手が止まって人を待つ時間が増えます。
Hに入るのは、人が止まる場面の全部です。意図の確認があります。管理画面とユーザー向けのどちらを指すのか、という確認です。お客様への対応を、どちらの形にするかという判断もあります。
ほかにも、やり直しのレビュー、承認の関所(承認を取るために止まる所)、曖昧さの解消が入ります。方針に「適切に対応する」とあれば、適切とは何かを決めるのは人です。
技術的には正しいけれど何か違う、という好みの判断も入ります。
数字は文で見ると分かりやすいです。元記事によると、Hが50%なら上限は2倍、30%なら3.3倍、20%なら5倍です。Hが40%なら2.5倍で、エージェントがどれだけ賢くなっても超えられません。
10%で10倍、5%で20倍です。
元記事は、速さを決めるのはエージェントの能力ではなくHだと書きます。ただ、アムダールのSは決まった値ですが、Hは動きます。この違いを、元記事は大事にしています。
よいモデルは確認や間違いを減らすので、Hの一部は縮みます。でも、規模が大きくなるといちばん大きな割合を占めるのは、好みと新しい判断です。そこは、モデルが良くなってもほとんど縮まない、と元記事は書いています。
だから問うのは、Hがどれだけ速く下がっているかと、下がった分を何に使うかです。私は、速さの上限を決めるのは、AIの賢さより、人を待たせている時間の中身だと思います。
あなたの仕事で、AIの手が止まって人の返事を待っている時間は、どこにありますか?
人の介入を自己清算にする。AIエージェントに同じ確認を2度させない仕組みの整理
人が介入するたびに、その成果物(テスト、仕様の更新、記録した判断)が残るようにします。それが、次に同じ種類の介入を要らなくしてくれます。
引用の中身は、手入れを形に残す、ということです。人が手を入れるたびに成果物を残せば、次に同じことで人が呼ばれなくなります。
元記事は、いちばん効く投資はエージェントを速く賢くすることではなく、Hの性質を変えることだと書きます。道具は新しくありません。テスト、仕様、自動化、記録した判断です。新しいのは見返りの大きさ。
エージェントが記録された判断に従って自分で動けるなら、1本のテストを書く価値は以前よりずっと大きい、という話です。
目標は、人の関わりを最小にすることではなく、自己清算にすることです。自己清算は金融の言葉で、返済の元手を自分で生む貸付のこと。
人の介入が、その介入自体を要らなくする成果物を生む、という意味で元記事は使っています。
Hが同じ40%でも、全部が好みと戦略の人と、全部が「XですかYですか」の確認の人では、立場がまるで違います。見分ける問いは「この介入は符号化できるか」。符号化とは、判断をテストや仕様の形に書き残すことです。
バグを見つけたら、テストケースにできるか。曖昧さを解消したら、仕様の更新にできるか。好みの判断をしたら、記録した前例にできるか。確認と検証は符号化しやすく、好みと新しい判断はいちばんしにくい。
そこに人の判断の価値があるので、それでいい、と元記事は書いています。
あ、同じ向きの話が、私の過去の記事にもあります。私は2026年10月8日の記事に、毎朝の自動便が、10月1日の私の答えを知らないまま10月3日に動いたと書きました。自動便は、毎朝自動で動く作業のことです。
毎回新しい作業として始まるので、2日前の答えが届かなかったんです。
AI氣道『ADRとは、決めた理由を残す記録。Obsidianでの作り方を飯塚浩也さんが解説』より
「10月4日、答えた決定を次の便に見せる「決定メモ」を作る案に、私は「この形で進める」と答えました。いまは、ボタンで選んだ直近10件の決定が、新しい便の最初に見えます。」
同じ答えを2度させないために、答えを書き残す。元記事の「介入のたびに成果物を残す」と、向きが同じだと思います。
溜めて、圧縮する。AIエージェントの指示書やテストは、足すだけでも圧縮だけでも保てない
溜めるだけのチームは、ずれと矛盾を抱えることになります。圧縮だけをしようとするチームは、最初に作り込みすぎます。この循環には、両方が要ります。
溜めるだけでも、圧縮だけでも足りない。引用は、その両方が要ると言っています。
元記事は、介入を片っ端から足すだけだと別の問題が出てくると書きます。例は、矛盾する注意書きが400行もあって誰も読まないAGENTS.mdです。
AGENTS.mdとは、AIエージェントに読ませる指示書のこと。重なり合って食い違うテストの山も同じです。生の蓄積はノイズで、知識にならない、という言い方です。
本当の型は「溜めて、圧縮する」。個別の判断が溜まり、定期的に、まとまった上位の成果物に統合されます。判例法は事例を溜めて原則と法令に、科学は論文を溜めてレビュー論文と教科書にまとめる、と元記事は例えています。
実務では、介入のたびに小さな成果物を残します。テストケース、AGENTS.mdの1項目、決定の記録。それを定期的に、仕様や整理したテストへまとめ直します。
圧縮は、前提がまだ正しいかを問う場でもあります。同じ前提の40の変種を符号化した40のテストが並ぶなら、前提そのものが間違っていないかを確かめる場だ、と元記事は書きます。
レバーは2つです。信号を拾うことと、configurancyを高く保つこと。バグを見つけたレビューがテストを更新しないなら、信号の無駄です。
configurancyは元記事の言葉で、仕様・不変条件(どんな時も守る約束事)・適合テスト(仕様どおり動くかを確かめる自動テスト)・理由の記録が明示されている度合いです。
あ、溜めては減らす話は、私の過去の記事にもあります。私は2026年11月9日の記事に、AIに最初に読ませる入口ファイルMEMORY.mdの大きさの往復を書きました。
AI氣道『AIエージェントの記憶は足し続けるより、何を残すかを人が決めて減らす』より
「で、5月で終わりではないんです。10月7日に自分の記事のために測ると33,157バイトに戻っていて、今日(2026年11月9日)は16,029バイト・147行。その記事には「方針を書くだけでは、短くは保てていません。」と書いています。数字は、戻っては減るを繰り返しているんです。増えて、減って、また増える。」
2026年5月に74,442バイト・200行だった入口ファイルを、索引に作り直して10,853バイト(85.4%減)にしました。引用のとおり、そのあと一度戻っています。バイトは、ファイルの大きさの単位です。
減らして終わりでも、足し続けて終わりでもない。溜めては圧縮する循環が要る、という元記事と向きが同じだと私は受け取りました。
足場の実例。適合テストがレビューそのものになると、67ファイルの変更も数分で見られる
それが無ければ、10の言語にまたがる、何時間もの丁寧な手作業の確認になります。それがあったので、私がPR(変更の提案)を見るのに使ったのは数分でした。
適合テストがあるかどうかで、人が見る手間が何時間と数分に分かれた、という話です。引用はそのことを言っています。
舞台はElectricSQLです。元記事によると、エージェントがプロトコルの変更を67ファイルに反映しました。プロトコルは、プログラム同士が通信するときの取り決めのこと。
反映先は、仕様、2つのサーバー実装、10の言語にまたがる10のクライアントライブラリです。かかったのは20〜30分でした。
67ファイルを人が見たわけではない、と元記事は書きます。適合テストがレビューそのもの、という言い方です。適合テストは、仕様に照らして動作を確かめる自動テスト群のこと。
Kyle Mathewsさんは、PR(変更の提案)を見るのに数分を使ったと書いています。
人がプロトコルの変更を設計し、下流の作業は適合テストが確かめた。しかも、新しい正しさの判断がテストケースに変わるので、次の変更はさらに自律的になる、とも書いています。
別の例が、Emil Stenströmさんです。元記事によると、html5lib-testsという公開の適合テストを最初から繋いで、エージェントでHTML5パーサーを作りました。
パーサーは、HTMLを読み解く部品のこと。
そのあと、Simon Willisonさんが同じテストに別のエージェントを向けて、4時間半でJavaScriptへ移植した、と元記事は書きます。
仕様が実行できる検証として符号化されていたから、人のレビューが要らなくなった、という説明です。
元記事のまとめは、モデルが仕事を担当し、configurancyが信頼を担当する、というもの。
「モデルを選んでプロンプトを書く」で止まるチームはすぐ頭打ちになり、速くなったチームは足場に多くの手間をかけている、とも書いています。
足場とは、エージェントが迷わず動けるように先に組んでおく、仕様やテストの枠組みのことです。
私は、足場は人のレビューをなくす装置ではなく、人のレビューを仕様の側へ移す装置だと受け取りました。
並列を増やすと遅くなる理由とは。人は待ち行列の窓口の1台で、稼働率が上がると待ちが跳ね上がる
稼働率が50%なら、待ち行列は何とかなります。80%では4倍の長さになります。90%では9倍、95%では19倍です。
稼働率は、窓口がふさがっている時間の割合のこと。それが上がるほど、順番待ちの列は急に伸びる。引用は、その伸び方を示しています。
元記事は、エージェントが速くなるとHはむしろ大きく感じられる、と書きます。調べるのに2時間かかるなら、30分のレビューは気になりません。でも30秒で終わるなら、同じ30分で人が詰まりの原因になります。
Donald Reinertsenさんは、『The Principles of Product Development Flow』で待ち行列の理論を使っています。稼働率が上がると行列が急に長くなる、と示しました。
人のレビューは、この行列の窓口1台です。5体を並列にすると到着が5倍になり、待ち時間は限りなく延びる、と元記事は書きます。
Gas Townの利用者は、3時間で5件だったPR(変更の提案)が4時間で36件になりましたが、途切れない強い集中が要ったそうです。
元記事が示す処方は、稼働率を最大にするのではなく、行列そのものを管理することです。仕掛かりの上限(同時に抱える作業数の上限)、小さな単位、速いフィードバック。
エージェントなら、人でつかえる摩擦を無くして、自分で検証できる足場を作る。そうすれば人に来るのは、本当に判断が要る時だけになります。
Ralph Loopが効くのも、並列だからではなく自己清算の仕組みだからだ、と元記事は書きます。仕様としてのPRD、受け入れ基準としての自動テスト、型を溜めるAGENTS.md。
shadcnさんは、セッションのたびに/doneというスキル(エージェントに覚えさせる手順)を回します。決定と疑問と次の宿題をmarkdownに書き出すそうです。
あ、この向きは私の記事にも書いています。
AI氣道『AIエージェントに仕事を任せる前に、その工程が要るかを見直す手順を整理する』より
「私なら、止める所は外に出る直前に絞ります。途中の工程を一つずつ止めて確かめていたら、確かめる仕事がまた人の手に戻ってくる。任せた側に返ってくるのは、終点まで運んだ成果か、本当に人が決めるべき判断だけ。その責任まで含めて渡す形にします。」
毎回の確認が人に戻ってくる形だと、人が行列の窓口に立ち続けることになります。止める所を外に出る直前に絞るのは、窓口に並ぶ列を短くする考え方だと私は読みました。
見る指標は再発率。AIエージェントを使うほどHは下がり続けず、鋸歯のように上下する
摩擦を符号化(テストや仕様などの形に書き残すこと)するとHは下がり、もっと難しい問題に挑むとHは上がります。新しい摩擦を書き残すとまた下がり、そしてまた上がります。
摩擦を書き残すとHは下がり、難しい仕事に挑むとまた上がる。引用は、その上下の動きを言っています。書き残すとは、テストや仕様の形にする符号化のことでした。
元記事が提案する指標は、再発率です。同じ種類の人の介入が、2度起きる頻度のこと。トヨタの不良の追跡と同じ考え方で、見つけた数ではなく、同じ種類の不良が減っているかを見ます。
減っていればシステムは学んでいて、横ばいなら同じ人の手間を払い続けている、という整理です。
元記事の中心の主張は、AIがコードを作りやすくするので、希少なのはシステムの自己知識になる、というものです。仕様を変えればエージェントが実装に広げ、適合テストが正しさを確かめる。
Hを減らす作業そのものが、作りやすくなったんです。
そこから、はずみ車が回ります。はずみ車は、一度回ると勢いが続く仕掛けのこと。判断を符号化しやすくなり、成果物が将来の介入を減らし、再発が減ってエージェントの1回あたりの価値が上がる。
それがさらに投資する理由になる、という流れです。
ただ、Hは一直線には下がりません。Hを40%から20%に下げたチームは、同じ機能を5倍の速さで出すのではなく、以前なら考えられなかったプロトコルの再設計に挑む、と元記事は書きます。
そこで新しい好みと戦略の判断が出て、Hがまた上がります。
元記事はこれを、認知版のジェボンズのパラドックスと呼びます。効率が上がると、かえって全体の仕事の量が増える現象のこと。健全な姿は、Hがゼロに向かって減り続けることではなく、鋸歯です。
のこぎりの歯のように、下がって、上がって、また下がる。一周ごとに、より高い水準で動きます。
いちばん低いHのチームではなく、鋸歯をいちばん速く回すチームが積み重ねる、と元記事は結びます。最後の問いは、人がシステムに触れた時、次の触れ方を要らなくする何かをシステムは学ぶか、です。
私は、一人で会社をやっている人にも使える問いだと受け取りました。あなたが今日AIに頼んだ同じ確認を、明日もまた口で言うことになりそうか。そこを見るのが、再発率の読み方の入口です。
読んだあと、AIに任せた仕事で人が待たせている確認を整理したい人へ
AIに任せた仕事で、人の確認を仕分けて、最初に書き残す1つを決めるプロンプト
枠の中にこの記事のURLが入っていて、AIが記事を読んでから、状況を聞き取り、人の介入の仕分け、最初に書き残す1つ、確かめ方にまとめてくれるプロンプトです。読んで終わりにせず、自分の環境ですぐ使える追加のプロンプトまで手元に残せます。
1
人の介入の仕分け
任せている仕事のうち、人が毎回確認している所を、書き残せば要らなくなる物・部分的に書き残せる物・人に残す物に分けて返します。
2
最初に書き残す1つ
4つの質問に答えると、最初に書き残す1つと、書く場所が返ってきます。
3
確かめ方と、追加のプロンプト
同じ介入が2度起きていないかの確かめ方と、記事のURL入りのプロンプトを1〜3本、そのまま貼れる形でつくります。
AIの答えは下書きとして受け取り、任せ切りにせず自分の目で読み直す前提です。使ってみたい時だけ、下のボタンから使い方と依頼文を開いてください。
▶ タップしてプロンプトを開く
下の枠の文を丸ごとコピーして、手元のAIエージェントに貼ってください。枠の中には、この記事のURLが入っています。記事を読んだAIから、短い質問が4つ、1つずつ届きます。
返ってきた結果は、そのまま信じず、自分の目で読み直してください。何を書き残し、何を人に残すかを決めるのは自分です。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
https://ai-kidou.jp/(公開後のURL)
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、下の記事の要点だけを材料にしてください。

【参照元(先に読む)】
https://electric.ax/blog/2026/02/19/amdahls-law-for-ai-agents
ElectricSQLのKyle Mathewsさんが2026年2月19日に公開した英語のブログ記事「Amdahl's law for AI agents」です。2026年11月17日に読んだ時点の内容です。読めた場合は、記事の記述と下の要点が合っているか確かめてください。

【目的】
私がAIに任せている仕事のうち、人の判断が要る部分(その部分が仕事全体に占める割合を、元記事はHと呼びます)の中身を仕分けします。そのうえで、同じ種類の人の介入を2度しないために、何を書き残すかを決め、私の環境で使える追加のプロンプトをつくります。

記事の要点
・AIエージェントで出せる最大の速さは、1/Hで頭打ちになる。Hは、仕事の流れのうち、人の判断が要る割合。確認、判断、やり直しのレビュー、承認、曖昧さの解消、好みが入る。
・Hは動く。よいモデルは確認や間違いを減らす。ただし、規模が大きくなると残るのは、好みと新しい判断。
・いちばん効く投資は、人の介入を自己清算にすること。介入のたびに、テスト、仕様の更新、記録した判断などの成果物を残し、同じ種類の介入を次から要らなくする。問いは「この介入は符号化できるか」。
・介入は、溜めてから圧縮する。溜めるだけだと、矛盾する注意書きや重なったテストの山になる。定期的に仕様や整理したテストへまとめる。
・見る指標は再発率。同じ種類の人の介入が、2度起きる頻度。
・Hは一直線には下がらない。下げた分、人はより難しい問題に挑むので、Hはまた上がる。上下を繰り返す。
・書き手(ひろくん)の考え: 同じ答えを2度させないために、答えを書き残す。

【やってよいこと】
1. 記事を読んだあと、次の4つを1つずつ質問してください。答えが返ってから次の質問へ進んでください。
 ・今、AIに任せている仕事は何か。その中で、人が毎回確認している所はどこか
 ・同じ確認や同じ指示を、2回以上言い直した場面はあるか。あれば、その内容
 ・今、判断や決めたことを書き残している場所はあるか(メモ、指示書、手順書など)。あれば、いつ書き足して、いつ整理しているか
 ・人に残したい判断は何か(好み、最終の確認など)
2. 答えをもとに、人の介入を3つに仕分けた一覧を返してください。(a) 書き残せば次から要らなくなる介入 (b) 部分的に書き残せる介入 (c) 人に残す介入。決めるのは私です。
3. (a)のうち最初に書き残す1つを選び、何をどこに書くかの案を、一行ずつの箇条書きにしてください。実行するのは私です。
4. 私の環境で、そのまま貼って使える追加のプロンプトを、1〜3本つくってください。記事のURLを、各プロンプトの中に入れてください。

【守ること】
・設定の変更、削除、送信、購入、公開、インストールは行わないでください。ここでは、聞き取りと整理だけです。
・パスワード、鍵、口座の情報、個人情報、お客様の情報は求めないでください。貼られても使わず、消すよう伝えてください。
・記事の内容は、元記事が書いた記述として扱い、確かめられた事実とは書かないでください。
・分からない所は、推測で埋めずに未確認と書いてください。
・材料は、上のURLの記事と記事の要点、私の答えだけにしてください。記事に無い数字・効果・手順を足さないでください。追加のプロンプトに足してよいのは、私の環境に合わせた言い方と手順だけです。この依頼で禁じたことは、追加のプロンプトの中にも同じように書いてください。

【返す形】
(1) 人の介入の仕分け一覧 (a)(b)(c)
(2) 最初に書き残す1つと、書く場所
(3) 書き残したあとの確かめ方(同じ介入が2度起きていないか)
(4) 私の環境で使える追加のプロンプト(1〜3本)
(5) 未確認の点(分からなかった所を、推測で埋めずに書く)
最後に、私が自分の目で読み直したほうがよい所を1行で添えてください。よくある質問
Q. アムダールの法則とは何ですか?
A. 1967年にGene Amdahlさんが示した、プログラムの速さは順番にしか進められない部分の割合で頭打ちになる、という考え方です。元記事によると、10%が順番にしか進まないなら、並列の数を100個にしても100万個にしても10倍は超えません。
Q. Hとは何で、何が入るのですか?
A. 元記事は、仕事の流れのうち人の判断が要る部分の割合をHと呼んでいます。意図の確認、判断、やり直しのレビュー、承認の関所、曖昧さの解消、好みの判断が入る、と書いています。
Q. 自己清算する介入とは何ですか?
A. 元記事によると、人が介入するたびに、テストや仕様の更新や記録した判断を残し、次に同じ種類の介入を要らなくすることです。自己清算は、返済の元手を自分で生む貸付という金融の言葉から来ています。
Q. エージェントを増やしても速くならないのはなぜですか?
A. 元記事は、人のレビューが待ち行列の窓口1台になるからだと書いています。稼働率が上がるほど待ちは急に伸び、5体を並列にすると到着が5倍になって、待ち時間は限りなく延びます。
Q. 溜めるだけでは足りないのはなぜですか?
A. 元記事によると、介入を足すだけでは、矛盾する注意書きが400行も並ぶAGENTS.mdや、食い違う前提を含むテストの山になり、知識ではなくノイズになるからです。溜めてから定期的に圧縮する循環が要る、と書いています。
まとめ。AIエージェントを増やす前に見るのは、人の判断の割合と、同じ介入の再発
元記事の筋を、振り返ります。1967年のアムダールの法則は、順番にしか進められない部分が速さの上限を決める、という考え方でした。AIエージェントでは、その部分が人の判断が要る割合Hで、上限は1/Hです。
Hを減らす近道は、人の介入を自己清算にすることだと元記事は書きます。介入のたびに、テストや仕様や記録した判断を残す。溜まったら、定期的に圧縮する。私の過去の記事3本にも、同じ向きの記録があります。
並列を増やすと、人のレビューが待ち行列の窓口になります。稼働率が上がるほど待ちは急に伸びるので、増やす前に、人でつかえる摩擦を無くす足場が要ります。見る指標は再発率で、Hは下がり続けるのではなく、鋸歯のように上下する、と元記事は結んでいます。
同じ確認を2度させない、止める所を絞る、という問いは、一人の仕事にも持ち帰れます。エージェントを増やす前に、まず自分の手を止めている確認を数えてみる。そこが出発点かなと思います。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
Hを下げるとは、判断を渡せる形に教えること
本文では仕組みの話を整理しましたが、そこでは言い切れなかった気持ちが、ひとつ残っています。人の判断は、書き残して渡せるものと、書き残しにくいものに分かれるかな、と私は思っているんです。料理にたとえると、分量と手順はレシピに書けて、書いてあれば初めての人でも同じ味に近づけるのに対し、最後に味見して決める塩加減は、舌の上で決まるので書き残しにくい。あくまで私の考えですが、人の判断が要る割合H、つまりシステムが人の判断を待たないと進めない部分を下げるとは、判断をなくすことではなく、書き残せる判断を渡せる形に、先に教えておくことだと思っています。
AI氣道『AIに判断まで委ねるには、魂を込めて教える時間がいる。その時間は私の学びにもなりました』より
「自分らしく判断ができれば自分の代わりに判断する仕事も委ねることができる」
この向きは、私が『AIに判断まで委ねるには、魂を込めて教える時間がいる。その時間は私の学びにもなりました』で書いたことと重なります。判断を渡せる形にできれば、その判断を含む仕事まで、AIに任せていけるわけで、今回の話に引き寄せると、Hが小さくなるのは人がいなくなるからではなく、人の判断が先に言葉や手順になっているからなんです。ただ、その形にするには、頭の中で当たり前になっていて、普段は意識しない判断を一つずつ言葉にする、先に教える時間がかかります。どこか遠回りに見えますが、教えながら自分が何を基準に選んでいたのかに気づく時間にもなるので、私はその時間を損だとは思っていません。
今日から真似するなら、今週AIに2回言い直した確認をひとつだけ、小さなものでいいので選んで、なぜそうするのかの理由を1行つけ、次の依頼の最初に渡してみませんか。たとえば「見積書は送る前に私に見せて。取引先に出てしまうと取り消せないから」のように、手順だけで終わらせず、やることと理由をセットにして渡すんです。全部を整えなくても大丈夫で、まずは一つ渡せば、似た場面でAIが理由から考えて動きやすくなるので、同じ言い直しが減るかどうかを、来週の自分の目で確かめられるかな。言い直しは、理由を添えて最初に渡す。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
決めた理由を残す記録ADRと、Obsidianでの作り方を解説した記事です。
AIエージェントの記憶を足し続けず、何を残すかを人が決めて減らす話の記事です。
AIエージェントに仕事を任せる前に、その工程が要るかを見直す手順を整理した記事です。
参考リンク
この記事が整理した元の英語記事。1967年のアムダールの法則をAIエージェントに当てはめた内容が書かれている
第3章で引用した、答えた決定を次の便に見せる決定メモを作ったと書いた私の記事
第4章で引用した、入口ファイルの大きさが戻っては減る往復を書いた私の記事
第6章で引用した、止める所は外に出る直前に絞ると書いた私の記事
コラムで引用した、AIが自分らしく判断できれば判断する仕事も委ねられると答えた私の魂磨きの記事
今回紹介した記事
| 著者 | Kyle Mathews(ElectricSQL) |
| 媒体 | Electric(electric.ax)ブログ |
| 公開日 | 2026年2月19日 |
| 元URL | https://electric.ax/blog/2026/02/19/amdahls-law-for-ai-agents |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!