VIDEO REPORT
AIエージェントの記憶は足し続けるより、何を残すかを人が決めて減らす
2026.11.09
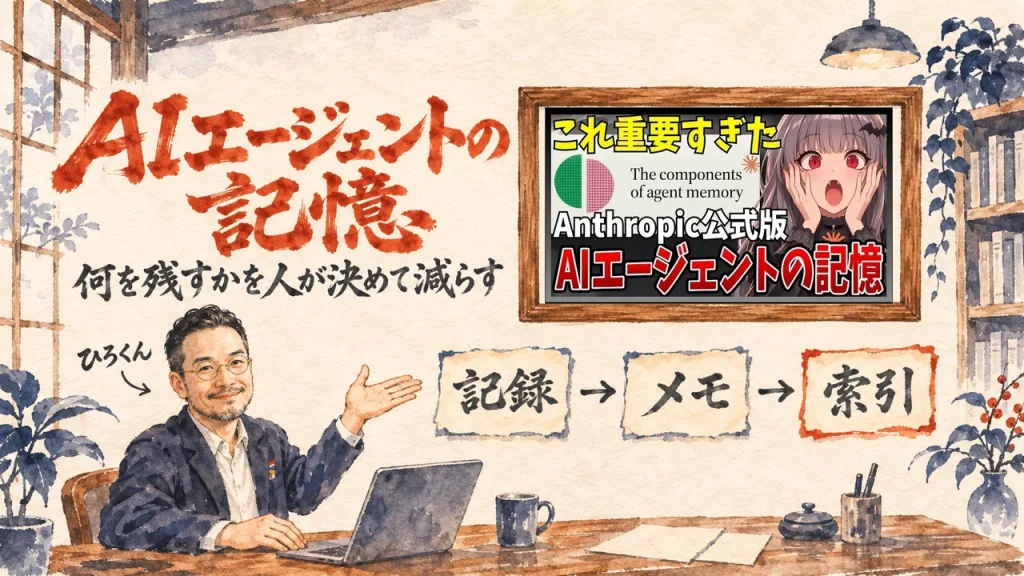
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、まさおさんのYouTubeチャンネル「まさおAIじっくり解説ch」の動画「【重要知識】Anthropicの語るAIエージェントの記憶を徹底解説!」を紹介するね。
AIに渡した説明書や記憶のファイル、増える一方になっていませんか?
この動画では、まさおさんが一人で、Anthropic Engineering Blogの記事「The components of agent memory」を、スライド26枚を使って解説しています。話の順は、記憶が4層に分かれるという整理とドリーミングから始まり、メモの持ち越しと正答率、手順で縛らないこと、量より何を残すか。そこから、ドリーミングが誤ったメモを直す話、Wikiの育て方と落とし穴へ進み、最後は先頭200行を索引にする運用で締めくくられます。
受け取ったのは、記憶は足し続けるより、何を残すかを人が決めて減らす、という入り口です。
私が自分の環境で確かめたのは、各章に出てくる6件だけ。元のブログ記事は私は開いておらず、それ以外の実験や数字は、まさおさんの話とスライドの整理として紹介していきます。
AIの「今」を毎日シェアしているコミュニティをやっています
GPTs研究会をのぞいてみる動画:まさおAIじっくり解説ch「【重要知識】Anthropicの語るAIエージェントの記憶を徹底解説!DreamingやLLM-Wikiなど重要概念も登場!」 YouTubeで観る
2026年9月15日の朝、私はまさおさんのnoteを参考に、記憶の仕組みの改善案をまとめてほしいとAIに頼みました。
AIが当時の環境を測りました。分かったのは、どこに何を聞けばいいかを示す1行が、どこにも無かったこと。取りに行く記憶はwikiに34件、メモの束に956件など、5か所に散らばっていました。毎回読まれる指示は29,373バイトで、MEMORY.mdは144行です。
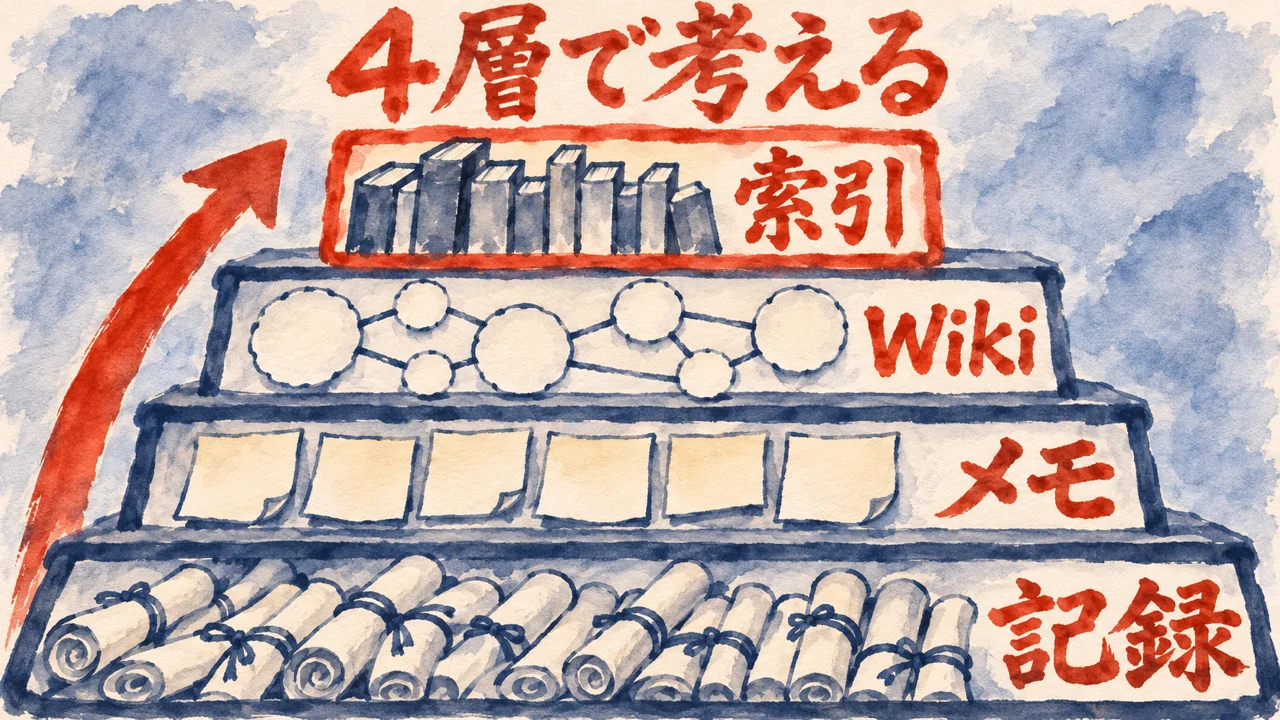
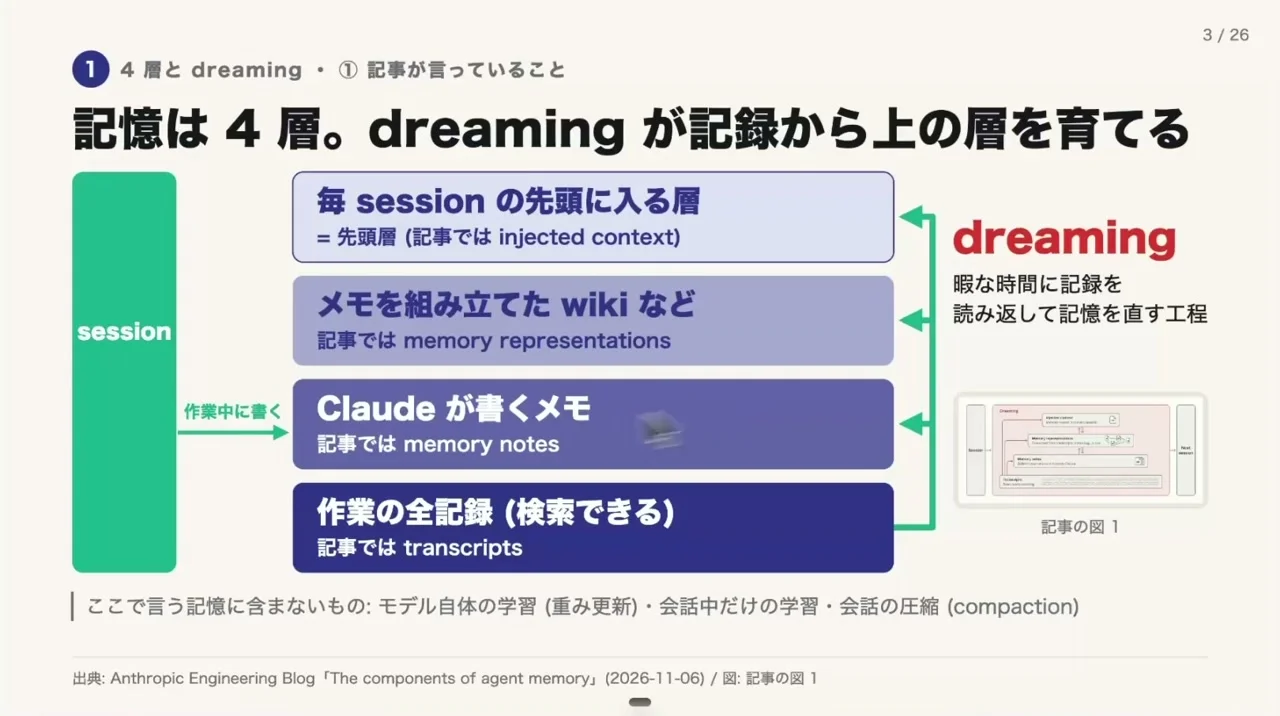
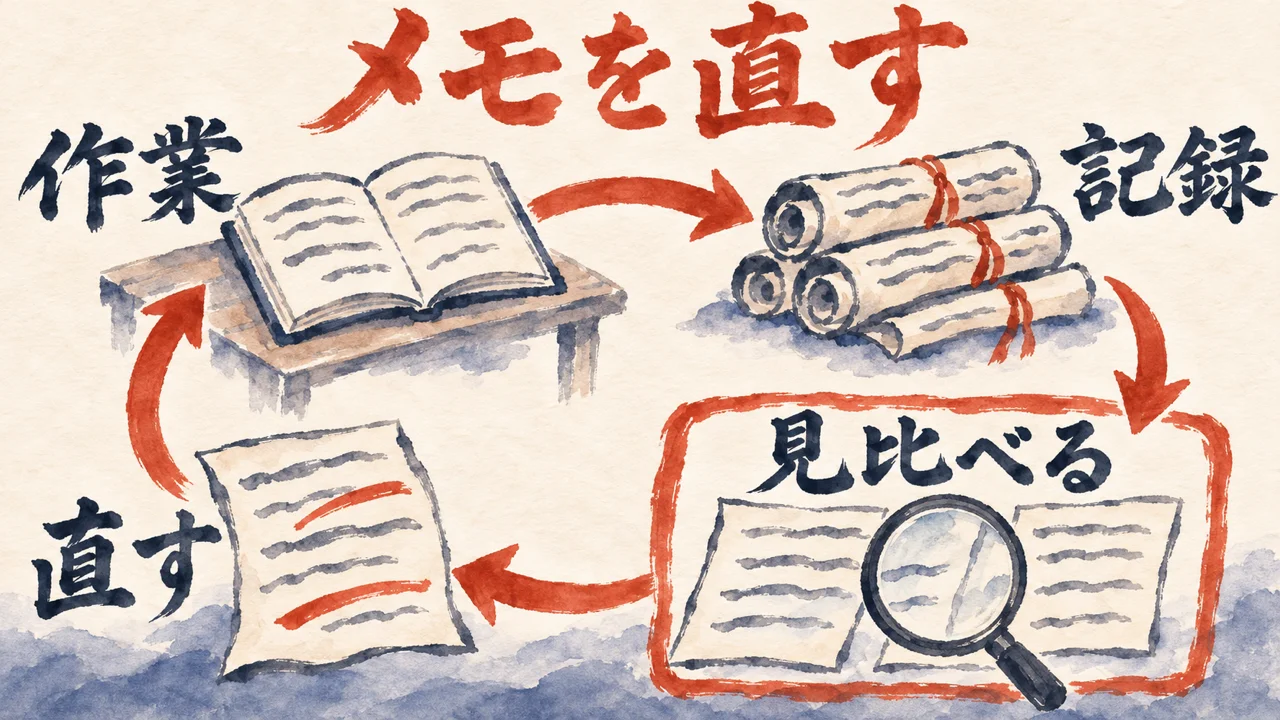
まさおさんは、Anthropicの記事が記憶を4層に分けていると話します。毎回セッションの先頭に入る層、メモから組み立てたWikiのような層、Claudeが書く個別のメモ、そして作業の全記録。暇な時に記録を読み返して記憶を直し、下の層から上の層へ育てていく工程がドリーミングだそうです。スライドでは人の記憶と並べてあり、海馬で経験を素早く取り込み、寝ている間に一部を長期記憶へ固める形として描かれていました。元になった研究として、LettaとUC Berkeleyのsleep-time computeの名前も書かれています。
一番上の層について、まさおさんの言葉はこうです。
まさおさん(0:58)
ですねこのアンスロピック【Anthropic】の記事の中で記憶のレイヤーていうのをね4層に分けていますと。はいま先頭からあの毎回ねセッションの頭に入ってくるまクラウドMD【CLAUDE.md】であったりだとかメモリー.MD【MEMORY.md】のま先頭であったりだとかていうのを1番上のレイヤーとして持っていて
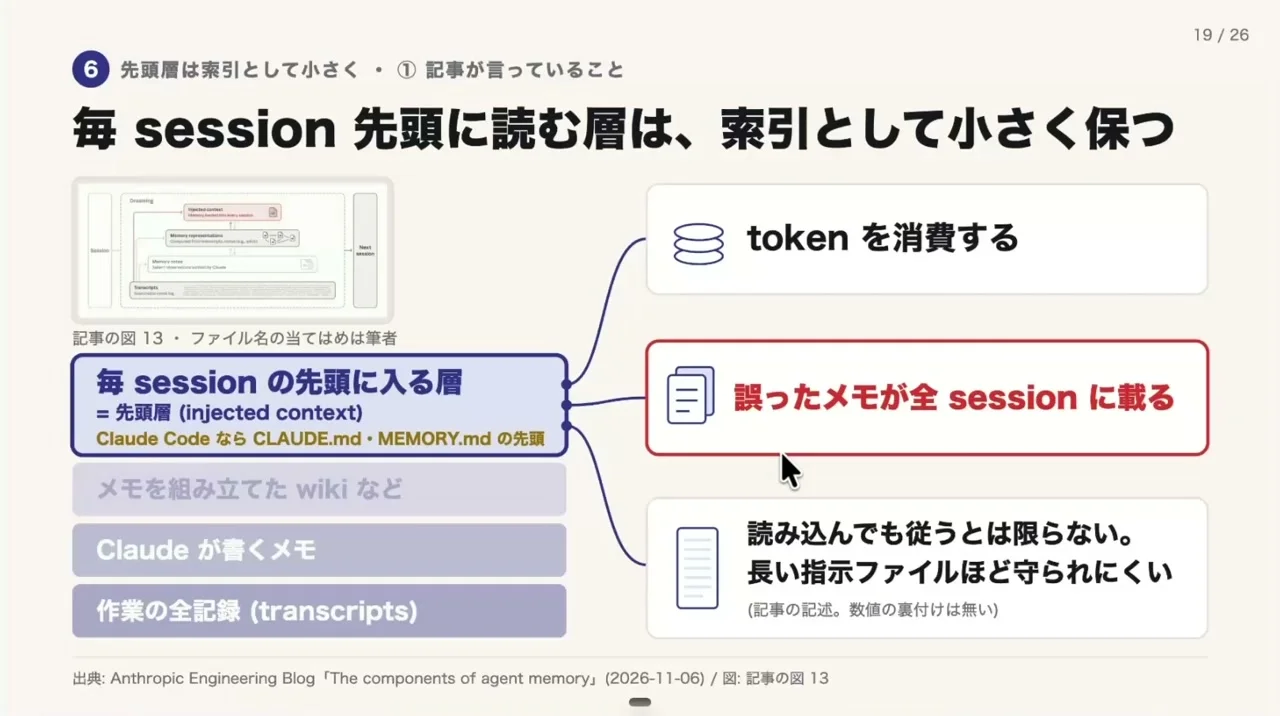
先頭の層に入るのは、CLAUDE.mdとMEMORY.mdの先頭。
あの時AIが作ったのは、wikiのフォルダで起動して、記録を根拠に答えの文だけを返すAIです。別のAIのチェックを通してから、9月16日までに取り込みました。毎回読まれる側に残したのは、宛先と聞き方を書いた4行だけ。
まさおさんは、記憶を何でも入る箱と見ずに層を引くと、どこに重みが要るか整理しやすい、とも話しています。層に名前があるから、先頭に置く物と、聞きに行けば足りる物を分けて話せるんですよね。整理は、そこからです。
私が仕組みを考える時の前提は、人格、記憶、スキル、実行権限、見た目を混ぜないことです。記憶もその中でさらに置き場ごとに名前をつけて分けます。散らばっていた5か所に足りなかったのは、中身ではなく、どこを開けばいいかの1行でした。
毎回読むのは4行、残りは聞きに行く先。
あなたのAIは、昨日伝えた前提を、今日また聞き返してきませんか?
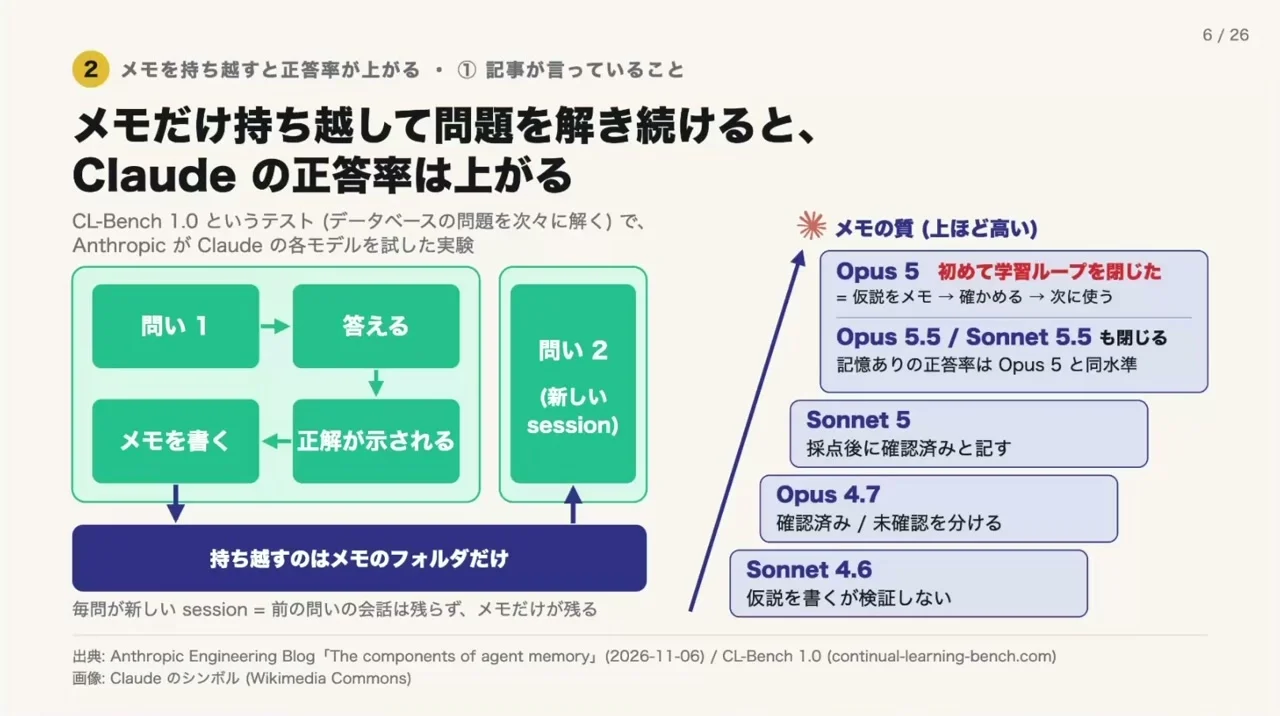
まさおさんによると、Anthropicの記事は、メモを持たせたら本当に賢くなるのかを、CL-Bench 1.0というテストで確かめています。問い1に答えてメモを書き、正解が示されたら、新しいセッションの問い2へはメモだけを持ち越す。この輪を回し続けると、正答率が上がっていくそうです。
スライドには、モデルごとのメモの質が階段のように並んでいました。仮説を書くが検証しないSonnet 4.6から始まり、Opus 5で初めて学習ループが閉じ、Opus 5.5とSonnet 5.5もそこに並ぶ、という整理です。
その節目を、まさおさんはこう言います。
まさおさん(6:03)
どんどんね、そのメモの部分を引き継いで新しい問いに行くなやつなんですけれども一定ゾーン、つまりオーパス5【Opus 5】ぐらいのところから仮説をメモして確かめて次に使うみたいな学習ループがね、え、閉じたと。
仮説をメモして、確かめて、次に使う。輪をまたいで残るのはメモだけ、というのがこの実験の形でした。メモが主役です。
でね、私が引っかかったのは、正答率よりも、何を持ち越すかのほうです。
私の判断軸に、管理のボールの話があります。AIに委ねたいのは作業だけではなく、約束を覚えて期限まで運ぶ責任まで。私が進捗を思い出して催促したり、同じ品質基準を言い直したりした瞬間、ボールは私の手に戻ってきます。そうなると、本当に大事な判断や創ることに集中できません。
持ち越す価値は、次のセッションが同じ問いを私に言い直させないことにあります。私なら、持ち越すものを、何を言い直させたくないかから選びます。正解の数を増やす前に、聞き返されたくない前提を1行にしておく順番です。
メモリを層で分ける話は、前にClaude Codeのメモリに指摘を残して同じ間違いを防ぐ方法を整理した記事でも紹介しました。そこでもMEMORY.mdは、毎回のチャットの始めに読み込まれる1層目として出てきます。
持ち越す1行を選ぶ物差しは、正答率より手前にあります。
2026年9月、私の毎回読まれる説明書(CLAUDE.md)は約20KBありました。決まりのファイル6本と合わせて、セッションのたびに全部読み込まれる。起動するだけで使うトークンは58,175です。
その月、あるYouTube動画を参考に、仕組みをゼロベースで見直すようAIに頼みました。
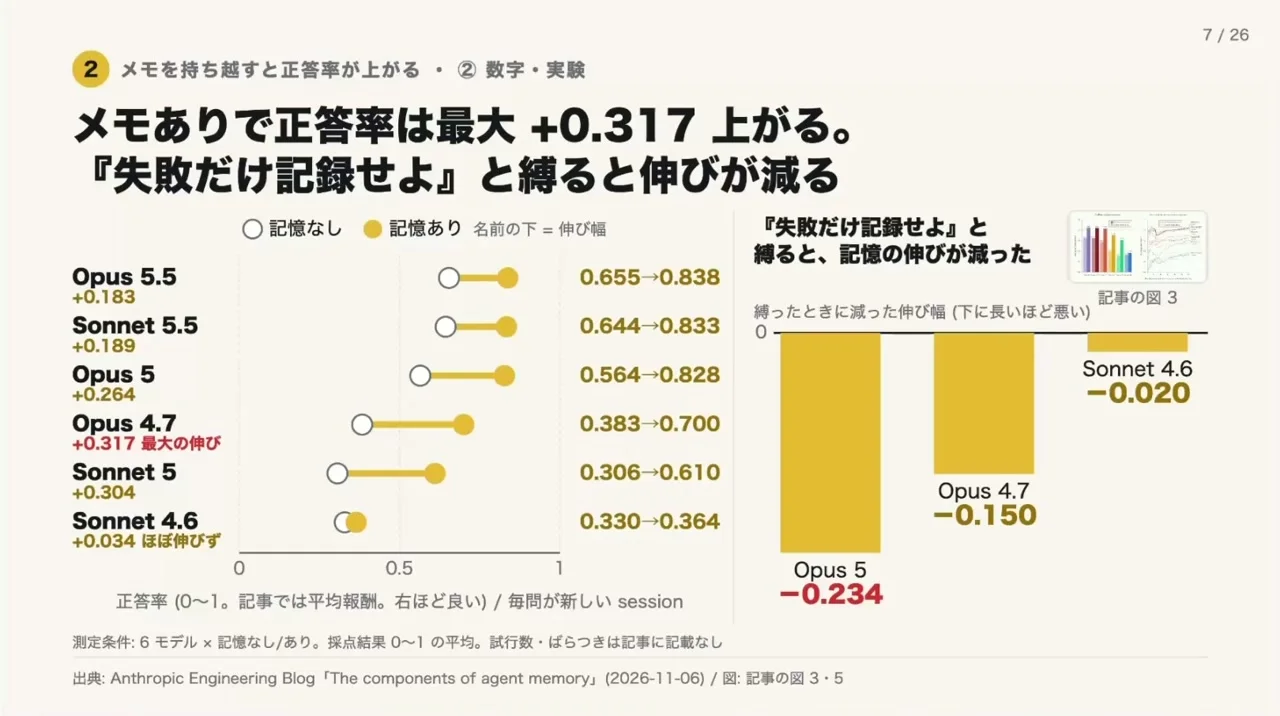
まさおさんは、実験の中で記憶の仕方を縛ると、結果が良くならなかったと話します。失敗だけを記録せよ、のように縛った時、スライドではOpus 5の正答率の伸びが0.234減っていました。一方で、古いモデルほど手順の指示が効くそうです。Sonnet 4.6は、答える前に記憶を読む、仮説を検証する、を足すと0.364から0.641へ。Sonnet 5は指示なしでも、10回中9回は答える前に記憶を読む、という話でした。
運用への当てはめを、まさおさんはこうまとめています。
まさおさん(7:00)
ま、細かいルールっていうのはかえって邪魔になります、なるっていうようなね、え、実験結果が得られたみたいな教諭【教訓】がありました。なのでつまりはね、ま、運用へ当てはめていくんやったら、ま、クラウドMD【CLAUDE.md】っていうのは何のための記憶かみたいなのを書くけれども、やっぱハウ【How】の部分、使い方の手順は縛らないようにしましょうと
目的は書く、手順は縛らない。
AIは約5KBの短い版に作り直し、起動トークンは30,086に減りました。見張りの仕組み(hook)は足していません。AIが私に確認の質問を書く入口4か所に、同じ1行を入れただけです。
翌日、その質問が私の言葉に触れる率は、23%から74%(219件中148件)になりました! ただ、上がったのは入口に入れた1行のほう。説明書を短くした話とは分けて見ています。動画の実験とも、測っている物差しが違います。混ぜません。
私の判断軸では、魂は渡すものではなく込めるもの。目的や守りたいもの、判断軸を磨いたあと、実行は委ねる。説明書で力を使うべきなのは、何のための記憶かを書く所で、手順を並べる所ではないんですよね。
20KBが5KBへ。
私の環境には、AIの記憶に入れる線引きがあります。判断、実測、文脈、失敗のどれかが1行でもあれば入れる。読めば分かる事実だけのものと、認証情報は入れない。
2026年9月28日の週の振り返りでは、1週間分の感情・行動・知識から候補を取り出し、私が選んだものだけを、AIが過去の私の指摘を引くための索引に入れました。ルール4本を入れて、769件が770件に。
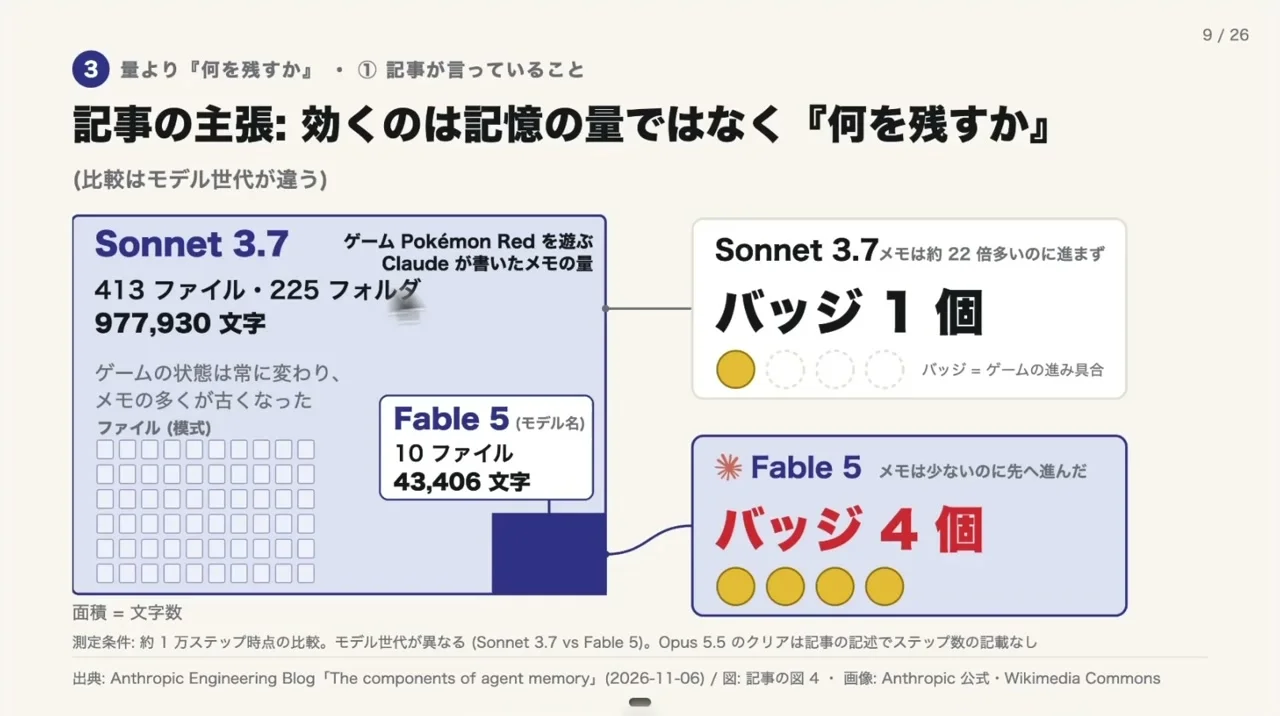
まさおさんは、2世代前のモデルとの比べとして、ポケモンの実験を挙げます。スライドでは、Sonnet 3.7は大量のメモを参照しながらバッジ1個、Fable 5は量をぐっと減らしてバッジ4個。メモが約22倍多くても、ゲームは先へ進めなかったそうです。Opus 5.5は、目標と次の手を追う小さなフォルダを書き換え続けて、クリアまで行ったと紹介されていました。
この差を、まさおさんはこう受け止めています。
まさおさん(8:12)
ま、記憶の量が絶対的に多ければ多いほど言うわけじゃないというか、うん。ていうのは、ま、モデルの性能が2世代上がってるけれども1つ言え、あの、言えることなんじゃないかという形で、え、共有がありましたと。
スライドの仕分けは、台所の冷蔵庫の整理に近い感覚で読めました。残すのは判断、失敗から分かったこと、戦略・計画・ルール。書かないのは、READMEや設定ファイルを読めば分かる事実、画面にそのまま出ている状態、すぐ古くなる途中経過です。
で、ここで並べると、少し笑ってしまいます。量を減らしたFable 5が先へ進んだ話の隣で、私の索引は769件から770件へ、1件増えていました。減るどころか、増えたんです。
といっても、足したのは私が選んだ分だけ。入れる基準は判断・実測・文脈・失敗で、動画が残す側に置いた物と向きはそろっています。違いが出るのは、件数ではなく、何を入れないと決めているかのほう。
AIに委ねて、人は積み減らして生き直す。この軸は、記憶にも当てはまります。書く・探す・直す作業はAIに委ねても、何を残すかの線は人が持つ。足す前に、これは読めば分かる事実ではないか、と問う。
AIが、42日前の資料を、今の私の話として使っていました。
2026年9月23日のことです。AIが自分の答えの材料を調べ直すと、使っていたのは8月12日更新の現在地のメモ。9月22日に作られた最新の親設計書には、前回の軸だった「ポータル」「田上」「79ステップ」が一度も出てこなかったんです。
そこで、ルールを2つ足しました。私の現在地は、最新の親設計書を先に読んでから語る。読む前に、更新日を見る。
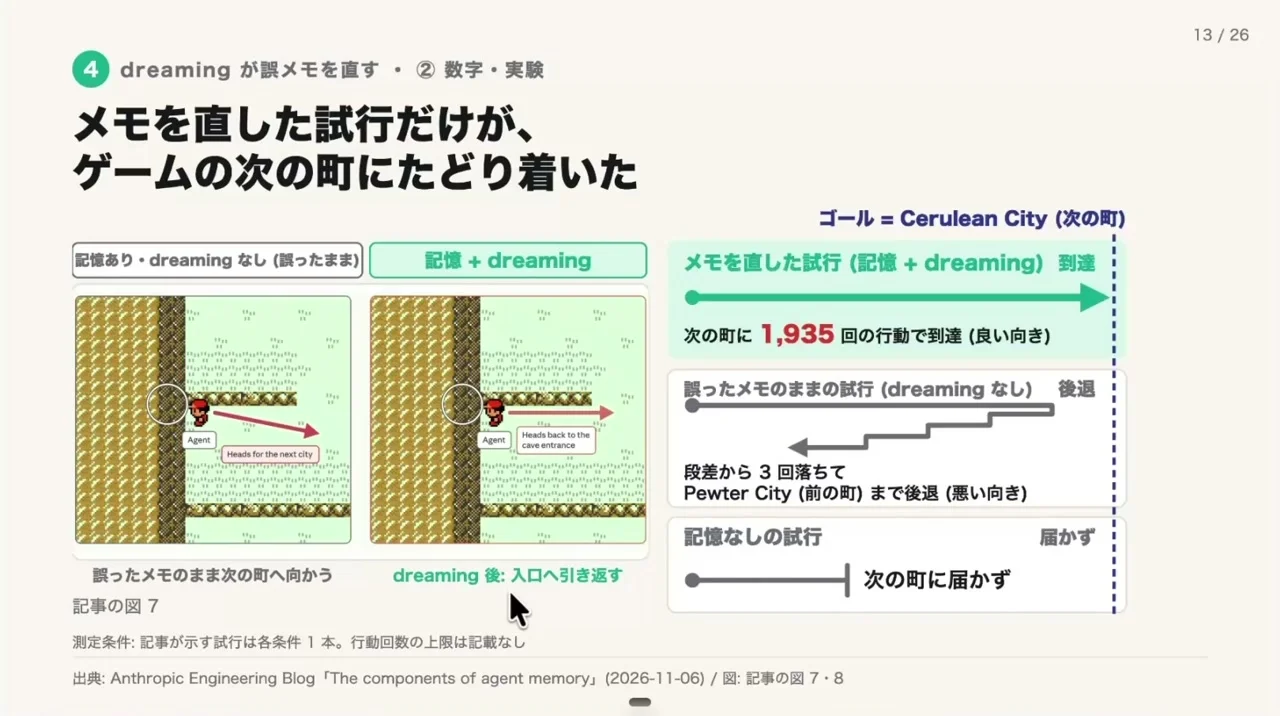
まさおさんがこの章で話すのは、ポケモン赤の実験で起きた、同じ形の間違いです。まさおさんによると、Claudeはポケモンセンターの入口にある一方通行の段差を誤って記録し、その罠を無視して元のルートへ落ちてしまった。作業の全記録と誤ったメモを突き合わせるドリーミングをしたら、入口へ引き返せるようになった、と話します。
では、直さないまま読み続けたらどうなるのか。
まさおさん(11:12)
ここをね、定期的にじゃあ全体見ながら、あの、一貫性保っておかないと、ま、嘘が混じってたりだとかね、古い情報をそのまま読んでしまったりメタ認知が効かなくてね
まさおさんは、CLAUDE.mdやMEMORY.mdの先頭を読み続けるうちに、嘘が混ざり、古い情報をそのまま読み、メタ認知が効かなくなる、と続けます。だから鮮度を保つ仕組みが要る。
運用の案として挙げていたのは、週に1回、夜にClaude Codeの過去ログとMEMORY.mdを見比べさせ、説明書と記憶を直す形でした。トークンはかかる、とも話しています。
私の件は、ドリーミングではありません。古いメモを読んでいたと分かり、ルールを足したのは人の手です。でも、誤ったメモが毎回の答えに載り続ける形は、段差の罠とそっくりでした!
私なら、直す時も古いメモは消さずに、新しい見え方を上に重ねます。ドリーミングそのものは、今西さんの動画で「ドリーミング」(夜に自動で記憶を直す仕組み)を紹介した記事でも前に取り上げました。
直す時に、元の記録をどう扱うか。その続きは、あとのコラムで書きますね。
私のwikiでは、Resendの作業を聞くと「無い」という答えになる状態でした(9月30日の記録を除いて測った結果です)。
2026年9月30日、wikiの精度を直したいとAIに頼みました。AIが測ると、作業記録966件のうち、wikiが参照していたのは19件だけ。9月17日より前の787件は、そもそも取り込まれていなかったんです。
意味で探す検索を毎回あわせて使い、作業記録3件を補助に足す。その最小の形にすると、Resendの3問は「無い」から3問とも答えられるようになりました(9月30日の記録は除いて測っています)。80問のうち、正解の記録が材料に入った数は68から69へ。答えが分かっている10問の待ち時間は、27.9秒から57.8秒に延びています。
私は、外へは出さず、すぐ戻せる形で本体に入れる方を選びました。
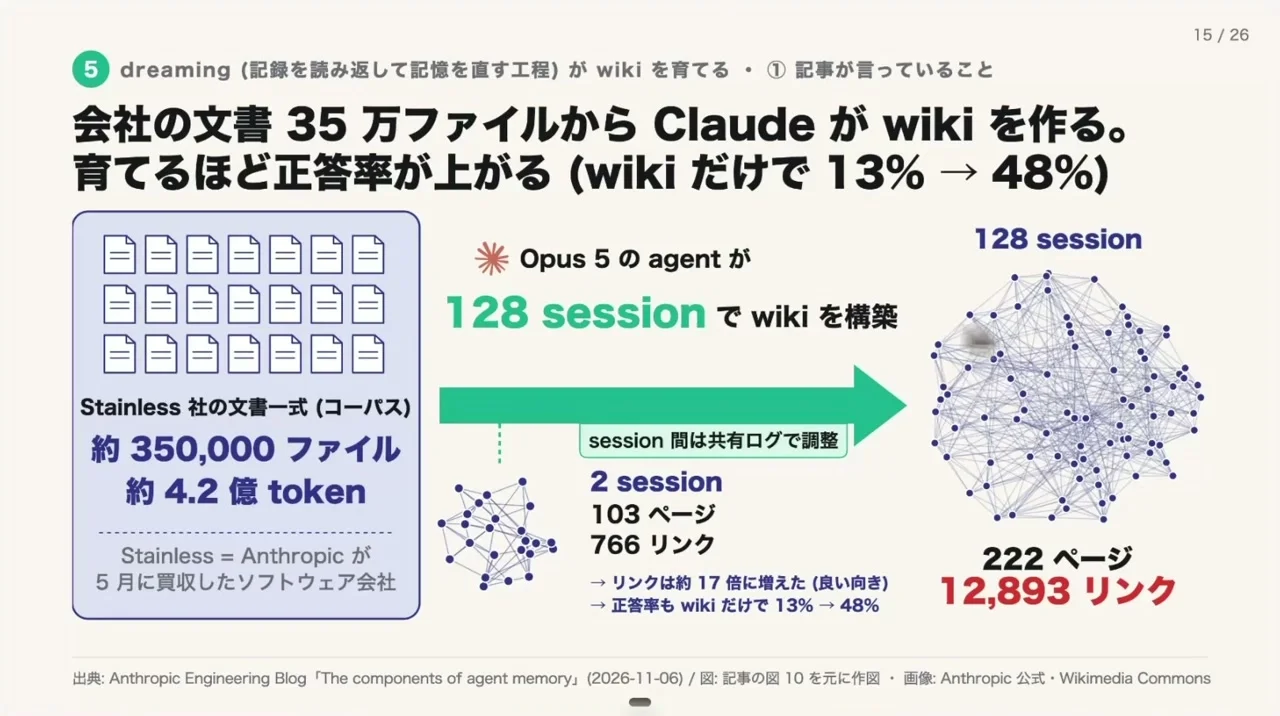
Wikiの話は、動画でいちばん数字が大きい所です。まさおさんによると、Anthropicが買収した会社(スライドの記載はStainless社)の文書約35万ファイル・約4.2億トークン分から、Opus 5のエージェントが128セッションでWikiを作った。スライドでは222ページ・12,893リンクで、Wikiだけでクイズの正答率が13%から48%に上がっています。Wikiと検索を組み合わせると、複数の文章が要る質問で検索だけより強い、とも。KarpathyさんのLLM Wikiにも触れていました。
正直、ここは手放しにはほめないんですよね。
まさおさん(15:12)
ま、書き方誤ってしまうとね、ま、無駄な情報が膨らんだりだとか事実が消えたりだとか、あの、ま、古い情報がそのまま残ってしまったりだとかね、ま、いろんな問題があります。
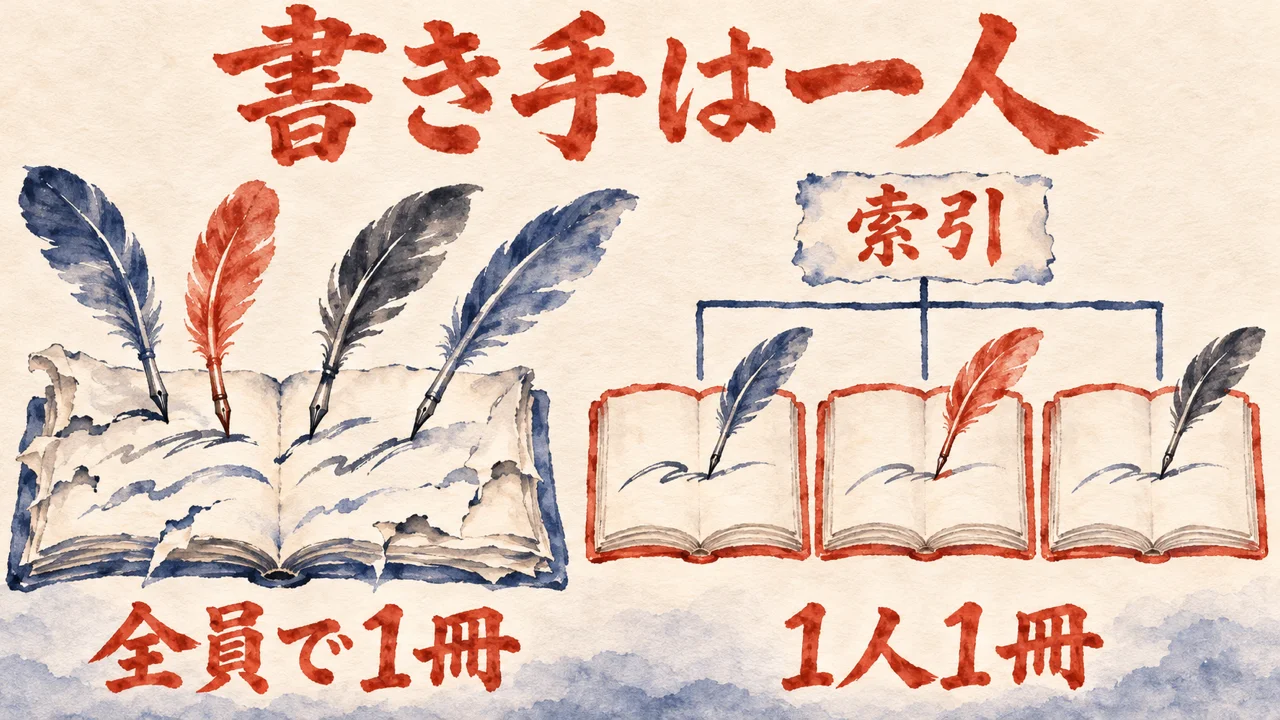
スライドには、元の文書115KBが203KBに膨らんだ例(1.77倍)が載っています。4体のエージェントが1つのファイルprovisions.mdに書くと、57件の事実のうち41件、72%しか残らなかった。1ページの書き手を1体にすると57/57。MEMORY.mdも、役割ごとにnotes/のファイルを分けてMEMORY.mdから引く形にしたら事実が残った、とまさおさんは話します。
並べてみると、私の件と動画の件は原因が別です。動画は、上書きで事実が消えた話。私のwikiは、材料がそもそも入っていなかった話でした。
だから数字も比べません。13%から48%と、68から69では、測った物が違います。
それでも、通じる線は1本あります。私なら、ファイルにも書き手にも、持ち主を一人決める。関連する話は、記憶の取りに行き方を、記録を探して答えだけ返す道具に任せる形に触れたObsidianの記事でも書きました。
毎回のセッションで、MEMORY.mdの後半が読まれていませんでした。
2026年5月、あるYouTubeを参考に環境の見直しをAIに頼み、MEMORY.mdを測ってもらった時です。74,442バイト・200行。読み込みの上限(先頭200行か25KBの早い方)の約3倍でした! 私が最近書いたルール35項目が、毎回切り捨てられていたんです。
AIが1項目1行の索引に作り直して、10,853バイト(85.4%減)。進める前に、バックアップを取ってから、と私は頼みました。
まさおさんは、MEMORY.mdの先頭200行はClaude Codeが毎回自動で読み込む、と話します(まさおさん自身は、管理しにくいからとMEMORY.mdをオフにしているそうです)。載るのは200行だけなので、段階的に開く。先頭は索引にして、デザインはここ、デプロイ手順はここ、Wikiはここ、と指し示し、詳しいメモは別ファイルへ。スライドには、320行のMEMORY.mdを30行の索引と別ファイルに分けた例が載っていました。
では、その200行は誰が整えるのか。
まさおさん(17:32)
なんでま、ここの200行をね、え、どう作るかっていうのも実はドリーミングの役割だったりしますし、ま、ここがね、腐ってしまっていると、ま、ま、あの、モデルを惑わしてしまうとか
残る課題として、まさおさんは、いつ走らせるか、ずれた記憶の鮮度、トークンをどれだけ使うか、の3つを挙げます。最後のスライドの題は、運用で今日からやる3手。CLAUDE.mdとMEMORY.mdは索引だけにして、詳細は別ファイルへ。複数のエージェントに1つのファイルを同時に書かせない。READMEを読めば分かる事実は、MEMORY.mdに書かない。
先頭は索引に、という話。私は5月、その先頭に74,442バイトを詰め込んでいました。
で、5月で終わりではないんです。10月7日に自分の記事のために測ると33,157バイトに戻っていて、今日(2026年11月9日)は16,029バイト・147行。その記事には「方針を書くだけでは、短くは保てていません。」と書いています。数字は、戻っては減るを繰り返しているんです。増えて、減って、また増える。
全体を一つにまとめることと、全部を一つのファイルに押し込むことは、別物。先頭は、構造と参照先を持つ索引にする。変わり方や扱う人が違う中身は、別の正本に置く。10月7日の数字は、毎回読まれる入口ファイルを短く保つ公式ページを解説した記事で測ったものです。
16,029バイト・147行。これが今日の、私のMEMORY.mdの大きさです。
HIROKUN COLUMN
▲目次ひろくんコラム:訂正は消さずに、書き加えて重ねる
記憶に誤りが混ざる。古い情報が残る。それを直すのがドリーミングだ、とまさおさんは話していました。
私が大事にしたいのは、直し方の方です。直す時に元の記録を消してしまうと、なぜ直したのか、直す前はどうだったのかを、あとから追えなくなります。
出典:AIへの訂正は一言で終わらせず、元の文を消さずに書き加えると書いた魂磨きの記事(節:訂正はどこに残ったか)
AIへの訂正は、その場の一言で終わらせない。次に同じ言葉が引き出される時にまた縮んで読まれたら、訂正した意味がありません。
今回の訂正は、その日のやり取りの記録だけでなく、判断軸の正本にある元の一文への注記、そして記事や動画に使い回すための文章カードにも残しました。元の文はどこも消さず、訂正を書き加える形です。
魂磨きの記事に、私はこう書いていました。訂正は、元の文を消さずに書き加える形で残す。
AIの記憶を直す時も、同じ向きでいたいんです。古くなった項目を消して入れ替えるより、前の記録の上に、今の見え方を書き足す。そうすれば、直した理由も、直す前の姿も残ります。
直す手がAIでも私でも、元の記録の居場所は残しておく。毎回読む入口は短く保ち、奥には、重ねた版を順に残していく。減らすのは入口で、消さないのは記録です。この分け方なら、古い項目を整えたあとでも、いつ何を直したのかを、あとから辿れます。
あなたがAIの記憶を直す時、元の記録はどこに残りますか?
AIエージェントに渡す、記憶のファイルの点検プロンプト
あなたが使っているAIエージェント(Claude Code や Codex など)に、そのまま貼れる依頼文です。枠の中にこの記事のURLが入っているので、丸ごとコピーして貼れば、AIが記事を読み、短い質問をしながら、あなたの説明書や記憶のファイルを表に整理してくれます。
ファイルを書き換えたり消したりはさせず、見る所を挙げるところまでにしてあります。返ってきた結果は、そのまま信じず、あなたの目で読み直してくださいね。何を残すかの線を引くのは、あなたです。
AIが記事を読み、あなたに1つずつ聞きます
長さ・書く物と書かない物・書き手の数を並べます
記事のURL入りで1〜3本つくります
依頼文を開く
【記事のURL】
https://ai-kidou.jp/video-report-masao-agent-memory/
最初にこのURLの記事を読んでください。読めない時は、読めなかったと伝えてから、下の【記事の要点】だけを材料にしてください。

【参照元(先に読む)】
YouTube本編(まさおAIじっくり解説ch): https://www.youtube.com/watch?v=WXvjFeY8g6s

【目的】
AIエージェントに使わせている説明書や記憶のファイルを、この記事の目で整理したいです。毎回読まれる説明書や索引の長さ、書いてよい物と書かない物、古くなった記憶の見直し、複数のAIが同じファイルに書いている場所を、表にしてください。

【記事の要点】
- 記憶は4層(毎回先頭に入る層/メモから組み立てたWikiなど/AIが書くメモ/作業の全記録)。ドリーミングは、記録を読み返して記憶を直す工程
- メモを持ち越して問題を解き続けると正答率が上がる、という実験が動画で紹介されている
- 説明書には何のための記憶かを書き、使い方の手順は縛らない
- 量より何を残すか。判断・失敗から分かったこと・計画を残し、読めば分かる事実は書かない
- 誤ったメモや古い情報は、直さないと毎回の答えに載る
- Wikiは育てると役に立つが、書き方を誤ると膨らみ、事実が消える。1つのファイルの書き手は1体
- 先頭の200行(25KB)より先は読まれない。先頭は索引にして、詳しい中身は別のファイルへ
- 書き手の読み方: 動画の話は断定の助言ではない。動画の数字は動画の中で話されたこと。何を残すかの線は人が決める。わからないことは憶測せず確かめる

【やってよいこと】
1. 記事を読む
2. 次の質問を、1つずつ短く聞く
 (1) 今AIに使わせている説明書や記憶のファイルの名前と大きさ
 (2) そのファイルの先頭に書いてあること
 (3) 複数のAIが書き込んでいるファイルがあるか
 (4) 使っているAIエージェントや道具
3. 答えに合わせて整理する
4. 使っている環境にそのまま貼れる追加のプロンプトを1〜3本つくる(各プロンプトの中に記事のURL https://ai-kidou.jp/video-report-masao-agent-memory/ を入れる)

【守ること】
- 設定の変更、ファイルの書き換え・削除、インストール、投稿・送信・公開、購入・契約、パスワードの入力はしない。提案として書くだけにする
- 実際のファイルは書き換えず、見る所を言葉で挙げるだけにする
- 鍵・パスワード・口座番号・顧客データを貼るよう求めない。貼られても使わない
- 安全や成果を約束しない
- わからないことは憶測で埋めず、わからないと書く

【返す形】
1. 整理した表(ファイル名/大きさ/毎回読まれるか/書いてある物の種類/書かない方がよい物の候補/書き手の数/見直しの候補)
2. 自分の目で読み直す所を1行
3. 追加のプロンプト(1〜3本・記事のURL入り)Q. AIエージェントの記憶は、どんな層に分かれるの?
まさおさんが紹介するAnthropicの記事では、4層に分けています。毎回セッションの先頭に入る層、メモから組み立てたWikiのような層、Claudeが書く個別のメモ、作業の全記録の4つです。くわしくは第1章で紹介しています。
Q. ドリーミングって何?
暇な時間に記録を読み返して、記憶を直す工程です。下の層から上の層へ育てていく流れで、まさおさんは、人が寝ている間に記憶を固める形に似ていると説明しています。誤ったメモが直った例は第5章にあります。
Q. CLAUDE.mdには何を書くといい?
動画では、何のための記憶かを書き、使い方の手順は縛らない、という話でした。古いモデルほど手順の指示が効き、新しいモデルでは細かい縛りがかえって邪魔になった、という実験の紹介です。第3章で整理しています。
Q. MEMORY.mdが長くなったら?
動画では、先頭200行(25KB)より先は読まれないので、先頭は索引だけにして、詳しいメモは別ファイルへ、と話しています。複数のエージェントに1つのファイルを同時に書かせない、も同じ流れで出てきます。第7章で紹介しています。
まさおさんの動画は、記憶を4層に分け、ドリーミングで下から上を育てる話から始まります。メモの持ち越しで正答率が上がる実験、手順を縛らず目的を書く話、量より何を残すかのポケモン実験。そこから誤ったメモを直す話、Wikiを育てる話と落とし穴へ進み、先頭の200行を索引にする3手で閉じます。
最後にまさおさんが挙げたのは、公式が概念を切って共有したことの大きさでした。
まさおさん(19:38)
で、大きかったのはここでね、わざわざWikiっていう概念を登場させたことですよね。うん。え、ま、Wikiをね、やっぱ使うのモデルうまいなと思っているんで
層に名前がつくと、どこに何を置くかを決められます。減らす線も引けるようになる。
私の手元でも、置き場が5か所に散らばっていたこと、説明書が約20KBあったこと、MEMORY.mdが上限の約3倍だったことがありました。
AIに委ねるのは、書く・探す・直す作業。何を残し、何を書かないかの線は、私が持ちます。
記憶は、足し続けるより、何を残すかを人が決めて減らす。それが、この動画を観て私が受け取った答えです。
本編の動画も観てみてください
動画は約21分。まさおさんがスライド26枚で、Anthropicの記憶の記事を、4層、ドリーミング、Wikiの順に説明していきます。ここで紹介したのは、そのうち私が受け取った7つの話です。観る時は、動画の話をひとつの見方として聞いてみてください。
YouTubeで本編を観る私の本も置いておきます
『Claudeプロジェクト実践入門 コンテンツマーケティング編』(Kindle)
Claudeのプロジェクトを使って、コンテンツマーケティングの仕事を進める形をまとめた本です。
ClaudeのプロジェクトでAIと一緒に仕事を進めたい時に、手に取ってみてください。
Amazonで見るAmazonアソシエイトのリンクです
関連記事
作業は任せて、判断は人が持つ。まさおさんの動画から、AIエージェントとの付き合い方の習慣を紹介した記事です。
AIエージェントに作業を任せる時、人の手に残す習慣を動画から整理した記事です。
Claude Codeのスキルとメモリに指摘を残して、同じ間違いを防ぐ形を紹介した記事です。
参考リンク
動画の概要欄にある、動画が解説している元の記事です。
動画の中で紹介された、まさおさんのnoteです。
この記事で紹介した動画の本編です。
今回紹介した動画
| 題 | 【重要知識】Anthropicの語るAIエージェントの記憶を徹底解説!DreamingやLLM-Wikiなど重要概念も登場! |
| チャンネル | まさおAIじっくり解説ch |
| 公開日 | 2026-11-07 |
| 長さ | 21分22秒 |
| URL | https://www.youtube.com/watch?v=WXvjFeY8g6s |
| 登場 | 話し手1人(まさおさん) |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!