READ REPORT
ChatGPTに「見つかりません」と言われた資料は本当に無いのかをEmbeddingGemma 2で考える
2026年10月13日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回の元ネタは、kun432さんがZennに残したEmbeddingGemma 2のメモと、そこからたどれるGoogleの公式ブログ(10月6日公開)とモデルカードです。
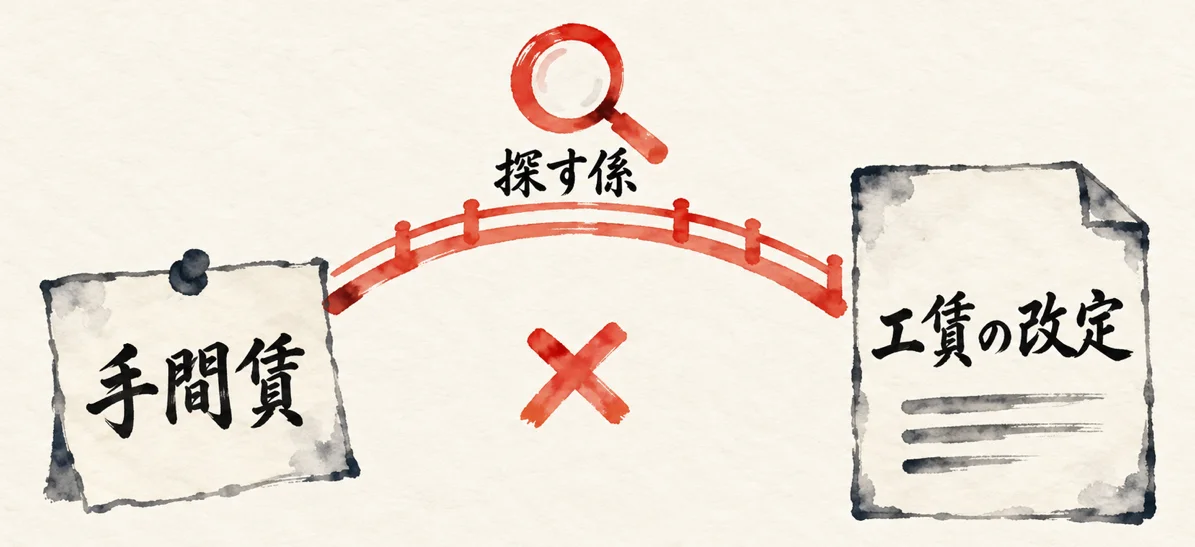
たとえば、毎月の打ち合わせメモを、Claudeのプロジェクトに入れてあるとします。「去年の秋に職人さんの手間賃を見直した話、どこに書いてあった?」と聞いて、「該当する記述は見つかりませんでした」と返ってくるとします。でも、書いた覚えはありますよね。自分でメモを開いてみると、そこには「手間賃」ではなく「工賃の改定」と書いてあった、という場面です。
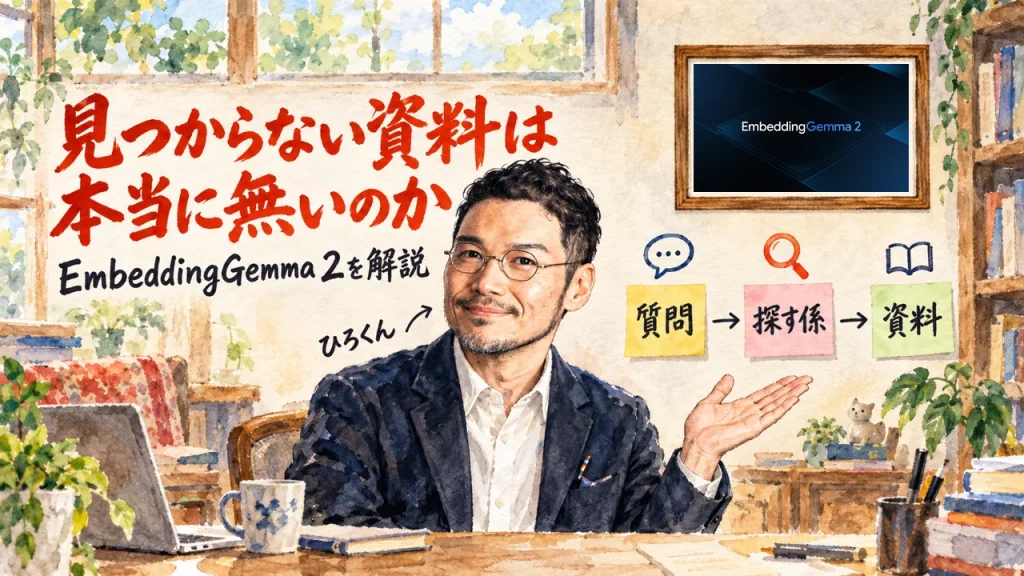
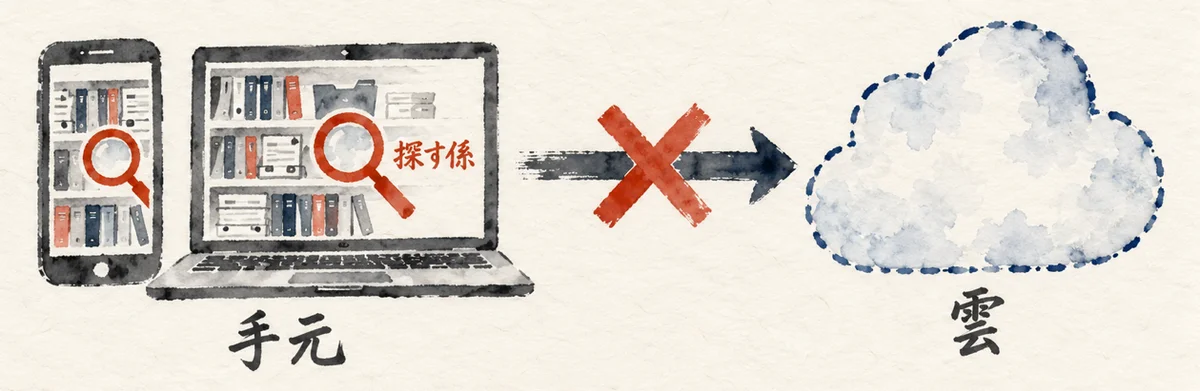
AIに自分の資料のことを聞いて「見つかりません」と返ってくると、つい「書いてなかったんだ」と思ってしまいますよね。でも、無いって意味とは限らないんです。AIに資料を読ませる仕組みでは、答える手前に、資料を探す係がいます。聞いた言葉と書いた言葉が違うだけで、拾われないことがあるんです。この記事を読み終わる頃には、EmbeddingGemma 2がその探す係を、言葉の一致ではなく意味の近さで、手元のスマホやパソコンの中で受け持つ部品だと分かります。AIに頼む時に、別の言い方と中身の分かる題名を添える理由も、自分の言葉で話せるようになるかな、と思います。
3行でわかるポイント
- 「見つかりません」は、資料が無い証拠とは限りません。私のブログの検索でも、自分の記録の置き場でも、言い方が違うだけで同じ資料が0件になったんです。
- EmbeddingGemma 2は答えを書くAIではなく、文章や写真、音声、動画の意味を数字の並びにして、近いものを探す部品です。Googleによると、スマホやパソコンの中で動くように小さく作られています。
- Googleの数字はGoogleが自分で測った評価で、伸びたのはコードと写真・音声・動画です。文章は、初代とほぼ同じでした。AIに資料を探してもらう時は、別の言い方と中身の分かる題名を添えておきたいです。
kun432さんがZennのスクラップに書いた個人の備忘録。Googleの公式ブログとモデルカードを読み、EmbeddingGemma 2の特徴とMediaPipeでの様子をメモしている(一部LLM生成・内容無保証と本人が明記)
ChatGPTに「見つかりません」と言われた資料は本当に無いのか。EmbeddingGemma 2を読んで考えた
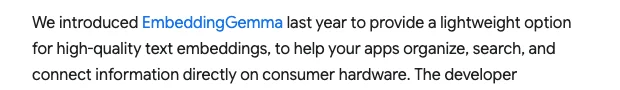
Google公式ブログ「EmbeddingGemma 2」(2026年10月6日)の一節
to help your apps organize, search, and connect information directly on consumer hardware
英語の原文を日本語にすると、「アプリが情報を整理し、探し、つなげるのを、手元の普段使いの機械の上で直接手伝うため」って意味です。
これは、Googleが去年、初代のEmbeddingGemmaを出した理由を書いた一文なんです。今回の2は、その続きです。
冒頭の「手間賃」と「工賃の改定」の場面、ありそうですよね。資料は、ちゃんとあったんです!違いは、聞いた言葉と書いた言葉だけでした。似たことを、私は自分のブログで見ていました。数字としてです。
9月30日に、WordPress標準の検索で、同じ記事をAIに探してもらったんです。言い方を、少しずつ変えながらです。探したのは、JevというAIの記事なんです。前に私が記事にしたものでした。
当時の記事には、こう書いています。
AI氣道『mazrean さんのJevサイト内検索を解説。ベクトル検索とAI判定の2段で、何が拾えて何が落ちるか』より
「私のブログは、今日の朝の時点で1,811本あります。WordPress標準の検索でJevの記事を探すと、「Jev」と入れれば27件、「答えを出さないAI」と入れれば0件でした。同じ記事を探しているのに、言い方で結果が変わります。」
言い方で検索の結果が変わったこの実測を、私は『mazrean さんのJevサイト内検索を解説。ベクトル検索とAI判定の2段で、何が拾えて何が落ちるか』で書いています。
細かく言うと、「判定AI」は5件、「判定だけするAI」は2件、「文章を書かないAI」は6件でした。Jevは、文章を書かずに判定だけをするAIなんです。どの言い方も、同じJevを指しています。
なのに、言葉が少し違うだけで、出たり消えたりするんです!読む人は、知っている言い方で探しますよね。出なかったら、記事は無いって受け取るかもしれません。
自分のメモや作業記録を溜めている場所でも、同じことがありました。9月17日に、AIに使わせる道具の許可を見直した記録があります。
それなのに、「ツール承認を減らした件」「クロードの設定を減らした話」のように、言い方を変えて3つ聞いたんです。返ってきたのは、3つとも0件で「無い」でした!
その後、意味の近さで探す仕組みを足しました。すると、3つとも1位に出たんです(EmbeddingGemma 2とは別の仕組みです)。
聞いたのは、同じ3つなんです!ChatGPTやClaudeに自分の資料やメモを入れて聞く時も、書いた言葉と聞いた言葉が違うと拾われないことがあるのかもしれない、と思います。
その続きとして、kun432さんのZennのメモから、Googleの公式ブログとモデルカードを読みました。そうして書いたのが、この記事です。
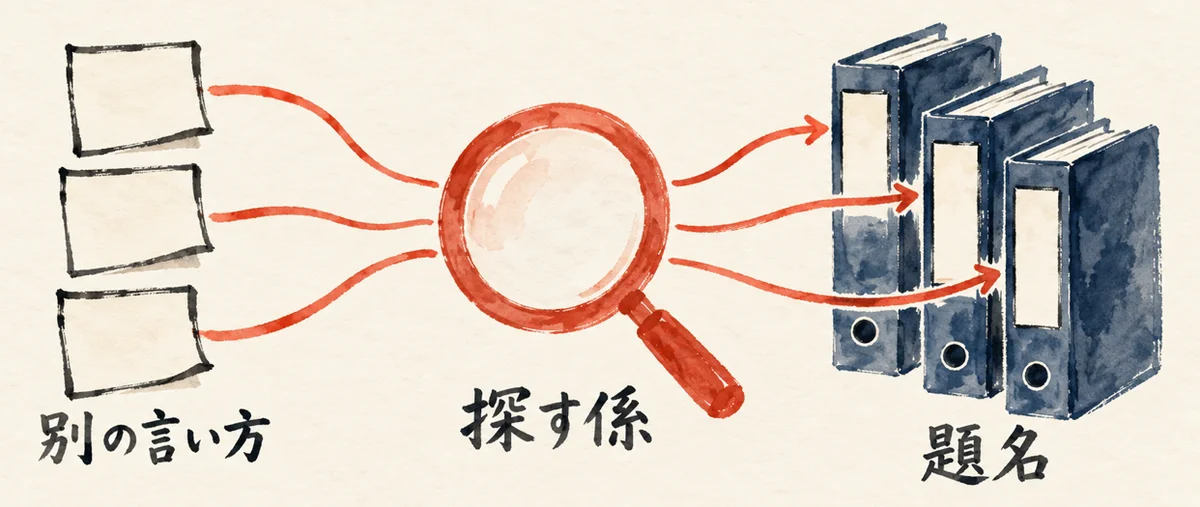
EmbeddingGemma 2は言葉の一致ではなく意味の近さで資料を並べる「探す係」です
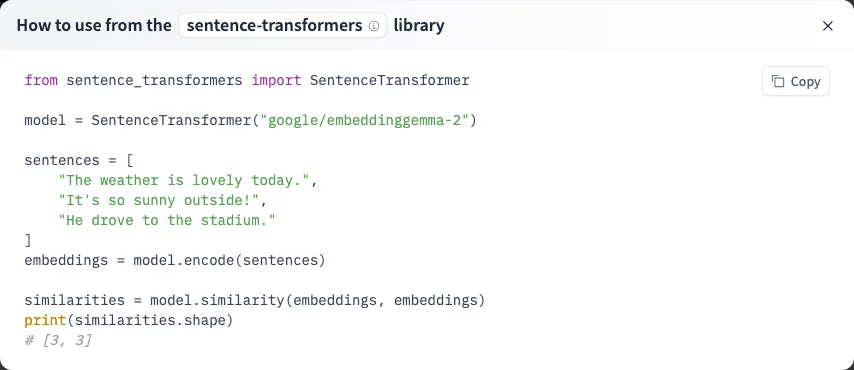
Google DeepMind「EmbeddingGemma 2」モデルカード(Hugging Face)の一節
The weather is lovely today.
英語の原文を日本語にすると、「今日はいい天気ですね」って意味です。
モデルカードの使い方の例には、この1文に続けて「It’s so sunny outside!」と「He drove to the stadium.」が並んでいます。
それぞれ「外はすごく晴れてる!」「彼はスタジアムへ車で行った」って意味です。
1つ目と2つ目は、同じ言葉を使っていませんよね。でも、言っていることは近いんです!3つ目だけ、意味が遠い文です。この近い・遠いを、数字で扱えるようにします。
それが、EmbeddingGemma 2の仕事なんです!
EmbeddingGemma 2は、答えを書くAIではありません。文章や写真の意味を、768個の数字の並び(ベクトル)に置き換えます。そして、意味が近いものを近くに置く係です。
これを「埋め込み」って呼ぶんですね。ChatGPTのように返事をくれる相手というより、返事を書くAIのために資料を並べておく裏方、と言ったほうが近いかな。
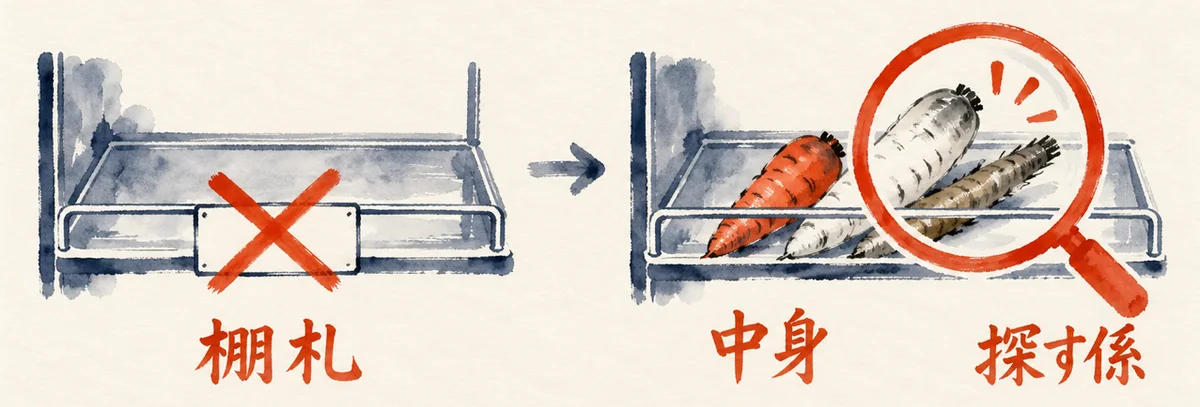
冷蔵庫でいえば、棚札の文字を読むのではなく、中身を見て近い棚に入れていくイメージです。札の文字が違っても、中身が近ければ近い棚に入る、という感じです。
中身が職人さんへの支払いの話かどうかで、置く棚が決まるって形です。冒頭の「手間賃」と「工賃の改定」も、言葉は違っても意味は近い組み合わせですよね。言葉の一致だと、この2つは他人同士なんです。
意味の近さで並べる仕組みなら、近い棚に置かれることを狙えます!
kun432さんのメモによると、埋め込みは「意味マップの座標」のようなもの、と説明されています。ただ、この部分はDiaというAIがまとめた文章なんです。
kun432さん自身も、一部にLLMで生成した文章を含み、内容は無保証だと書いています。なので私は、地図の上の住所くらいのゆるいたとえとして受け取っています(たとえのたとえ、ですね)。
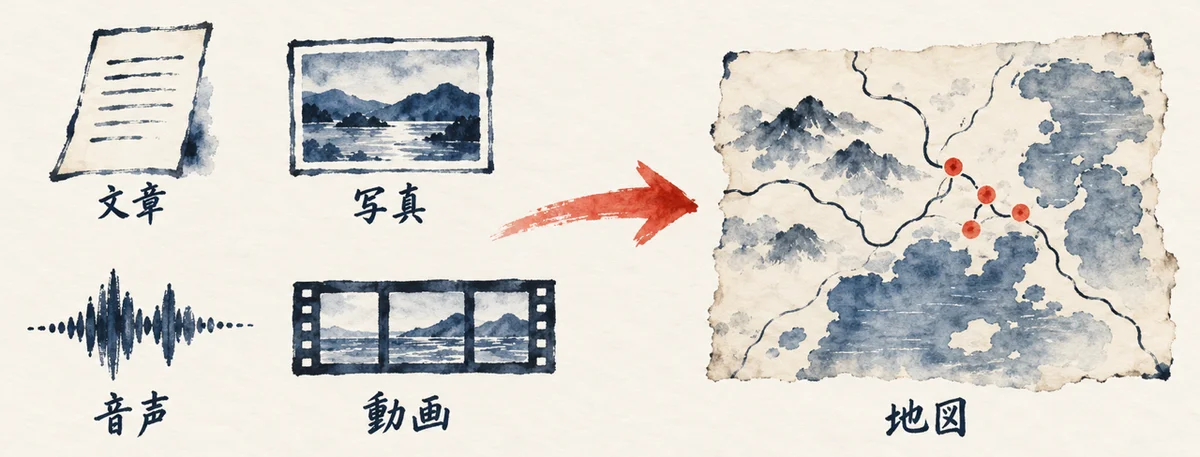
写真もボイスメモも動画も同じ地図に置く。EmbeddingGemma 2が文字以外まで探せる意味
Google公式ブログ「EmbeddingGemma 2」(2026年10月6日)の別の一節
It can help find a specific video clip from a voice memo, or search through hours of audio recordings based on a text query
英語の原文を日本語にすると、「声のメモから特定の動画の場面を見つけたり、文字で聞いて何時間もの録音の中を探したりするのを手伝える」って意味です。
Googleが、EmbeddingGemma 2の使い道として挙げている一文ですね。
スマホのカメラロールに溜まった現場写真や、ボイスメモに残した打ち合わせの録音を思い浮かべてみてください。後で探そうとすると、困るんです。写真は、番号のような名前のままです。
録音は、頭から聞き直すしかありません。そういうこと、多いですよね?
Googleによると、EmbeddingGemma 2は文字だけでなく、写真・音声・動画・プログラムのコードまで、同じ1つの地図に置けるんです。
だから、言葉で写真を探したり、声のメモから動画の場面を探したりする使い方が挙がっています。初代は、文字だけのモデルでした。ここが、2で一番大きく変わった所かな。
モデルカードには、こんな例が載っています。防水のランニングシューズの商品説明に、写真2枚と動画1本を混ぜて、1つの数字の並びにまとめます。
それを「waterproof shoes for trail running」(山道を走るための防水の靴)という文字だけの検索と、そのまま比べられるって例です。
説明文と写真と動画が、まとめて1つの住所を持つイメージですね。文字の検索と写真や動画が、同じ土俵に乗るんです!
Googleは、写真や動画の中から探すデモとして、Instant Media SearchとVideo Moments Finderも挙げています。
前者は、文字か写真で、手持ちの写真や動画から近いものを探します。後者は、文字か声で、動画の中の場面を探すって説明です。
ただ、1回に入れられる量には上限があるんです。Googleは、音声なら約5分半、写真なら約29枚と書いています。何時間もの録音を探せる、って話とは別ですよね。ここは、分けて読んでおきたい所です。
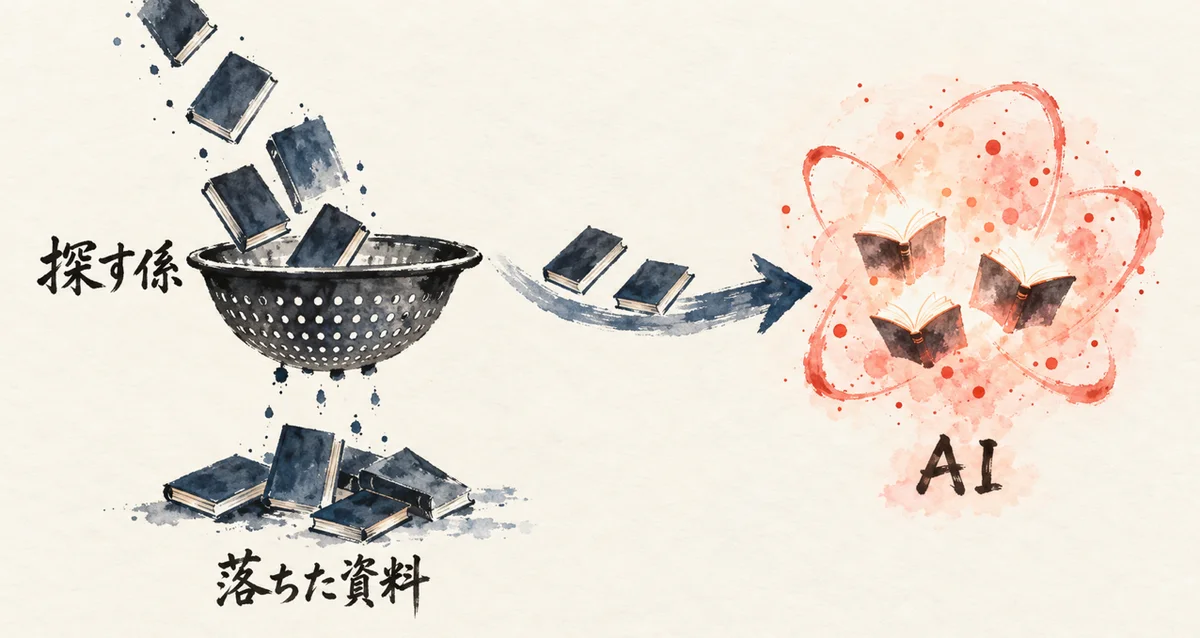
ChatGPTやClaudeが賢くても、探す係が拾い損ねた資料は読めない。EmbeddingGemma 2の持ち場
Google公式ブログ「EmbeddingGemma 2」(2026年10月6日)のさらに別の一節
When paired with generative models such as Gemma 4, EmbeddingGemma 2 enables on-device RAG pipelines that understand complex multimodal data.
英語の原文を日本語にすると、「Gemma 4のような文章を作るAIと組むと、EmbeddingGemma 2は、写真や音声などが混ざった複雑なデータを理解するRAGの仕組みを、端末の中で動かせるようにする」って意味です。
RAGは、AIが答える前に、資料から関係しそうな所を探して渡す仕組みのことです。
つまり、EmbeddingGemma 2が前で探して、Gemma 4のようなAIが後ろで答えを書く、って分担なんです。手前の探す段階で拾われなかった資料は、後ろのAIがどれだけ賢くても読めません。
読めないものは、答えに使えませんよね(当たり前のようで、見落としやすい所です)。私が前に数字で見たのは、まさにこの話でした!
9月30日の記事に、こんな実測があります。Jevに「本文に検索の答えがあるか」を聞いて、本文の冒頭だけを見せるか、全文を見せるかを変えたんです。それだけで、答えが大きく変わりました!そのときの言葉が、これです。
AI氣道『mazrean さんのJevサイト内検索を解説。ベクトル検索とAI判定の2段で、何が拾えて何が落ちるか』より、同じ記事の別の段落
「Jevの前に絞った分は、Jevが賢くても取り戻せません。私の実測では、本文の冒頭1,800字だけで聞くと「答えなし」が64本、全文で聞き直すと35本でした。」
見せる範囲で答えが変わったこの実測を、私は『mazrean さんのJevサイト内検索を解説。ベクトル検索とAI判定の2段で、何が拾えて何が落ちるか』で書いています。
差は29本です。ただ、これはJevの答えが変わった数なんです。人が1本ずつ開いて、答えが後ろにあったと確かめた数ではありません(元の記事にもそう書いています)。それでも、材料にはなりました。
手前で見せる範囲を狭めた分は、後ろの判定から見えなくなる、って材料ですね。
自分のメモや作業記録を溜めている場所でも、言い換えた質問を10問試した記録があります。言葉の一致で探す方法が拾えたのは、0問でした。
意味の近さで探す方法は、8問を拾っていたんです!どちらも、EmbeddingGemma 2ではない仕組みでの結果です。
ChatGPTやClaudeの答えがずれた時、私はAIの頭を疑う前に、正しい資料がそもそも渡っていたかを見たいです。
たとえば「どの資料のどこを見て答えましたか?」と聞き返してみるのは、どうでしょう?渡った範囲が、見えるかもしれません。工賃の改定のメモがそこに無ければ、言い方を変えて聞き直す番かな、と思います。
資料を外に出さず手元のスマホやパソコンで探す。EmbeddingGemma 2が小さく作られた理由
Google公式ブログ「EmbeddingGemma 2」(2026年10月6日)の続きの一節
Generating embeddings locally helps ensure data privacy
英語の原文を日本語にすると、「埋め込みを手元で作ることは、データのプライバシーを守る助けになる」って意味です。原文は「helps ensure」なんです。
守ると約束する言葉ではなく、守る助けになる、って言い方ですね(細かいけど、大事な所です)。
Googleによると、EmbeddingGemma 2はスマホやノートパソコンの中で動くように小さく作られています。資料を外に送らずに、探す段階を手元で済ませられる、って説明です。
手元で済むのは、ありがたいですよね。人に見せたくない見積書やお客さんの記録ほど、ここが効いてくるのかな、と思います。
数字も出ているんです!Googleが自分で測ったところでは、Google Pixel 11 Proで、軽くした状態なら、文字だけで約191MB、写真や音声まで全部で約567MBのメモリで動くそうです。
文字だけ使う人は、写真と音声の部分を外して、小さく載せられますね。Gemma 4と同じ文字の区切り方と音声の部品を使っている、とも書かれています。
なので、2つを一緒に動かしても、合わせたメモリが小さく済むそうです。
kun432さんのメモによると、スマホ向けには「文字だけ」「文字と写真」「全部入り」の3つの大きさが、別々に用意されているようです。
同じメモには、今はPythonでの対応が少し追いついていない、とも書かれています。ドキュメントのままだと動かず、ひと手間いるってことですね。そもそも、開発者がアプリに組み込む部品なんです。
ChatGPTの設定から選べるものではありません。
私のメモや作業記録を溜めている場所は、今は外の埋め込みサービスを呼んで動いています。手元で探すか、外に頼むか。預け先を選ぶ時の見方が、1つ増えるかな、と思います。
これは、ChatGPTやClaudeそのものが手元で動くようになる、って話ではありません。手元で探して、必要な所だけAIに見せるって分け方です。その選択肢が増える話として、読むのがいいのかな。
ここは、取り違えたくない所です!
Googleの数字は誰が測ったのか。EmbeddingGemma 2の日本語とベクトルの長さを落ち着いて読む
kun432さんのZennスクラップ「メモ: Embedding Gemma 2」の一節
テキスト性能は基本的にv1と変わらない
kun432さんのメモにある一文です。Hugging Faceの議論を見て、文章の性能は基本的に初代と変わらず、強くなったのはコード検索とマルチモーダル(写真・音声・動画をまたぐこと)、とまとめています。
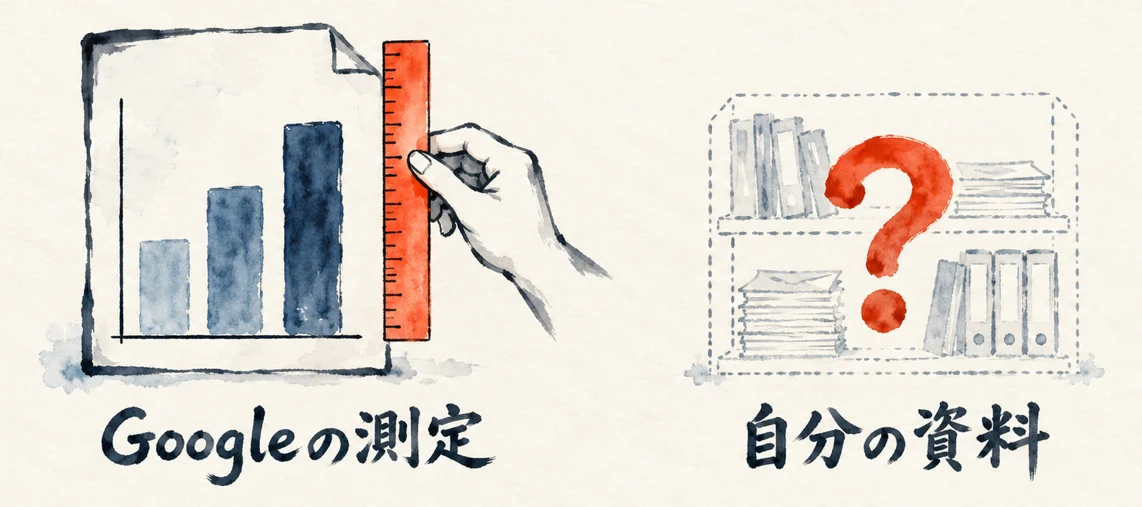
Googleの表を見ても、同じ形が見えるんです。Googleが自分で測った評価では、多言語の文章の評価が初代61.15、2が61.36でした。ほぼ同じですよね。
コードは68.76から78.68に上がっています!写真・音声・動画は、2で新しく加わった所ですね。
公式ブログには「best-in-class」、10億パラメータ未満のマルチモーダルの埋め込みモデルの中でトップクラスのスコア、って言葉も出てきます。
コードの評価(MTEB Code)や音声の評価(MAEB)での話で、これも、Googleが自分で付けた評価なんです。9月30日の記事で、速さの数字は測った場所とセットで書く、と決めました。
それと同じ姿勢で、誰が測った数字かを添えて読みたいです。
日本語はどうでしょう?表にあるのは、多くの言語をまとめた評価です。日本語だけの数字ではないんです。モデルカード自身も、言語によって同じ性能にならないことがある、と書いています。
なので、日本語でもよく探せる、とまでは言えないかな。
それと、数字の並びの長さも選べるんです。768個から512個、256個、128個まで短くできます。Googleの表だと、256個までは文章の評価が61.36から60.41で、ほぼ変わりません。
でも、128個にすると、写真や動画を含む評価が59.01から45.65に下がるんです。ここは、けっこう大きな差ですね!
短くした後に長さを整え直す手順を飛ばすと、エラーにならないまま並び順の質が落ちることがある、って注意も、モデルカードにはちゃんと書かれています。エラーが出ないのが、かえって怖い所です。
私の記録の置き場のほうは、1024個の並びで動いています。
ChatGPTやClaudeに自分の資料を探してもらう時、EmbeddingGemma 2から借りたい頼み方
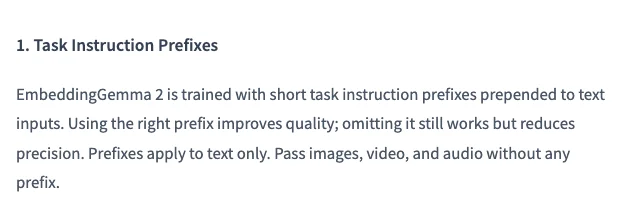
Google DeepMind「EmbeddingGemma 2」モデルカード(Hugging Face)の別の一節
Using the right prefix improves quality; omitting it still works but reduces precision.
英語の原文を日本語にすると、「正しい前置きを付けると質が上がり、付けなくても動くが、精度は下がる」って意味です。
EmbeddingGemma 2は、探す時に「これは検索です」「これは質問の答え探しです」って短い一言を頭に付けると、質が上がるように作られています。一言の差って、面白いですよね!
資料のほうにも、作法があるんです。
モデルカードには、題名のある資料は「title: {title} | text: {content}」の形で渡し、題名が無い時は「title: none」と書く、とあります。
題名と中身をセットで渡すって形ですね。
これを、毎日の場面に置き換えて考えてみました。Claudeに「去年の秋に職人さんの手間賃を見直した話」と頼む時に、「工賃の改定」「単価の見直し」という言い方も添えます。
ファイル名は「2025-10_工賃改定_打ち合わせ」のように、中身で付けておきます。
探しているものに別の言い方を2つ3つ添えることと、資料に中身の分かる題名を付けること。探す係に手がかりを渡す、という意味では、EmbeddingGemma 2の一言や題名と似ているかな、と思います。
8月15日の記事では、sasakunaさんがCodexの前にBM25という検索を置いた検証を読んで、役割の分け方について書きました。その中の一文が、ここにそのまま当てはまるんです。
AI氣道『cclensの続編|なぜCodexは同じコードを何度も読み直すのか? BM25で解く検索非効率の正体』より
「鍵は「粗く探すのは検索、深く考えるのはAI」という役割分担。」
この役割分担のことを、私は『cclensの続編|なぜCodexは同じコードを何度も読み直すのか? BM25で解く検索非効率の正体』で書いています。
これは、私が測った話ではありません。sasakunaさんの検証を読んで受け取った言葉です。粗く探す係が拾いやすいように手がかりを渡しておけば、深く考えるAIは、考えることに集中しやすくなるのかな。
同じ8月15日の記事には、こんなことも書いています。下書きファイルの名前をバラバラに付けていた時期があって、名前を揃えただけでAIも私も迷わなくなった、って話です。名前を揃えた、それだけでした!
題名を付けるのは、地味な一手間です(本当に地味です)。でも、手間賃のメモが「工賃の改定」の名前で眠っているなら、その一手間が取りに行ける道になるんです!
よくある質問
Q. EmbeddingGemma 2とは何ですか?ChatGPTのようなAIとは何が違いますか?
A. Googleが10月6日に出した、文章や写真、音声、動画の意味を768個の数字の並びに置き換えるモデルです。ChatGPTのように返事の文章を書くのではなく、意味の近い資料を探して並べる側を受け持ちます。答えを書くAIの手前で働く裏方、と考えると分かりやすいかな。
Q. ChatGPTやClaudeの中でEmbeddingGemma 2が使われているのですか?
A. Googleの説明で組み合わせ先として挙がっているのは、同じGoogleのGemma 4です。ChatGPTやClaudeが中でどう資料を探しているかは、外からは分からないんです。なので、使われているとは言えません。
Q. 自分のパソコンやスマホで、すぐに使えますか?
A. 開発者がアプリに組み込む部品なので、ChatGPTの設定から選ぶような使い方はできません。kun432さんのメモによると、今はPythonでの対応が少し追いついていなくて、ドキュメントのままだと動かず、ひと手間いるそうです。Googleは、Google AI Edge Galleryというアプリでのデモも挙げています。
Q. 日本語の資料でも、ちゃんと探せますか?
A. モデルカードでは100以上の言語を理解するとされていますが、Googleの表にあるのは多くの言語をまとめた評価で、日本語だけの数字ではありません。モデルカード自身も、言語によって同じ性能にならないことがある、と書いています。文章を探す力は初代とほぼ同じ、というのがGoogleが自分で測った評価です。
Q. 写真や録音も、文字と同じように探せるのですか?
A. Googleによると、写真・音声・動画も文字と同じ地図に置けるので、文字で写真を探したり、声で動画の場面を探したりする使い方が挙がっています。ただ、1回に入れられるのは音声なら約5分半、写真なら約29枚まで、と書かれています。
Q. Googleが発表した数字は、そのまま信じていいですか?
A. 公式ブログやモデルカードの数字は、Googleが自分で測った評価です。「best-in-class」もGoogleによる言い方なので、誰が何で測った数字かを添えて読むのがいいかな、と思います。私は9月30日の記事で、速さの数字は測った場所とセットで書く、と決めています。
まとめ。「見つかりません」は、言い方を変えて聞き直すきっかけにしたい
AIに資料を読ませる時、答えの手前には、資料を探す係がいます。そこで拾われなかった資料は、AIがどれだけ賢くても読めません。私のブログの検索でも、記録の置き場でも、言い方ひとつで同じ資料が0件になるのを見てきました。記事も記録も、ちゃんとあったんです!
EmbeddingGemma 2は、その探す係を、言葉の一致ではなく意味の近さで、しかも手元のスマホやパソコンの中で受け持つ部品なんです。数字は、Googleが自分で測った評価です。伸びたのはコードと、新しく加わった写真・音声・動画のほうでした。文章を探す力は、初代とほぼ同じですね。
だから「見つかりません」は、言い方を変えて聞き直すきっかけにしたいです。別の言い方を2つ3つ添えて、資料には中身の分かる題名を付けておきます。それが、探す係に手がかりを渡す一歩かな、と思います。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
ひろくんコラム。セカンド冷蔵庫は、取りに行けてはじめて冷蔵庫になる
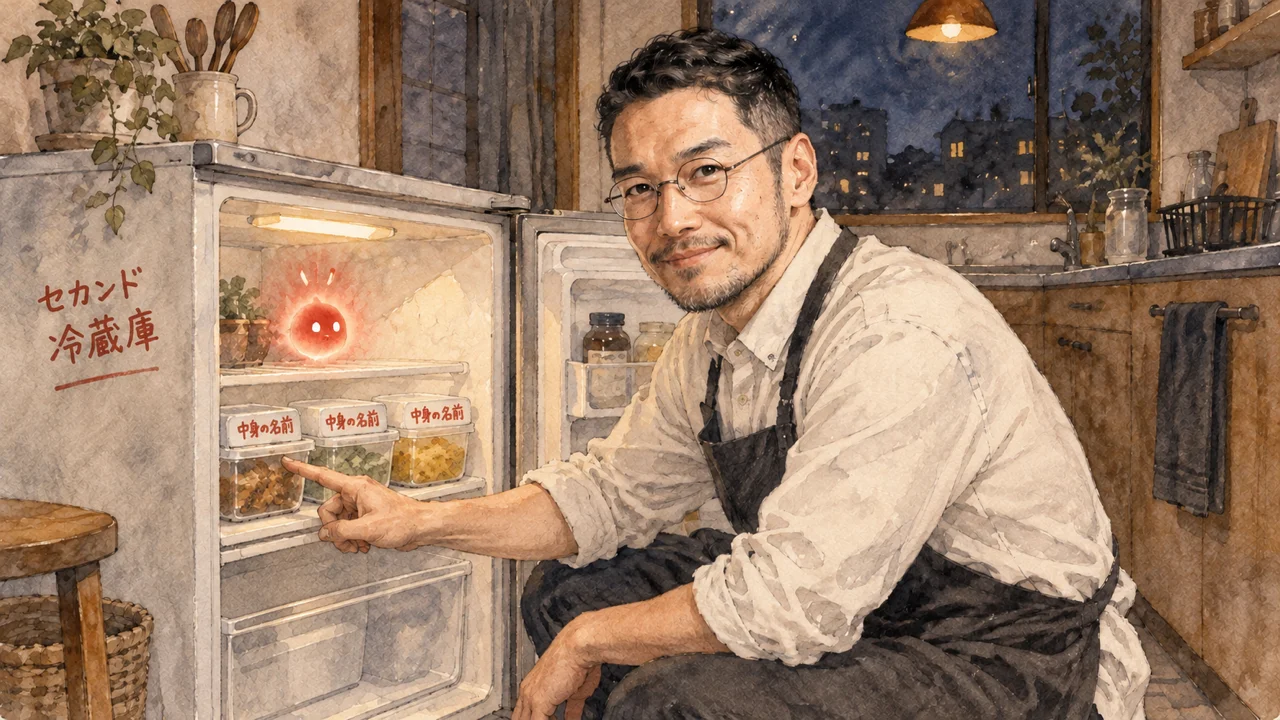
私は、記事もアイデアも全部捨てたくない側の人間です。捨てずに身軽でいるために、分身AIに預けているんです。料理でいえば、自分のキッチンはスッキリさせておいて、セカンド冷蔵庫に入れておく形ですね。使いたい時は、取りに行けばいいだけです。キッチンに全部の食材を出しっぱなしにしたら、どうでしょう?料理のたびに、食材をかき分けることになりますよね(全部捨てたくない人ほど、そうなりがちです)。だから、預ける側を選んでいます。預けるのは、捨てることとは違うんです!冷蔵庫の食材は、ちゃんと私の食材のままです。
ただ、9月30日の記事で、この形が成り立つ条件は取りに行けることだ、と書きました。言い方ひとつで返ってこないなら、それは預けたのではなく、しまい込んだだけになる、とも書いたんです。冷蔵庫の奥で、ラップに包まれたまま何だったか分からなくなったおかずと同じです。入っているのに、無いって扱いになっているんです!おかずが悪いわけでも、冷蔵庫が悪いわけでもありません。入れた時の言葉と、取り出す時の言葉が、ずれていただけなんです。冒頭の「工賃の改定」のメモも、探す側から見れば、そういう一皿になっていたのかもしれませんね。
EmbeddingGemma 2を読んで、預け先にいる探す係のことを、この姿勢から改めて見直しました。棚札の文字ではなく中身で、近くに置いてくれる係がいれば、取りに行ける道は広がります!それでも、預ける側にできることは残っているかな、と思います。入れる時は、中身が分かる名前を付けておきます。取り出す時は、言い方を変えて聞き直します。預けた先が賢くなるのを待つだけでなく、こちらからも手がかりを渡しておきたいんです。料理は、取り出せる食材でしか作れませんよね。だから毎日、冷蔵庫に入れる時も開ける時も、取りに行ける形になっているかを気にかけていたいです。
AIと一緒に、頼み方と窓口を直して育てていく途中の記録は、分身AIと歩んだ100日の全まとめにも残しています。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
mazreanさんのJevを使ったサイト内検索を読み解き、自分のブログ1,811本で言い方を変えながら検索の件数を数えた回です。
sasakunaさんがCodexの前にBM25という検索を置いた検証を読み、「粗く探すのは検索、深く考えるのはAI」という分け方を考えた回です。
文章を書かずに「決定」だけを素早く返す新しいAI「Jev」を、Rob Shocksさんの解説から読み解いた回です。
ClaudeとObsidianでセカンドブレインを15分で作る方法と、9ヶ月使い続けて分かった壁を書いた回です。
参考リンク
この記事で読んだ、Googleによる2026年10月6日の発表
モデルカード。数字の表、次元を短くする時の注意、使い方が載っている
この記事のきっかけになった、kun432さんの個人の備忘録
アプリにAIの機能を組み込む部品集。kun432さんの備忘録に出てきたもの
LiteRT-LM向けに用意された、フル構成(740M)のモデル
今回紹介した記事
| 著者 | kun432さん(個人の備忘録)/元情報はGoogle公式ブログ・モデルカード |
| 媒体 | Zenn(スクラップ) |
| 公開日 | 2026年10月 |
| 元URL | https://zenn.dev/kun432/scraps/1cffe6640cd478 |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!