WATCH REPORT
ElevenLabs V4の日本語と関西弁を動画で見て、聴いて直す所を考えた
2026.10.12
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTubeチャンネル「[動画生成AI] 始め方_How To チャンネル」の動画『【神AI】ElevenLabs V4の日本語がヤバい|関西弁まで自然に話す音声AI』を紹介するね。
日本語のナレーションを作るなら、最初から動画を全部作らなくていい。自分の台本の1行を声にして、聴いて直す。そこから、自分の声や動画づくりへ広げられます。
「[動画生成AI] 始め方_How To チャンネル」のHarutaさんが、2026年10月8日に公開した17分19秒の動画。日本語の違和感、自分の声の登録、APIで台本から動画まで任せる流れを見せています。関西弁を出すコツも、文字の直し方まで具体的。
動画の作例と私のナレーションの記録を並べると、任せる所と聴いて直す所が見えてきます。読み終えたら、演技のタグ、方言の文字、自分の声の録音をどう使うか決めて、最初の1行を作れるようになります。
CHANNEL
[動画生成AI] 始め方_How To チャンネル
Harutaさんが、画面を見せながら1人で語る実演動画です。2026年10月8日に公開されました。
17分19秒。前半はEleven v4の日本語、関西弁の出し方、自分の声の登録。後半はClaude CodeとHiggsfield MCPで、台本から動画までつなぐ実演です。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・8,900名突破!)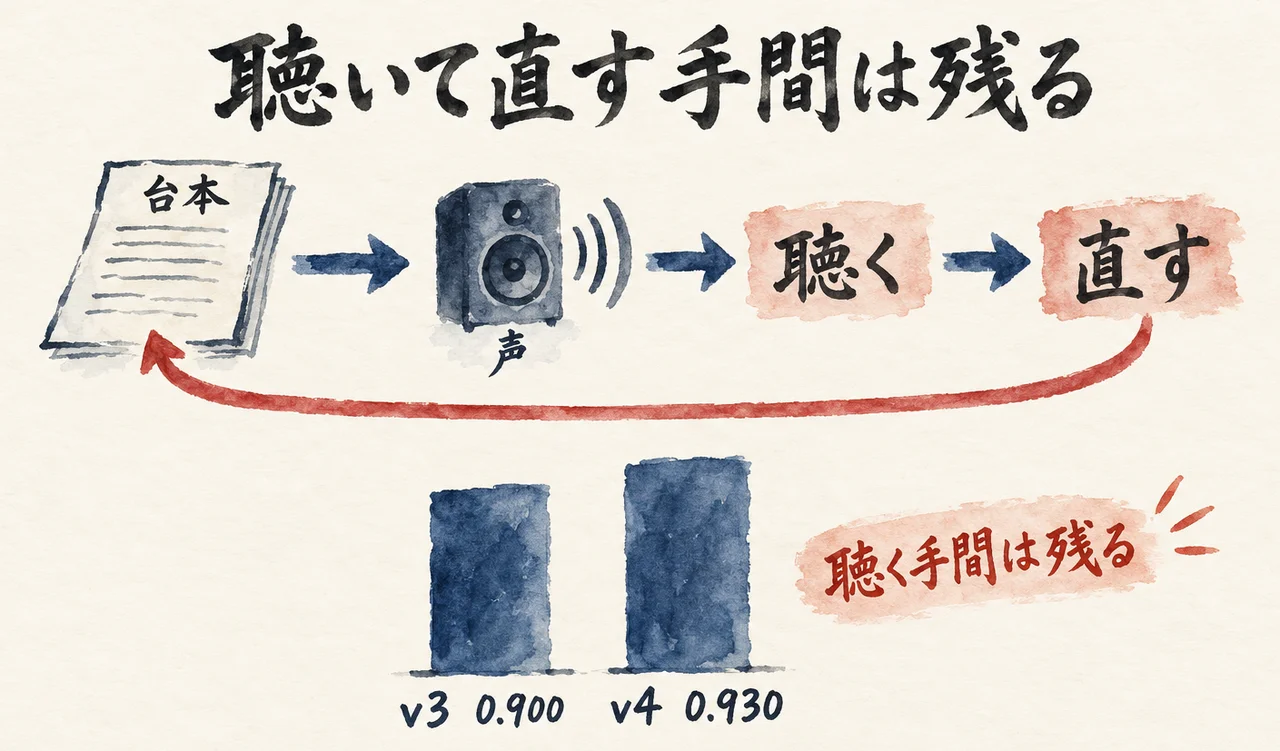
日本語が自然になったら、自分の声で話させたい。その声を使って、動画づくりまで任せたいよね。この動画は、その流れを見せています。まずHarutaさんが語るのは、Eleven v4の日本語の変化です。
Harutaさん(動画の中で・自動字幕・1:24〜)
「上がってます。これまで日本語に弱いところがあったりしたんですけど、全然違和感がないレベルまで来てます。」
動画の「違和感がない」は、私の記録とも向きが合います。ただ、私は出来上がりを耳で聴いて、直す前提で使います。
私にとって完璧って、一度で直しがなくなることではありません。未完成でも受け入れ、違和感があればやり直す。その見方で声も使いたい。
9月30日に講座ナレーションをv3からv4 Turboへ切り替えた時の記録には、「直したのは、読み上げを作る仕組みの中でモデル名を決めている1か所です。」と残しました。声のIDも読み方の辞書も触っていません。切り替えた直後の記録は、こう残しています。
私の記事(2026年9月30日)
「切り替えてすぐ、1行だけ試しに作りました。3.5秒の音声です。」
ElevenLabs v3(9月まで使用)
ElevenLabs v4 Turbo(私の選択)
同じ台本9行を声にして、文字起こしAIで聞き取り、元の台本とどれだけ合っているかを行ごとに出しました(1.000なら台本と同じ)。平均はv3が0.900、v4とv4 Turboが0.930。差が出たのは、名乗りの1行です。これは文字の近さの数字で、耳に自然かどうかは聴いて決めます。
本番ナレーションでは読み間違いが出なかった一方、別の吹き替えでは、「楽しそう」が「たまし そう」と読まれた、という記録もあります。
比べるなら、自分が使う文で聴くのがいちばん早い。
→ 最初の1行から
自分の台本の冒頭1行をv4で生成し、耳で聴いてから文字起こしにかけます。元の台本と並べて、名前や読みが変わった語を探す。その語を直して、同じ行をもう一度作りましょう。
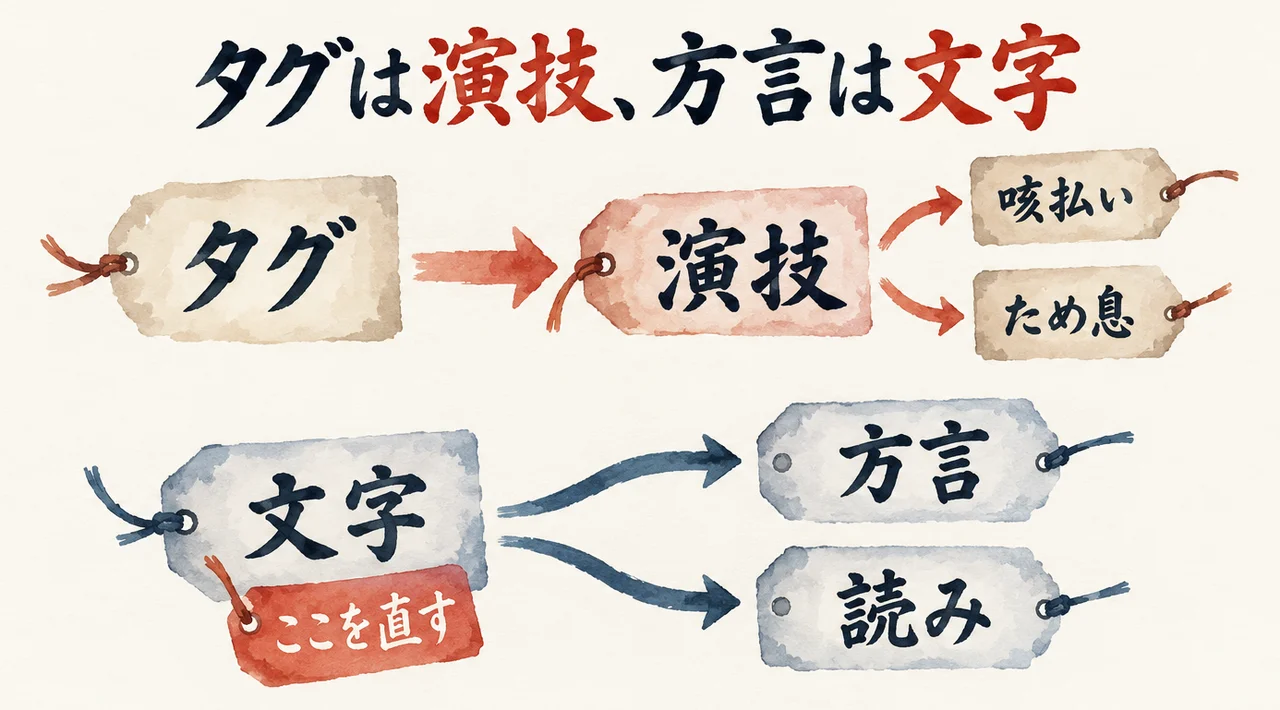
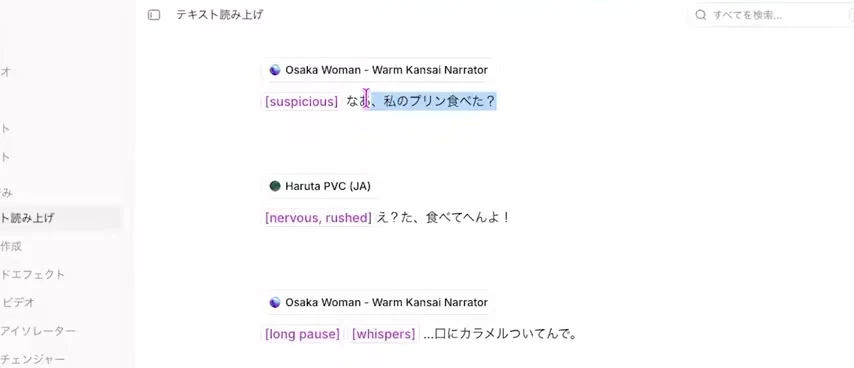
咳払いを入れる、疲れた様子で話す。動画ではタグを付けた音声を生成し、関西弁の女性ボイスとの掛け合いも作っています。ただ、関西弁に変える時に触るのは、タグより先に台本の文字。Harutaさんはこう語りました。
Harutaさん(動画の中で・自動字幕・4:27〜)
「ちなみに関西弁とかにする時はタグをつけずにこういう風に文字を関西弁に変えてください。」
タグは演技、方言は文字。出したい声に合わせて、直す場所を選ぶ。指示を増やすだけでは、読みたい言葉そのものは変わりません。
AIは魔法じゃない。使いこなすには縦に掘る努力が必要です。声づくりなら、どの語がどう読まれたかまで見ること。短い文でも、そこを見れば次に直す所が決まる。
私の吹き替えの記録に、「楽しそう」の読み間違いを文字から直した場面があります。
私の記事(2026年9月30日)
『「楽しそう」が「たまし そう」と読まれた
→ 「らく」「たの」をひらがなで書いて、読みを固定します』
日本語の読みの修正と、動画の関西弁の作例は、直す内容が違います。それでも、文字へ戻る考え方は同じです。
感情タグを付けた私の実測では、タグを文字として読み上げた行は0でした。対象の8行のうち、タグそのものを読んだ行はありません。
ただ、動画ではHarutaさんも「ちょっと疲れた感がね、薄い」と語っています。タグが入ることと、欲しい演技になることは別。最後は聴いて合わせます。
動画の説明と同じやり方で、方言と感情を私の声のクローンで実際に作りました。方言は台本の文字を書き換える、感情はタグ(声の調子を指定する印)を付ける。10月12日に作った音声を、下のプレイヤーに並べます。
方言の聴き比べ(同じ内容の台本を、文字だけ書き換えて作成)
標準語(4.96秒)
この音声、ちゃんと自然に聞こえますか。ちょっと聴いて、確かめてください。
関西弁(5.20秒)
この音声、ちゃんと自然に聞こえてるやろか。ちょっと聴いて、確かめてみてや。
関西弁+笑いのタグ(5.76秒)
この音声、ちゃんと自然に聞こえてるやろか。ちょっと聴いて、確かめてみてや。(頭に笑いのタグを付けた版)
博多弁(5.04秒)
この音声、ちゃんと自然に聞こえとると?ちょっと聴いて、確かめてみてくれんね。
広島弁(5.52秒)
この音声、ちゃんと自然に聞こえとるじゃろうか。ちょっと聴いて、確かめてみてつかあさい。
東北弁風(4.96秒)
この音声、ちゃんと自然に聞こえるべか。ちょっと聴いて、確かめてみてけろ。
標準語と、関西弁・博多弁・広島弁・東北弁風。同じ内容の台本を各方言の文字に書き換えて作り、文字起こしで元の台本と照合しました。関西弁には、頭に笑いのタグを付けた版も1本あります。台本どおりの文字になったのは、笑い版を除く5本のうち4本。その4本で、関西弁の「やろか」、博多弁の「くれんね」、東北弁風の「べか」「けろ」は語尾まで出ていた。
残る1本の広島弁は、「つかあさい」だけが「使わせ」と文字になり、ほかは台本どおり。声が読み間違えたのか、文字起こしの聞き違いか。この結果だけでは分からない。ここは耳で聴いて確かめる所です。
動画は「タグをつけずに文字を関西弁に変える」と説明していました。文字を書き換えるだけで、5本のうち4本が台本どおりの文字になった。方言らしい抑揚まで出ているかは、下のプレイヤーで聴いて確かめてください。
感情タグの聴き比べ(同じ1文に、タグだけ変えて作成。音量はRMS、0に近いほど大きい)
タグなし(2.08秒・-20.4dB)
今日の収録、うまくいきました。
happy(2.40秒・-19.0dB)
今日の収録、うまくいきました。
angry(2.32秒・-18.0dB)
今日の収録、うまくいきました。
sad(2.88秒・-27.8dB)
今日の収録、うまくいきました。
whispers(2.56秒・-31.2dB)
今日の収録、うまくいきました。
surprised(2.32秒・-17.2dB)
今日の収録、うまくいきました。
感情は、同じ1文にタグだけ変えて、6本作りました(タグなし・happy・angry・sad・whispers・surprised)。尺(長さ)と、ffmpegで測った音量(RMS。0に近いほど大きい)を並べると、sadは2.88秒で6本のうち一番長く、音量はタグなしより小さくなりました(-27.8dBと-20.4dB)。whispersは-31.2dBで6本のうち一番小さい。happy・angry・surprisedは、タグなしより大きい数字でした。
文字起こしでは、タグを付けた5本のうち、タグを文字として読み上げた本は0本。関西弁に笑いのタグを付けた別の1本を足した6本でも0本でした。ただ、文字に出ないことだけでは、笑い声や欲しい感情が入ったとは判断できません。
タグを付けると、尺と音量の数字は変わりました(各1本ずつの測定です)。欲しい演技になっているかは、聴いて合わせます。
→ ひらがなで読みを合わせる
生成した声で読み間違えた1語を拾い、その語だけひらがなへ書き換えます。ほかの文字とタグは変えずに再生成。前の音声と聴き比べ、狙った読みになったかを確かめてください。
→ 一文で比べる
同じ1文で、タグなしと、タグだけを変えた音声を作ります。尺を確かめ、音量は ffmpeg の astats で測って、実際に聴き比べてください。方言は、台本の文字を方言に書き換えて作り、文字起こしで台本と照合します。
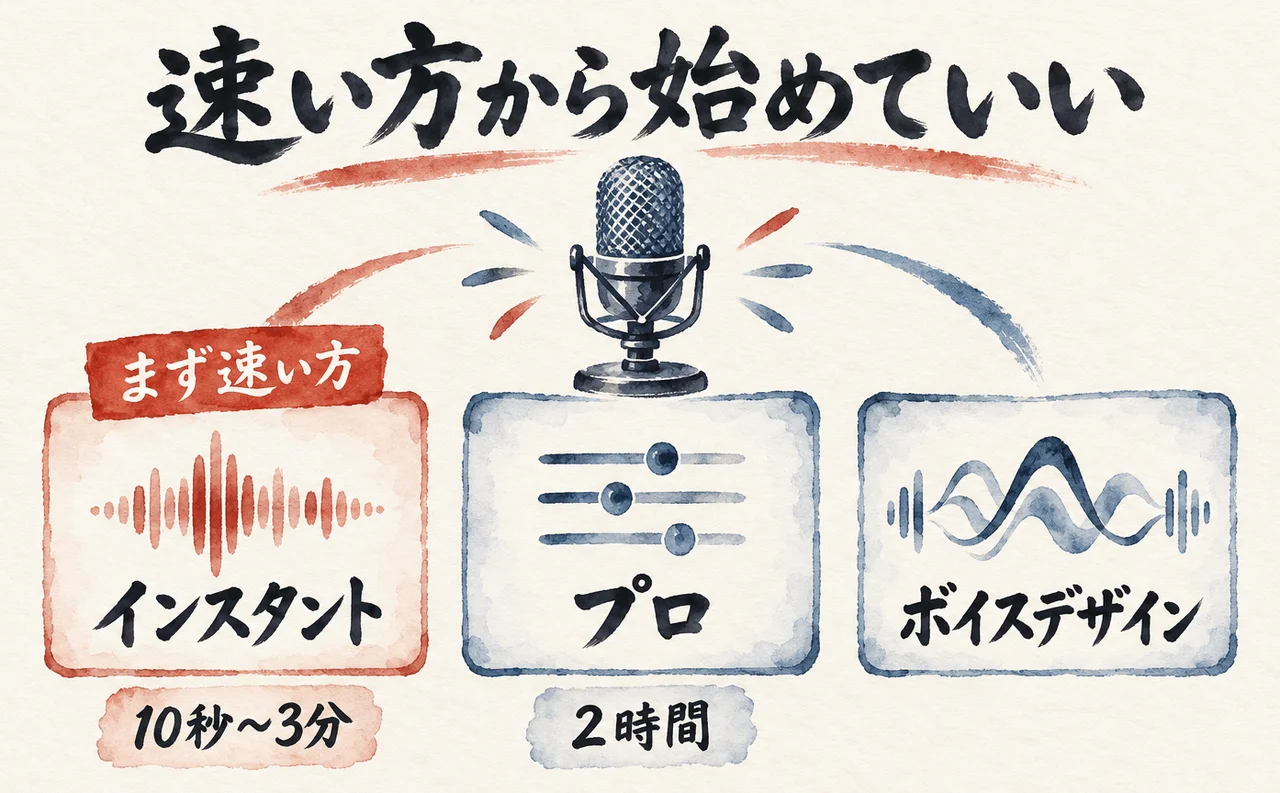
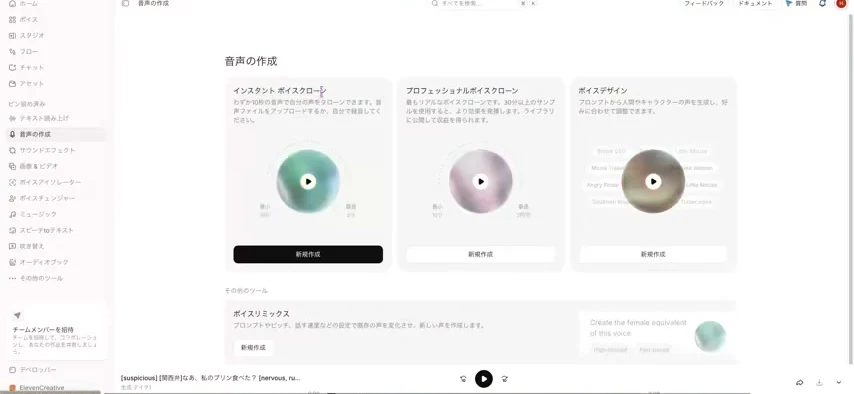
自分の声を登録する画面には、インスタントボイスクローン、プロフェッショナルボイスクローン、ボイスデザインが並びます。録音を使う方法にも、必要な長さの違いがある。Harutaさんは、その違いをこう説明しています。
Harutaさん(動画の中で・自動字幕・6:03〜)
「10秒から3分ぐらいの録音とかを投げて作らせるタイプでプロフェッショナルはもうめっちゃ長いもの2時間ぐらいの素体があったら忠実に再現されますよっていう感じで」
自分の声は、速い方から始めて十分です。まず短い録音を登録し、自分が使う台本で声を作る。長い素材をそろえる前に、使える所まで進めたい。
声の近さを比べた記事に、こう残しています。
私の記事(2026年10月5日)
「ElevenLabsの声は、この一文を含む30秒の録音から作っています。だからElevenLabsは少し有利な条件です。」
本物の私(生の声・7.5秒)
ElevenLabs v4 Turbo(私のクローン)
VoiceStudioで自分の声をボイスクローン。ElevenLabs v4 TurboとGemini 3.8 TTSとも聞き比べ
比較した同じ一文では、本物の私の声を1.000とした近さが、ElevenLabs v4 Turboで0.901〜0.922。本物の私が別の場面で話した声でも0.937でした。
録音に比較用の一文が入っている条件も、忘れたくない所。
その声を講座の本番ナレーションに使っています。動画のHarutaさんは、YouTube動画から音声をAIに切り出させ、長い素材でプロ版を作ったと語っています。
動画内の説明では、インスタントはスターターから、プロフェッショナルはクリエイターから。私なら、まず短い録音で自分の用途に合う声を作ります。
→ 30秒の声を用意する
自分の声を30秒録り、インスタントボイスクローンに登録します。その声で、実際に使いたい台本の1行を生成。録音した声と並べて聴き、声の近さと読みの正しさをそれぞれ確かめましょう。
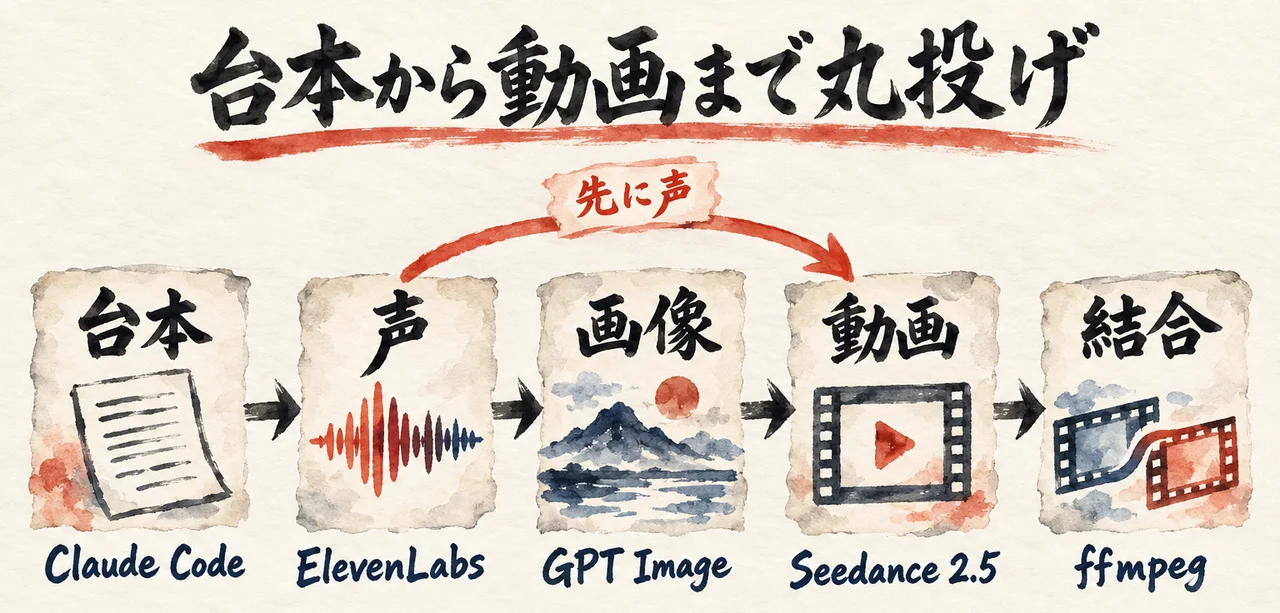
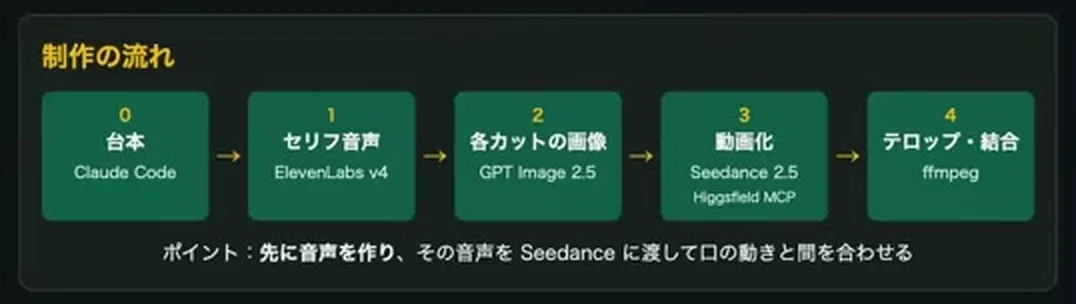
台本をClaude Codeで作り、ElevenLabsで声にし、画像から動画へ進める。動画の流れ図では、テロップと結合までつながっています。先に作った音声をSeedance 2.5へ渡せることが大きい、とHarutaさんは強調しています。
Harutaさん(動画の中で・自動字幕・16:05〜)
「そのイレブンラボで作った素材をリファレンスしてCダンス2.5に投げれるってのがでかいんすよ。これAPI連携、MCP連携ができてるからこんだけ簡単にできるんですよね。」
字幕の「イレブンラボ」はElevenLabs、「Cダンス2.5」はSeedance 2.5のことです。
台本から結合までを任せる設計は、私も使いたい。声を作って終わり、画像を作って終わりでは、動画になるまで人がつなぐ手間を持ち続ける。その続きも任せたいよね。
動画の画面では、Claude Codeの台本から、ElevenLabs v4のセリフ音声、GPT Image 2.5の画像へ進みます。Seedance 2.5とHiggsfield MCPで動画にし、テロップを重ねて結合。
先に音声を作り、その声に口の動きを合わせる順番です。Harutaさんは、43秒の架空ニュースを約20〜30分で作ったと語りました。
私の通販番組パロディは逆で、元の映像に日本語の吹き替えを重ねました。記録には「無音を削ってから置きます」とあります。音声の前後に付いた無音を削った場面です。
同じ声づくりでも、映像に声を合わせるか、声から映像を作るかで順番が変わる。これから作るなら、まず1カットで声から動画までつなぐ。それが私の入口です。
→ 声から1カットをつなぐ
台本を1カット分だけ書き、ElevenLabsでセリフ音声を作ります。次に開始画像を用意し、音声をリファレンスとしてSeedance 2.5へ渡す。口の動きとセリフが合うか、出来た動画で確かめます。
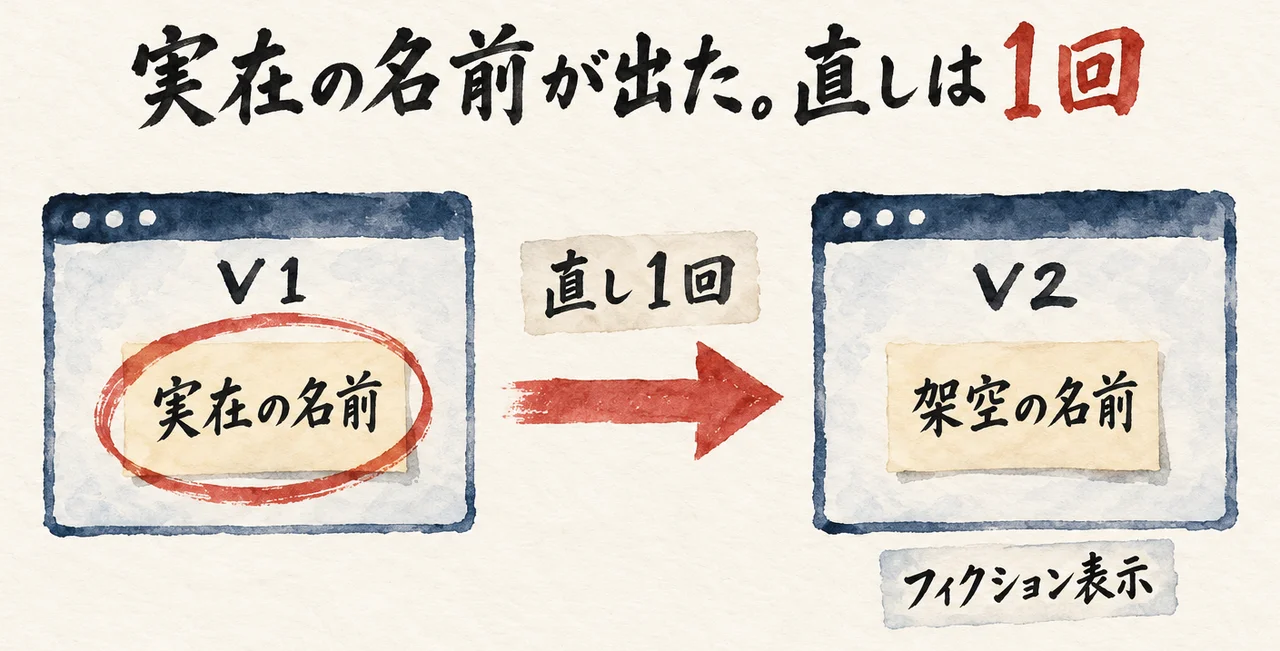
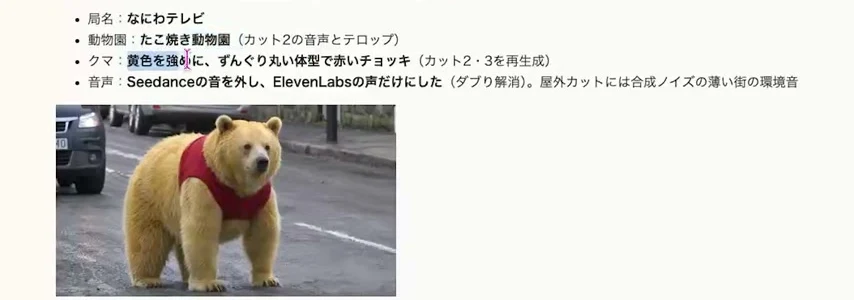
最初の架空ニュースには、実在の動物園の名前が出て、クマも黄色く見えませんでした。そこで名前と見た目を変えて作り直し。Harutaさんは、最初の版から次の版への修正について、こう語りました。
Harutaさん(動画の中で・自動字幕・13:34〜)
「1回も僕修正してないですよ。このバージョン1からバージョン2に修正したぐらいで他をもう何も指示してないていうぐらい出てきました。」
任せ切る前に、人が出来上がりを見る仕組みが先です。直す指示が1回で済んだことより、直す場所を人が見つけたことが大事。私はそこを、自分の目と耳で確かめます。
架空のニュースでも、実在の名前が混ざれば、意図した内容から外れます。映像がよく出来ているほど、名前もそのまま見過ごしたくなる所。
動画ではHarutaさんが、実在の動物園の名前と、クマの色を直す場所として挙げました。局名を「なにわテレビ」、動物園を架空の名前に変え、クマは黄色を強めて赤い服へ。
画面には「※この映像は、AIで生成したフィクション」の表示もあります。表示を付けることと、内容の固有名詞を見直すこと。両方が必要だと思います。
作例の良さを、見ていない所まで広げない。任せる範囲は広げていい。確認する対象は、具体的に決めておく。
→ 名前を全部拾う
出来上がった1本から、人名・地名・施設名・局名を全部書き出します。実在か架空かを分け、架空の話に混ざった実在名を変更。直した動画を見直し、音声とテロップの両方で名前を確認してください。
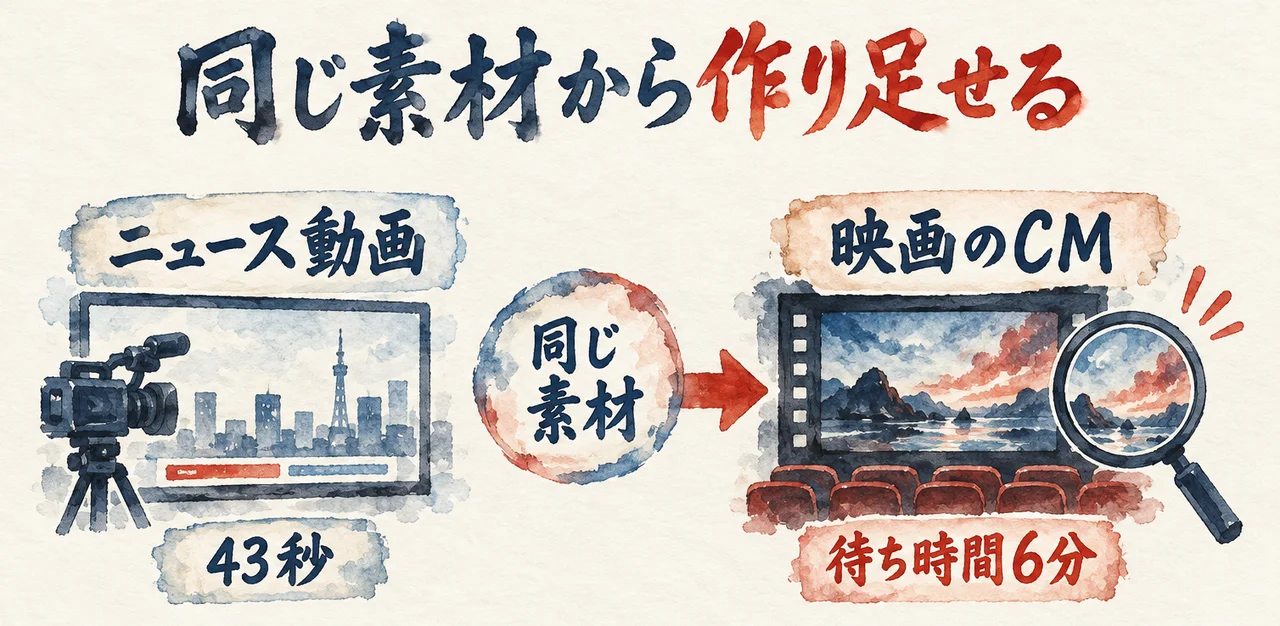
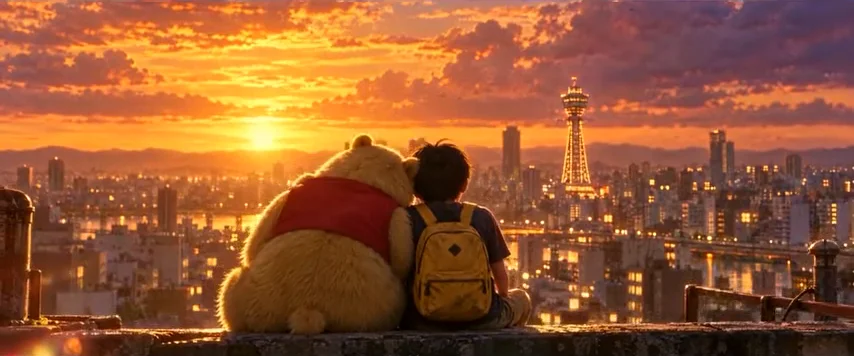
作った動画の素材を使って、別の見せ方まで作り足せる。Harutaさんは、43秒の架空ニュースを作った流れの続きで、動物園から逃げ出したクマと少年の物語を、映画が実際にあるような予告CMにするよう頼んでいました。
Harutaさん(動画の中で・自動字幕・14:46〜)
「今この作った流れに対して、ま、これを映画の一部として実際にこの映画があるようなCMを作ってくれと。」
同じ素材から別の形を作り足す。声と画像を作って終わりにせず、予告や短い紹介へつなげれば、伝えたい内容を別の入口から届けられます。
Harutaさんは、元の動画も使いながら新しい場面も作ってくれた、と語っています。画面には、赤い服のクマと黄色いリュックの少年が並んで座る姿も出ます。広げるほど、名前や姿を見比べる場所も増える。新しい場面でも服と持ち物がつながっているか、そこまで見て届けたいですね。
→ 声と画像から次へ
1カット分の声と画像を作ったら、同じ素材でもう1本、予告や告知を作るようAIに頼んでみよう。できた映像で、人物の服の色が元の画像と同じか見比べてください。
Q. この動画には誰が出演していて、長さはどれくらいですか?
A. 「[動画生成AI] 始め方_How To チャンネル」のHarutaさんです。2026年10月8日公開で、長さは17分19秒。Eleven v4の日本語、自分の声の登録、Claude Codeなどと連携した動画づくりを紹介しています。
Q. 関西弁にするには、タグを付ければいいですか?
A. Harutaさんは、台本の文字そのものを関西弁に書き換えるのが基本で、文字だけでは方言に聞こえにくい台詞に、タグを足すと語っています。咳払いや演技の指定と、方言の言葉づかいを分けて直すと、触る所が決まります。
Q. 自分の声を登録できるプランはどれですか?
A. 動画内では、インスタントボイスクローンはスターターから、プロフェッショナルボイスクローンはクリエイターからと説明されています。また、Harutaさんはフリープランでは商用利用できないと語りました。使う用途と声の登録方法を合わせて選ぶ所です。
Q. 読み間違いが出たら、どう直しますか?
A. 読み間違えた語だけをひらがなに書き換えて、同じ行を作り直します。私の別の吹き替えでも、「楽しそう」の読み間違いをひらがなで直しました。直したら、その行をもう一度耳で聴いて確かめます。
声から動画まで任せられる流れは、使いたい。そのうえで、私が自分でやるのは、出来上がりを聴くことです。演技はタグで、方言や読みは文字から直す。触る所が決まれば、やり直しも具体的になる。
今日の1手は、自分の台本の最初の1行をv4で作ること。耳で聴き、文字起こしと照らして、読み間違いがあれば文字を書き換えて作り直す。その1行から、自分の声、1カットの動画へつなげていけばいい。
COLUMN
楽譜の書き込みと、声の直し方
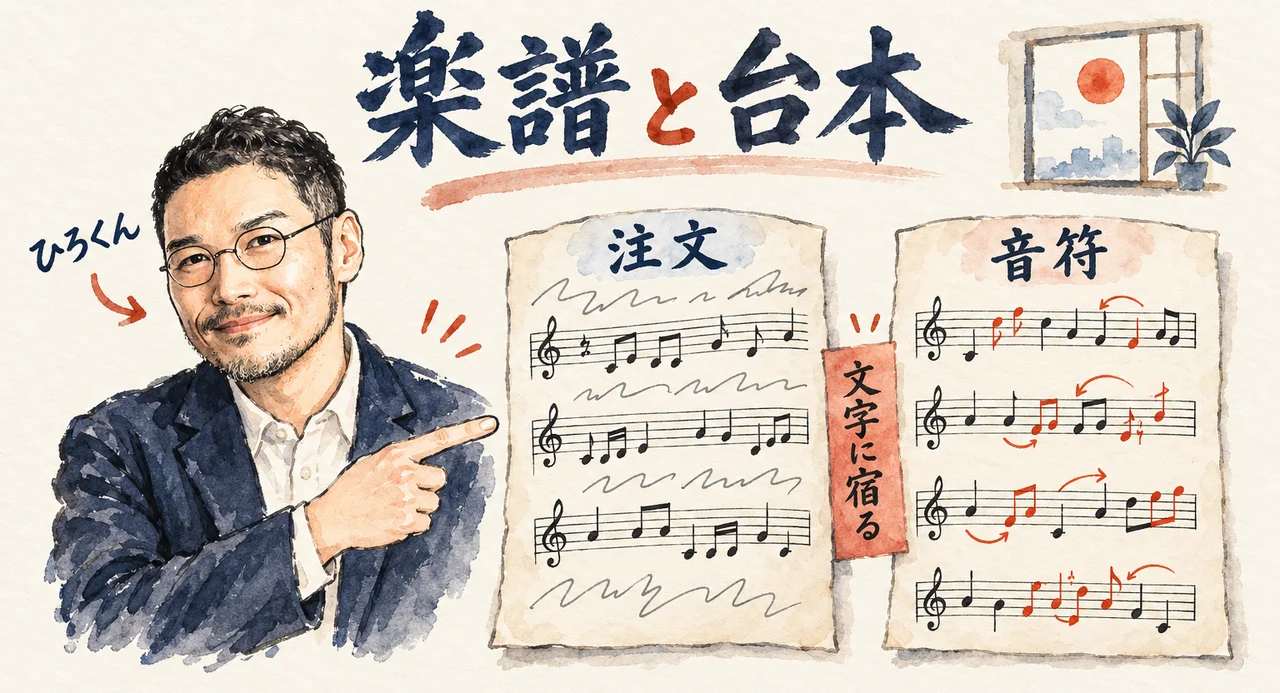
たとえるなら、楽譜の書き込みです。「もっと元気に」と鉛筆で書いてあっても、演奏する人によって音の強さや速さには幅が出る。同じ注文を読んでも、頭の中で鳴っている音まで同じにはなりません。声の演技にも、その幅があります。「疲れた様子」と付けたから、欲しかったため息の深さまで決まるわけではない。指定を読んだことと、狙った音になったことは別。だから私は、注文を足した回数より、返ってきた声のどこが違うかを聴きたい。
音符そのものを書き換えるのが、台本の文字を直すことに近い。「もっとこう読んで」と頼むだけでなく、読んでほしい形を文字に置く。私が日本語の読みをひらがなで直したのも、その場所でした。ただ、文字の書き換えで声の表情まで同じになるわけではありません。音符が音の位置を渡し、書き込みが表情の方向を渡すように、言葉と演技は別々の働きを持つ。片方だけに全部を背負わせると、直したい所が見えにくくなります。
演技は注文書だけで完結せず、台本の文字にも宿る。どんな言葉を選び、どこで切り、何を言わせるか。その形が声の出発点になります。でも、台本の上で思い描いた声と、実際に鳴った声の間には確認が要る。楽譜を整えたら、一度演奏して聴く。それと同じです。全部を手で作る必要はありません。生成も修正もAIへ任せながら、欲しい表現に合うかを耳で確かめる。やり直しは、委ねることの失敗ではない。任せた声を自分の用途へ近づける、次のひと手です。
任せ方の考え方は、分身AI日記のDAY160「賢いAI」より「委ねるAI」にも書きました。分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
台本9行を5本の声で聴き比べた記録です。第1章の一致率と、感情タグを読み上げた行の数の出どころを確かめたい時に
別の動画で、Eleven v4が日本語の数字をどう読むかを見た記事です。数字の読みが気になる時に
自分の声のクローンを、ElevenLabs v4 Turboとローカルで比べた記事です。第3章の、30秒の録音と声の近さの数字を確かめたい時に
映像に日本語の吹き替えを重ねた手順です。第2章の読みの直し方と、第4章の無音の削り方を確かめたい時に
ElevenLabsのEleven v4とv4 Turboの発表を取り上げたニュース解説です。発表の中身を先に知りたい時に
参考リンク
今回紹介した動画本編。時刻つきの発言は、ここで確かめられる
今回紹介した動画
| タイトル | 【神AI】ElevenLabs V4の日本語がヤバい|関西弁まで自然に話す音声AI |
| チャンネル | [動画生成AI] 始め方_How To チャンネル |
| 長さ | 17分19秒 |
| URL | https://www.youtube.com/watch?v=mu3SzoQPm1o |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!