WATCH REPORT
Muse Wonderのベンチマークを、Metaの表と外の会社の測定に分けて動画で読む
2026.10.13
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、まさおAIじっくり解説chの『【徹底解説】Metaの最先端モデル『Muse Wonder』公開!長い開発と記憶で Opus 5.5 超え!? 一方で3Dに弱い等の指摘も【AI解説】』の動画を紹介するね。
Muse WonderがOpus 5.5超えと言われているのを見かけたものの、どの数字の話か分からず、乗り換える価値も判断できない。24分54秒を通しで見る時間もない。そんな個人事業主や経営者に向けて書きました。
YouTube「まさおAIじっくり解説ch」の動画です。24分54秒、2026年10月12日公開、日本語で、説明役のまさおと聞き役のエレンが話します。台本・図・声はAIが作ったものです。
まさお(動画の中で・0:37〜)
本質的には[Opus 5.5]とは得意な仕事が分かれてるんです。公式の成績表では長い開発と前の話を覚える力は[Opus 5.5]より上で短いコード書きと画面を動かす仕事は負けています。
動画は10の章ですが、記事では6つの章に束ねて、動画の順に整理しました。
読んでほしいのは、数字の出どころです。どの数字を誰が測ったのかを分けて読むと、Opus 5.5超えの意味が見えてきます。
SPEAKER
まさおAIじっくり解説ch
出演: 説明役のまさおと、聞き役のエレンです。台本・図・声はAIが作った動画で、声は合成音声です。
2026年10月12日の公開、日本語です。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)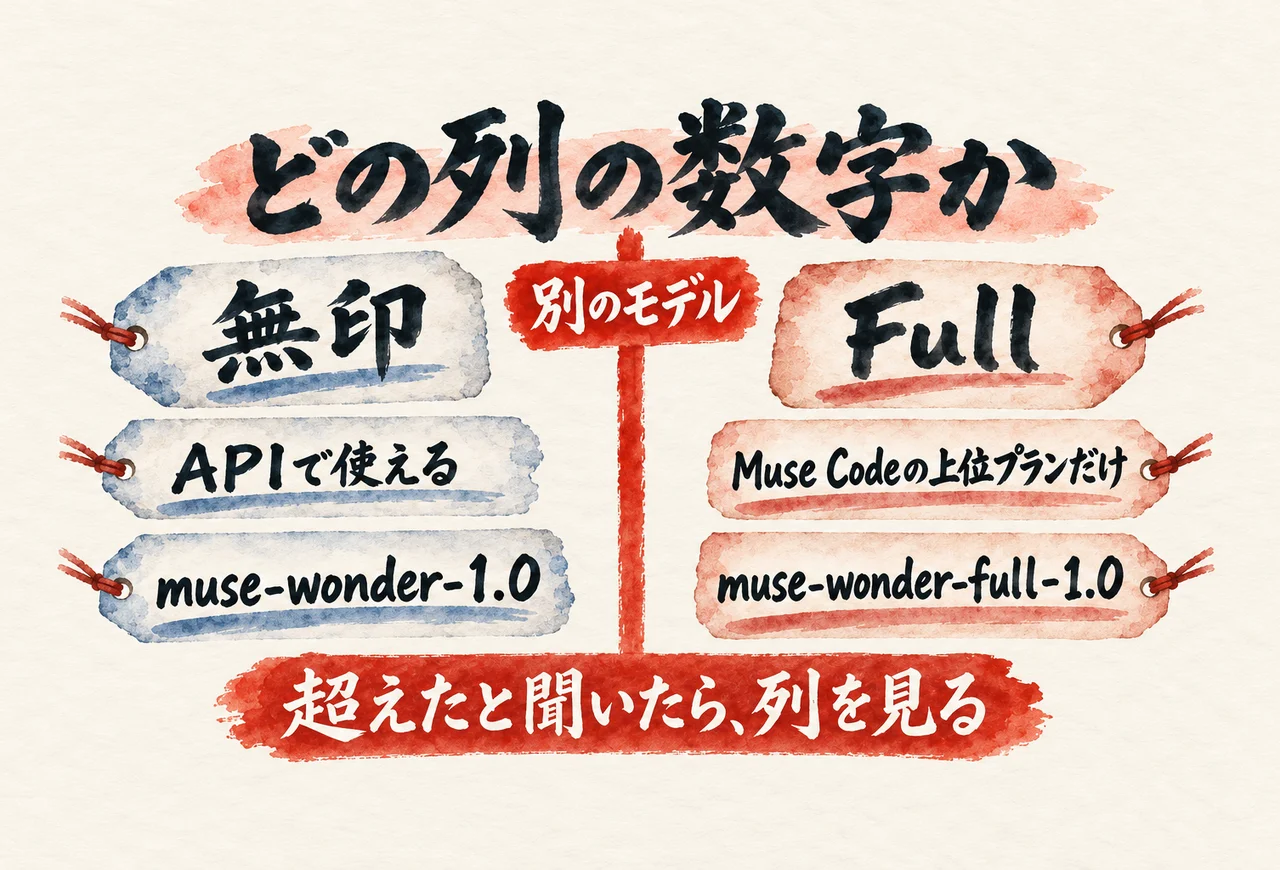
「Opus 5.5超え」と聞く。最初に見るのは、どの列の数字か。まさおは、まずMuse Wonderが2つあることを話します。動画の数字は2種類あります。画面に出るものと、声だけで語られるものです。声だけの数字は区別します。動画で語られた数値と書きます。
ベンチマークを読む時も、数字は分けて読みます。Metaが自分で測った数字(Metaの表)と、外の会社が測った数字です。
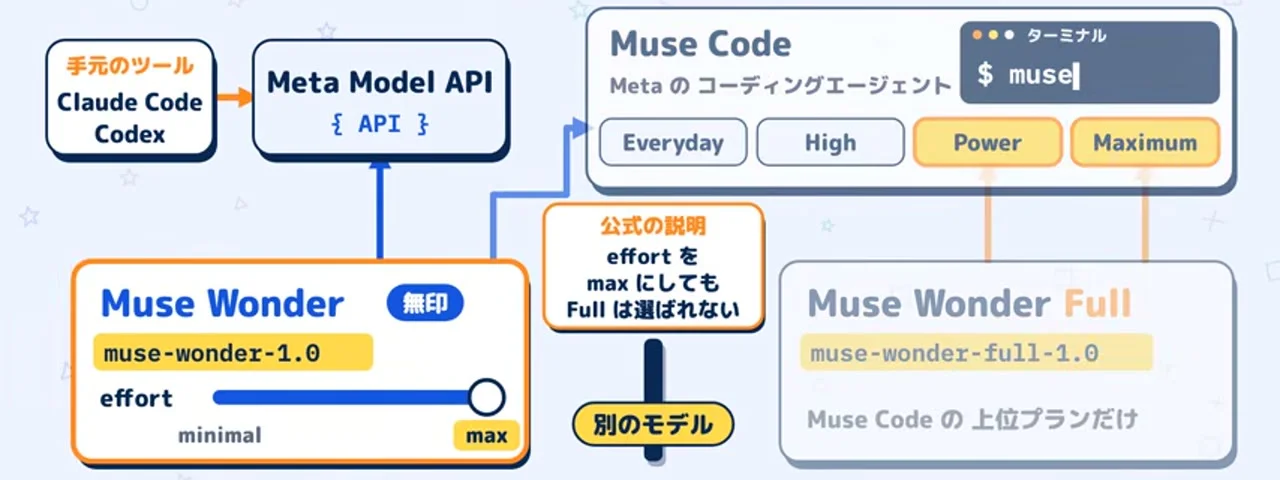
上位のFullはMuse Codeの契約でしか使えず、APIで呼べるのは無印だけです(1:21)。動画の画面のモデルIDは muse-wonder-1.0 と muse-wonder-full-1.0。Muse Codeのプランは4つあり、Fullを使えるのは上の2つ、PowerとMaximumです。
まさお(動画の中で・2:00〜)
そこが違って公式の説明にはエフォートをマックスにしてもフルは選ばれないと書いてあるんですよね。モデルのIDも別々についていてフルは無印の考える量を増やしたものではなく別のモデルなんです。
無印は、OpenAI互換のツールから接続先を替えるだけで呼べます。Fellow AIという解説サイトの比較では、無印がOpus 5.5を上回るのは14行のうち5行です。
MuseはMetaのアプリの名前でもあり、モデルのMuse Wonderは近いうちにそのアプリでも使われると書かれています。今回のモデルは、最初のモデルMuse Sparkの土台の上に作られたそうです。
まさおとエレンのやりとり(動画の中で・3:21〜)
[…]メタの研究ブログは作り直しを終えて最前線で[先頭]を走る側に移ったと書いてます。でも最前線に移ったって言ってるのはメタ自身だよね。
Artificial Analysisの総合点は、画面(3:54)でMuse Wonderが52、Opus 5.5が58です。一番上はOpus 5.5でした。
「Opus 5.5超え」は、APIで使える無印の列の話です。総合点で一番上にいるのはOpus 5.5です。ここは分けて読みます。
「最前線に移った」と言っているのは、Meta自身です。エレンも、そこを突っ込んでいます。
発表の全体像はMuse Wonderの発表を日付順に整理した記事に、アプリのMuseの話はアプリのMuseを動画で解説した記事にまとめてあります。この記事では、成績表の読み方に絞ります。
9月30日の朝LIVEで、私は6.1(GPT-6.1 Sol)の話をしました。「アストラ並みの性能でコストが安い」と言われているけれど、私は「そんなことない」と思う、と。Solがオーパス(Opus)を超えたという話も、「どこでも聞く話」なんですよね。
同じLIVEで、「どのモデル触ったらいいのか」「エフォートって何ですかね」とも話しました。AIを触っている人にも、分かりにくいんです。
10月2日の朝LIVEでは、6.1を使ってみた感覚として、品質は全然Astraのレベルではないけれど、「かなり賢いので十分使える」と話しています。
無印とFullの違いは、その分かりにくさの実例です。名前が似ていても、中身は別のものなんです。
超えた、と聞いたら、まず、どの列の誰が測った数字かを聞きます。名前が同じでも、列が違えば別の話になるからです。
まさおは、Muse Wonderが売りにするActive Focusを説明します。冒頭の七角形の例も、この力の例です。
まさお(動画の中で・4:41〜)
[Muse Wonder]が売りにしているアクティブフォーカスは作業が難しくなってもゴールに向けて働き続ける力です。例えば行き詰まったら別のやり方を試して壁を超えます。
公式の動画は「諦めないよう訓練した」と言います。進め方は立て直します。途中で新しいことが分かった時です。重要な操作の前には、確認を取ります(5:02)。
まさお(動画の中で・0:12〜)
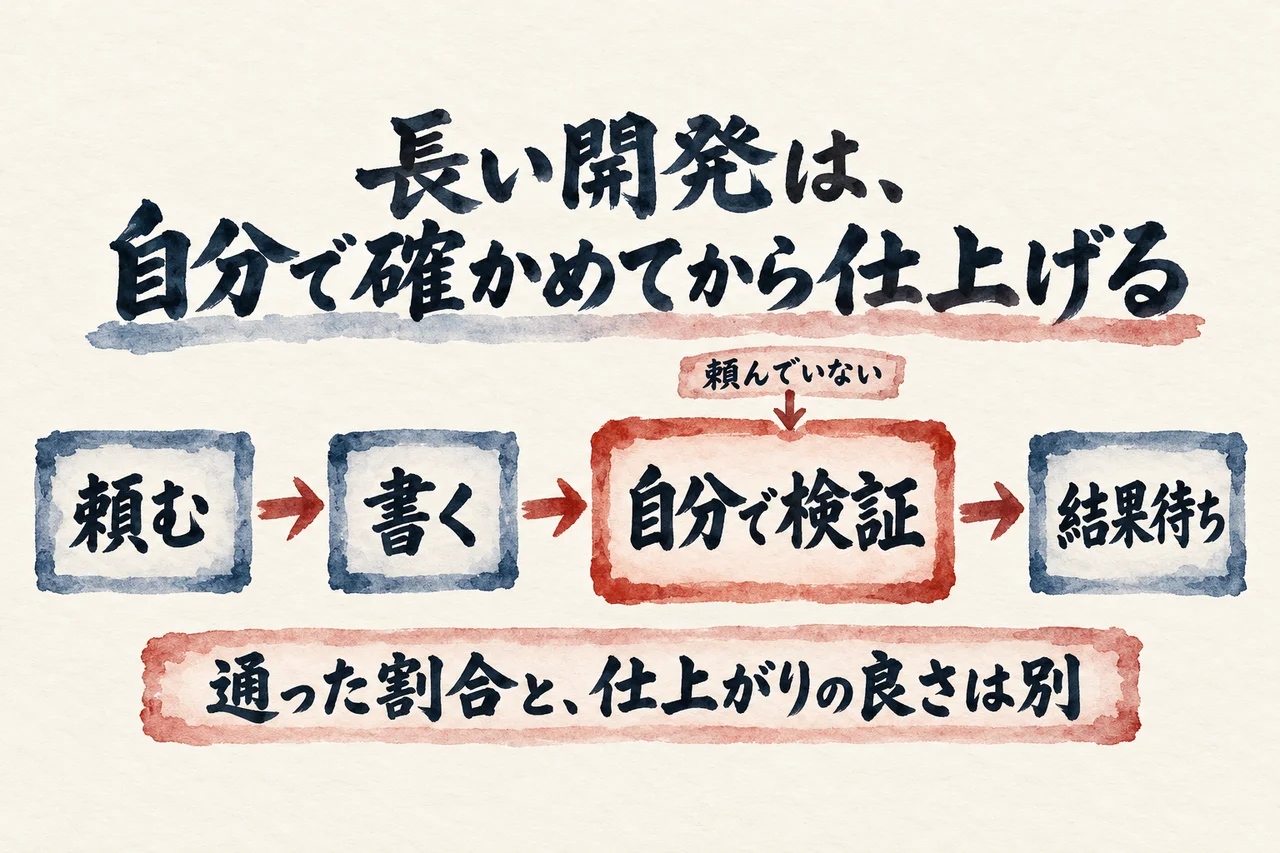
実際にオープンコードっていうターミナルで動くAIの開発ツールで回る七角形の中をボールが跳ねる画面を頼みました。そしたら頼んでないのにボールが壁を突き抜けないかを自分で確かめてから仕上げたんですよ。
画面の手順の図は、頼む、書く、自分で検証、結果待ちの流れです(5:27)。
まさお(動画の中で・5:47〜)
ボールの回り方の式を探して手を入れてもう一度確かめてます。壁抜けも重なりもないと自分で確かめてから仕上げるのがまさにアクティブフォーカスの動きです。
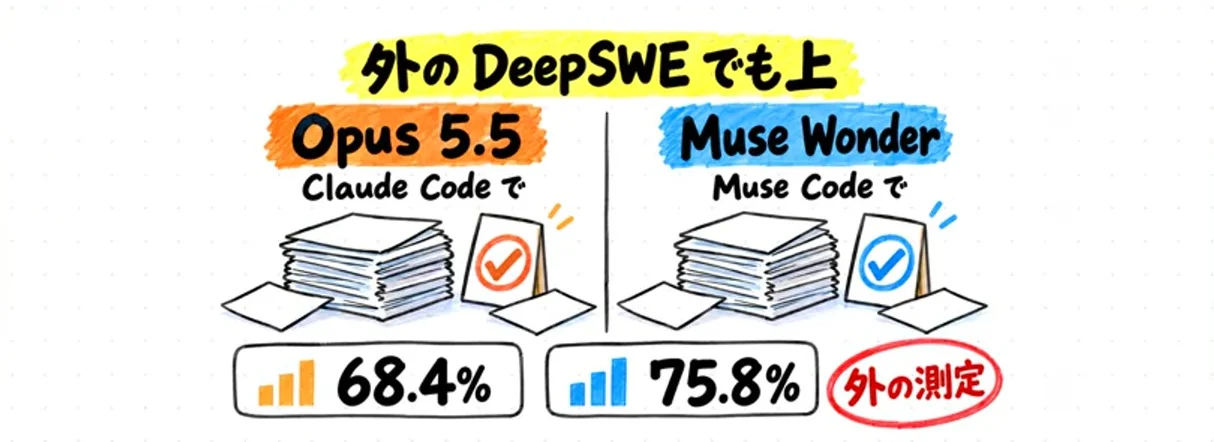
DeepSWEは、長い開発の課題です。SWE-Marathonは、さらに長い開発プロジェクトです。Metaの表では、どちらも無印がOpus 5.5より上です。DeepSWEの外の会社の測定は、画面(7:00)でMuse Wonderが75.8%、Claude CodeのOpus 5.5が68.4%。SWE-Marathonは、Metaの表だけです。
まさおは、Muse Wonderが頼んでいない検証まで自分で走らせて仕上げた、と話します。
75.8%は、1回目で通った割合です。通った割合と仕上がりの良さは別の物差しなので、通ったからといって、中身が良いとは限らないんです。
私はセミナーで、AIは「やった後に嘘つくときがある」と話していました。だから本当にできているかは、「サブエージェントでチェックして」と。
「違う脳みそでチェックする」んです。「同じ脳みそでやると嘘つくんですね」、と。
動画は、頼んでいない検証を自分で走らせる話です。私が話したのは、できたと言った本人とは別の目で確かめる話です。どちらも「できた」を信じる前に確かめる、という点でつながります。
長い仕事は、頼む前に決めておきます。できたという報告の後に確かめる役です。頼んだ側とは別の目か、別のAIを置きます。確かめる役が決まっていないと、困ります。報告の言葉をそのまま信じることになるからです。
エレンが聞きます。使うツールが会社ごとに違ったら、比べたことにならないのでは、と。まさおは、ハーネスの話をします。
まさお(動画の中で・7:27〜)
そこで出てくるのがハーネスでモデルに作業をさせる周りの仕組みのことです。[…]を変えるだけで同じモデルでも点は変わるんですよね。つまり別の会社の[DeepSWE]の点もモデル単体でなくツールと組み合わせて測った点です。
SWE-Marathonは同じツールの比較ではないと、モデルカードが書いています(7:44)。
Metaの社内の総合点(Personal Superintelligence Index)は、Fullが59.1、無印が54.3でOpus 5.5の下です。
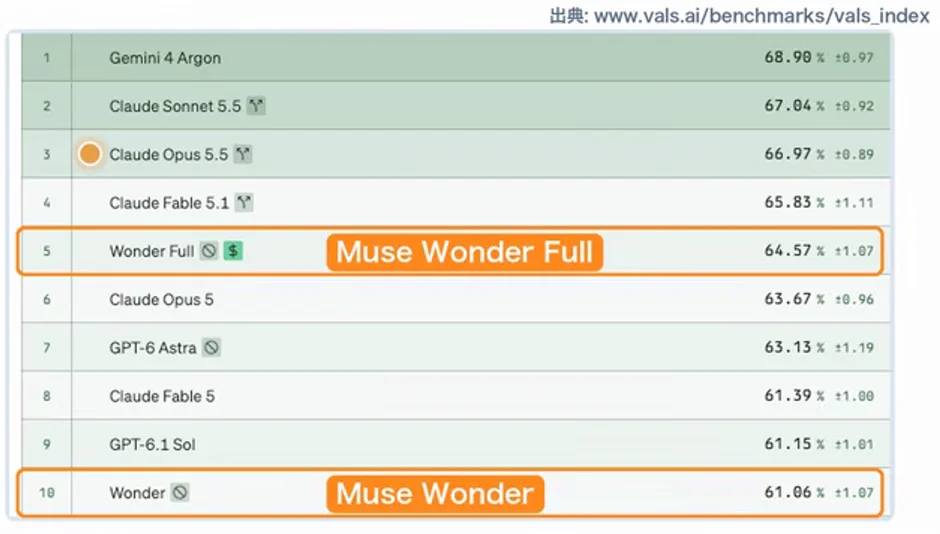
Vals Indexは、金融・開発・法律・税の仕事のテストを平均した点で、Opus 5.5が3位、Wonder Fullが5位、無印が10位です。
無印はOpus 5.5の下です。Automation Benchは、Metaとは別の会社が測った、業務の長い仕事の点です。
Active Memoryは、会話をまたいで大切な文脈を持ち、作業に要る細部を自分から取り出す力です。
まさおとエレンのやりとり(動画の中で・11:01〜)
まだこのデモには全体を短く編集してあるって注意書きがついてるね。そうなんです。なのでデモは何ができるかの見本としてみて強さは成績表で確かめましょう。
MemoryBenchは、関係ない会話や書き変わる情報を混ぜて思い出せるかを見るMetaの社内テストで、無印が85.6、Opus 5.5が81.5です。
まさお(動画の中で・12:10〜)
1番高いのは上位版よりこっちの方なんですよ。比べる相手の[Opus 5.5]は81.5です。ただ[TechCrunch]はこの点数はメタ自身が[測った]もので自分たちでは確かめていないと書いてます。
点は、モデルだけでは決まりません。周りの仕組みで変わります。同じモデルでもツールが違えば点は動きます。
業務の長い仕事では、無印はOpus 5.5の下に並びます。Vals Indexでも10位です。長い開発で上だった無印が、ここでは下に回るんです。
10月4日のLIVEで、私は、Fable 5.1をマスターエージェントにして、その1人に話せば全部済む、という状態を作っていた、と話しました。
「めちゃくちゃ賢い」し「よくやってくれてた」けれど、柔軟性が欠けることと、コンテキストの圧縮がうまくいかないことが「めんどくさかった」んです。
そのあと話したのは、別のAIのdotsのことです。メモリをちゃんと組んでいて、よしなに分かってくれる。コンテキストの処理は「めちゃくちゃ優秀」。
ただ、事実性が相当高いので「怖いっちゃ怖い」、とも話しました。
動画の記憶ベンチはMeta自身の測定です。
AI共創OS(私の仕事のメモを検索する仕組み)の検索を良くする試験の場面です。9月30日、AIの報告では、良くなったと見えた2問は、メモの元になった質問と同じAIが書いた言い換えでした。
確かめるには、別のAIが記録だけを読んで書いた質問で、測り直す必要がある、とのことです。9月30日に「別のAIの質問で測り直す」を選び、10月1日の朝には「本番の検索で測る」を選びました。
本番の検索で測ると、上位5件に入る率は87.5%のままでした。順位が上がった問が14、下がった問が14で、入れ替わっただけです。結論は、今は検索の本番に入れない方がよい、でした。
記憶の力は、測る人と問いの書き手を分けて、測り直してから決めます。動画の点だけでは、決め手にしません。
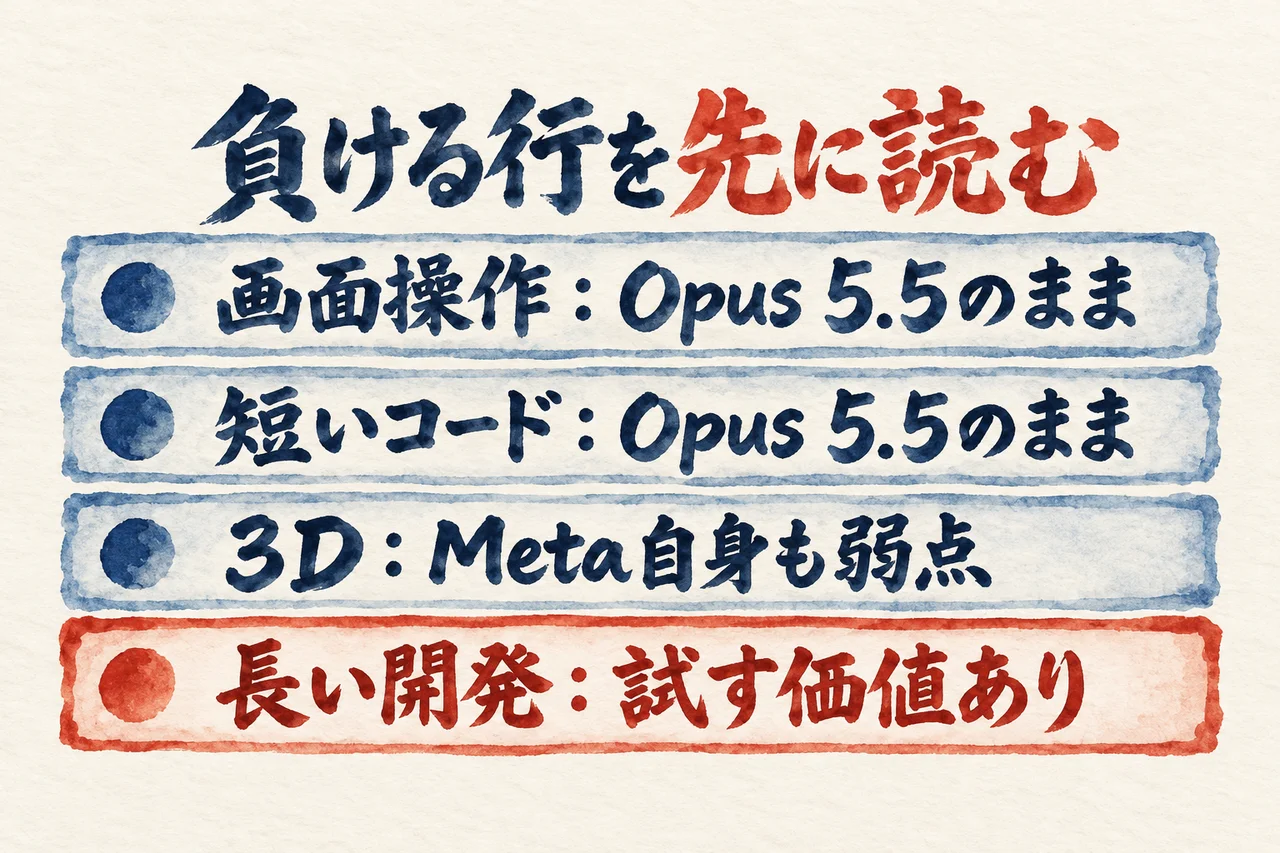
ここからは、Muse Wonderが負ける行の話です。短いコード書きと画面操作です。Metaの成績表でもOpus 5.5が上です。まさおは、負ける行も読み上げます。勝つ行と同じ順番です。
まさお(動画の中で・12:52〜)
ターミナルベンチはターミナルでコマンドを打ちながら開発の課題を解くベンチマークです。メタの成績表のこの正解率で[Opus 5.5]は59.6です。[…]メタは自分の表で負けを認めてますね。
まさおは、短いコードの行は、Metaが自分の表で負けを認めている、と話します。同じ行で、Fullは57.1、無印は52.0です(13:14)。この行はArtificial Analysisの点で、元のグラフでも無印はOpus 5.5より下です。
まさお(動画の中で・14:33〜)
でもメタ自身の成績表で見ると画面操作では[Opus 5.5]に負けてるんですよ。[…]つまり画面を見て操作する作業は[Opus 5.5]が上で3Dの絵を作るような仕事はメタ自身も弱点と書いています。
OSWorldは、パソコンの画面で作業をやらせる試験です。部分点(途中まで進んだ分も点)で見ると、無印は72.6と表の中で一番低く、一番高いのはOpus 5.5の81.8(Anthropicが出した点)。
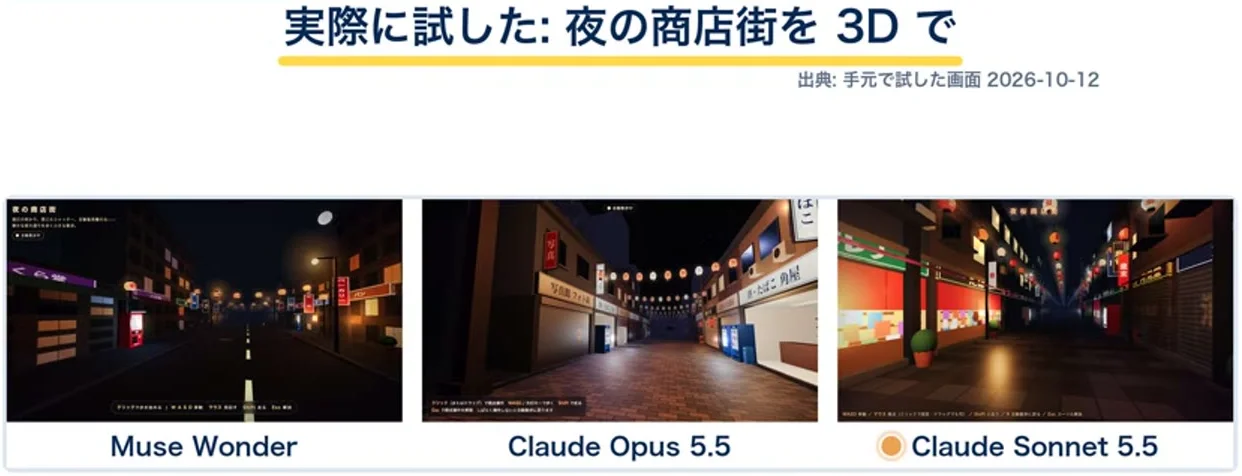
苦手は3Dにもあります。Metaの説明書は、形や物の位置関係を考えるのは「弱点」と書いています。夜の商店街を同じお題で作らせた実験(16:21)では、Muse Wonderの画面は白い線の引かれた広い車道でした。Opus 5.5とSonnet 5.5は、細い道でした。実験をしたのは動画の制作者です。
画面操作は、AIが画面を見て、クリックや入力で人と同じようにアプリを動かすことです。
画面操作の列は、Metaの自分の表でもOpus 5.5が上です。乗り換える材料は、画面操作の列には今はありません。
3Dの行は、ほかの行の強さで埋めません。Meta自身が弱点と書く領域だからです。
別のモデルとの10番勝負と仕事の振り分けの考え方は、Opus 5.5とGPT-6 Solを10の課題で並べた記事に書いてあります。
画面操作と短いコードは、毎日の仕事の中心になりやすい作業です。ここで負けている行がある限り、乗り換えの理由は長い開発の側に探します。
動画の結論どおり、長い開発は試す価値があり、画面操作と短いコーディングはOpus 5.5のままにします。
海外の記事に、Muse Wonderは知識が弱いと書かれています。まさおは、2つを別の話として並べます。作り話が少ないことと、費用です。物知りかどうかとは、切り分けて聞きます。
まさお(動画の中で・17:42〜)
でも知らないのに間違える作り話の割合は低い方です。つまり低いほどを知らない時に正直だということになります。[…][Muse]の強みはたくさん知っていることではなく知らない時に作り話をしにくいところです。
元はArtificial AnalysisのAA Omniscienceで、正解率はMuse Wonderが一番低いです。作り話の割合は、Opus 5.5が58.6%、Muse Wonderが26.5%(低いほどよい)です。
例は、作り話です。社内の決まりに無い問い合わせに、無い決まりをそれらしく返します。
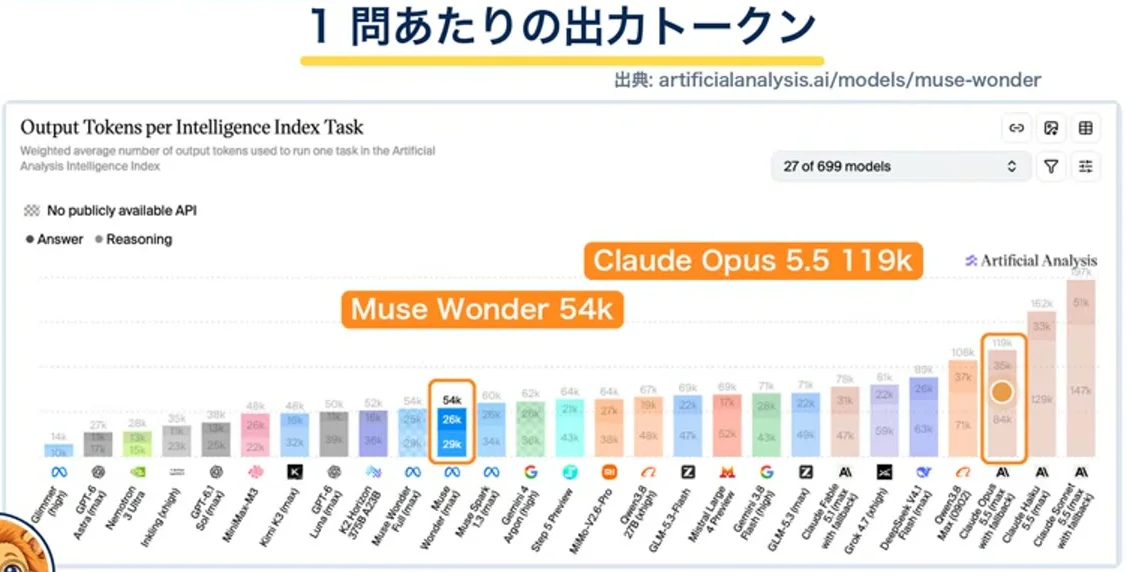
Museの料金表は、Opus 5.5と全く同じです。作業1回のお金は、出力トークンの量で決まります。1問あたりの出力は、Muse Wonderが54k、Opus 5.5が119kです(19:28)。
まさお(動画の中で・19:42〜)
で、その結果が同じテスト1問あたりの費用です。[Muse]は1問4.52ドルです。それぞれのAPIの値段で数えたテスト全体の平均なんですよ。
動画で語られた数値では、Opus 5.5は同じテスト1問で5.98ドルでした。VentureBeatは、1問あたりならGPT-6 Astraの方が安いと書いています。
まさおとエレンのやりとり(動画の中で・20:42〜)
じゃあ乗り換る前に値段の表より自分の作業1回にかかるお金を比べた方がいいね。[Muse Wonder]は喋る量が少ない分作業ごとに安く済みます。
知らない時の返し方の話です。作り話の割合が低いと、「分かりません」「確認します」と返しやすいんです。物知りであることとは別の話です。
作り話の少なさと費用は、別々の物差しで見ます。返信文のような仕事なら作り話の割合を、費用なら作業1回の出力量を見ます。片方が良くても、別の方の根拠にはしません。
料金表が同じでも、作業1回の出力量で費用は変わります。出力が多ければ、費用はかさみます。所要時間にも響きます。
まさおは続けます。一番安いのがMuseというわけではない、と。
10月5日、ある案を選ぶ質問に、私は「ゲームによるだろ」と返しました。「かかるトークンやコストや時間にもよる」ので、「この情報で判断できん」と。案の良し悪しより先に、判断に要る情報が足りない、という返事です。
9月24日、Opus 5.5の考える深さ(effort)の既定をmediumにする案が出ました。私は「2か所ともmediumに直す」を選びました。1か所は、それまでxhighだった設定です。
そのとき判断の材料にした、思考の量が2.0〜2.4倍になるという数字は、別の動画の実測値でした。手元の実測は、その時点では取っていませんでした。
トークンの消費を見る手順は、Claude Codeの使用量の見方をまとめた記事に書いてあります。
54k対119kは、動画の画面に出た、外の会社のグラフの数字です。倍率の方は、別の動画の実測で、私が設定を直す時に見た数字でした。どちらも私の作業で測った数字ではないので、自分の作業で測るまでは、材料にとどまるんです。
費用は順番で読みます。料金表の次に、出力の量を見て、乗り換えは自分の作業1回の量を数字で書いてからにします。
試す入口は、Meta Model APIとMuse Codeです。まさおは順に話します。どこから試せて、何に気をつけるかです。
Meta Model APIは、OpenAIやAnthropic向けのコードのまま、接続先とキーを替えるだけで呼べます。OpenRouter経由で試した時、作った会社を聞かれると、Metaとは言わず「開発したチーム」とぼかしました(21:53)。
まさおとエレンのやりとり(動画の中で・22:10〜)
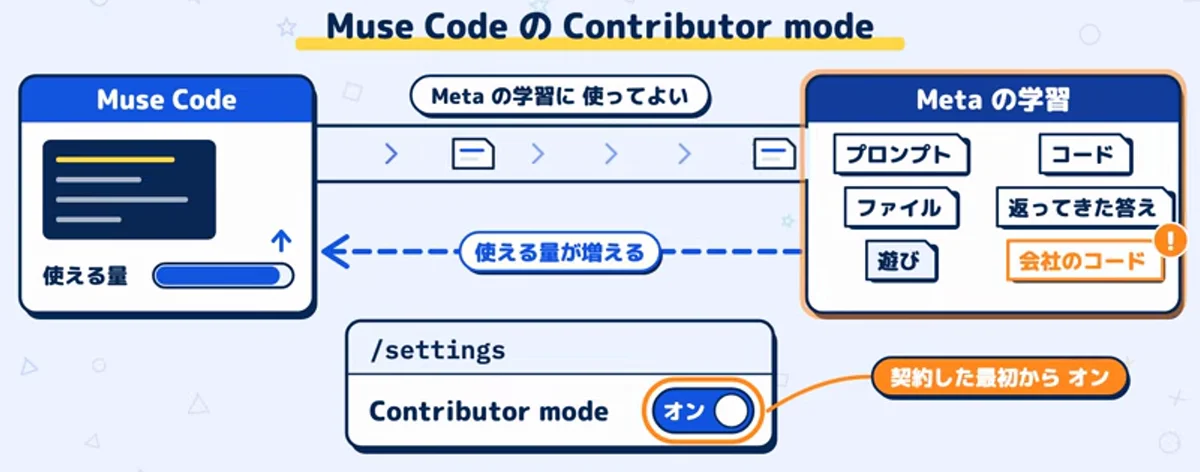
これは送った中身をメタの学習に使って良いと認める代わりに使える量が増える設定です。[…]で、これが契約した最初からオンなんですよ。遊びならそれでいいけど会社のコードだと話が変わるね。
学習に回るのは、送った中身と返ってきた答えの両方です。オフにするのは「/settings」から。まさおは、会社の仕事なら最初に切るのが安全、と話します。
日本からMeta Model APIに登録できるかは、公式のページに書かれていません。手元のパソコンでは動かせません。すぐ試すなら、無印を呼ぶのが早いそうです。接続先を替えるだけです。
まさお(動画の中で・23:28〜)
全部をよく見せた表ではなかったんですよ。[Opus 5.5]より上のところと下のところがはっきり分かれてました。例えば長い開発作業はよその会社が測っても[Muse]の方が上でした。
まさお(動画の中で・23:58〜)
そうなんです。で、記憶の成績はメタの表だと1番高いんですが、よその会社の結果はまだ見つかっていません。画面操作もまだメタの表だけで、そこでは[Opus 5.5]の方が高いんですよ。[…]長い開発なら[Muse Wonder]を試す価値があって、画面操作と短いコーディングは[Opus 5.5]のままです。
接続先を替えるだけで呼べます。設定の確認を後回しにしやすい入口でもあります。
会社の仕事で使うなら、確認が先です。試す前に確かめるのは、学習に使われる設定と、接続先が会社の仕事で使ってよい場所かどうかです。
設定は、使い始める前に見ます。使い始めてからでは、遅いんです。すでに送った中身は取り消せないからです。
日本から使えるかも、先に調べておく項目です。公式のページに書かれていないので、使えると決めてかかりません。
AIの設定を見直す手順は、Googleのデータ設定を見直す手順の記事にも書いてあります。
9月30日、私が決める場面がありました。AI共創OS(私の仕事のメモを検索する仕組み)の記録744件を、外部のAI(GLM)へ送るかどうかです。記録には、開発の記録や失敗の記録も含まれます。
新しく外へ出す量で、送った記録は取り消せません。
私は「GLMで公式どおり」を選びました。AIの報告では、秘密らしき文字列を含む68件は送らず、評価用の80問も渡っていません。
外へ出る前に決める、という点が同じです。
モデルの性能より先に、送った中身がどこへ行くかを決めます。軽い入口でも、確かめる項目は減りません。
COLUMN
新しい包丁と朝の仕込み
料理で言うと、新しい包丁を朝の仕込みに回す前の話に近いです。包丁には札が付いてくることがあります。どの包丁より切れます、と書いた札です。その札の数字を測ったのは、作った側です。作った側の調理場で測っています。嘘だとは思いません。ただ、作った側の調理場で測った数字は、そのまま信じる数字ではなくて、見本として読む数字かな、と思うんです。札を読むなら、何をどう切った数字なのかを先に見たくなります。玉ねぎを切った数字なのか、魚をさばいた数字なのか。切れ味の話ばかりなら、札は札として、脇に置いておきます。
別の人が、別の場所で、同じ包丁を使って測った数字があれば、札の隣に並べます。札と同じ向きなら、少し安心できます。見つからない項目は、札のままです。外の誰かが測るまでは、見本として置いておきます。仕込みで言えば、味見を人に頼んでからでないと、鍋には入れない、という順番です。並べて見ても、二つの数字を同じ重さでは読みません。札は作った側の言葉で、外の数字は使った側の言葉です。言葉の持ち主が違うと、同じ数字でも、背中にある事情が違うんですよね。札の隣に並べるだけで、札の言い分の確かさが、少し見えてくるんです。
いちばん確かなのは、自分の手で切った一回です。朝の仕込みのうち、玉ねぎ一山だけを新しい包丁に任せます。帳面に書いておきます。終わるまでの時間と、手の疲れ方です。魚をさばくときは、使い慣れた包丁のままです。手が覚えている仕事は、札の数字がどれほど良くても替えません。帳面の数字が札の数字の隣に並んで、はじめて、この包丁を使うかどうかを決められる。料理で言えば、そういう順番かな、と思います。朝の仕込みを丸ごと任せるのは、帳面が埋まってからでも遅くありません。新しい包丁を急いで使い込むより、先に手に馴染むかを見るほうが、あとで慌てないんですよね。
ひとつずつ確かめながら進める歩き方の続きは、分身AI.comに載せた、分身AIと100日歩んだことの全体のまとめの記事、分身AIと歩んだ100日──AIに任せて転びながら学んだことの全まとめで読めます。
分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
Q. Muse Wonderの無印と上位版のFullは、何が違いますか?
A. Fullは別のモデルで、無印の考える量を増やしたものではありません。FullはMuse Codeの契約でしか使えず、APIで呼べるのは無印だけです。詳しくは第1章。
Q. Meta Model APIは、今使っているツールからそのまま呼べますか?
A. まさおは、OpenAIやAnthropic向けのコードのまま、接続先のURLとキーを替えるだけで呼べると話します。今使っているツールを作り直さなくて済み、OpenRouterにも出ています。詳しくは第6章。
Q. Opus 5.5より上と言えるのは、どの仕事ですか?
A. 動画の結論は、長い開発なら試す価値があり、画面操作と短いコーディングはOpus 5.5のままです。記憶の数字はMeta自身のテストで、外の会社の数字はまだ見つかっていません。詳しくは第2章と第4章。
Q. 日本から使えますか?
A. 日本からMeta Model APIに登録できるかは、公式のページに書かれていないとまさおは話します。手元のパソコンでは動かせません。モデルの中身のファイルが公開されていないからです。別の会社を通して呼ぶ方法はあります。詳しくは第6章。
Q. Contributor modeとは何ですか?
A. Muse Codeの設定で、送った中身をMetaの学習に使ってよいと認める代わりに、使える量が増えます。学習に回るのは、送った中身と返ってきた答えの両方です。契約した最初からオンです。オフにするのは/settingsからです。詳しくは第6章。
2026年10月12日公開の24分54秒の動画です。まさおとエレンが、10の章で読みます。Metaの成績表と、外の会社の測定です。台本と図はAIが作り、声は合成音声です。
動画の順に整理しました。無印とFullの違いから、試す前の設定までです。動画の結論は、長い開発なら試す価値があり、画面操作と短いコーディングはOpus 5.5のままです。
Muse Wonderを試す前に、別の目で確かめる手順を1行で決めます。作業1回の出力量と所要時間です。今のモデルで測ります。学習に使われる設定の初期値も、使う前に見ます。
次にモデルを替える話を見かけたら、見出しより先に、誰がどんな条件で測った数字かを確かめるでしょうか。
関連記事
同じ週のMuse Wonderの話を、文書を動画にする話と並べて追える記事です。この記事の動画の位置づけを、広く見渡す材料になります。
Metaの新しいMuseを、サブスク解約や買い物までAIに任せる時代の入り口として解説する記事です。成績表とは別の角度から全体像を補えます。
Opus 5.5とGPT-6 Solを10本の課題で比べた検証の記事です。第1章の、超えたと言われる話を別の目で確かめる材料になります。
Claude Codeの使用量の見方を、記事で確かめた内容です。作業1回の出力量を測る第5章の行動と相性がよく、枠の減り方を知る手がかりになります。
Googleのデータ設定の変更と、親子で見直す安心設定を扱う記事です。第6章の、学習に使われる設定を使う前に見る話と同じ向きです。
ClaudeとChatGPTを、仕事別にどう使い分けるかを動画で整理した記事です。乗り換えを考える前に、今の使い方を見直す土台になります。
Claude Haiku 5.5の単価と使いどころを扱う記事です。第5章の、作業1回の費用を出力量から見る考え方とつながり、役割分担も確かめられます。
書籍の原稿をAIに書かせ、5つのモデルで文字数に差が出た結果を解説する記事です。モデルごとの出力量の違いを見る参考になります。
参考リンク
今回紹介した動画本編。時刻つきの発言は、ここで確かめられる
今回紹介した動画
| チャンネル | まさおAIじっくり解説ch |
| 公開日 | 2026年10月12日 |
| 長さ | 24分54秒(日本語) |
| URL | https://www.youtube.com/watch?v=taYd1RTzq1U |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!