AI音声・ボイスクローン
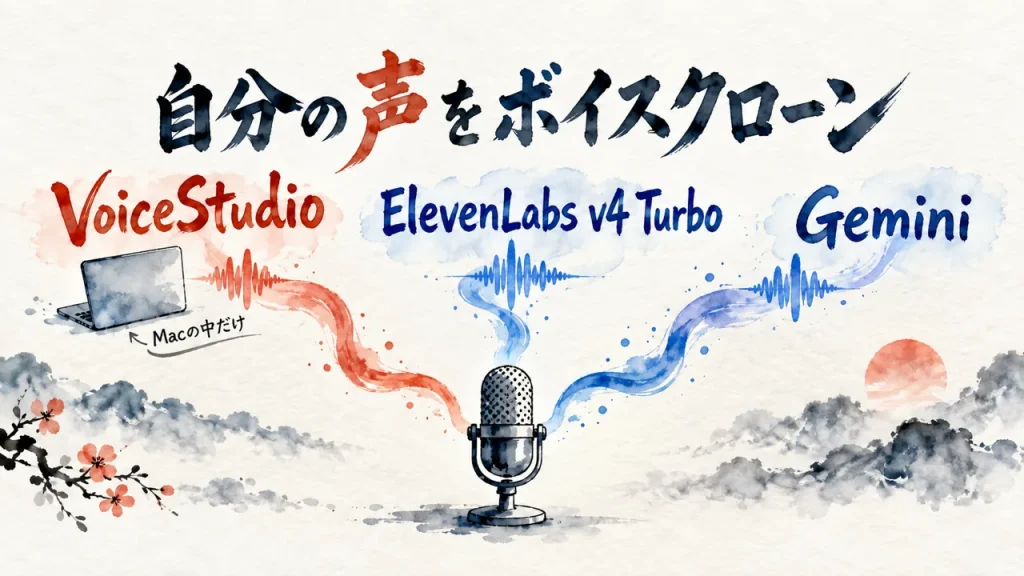
VoiceStudioで自分の声をボイスクローン。ElevenLabs v4 TurboとGemini 3.8 TTSとも聞き比べ
使ったツール:VoiceStudio(OmniVoice)/ElevenLabs v4 Turbo/Gemini 3.8 Flash TTS
2026年10月5日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくんです。
GitHubで今週いちばん伸びていたのが、VoiceStudioでした。1週間で16,000以上のスター。646言語に対応したボイスクローン(声のクローン)が、自分のパソコンの中だけで動くって触れ込みです。で、AI秘書の凛ちゃんに頼んで、私のMacに入れてもらいました。
材料は、私の生の声13秒だけ。比べる相手は、いま講座動画で使っているElevenLabs v4 Turboと、Google AI Studioで作ったGeminiの私の声です。結果、ローカルのクローンはElevenLabsにあと一歩でした!
3行でわかるポイント
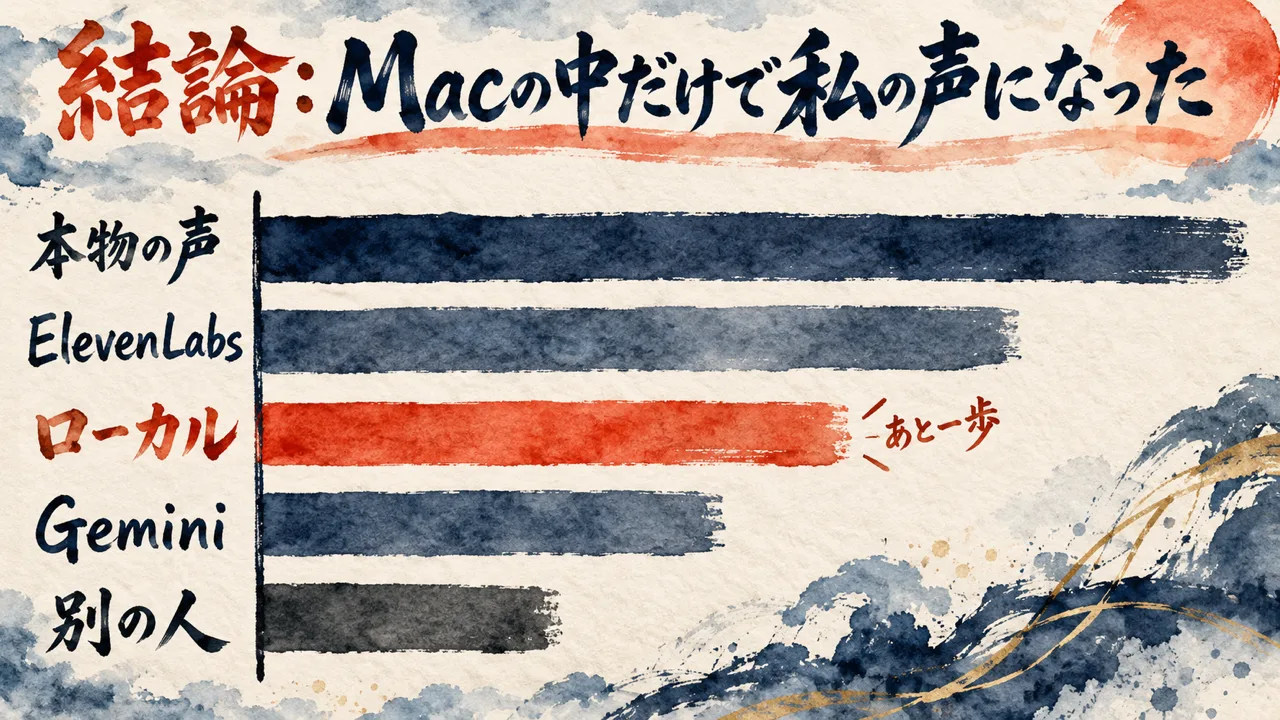
- Macの中だけで、私の声になった。生の声13秒から作ったクローンの近さは0.874〜0.895。ElevenLabs v4 Turboは0.901〜0.922、Geminiは0.775〜0.815でした。
- つまずいたのはポート3900。別の道具が使っていると、アプリが間違った相手につながります。起動時に番号を変えれば直ります。
- 弱点は速さと読み間違い。長さを指定し、何本か作って選べば対処できます。
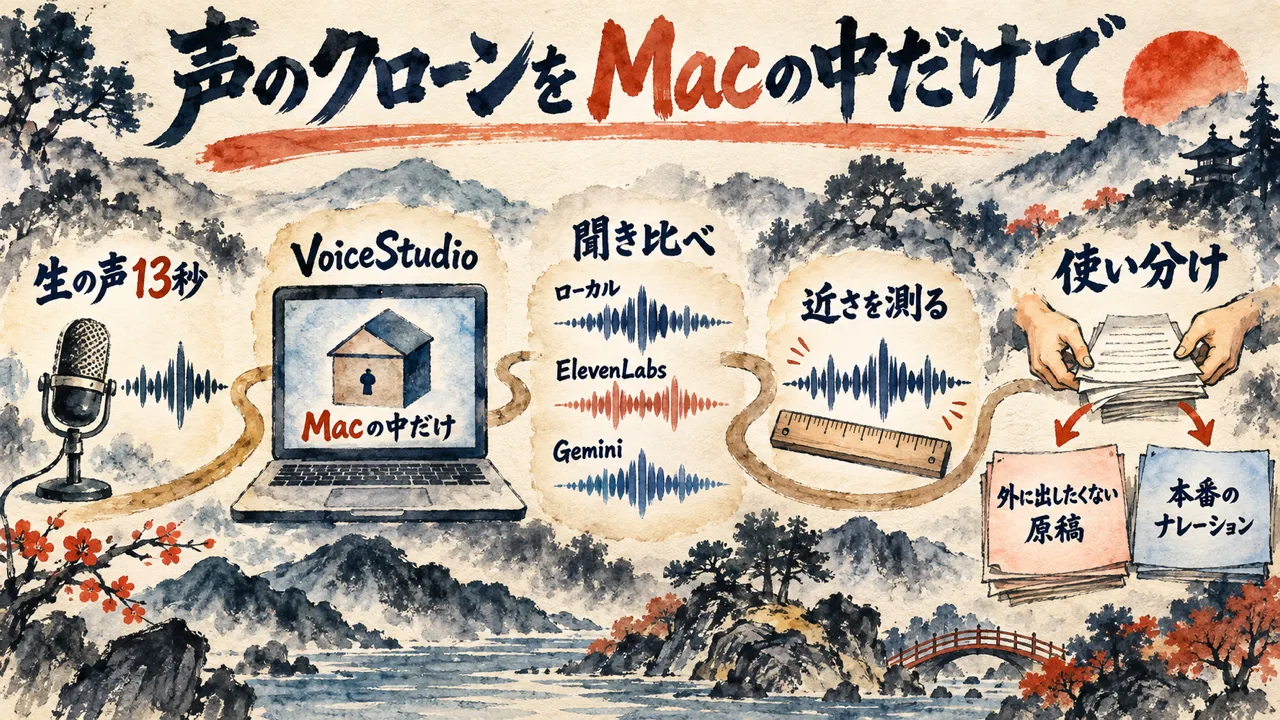
結論:ボイスクローンがMacの中だけで「私の声」になった。差は速さと読み間違い
私の講座動画のナレーションは、ElevenLabsで作っています。私の声のクローンに、台本を1行ずつ読ませる形です。9月30日にはv4 Turboへ切り替えました(ElevenLabsとGemini 3.8 TTSを自分の声で5本聴き比べた記事)。その本番の声と、Macの中だけで再現した声を並べました。
似ている度合いは、本物の私の声を1.000とした時の近さです。本物の私が別の場面で話した声でも0.937。ここが天井です。
| 声 | 本物との近さ | 長さ(本物は7.5秒) |
|---|---|---|
| 本物の私(別の区間) | 0.937 | – |
| ElevenLabs v4 Turbo | 0.901〜0.922 | 7.5秒 |
| ローカル(VoiceStudio) | 0.874〜0.895 | 5.1〜5.4秒 |
| Gemini 3.8 Flash TTS | 0.775〜0.815 | 6.3〜6.7秒 |
| 別の人の声 | 0.638 | – |
ローカルは、ElevenLabsとの差が0.01〜0.05。Geminiより上でした!弱点は2つあります。読むのが速いこと。それと、たまに読み間違えること。どちらも対処できるので、後の章で書きます。
VoiceStudioとは:自分の声を外に出さずにボイスクローンを作るアプリ
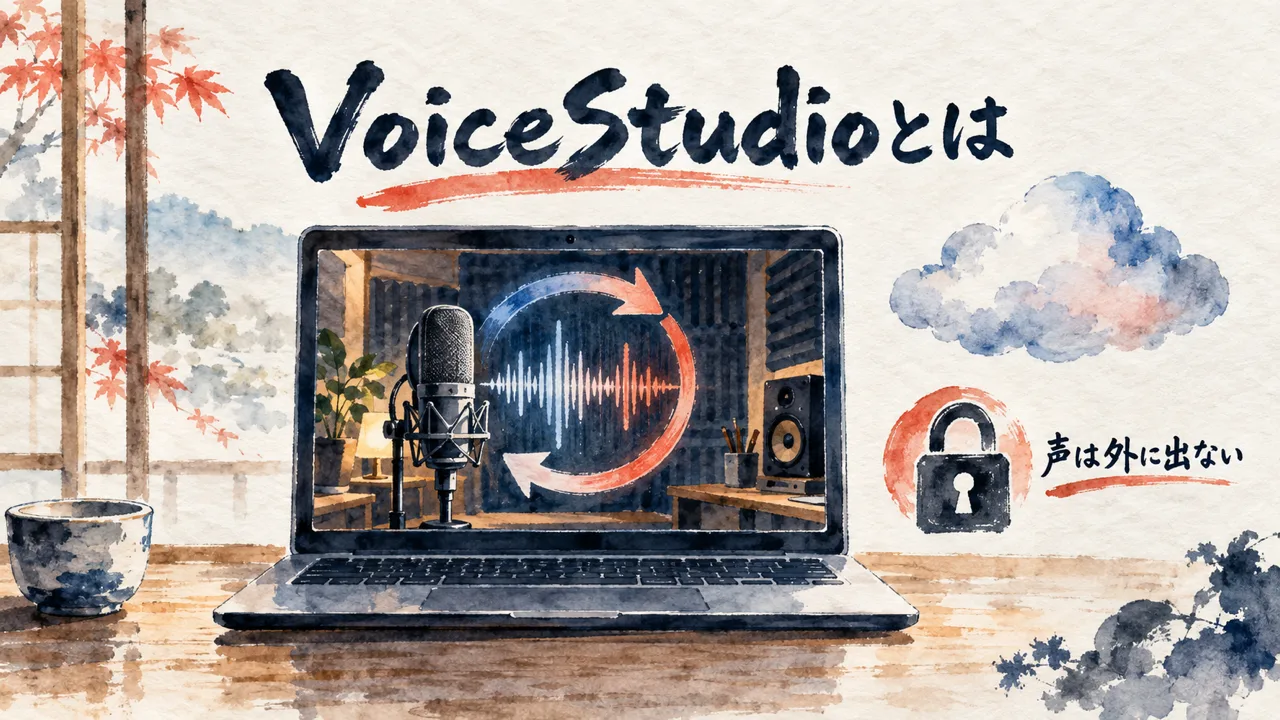
VoiceStudioは、GitHubで公開されている声のアプリです。WindowsやLinuxでも動く作りで、今回はMac版の0.5.6を入れました。
中で動いているのは、OmniVoiceという声のモデルです。大きさは3.27GB。ライセンスはApache-2.0で、アプリ本体はAGPL-3.0です。
できることはシンプルで、3つです。
- 声の見本と、その文字起こしを渡す
- 読ませたい文を入れる
- 見本の声で読み上げた音声が返ってくる
ポイントは、声も文章もインターネットに出ていかないことです。クラウドの読み上げは、声の見本を相手のサーバーに預けます。VoiceStudioは、最初にモデルを落とした後はMacの中だけで完結します。速さも測りました。12秒の音声を作るのに、温まった状態で約4.5秒。Mac(Apple Silicon)のGPUで動いています。
入れ方3ステップと、ポート3900の落とし穴
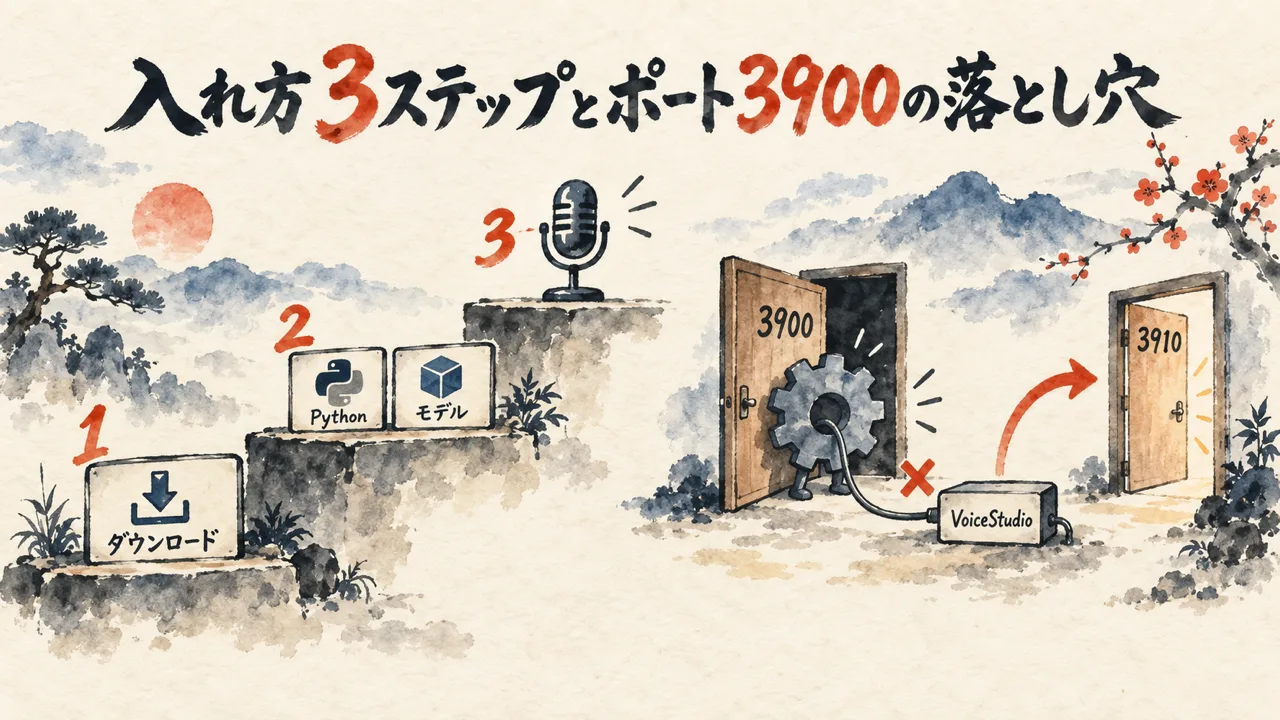
入れ方は3ステップです。
- GitHubのリリースからMac用のdmgを落として、アプリケーションへ入れる
- 初回起動で、Pythonの実行環境(約1.5GB)とOmniVoiceのモデル(3.27GB)を入れる
- 声の見本を入れて、文を読ませる
で、つまずいた所があります。ポート3900の取り合いです。
VoiceStudioは、裏でポート3900番を使って声のモデルを動かします。私のMacでは、別の道具がすでに3900番を使っていました。するとアプリは、その別の道具を自分の裏方だと思い込んでつながってしまいます。画面は動くのに、声が作れない状態です。
直し方は、起動時に別の番号を渡すことでした。
open -n -a /Applications/VoiceStudio.app --env OMNIVOICE_PORT=3910これで3910番で立ち上がり、正しくつながりました!普段から開発の道具を何本も動かしている方は、先に3900番が空いているか確かめておくと早いです。
もう一つ細かい所です。モデルの一覧で「入った」と表示されても、裏ではまだダウンロード中のことがありました。ダウンロードの進み具合が空になるまで待ってから使ってください。
聞き比べ:同じ一文を4つの声で
読ませたのは、この一文です。
一貫した機材を使用。サンプル間で録音機器を変更しないでください。10秒の音声が必要。
実はこの一文、私が実際に読み上げた録音の中にあります。だから本物と並べられるってわけです。
本物の私(生の声・7.5秒)
ローカル(VoiceStudio・見本13秒)
ElevenLabs v4 Turbo(私のクローン)
Gemini 3.8 Flash TTS(私のクローン)
ローカルの声の見本は、同じ録音の別の部分13秒だけです。この一文は見本に入れていません。
ElevenLabsとGeminiのクローンは、私がそれぞれのサービスで作ったものです。ElevenLabsの新しい版が日本語の数字をどう読むかは、Eleven v4の実演を確かめた記事にまとめています。ElevenLabsの声は、この一文を含む30秒の録音から作っています。だからElevenLabsは少し有利な条件です。Geminiの声は、9月26日に私がGoogle AI Studioで録音から作りました。
測り方と、最初の測定をやり直した話
近さの数字は、話者の声の特徴を数値にする道具(Resemblyzer)で出しています。声の特徴同士を比べて、1.000に近いほど同じ人の声に聞こえる、という見方です。
ここで一度、測り直しをしています。
最初にAI秘書の凛ちゃんが基準にした「私の声」は、講座動画のナレーションでした。それ、ElevenLabsが作った私のクローンです。AIの声を手本にAIの声を測っていたので、数字は全部使えません。
報告を見た私は、こう聞きました。
なんで私自身の生の声を使ってやらないんですか?
そこでAI秘書の凛ちゃんが、ElevenLabsに声を作る時に私が録った、生の声30秒を探し出しました。その録音を「見本の13秒」と「答え合わせの一文」に分けて、全部やり直しています。この記事の数字は、やり直した方です。
ローカルの声を試すなら、ここは真似してほしい所です。手本にするのは、AIで作った声ではなく、自分がマイクで話した声。そうしないと、クローンのクローンを作ることになります。
弱点と対処:速すぎる・たまに読み間違える
弱点の1つ目は、速さです。
本物の私は、あの一文を7.5秒で読みます。ローカルは5.1〜5.4秒。早口の私になります(笑)対処は、長さを指定することです。VoiceStudioには、出来上がりの秒数を決める設定があります。7.5秒を指定すると、本物と同じ長さで読みました。
弱点の2つ目は、読み間違いです。
見本を20秒に増やして、長さを7.5秒に指定した4本のうち、1本だけ「変更しないで」を「変更にしないで」と読みました。
ローカルの読み間違い(「変更にしないで」と読んだ1本)
対処は、同じ文で何本か作って、良い1本を選ぶことです。1本あたり数秒で作れるので、4本作っても待ち時間は30秒もかかりません。ナレーションに使うなら、文字起こしで台本と照らし合わせる工程を1つ挟むと安心です。
使い分け:数字では測れない所を、誰の声として届けるか
今回の結果で使い分けるなら、こうなります。
- 声を外に出したくない原稿:ローカル(VoiceStudio)。社内向けの説明、下書きの読み上げ、試し録り
- 講座動画など本番のナレーション:ElevenLabs v4 Turbo。長さが正確で、読み間違いが出なかった(台本から動画を作る流れはClaude Codeで台本から動画を作る手順が参考になります)
- Googleの仕組みの中で完結させたい時:Gemini。近さはローカルより下でしたが、読み間違いは0本でした
数字の上では、ローカルで再現した声が本番にかなり近づきました。ただ、私は前から、声で感じることはテキストではないものがいっぱいあると思っています。言霊というか、響く。
愛している人の声を聞いて、ホッとしたことがあります。あの安心には、声の音だけでなく、その人が話しているということも入っていたのかなと思います。
近さ0.9の声は、音としては私の声です。でも、聞く人が「ひろくんが話している」と受け取るかどうかは、数字では測れません。
ローカルで声が作れるようになったことで、声を預けるかどうかを、原稿ごとに選べるようになります!
よくある質問
Q. VoiceStudioはWindowsでも使えますか?
A. 説明書(README)では、WindowsやLinuxでも動く作りになっています。私が試したのは、Apple SiliconのMacだけです。
Q. 声の見本は何秒あればいいですか?
A. 私は13秒で作りました。見本を20秒に増やしても、近さは0.869〜0.902で、ほぼ同じでした。大事なのは長さより、AIの声ではなく自分がマイクで話した声を使うことです。
Q. ElevenLabsやGeminiから乗り換えるべきですか?
A. 私は乗り換えていません。講座動画の本番はElevenLabs v4 Turboのままです。ローカルは、声を外に出したくない原稿で使い分けます。
Q. 他人の声でも作れますか?
A. 技術的には作れてしまいます。だからこそ、声は本人の同意がある声だけを使います。
COLUMN
ひろくんコラム。手本は、自分の生の声
今回、アプリを入れるのも、声を作るのも、数字を測るのも、AI秘書の凛ちゃんに任せました。
私がやったのは、途中で2回、口を出したことです。1回目は、手本の声が生の声ではなかった時。2回目は、比べる相手にGeminiが入っていなかった時です。
どちらも、測り直すと数字が変わりました。手本がAIの声のままだったら、この記事の表は全部違っていました。
記事を声に変える仕組みは、分身AI日記の「分身AIが記事を声に変えた、リパーパスの裏側を全公開」で書いています。ローカルの声が使えると、その仕組みの中で、声を外に出すかどうかを原稿ごとに選べます。
👉 AIに任せる範囲と、自分に残す判断の話は、分身AI.comもチェックしてね!
関連記事
今の本番ナレーションをv4 Turboに決めた回
クラウド側の読み上げの癖を確かめた回
声のAIの最新ニュース
参考リンク
今回入れたアプリ。0.5.6版
中で動いている声のモデル。Apache-2.0
比べた相手。講座動画の本番ナレーションで使用中
Geminiの私の声を作った場所
🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 金 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 土 | 7:00〜7:30 | ただっち | 愛紗さん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜のLIVEは無料視聴、7:30〜のZOOM LIVEは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!