READ REPORT
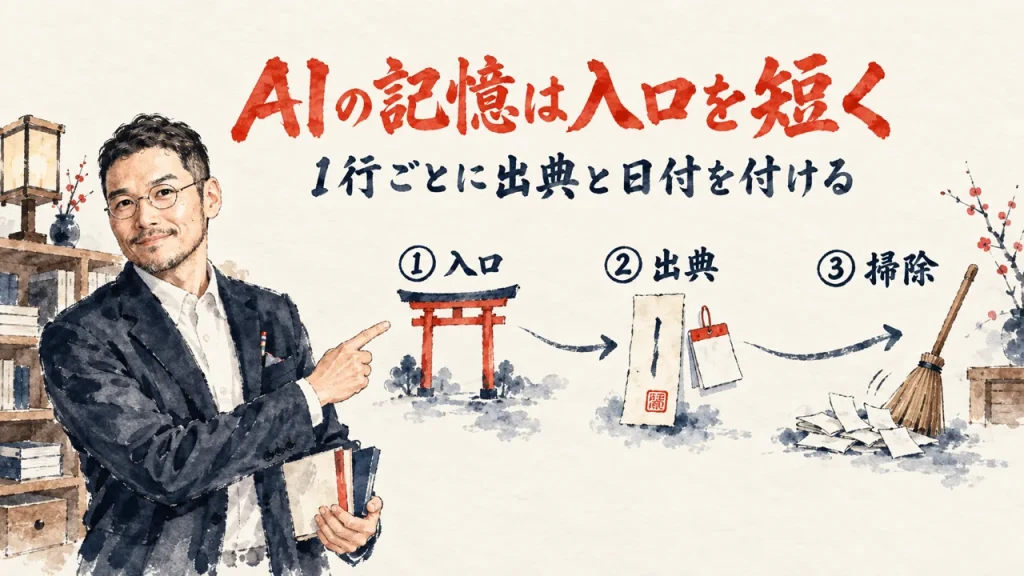
Cognition「Agent Memory Repo」を解説。AIの記憶は、毎回読まれる入口を短くして、1行ごとに出典と日付を付ける
2026年10月7日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、Cognitionの公式ページ「Agent Memory Repo」を紹介するね。AIに記憶を持たせる形の話ですが、私は、同じ指摘を言い直さないための、記憶の置き方の話として読みました。
AIは、会話が変わると、前の指摘を忘れます。メモを書いても、毎回読まれる場所に無ければ、同じ指摘が戻ってきます。Cognitionの公式ページは、記憶をフォルダに置き、入口を短くして、1行ごとに出典と日付を付け、定期的に掃除する形を示しています。私が持ち帰ったのは、次の会話で使える形で残す、という考え方です。
3行でわかるポイント
- 公式ページは、記憶の入口になるMEMORY.mdを短く保ち、1項目を1行にして、出典と日付を付け、同じ情報は1か所に置いてリンクで指す形を示しています。
- 複数のエージェントが同じフォルダに書く例では、1体では見つけられなかった原因が突き止められています。保存したSQLが、次の会話で使い回される例もあります。
- 私は、まず次回も引き継ぎたいことを3件だけ、日付と根拠つきのメモにして、新しい会話に貼ってみます。元記事の手順はDevin向けで、これは元記事にはない私の提案です。
Cognition(Devinを提供する会社)の公式ページ・英語。AIエージェントが会話をまたいで覚えている状態を、フォルダとMarkdownで作る形を説明している。ページに公開日の記載は見当たらない(2026年10月7日に確認)
Cognition「Agent Memory Repo」の入口。AIがセッションをまたいで覚えていると、何が変わるのか
Cognition「Agent Memory Repo」(公式ページ)(冒頭の説明)
Agents work better when they remember things across sessions.
Cognitionは、AIエージェントのDevinを提供している会社です。今回紹介するのは、その公式ページ「Agent Memory Repo」。
AIがセッション(1回の会話や作業のまとまり)をまたいで覚えている状態を、フォルダとMarkdownのメモで作る形を説明しています。
引用した冒頭の一文は、「エージェントは、セッションをまたいで覚えているほうが、よく働く」という意味です(訳は私)。
ページは続けて、学んだことをその場で保存し、記憶同士がリンクして、wikiのようにたどれる、と書いています。
私には、同じ指摘を何度も言い直した実測があります。10月2日の記事の引用を、先に置きます。
AI氣道『AIエージェントに60点のままスキルを作らせない。1回分を手で直し切ってから量産する』より
「「作り方が決まる前に作らない」。この指摘を、私は3月17日から9月27日までに7回しています。」
同じ指摘を言い直す話は、10月2日の記事、『AIエージェントに60点のままスキルを作らせない。1回分を手で直し切ってから量産する』で書いています。
AIに記憶を持たせたいのは、物知りにするためではありません。同じ説明と指摘を言い直す手間を減らして、本当に大事な判断へ戻るためです。
公式ページの試し方はDevin向けで、私は試していません。ChatGPTやClaudeを使う方は、一番小さい形を手元で試せます。
次回も引き継ぎたいことを3件だけ選んで、1行ずつの「次回用メモ」にして保存し、新しい会話の最初に貼る方法です。
AIが勝手に書き足さないよう、メモに入れるのは、私が実際に言った目的・判断基準・好みだけにします。各行には、記録日と、使う場面を添えます。推測や、採用していない提案は入れません。
これは元記事にはない、私の提案です。試せるのは、引き継ぎメモが役に立つかまでで、公式の仕組みを入れたことにはなりません。
「Update entries as the agent learns, with no human in the loop」。記憶の4歩のうち、私が人を残したい所
Cognition「Agent Memory Repo」(公式ページ)(The memory loop)
Update entries as the agent learns, with no human in the loop.
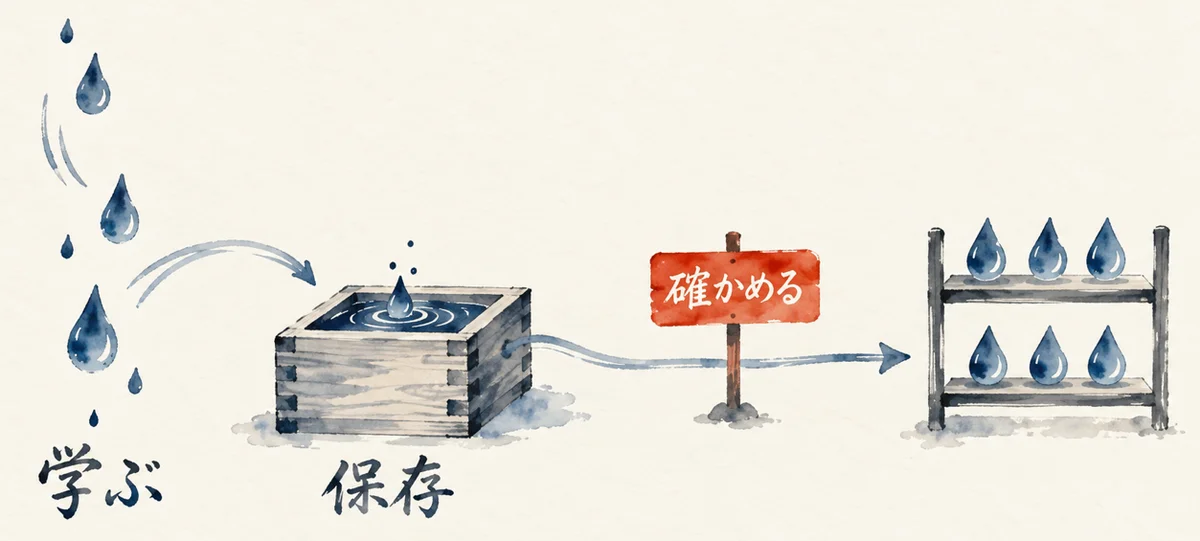
公式ページが示す、毎回の流れは4歩です。1つ目は、最新の記憶を手元に取り込む。2つ目は、必要なものを検索するか、リンクをたどる。3つ目は、学んだらエントリ(記憶の1項目)を更新する。
4つ目は、編集のたびに共有の場所へ送る。
引用したのは3歩目です。「エージェントが学ぶたびに、人が介在せずにエントリを更新する」という意味です(訳は私)。
私は、ここに賛成する所と、違うと言う所があります。賛成するのは、学んだその場で保存することです。後回しにすると、その時の文脈が薄れます。保存の手間が小さいほど、続きます。
違うと言うのは、「人が介在しない」を、どこまで広げるかです。AIが学びや仮説を保存することには賛成します。でも、私がまだ確かめていない解釈を、私の価値観として保存することには反対です。
過去の出来事の事実と、その時の感情や解釈と、いまの私の再解釈は、別の行にしておきたいんです。履歴は上書きせず、重ねる。この考えは、私の判断軸の1つです。
公式ページの例に出てくる記憶は、仕事の関係や、機能の測り方のような記録です。価値観の保存の話ではありません。ただ、人が介在しないで書き換わる範囲を、私なら、記録と仮説までに止めます。
自分の仕事に持ち込む時は、AIが勝手に書いてよい行と、私が確かめてから書く行を、先に分けておきます。1つ目の枠に「推測は入れない」と書いたのは、そのためです。
「keep it short」。毎回読まれる入口ファイルは、短く保つ。私の入口ファイルは33,157バイトありました
Cognition「Agent Memory Repo」(公式ページ)(MEMORY.md)
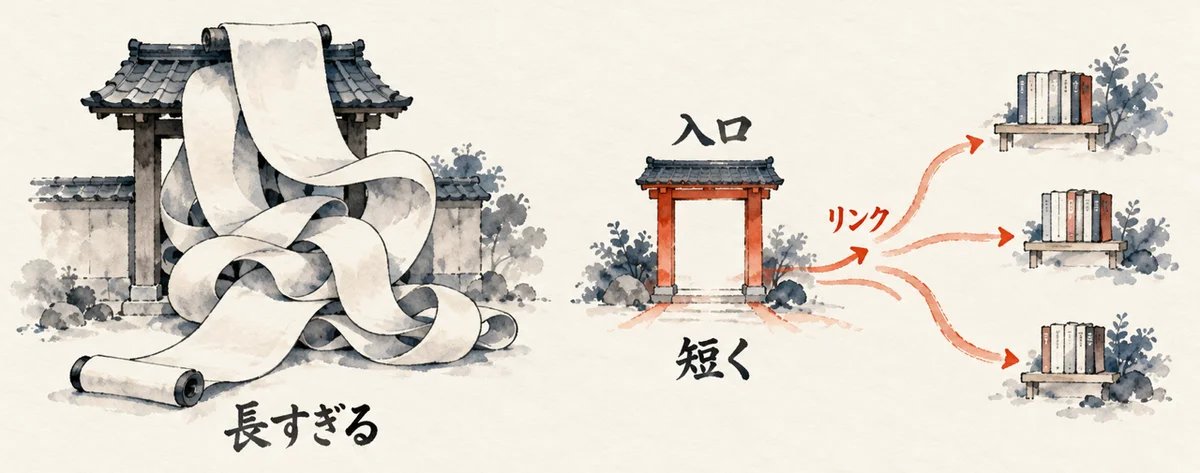
Agents load it at the start of every session, so keep it short: include only what every session needs, plus links to everything else.
次は、記憶の置き方です。公式ページによると、記憶のフォルダには、Markdownのメモ、SQL、スクリプトなどを、好きに置けます。その入口になるのが、MEMORY.mdという1つのファイルです。
引用した文は、「エージェントは、セッションの最初に、毎回これを読み込む。だから短く保つ。毎回のセッションに要るものだけを書いて、あとは全部リンクにする」という意味です(訳は私)。
公式の例の入口は短く、ジョンの概要が1行と、各ファイルへの目次(Index)が並ぶだけです。詳細は別のファイルへのリンクで指します。
この話を読んで、AI秘書の凛ちゃんに、私の入口ファイルの大きさを測ってもらいました。私が使っているAIの記憶にも、MEMORY.mdがあります。
ファイルの冒頭には、「核心のみ常時ロード」「目安24KB以下」と書いてあります。
10月7日の実測は、33,157バイトでした。目安を超えています。短くする方針は、書いてありました。でも、方針を書くだけでは、短くは保てていません。
この「書いてあるのに、守れていない」は、10月3日の記事にも書いた形です。
AI氣道『AIに任せる範囲はどこまで?6万人が使うSNSアプリを作る開発者が、Claude Codeで決めている線引き』より
「メモを増やす前に、そのメモが毎回読まれる場所にあるか。ここを見ずに足しても、同じ指摘が戻ってきます。」
メモが毎回読まれる場所にあるか、という見方は、10月3日の記事、『AIに任せる範囲はどこまで?6万人が使うSNSアプリを作る開発者が、Claude Codeで決めている線引き』で書いています。
救いになる設計が1つあります。私の起動時の資料には、「過去の判断や教訓は、関連語で検索して、該当項目の原本だけ読む。全文は常時投入しない」と書いてあります。公式の「入口は短く、あとはリンク」と同じ向きです。
「Keep information in one place and link to it elsewhere」。出典と日付を1行ごとに付けて、同じ情報は1か所に置く
Cognition「Agent Memory Repo」(公式ページ)(Cross-links)
Keep information in one place and link to it elsewhere.
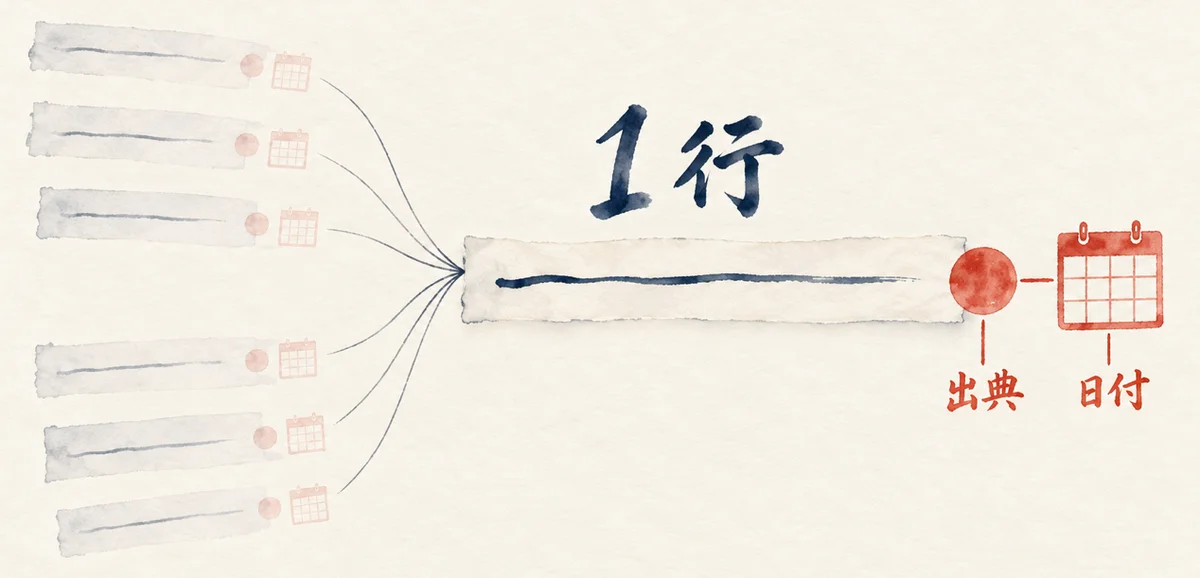
引用した文は、「情報は1か所に置く。ほかからは、そこへのリンクで指す」という意味です(訳は私)。同じ内容を何か所にも書くと、直す時に、どれが正しいのか分からなくなります。
公式ページが示す記憶の1項目は、箇条書きの1行です。行の末尾に、メタデータ(付け足しの情報)を付けられます。書き方は、[source: …; added: 2026-09-03] のような形です。
sourceは、その情報を学んだ会話へのリンク。addedは、保存した日です。ページは、この2つを推奨のキーとして挙げています。必須ではありません。
私は、これを読んで、自分の運用と並べました。10月2日の記事に書いたとおり、私は今、指摘を受けた日の事故の日付と、私が言った原文を、毎回読まれるルールの置き場へ書き込んでいます。
日付と原文が付いていると、後から読んだAIも私も、「いつ、何があってできたルールか」が分かります。公式の考え方と同じ方向です。
1つだけ、足したいことがあります。日付と出典だけでは、「いまも有効か」と、「私が確かめたか」が分かりません。私なら、1行に、確かめた日と、本人が確認した行かどうかも添えたいです。提案です。未実装です。
「Merge duplicates, remove outdated entries」。定期の掃除(Dreaming)と、私の夜の同期
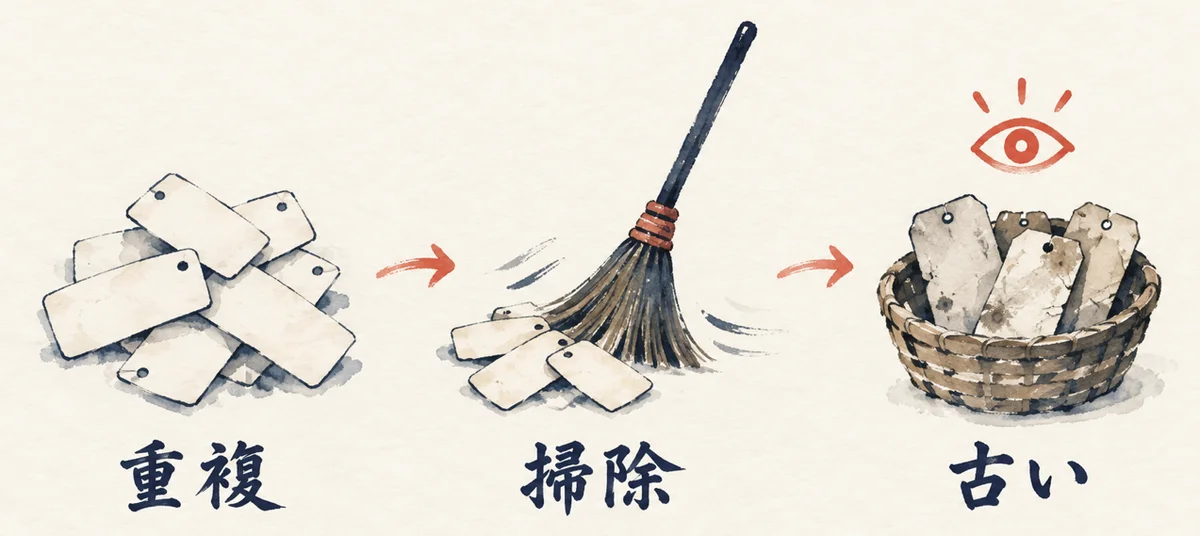
Cognition「Agent Memory Repo」(公式ページ)(Dreaming)
Merge duplicates, remove outdated entries, and check sources to resolve contradictions.
公式ページには、Dreaming(夢見)という仕組みが出てきます。定期的に動く専用のエージェントで、仕事は2つです。1つ目は、新しい記憶を足すこと。
セッションをまたぐパターンを見つけて、新しいエントリとして保存します。2つ目が、記憶の掃除です。
引用したのは、その掃除の中身です。「重複を統合して、古いエントリを消して、出典を確かめて矛盾を解消する」という意味です(訳は私)。ページでは、定期的に動くと書かれていて、夜に限られてはいません。
私は10月2日の記事で、今西さんの動画に出てきた「ドリーミング」を紹介しています。夜に自動で回して、朝には直っている形でした。
私の運用は、10月2日の記事の時点で、こうです。夜の同期(毎日5時43分)の便が、セッションの履歴を蒸留して、検索に使える形にします。
月曜10時には、AIの割り当ての実績を振り返って、ルールの改善案を出す便が回ります。
ただ、履歴からルールの本文を直す所は、そのまま私の手でした。
ここを仕組みにするなら、同じ指摘が2回出た日に、翌朝の候補一覧へ上げる形かな、と考えています(提案です。未実装です)。
AI氣道『Claude×Obsidianのメモ整理をAIに任せる前に、使う場面を一行残す』より
「整理という一番重い作業は、AIの側にあります。そのぶん、人の側に残る作業がはっきり見えます。」
掃除をAIに渡した時に、人の側に何が残るか。メモ整理をAIに渡す話を書いた記事に、手がかりがあります。『Claude×Obsidianのメモ整理をAIに任せる前に、使う場面を一行残す』で書いています。
掃除には賛成です。記憶は、放っておくと重複して、古くなって、食い違います。
ただ、「古い項目を消す」には、私は慎重です。いまの私から見て古くても、当時の私にとっては、事実で、感情だったからです。消すより、「いまはこう見える」という版を、重ねたいんです。
掃除の候補をAIが出して、消す前に私が目を通す。これなら、記憶は軽くなって、私の履歴は残ります。
「No agent could have found this alone」。複数のエージェントが同じフォルダに書くと、1体では見えない原因がつながる
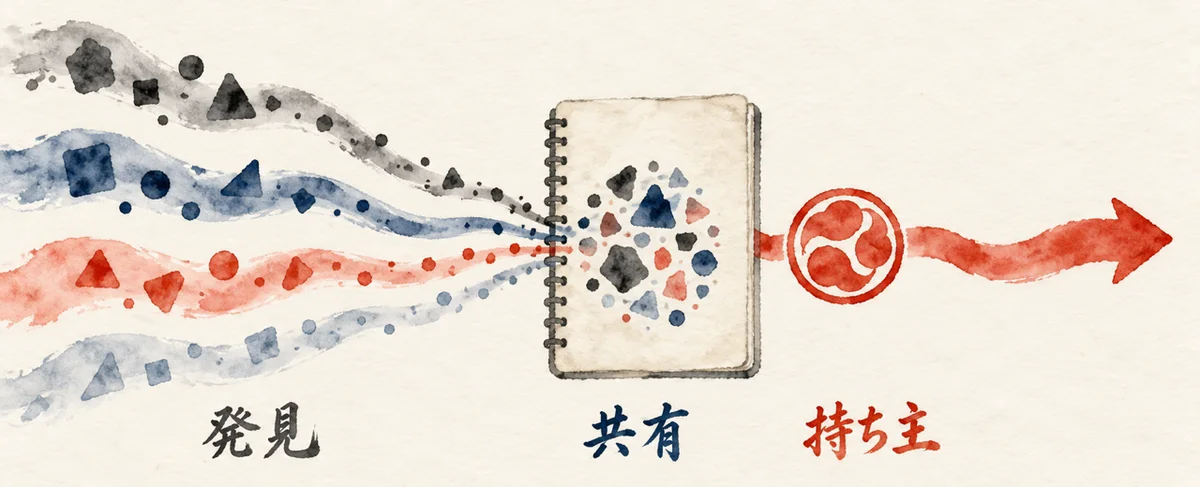
Cognition「Agent Memory Repo」(公式ページ)(Example: agent swarm)
No agent could have found this alone.
公式ページの1つ目の例は、複数のエージェントが、同じフォルダに書き込んで、原因を突き止める話です。リクエストの中央値は80ミリ秒。でも100件に1件が2.4秒かかり、理由は誰にも分かりません。
頼まれたエージェントは、データベース、ランタイム、キャッシュ、ロードバランサ(負荷の振り分け役)に1体ずつ、4体を立ち上げます。
群れ専用のフォルダに、目的とルールのREADME.md、測ったことを書くfindings.md、互いに質問するquestions.mdを置きます。
1時間後、findings.mdには3つの事実が並びます。データベースは、混み合う時に最大2秒、接続を待つ。ランタイムは、約10秒に1回、約400ミリ秒止まる。ロードバランサは、原因ではない。
でも、どれも、問題の理由を説明しません。
そこで質問が飛びます。ランタイムが「10秒ごとに動く、メモリを食う処理はあるか」と聞くと、キャッシュが「価格キャッシュの更新が10秒ごとに、約2GBの価格表を作り直す」と答えました。
3つの事実がつながります。更新が約400ミリ秒の停止を起こし、溜まった要求が一斉にデータベースの接続を求めて、20ある枠が尽きていたのです。
変わった価格だけを更新する直しで、遅い1%は2.4秒から310ミリ秒に下がりました。
引用した文は、「この原因は、どのエージェントも1体では見つけられなかった」という意味です(訳は私)。
キャッシュは自分の更新に問題を見ず、データベースは理由の無い待ちを、ランタイムは出どころの分からない停止を見ていました。
私は、この仕組みの、発見をつなぐ所に賛成です。ただ、ここでも、私の判断軸が1つあります。共有することと、責任を共同で持つことは、別です。
私は、1つの仕事のボールは、人でもAIでも、誰か1人が全部持つ形にしています。複数の共同責任にはしません。
4体が書いたfindings.mdを読んで、採るかどうか、次に何をするかを決める持ち主を、先に1人決めておきます。
公式の例でも、群れを作った最初のエージェントが、終わった時に入口へ1行を足しています。複数の人の記憶を合成する時も、リポジトリは別々のままで、Bobの記憶は、本人が共有を選んだ時だけ取り込まれます。
持ち主を分ける考え方は、ここにもあります。
これは公式の説明例で、私が試した結果ではありません。
「This time, John asked once」。保存したSQLが、次の会話で使い回された
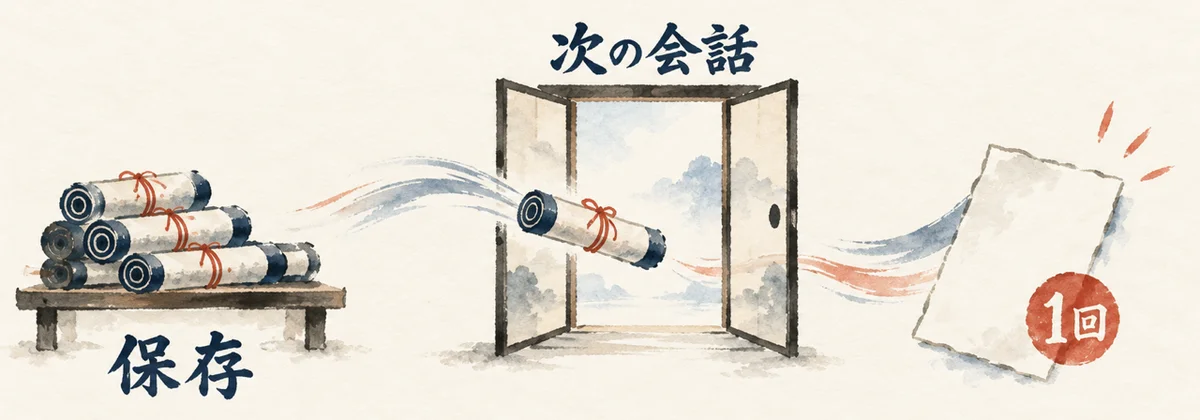
Cognition「Agent Memory Repo」(公式ページ)(Example: reusing a saved SQL query)
This time, John asked once.
2つ目の例は、保存したSQLの再利用です。ジョンが「先週のリリースで、自動補完の機能は悪くなったか」と聞きます。新しいセッションなので、AIには、ジョンとの会話の履歴がありません。
AIは、記憶のフォルダを「autocomplete」で検索して、1つのエントリを見つけます。
そこには、コードの中では、この機能がghost_textという名前で呼ばれていること、提案を出した後にユーザーが受け入れて30秒残した割合が、チームの測り方であること、そして、その計算を保存したSQLへのリンクが書かれていました。
AIは、そのSQLを実行して答えます。リリースの日に、その割合は31%から24%に下がっていました。ジョンは、機能がコードの中でどう呼ばれているかも、チームの測り方も、説明していません。
1週間前は、ジョンが機能の実装場所と測り方を説明する必要がありました。引用した文は、「今回、ジョンが聞いたのは1回だけだった」という意味です(訳は私)。
保存されていたのは、答えではなく、測り方と、その計算でした。次の仕事で使える形で残すと、説明は1回で済みます。ここを一番、持ち帰ってほしいです。
ChatGPTやClaudeを使う方なら、保存する物を、答えだけにしないことです。前に使った依頼文や、確認の手順まで残すと、次の仕事を始めやすくなります。
次回用メモを使う時は、新しい会話の最初に、次の文を貼ります。
ChatGPTやClaudeに貼る文:保存したメモを、新しい会話の前提にしてもらう
次のメモを前提にして、今回の仕事を進めてください。メモに無いことは、推測で補わず、私に質問してください。
【ここに、前の会話で作った次回用メモを貼る】
守る所も、1つあります。AIが日付や出典を補った行は、そのまま信じません。私が実際に言った言葉と見比べて、合っている行だけ残します。数字も同じで、AIが出した件数や割合は、自分の記録と照らします。
公式ページの試し方は3歩です。ターミナルでdevin plugins installを実行する。好みを1つ教える。新しいセッションで、教えた好みを聞き直す。
記憶は手元のフォルダにだけ置かれて、自動の起動と、定期のDreamingは含まれません。
この手順はDevinを使う方向けで、私は試していません。ただ、教える、保存する、新しい会話で聞き直す、という順番は、次回用メモと同じです。私は手元のメモから始めます。
よくある質問
Q. ChatGPTやClaudeでも、この形は使えますか?
A. 公式ページの手順は、Devin向けです。ただ、メモに出典と日付を付けて保存する考え方は、手元で真似できます。記事の中では、次回も引き継ぎたいことを3件だけメモにして、新しい会話に貼る方法を書きました。
Q. AIが人の介在なしに記憶を書き換えて、大丈夫ですか?
A. 公式ページが書いているのは、学んだらエントリを更新する、人は介在しない、という流れまでです。私なら、AIが書いてよい行と、私が確かめてから書く行を、先に分けます。
Q. 入口のファイルが大きくなったら、どうすればよいですか?
A. 公式ページは、入口には毎回要るものだけを書いて、あとはリンクにするよう書いています。私の入口ファイルも目安を超えているので、まず毎回貼る前提文の長さを数えます。
Q. Dreamingは、夜に動かすものですか?
A. 公式ページは、定期的に動くと書いていて、夜に限るとは書いていません。また、自動での起動と、定期のDreamingは、公式の試し方の手順には含まれていません。
まとめ:AIの記憶は、毎回読まれる入口を短く、1行ごとに出典と日付を付けて置く
Cognitionの公式ページが示すのは、記憶を持たせる、というより、記憶を使える形で置く、という話でした。入口は短く。1項目は1行。出典と日付を付ける。同じ情報は1か所に置いて、リンクで指す。古い項目は、定期的に掃除する。
そのうえで、私は、AIが勝手に書き換えてよい範囲と、私が確かめてから書く範囲を、分けておきたいと考えています。複数のAIが書く時は、最後に決める持ち主を1人、先に決めます。
最初の一歩は、15分の枠を取ることです。ChatGPTやClaudeに、次回も引き継ぎたいことを3件だけメモにしてもらい、手元に保存します。明日の最初の会話で、そのメモを貼ってみてください。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
過去の私が、いまの私を縛る紙にしない
記憶の掃除には、古い項目を消す仕事があります。これを私の原体験に照らすと、慎重になります。私の原体験は、夏休みの宿題へ計画を立てたことです。計画を立てた瞬間に、やる気がなくなる。決まった計画に従うのが、地獄。期間が決まって、過去の自分が作った予定へ、いまの自分を従わせると、自由が縛られるんです。
AIの記憶が、私を縛る予定表になったら、本末転倒です。だから私は、記憶を命令にはしません。「前の私は、こう言っていた」という履歴として、積んでおきます。出来事の事実と、当時の感情と、いまの再解釈を、消さずに重ねる。そう考えています。
だから、AIが書いた行には出典と日付を付けて、私が目を通して、消すか残すかを決めます。決める手は、私に残しておきたいんです。記憶に残すのは、私が実際に言った言葉と、確かめた出来事だけです。でも、同じ指摘を7回言った私は、毎回言い直す側でもあります。記憶が無ければ、同じ説明を言い直すことになって、本当に大事な判断へ集中できなくなります。記憶は、縛る紙にも、戻る道標にも、なれる。違いは、読む私が、いまの目で選び直せるかどうかだと、私は読んでいます。
この読み替えは、元記事にはない、私の考えです。私の運用は、まだ途中です。その途中の話は、分身AIと歩んだ100日の全まとめにも残しています。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
同じ指摘を7回した話と、夜に回して朝には直っている形を書いた回
メモが毎回読まれる場所にあるか、という見方を書いた回
メモ整理をAIに任せる前に、使う場面を一行残す話の回
参考リンク
この記事で紹介した元ページ
同じ指摘を言い直した実測と、運用の現状を書いた回
書いてあっても毎回読まれる場所に無ければ戻ってくる、と書いた回
今回紹介した記事
| 著者 | Cognition(公式ページ・個人の署名なし) |
| 媒体 | cognition.com(公式サイト) |
| 公開日 | ページに記載なし(2026年10月7日に確認) |
| 元URL | https://cognition.com/agent-memory-repo |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!