READ REPORT
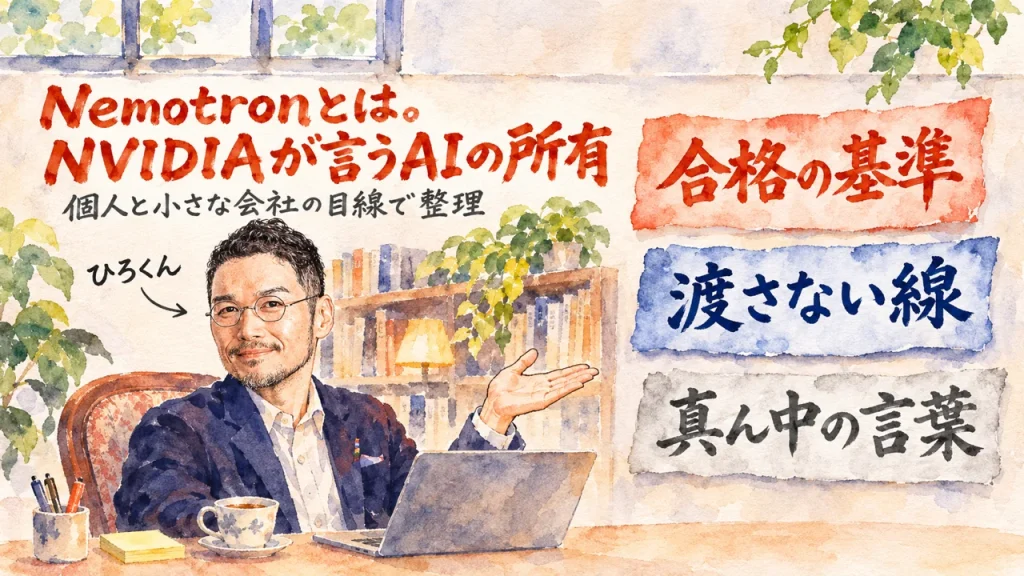
Nemotronとは。NVIDIAが言うAIの所有を個人と小さな会社の目線で整理
2026年11月3日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、NVIDIA Japan Blogが2026年7月30日に公開した、オープンモデルNemotronで「AIの所有」を語る記事を紹介します。
この記事は、私が保存したブックマークの1本です。NVIDIAは所有を勧めています。私は、AIを替えても残る物を自分の側に置くという過去記事の考えを、NVIDIAの「所有」に重ねて読みました。立場のある書き手の記事なので、元記事の言葉は「NVIDIAは〜と書いています」と分けます。私の読みは、私の読みとして分けて書きます。
読み方の筋は、所有とは何か、どう組み立てるか、機密データ、複数のモデル、自社の基準での評価、6つの事例と数字の読み方、そして個人と小さな会社が先に持つ物、の順です。専門語は出した所で一言ずつ言い換えます。
NVIDIAが言う「AIの所有」を、元記事の言葉で6つの章に整理しました。最後の第7章で、モデルの重みを持たない個人や小さな会社が先に自分の側へ持つ物を、推測として書いています。NVIDIAは所有を勧めていますが、私は持つ物の決め方を先に見る、という立場です。
3行でわかるポイント
- NVIDIAは、AIを借りて使う段階から、オープンモデルを自分たちの知識で磨いて所有する段階へ進んでいる、と書いています。
- 記事が約束するのは、機密データを第三者経由で送らずに、自社の基準で検証と評価ができることです。
- 個人や小さな会社が先に持てるのは、合格の基準、渡さない情報の線、真ん中に置く言葉の3つではないか、というのは私の推測です。
NVIDIA Japan Blogが2026年7月30日に公開した「Nemotron Labs」シリーズの一編(Joey Conway氏)。オープンモデルNemotronを軸に、AIを導入する段階からAIを所有する段階への移行、機密データを第三者経由で送らない検証と評価、複数モデルの組み合わせ、自社の基準での評価、6社の事例を伝えるNVIDIA自身の公式ブログ
NVIDIAが言う「AIの活用から所有へ」とは。Nemotronとオープンモデルを整理する
NVIDIA Japan Blog・Joey Conway氏の記事(AIの所有の話)
AI を導入する段階から、AI を所有する段階への移行が進んでいます。
元記事は、NVIDIA Japan Blogが2026年7月30日に公開した「Nemotron Labs」シリーズの一編です。書き手はJoey Conwayさん。
章頭の一文を言い直すと、AIを借りて使う段階から、自分の手で持つ段階へ進んでいる、という話です。
記事の出発点は、企業が選べる強いモデルは豊富にある、という認識です。問われるのは、自社固有の仕事の要望に応えられるかどうか。ワークフローの改善、専門知識の活用、精度や信頼性の基準を上回ること。
ここが軸になります。
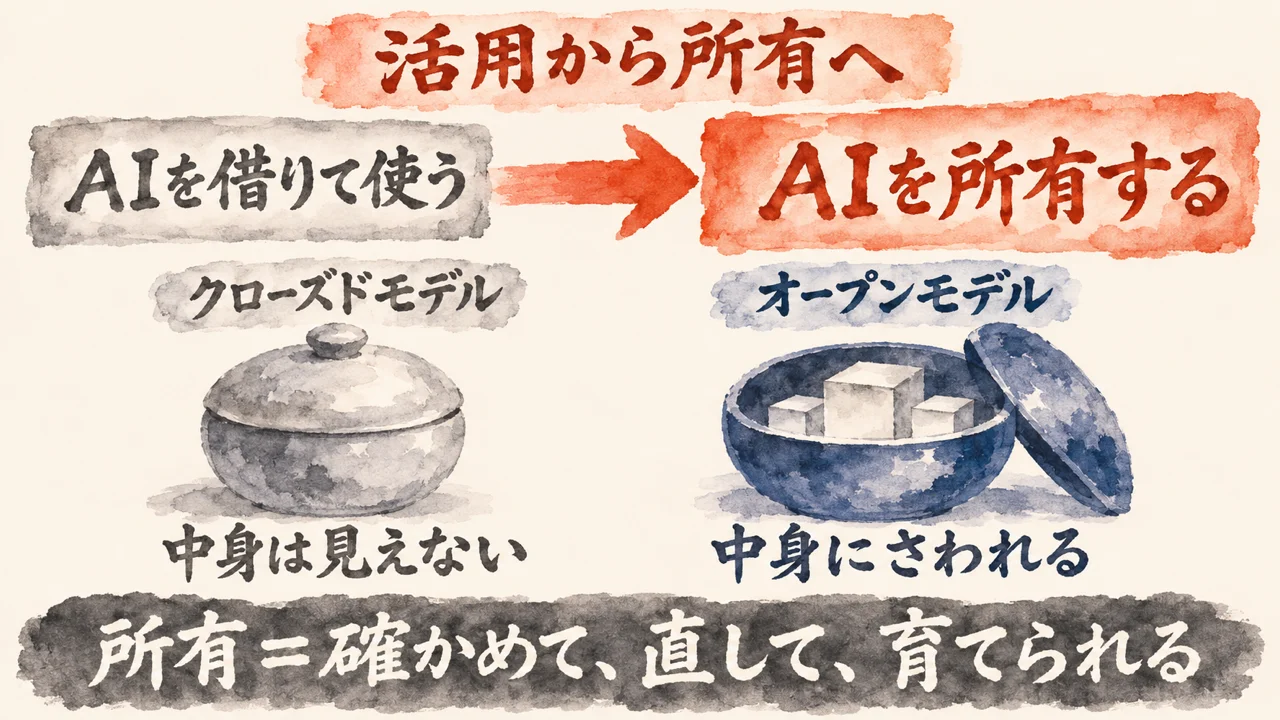
そこで出てくるのが、NVIDIA Nemotronなどのオープンモデルです。オープンモデルとは、中身にさわって自分向けに直せるAIのこと。
記事は、カスタマイズを前提に作られていて、企業や国家が、制御できて信頼できるAIを作る助けになると説明します。
対比されるのがクローズドモデルです。中身を見せずに提供されるAIのことですね。記事は、クローズドモデルは汎用知能の最前線を押し広げ続けていると認めます。
そのうえで、企業が検証し、最適化し、改善できる範囲には上限がある、と書きます。
「特化型AI」という言葉も出ます。自律型のエージェントやアプリケーションのことです。エージェントとは、頼んだ仕事を自分で段取りして進めるAI。記事によると、これはカスタマイズしたオープンモデルで作られています。
記事が言う所有は、モデルそのものにアクセスして、確かめ、直し、育てられる状態のことです。ここがポイントです。
私の読みです。これはNVIDIA自身の公式ブログで、自社の製品のNemotronやNeMoを紹介する記事。立場のある書き手の主張として読むのが、まず大事かな。
今使っているAIで、自分の仕事の言葉遣いや、これなら出せるという基準を、どこまで直せているか。1つ思い浮かべてみてください。
AIの所有は、どのモデルを選ぶかより、どう活用して組み立てるかで分かれる
NVIDIA Japan Blog・Joey Conway氏の記事(モデルの選び方より活用の話)
AI 分野における競争上の優位性は、どのモデルを選ぶかよりも、利用可能なモデルを組織がどのように活用して AI を構築するかによって決まる傾向が強まっています。
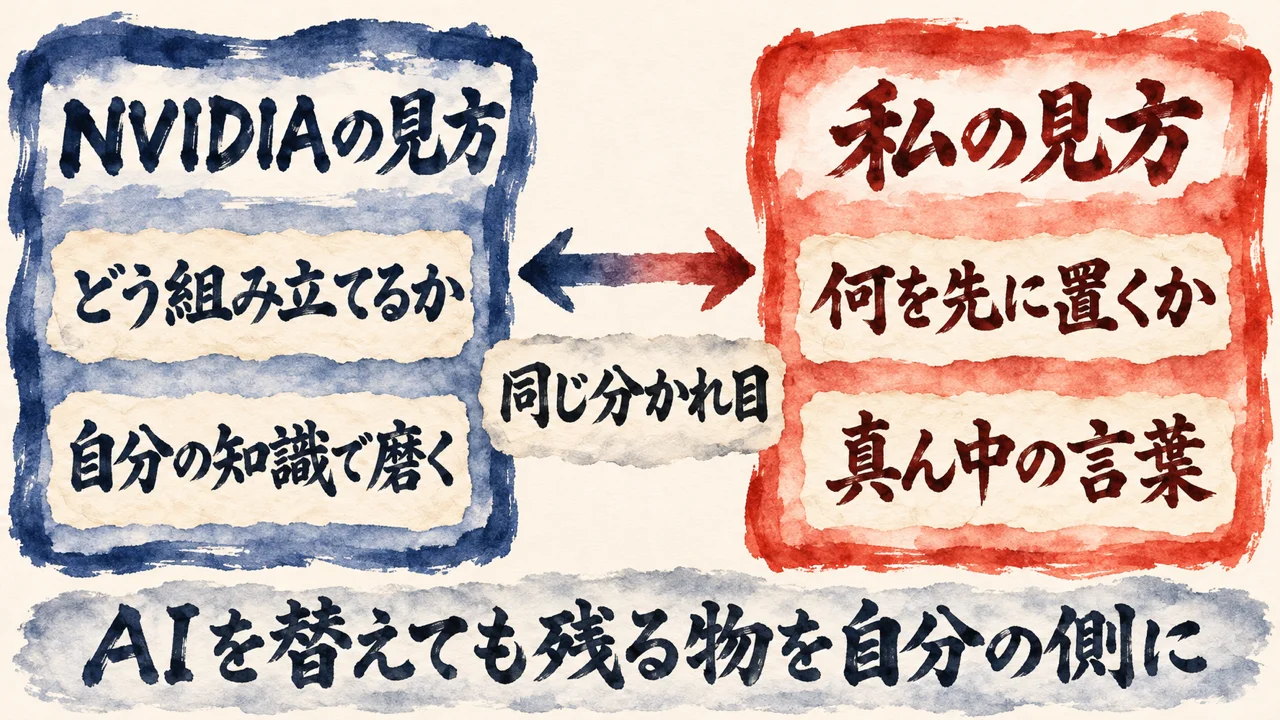
言い直すと、強いモデルを選ぶこと自体は決め手になりにくく、手に入るモデルをどう組み立てて使うかで差がつく、ということです。
記事はこの流れを「AIの活用からインテリジェンスの所有へ」と呼びます。独自の知識で最適化して、実際のビジネス成果に照らして評価したモデルで、決まった仕事をこなすエージェントを作る。
そのためにはモデルそのものにアクセスする必要がある、という筋です。
AI氣道『NotionのFDE担当、AIの乗り換えは文脈の置き場が整えば軽いと話す』より
「再現性の中身は、道具ではなく、真ん中に置いた言葉。どのAIを使うかより先に、何を置くかで決まるんですよね。」
AIを替えても残る物を、先に自分の側に置くという考えを、私は『NotionのFDE担当、AIの乗り換えは文脈の置き場が整えば軽いと話す』で書いています。
NVIDIAは、AIを作る組織の側から「どう組み立てるか」を見ています。私は、AIを使う人の側から「何を先に置くか」を見ています。見る場所は違うのに、同じ分かれ目を指している。私の読みです。
セカンドブレインの導入セミナーで、私はこう話しました。自分の言語化が済んで、第二の脳ができていれば、新しいAIツールと組み合わせた瞬間に、最新のAIが私の原液(体験や判断の元になる言葉)を活かせる、と。
逆にそれが無いと、AIごとに自分の状況を説明し直すことになります。地味です。でも、効いてくるのはここなんですよね。
ChatGPTやClaudeを使い分けている一人社長なら、組み立てる材料は何か。答えは、自分の仕事の言葉と、これなら出せるという基準だと私は考えます。
オープンモデルなら機密データを第三者経由で送らずに検証と評価ができる、とNVIDIAは言う
NVIDIA Japan Blog・Joey Conway氏の記事(機密データと評価の話)
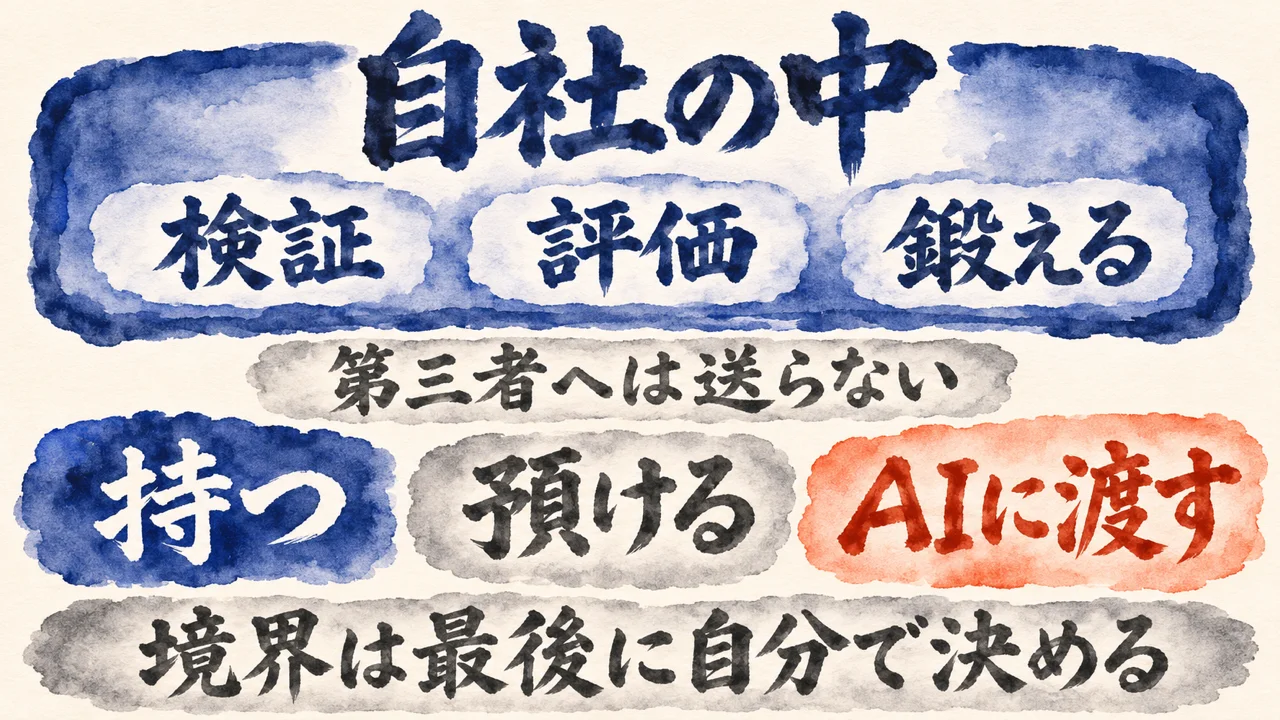
オープン モデルを利用すれば、チームは自社のアプリケーションを検証し、独自の基準に基づいて自社内で評価を実施し、自社のワークフローに合わせた強化学習環境を構築できます。その際、自社の機密データを第三者経由で送信する必要はありません。
言い直すと、機密データを外に出さないまま、自社のAIを自分たちの手で確かめ、採点し、鍛えられる、という約束です。
記事は、ヘルスケアや法務のように機密データを扱い、厳しい精度の基準が求められる業界では、誤答の代償が非常に大きいと書きます。
そうした組織には、モデルがどう訓練され、どんな性能を示すかを把握して、必要なら改善できることが不可欠。記事の流れはここです。
オープンモデルなら、自社のアプリケーションを検証できます。独自の基準で、自社の中で評価もできる。強化学習の環境も、自社のワークフローに合わせて作れる、とNVIDIAは言います。
強化学習の環境とは、AIに「うまくいった・いかなかった」を返して腕を上げさせる練習場のことです。
AI氣道『情報漏洩に備えて、データを預ける前に預け先の責任範囲を自分で確かめる』より
「持つ・預ける・AIに渡すの境界は、最後に私が決めます。」
持つ・預ける・AIに渡すの境界を最後に自分で決めるという考えを、私は『情報漏洩に備えて、データを預ける前に預け先の責任範囲を自分で確かめる』で書いています。
NVIDIAの「第三者経由で送らない」と、私の「持つ・預ける・AIに渡すの境界を最後に私が決める」は、入口が違います。NVIDIAは、自分で持てば送らずに済むと言う。
私は、預けるとしても渡す物を自分で決めると考えます。
私の場合、分身AIの元になる文書の禁止事項に「個人情報の漏洩を避け、家族とクライアントの情報は守る」と入れています。文書どうしの関係を探す道具に渡すのも、私が明示的に選んだMarkdownだけです。
入口は違っても、渡す物を先に決める点は同じ。私の読みです。
Nemotronと複数のモデルの組み合わせ。大きなモデルと小さなモデルの役割分担を読む
NVIDIA Japan Blog・Joey Conway氏の記事(複数モデルの組み合わせの話)
最も効果的なエージェント型 AI アプリケーションは、複数のモデルで構成されるシステムです。
言い直すと、1つの万能なモデルに任せるより、得意な役を持つモデルを組み合わせる方が効く、ということです。
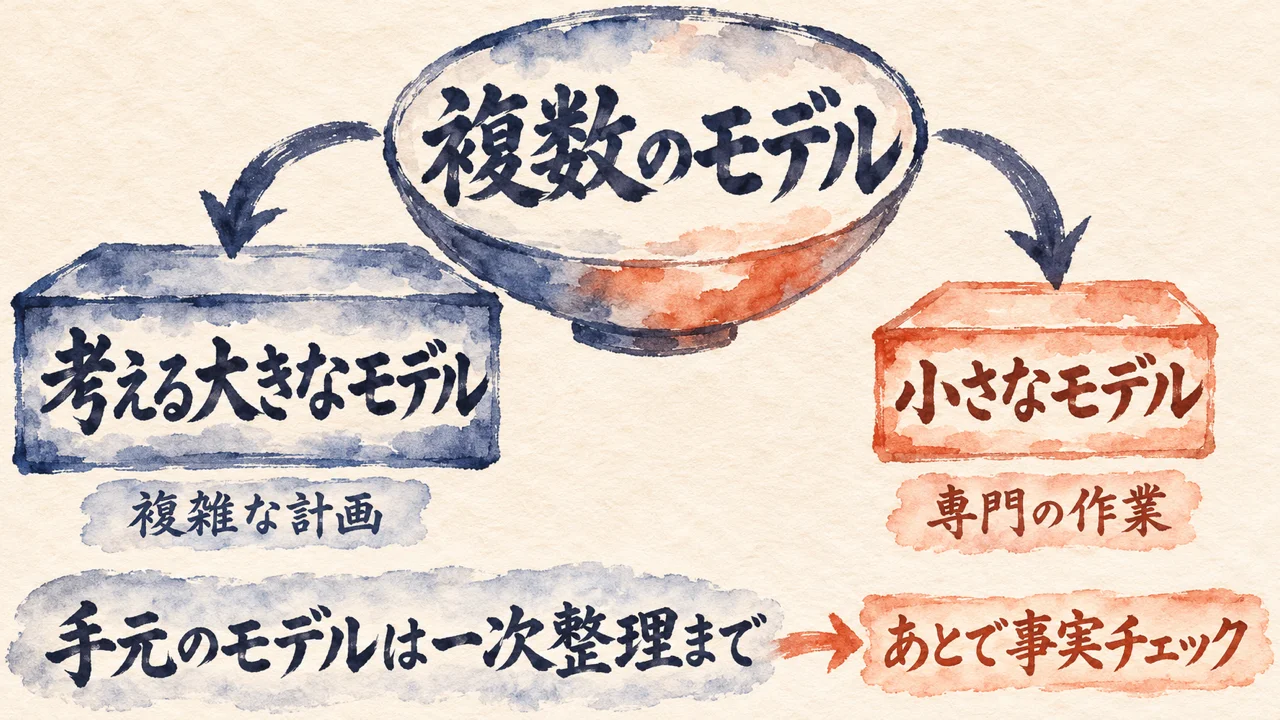
記事によると、いちばん効果的なエージェント型のAIアプリは、複数のモデルでできたシステムです。オープンモデルと最先端のフロンティアモデルが連携し、それぞれが得意な役を担います。
高性能なリーズニングモデル、つまり順を追って考えるのが得意なモデルは、複雑な計画に向きます。一方、小さなモデルは専門的な作業を実行できる。
これで推論の負担を適正にし、特定の仕事の精度を上げ、ワークフローの変化にも対応できる、と記事は書きます。
AI氣道『AGI CockpitのQoder・Cursor・ローカルQwen・Fleetを試して、どれをいつ使うか分かった』より
「ここは使える。社外に出したくないメモの、一次整理に向く。」
手元のモデルには一次整理までを任せるという考えを、私は『AGI CockpitのQoder・Cursor・ローカルQwen・Fleetを試して、どれをいつ使うか分かった』で書いています。
AGI Cockpitで、手元のQwen 3.6に、社外に出したくないメモの要約を頼みました。2026年8月13日の試用です。
189字の要約は、論点を残していました。ただ、厳密に原文の範囲で見ると、日付から日数を足した記述や、次にやることを勝手に決めた箇所があったんです。
だから結論は、一次整理に向く、です。厳格な抽出には、あとで事実チェックが要ります。最初は入力の上限が小さくて拒否されたので、上限を大きくして通しました。
つまり私は、手元のモデルに一次整理までを任せ、その先に別の手順を置いたんですよね。NVIDIAの「役割で分ける」と向きは同じです。
ただ、NVIDIAは組織がモデルを組む話で、私は一人が道具ごとの任せる範囲を決める話。私の読みです。
公開ベンチマークではなく自社の基準で評価する。AIの判断をどう見て、どう直すか
NVIDIA Japan Blog・Joey Conway氏の記事(自社の基準で評価する話)
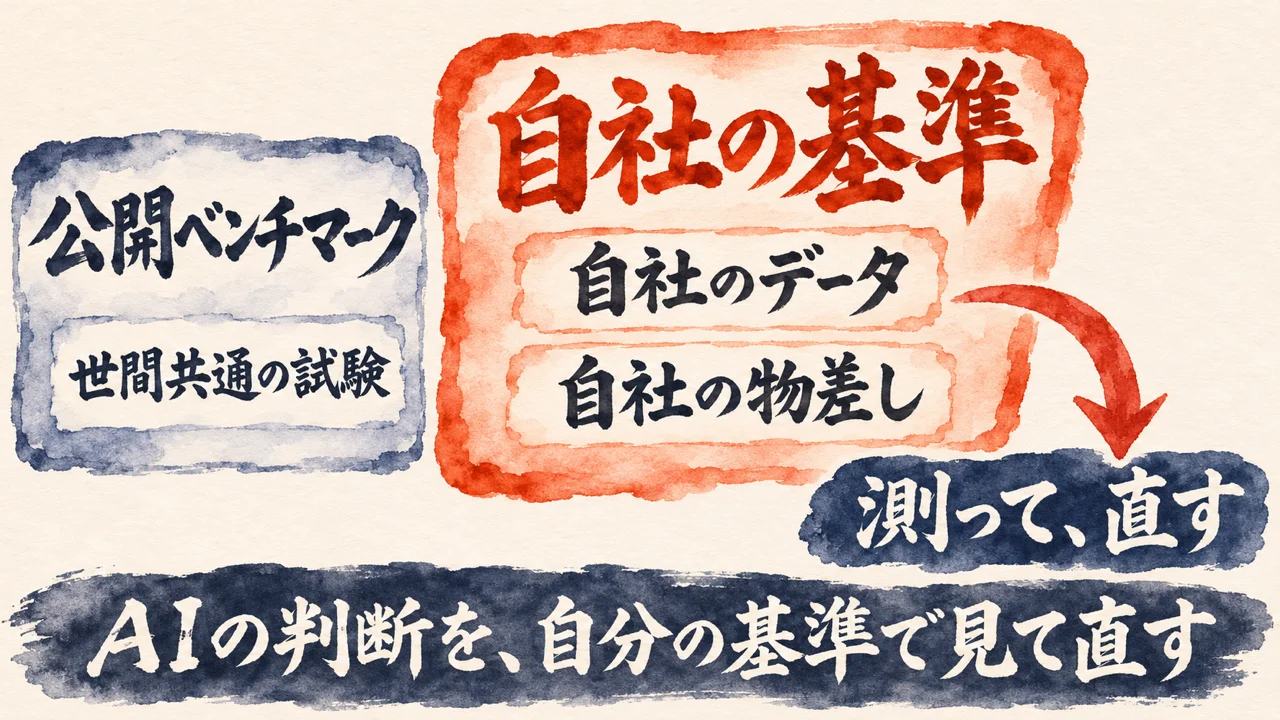
公開ベンチマークは汎用的な能力を測定するものですが、ビジネスに特化した評価を行えば、自社のデータ、ワークフロー、精度の定義を基準にテストし、その結果をもとに改善を進めることができます。
言い直すと、世間共通の試験の点数ではなく、自社の仕事の物差しで測って、そこから直していく、ということです。
記事は、公開ベンチマークは汎用的な能力を測る物だと言います。ベンチマークとは、AIの腕を測る共通の試験のこと。
これに対して、ビジネスに特化した評価なら、自社のデータ、ワークフロー、精度の定義でテストして、その結果で改善を進められる、と書きます。
例としてLangChainが出ます。
モデルを再トレーニングせず、プロンプト、ツール、ミドルウェア(AIと外の道具の間をつなぐ部分)を調整して、Nemotron 3 Ultra向けにDeep Agentsハーネスを最適化しました。
ハーネスとは、AIの動きを周りで支える仕組みのことです。その結果、オープンモデルの中で最高のエージェント精度を達成した、とNVIDIAは紹介しています。これはNVIDIAによる紹介として読みます。
AI氣道『AIに判断まで委ねるには、魂を込めて教える時間がいる。その時間は私の学びにもなりました』より
「自分らしく判断ができれば自分の代わりに判断する仕事も委ねることができる」
AIの判断を見て、魂を込めて教えるという考えを、私は『AIに判断まで委ねるには、魂を込めて教える時間がいる。その時間は私の学びにもなりました』で書いています。
これは10月26日の魂磨きの一節です。いま私が実際に手をかけているのは、分身AIが出した判断を見る部分。フィードバックに加えて、AIがどう判断して、どう認識しているかまで見ています。
AIに魂を込めてAIが自分らしく判断できるようにしていく。そのために、教える時間を取ります。教える時間は、私の学びにもなるんです。
NVIDIAの「自社の精度の定義でテストする」と、私の「AIの判断を自分の基準で見て直す」を並べると、基準を自分の側に置く点が重なります。
同じ「ハーネス」という言葉が出てきますが、指す物は違います。NVIDIAの例はプロンプトやツールの調整。私の言う魂磨きは、判断の見方です。私の読みです。
Nemotronの6事例。Abridge・Glean・H Company・Harvey・Heidi Health・YTL AI Labsを読む
NVIDIA Japan Blog・Joey Conway氏の記事(Abridgeの事例の話)
Abridge は Nemotron をカスタマイズし、臨床現場での対話に特化して設計された初の基盤モデルを構築しています。
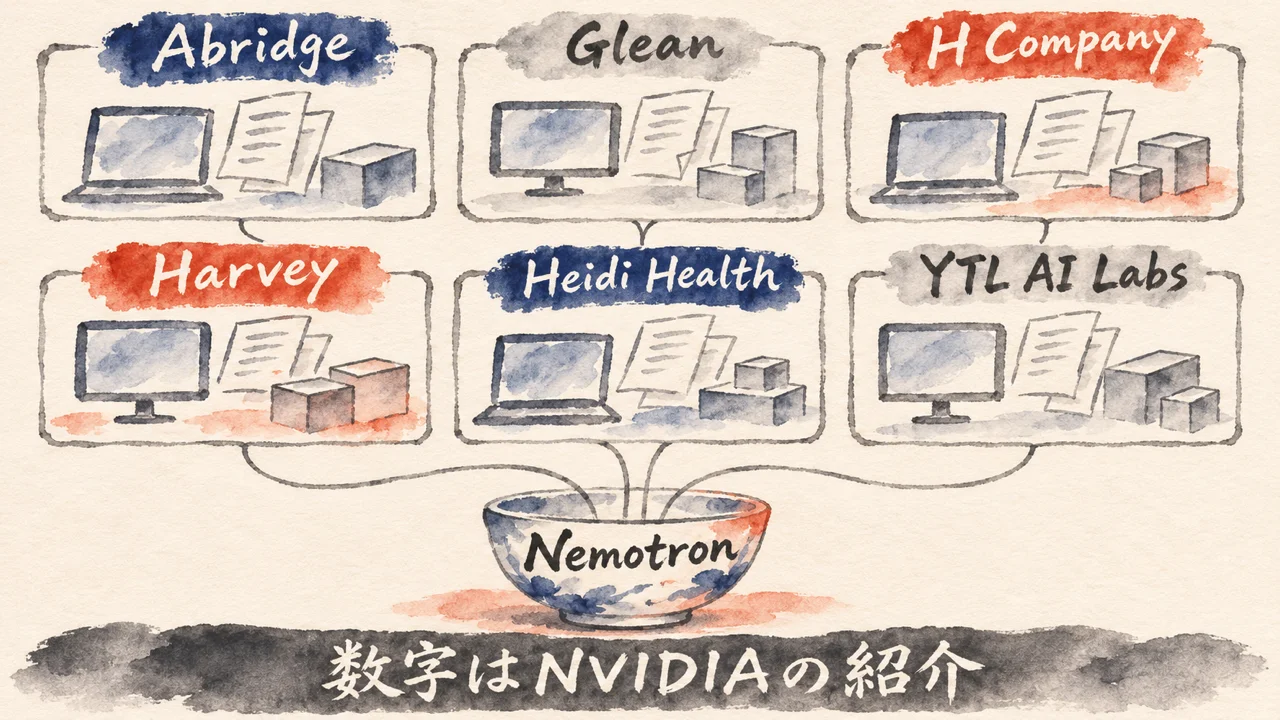
言い直すと、6つの会社が、それぞれの分野に合わせてNemotronを磨いた事例が並んでいる、という紹介です。記事は6社を順に挙げます。
Abridgeは、臨床現場での対話に特化して設計された初の基盤モデルを構築しています。
Gleanが開発したWaldoは、Nemotronをさらに大規模なクローズドモデルと組み合わせたエージェント型の検索モデル。遅延を大幅に抑え、少ない処理量で企業内の検索を実現する、と紹介されます。
H Companyは、独自のコンピューター操作データで、Nemotron 3 Nano Omniをポストトレーニングしました。ポストトレーニングとは、モデルにさらに追加で学習させること。
できあがったHolotron 3 Nanoは、コンピューター操作のベンチマークOSWorld-Verifiedで76%を超える精度を達成した、と記事は紹介します。
Harveyは、自社の法務ベンチマークでNemotron 3 Ultraをポストトレーニングし、最先端クラスの精度に届いたと紹介されます。
Heidi Healthは、臨床文書の作成でフロンティアモデルに匹敵する成果。YTL AI Labsは、マレー語向けにポストトレーニングして、マレーシアの開発者コミュニティに提供しています。
さらに記事は、周りの道具も挙げます。NeMoは、モデルのカスタマイズと評価を加速するオープンなライブラリ群。
Prime IntellectとUnslothは、ポストトレーニングの流れを作る企業を支援しています。Arcee AIはPinchBenchで2位に入ったと紹介されます。
ここで数字の読み方です。これはNVIDIAの公式ブログなので、数字はNVIDIAと各社の側の主張として読みます。独立に確かめた記録は、記事には載っていません。
6社の共通点は、特定の分野で、自分たちの基準で評価した、ということだと私は読みます。分野は医療、法務、検索、コンピューター操作、マレー語とばらばら。基準を先に持っている点が揃っているんですよね。
個人と小さな会社が、AIの所有より先に自分の側へ持つ物。合格の基準・渡さない線・真ん中の言葉
NVIDIA Japan Blog・Joey Conway氏の記事(独自の知識と成果で評価する話)
これらのエージェントは、独自の知識で最適化され、実際のビジネス成果に照らして評価されたモデルを用いることで、明確に定められたタスクを適切に遂行できるよう構築されています。
言い直すと、自分たちの知識で磨き、成果で評価したAIなら、決まった仕事を任せられる、という流れです。ここから先は、個人や小さな会社に当てはめる私の読みになります。
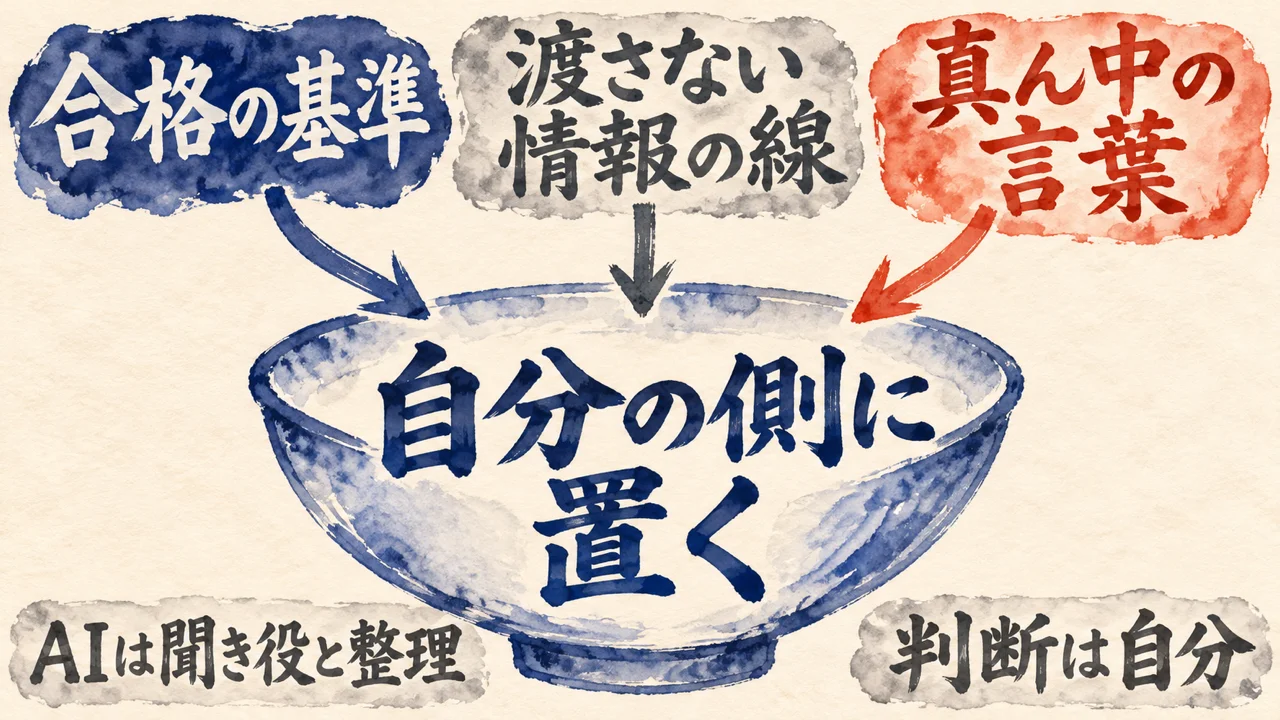
私は、モデルの重み(AIの中身そのもの)を持たない個人や小さな会社が、先に自分の側へ持てる物が3つあると考えます。合格の基準。渡さない情報の線。それから、真ん中に置く言葉です。
ここは私の推測で、私の過去記事の考え方を重ねた読みです。
1つ目は合格の基準。自分の仕事で、これなら出せると言える線を、1行で書きます。NVIDIAの言う、自社の精度の定義にあたります。
2つ目は渡さない情報の線。持つ、預ける、AIに渡すに分けて、最後は自分が決めます。
3つ目は真ん中に置く言葉。AIを替えても残る、自分の経験や判断や価値観の言葉です。
この3つなら、オープンモデルを使うか、ChatGPTやClaudeのような外のAIを使うかに関わらず、今日から自分の側に置けます。ここが大事です。
書き出す時は、AIに問いを出してもらい、私が1つずつ答える形が合います。魂磨きの形ですね。AIには判断させず、聞き役と整理を頼みます。AIが出した基準案は、そのまま採用しません。
モデルの重みを持つ必要があるかは、仕事次第です。私は、持つ物の決め方を先に見ます。
読んだあと、自分の仕事の場合で確かめたい人へ
AIの所有の話を自分の仕事に当てはめて、渡さない線と合格の基準を1行にするプロンプト
枠の中にこの記事のURLが入っていて、AIが記事を読んでから、AIの使い方を自分の仕事に当てはめて整理してくれるプロンプトです。読んで終わりにせず、自分の環境ですぐ使える追加のプロンプトまで手元に残せます。
1
記事の話と、私の読みの仕分け
NVIDIAの記事で語られた内容、書き手の考え、推測、未確認を分けて返します。元記事の主張と事例の数字を、そのまま事実として扱わずに読み比べられます。
2
持つ・預ける・渡すの整理
4つの質問に答えると、自分の仕事のAIの使い方が、持つ・預ける・AIに渡すに分かれて返ってきます。合格の基準と渡さない線の候補も、複数並びます。
3
環境に合う追加のプロンプト
使っているAIエージェントや道具に合わせて、記事のURL入りのプロンプトを1〜3本、そのまま貼れる形でつくります。
AIの答えは下書きとして受け取り、任せ切りにせず自分の目で読み直す前提です。使ってみたい時だけ、下のボタンから使い方と依頼文を開いてください。
▶ タップしてプロンプトを開く
下の枠の文を丸ごとコピーして、手元のAIエージェントに貼ってください。枠の中には、この記事のURLが入っています。記事を読んだAIから、短い質問が4つ、1つずつ届きます。
答えると、持つ・預ける・渡すの整理と、環境に合わせた追加のプロンプトが返ってきます。ただ、返ってきた結果はそのまま信じず、自分の目で読み直してください。何を持ち、何を渡すかを決めるのは自分です。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
https://ai-kidou.jp/nemotron-open-model-ai-ownership-nvidia/
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、下の記事の要点だけを材料にしてください。

【目的】
NVIDIA Japan Blogの「AIの所有」の記事の解説を読んで、私の仕事に当てはめて整理します。モデルを持つ話と、自分の側に先に持つ物の話を分けて、①今日AIに渡さない情報の線、②AIの出した結果の合格基準、③AIを替えても残る真ん中の言葉、のうち少なくとも1つを、私の言葉で1行にすることが目的です。そのうえで、私の環境で使える追加のプロンプトをつくります。

記事の要点
・NVIDIA Japan Blog(Joey Conway氏、2026年7月30日公開)は、AIを導入する段階から、AIを所有する段階への移行が進んでいると書いている。オープンモデルNemotronを軸に、自社の知識で磨いて自社の基準で評価することを勧める、NVIDIA自身の公式ブログである。
・機密データを第三者経由で送らずに、検証と評価ができる。複数のモデルを役割で組み合わせる。公開ベンチマークではなく、自社のデータ・ワークフロー・精度の定義でテストする。
・6社の事例(Abridge、Glean、H Company、Harvey、Heidi Health、YTL AI Labs)の数字は、NVIDIAと各社の側の主張として読む。独立に確かめた記録は元記事に載っていない。
・書き手の考え: NVIDIAの所有はモデルの話。個人や小さな会社が先に自分の側へ持つのは、合格の基準、渡さない情報の線、真ん中に置く言葉ではないか(これは推測)。

【やってよいこと】
1. 記事を読んだあと、次の4つを1つずつ質問してください。答えが返ってから次の質問へ進んでください。
 ・AIに任せている仕事のうち、結果を自分で最後に確かめている物は何か
 ・AIに渡したくない情報は何か(種類だけでよい。中身は書かなくてよい)
 ・AIを替えても自分の側に残したい考え方や判断の基準は何か
 ・私が使っているAIエージェントや道具は何か
2. 答えをもとに、「持つ」「預ける」「AIに渡す」の3つに分けて整理してください。整理だけにして、私の判断の良し悪しは評価しないでください。
3. 合格の基準、渡さない情報の線、真ん中に置く言葉のそれぞれについて、私の言葉で書ける1行の候補を、複数挙げてください。決めつけず、選ぶのは私です。
4. モデルを自分で持つ必要があるかどうかは、私の仕事次第として、確かめる問いを3つ挙げてください。結論は出さないでください。
5. 私の環境で、そのまま貼って使える追加のプロンプトを、1〜3本つくってください。記事のURLを、各プロンプトの中に入れてください。

【守ること】
・設定の変更、削除、送信、購入、公開は行わないでください。提案として書くだけにしてください。
・パスワード、鍵、口座の情報、顧客の個人情報は求めないでください。貼られても使わず、消すよう伝えてください。
・記事の内容は、記事に書かれた主張として扱い、確かめられた事実とは書かないでください。事例の数字も、NVIDIAと各社の主張として扱ってください。
・分からない所は、推測で埋めずに未確認と書いてください。推測を書く時は「これは推測です」と付けてください。
・材料は、上のURLの記事と記事の要点、私の答えだけにしてください。記事に無い数字・対策を足さないでください。追加のプロンプトに足してよいのは、私の環境に合わせた言い方と手順だけです。この依頼で禁じたことは、追加のプロンプトの中にも同じように書いてください。

【返す形】
(1) 持つ・預ける・AIに渡すの整理
(2) 合格の基準、渡さない情報の線、真ん中に置く言葉の1行の候補(複数)
(3) モデルを自分で持つ必要があるかを確かめる問い(3つ)
(4) 次に確かめること(3つまで)
(5) 私の環境で使える追加のプロンプト(1〜3本。記事のURL入り)
(6) 提案として書いたこと(あれば。実行はしていないと添える)
最後に、私が自分の目で読み直したほうがよい所を1行で添えてください。よくある質問
Q. オープンモデルとは何ですか?
A. 中身にさわって自分向けに直せるAIのことです。NVIDIAの記事は、モデルそのものにアクセスでき、企業が検証・最適化・改善できる物として説明しています。中身を見せずに提供されるクローズドモデルと対比されています。
Q. NVIDIAの言う「AIを所有する」とは何ですか?
A. 記事では、オープンモデルを自分たちの知識で磨き、自社の基準で評価し、制御まで自分たちで持つ状態として語られます。私は、モデルの話と自分の側の話に分けて読むのがよいかな、と考えます。
Q. Nemotronとは何ですか?
A. NVIDIAのオープンモデルです。記事は、カスタマイズを前提に作られていて、企業や国家が制御できて信頼できるAIを作る助けになると紹介しています。NVIDIA自身の記事なので、立場のある書き手の説明として読みます。
Q. 個人でもオープンモデルを持つ必要がありますか?
A. 仕事次第です。私は、持つ必要があるかを考える前に、合格の基準と、渡さない情報の線と、真ん中に置く言葉を書き出します。ここが先ではないか、というのは私の推測です。
Q. 元記事の事例の数字は、そのまま信じてよいですか?
A. NVIDIAと各社の側の主張として読みます。独立に確かめた記録は記事に載っていないので、自分の仕事に当てはめる前に、自分の基準で確かめるのがよいと私は考えます。
「AIの所有」を、モデルの話と自分の側の話に分けて読む
NVIDIAの記事は、AIの活用から所有へという流れを、オープンモデルNemotronを軸に語っていました。モデルそのものにアクセスして、検証し、直し、自社の基準で評価できる。それが記事の言う所有です。
記事の柱は3つありました。機密データを第三者経由で送らずに済むこと。複数のモデルを役割で組み合わせること。公開ベンチマークではなく自社の基準で測ること。6社の事例も、NVIDIAと各社の主張として読みます。
私の過去記事に重ねると、見える景色が少し変わります。AIを替えても残る真ん中の言葉、持つ・預ける・渡すの線、AIの判断を見る目。どれも、モデルの重みを持たなくても、今日から自分の側に置けるのではないか、と私は読みます。これは私の推測です。
個人や小さな会社が先に持つのは、合格の基準、渡さない情報の線、真ん中に置く言葉の3つではないか、と私は読みます。これは私の推測で、私の過去記事の考え方を重ねた読みです。この中から1つを書き出してみてください。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
持つ物を決める前に、手放さない物を一つ言葉にする
NVIDIAのブログは、企業が自社の知識でAIを磨き、モデルを「所有」することを語っています。読みながら、調理場の仕事を思い浮かべました。店を開く人が最初に決めるのは、仕入れの量ではない。スープの土台を自分で煮出すのか、買ってくるのか。ここなんです。土台は店の味の根っこ。煮出し方を人に任せると、同じ名前の料理でも別の店の味になります。一方で、野菜の下ごしらえや皿洗いは、人に任せても味は崩れません。全部持つか、全部任せるか。そういう二択ではないんですよね。手放さない物を先に一つ決めて、残りは渡す。この順番が先にあります。所有の話に入る前に、自分のスープの土台は何かと考える。そこが抜けたままだと、何を持つかも決まらない気がします。
AI氣道『「魂は渡さないだろ、込めるものだろ」』より
「委ねる前に磨くのは魂で、委ねた後に量産されるのはボール。二つを混ぜて「魂ごと手放した」と錯覚しないこと。」
この向きは、私が『「魂は渡さないだろ、込めるものだろ」』で書いたことと重なります。魂は渡すものではなく、込めるもの。委ねた先で量産されるのは、実行のボール。二つを混ぜない。そう書きました。NVIDIAが「所有」と呼ぶ対象はモデルで、私が書いてきたのは、目的と守りたいもの、判断軸でした。持つ物は違います。それでも、手放さない物を先に決める。その順番は同じ向きに見えます。だからモデルを所有する前に、整えておきたい準備があると思うんです。自分が手放したくない物を、まず一つ言葉にする。この準備がないまま所有に進むと、持った物が自分の味かどうか、確かめる基準がありません。
仕込みは人に任せても、最後の味見には店主が立つ。任せた鍋の味が店の味から外れたとき、直せるのは味見をした人だけです。AIも同じように考えられます。複数のAIを使い分けていると、どの仕事を誰に渡したか、だんだん曖昧になる。そこで、渡した仕事を一つ選んでみてください。結果を自分の味で最後に確かめている仕事です。何を見て「合格」と決めているのか。色なのか、塩加減なのか。それを三行で書いてみる。書けたら、それが手放さない物の最初の候補になります。書けなければ、まだ土台が決まっていないということ。そこに気づけるだけで、今日の一歩は十分です。手放さない物を、まず一つ言葉にする。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
NotionのFDE担当が、AIの乗り換えは文脈の置き場が整えば軽いと話した動画を、私の読みで紹介した記事です。
情報漏洩に備えて、データを預ける前に、預け先の責任範囲を自分で確かめる考え方をまとめた記事です。
ローカルLLMはどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える方法を扱った記事です。
参考リンク
AIの所有を、オープンモデルNemotronを軸に語った元の記事
第2章で引用した、AIを替えても残る真ん中の言葉を書いた私の記事
第4章で引用した、手元のモデルに一次整理までを任せた試用を書いた私の記事
コラムで引用した、魂は渡さず込めるものと書いた私の記事
今回紹介した記事
| 著者 | Joey Conway(NVIDIA) |
| 媒体 | NVIDIA Japan Blog |
| 公開日 | 2026年7月30日 |
| 元URL | https://blogs.nvidia.co.jp/blog/nemotron-open-models-ai-trust-control-customize/ |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!