READ REPORT
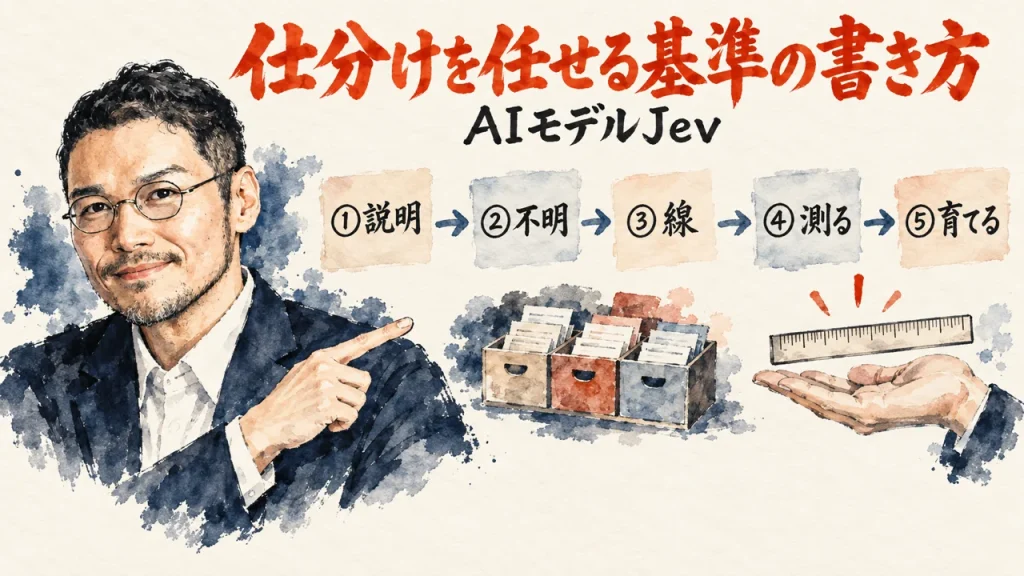
AIモデルJevに問い合わせの仕分けを任せる基準の書き方をHELLO_CYBERNETICSさんが解説
2026年9月21日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、HELLO_CYBERNETICSさんがZennに書いた「Jevを、自然言語で分類基準を渡せる識別モデルとして使う」を紹介するね。
届いた問い合わせを1通ずつ開いて、請求なのか、配送なのか、返品なのかを自分で決める。この仕分けをAIに渡したくなった時、手が止まるとしたら、「基準」が頭の中にあって、言葉になっていないからかもしれません。この記事を読むと、元記事の2つの例をもとに、AIモデルJevに仕分けを頼む時に先に書いておきたいこと、つまり候補ごとの意味の説明と、根拠がない時の「不明」という選択肢と、確率が競った時に人へ回す線が、つかめます。この整理は元記事そのものではなく、私がまとめたものです。
3行でわかるポイント
- 軸を差し替えれば別の仕事になる。質問と候補を変えるだけで、同じモデルが別の仕分けに使えます
- 基準文は使う側が書く。候補名を書くだけでは基準が決まるとは限らず、最初の意味の説明は使う側が書く仕事です
- 「不明」と人に回す線を先に置く。根拠がない時の「不明」と、確率が競った時に人が見る線です
HELLO_CYBERNETICSさん/Zenn/2026年9月19日公開
「質問と候補を変えれば、同じモデルで別の分類を行える」——Jevは、軸を差し替えれば別の仕事をする
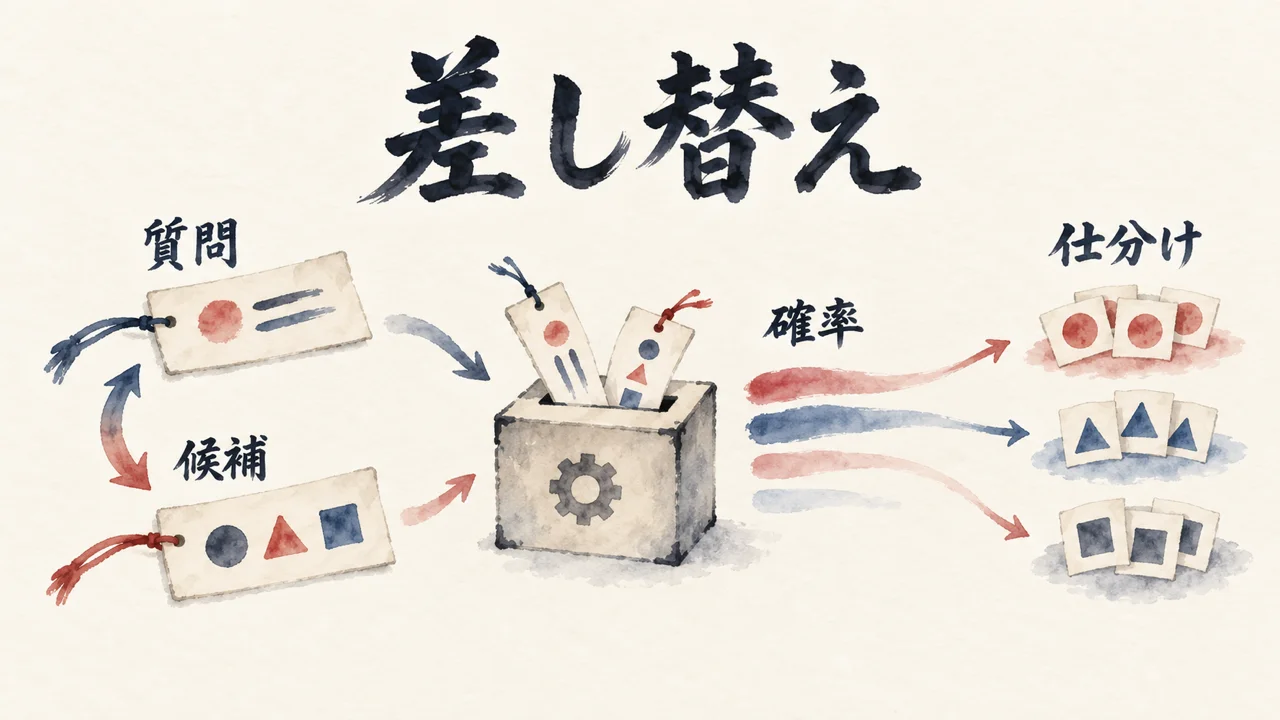
HELLO_CYBERNETICSさん(Zenn・Jevを分類器として見た冒頭の整理部分)
質問と候補を変えれば、同じモデルで別の分類を行える。「自然言語でタスクを指定できる識別モデル」という理解でよいと思う。
元記事は、Jevの使い方を、判定したい文章と質問と候補を渡して、候補ごとの確率を受け取る形で説明しています。識別モデルとは、候補の中から答えを選んで、その確率を返すAIモデルのことです。Jev自体の紹介は動画解説の記事にまとめました。
たとえば「商品が届かない。配送状況を確認してほしい」という問い合わせに、請求・配送・返品・その他の説明を付けて、担当部署を聞く。元記事の例(説明用の数字です)では、配送が0.94と返ってきます。同じ文章に「希望している対応は何か」と聞き直せば、別の仕分けに変わります。
仕事に置き換えると、毎朝届く問い合わせメールを「急ぎ」「あとで」「不要」に分ける場面です。急ぎの基準が「今日中に返事が要る」なのか「取引先からのもの全部」なのかで、同じメールでも分け先が変わります。Jevに渡す説明は、この頭の中の決め事を、そのまま文章にしたものです。
元記事は数式やカリブレーションにも紙幅を割いています。ただ、私が中心に読んだのは、「何を聞くか」「どんな選択肢を並べるか」という、人間が決める部分です。
これは、分身AI(私の判断軸を教えて、仕事を任せているAI)に任せる時の条件と同じ形をしています。分身AIは、本人が置いていない分類や物語を足さない。軸を置くのは私です!
元記事は、軸を差し替える手軽さの話として読めます。私はそこに、差し替える前に自分の軸があるか、という問いを足したいです。軸が曖昧なままモデルを選んでも、仕分けの中身は決まりません。選ぶなら、モデルの比較より先に、自分の軸です。
🎯 手放したい仕分けを1つ選ぶ 今週、自分の手で3回以上やった仕分けを1つだけ、紙に書き出してください(5分。書けたら完了です)。
「候補名を書くだけで分類基準が決まるとは限らない」——問い合わせの仕分けを任せる基準は、使う側が書く
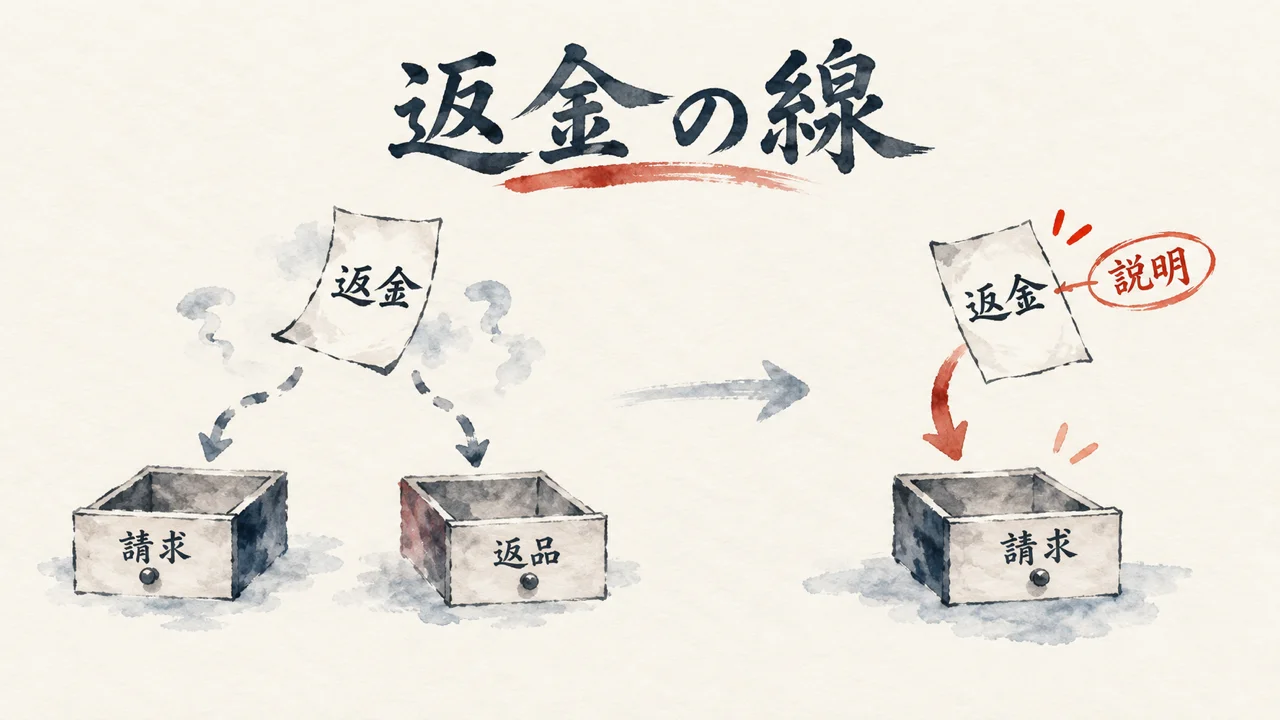
HELLO_CYBERNETICSさん(Zenn・分類基準の選定の重要性の節)
もちろん、候補名を書くだけで分類基準が決まるとは限らない。たとえば「返金」は、請求にも返品にも関係する。「二重請求に対する返金は請求担当」「商品返品に伴う返金は返品担当」と定義するのは、使う側の仕事になる。
元記事が例に挙げるのは「返金」です。請求にも返品にも関係する言葉なので、ラベルの名前を渡すだけでは、線が引けない場面があります。二重請求の返金は請求担当、商品返品に伴う返金は返品担当。この線を文章で書くのは、使う側の役目だと元記事は書いています。
「返金」の一語に、請求と返品のどちらの担当が答えるべきか。ここを決める文章がなければ、AIは毎回どちらかを推測するしかありません。頭の中の基準は、AIには見えないからです。だから、AIに任せる基準は最初に文章にして渡しておきたいです。「二重請求の返金は請求担当」と紙に書けば、その基準は、AIにも私にも同じように見えます。
任せる基準も、文章にして外に出して初めて読み返せます。「返金」のように、どの担当にも関係しそうな言葉から書き始めると、線が引きやすいはずです。
🎯 境目の言葉を1つ選ぶ どの担当にも関係しそうな言葉を1つ選び、「〇〇の場合は△△」と2行で線を引いてください(10分)。
「触媒について書いていない」と「触媒は変更していない」を分ける——「不明」という選択肢を先に置く
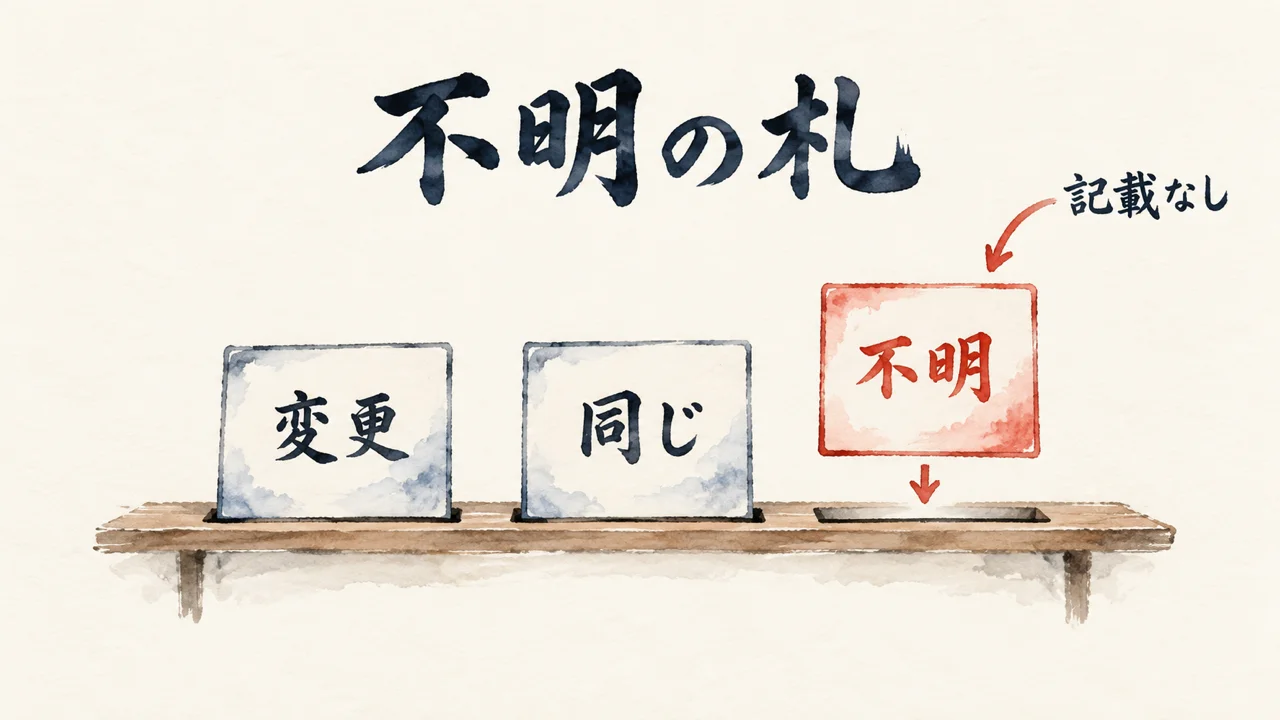
HELLO_CYBERNETICSさん(Zenn・実験報告書の検索の例の要点部分)
「触媒について書いていない」と「触媒は変更していない」を分けるのが、この例の要点だ。文書に根拠がないときの候補を用意しておけば、情報不足を後続処理で扱える。
元記事の二つ目の例は、実験報告書の検索です。「温度を上げたら収率が改善した実験を探したい。ただし、触媒を変えた実験は除きたい」という条件でした。
報告書は3本あります。Aは触媒が同じと書いてあり、Bは触媒も変えたと書いてあり、Cは触媒について何も書いていません。そこで、触媒の欄には「変更・同じ・不明」の3つを用意します。Cは触媒が同じか確認できないので、「条件の確認が必要な候補」として残せる、と元記事は書いています。
仕事なら、取引先への問い合わせに納期の記載がない場面です。「納期は今日」でも「納期の指定なし」でもなく、「書いていない」。この3つ目の答えを最初から用意しておくのが、「不明」という選択肢です。
この選択肢を見て、私が思い出したのは、分身AIとAIチームに求めている姿勢です。まずやり切る。手を尽くす。調べ尽くす。決める。やり切らずに「分からないから聞く」はしません。人へフィードバックを求めてよいのは、AI側が結論まで出し切ったあとだけです。
「やり切る」と「人に返す」は、ぶつかりそうに見えます。でも「不明」という選択肢があると両立します。報告書Cについて「触媒の記載なし」と言い切ることは、聞いているのではなく、結論です!
だから、「不明」は結論として返してもらい、その渡し先は事前に決めておきます。3本すべてを見直す必要はなく、Cの1本だけを見れば済みます。
「不明」という選択肢が無いと、AIは根拠がなくても、どれかの候補を選ぶことになります。埋めるしかない空欄は、危うい答えを生みます。
🎯 根拠なしの選択肢を作る さっき選んだ仕分けに「根拠がない」を1つ足し、それが来た時の渡し先を決めてください(5分)。
「配送の確率が0.94なら自動で担当を決め」——AIに任せる線と人が見る線を、数字で引く
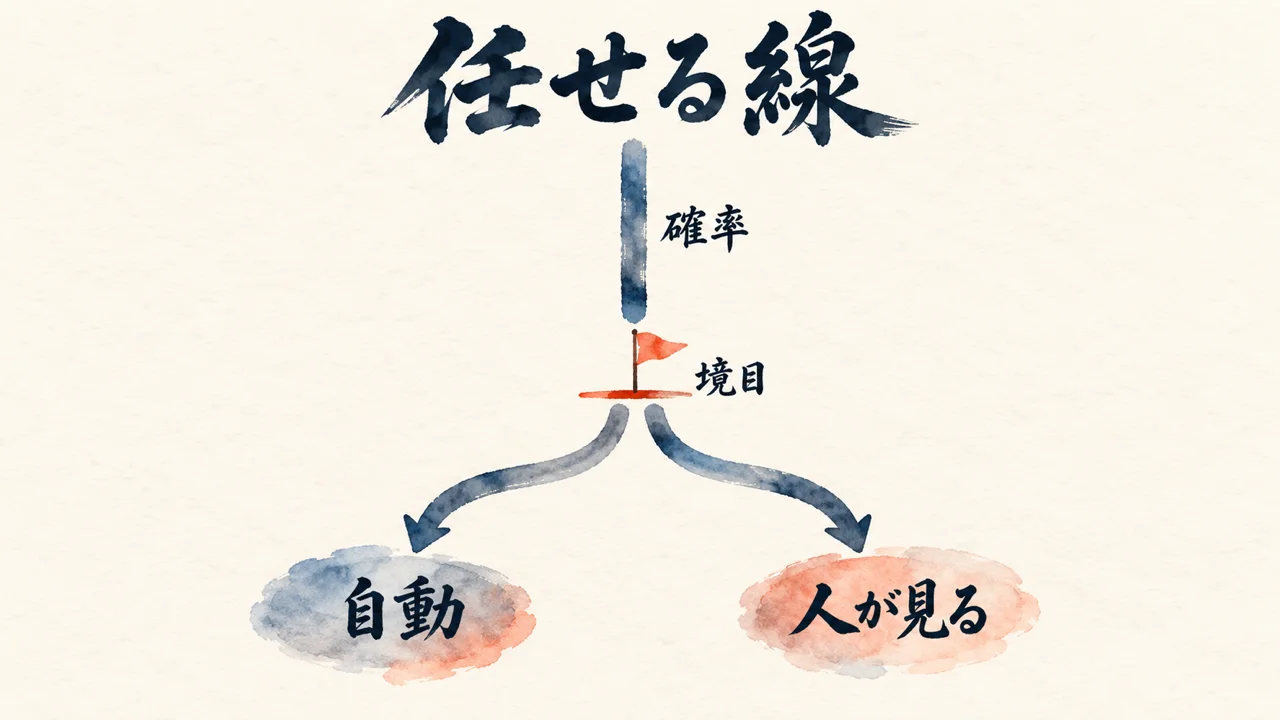
HELLO_CYBERNETICSさん(Zenn・確率が返る運用の部分)
たとえば配送の確率が0.94なら自動で担当を決め、配送0.51・返品0.46のように候補が競っていれば人が確認する。しきい値は、自分のデータで誤判定と確認件数を測って決める。
Jevは候補ごとの確率を返します。だから、迷った入力だけを人に回す運用が組めます。しきい値(自動にするか人が見るかを分ける確率の境目)は、元記事では自分のデータで測って決めるものです。0.94なら自動、0.51と0.46のように競っていれば人が確認する。
たとえば問い合わせが1日10通届くなら、9通はAIが担当を決めて、迷った1通だけが私の画面に並ぶ。そんな朝を想像すると、線を引く意味が見えてきます。
一つのボールを持つ人は、一人だけにします。私が委ねる時の決まりです。人・AI・システムの誰か一人が全管轄してやり切る。複数人の共同責任にはしません。
しきい値は、このボールの持ち主を切り替える線として読めます。0.94なら結果をAIが持ち、競った時は迷った1件だけを人が持つ。線の上と下で持ち主がはっきり替わるので、共同責任になりません!「一つのボールは一人が持つ」という整理は、分身AIとの問答をまとめた記事でも書いています。
ただ、線をどこに置くかは、数字だけでは決まらないと私は考えています。出す、止める、任せる。数字で測ったうえで、最後に線を置くのは私です。
🎯 持ち主の線を仮で置く 「この確率なら任せる」「競ったら私が見る」の2つの数字を仮で決めて、メモに書いてください(10分。仮でかまいません)。
「個々の回答の正しさを保証するものではなく」——確率は約束ではなく、測ってから使う目盛り
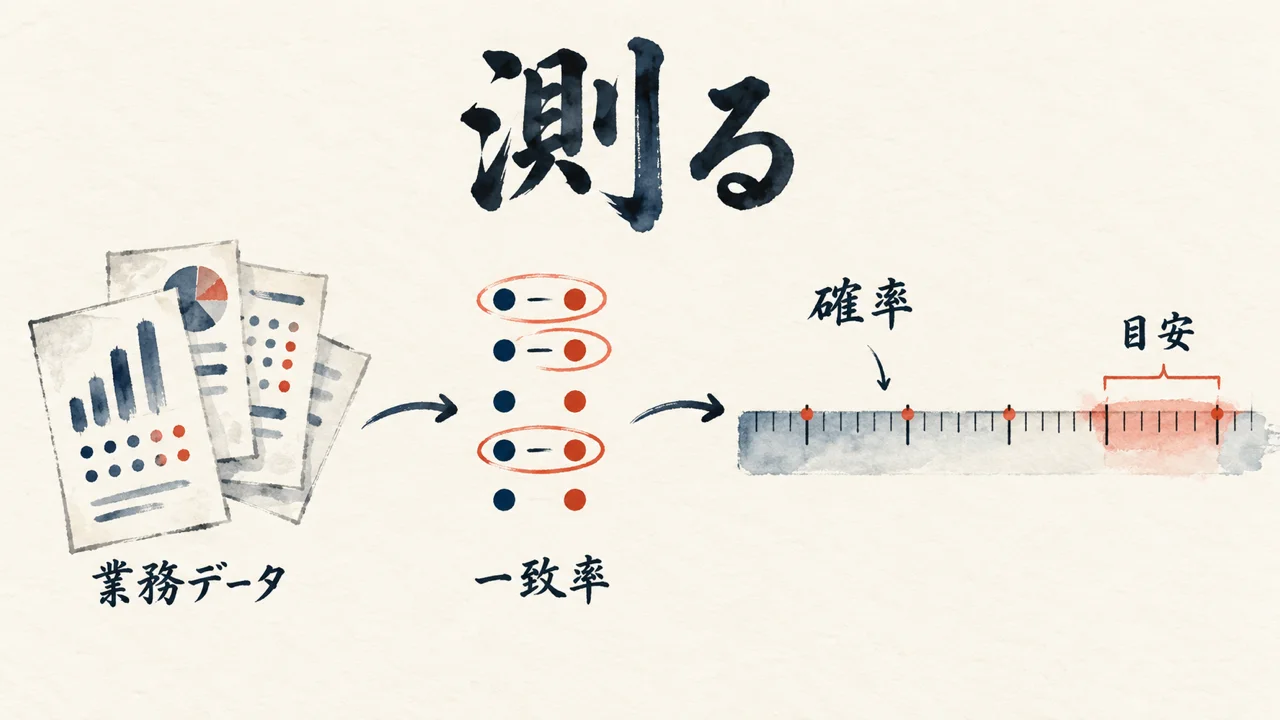
HELLO_CYBERNETICSさん(Zenn・確率カリブレーションの節)
カリブレーションとは、たとえば0.8前後と予測した事例を多数集めると、実際にも約8割が正解する性質である。これが成り立てば、自動処理に任せる範囲や人手確認の量を見積もりやすい。個々の回答の正しさを保証するものではなく、実際の業務データでの確認は必要になる。
元記事には「カリブレーション」という難しい言葉が出てきます。0.8と答えた事例をたくさん集めたら、約8割が実際に当たる性質のことです。成り立てば任せる範囲を見積もりやすい。ただし1件ごとの正しさの保証ではない、と念を押しています。
難しい言葉は、こう言い換えて読みました。「0.8と言ったものが、実際に8割前後当たるか」。数字が保証のように見えても、当たる割合を確かめるまでは、目盛りとして使えません。
たとえば先週の問い合わせ10通を自分で仕分けて、同じ10通をAIにも仕分けさせる。9通が一致したなら、一致率は9割です。これはカリブレーションそのものではなく、一致率の確認です。0.8と答えたものだけを集めて数える確認は、件数が増えてからの仕事になります。
私は、味見は卒業しないと決めています。味見とは、できあがったものを確かめる工程のことです。ただ、味見の粒度は固定しません。1件ずつ人が見るのではなく、AIが出した結果を集めて、判断軸そのものを一段上から見る。元記事が言う「実際の業務データでの確認」は、この上からの味見の材料になると読みました。
数えてみて外れが多ければ、その確率では、「任せる」側に置けません。
🎯 一致率の目安をつかむ 過去に自分で仕分けた10件をAIにも判定させて、一致した件数を数え、一致率を1行メモしてください(30分)。10件で分かるのは目安までで、件数を増やすほど確かになります。
「記載がない場合は不明を選ぶ」——外した仕分けから、基準文を育てる
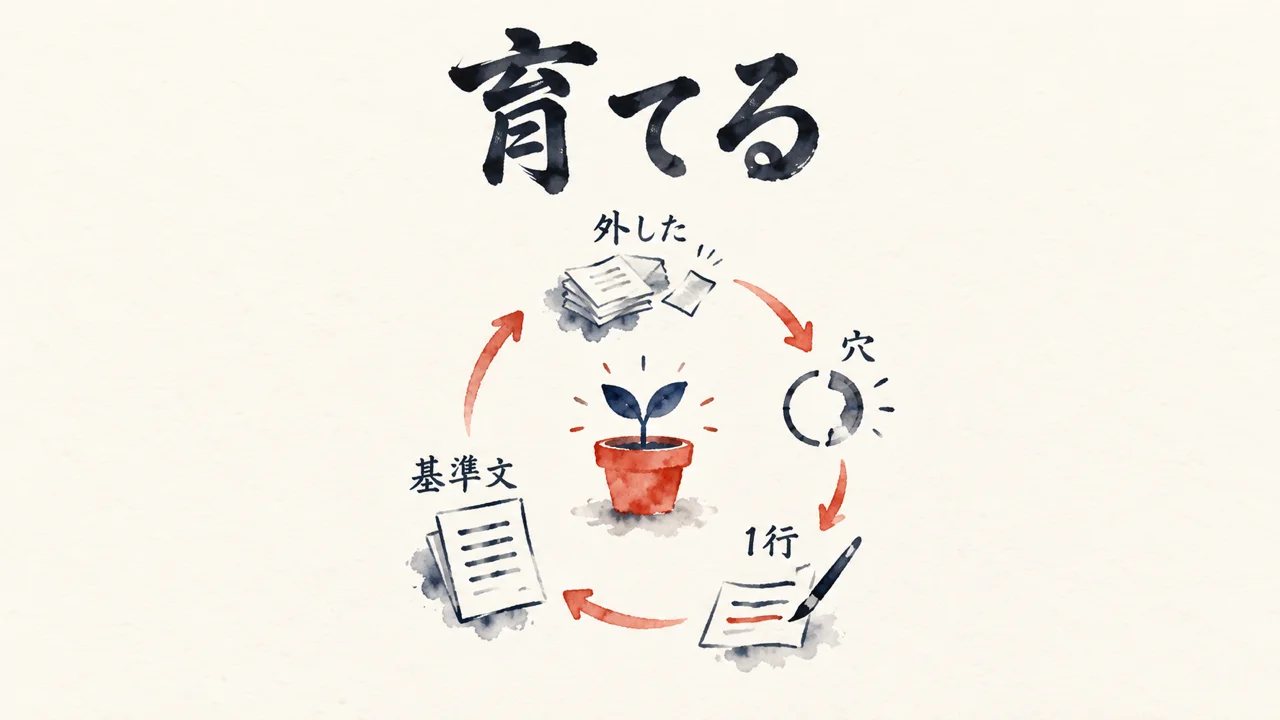
HELLO_CYBERNETICSさん(Zenn・最後にの節・次に試したいこと)
たとえば、触媒の記載がない報告書を「同じ」と判定してしまった場合、その失敗をもとに「記載がない場合は不明を選ぶ」という基準を補う。判定はJevに任せ、改善案を書く役割には別の生成LLMを使う。
元記事の筆者が次に試したいのは、DSPyとGEPAを使った基準文の改善です。DSPyで判定処理と評価をまとめ、GEPAで誤分類の例を見ながら記述を修正する流れを考えている、と書かれています。手書きの基準と最適化後の基準は、調整に使っていないデータで比べたい、と書いています。
元記事の筆者は、まだこれを試していません。「試してみようと思う」という段階の話です。だから私も、効果があるとは言いません。
それでも、この順番には共感します。失敗を見て、基準に1行足す。私が分身AIと続けているのも、同じ形の循環です。結果と分身AIの出力を見て、感じて、味見して、違和感を返す。すると分身AIの判断軸が育ちます。
基準文も、書いた日が完成日ではありません。最初は仮でいいんです!
ここが元記事との違いです。元記事は、改善案を別のAIに書かせる案です。私が人の側で見るのは、外した仕分けの並びから、判断軸の穴を見つける役目です。
🎯 外した仕分けから穴を探す AIが外した仕分けを3件並べて、共通する基準の穴を1つ見つけ、1行で補ってください(15分)。
「ここで行っているのは記載内容の分類である」——仕分けは、原因の証明ではない
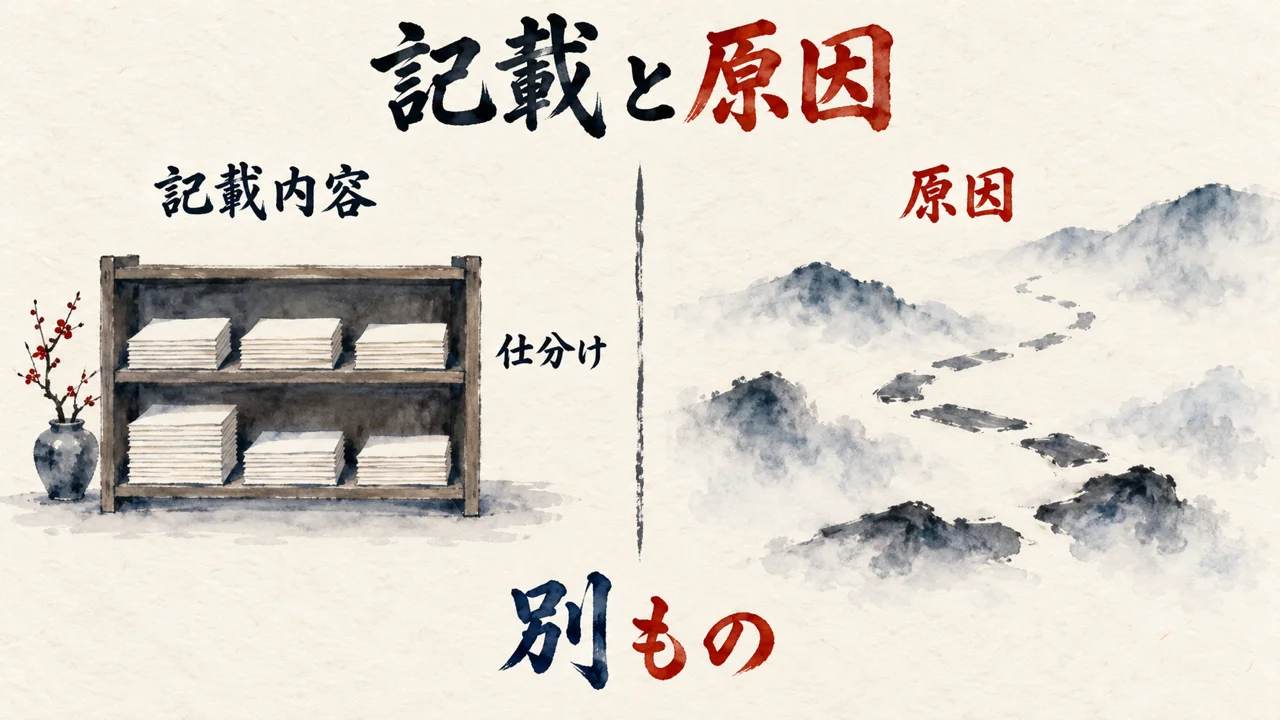
HELLO_CYBERNETICSさん(Zenn・実験報告書の検索の例の解釈の部分)
ただし、Aを見つけたことは、温度上昇が収率改善の原因だったことの証明にはならない。ここで行っているのは記載内容の分類である。
報告書Aが見つかれば、「温度を上げて、触媒は同じで、収率が上がった」と書いてある文書が手に入ります。でもそれは、温度が原因だと分かったこととは別です。元記事は、ここで行っているのは記載内容の分類で、原因の証明ではないと線を引いています。
たとえば「配送」に仕分けられた問い合わせが、本当に配送の遅れが原因だったかどうかは、仕分けだけでは分かりません。分かるのは、そう書いてあった、というところまでです。
分身AIに私のストーリーや価値観を渡す時、私は、もっともらしい物語や因果を足して、本当のWhyを変えないでほしいと決めています。変わった時点で、渡したものが壊れ、委ねる信頼も壊れるからです。元記事の線引きも、同じ向きだと読みました。書いてあることを仕分ける。書いてないことを、因果でつなぎ足さない。
仕分けの結果が手元にすぐ並ぶほど、「原因まで分かった」って気分になりやすいと思います。だから、AIが分類した結果には、「記載内容の仕分けです」とひと言添えて読むのが安全です。
🎯 ひと言添える AIの分類結果を使う資料に、「記載内容の仕分けです」と1行添えてください(3分)。
よくある質問
Q. Jevは、文章を書くAIとどう違いますか?
A. 元記事では、Jevを、質問と候補を渡すと候補ごとの確率を返す識別モデルとして説明しています。文章を生成するAIに候補を選ばせても、最終的な振る舞いは同じ形で書けると整理したうえで、Jevの特徴は、型の決まった判断と確率を返すように学習し、出力を並列に計算する設計だとしています。複数の判断を文字列として順番に作る処理を省けるので、その用途では待ち時間を短くできると考えられる、と元記事は書いています。
Q. 元記事の0.94や報告書の数字は、Jevの実測ですか?
A. 実測ではありません。元記事が、説明用に作った例だと明記しています。実際に使うなら、自分のデータで誤判定と確認件数を測って、しきい値を決める必要があります。
Q. 実験報告書のように、検索のたびに条件が変わる場合も使えますか?
A. 元記事では、2通りが挙がっています。固定の項目を繰り返し検索するなら、登録時に分類して結果を文書IDと一緒に保存し、検索のフィルタに使います。検索のたびに新しい条件を指定したいなら、既存の検索で候補を集めてから判定します。今回の報告書の例は、後者にあたります。
Q. 元記事の筆者は、Jevを実際に使っていますか?
A. 元記事には、Jevで実際に試した結果は出てきません。DSPyやGEPAで基準文を改善する部分も、次に試したいという計画として書かれていて、効果の数字はありません。
Q. 自分の仕事に使うなら、何から書き始めればいいですか?
A. これは元記事ではなく、私からの勧めです。手放したい仕分けを1つ選び、候補ごとの意味の説明と「不明」を先に紙に書いてください。確率が競った時に人が見る線は、そのあとで決めます。ここまで書けたら、AIに渡す下書きの完成です。
まとめ——賢いモデルより先に、基準文と「不明」と線を書く
元記事を読んで一番残ったのは、Jevの賢さではなく、使う側が書くものの多さでした。候補ごとの意味の説明、根拠がない時の「不明」、確率が競った時に人へ回す線。ここまで決まって初めて、仕分けは委ねられます。
確率は約束ではなく、自分のデータで測ってから使う目盛りです。分類の結果は記載内容の仕分けであって、原因の証明ではありません。元記事は、どちらの線も最初から引いています。
まずは、手放したい仕分けを1つ。候補の説明と、「不明」と、人に回す線を、紙に書いてみてください。書けたところまでが、今のあなたの任せる基準です。
この記事の前提です。元記事の数字と報告書は、筆者が説明用に作った例で、Jevの実測結果ではありません。Jevの内部構造や損失関数の全容も、元記事が確認した2026年9月19日時点の公式資料には示されていません。この記事は元記事を読んで書いたもので、Jevを動かした検証結果は入っていません。
COLUMN
基準文に書けなかった「しっくりこない」
料理に例えると、基準文はレシピの分量表です。塩は小さじ1、火は中火、3分で裏返す。ここまでは紙に書けます。書いてあれば、誰が作っても同じ味に近づきます。仕分けの基準をAIに渡すというのは、この分量表を渡すことだと私は考えています。分量が曖昧なまま人にレシピを渡すと、聞き返しが何度も起きます。本文で書いてきたのは、その分量表の話でした。でも、料理は分量表だけでは終わりません。
味見をした時に、「ここはまだ違う」と感じることがあります。私の場合、そのサインは、違和感、しっくりこない、ワクワクもウズウズもない、という形で出ます。「違う」と感じる時は、エネルギーが静かに消えていくような感じです。反対に「これだ!」の時は、ピンと来て、腹に落ちて、ワクワクします。胸と腹の両方に来ます。この二つの感覚が、私が出すか止めるかを決める手がかりです。
本文では、基準を書けば委ねられると書きました。ただ、書き切れない部分があるとも思っています。自分の内側から湧き出るものや、体の感覚で言語化できないことは、分身AIではまだ難しい。私はそう考えています。基準文に書ける部分と、書けない部分がある。そう思っています。
書けない部分は、最後に私が確かめる部分として残します。分身AIが個々の成果物の判断や味見まで走ってくれても、判断軸そのものと、自分の身体の反応は、私が一段上から味見します。基準文に書ける部分は、AIに渡す。書けない部分は、私が持つ。
仕分けを1つ手放せたら、空いた時間は、現場で五感を使う時間に戻したいです。私がAIに委ねたいのは、作業だけではありません。成果か、本当に必要な判断だけを返してもらうところまでです。基準文を書いていて、書けないところがはっきり見えたら、そこが、私が残す仕事です。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
Jev自体の紹介はこちら。今回は、その使い方のうち基準文の書き方と線引きに絞っています。
実際にどんな仕分けに使われているかを知りたい時に。今回の基準文は、その仕分けを自分の仕事に置き換える下書きになります。
一つのボールは一人が持つ、判断軸を磨いてから量産を渡す、という整理の元になった記事です。
参考リンク
今回紹介した元記事。
候補ごとの確率を返す質問の型の仕様。元記事が参照している公式資料です。
Jevの公開発表。元記事が参照している一次資料です。
誤分類の例とフィードバックから、文章で表された基準を改善する手法の公式実装。
確率の校正(カリブレーション)を扱った論文。元記事が参考として挙げています。
📄 今回紹介した記事
| 著者 | HELLO_CYBERNETICSさん |
| 媒体 | Zenn |
| 公開日 | 2026年9月19日 |
| 元URL | https://zenn.dev/cybernetics/articles/4f3762bd470fc4 |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 6:30〜 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 6:30〜 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜のLIVEは無料視聴、7:30〜のZOOM LIVEは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!