READ REPORT
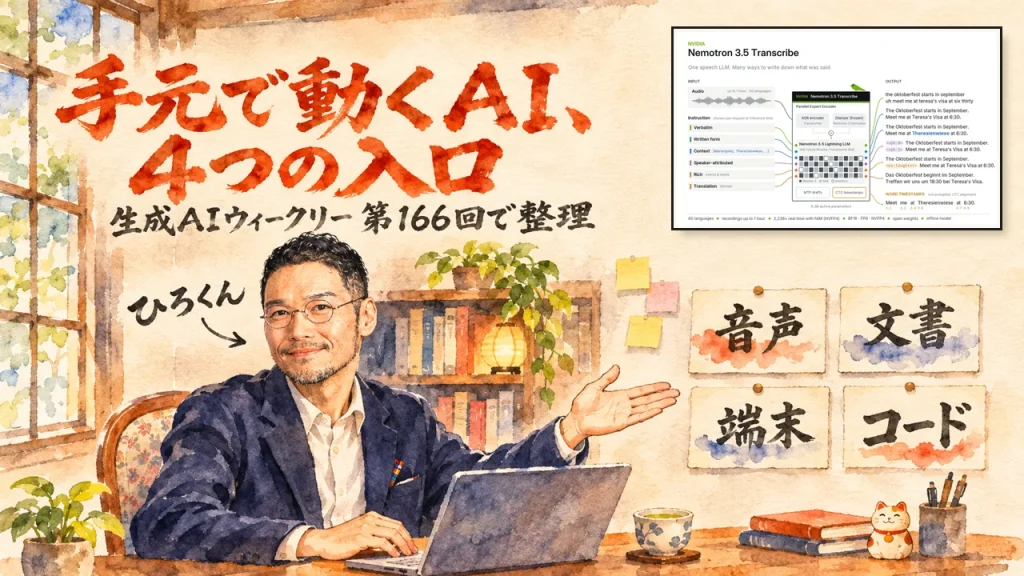
Nemotron 3.5 Transcribeを含む4つのオープンウェイトを、生成AIウィークリーで整理する
2026年11月10日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、テクノエッジが2026年11月6日に公開した、生成AIウィークリー第166回を紹介します。この1週間に出たオープンウェイトのAI4つを並べた回です。
この記事は、私が保存したブックマークから書いています。私の過去記事には、手元に置く物をどう選ぶかという考えがあります。4つのニュースで、その考えを確かめ直したいと思いました。ChatGPTやClaudeを仕事に使っていても、手元で動くAIという話が増えると、自分の仕事のどこに関係するのか分からなくなりますよね。その分からなさを、入口で分けて見る記事です。
私の考えは、私の考えと分かる形で書きます。山下さんの記事の数字は、各社・各チームの発表として受け取ります。
テクノエッジ TechnoEdge の連載「生成AIウィークリー」第166回が、オープンウェイトのAI4つを並べていました。音声のNemotron 3.5 Transcribe、文書のUnlimited OCR 2、端末のLFM3、コードのMistral Large 4です。この記事では4つを入口で整理して、自分の仕事で先に決める1つまでを書きます。
3行でわかるポイント
- 山下さんの記事では、4つのオープンウェイトが、使う場面の別々の話として並んでいます。
- 4つの数字は、各社・各チームの発表で、物差しも別々です。自分の録音・PDF・端末で確かめるまでは、目安として受け取ります。
- 先に決めるのは、入口を1つ選ぶことと、試す前に外へ出さない情報の線を1行書くことです。
山下(Seamless)さんが2026年11月6日にテクノエッジの連載「生成AIウィークリー」へ公開した第166回。オープンウェイトのAI(Nemotron 3.5 Transcribe、Unlimited OCR 2、LFM3、Mistral Large 4)を紹介している
生成AIウィークリー第166回のオープンウェイト4つは、音声・文書・端末・コードの別々の入口の話
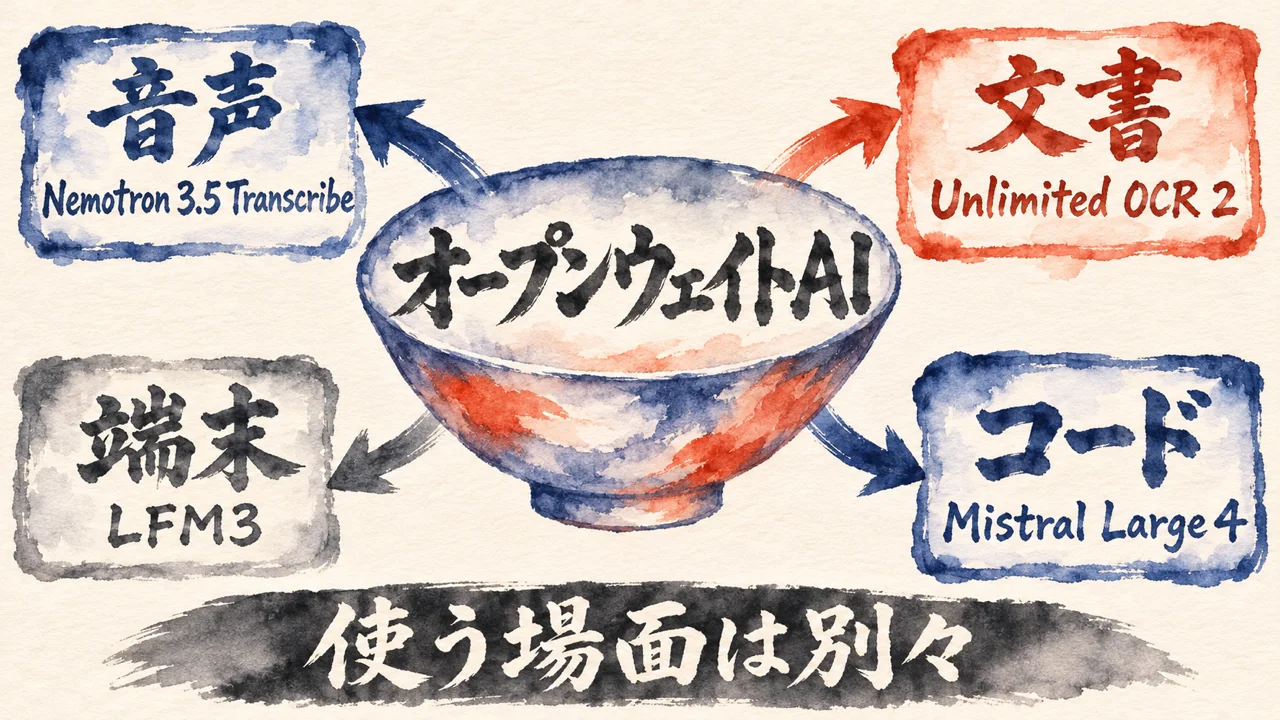
今回の「生成AIウィークリー」(第166回)は、スマホでも高速で動くオープンウェイトのAIモデル群「LFM3」や、数百ページの文書を一括解析できるローカルOCRモデル「Unlimited OCR 2」を取り上げます。
山下(Seamless)さんが、2026年11月6日にテクノエッジ TechnoEdge で連載「生成AIウィークリー」の第166回を公開しました。この1週間の気になる生成AI技術・研究を解説する回。
私はこの記事をブックマークしていました。
取り上げられたのは4つ。スマホでも高速で動くオープンウェイトのAIモデル群「LFM3」。数百ページの文書を一括解析できるローカルOCRモデル「Unlimited OCR 2」。
複数話者の文字起こしなどができるNVIDIA開発の音声AI「Nemotron 3.5 Transcribe」。
そして、GPT-6.1 Terraと同等のコーディング性能を持つAIモデルとして紹介された「Mistral Large 4」です。
オープンウェイトとは、AIモデルの重み(学習の結果の数値)が公開されていて、手元にダウンロードして動かせる形のこと。使える条件は、ライセンスで別に決まります。
連載には「生成AIクローズアップ」という枠があります。今回は、コーディングAIが作るAIっぽいUIを消すスキル3つの単体記事が、別にあるそうです。ただ、中身はこの記事では扱いません。
ここから先は、私の読み。ニュースの数字が多いと、どれも自分に関係ある気がして、結局どれにも手を付けない。そうなりやすいんですよね。入口で分けると、自分の仕事に近いのはどれかが見えてきます。
一人社長や小さなチームの仕事なら、会議の録音、厚いPDF、社外に出したくない書類のうち、手元に溜まっている物を1つ思い浮かべてみてください。その1つが、4つのどの入口に近いか。
そこから読むのが、今回の読み方です。
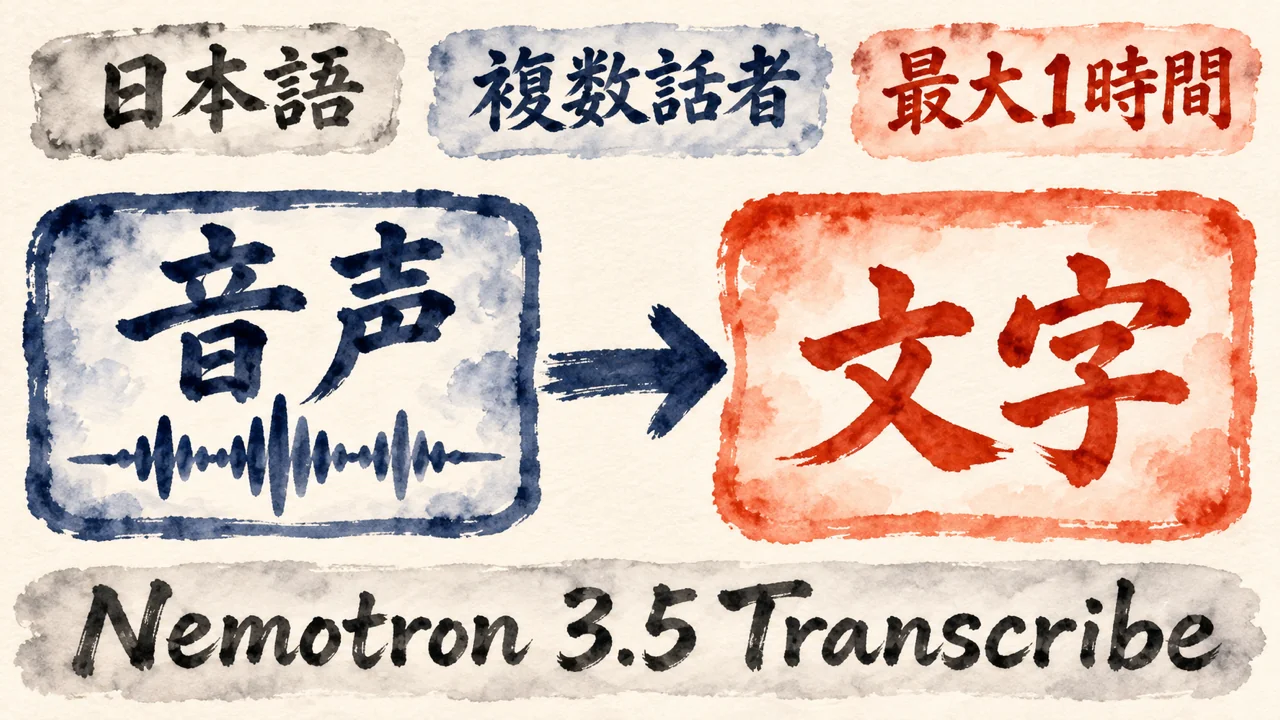
Nemotron 3.5 Transcribe(音声)は日本語と複数話者に対応し、最大1時間まで読める文字起こしAI
テクノエッジの記事(Nemotron 3.5 Transcribeの紹介)
また、日本語も実用レベルでサポートされており、英語との双方向翻訳、複数話者認識に対応しています。
山下さんの記事では、Nemotron 3.5 Transcribeは日本語も実用レベルでサポートされていて、英語との双方向翻訳と複数話者の認識にも対応する、と紹介されています。
NVIDIAが公開したのは、40言語に対応するオープンウェイトの音声認識AIモデル「NVIDIA-Nemotron-3.5-Transcribe-30B-A4B」です。
文字起こし、音声翻訳、言語識別、音声に関する質問応答に対応する、と山下さんの記事にあります。
総パラメータ数は34B(340億)で、推論時は約4.3B(43億)パラメータで動くそうです。パラメータとは、モデルの中の数値の数のこと。
重みデータはBF16のほか、量子化版のFP8やNVFP4でも提供されています。量子化は、数値の細かさを落としてメモリを小さくする方法です。
構造は、言語モデル「Nemotron-3.5 Lightning」に、音声認識と話者識別のエンコーダを組み合わせたMoEです。MoEは、全体の一部の専門部分だけを動かす構造のこと。
最大1時間の録音に対応して、商用でも非商用でも使えるとのことです。
AI氣道『Nemotronとは。NVIDIAが言うAIの所有を個人と小さな会社の目線で整理』より
「NVIDIAは、AIを作る組織の側から「どう組み立てるか」を見ています。私は、AIを使う人の側から「何を先に置くか」を見ています。見る場所は違うのに、同じ分かれ目を指している。」
AIを使う人の側から何を先に置くかを見るという話を、私は『Nemotronとは。NVIDIAが言うAIの所有を個人と小さな会社の目線で整理』で書いています。
引用の1文には、NVIDIAは組み立てる側、私は先に置く側、と見る場所の違いを書きました。今回のNemotron 3.5 Transcribeも、同じ分かれ目に立っている話かな、と私は読んでいます。
私の記録も重ねます。2026年11月6日、日本語文字起こしAIのHaas-jaを、AIに頼んでMacで測った。
同じ10発言(音声96秒)の読み確認は、Haas-jaが12.2秒、Whisperが17.9秒でした。
ただ、話者分離がありません。誰が話したかを分ける機能が、ないんです。英字は小文字になり、人名を間違える所も残った。精度を表す誤り率は、Whisperを上回れず。
速さの数字は、サーバーが混雑した状態で測ったので、目安です。
私の運用は、こうです。普段の文字起こしは替えず、講座動画の声の点検だけをHaas-jaに替えました。壊れた時は、faster-whisperへ自動で戻る形。
山下さんの記事の複数話者認識は、私が測って残った弱い所と同じ方向の話だと読みました。
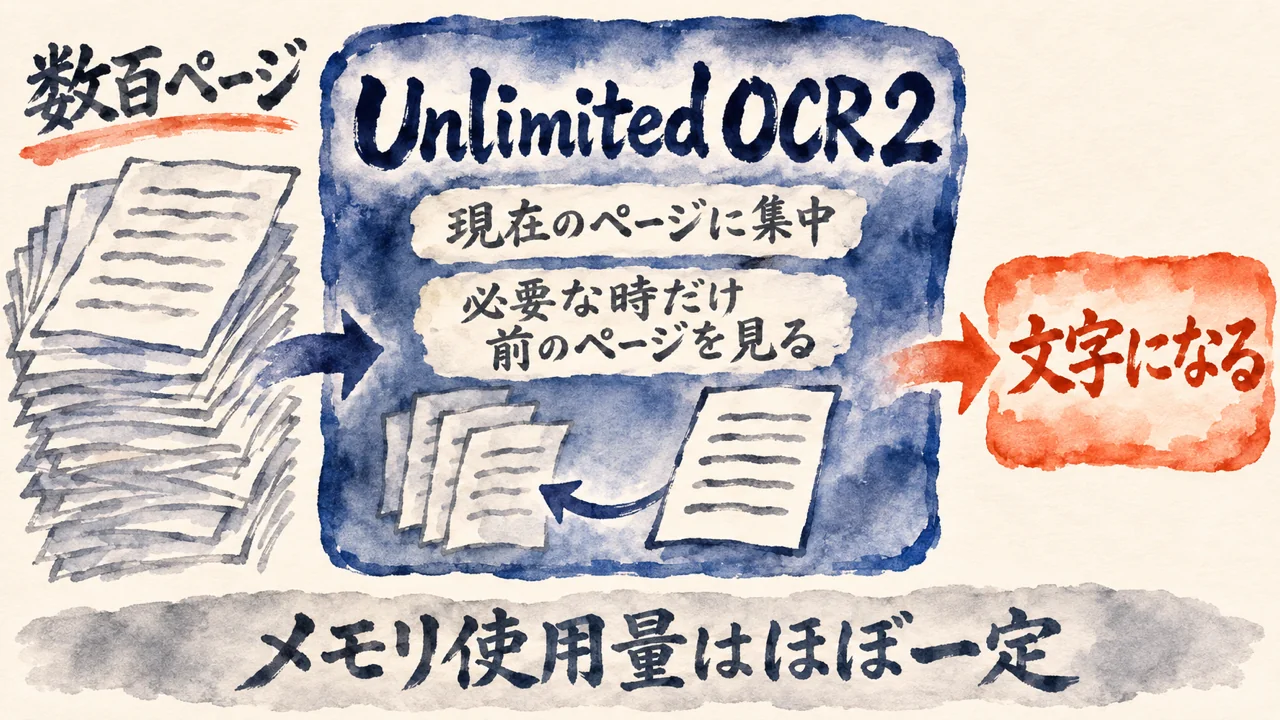
Unlimited OCR 2(文書)は数百ページを一括で読み、メモリ使用量をほぼ一定に保つOCRモデル
さらに、最大30ページの文書を扱うベンチマーク「MPDocBench」と、同社の最大300ページの文書解析ベンチマーク「MarathonDocBench」の両方で最先端(SOTA)を達成しました。
山下さんの記事では、最大30ページと最大300ページの2つのベンチマークの両方で、Unlimited OCR 2が最先端(SOTA)を達成した、と紹介されています。
BaiduのERNIEチームが、数百ページに及ぶ長文ドキュメントを一括で解析できる「Unlimited OCR 2」を、MITライセンスで発表しました。OCRは、画像の文字をコピーできる文字に読み取る技術です。
前身の「Unlimited OCR」は、デコードのたびに、文書内の全ページの画像情報を参照し続ける必要がありました。
ページ数が増えるほど1ステップあたりの計算の負担が膨らみ、数百ページ規模は難しかった、と山下さんの記事にあります。
研究チームは、人間が本を書き写す時の動きをモデルに取り入れました。現在のページに集中して、必要な時だけ前のページを振り返る動き。
そこで新しい注意機構「SR-SWA」を開発し、一度に処理する画像データの量を一定の上限内に抑えました。
さらに、文書をチャンク(かたまり)に分けて順に処理し、不要なデータをメモリから解放するデコード手法を組み合わせています。
何百ページでも、メモリ使用量と1ステップあたりの処理速度をほぼ一定に保てる、という説明です。
評価の数字も、山下さんの記事にあります。
100ページ規模の文書で、標準的なFull Attention(すべての情報を参照する方式)より1ステップあたり7.0倍、前身のR-SWAより5.6倍の高速化を達成したそうです。
山下さんの記事には、前身の記事(2026年6月29日・数十ページのPDFを1回で処理)へのリンクもあります。
ここは私の読み。数字は、研究チームの発表として受け取ります。物差しは、ページ数の多い文書での速さとメモリの安定にある、と見ています。
契約書、見積書、報告書の束のように、ページ数が多くて外へ出したくない書類を、手元で読ませたい場面があります。そこで「手元で動く」という言葉が、仕事に結び付いてきます。
LFM3(端末)は約1GBで動くテキストモデルを含む6つの小型オープンウェイト
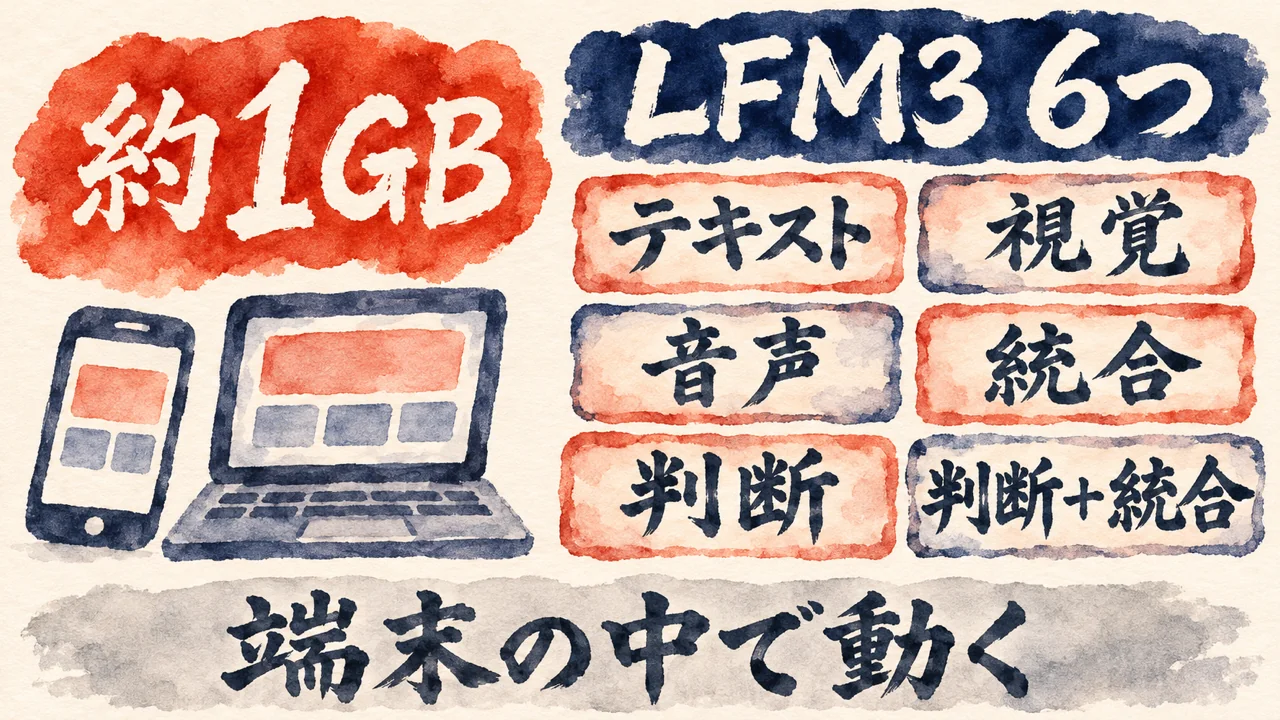
テキストモデルは4ビット精度で約1GBのメモリに収まる軽量設計ながら、新しいアーキテクチャと学習手法により、エージェント系タスクなどでは数倍の規模のモデルに匹敵する性能を発揮します。
山下さんの記事では、LFM3のテキストモデルは4ビット精度で約1GBのメモリに収まる軽量設計で、エージェント系タスクなどでは数倍の規模のモデルに匹敵する性能を発揮する、と紹介されています。
Liquid AIが公開したのは、スマホやPCの端末上で直接動くオープンウェイトの小型AIモデル群「LFM3」です。4ビット精度は、数値の細かさを落としてメモリを小さくした形のこと。
ラインアップは6つ。ツール操作や自律作業に強いテキスト用の「LFM3-1.7B」。動画理解や空間把握に対応した視覚用の「LFM3-VL-2B」。
18言語の音声認識・合成・翻訳に対応し、低遅延の音声対話もできる音声用の「LFM3-Audio-2B」。映像と音声を同時に理解してツールを動かす統合型の「LFM3-Omni-2B」。
残りの2つは、判断だけを数ミリ秒で返す意思決定モデルの「d1-2B」と「d1-Omni-2B」です。意思決定モデルは、文章を作らず、「これを実行するか」のような判断だけを返すモデルのことです。
AI氣道『ローカルLLMはどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える』より
「私は2026年8月18日から19日にかけて、手元のLM StudioでQwen 3.8を動かそうとして、うまく動きませんでした。LM Studioは、手元でAIを動かすアプリです。」
手元のLM StudioでQwen 3.8を動かそうとして、うまく動かなかった時のことを、私は『ローカルLLMはどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える』で書いています。
手元で動かそうとした経験が、ここでの手がかり。LFM3の端末で動くという話は、画面の数字だけでなく、動かせるようになるまでの手間も含めて見たいんですよね。動画の再現の画面と私の机は、別の環境ですから。
約1GBというメモリの数字は、端末の中でAIが動く、という話につながります。社外に出したくない書類や録音を、端末の中だけで扱える形があるか。そこに、私の関心は向きました。
意思決定モデルの話も面白い。判断だけを数ミリ秒で返すなら、文章を作る大きなモデルとは役目が違います。仕事の中の、はい・いいえで足りる所に当てはまるかもしれません。
Mistral Large 4(コード)は約1兆パラメータ。商用でもサービス提供事業者は別ライセンス
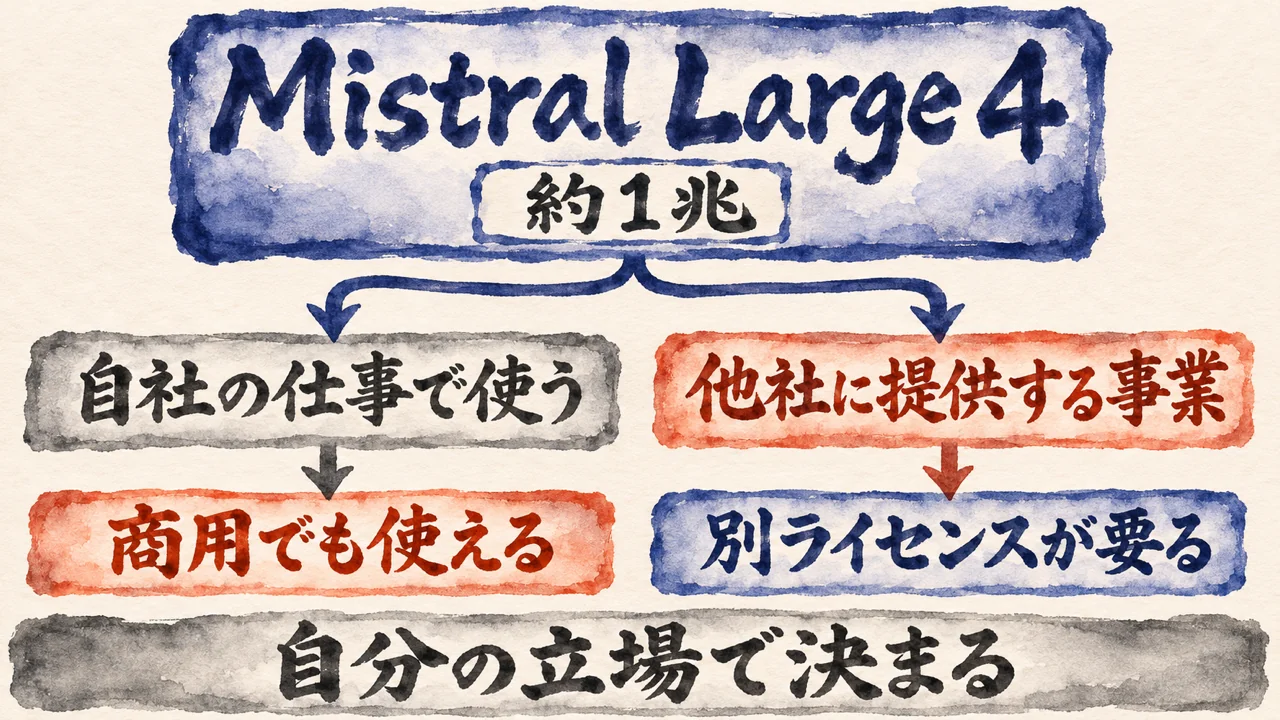
ライセンス上、利用・改変・追加学習・商用利用が可能ですが、Model as a Serviceを提供する事業者は商用利用の前に別途ライセンスを取得する必要があります。
山下さんの記事では、ライセンス上、利用・改変・追加学習・商用利用が可能、と紹介されています。ただしModel as a Serviceを提供する事業者は、商用利用の前に別途ライセンスが必要。
Model as a Serviceは、モデルをAPIなどで他社に提供する事業のことです。
フランスのAI企業Mistral AIが、最新のマルチモーダルAIモデル「Mistral Large 4」(通称Le Chonk)のオープンウェイトを公開しました。
総パラメータ数は約1兆で、アクティブパラメータ520億のMoEです。
Artificial Analysisのコーディングエージェント指標では48%を記録した、と山下さんの記事にあります。Mistralは、オープンモデル首位のGLM-5.3と事実上同点としています。
同じ指標で、Mistral Vibe上のMistral Large 4のスコアは、Codex上のGPT-6.1 Terraと同じでした。
記事の見出しでも、一部のコーディング指標でGPT-6.1 Terraと同点、と書かれています。
AI氣道『Mac Studio 512GBの約450万円の予約と、機密を手元に置くローカルAIの話を整理する』より
「私の手元にあるのは MacBook Pro で、M5 Max の128GBメモリです。そのMacで画像生成AIの Qwen-Image-2.1 を回して、記事の見出し画像を作ったことがあります。」
128GBメモリのMacで画像生成AIを回して、見出し画像を作った話を、私は『Mac Studio 512GBの約450万円の予約と、機密を手元に置くローカルAIの話を整理する』で書いています。
私の手元は、128GBメモリのMacBook Proです。約1兆という数字を前にすると、自分の机で動かす話なのか、使わせてもらう話なのかが、まず分かれます。
ここは私の読み。決めるのは、動かす側の条件を見てから。自分の机の大きさと、ライセンス上の立場の2つで決まる、と私は考えています。
ライセンスの所では、読者の立場も大事です。自社の仕事に使うだけなのか、モデルをAPIなどで他社に提供する事業をするのか。後者なら、別途ライセンスが必要になります。
コードを書く仕事に近い人は、ここが入口の確認になります。
オープンウェイト4つの数字は物差しが別々。各社の発表は、自分の素材で確かめるまで目安として読む
テクノエッジの記事(Mistral Large 4の数字の紹介)
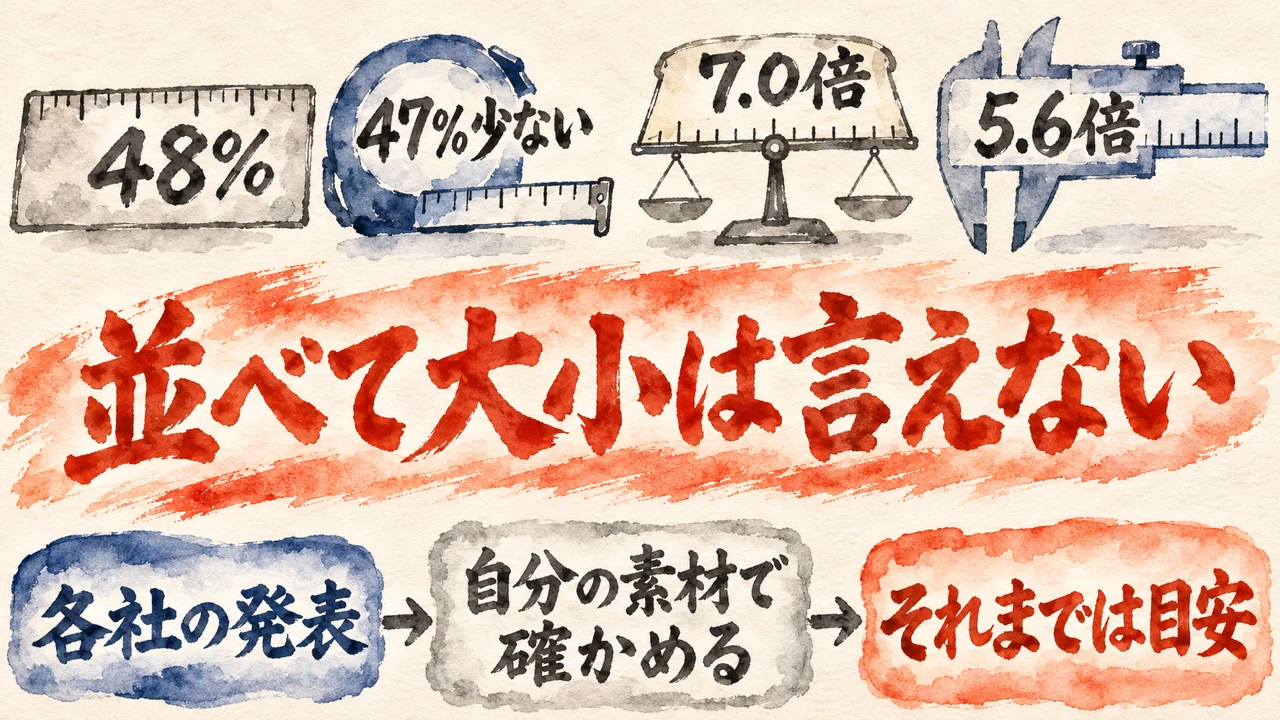
Artificial Analysisのコーディングエージェント指標では48%を記録しました。
ここで大事なのは、この48%が、山下さんの記事の中で紹介されている数字、という点です。
今回の数字は、48%、7.0倍、5.6倍、約1GBでした。Mistral、Baidu、Liquid AIなど、各社・各チームの発表として紹介されています。
4つの数字は、物差しが別々です。音声・文書・端末・コードで、測っている物が違う。48%と7.0倍は、並べて大小を言えません。
山下さんの記事の数字は、4つとも、記事の中では各社・各チームの発表として並んでいます。そのまま自分の仕事の速さや正確さに置き換えない。これが、この章の私の受け止めです。
ニュースの数字は、自分の素材で確かめるまで目安として受け取る。録音でもPDFでも端末でも、同じです。ここは私の考えです。
固有名詞や専門用語は、モデルを替えても確かめる所が残ります。ここで、私の記録を1つ置きます。
LIVEの文字起こしで、「アドレス」と出る所があります。ゴールやナレッジの話の文脈では、「Addness」が正しい。2026年11月5日に、私は「アドレスななくAddness。
覚えといて」と指示して、直す決まりにしました。
文字起こしAIが新しくなっても、この決まりは消えません。文字にする力が上がっても、社名や用語の確認は人の側に残る。私は、そう読んでいます。
自分の仕事で、聞き間違えられると困る名前を1つ思い浮かべてみてください。社名でも取引先の名前でも構いません。それが、試す時の確かめ項目の最初の1行になります。
オープンウェイトのAIを試す前に、4つの入口から1つ選び、外へ出さない情報の線を1行書く
テクノエッジの記事(Nemotron 3.5 Transcribeの対応範囲の紹介)
商用・非商用を問わずに利用できます。
山下さんの記事によると、Nemotron 3.5 Transcribeは最大1時間の録音に対応して、商用・非商用を問わず使えます。ここから、試す素材の大きさを決められます。
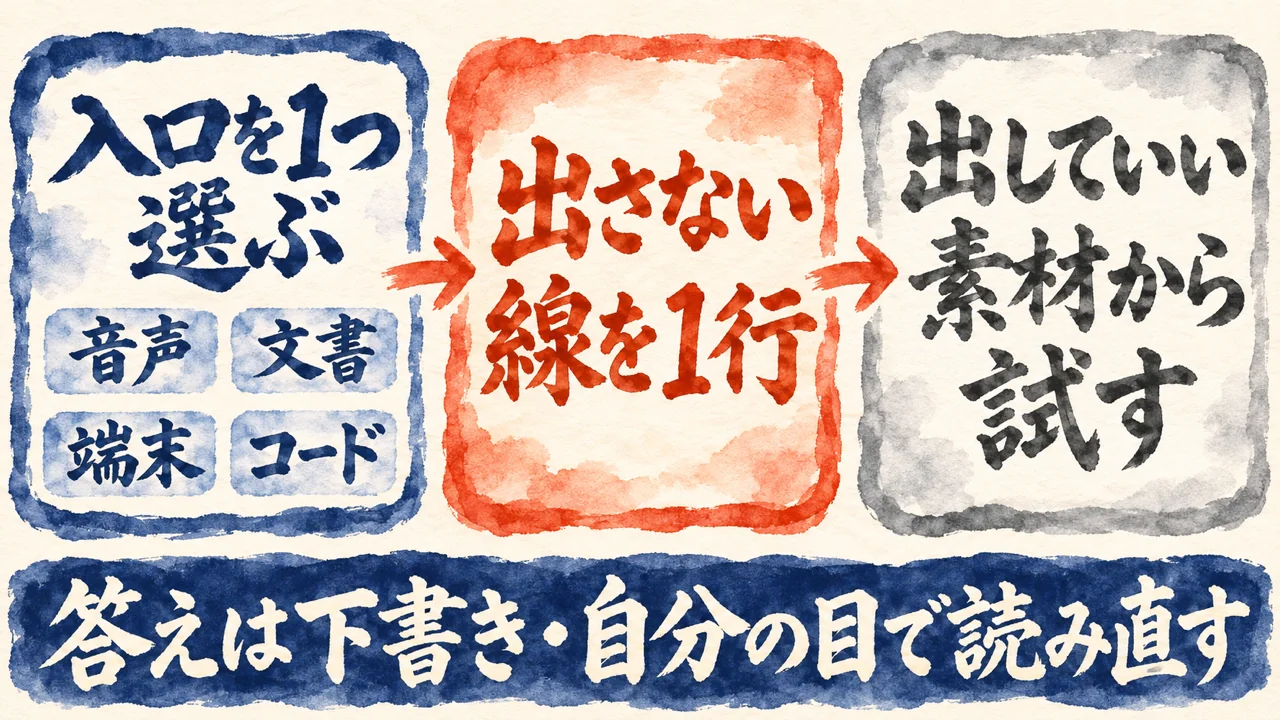
まず、入口を1つ選びます。音声なら、Nemotron 3.5 Transcribeの上限の目安が最大1時間の録音なので、1時間以内の録音を1本。文書なら、外へ出していい資料を1つ。
端末なら、LFM3の6つから、自分の入口に当たる1つ。コードなら、Mistral Large 4のライセンスで、自分がサービス提供事業者に当たるかどうかを見ます。
次に、試す前に、外へ出さない情報の線を1行で書きます。たとえば、取引先の名前と個人情報は渡さない。これだけで構いません。
手元で動かすか、外のサービスで使うか。その前に、渡さない情報の線があるんです。線が先にあれば、どの入口を選んでも、迷い方が変わります。
ここは私の考え。試す素材は、外へ出していい物から始めます。たとえば、公開済みの資料や、自分で話した内容の録音です。
AIの答えは下書きとして受け取り、任せ切りにはしません。自分の目で読み直す。一人社長の仕事では、確認する人が自分だけの日も多いかもしれません。
手順づくりの聞き取り役は、AIに任せられます。入口は何か、素材は何か、線はどこか。聞かれて答えるだけで、自分の仕事の1行が決まっていきます。この記事の末尾に、AIエージェントに渡す依頼文の囲みがあります。
読んだあと、自分の仕事で試す入口を選びたい人へ
4つの入口から1つ選んで、外へ出さない情報の線を決めるプロンプト
枠の中にこの記事のURLが入っていて、AIが記事を読んでから、手元に溜まっている物を聞き取り、近い入口と外へ出さない情報の線の文案にまとめてくれるプロンプトです。読んで終わりにせず、自分の環境ですぐ使える追加のプロンプトまで手元に残せます。
1
記事の話と、書き手の考えの仕分け
テクノエッジの記事で紹介された内容、私の考え、未確認を分けて返します。各社の発表を、確かめられた事実として扱いません。
2
近い入口と、外へ出さない線の文案
4つの質問に答えると、音声・文書・端末・コードのうち近い入口の候補と、外へ出さない情報の線の文案が返ってきます。
3
自分の環境で使える追加のプロンプト
使っているAIや道具に合わせて、記事のURL入りのプロンプトを1〜3本、そのまま貼れる形でつくります。
AIの答えは下書きとして受け取り、任せ切りにせず自分の目で読み直す前提です。使ってみたい時だけ、下のボタンから使い方と依頼文を開いてください。
▶ タップしてプロンプトを開く
下の枠の文を丸ごとコピーして、手元のAIエージェントに貼ってください。枠の中には、この記事のURLが入っています。記事を読んだAIから、短い質問が4つ、1つずつ届きます。
返ってきた結果は、そのまま信じず、自分の目で読み直してください。何を試して、何を渡さないかを決めるのは自分です。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
https://ai-kidou.jp/open-weight-ai-genai-weekly-166/
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、下の記事の要点だけを材料にしてください。

【参照元(先に読む)】
https://www.techno-edge.net/article/2026/11/06/5679.html
テクノエッジの連載「生成AIウィークリー(第166回)」の元記事です。読めた場合は、元記事の記述と下の要点が合っているか確かめてください。

【目的】
オープンウェイトのAI(音声・文書・端末・コードの4つの入口)のうち、自分の仕事に一番近い入口を1つ選び、試す前に外へ出さない情報の線を1行で決めることです。そのうえで、私の環境で使える追加のプロンプトをつくります。

記事の要点
・山下(Seamless)さんの記事では、4つが紹介されている。音声のNemotron 3.5 Transcribe(日本語・複数話者・最大1時間・商用・非商用とも利用可)、文書のUnlimited OCR 2(数百ページを一括解析・MITライセンス)、端末のLFM3(スマホやPCの端末上で動く小型モデル群・テキストモデルは4ビット精度で約1GBのメモリ)、コードのMistral Large 4(約1兆パラメータ・Model as a Serviceを提供する事業者は商用利用の前に別途ライセンスが必要)。
・記事の数字(48%、7.0倍、5.6倍、約1GBなど)は各社・各チームの発表として紹介されたもので、物差しは4つで別々。
・書き手(ひろくん)の考え: ニュースの数字は、自分の素材(録音・PDF・端末)で確かめるまで目安として受け取る。試す前に、外へ出さない情報の線を1行で書く。動かす場所の前に、渡さない情報の線がある。

【やってよいこと】
1. 記事を読んだあと、次の4つを1つずつ質問してください。答えが返ってから次の質問へ進んでください。
 ・仕事で手元に溜まっている物は何か(会議の録音、厚いPDF、社外に出したくない書類、コードを書く仕事のどれか)
 ・その物のうち、外へ出していい素材と、外へ出さない情報は何か
 ・使っているAIや道具は何か(手元で動かしているか、外のサービスだけか)
 ・自分が、モデルをAPIなどで他社に提供する事業をしているか
2. 答えをもとに、4つの入口(音声・文書・端末・コード)から、一番近い1つの候補を挙げてください。選ぶのは私です。
3. 外へ出さない情報の線を、1行の文案にして挙げてください(例: 取引先の名前と個人情報は渡さない)。
4. 最初に試す素材を、外へ出していい物から1つ、選択肢にして挙げてください。
5. 試した結果を確かめる項目として、聞き間違えられると困る名前を1つ、選択肢にして挙げてください。
6. 私の環境で、そのまま貼って使える追加のプロンプトを、1〜3本つくってください。記事のURLを、各プロンプトの中に入れてください。

【守ること】
・設定の変更、削除、送信、購入、公開、モデルのダウンロードは行わないでください。ここでは、聞き取りと整理だけです。
・パスワード、鍵、口座の情報、取引先の個人情報は求めないでください。貼られても使わず、消すよう伝えてください。
・記事の内容は、記事に書かれた記述として扱い、確かめられた事実とは書かないでください。各社の発表を、独立に確かめられた結果として扱わないでください。
・分からない所は、推測で埋めずに未確認と書いてください。
・材料は、上のURLの記事と記事の要点、私の答えだけにしてください。記事に無い数字・効果・手順・必要メモリなどを足さないでください。追加のプロンプトに足してよいのは、私の環境に合わせた言い方と手順だけです。この依頼で禁じたことは、追加のプロンプトの中にも同じように書いてください。

【返す形】
(1) 手元に溜まっている物と、外へ出さない情報の整理
(2) 4つの入口のうち、近い1つの候補と理由
(3) 外へ出さない情報の線の文案
(4) 最初に試す素材の選択肢
(5) 確かめる項目の選択肢
(6) 私の環境で使える追加のプロンプト(1〜3本)
(7) 未確認の点(分からなかった所を、推測で埋めずに書く)
最後に、私が自分の目で読み直したほうがよい所を1行で添えてください。よくある質問
Q. オープンウェイトとは何ですか?
A. AIモデルの重み(学習の結果の数値)が公開されていて、手元にダウンロードして動かせる形のことです。使える条件はライセンスで別に決まるので、使う前に確かめます。私は、動かす場所の前に、渡さない情報の線を決めたいと考えています。
Q. Nemotron 3.5 Transcribeは日本語に対応していますか?
A. 山下さんの記事では、日本語も実用レベルでサポートされていて、英語との双方向翻訳と複数話者認識に対応する、と紹介されています。最大1時間の録音に対応するそうです。私は、自分の録音で確かめるまで目安として読みます。
Q. Mistral Large 4は仕事で使ってよいですか?
A. 山下さんの記事では、利用・改変・追加学習・商用利用が可能と紹介されています。ただしModel as a Serviceを提供する事業者は、商用利用の前に別途ライセンスが必要です。自分がどちらに当たるかを先に確かめるのが、私の考えです。
Q. LFM3はスマホで動くのですか?
A. 山下さんの記事では、スマホやPCの端末上で直接動くオープンウェイトの小型AIモデル群として紹介されています。テキストモデルは4ビット精度で約1GBのメモリに収まる設計です。動かせるようになるまでの手間は、自分の端末で見たい所だと私は考えています。
Q. 何から試せばよいですか?
A. 音声・コード・端末・文書の4つの入口から、自分の仕事に一番近い1つを選びます。次に、外へ出さない情報の線を1行で書きます。試す素材は、外へ出していい物1つから、というのが私の考えです。
まとめ。4つの入口から1つ選び、外へ出さない線を1行書いてから試す
生成AIウィークリー第166回のオープンウェイトは、音声のNemotron 3.5 Transcribe、文書のUnlimited OCR 2、端末のLFM3、コードのMistral Large 4でした。ニュースの数が多く見えても、入口で分ければ4つの別々の話です。
山下さんの記事の数字は、各社・各チームの発表として受け取ります。物差しが別々なので、横に並べて比べません。自分の素材で確かめるまでは、目安です。
私の過去記事の考えと、Haas-jaを測った記録を重ねると、見る場所が見えてきます。手元で動かすには手間がかかります。128GBメモリの机の大きさもあります。固有名詞は、モデルが変わっても確かめる所が残ります。
先に決める1つは、入口を1つ選ぶことと、外へ出さない情報の線を1行書くことです。外へ出していい素材1つから、確かめ始められます。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
手元で動かす方が偉い、と読んでしまう前に確かめたい一つのこと
手元で動くAIが増えるほど、読み違えやすいことがあります。手元で動かす方が上で、外のサービスを使うのは一段下、という読み方です。入口で4つに分けた整理は、本来そういう話ではありません。でも並んだ名前を見ると、つい序列に見えてしまう。私も、そこは気をつけたいところかな。
AI氣道『朝の魂磨き|用意してもらう有難さと、自分で作れる喜びは共にある』より
「用意してもらう有難さと、自分で作れる喜びは、共にある。」
この向きは、私が『朝の魂磨き|用意してもらう有難さと、自分で作れる喜びは共にある』で書いたことと重なります。外のサービスに用意してもらうのは、有難いこと。自分の手で動かして作るのは、喜びのあること。どちらかを選ぶ話ではないんです。手元で動かせる物が増えたいま、この二つは、同じ机に並べておける相手になりました。
たとえば料理のだしです。時間のある日は、昆布と鰹節から自分で取る。忙しい日は、できあがりのだしを買ってくる。どちらの日も、キッチンはちゃんと回ります。味を分けるのは、どこで取っただしかではありません。この鍋の味の決め手になる合わせ方を、人に預けるかどうか。そこに線があるんです。
今日から真似するなら、手元に置く物と外に頼む物を、物の名前で分けないことです。ソフトの名前で決めると、新しいAIが出るたびに決め直しになる。名前ではなく、渡さない情報の一行で分けます。書くなら、「お客様の名前と連絡先が入った書類は、外に出さない」。これなら、道具が替わっても線は動きません。
もう一つ。手元で動かせない日があっても、引け目に感じることはありません。持っている環境も、手間をかけられる日も、人それぞれですから。外のサービスを使う日は、線の内側で、気兼ねなく頼む。手元で動かす日は、その喜びを味わう。どちらの日も、同じ線が支えてくれます。
手元で動くものが増えるのは、いい流れです。ただ、「どこで動かすか」に目が向きやすくなります。でも本当に決めておきたいのは、置き場所の話ではなく、何を外へ出さないかの話。そこが決まっていれば、手元でも外でも、AIにはのびのび働いてもらえます。線を引く場所は、動かす場所ではなく、渡さない情報。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
NVIDIAが言うAIの所有を、個人と小さな会社の目線で整理した記事です。
ローカルLLMがどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える話を整理した記事です。
Mac Studio 512GBの予約と、機密を手元に置くローカルAIの話を整理した記事です。
参考リンク
オープンウェイトのAI4つを紹介した元の記事
第2章で引用した、組み立てる側と先に置く側の違いを書いた私の記事
第4章で引用した、手元のLM Studioでうまく動かなかった経験を書いた私の記事
第5章で引用した、128GBメモリのMacで画像生成AIを動かした話を書いた私の記事
コラムで引用した、用意してもらう有難さと自分で作れる喜びを書いた私の記事
今回紹介した記事
| 著者 | 山下(Seamless)さん |
| 媒体 | テクノエッジ TechnoEdge |
| 公開日 | 2026年11月6日 |
| 元URL | https://www.techno-edge.net/article/2026/11/06/5679.html |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!