WATCH REPORT
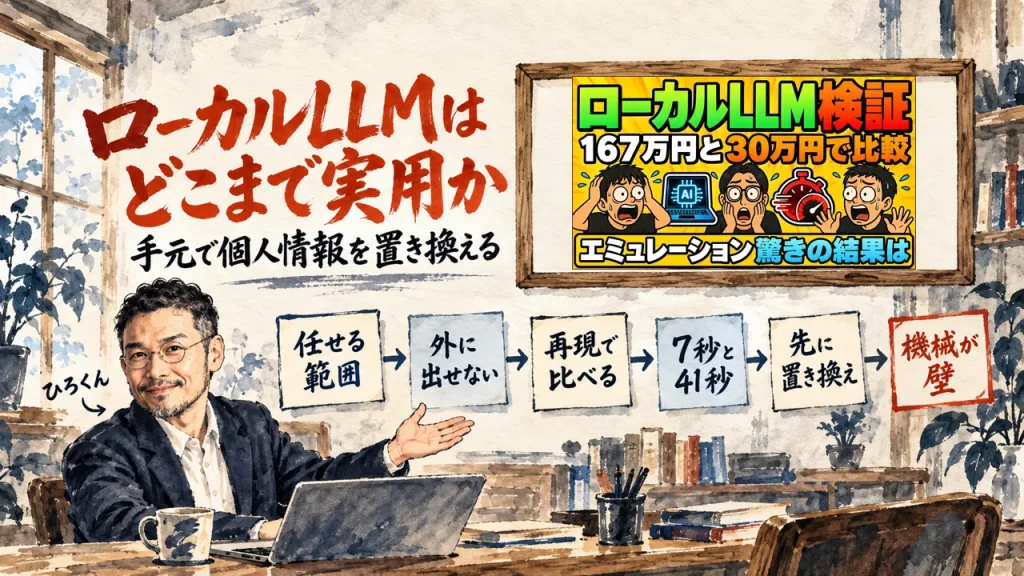
ローカルLLMはどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える
2026.10.30
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル『ギリギリ開発会議 by ボイスアップラボ』で、Sasageさんが、ToruさんとIkedaさんと一緒に、ローカルLLMはどこまで実用になったかを確かめた動画を紹介するね。
約30万円のMac mini構成と、約167万円のMac Studio構成。同じ質問を流します。画面には、Ultra構成に7秒間の思考。Mac mini構成に41秒間の思考。思考というのは、答える前に考えていた時間の表示です。動画の中で、いちばんはっきり数字が出る場面です。
動画の題は、ローカルLLMはどこまで実用になったか検証した件。解説とデモはSasageさん。番組の進行と締めはToruさん。そこにIkedaさんも加わる、約15分の動画です。ローカルLLMとは、自分の機械の中で動かすAIのこと。
社外に出せない情報を扱っている。AIは使いたい。でも、外に渡すのは不安です。そんな一人社長や小さな会社の経営者、士業や医療に近い仕事の人に向けて書きました。
話は、実用レベルになってきた所から始まります。続くのは、医療や法務の外に出せない情報。実機を買わずに3通りの構成を比べる方法。7秒と41秒。外のAIへ渡す前に、個人情報をローカルで置き換える使い方。そして動かす先の機械。
この記事では、動画で話された範囲を整理し、そこに私の判断を1つずつ重ねます。読み終えると、持ち帰れる物が2つ!1つ目は、7秒と41秒を、手元で測った値ではなく、ネット上の報告をもとにした再現の数字として読む見方。
2つ目は、自分の仕事で外に出さない情報を、種類で3つ書き出すこと。書き出した物は、このあとの折りたたみの依頼文に貼れば、線の整理をAIに手伝ってもらえます!
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料)外に出さない情報の線を、自分の仕事で整理するための依頼文(クリックで開きます)
下の枠の文を丸ごとコピーして、手元で作業を頼めるAIエージェントに貼ってみてください。記事の6つの話を仕事に当てはめて、外に出さない情報の線とローカルで動かす範囲を整理してくれます。
返ってきた結果は、そのまま信じずに自分の目で読み直してください。どこに線を引くかは、自分で決めます。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
ローカルLLMはどこまで実用か、外のAIに渡す前に手元で個人情報を置き換える
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、この依頼文に書いた内容だけを材料にしてください。

【目的】
ローカルLLM(自分の機械の中で動かすAI)について書いた記事の要点を、依頼した人の仕事に当てはめて確かめてください。外に出さない情報の線と、ローカルで動かす範囲を整理するのが目的です。
材料は次の要点だけです。
動画の中の発言(解説とデモはSasageさん、番組の進行と締めはToruさん)
1. ローカルLLMが実用レベルになってきた
2. 医療や法務など、個人情報を外に出せない仕事で関心が高まっている
3. 実機を買わずに、エミュレーション(ネット上のサービスにつなぎ、報告された速さをまねて見せる方法)で3つの構成を比べた
4. 同じ質問で、画面に出た思考の秒数は7秒と41秒。3の方法の画面に出た、考えていた時間(思考)の表示
5. 個人情報を先にローカルでマスキング(氏名などを別の言葉に置き換えること)してから、本命のAIへ渡す使い方がある。ダミーの30件の実演も3と同じ画面の中の出来事で、置き換わったというのは件数ではなく画面を見た感想
6. オープンウェイト(公開されていて、ダウンロードして自分の機械で動かせるモデル)を手に入れても、動かす先の機械が壁になる
記事の書き手の考え
・AIに渡す前に、家族とクライアントの情報を、渡す物と渡さない物に分ける
・実用かどうかは、任せる範囲を決めて、範囲ごとに確かめる
・個人情報は置き換えて、置き換え漏れを別の手順で確かめる

【やってよいこと】
・最初に次の質問を1つずつ聞き、答えを受けてから次へ進んでください。
1. どんな仕事でAIを使いたいか
2. 外に出したくない情報はどんな種類か(種類だけでよい。まず3つ)
3. 今使っているAIに何を渡しているか
4. 渡す前に情報を置き換える手順を持っているか
5. ローカルで動かしたい作業はあるか
・答えと要点を照らして、外に出さない情報の線と、ローカルで動かす範囲の案を書いてください。
・機密情報を扱う仕事なら、本物の記録に使う前に、作り物の記録を自分の機械で動かして確かめる手順を案に入れてください。

【守ること】
・設定の変更、ファイルの削除、外部への送信、機械やサービスの購入、外部のAIへの情報の送信はしないでください。必要に見えても、提案として書くだけにしてください。
・パスワードや鍵、顧客や家族の実際の個人情報を求めないでください。貼られても使わず、情報の種類の話に戻してください。
・動画の話は記事の中の発言として扱い、うのみにしないでください。
・7秒と41秒、ダミーの30件の話を、実機で動いた結果や置き換えの精度の根拠として使わないでください。
・記事に無い手順・数字・主張を足さないでください。
・追加のプロンプトに足してよいのは、私の環境に合わせた言い方と手順だけです。この依頼で禁じたことは、追加のプロンプトの中にも同じように書いてください。

【追加のプロンプト】
上の作業が終わったら、次の4つを1つずつ質問してください。答えが返ってから次の質問へ進んでください。
・この記事の話を、自分のどの仕事や場面に当てはめたいか
・その場面で、AIに渡せる物は何か(資料、記録、メモなど)
・最後に自分の目で確かめたい所はどこか
・私が使っているAIエージェントや道具は何か(名前、使えるファイルや記録の範囲など)
答えをもとに、私の環境でそのまま貼って使える追加のプロンプトを、1〜3本つくってください。記事のURLを、各プロンプトの中に入れてください。

【返す形】
・次の項目ごとに短く書いてください。
渡してよい情報の種類/渡さない情報の種類/ローカルで動かす範囲/置き換え漏れを確かめる手順の案/機械を選ぶ前に決めること
・各項目で、根拠にした記事の話と、依頼した人の答えを分けて書いてください。
・分からなかった所は、未確認と書いてください。
・私の環境で使える追加のプロンプト(1〜3本。記事のURL入り)
自分の機械の中で動くAIは、仕事に使えるところまで来たのでしょうか?動画の出だしは、まさにこの問い。ローカルLLMが実用レベルになってきた、という見立てから始まります。
Sasageさんの見立ては、ローカルLLMは実用レベルに入ってきた、というもの。
Sasageさん(動画の中で・1:38〜)
でもローカルLLMがもうね、Mac1台でもちょっとしたものならばGLM5.3フラッシュとかなら動くし、ま、ま、生成速度も、ま、それなりに出るような感じになってきてますよと。
言い換えると、Mac1台でも小ぶりなモデルなら動き、文章を作る速さもそれなりに出るようになった、ということです。例に挙がったGLMは、モデルの名前のひとつ。その軽い版です。
これはSasageさんの見立て。動画のデモは、このあと第3章で出てくる再現の画面で進みます。
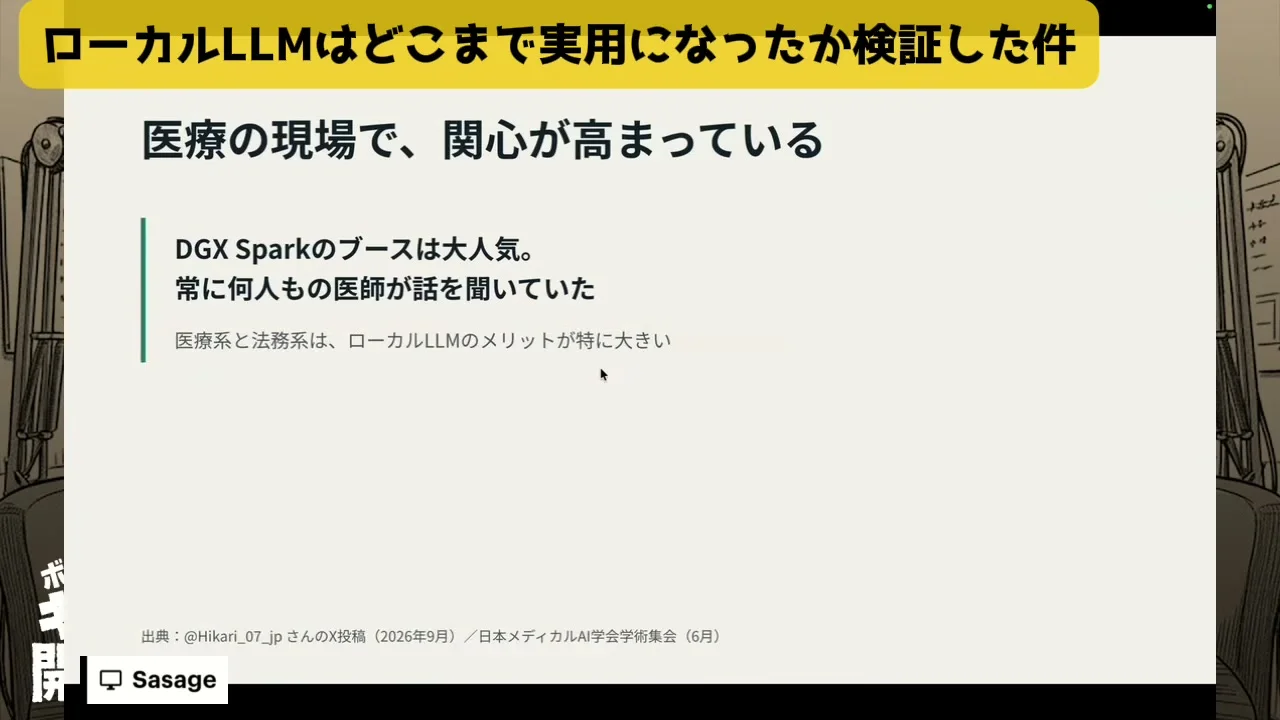
続いて、医療の現場での関心へ。医療系の展示会で、ローカルLLMを動かすのによく使われるマシン、DGX Spark のブースが大人気だった、という報告がXにあったと言います。
常に何人ものお医者さんが話を聞きに来ていた、とも。その報告を見て、今はそういう状況なのかと感じた、とSasageさん。
DGX Spark は求める人が多く、値段が上がってきている、という話も出ます。
実用かどうかは、速さだけでは決まらないんですよね。同じモデルでも、要約を頼むのか、数字を抜き出すのかで、求められる確かさが変わります。決め手は、何を任せるかの線引き。
私なら、実用かどうかは、任せる範囲を決めて、範囲ごとに確かめます!
動くかどうかと、生成の速さ。動画が見せた物差しは、この2つです。私はその手前で、任せる仕事を小分けにしておきたい。
その線について、手元で動かすQwenを含む4つの道具を試した記事の、手元のQwenの節で、私はこう書きました。
私の記事より(4つの道具を試した記事の、手元のQwenの節)
ここは使える。社外に出したくないメモの、一次整理に向く。
…
手元の要約は、Qwen 3.6で実用になった。ただしAGI Cockpit経由では、小さい原稿でも大きな器が必要になりうる。厳格な抽出には、後段の事実チェックが要る。
引用の中の器は、AIが一度に読める文章の量のこと。その記事では、最初の器が小さくて拒否され、器を大きくして通った、と書いています。引用の中の英語の名前は、同じ記事の冒頭で、AIを何個も同時に使える箱、と書いたアプリです。
動画の実用レベルの話も、この分け方で見ると具体的になります!整理を頼むのか、抜き出しを頼むのか。それで実用かどうかの答えは分かれます。
私が手元のモデルに向くと書いたのは、社外に出したくないメモの、一次整理まで。厳しく抜き出す仕事には、後ろで事実を確かめる手順を置く、とも書いています。
精度だけなら、クラウドの方が上。そう分かっていても、ローカルを選ぶのはどんな仕事でしょうか?動画は、ローカルで動かす理由へ移ります。
Sasageさんは、精度だけならローカルでない方がいい、と前置きします。それでもお医者さんが注目するのは、普通のLLMがそもそも使えないから。
Sasageさん(動画の中で・3:03〜)
もうすごい個人情報の塊りなんで。
外に出せるかどうか。これは、精度を比べるより前に引く線なんですよね。
私なら、AIに渡す前に、家族とクライアントの情報を、渡す物と渡さない物に分けます!
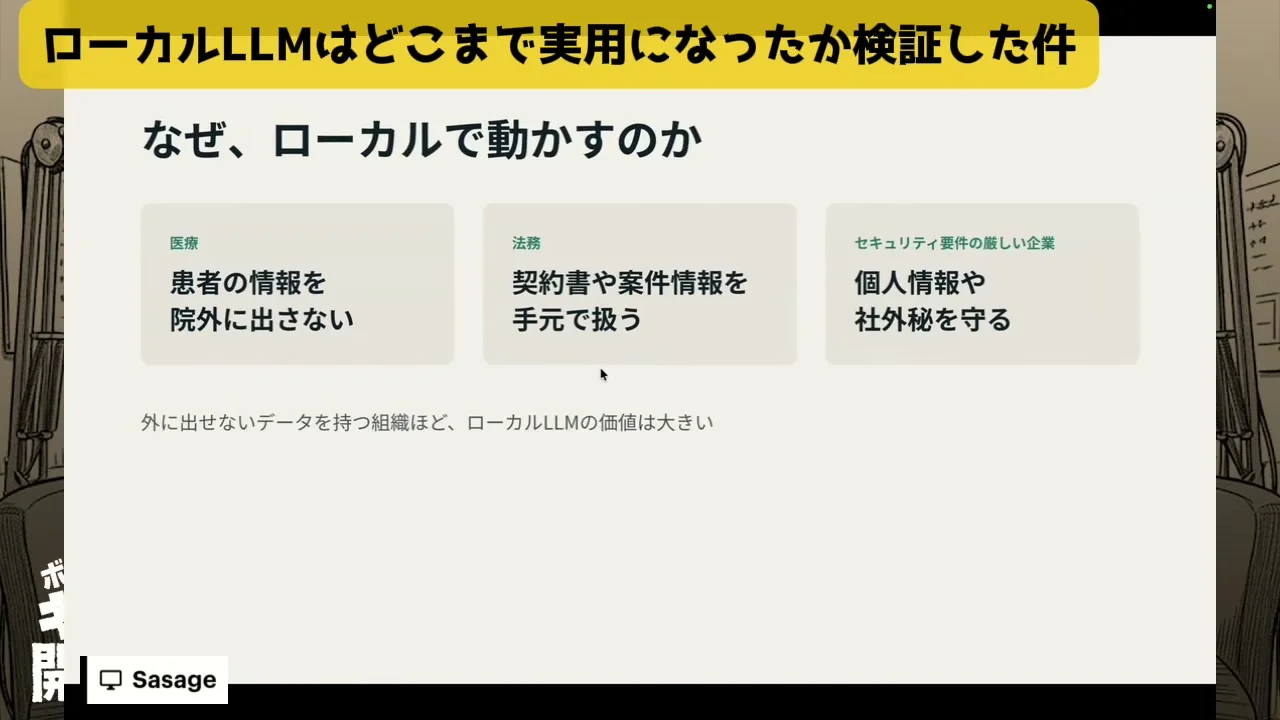
最初の例は医療です。患者の情報は、病院の外に出してはいけない決まりがある。だから、ローカルで動かす機械を院内に入れたい、という話になります。
次は弁護士や法務の仕事。さまざまな情報を扱うので、ローカルにしたいと考える人がいる、と続きます。
3つ目は、セキュリティ要件の厳しい企業。外に出せない所が、まだ残っていると言います。
どの仕事も、理由は同じ。外に出せない情報があるから、ローカルLLMが注目されている、という流れです。
その線について、個人情報を預ける前に預け先の責任範囲を確かめる記事で、私はこう書きました。
私の記事より(預け先の責任範囲を確かめる考え方を書いた記事)
私の分身AIの元になる文書の禁止事項の一つに、個人情報の漏洩を避け、家族とクライアントの情報は守る、があります。預けても、この線は変わりません。
…
持つ・預ける・AIに渡すの境界は、最後に私が決めます。
預ける相手が変わっても、この線は自分の側に置いておけます。クラウドでも手元でも、守る情報は同じ。
動画が見せたのは、外に出せないから手元で動かす、という使い分け。私の線はその一歩手前で、どこで動かすかより先に、誰に何を渡すかを決める所にあります!
渡す物と渡さない物が分かれていれば、機械を選ぶ時も、何を手元に残すかがはっきりします。
ローカルLLMが動くと分かると、次は機械ごとの速さが気になります。けれど、手元に無い機械の速さは、どうやって知るのでしょうか?動画が選んだのは、買わずに試す方法。
そのマシンを買うのは大変なので、エミュレーションにした、とSasageさんは言います。エミュレーションは、ネット上の報告をもとに、その機械で動かした時の様子を再現して見せることです。
元にしたのは、実際にそのMacで動かしたらこれぐらいの速度や性能が出た、という報告。ネット上にたくさんあったものだと話します。
動画の画面は、その報告を読み込ませて、同じように動かしたらどういう動きになるかを見る作りだ、と説明されます。
使うのは、Open WebUIという、モデルを選んで質問する画面。ここで構成とモデルの組み合わせを選びます。画面の裏側はネット上のサービスにつながっている、とSasageさんは話します。
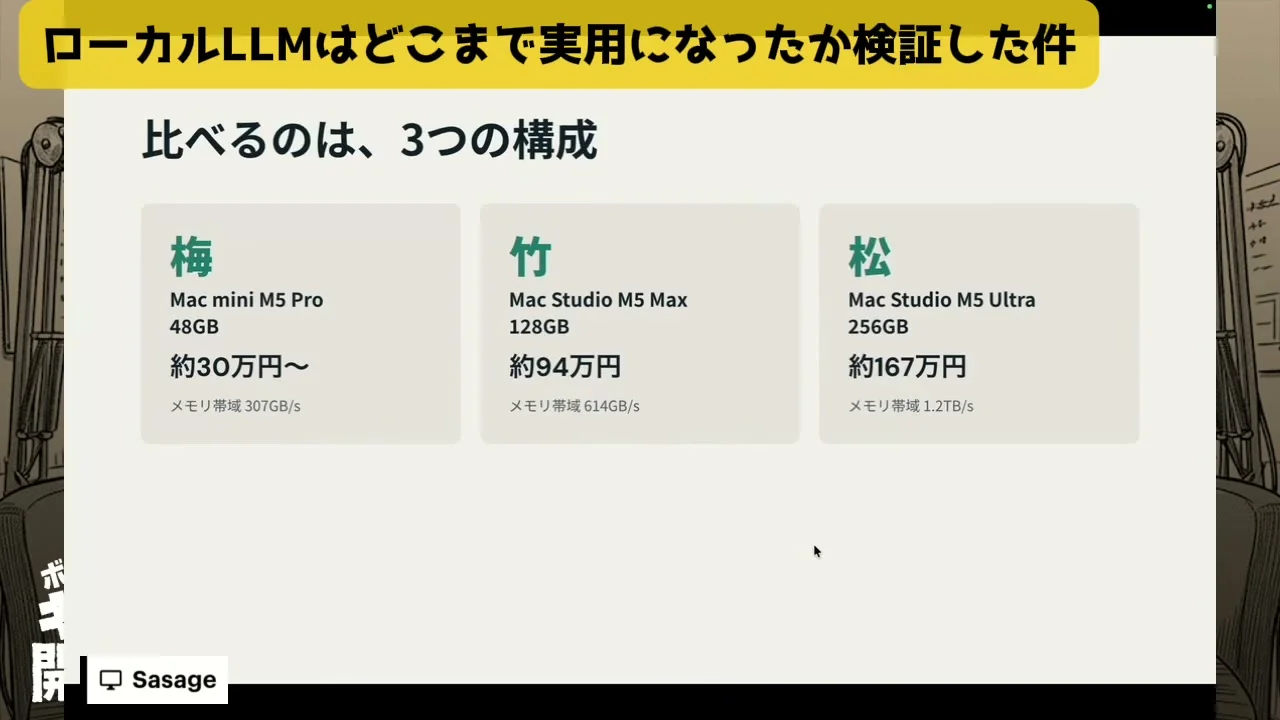
比べる構成は3通り。M5 Pro・M5 Max・M5 Ultraは、チップの名前の違いです。
Mac mini(M5 Pro・メモリ48GB)は、約30万円から。Mac Studio(M5 Max・メモリ128GB)は、約94万円。Mac Studio(M5 Ultra・メモリ256GB)は、約167万円。3つの違いは、メモリの量に大きく出ます。
使うモデルは、Qwen系やGLMなど。Qwenも、モデルの名前です。Sasageさんがそのマシンを持っているわけではないことも、出演者の質問に答える形で明かされます。
Sasageさん(動画の中で・6:01〜)
ちょっとエミュレーションなんで正しいかどうか分からないですけど、ま、雰囲気をね、ローカルLMを使ってる時こんな感じになるんだみたいな雰囲気を分かってくれれば
引用の中のLMは、LLMのことです。
私なら、再現の数字は、実測の値として並べず、雰囲気をつかむ材料として読みます。
雰囲気でつかめるのは、どの構成で待ちが長くなるかの向き。実際に私の机で何が起きるかは、別に見ておきたい所です。動かす前の準備も、その中に入ります!
数字を見ると、自分の机でも同じ速さが出る気がしませんか?私はそこで一度、手を止めたいんです!
デモの質問は、社内の勉強会で、生成AIを業務に取り入れる時の注意点を3点挙げ、それぞれ短く説明する、というもの。対象は営業部とサポート部のメンバーです。ITにあまり詳しくない人も含みます。
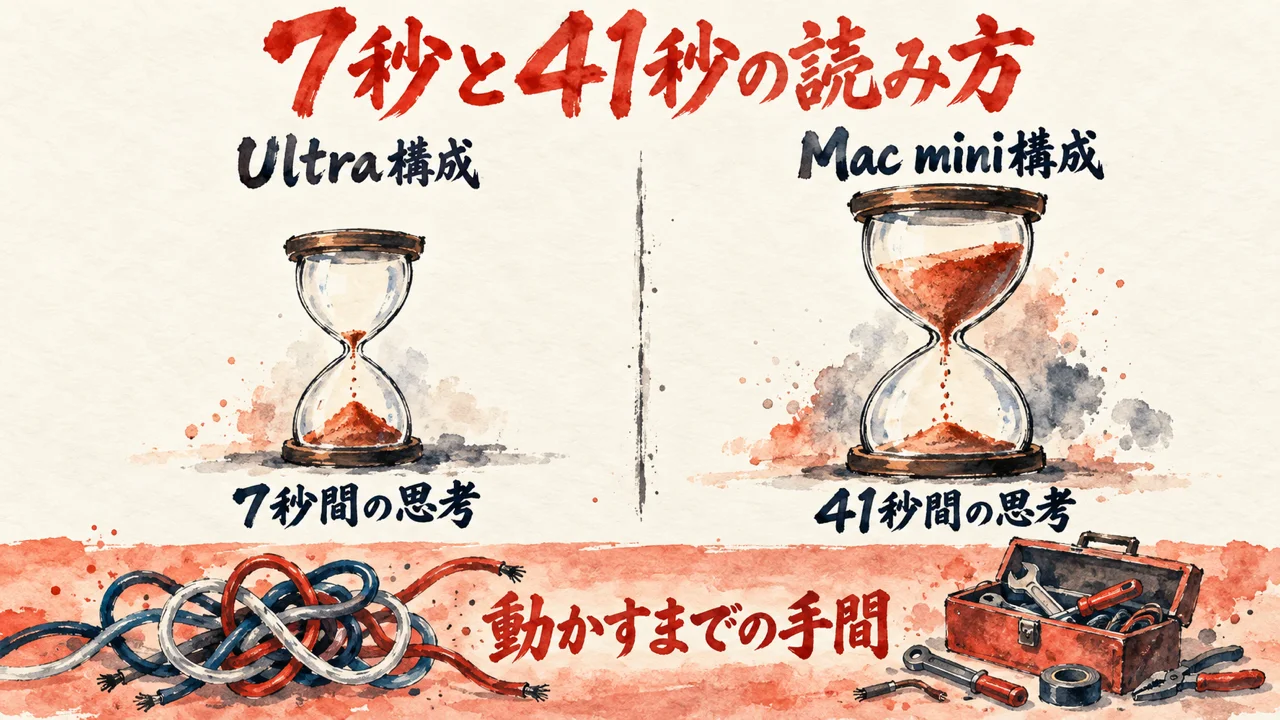
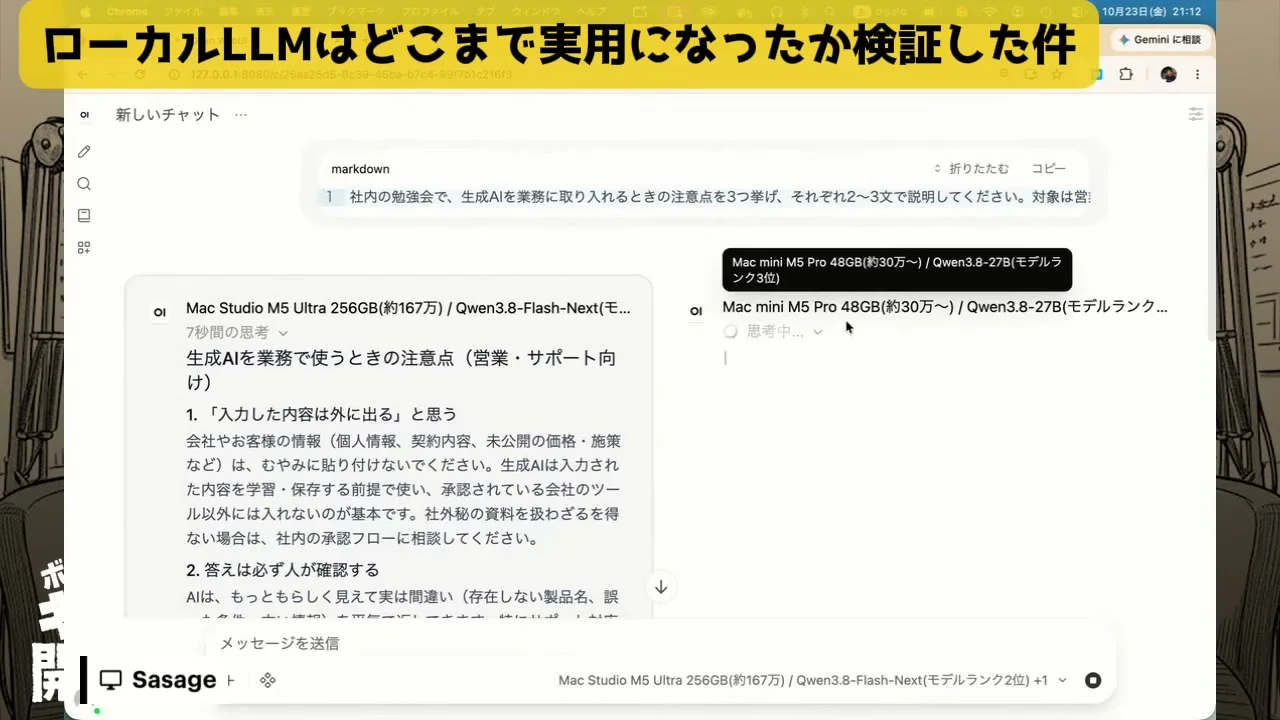
画面には、Ultra構成に7秒間の思考、Mac mini構成に41秒間の思考と出ます。同じ質問を、2つの構成に流した時の表示。どちらも、第3章で見た再現の画面の上の数字です。仕事で毎日使うと、この差はどれくらい影響してくるでしょうか?
Sasageさんは、同じ質問を2つの構成に同時に流します。並ぶのは、Ultra構成と、約30万円のMac mini構成。その秒数を、答えが出るまでの時間として語ります。画面の表示は思考。答えを書き出す前に考えていた時間です。
Sasageさん(動画の中で・7:03〜)
ま、やっぱウルトラだともう7秒でバーンで出してくれるんで。
Ultraなら、普段使うAIとあまり変わらない感覚で使える、という話です。
Sasageさん(動画の中で・7:16〜)
で、やっぱ30万円ぐらいのモデルだと、え、なかなか時間がこんな短いやつでもかかってしまうっていう。あ、だけど41秒か。41秒で出ていきますという感じ。
出演者から、モデルが違うのに比べになっているのか、という質問が出ます。答えは、そのマシンで動く一番いいモデルを使っている、というもの。厳密な同条件ではありません。
画面のMac mini構成の欄には、Qwen3.8-27Bと出ています。
Sasageさん自身も試してみて、普通のことを聞く分には、ここに挙げたモデルは変なことを言わない印象だったと言います。
Sasageさん(動画の中で・7:58〜)
ま、めっちゃアホだなっていうことはなくて、ま、どっちかというと、ま、どれぐらい時間が答えるまででかかるのかっていうところがネックになってくるのかなっていうイメージでしたね。
Qwen系は中国で作られたモデルなので、答えの後ろの方に中国語が混ざることがたまにある、とも。
私なら、画面の秒数だけでなく、動かせるようになるまでの手間も含めて見ます。
私は2026年8月18日から19日にかけて、手元のLM StudioでQwen 3.8を動かそうとして、うまく動きませんでした。LM Studioは、手元でAIを動かすアプリです。
最後に読み込み直したのは、qwen3.8-27b-mlx。動画のMac mini構成の欄にあったQwen3.8-27Bと、同じ名前のモデルです。私の机は、再現の画面とは別の環境です。
私がAIに送ったのは、ちゃんと動くようにして、という言葉。続けて、LLMロード2個されちゃってる、なんで、と聞きました。
AIに調べてもらうと、動かなかった原因は3つ。
1つ目は、同じQwen 3.8が二重に読み込まれていたこと。同じモデルが、2つ同時に立ち上がっていた状態です。
2つ目は、長い指示と多くの道具の定義が、一度に送られていたこと。道具の定義は、AIが使える機能を知らせる説明書きです。それが長い指示と一緒に、1回の問いかけに乗っていました。
3つ目は、削除したQwen 3.6の指定が残っていたこと。消した古いモデルの名前が、設定の中に残ったまま。
対処は2つ。qwen3.8-27b-mlxを1つだけ、同時に2件まで受ける設定で読み込み直すこと。送る文章の形を整える仲介役を、手元に常駐させること。
動画の画面に出ていたのは、7秒間の思考、41秒間の思考という、考えていた時間の表示です。
M5 UltraとDGX Sparkを比べる動画を紹介した記事で、私はこう書きました。
私の記事より(表の数字より先に見る物を書いた記事)
私なら、表の数字より先に、自分の仕事のプロンプトと答えの大きさを見ます。
プロンプトは、AIに渡す指示や文章のこと。短い質問でも、考える時間の表示だけで41秒と出るなら、長い文章を読ませる仕事では、待ち方から考え直したくなります!
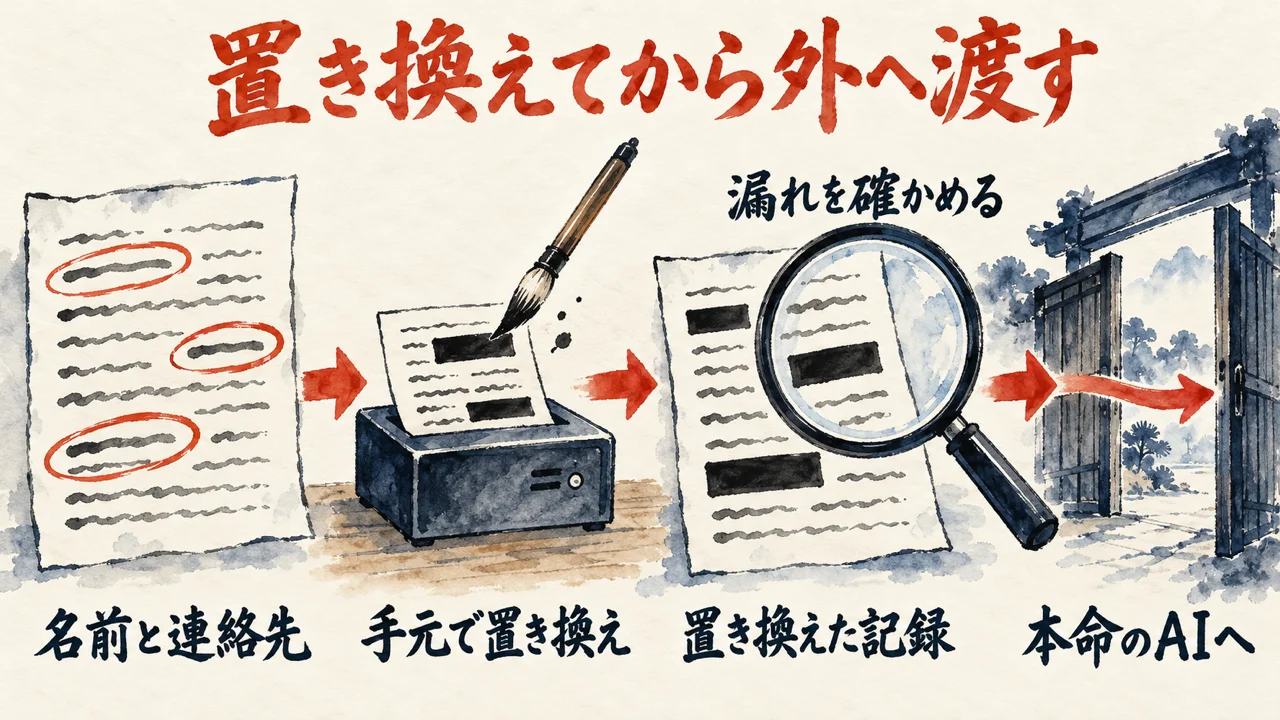
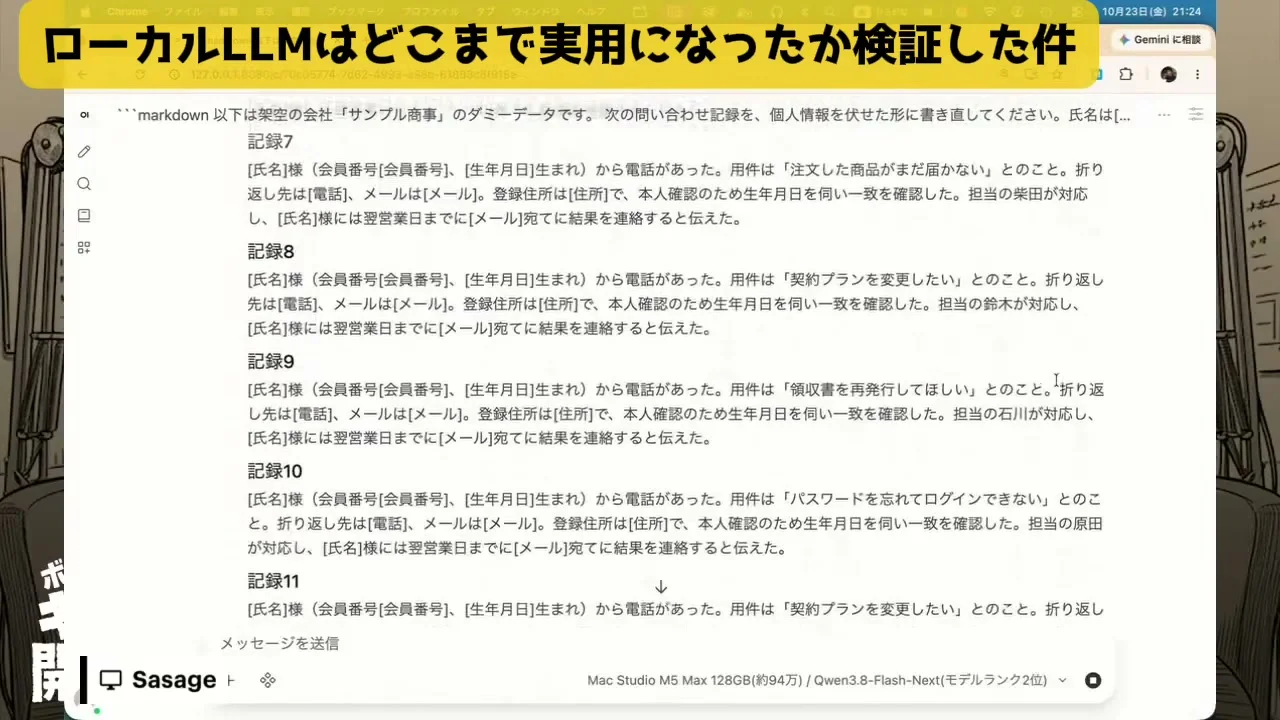
問い合わせの記録や相談の文面には、名前や連絡先がそのまま入っています。こうした文書を外のAIに読ませたい時、どうしますか?動画は、ローカルLLMの使い方の例として、個人情報の扱いへ進みます。
個人情報をAIに読ませていいのかは、よく問題になる、とSasageさんは言います。そこで出てくるのが、先にローカルLLMでマスキングしてから、本命のLLMへ渡す使い方。マスキングは、氏名などを別の言葉に置き換えて見えなくすることです。
Sasageさん(動画の中で・9:52〜)
やっぱ個人情報をローカル、え、普通のLMに投げるのは良くないみたいな話があると思うんですけども、ま、それを先にローカルLLMでマスキングしてから本ちゃのLM投げる使い方が結構便利なんじゃないかなと個人的には思ってます。
引用の中の本ちゃのLMは、本命として使う外のAIのことです。
私なら、個人情報は本命のAIへ渡す前に置き換えて、置き換え漏れを別のやり方で確かめます。
試すのは、問い合わせの記録に見せたダミーのデータ30件。個人情報が大量に載っていて、全部マスキングしてください、という指示を与えます。選んだ組み合わせは、M5 Max 128GBの構成とQwenのモデル。
この30件の実演も、第3章の画面の中の出来事です。画面の裏側はネット上のサービスにつながっているので、ローカルで動いた証拠にも、本物の個人情報を流してよい証拠にもなりません。
考えている途中の表示のあと、30件の出力が並びます。途中、名前が残って見える所があり、出演者が慌てる場面も。ただ、指示には、社員の苗字は置き換えないでください、と書いてありました。担当者の苗字が残るのは、指示どおりです。
氏名などが指示どおりに置き換わった、というのが、画面を見たSasageさんの受け止め。件数を数えた話ではなく、画面を見た感想です。どの記録がどの人のものか、後から見分けられるかは分からない、という指摘も出ます。
使い道としては、こういう事案があって改善をどうするかを考えたい時、というイメージだと続けます。
Sasageさん(動画の中で・12:03〜)
あんまり違和感なくちゃんとしたこと答えるなってイメージは全体的に受けたので、そういう個人情報とかたくさん取り扱っているところは検討してみてもいいかもしれません
動画では、置き換えそのものを機械に頼んでいました。ただ、漏れの確認まで同じ機械に任せると、確かめる手順がひとつきり。
本物の記録に使う前に、作り物の記録を手元で通して確かめたい!
2026年7月14日には、文書どうしの関係を探す道具を、手元でAIを動かすアプリのOllamaだけで手動で動かし、外のAIへは送らないと決めました。
私の記事で、手元のQwen 3.6の要約を、原文に書いてある範囲だけで見ると、はみ出した箇所があった、と書いています。日付から日数を足した記述と、次にやることを勝手に決めた箇所です。
原文の抜き出しではなく、推論寄りでした。厳格な抽出にはあとで事実チェックが要る、とも書きました。
手元で動くことと、出力が原文どおりであること。この2つは別の話です。置き換え漏れを別の手順で確かめたいのは、そのため。
マスキングを機械に任せる所までが、動画の見せ場。私は、置き換え漏れを確かめる所までを、自分の側に残します!
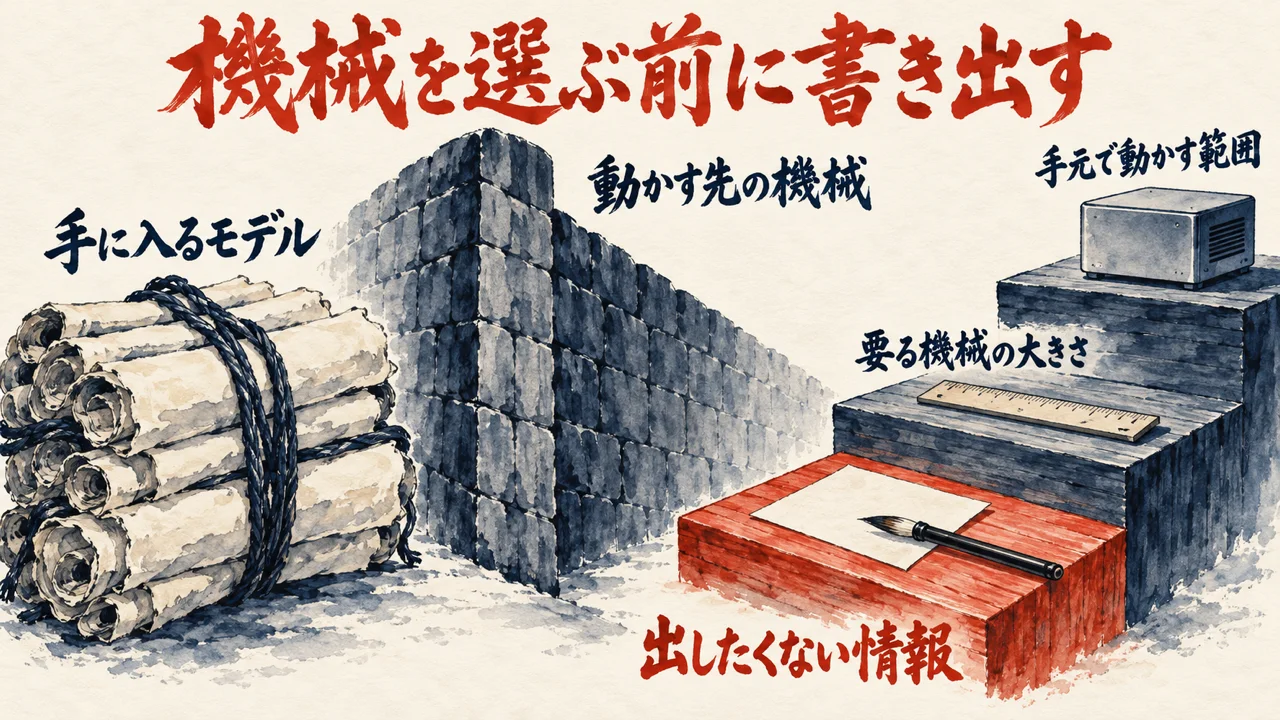
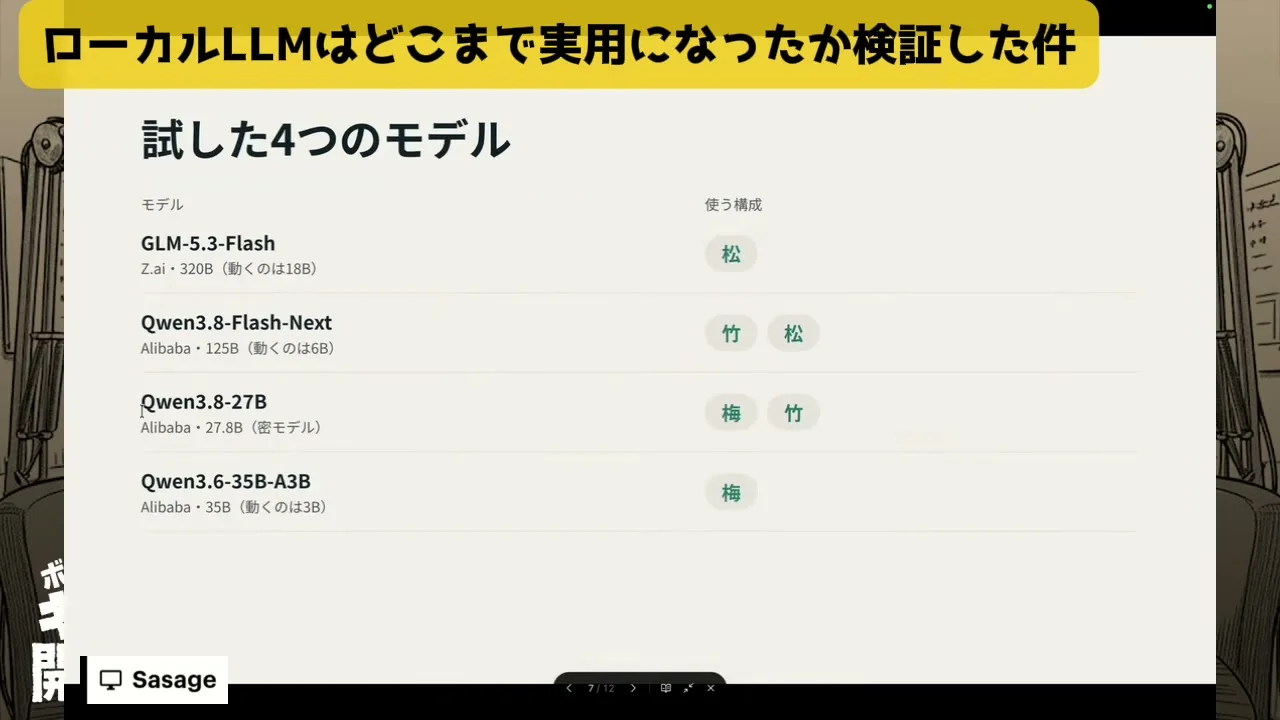
モデルが公開されていれば、手に入れたそのまま、自分の機械で動かせるのでしょうか?動画は、マスキングのあと、オープンウェイトへ移ります。モデルの大きさと、それを受け止める機械の話です。
出演者から、オープンウェイトにはテラ級の大きさのものがあるけれど、どうやってダウンロードするのか、という質問が出ます。
オープンウェイトは、公開されていて、ダウンロードして自分の機械で動かせるモデルのこと。テラ級は、サイズがテラバイトの単位になるほど大きいことです。
ダウンロードのリンクを押しても、何日もかかるのでは、という話も出ます。答えは、ダウンロードできても、それを動かす方が難しい、というもの。今回紹介した構成は、そういう大きさとは別だ、とも付け加えられます。
(動画の中で・13:07〜)
ダウンロードできたとしてもそれを動かすサーバーがもうどうすんねんみたいな話なんで。
動画の中では、ダウンロードまで済んでも、動かすサーバーをどうするのかが問題になる、という意味で語られます。その動かす先のサーバーの価格が上がっている、と続きます。
ローカルLLMを動かすのによく使われるマシン、DGX Spark が話題になり、M5 Ultra も人気がある、と進みます。
Sasageさん(動画の中で・14:16〜)
ま、実際にね、使わ、実際に買ってる人も増えてるし、ま、実際の会社でも会社とか医療機関でも使われるケースが増えてきているっていうのが、ま、情勢としてありますよという感じですね。
モデルが手に入ることと、動かせることは別の問題。ここ、見落としやすいんですよね。
私なら、機械を買う前に、自分の仕事で外に出したくない情報は何かを、先に書き出します。
外に出したくない情報が決まっていれば、要る機械の大きさも、手元で動かす範囲も、ぐっと決めやすくなります!
逆に、そこが決まらないまま比べ始めたら、機械の比べ合いはいつまでも終わらない気がしませんか?
買う人が増えている、というのがSasageさんの語る情勢。機械選びは、その書き出しの後でいい、と私は考えます。
COLUMN
▲目次委ねる前に、信頼できる仕組みを置く
委ねる先が、嘘をつかない、逃げない。それが条件だと書いた魂磨きの記事があります。
仕事の場では、握り続けようと思えば握り続けられる。だから委ねるかどうかは、決意の問題に見えやすいのかもしれない、とその記事に書きました。続けて、次のように書いています。
私の記事より(集中治療室で、安心して委ねられた)
仕事の場面で私が置いている条件は、信頼できる仕組みが先、ということです。
安心は、渡す側の気持ちの中だけでは作りにくいのだと思います。
委ねる話は、渡す側の覚悟だけでは完結しません。ボールを受け取って、一人でやりきれる相手がいて、はじめて成り立つ!
外に出せない情報をどこに預けるか、という今回の話にも、この条件は重なります!預ける前に見るのは、預け先の仕組みの方です。
第5章の動画のデモも、裏側はネット上のサービスにつながった画面でした。見せ方がきれいでも、本物の情報を流してよい証拠にはなりません。預け先を選ぶ順番は、仕組みを確かめるのが先、機械の性能の比べ合いは後です。手元のMacで動かす場合も、ネット越しのサービスを使う場合も、問いは同じです。預けた情報は、どこへ行くのか。自分の目で確かめられるか。
今、手放せていない情報は、どんな仕組みがあれば預けられますか?
委ねる時の条件について、信頼できる仕組みが先だと書いた魂磨きの記事があります。
分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
Q. ローカルLLMは、Mac1台でも仕事に使えますか?
A. Sasageさんは、Mac1台でも小ぶりなモデルなら動き、生成の速さもそれなりに出る、と言います。どこまで任せるかは、任せる範囲を決めて、範囲ごとに確かめると見えてきます。詳しくは第1章。
Q. 医療や法務で、ローカルLLMが注目されるのはなぜですか?
A. 理由は精度ではありません。患者の情報を院外に出せない医療、弁護士や法務、セキュリティ要件の厳しい企業では、個人情報を外に出せないから、と動画では説明されます。詳しくは第2章。
Q. 7秒と41秒は、実機で測った値ですか?
A. ネット上の報告をもとに、構成ごとの速さを再現した画面の表示です。表示は思考の秒数。答えを書き出す前に考えていた時間です。モデルも構成ごとに違い、厳密な同条件ではありません。詳しくは第3章と第4章。
Q. 個人情報は、先にローカルで消してから渡せますか?
A. 動画では、ダミーの問い合わせ記録30件で、氏名などが置き換わる様子を見せています。残って見えた名前について、指示に社員の苗字は置き換えないとあった、と出演者が気づく場面もあります。この実演をどこまで当てにできるかは、第5章に書きました。
この記事では、Toruさんの進行のもと、Sasageさんが解説とデモを担い、Ikedaさんも加わってローカルLLMの今を確かめた動画を、6つの章で追いました。
ローカルLLMは、どこまで実用か。動画の再現の画面では、約30万円のMac mini構成に41秒間の思考と出ました。私が手元で確かめて書き残したのは、社外に出したくないメモの一次整理に向く、という所まで。私の答えは、任せる範囲を決めて、範囲ごとに確かめる、です!
7秒と41秒は、再現の画面に出た、考えていた時間の表示。答えが全部出るまでの時間とは分けて読みます。
医療や法務のように、個人情報を外に出せない仕事では、なおさら線が先です。機械を選ぶ前に線を引き、置き換えたら、置き換え漏れを別の手順で確かめる所までを、自分の側に残します!
動画は、ローカルならどこまで動くかを、速さと使い方で見せてくれました。その手前の問いをひとつ。今の仕事で、AIに渡さない情報を、迷わずひとつ言えますか?
まずは、外に出さない情報の種類を3つ書き出してみてください。書いたら、記事の最初の折りたたみの依頼文に貼って、線の整理をAIに手伝ってもらえます。
関連記事
2つの構成に長い文章を読ませて、待ちの違いを比べた記事です。待ち時間を秒数以外からも見る時の手がかりになります。
外にデータを出さずにAIを動かせるワークステーションを紹介した記事です。動かす先の機械を考える時の材料になります。
データを預ける前に、預け先の責任範囲を自分で確かめる記事です。渡す物と渡さない物を分ける話とつながります。
手元で動かすモデルを含むいくつかの道具を試し、どれをいつ使うか分けた記事です。任せる範囲を決める話に近い内容です。
新しいチップの発表を解説し、ローカルでAIを動かす選択肢が広がる話をした記事です。機械選びの背景が分かります。
AIを使った開発の情報漏洩対策を、何から始めるか動画の順に追った記事です。外に出さない線を引く話の続きとして読めます。
ローカルLLMに検索を足す前に知っておきたい選択肢を整理した記事です。手元で動かすAIの使い道を広げる時に読めます。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
第1章で一部を引いた、私の記事です。
第2章で一部を引いた、私の記事です。
第4章で一部を引いた、私の記事です。
今回紹介した動画
| チャンネル | ギリギリ開発会議 by ボイスアップラボ |
| 出演 | Sasageさん(解説・デモ)・Toruさん(番組の進行と締め)・Ikedaさん |
| 公開日 | 2026年10月30日 |
| 長さ | 15分31秒(日本語の雑談形式) |
| URL | https://www.youtube.com/watch?v=OKwhHfil4po |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!