WATCH REPORT
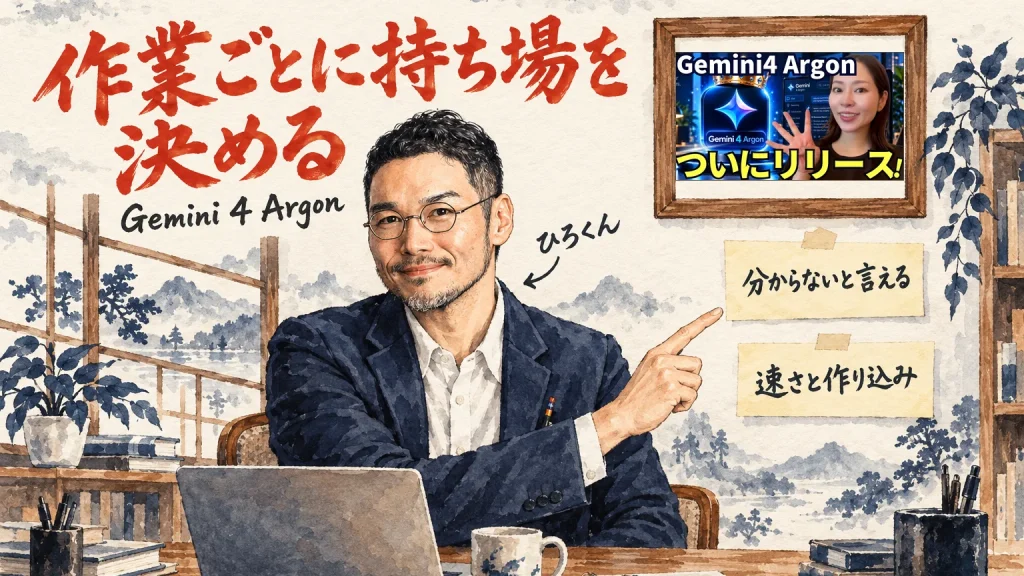
Gemini 4 ArgonとClaude Opus 5.5の比較、持ち場はどう違うか
2026.10.15
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、mikimiki web スクールの『最新/最強モデル「Gemini4 Argon」爆誕!実力を徹底解説(vsGPT-6 Astra vs Claude Opus 5.5)』の動画を紹介するね。
新しいAIモデルが出るたびに、迷いますよね。ChatGPTとClaudeとGeminiのどれを、自分の仕事のどこに置けばいいのか。決めきれないまま、比較記事だけが増えていきます。
個人事業主や一人社長なら、毎週のように出会う迷いだと思います。今回はそこを整理します。
取り上げるのは、YouTube「mikimiki web スクール」の動画です。長さは21分48秒。2026年10月14日公開の日本語の動画です。みきさんが、Googleの新モデルGemini 4 Argonを解説しています。比べる相手は、GPT-6 AstraとClaude Opus 5.5です。
この記事では、みきさんの話を動画の時刻つきで整理しました。その隣に、手元で実際に測ったAIの比較の数字を置いています。動画の評価と手元の測定は混ぜません。並べるだけです。
読み終えると、Argonが得意なことが分かります。AstraやOpus 5.5との持ち場の違いと、使える条件も分かります。デモの結果と、公開前の事実確認での使い方も載せました。順位表の1位を探すより、作業ごとに持ち場を決める。その見方を持ち帰れます。
SPEAKER
mikimiki web スクール
語り手: みきさん。右上のワイプに顔を出し、スライド資料と実際の画面を見せながら解説する動画です。
21分48秒、2026年10月14日の公開、日本語です。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)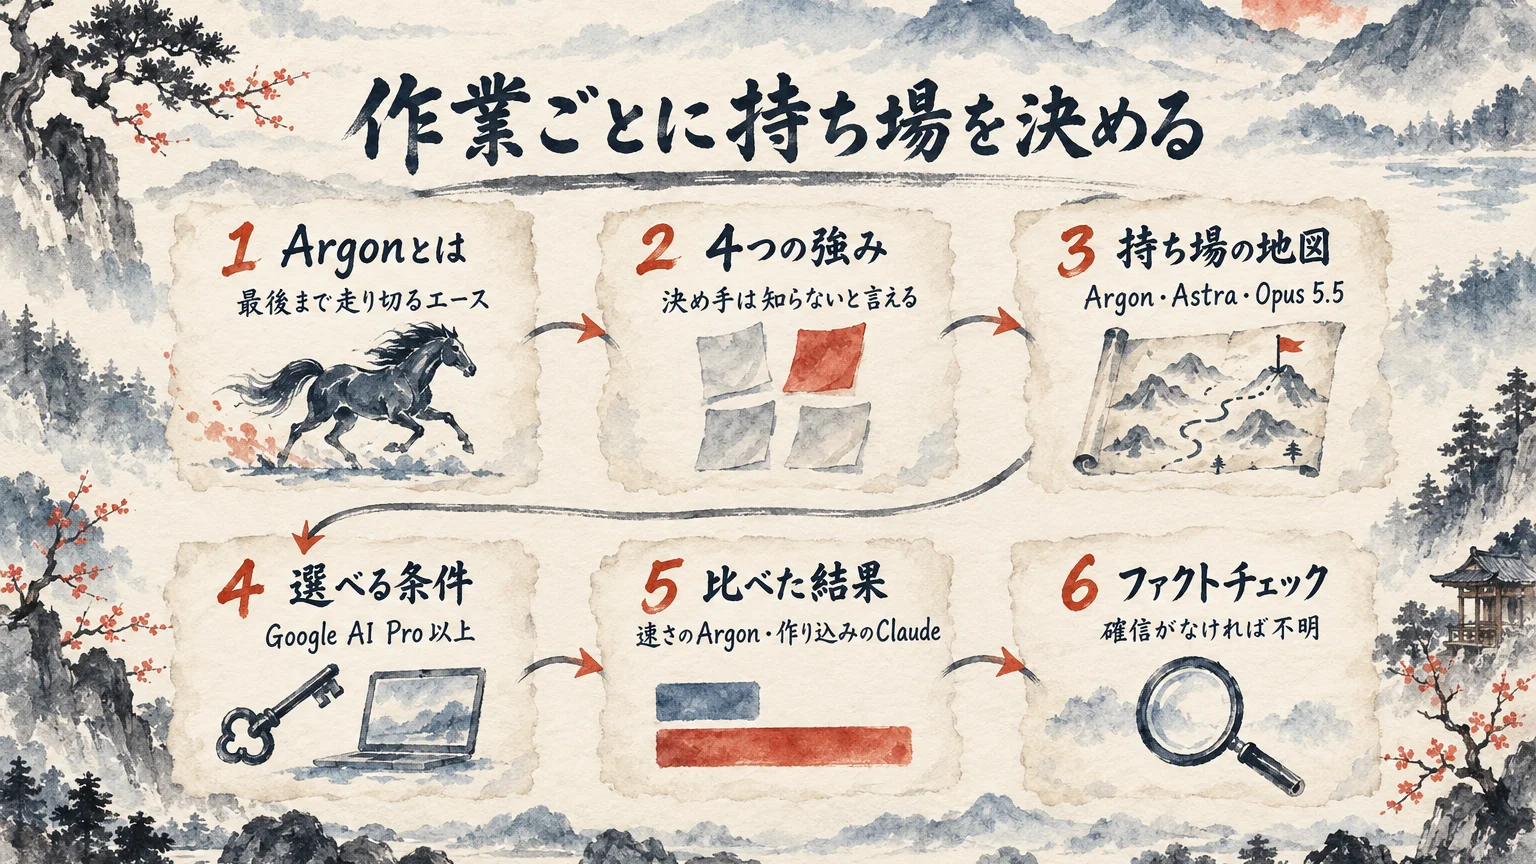
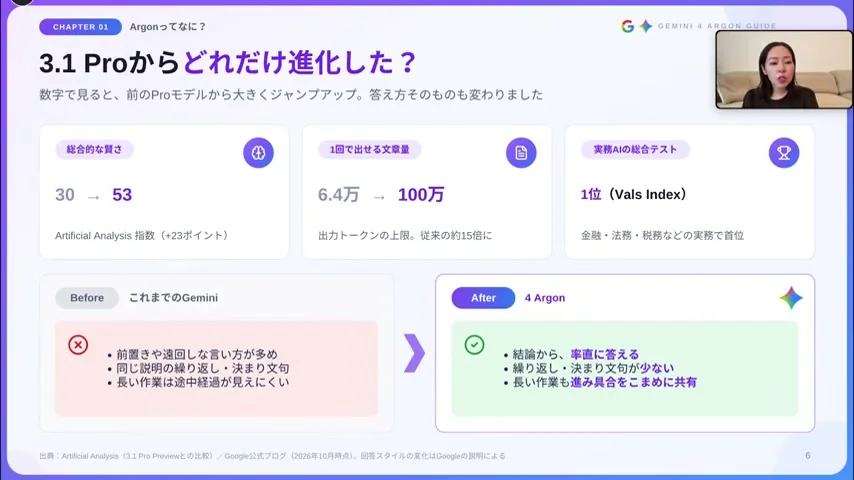
まずは動画の第1章、0:10から3:31までです。この章では、評価や立場を足しません。みきさんがArgonをどう紹介したかを追います。スライドの数字も、時刻つきで順に見ていきます。
0:10でみきさんは、Geminiの新モデルArgonを紹介します。Google史上最高の性能と言われるモデル、という位置づけです。1:12からは、3.1 Proのあと更新が止まっていた最上位に出てきたモデルだと紹介します。
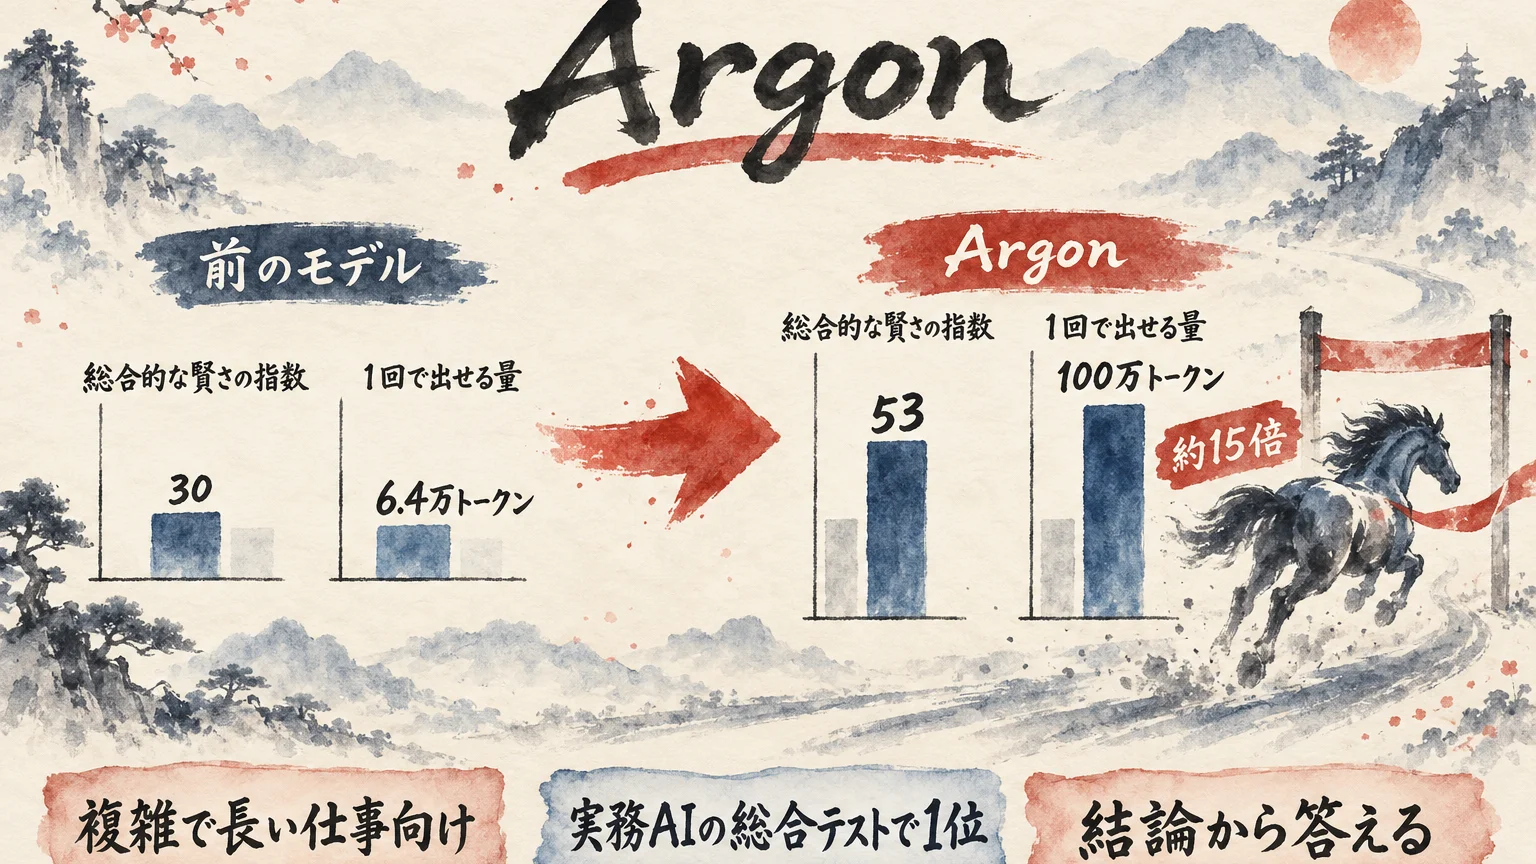
1:48のたとえは、長い仕事を途中で投げ出さないエースです。向くのは、コーディング・金融・法務・科学のような複雑で長い仕事です。2:00からは、入出力あわせて最大100万トークンの話です。出力も100万に広がった点を、みきさんは大きな進化だと言います。
2:20のスライドの数字です。総合的な賢さ(Artificial Analysisの指数)は30から53。1回で出せる量は6.4万から100万トークンで、約15倍です。実務AIの総合テストVals Indexでは1位です。
2:47からは、答え方の変化です。前置きや決まり文句が減り、結論から答えるようになったと、みきさんは説明します。3:16からは日程の話です。9月30日発表、10月14日一般提供です。
みきさん(動画の中で・1:48〜)
例えるなら最後まで走り切るエースです。難しい仕事も投げ出さずゴールまで作業してくれるというのが特徴としてあります。
みきさん(動画の中で・3:06〜)
ジェミニ4アルゴンは結論から率直に答え繰り返し決まり文句が少なく長い作業も進み具合をこまめに共有してくれるようになりました。
同じモデルの数字は、Google発表の数字と独立ランキングを分けて整理した、Gemini 4 Argonの最新AIニュース解説(10月14日号)で見方を整理しました。ここでは、10月14日公開のみきさんの説明を中心に追います。
0:10から3:31までの要点を並べます。複雑で長い仕事向けであること。1回で出せる量が広がったこと。答え方が変わったこと。どれも、置き場所を決める材料です。
2:20のスライドの数字は、地図として持っておきます。第3章の比較と、第5章のデモを読む前の地図です。どの作業に置くかは、そのあとで考えます。
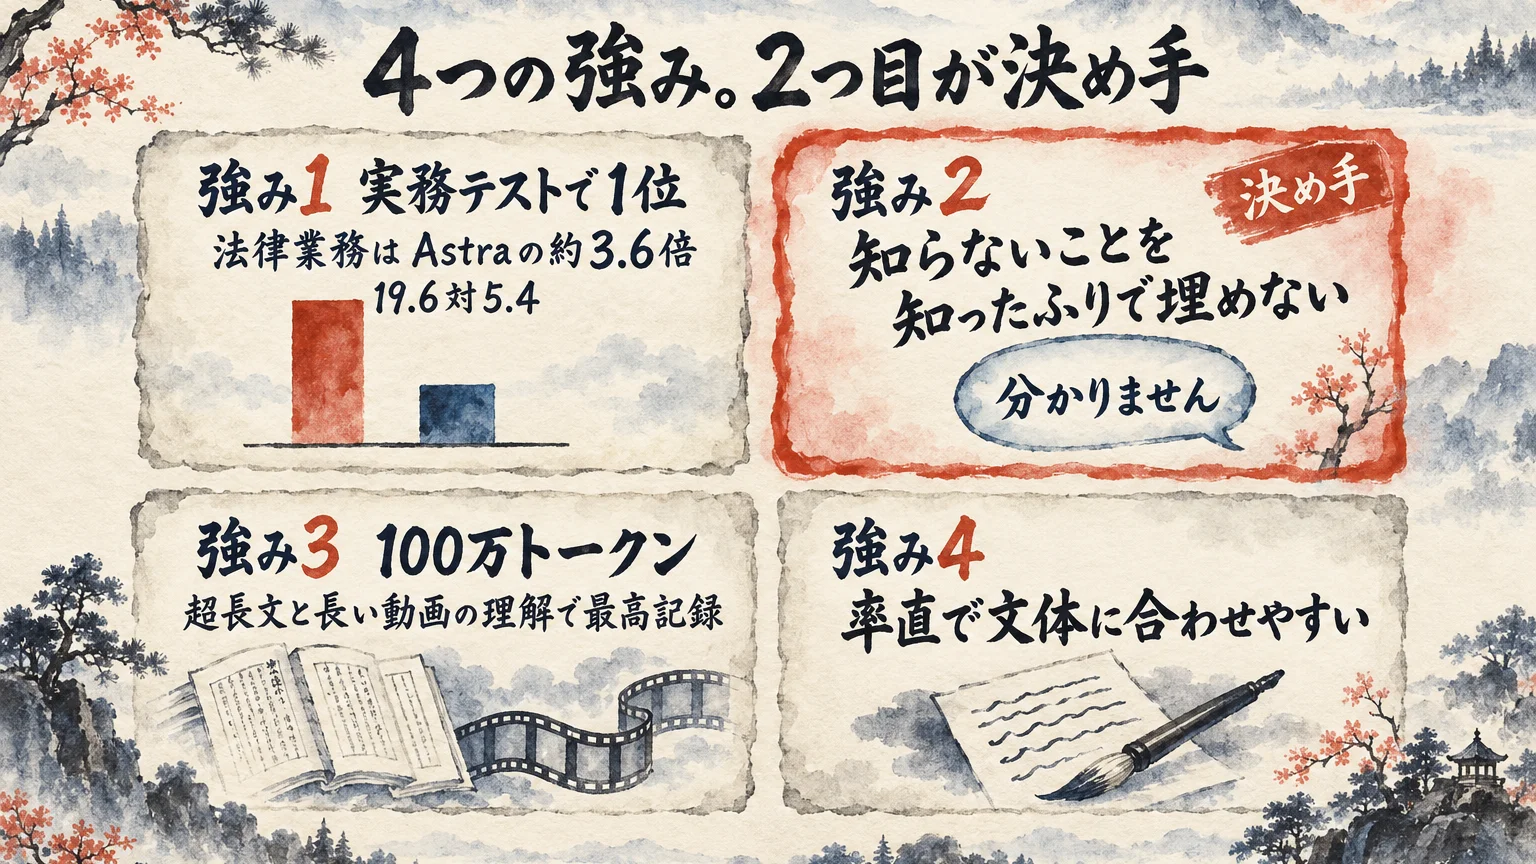
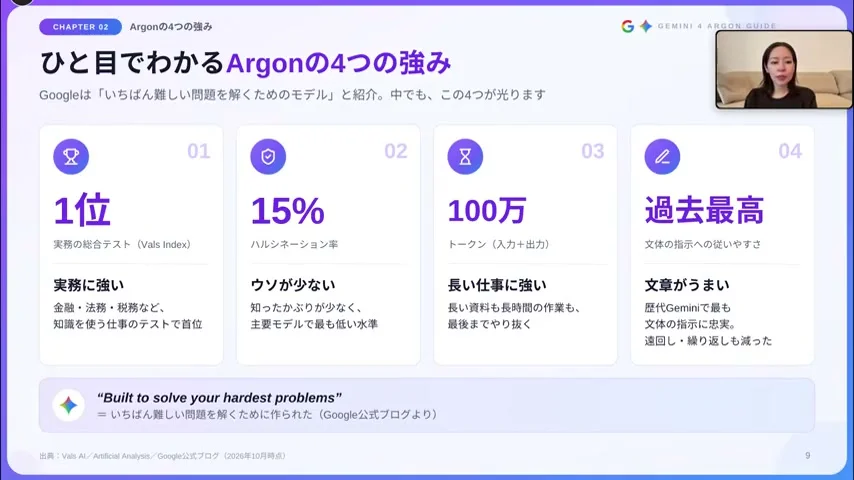
第2章は4:20から6:29までです。みきさんはArgonの強みを4つ挙げます。目立つのは、実務テストの数字です。ただ、記事や資料を任せる側として見逃せないのは2つ目です。知らないことの扱いです。
強み1は4:27からです。みきさんは、金融や法務のような実務のテストで1位だと伝えます。スライドの棒グラフでは、AstraやOpus 5.5より高い結果です。法律業務は特に高く、Astraの約3.6倍(19.6対5.4)です。
強み2は5:15からです。みきさんは、Argonは嘘が少ないと話します。知らないことを、知っているふりで埋めないという話です。
強み3は5:36からの100万トークンです。スライドでは、超長文の読解テスト(GraphWalks)と長い動画の理解テスト(LVBench)で最高記録です。強み4は6:20からです。回答が率直で、指定した文体にも合わせやすいと、みきさんは挙げます。
みきさん(動画の中で・5:15〜)
嘘が少ないという点です。[…]知らないことを知ったかぶりしてアウトプットを出すということね、結構あったりするんですが、知ったかぶりをしないというのがアルゴ[ン]の大きな特徴です。
5:15の「嘘が少ない」を、私は順位として受け取りません。分からないと言える性質として受け取ります。委ねるAIの最低条件は「わからないことは憶測しないできく。わかることは2度聞かない」です。
2026年5月7日に、AIニュース自動作成の裏取りを入れ替えました。それまでは、裏取りを固定で飛ばしていました。入れ替えた先は、検索つきのGeminiで「真・偽・不確か」を返し、独立した情報源3件を取る形でした。
私なら、記事1本の裏取りをAIに任せる前に、出口を先に置きます。「不確か」と返せる出口です。モデルの順位より、その出口があるかを先に見ます。
契約書の確認や公開前の記事のように、間違いが痛い作業があります。そういう作業ほど、4つの強みのうち2つ目から確かめてみてください。
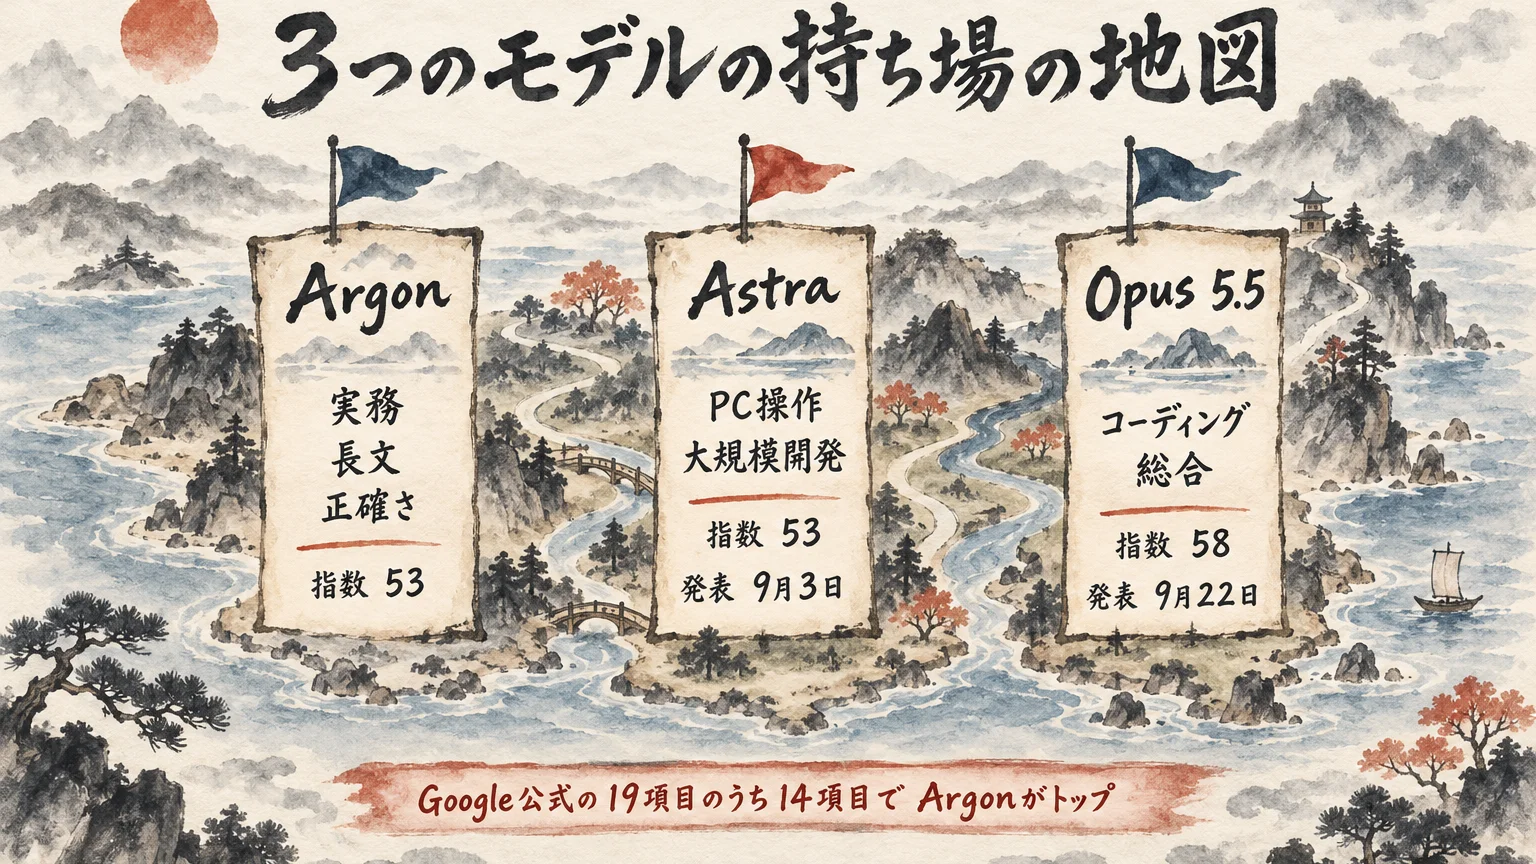
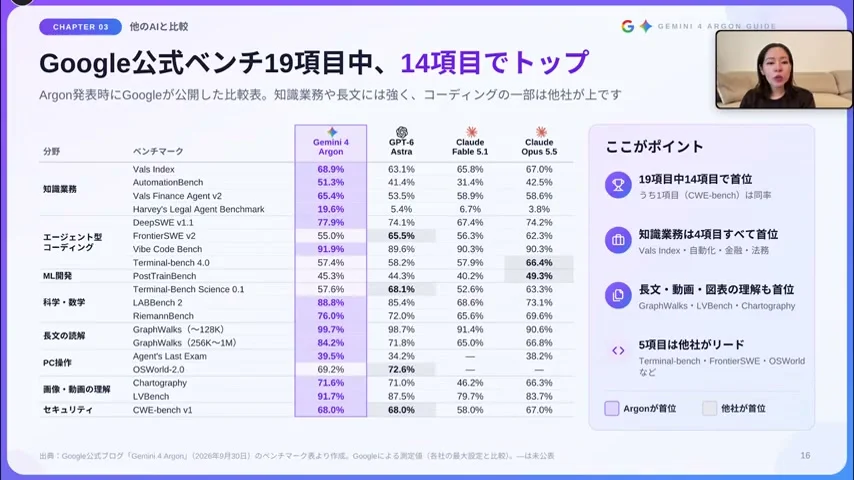
第3章は6:35から8:28までです。Argon、Astra、Opus 5.5の比較です。ここは順位表として読みません。どの作業に向くかの地図として読むと、自分の仕事に置き換えやすくなります。
6:35からみきさんは、総合的な力ではOpus 5.5が抜けて強いと話します。そのうえで、得意分野が少しずつ違うという整理です。
みきさんの整理では、Argonは実務・長文・正確さです。AstraはPC操作・大規模開発、Opus 5.5はコーディングと総合です。API料金はArgonが圧倒的に安いと、みきさんは述べます。
スライドでは、Artificial Analysisの指数がArgon 53、Astra 53、Opus 5.5 58です。発表日はAstraが9月3日、Opus 5.5が9月22日です。
7:52からのスライドでは、Google公式のベンチマーク19項目のうち、14項目でArgonがトップです(1項目は同率)。他社がリードする項目もあります。
みきさん(動画の中で・7:02〜)
総合力で見ていくとやはりクロードオーパス5.5かなり強いです。で、得意なところが若干異なります。
10月4日、勉強会のアンケート自由記入50件で試しました。AIに頼んで、小さい分類AIと大きい分類AIに1回ずつ分けさせたんです。応答時間はおよそ0.5秒と0.6秒でした。小さい分類AIが0.5秒、大きい分類AIが0.6秒です。私は投稿に「分類AI、clefのフラッシュ、鬼速い。」と書きました(普段は小さい分類AIのClef-flash、難問はJevと使い分けた、同じ50件の比較記事)。
10月6日は、勉強会アンケートの試験64件を、9Bと27Bに分けさせました。つまずきは52/64対23/64。次の一歩は45/64対51/64。質問によって、順位が入れ替わりました。
私なら、順位表の1位は探しません。アンケート分けや計算のように、作業ごとに持ち場を決めます。モデルは器です。主役は、中に入れる私の判断軸です。
5つのモデルを並べた別の人の比較もあります。書籍の原稿を5つのAIモデルに書かせ、14万文字から7万文字まで差が出た比較の解説記事も、地図の1枚になります。
毎週のアンケート50件を分けるなら、まず候補を決めます。候補は、6:35の得意分野の整理から2つ選びます。同じ50件で、1回ずつ比べてみてください。
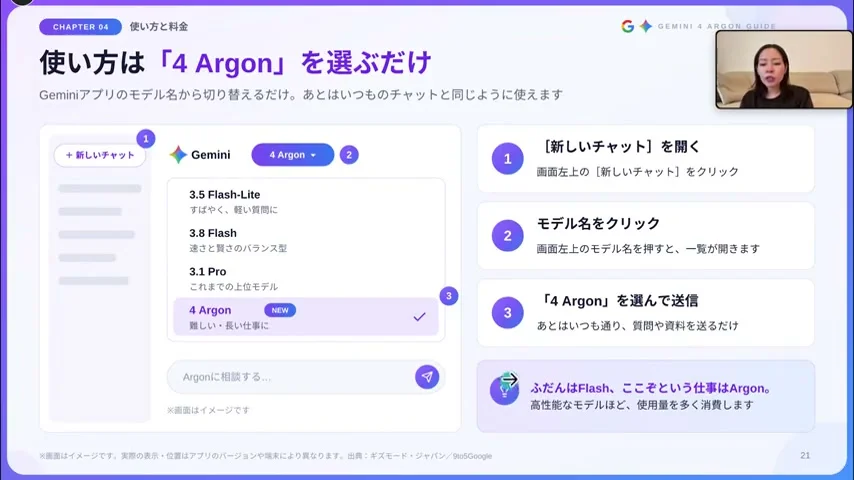
第4章は8:28から9:12まで、使い方と条件の話です。9:24から10:04には、実際の画面も映ります。みきさんの話と画面を合わせて、どこで選べて、いつ選ぶかを整理します。
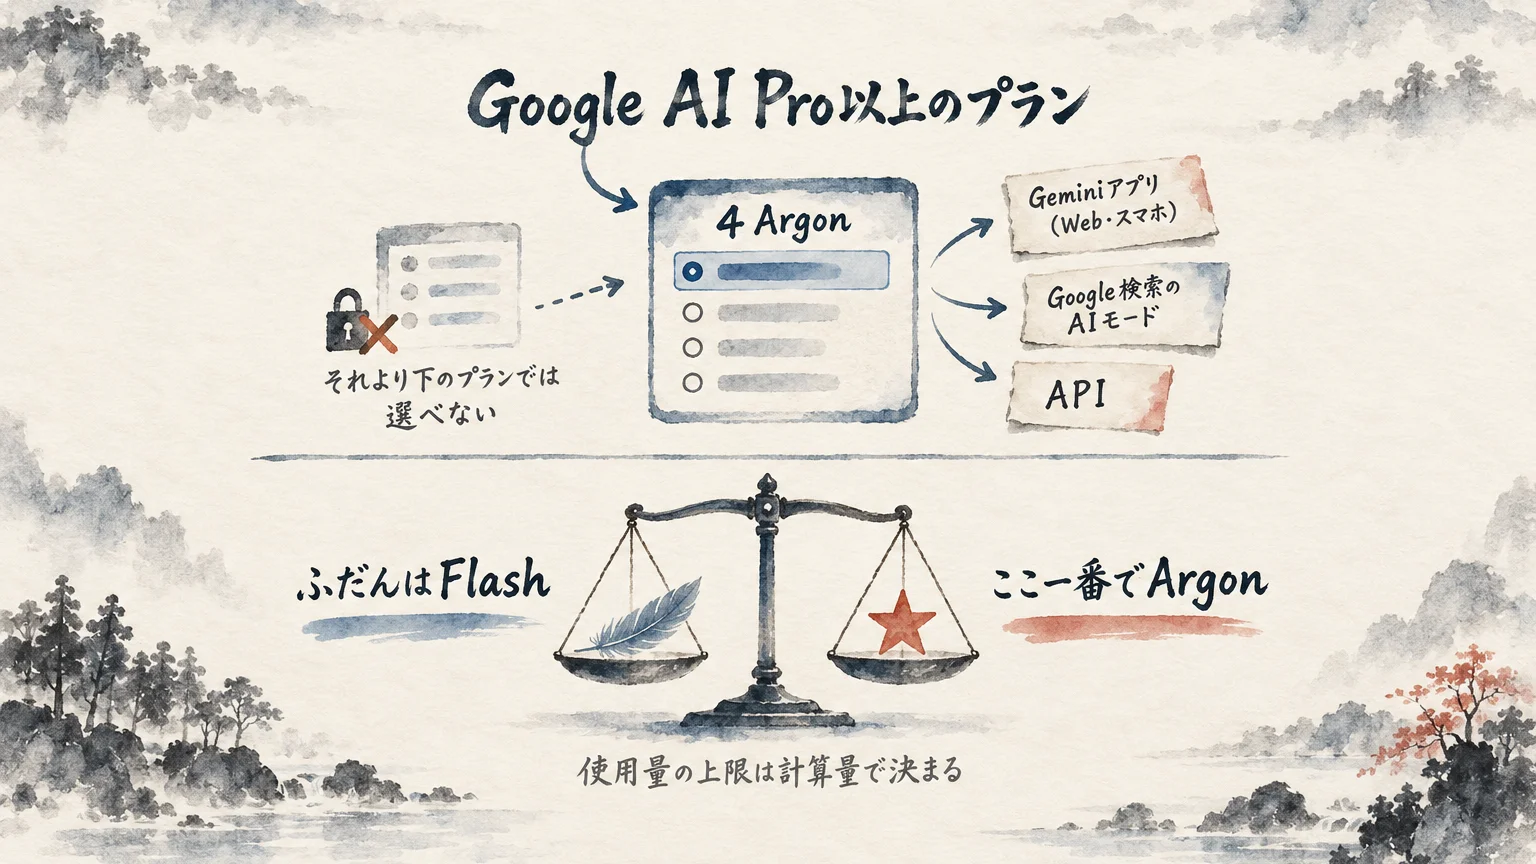
8:51でみきさんは、Geminiのチャット欄で「4 Argon」を選ぶだけだと案内します。スライドでは、Google AI Pro以上のプランで選べます。それより下のプランでは選べません。使える場所は、Geminiアプリ(Web・スマホ)、Google検索のAIモード、APIです。
使用量の上限は、回数ではなく計算量です。Argonは使用量が多くなります。そのため9:05でみきさんは、ふだんはFlash、ここ一番でArgonという分け方を勧めます。
9:24からの画面では、下のプランで上位モデルを選ぶと、アップグレードの表示が出ます。上のプランでは、モデル選択に「4 Argon」と3.1 Proが並びます。
みきさん(動画の中で・9:02〜)
普段の仕事はフラッシュを使ってここぞという時はアルゴンを選ぶと、ま、このような使い分けがおすす[め]です。
10月13日の点検時点で、私の環境は作業ごとに既定のモデルを決めてありました。Claudeはclaude-opus-5-5です。Codexはgpt-6.1-sol、Grokはgrok-4.7です。
最上位モデルの使いどころは、最上位モデルを「ここぞの一皿」に使う、GPT-5.4-Proのeffort比較データの記事にも書きました。2026年3月9日の記事です。モデル名は古くなっています。
私なら、毎日の作業は軽いモデルに任せます。ここぞの時だけ、最上位を選びます。自動化できることは自動化し、どれを選ぶかの手間は人が持ちます。
毎朝のメール下書きは、軽いモデルで足りる。月に一度の事業計画の見直しは、最上位。そう分けてみてください。人間にしかできない判断に集中できます。
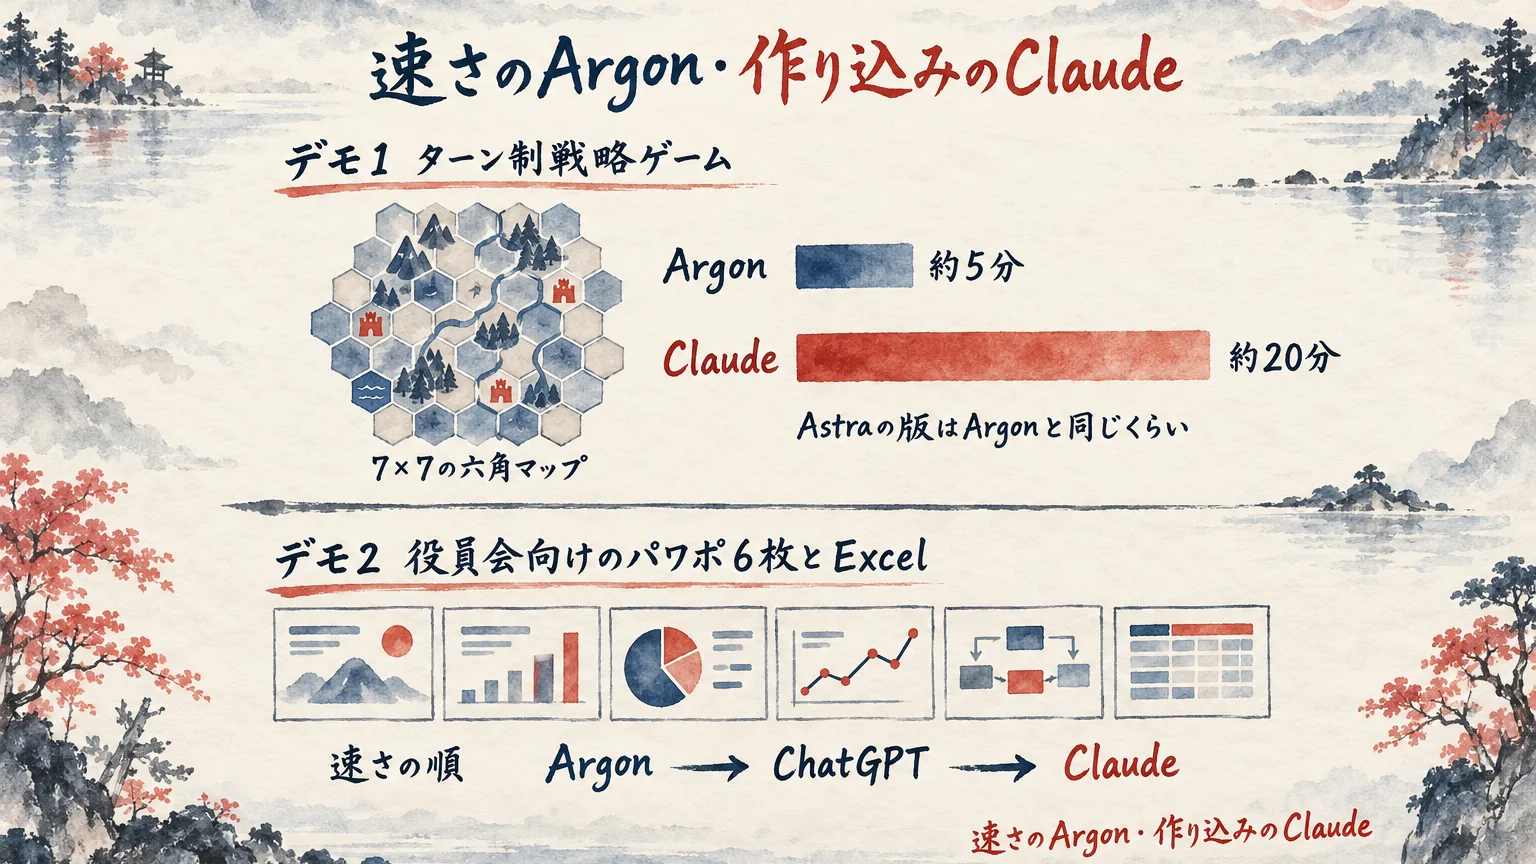
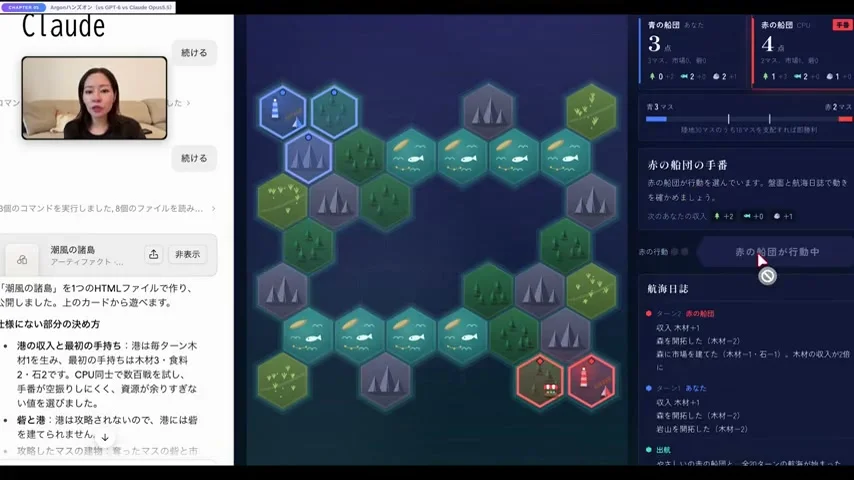
第5章は10:06から17:05まで、実際に作らせるハンズオンです。同じ依頼を、ArgonとAstraとClaudeに出しています。速さと作り込みの差が、画面ではっきり見えます。
10:06からのデモ1は、1つのHTMLで遊べるターン制戦略ゲーム「潮風の諸島」です。7×7の六角マップで、CPUと対戦します。みきさんは同じプロンプトで、ArgonとAstraとClaudeに作らせます。Argonは約5分です。Claudeは細かく作り込んで、約20分でした。
12:42でみきさんは、仕上がりの細かさはClaude、出てくる早さはArgonと整理します。Astraの版は、Argonと同じくらいです。総合はClaudeが1番で、GPT-6とArgonが並ぶと言います。
13:46からのデモ2は、パワポとExcelです。Googleドライブのデータから役員会向けのパワポ6枚とExcelを作り、ドライブに格納させます。みきさんの評価では、Argonは速く、グラフや配色も少し手を入れれば仕事に出せる水準です。Claudeはやや丁寧です。速さはArgon、ChatGPT、Claudeの順で、GPT-6のスライドは微妙だと、みきさんは言います。
16:41からのまとめで、みきさんは、置いていかれていたGeminiが大きく追いついたと話します。追いついた相手は、ChatGPTやClaudeです。早く出したい時や、たたき台に向くという話です。
みきさん(動画の中で・10:47〜)
約5分ぐらいで作成をすることができました。やはりスピードが早いというのがジェミニ[の]持ち味です。
みきさん(動画の中で・12:42〜)
やっぱクロードの方がいいかなという感じはしているんですが、スピードという観点で見ていくとジェミニ4アルゴンかなりいいんじゃないかなと思います。
みきさん(動画の中で・15:12〜)
あ、いいですね。パワポ資料かなり良くなりました。あ、これぐらいのクオリティであればもう実務でちょこちょこっと編集して使用できるレベルです。
みきさん(動画の中で・16:55〜)
チャットGPTとクロードとの差がグっと縮まりました。で、スピードが早いので早くアウトプットを出したい時や一時[たたき台]を作りたい時なんかに便利です。
10月12〜13日、会議中に小窓で答える自作ツールで試しました。「何て言う?」を1回ずつ聞いた結果です。最初の字が出るまでは、手元の12Bが約1.2〜1.9秒でした。Claude Sonnetが4.4秒、Codexが18秒(一括)です。
ただ12Bは、年額を月あたりに割る計算で外しました。正しい額より小さい額を返したんです。だから大事な計算はClaudeを選ぶ、と記録に書きました。
動画の約5分と約20分は、作り終えるまでの差です。私の約1.2〜1.9秒・4.4秒・18秒は、最初の字が出るまでの差です。同じ速さでも、場面が違います。
私なら、たたき台は速いモデルで60点を出します。仕上げと大事な計算は、作り込むモデルに回します。100点を目指して0点より、60点でも出す。これが私の基準です。
毎週の会議資料6枚なら、まず速いモデルで骨組みを出します。数字の入るページだけ、作り込むモデルに回してみてください。
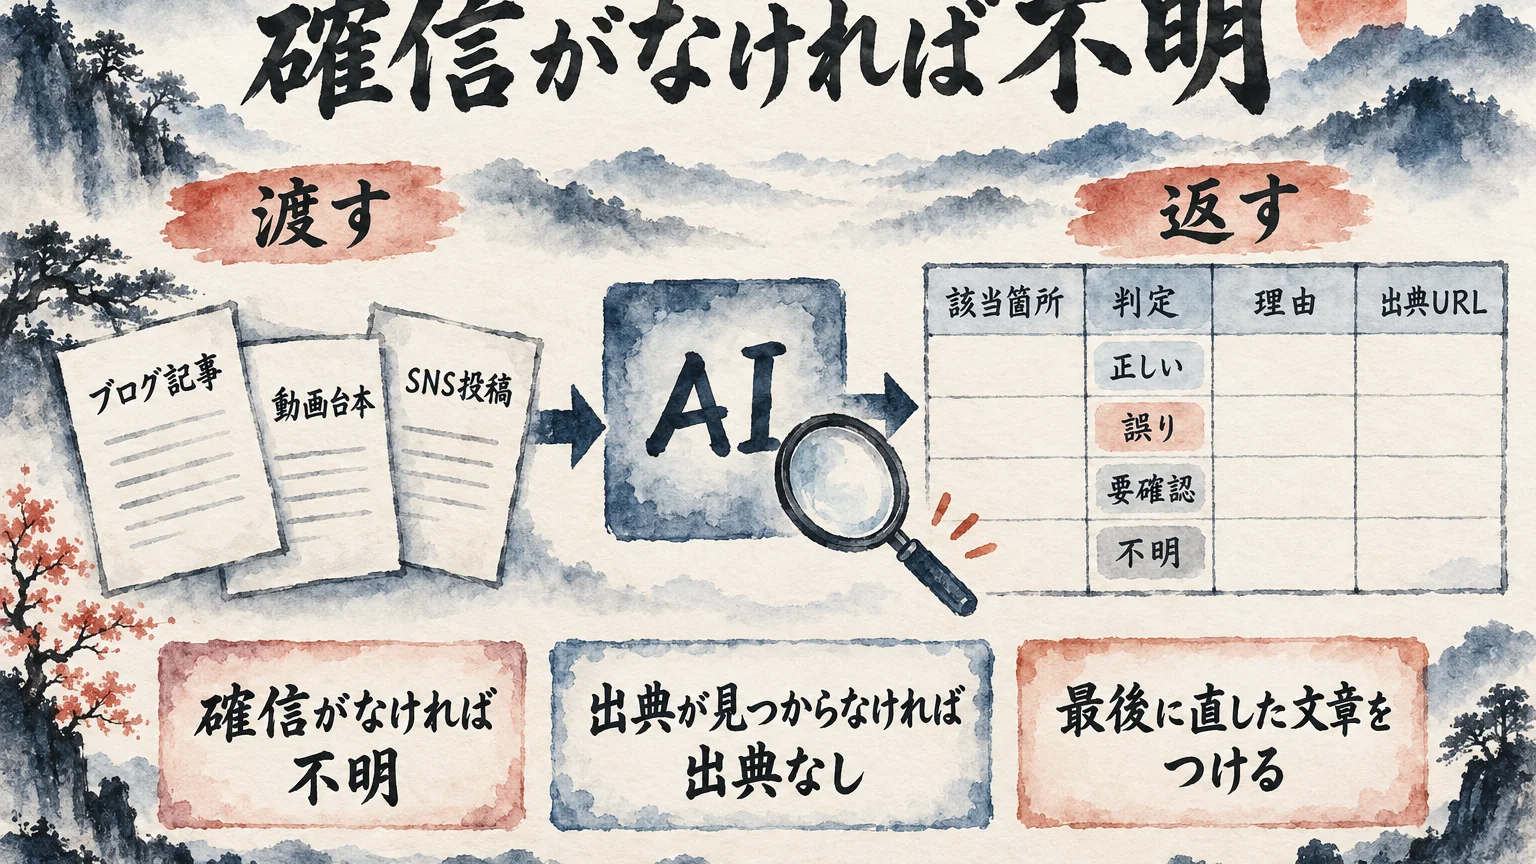
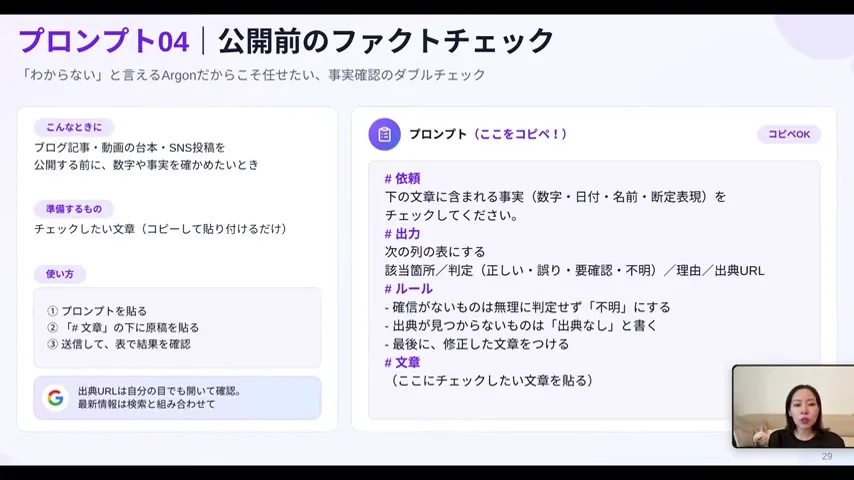
第6章は17:11から19:00までです。実践プロンプト10選から、2つの紹介です。記事や投稿を出すたびに通る、公開前の確認の話です。手元の裏取りの測定と並べて読みます。
17:11からみきさんは、2つのプロンプトを紹介します。1つは、立場を指定して注意点を洗い出す契約書・利用規約チェックです。もう1つが、公開前のファクトチェックです。
スライドのファクトチェックのプロンプトは、ブログ記事・動画台本・SNS投稿などを渡す形です。返させるのは、該当箇所、判定(正しい・誤り・要確認・不明)、理由、出典URLです。
スライドのルールでは、確信がないものは無理に判定せず「不明」と書きます。出典が見つからないものは「出典なし」と書きます。そして最後に、直した文章をつけます。18:19でみきさんは、事実確認の二重チェックこそ、分からないと言えるArgonに預けたいと話します。
みきさん(動画の中で・18:17〜)
公開前のファクトチェックに使えるプロンプトもご紹介していきます。分からないと言えるアルゴンだからこそ任せたい事実確認のダブルチェックです。
10月9日、字幕に5つの文が合うかの裏取りを試しました。AIに頼んで、Haiku 5.5とSonnet 5.5に1回ずつ任せたんです。所要は26.5秒と17.0秒、トークンは167,879と164,147でした(Haiku 5.5に裏取りを任せ、Sonnet 5.5と時間・トークン・間違いを並べた下ごしらえの記事)。
みきさんのプロンプトの「不明」は、10月9日の測定で置いた「書かれていない」と同じ向きの出口です。その選択肢を置いた問いは、字幕の範囲で正しく返りました。
私なら、公開前の記事1本の判定は、「不明」を返した件の中身から読みます。「正しい」の数は後です。わからないことは憶測しないできく。わかることは2度聞かない。
10月9日は、5問の判定が2つとも同じでした。2つとも、同じ1問を字幕の崩れで外しました。確かめるのは任せたAIと、最後に私の目です。
公開前の記事を1本確かめる時は、AIに頼んで下書きを判定させます。「不明」と「出典なし」の行から読んでみてください。
COLUMN
AIが外した場面を一行ずつ残す
10月12日から13日にかけて、会議中に小窓で答えを返す自作ツールを試していました。年額を月あたりに割る問いを、手元の12Bモデルに投げた時のことです。返ってきたのは、正しい答えより小さな数字でした。最初の字は速く出る。でも、肝心の割り算がずれている。だから、大事な計算はClaudeを選ぶ、と記録に書きました。
ここで、小さいモデルは駄目だと決めるのは早いかなって思います。10月9日、字幕に5つの文が合うかの裏取りを、AIに頼んで2つのモデルに1回ずつ任せました。2つとも、同じ1問で違うと判定しました。後で突き合わせると、日本語字幕の文字が崩れていて、字幕だけでは正しく読めない問いでした。外した原因は、モデルの強さではなく、読ませた材料のほう。10月6日のアンケート64件でも、質問によって2つのモデルの順位が入れ替わりました。外し方は、作業と材料で変わるんです。
私なら、新しいモデルが出た週こそ、順位表より先にこの記録を開きます。一行に置くのは3つ。いつ、どの作業で、どう外したか。そこに、原因がモデルなのか、渡した材料なのかを1語で添えます。月割りの計算はモデル側。字幕の裏取りは材料側。材料側なら、モデルを替える前に材料を直す。モデル側なら、その作業だけ新しいモデルに1回やらせて、前の一行と並べます。
たまってくると、どの作業をどのモデルに任せるかが、順位表ではなく自分の記録から決まります。仕上げの確認は、自分の目に残しておきます。新しいモデルの名前が増えても、外した一行は次の選び方を教えてくれます。
AIに任せて転びながら学んだことの全体は、分身AIと歩んだ100日──AIに任せて転びながら学んだことの全まとめで読めます。
分身AIについてもっと知りたい方は分身AI.comもご覧ください。
Q. Argonはどこで選べますか?
A. 動画の8:51でみきさんは、Geminiのチャット欄で「4 Argon」を選ぶだけだと案内します。スライドでは、Google AI Pro以上のプランが条件です。それより下のプランでは選べません。Geminiアプリ(Web・スマホ)、Google検索のAIモード、APIでも使えます。
Q. AstraやClaudeより良いのですか?
A. みきさんは7:06で、総合力ではOpus 5.5がかなり強く、得意が違うと説明します。Argonは実務・長文・正確さ、AstraはPC操作・大規模開発です。Opus 5.5はコーディング・総合です。1位を探すより、自分の作業に合う持ち場で選ぶ。これが私の見方です。
Q. 100万トークンは何に使うものですか?
A. みきさんは2:00で、入出力あわせて最大100万トークンと示します。今回は出力も100万に広がった、という話です。スライドでは、超長文の読解テストと長い動画の理解テストで最高記録です。コーディング・金融・法務・科学のような、複雑で長い仕事向けと紹介されています。
Q. 公開前の確認にどう使うのですか?
A. みきさんのプロンプトでは、記事や台本を渡し、該当箇所・判定・理由・出典URLを返させます。確信がないものは「不明」、出典がないものは「出典なし」と書かせます。10月9日の私の測定では、2つのモデルが字幕の崩れで同じ1問を外しました。だから最後に、人の目で確かめる所を残します。
21分48秒の動画を通して見えたのは、Argonの持ち場でした。1位かどうかより、実務・長文・正確さという持ち場がはっきりしました。
6章で持ち帰れることを並べます。強みは4つです。使えるのはGoogle AI Pro以上のプランです。比較では得意が分かれます。ふだんはFlash、ここぞでArgon。デモは速さと作り込み。事実確認は「不明」の出口です。
モデルが毎週替わっても、判断は手元に残せます。その見方は、モデルは毎週替わった。判断は手元に残した、と整理した月刊GPTs研究会 2026年9月号でも同じです。
2026年7月19日の私の言葉は「AIのモデルに縛られない事について発信したいね。」です。最新のモデルが毎週出ても、モデルは器です。主役は、中に入れる私の判断軸です。
関連記事
同じArgonのニュースを、Googleの発表値と外部のランキングに分けて読み解いた10月14日号の解説
アンケート自由記入50件を小さい分類AIと大きい分類AIで分け、速さと正解数を並べた比較
5つのAIモデルが書いた書籍原稿の長さが、14万文字から7万文字まで開いた比較動画の解説
毎週替わるモデルに振り回されず、判断を手元に残す考え方をまとめた月刊GPTs研究会9月号
最上位モデルを大事な場面に絞って使う考え方を、GPT-5.4-Proのeffort比較で示した3月の記事
字幕の裏取りをHaiku 5.5とSonnet 5.5に任せ、時間とトークンと外した問いを並べた記事
参考リンク
今回紹介した動画本編。時刻つきの発言は、ここで確かめられる
今回紹介した動画
| チャンネル | mikimiki web スクール |
| 公開日 | 2026年10月14日 |
| 長さ | 21分48秒(日本語) |
| URL | https://www.youtube.com/watch?v=Nz9aZK64V_A |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!