WATCH REPORT
Gemini 4 Neon は迷ったら Hydrogen から。公式ベンチ19行中9行は Google の自己計測
2026.11.19
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル『まさおAIじっくり解説ch』で、まさおさんが Gemini 4 Neon を解説する日本語の動画を紹介するね。
新しいモデルが出た日の紹介に、ベンチ最上級と中堅が同じ顔で並びます。Gemini 4 Neon の話を、自分の仕事に入れていいか迷っている一人社長や発信者に向けて書きました。
数字を見るほど、公式ベンチの最上位と、まさおさんが自分で試した動画分析では Hydrogen で足りた、という話が両方出てきて、判断が止まる。
まさおAIじっくり解説chのまさおさんが、Gemini 4 Neon を、公式の資料・自作の実験・エフォート別の比較・25問のデモで見ていく約58分の日本語の動画です。読み上げは、出張のため本人の声から作ったAI音声だと、動画の中で話されます。
まさおさんの解説で、位置づけから25問のデモまで、動画の順に5章で追い、各章に私の読みを重ねます。数字は、画面に出たものと動画の話のままです。読み終えると、新しいモデルの数字を見て、持ち場を自分の仕事の大きさで決める手がかりが持てます!
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)
新しいモデルが出た日に決めるのは、順位より、使い分けの表のどこへ置くかです。自分の仕事の表に、Neon を置く場所はありますか?動画は、Hydrogen と Carbon の間の4つ目、という置き場所から始まります。
Neon は、アメリカ時間11月18日に発表された Gemini 4 の4つ目のモデルで、Carbon を元に作られた。約5週間で4つ出た流れを、まさおさんが紹介します。
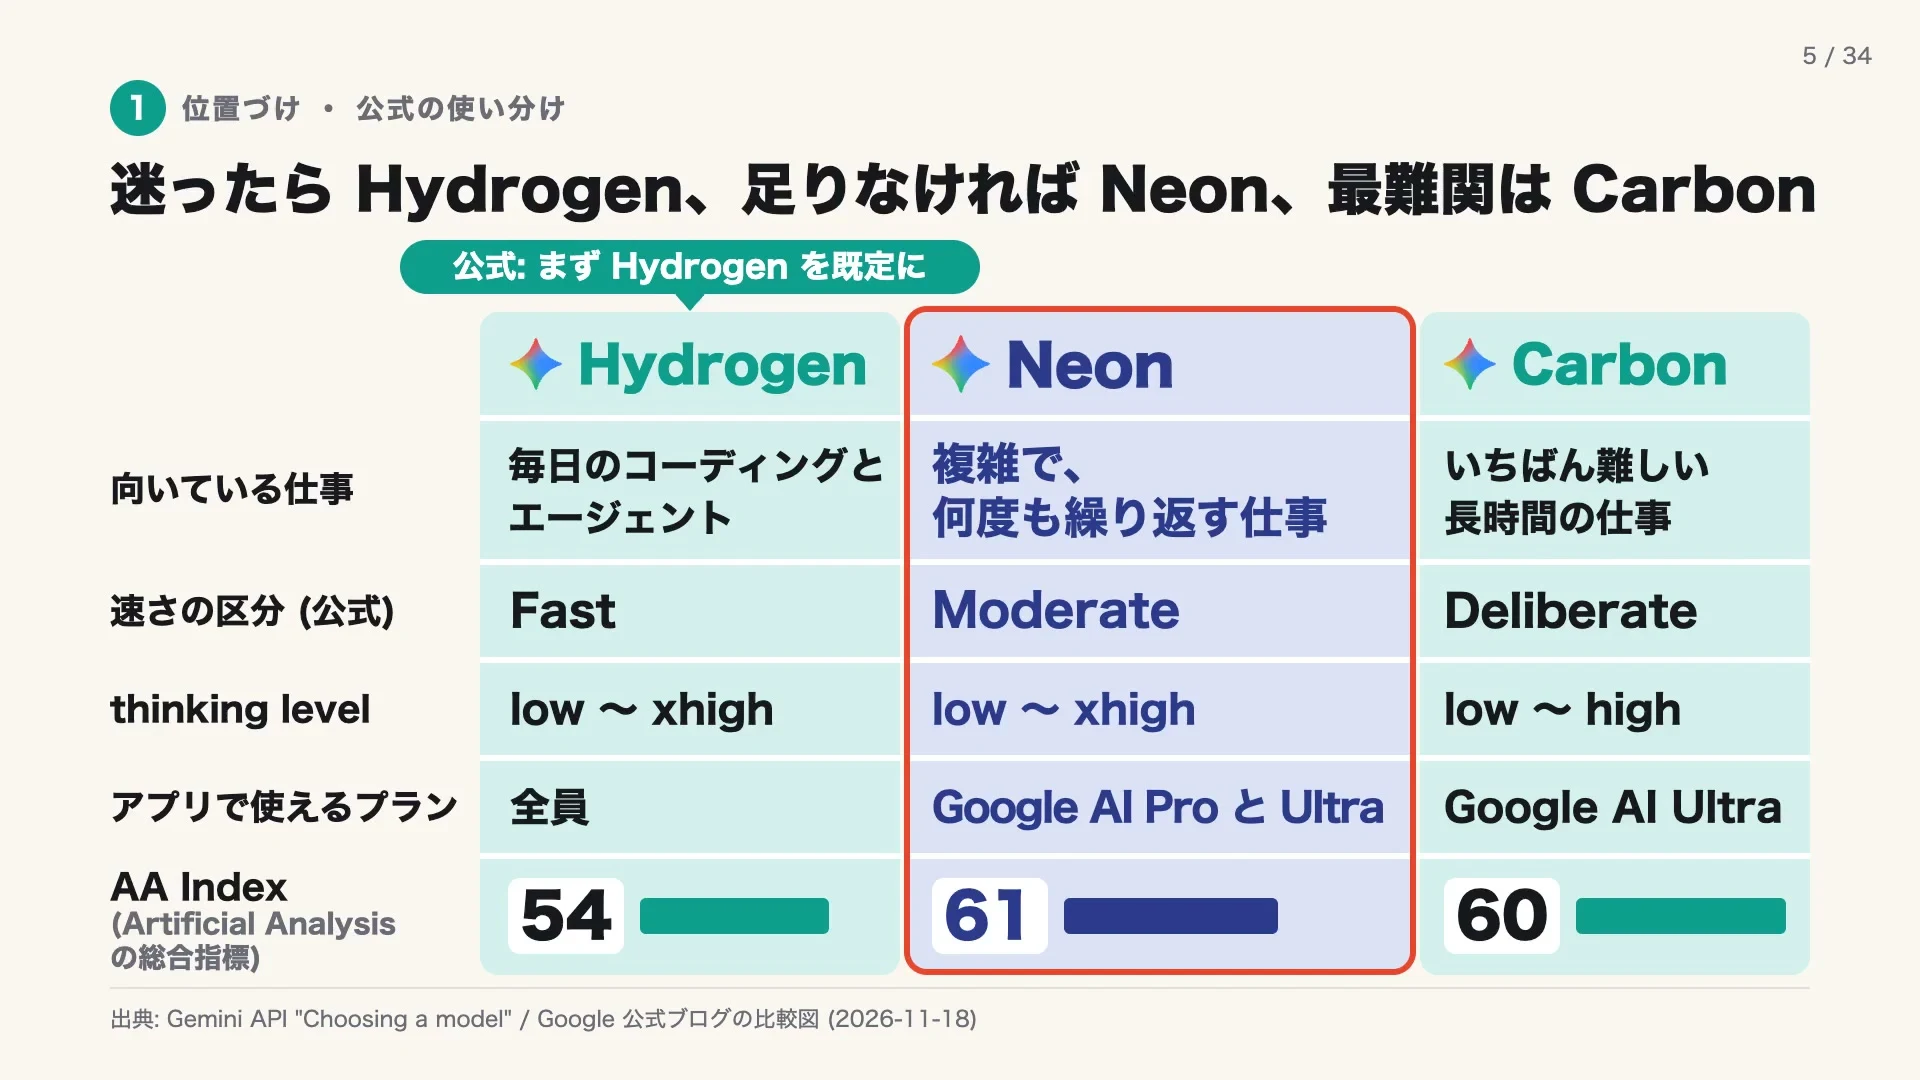
画面のスライドでは、速くて安い Hydrogen と、深く考えて重い Carbon の間に Neon が立ちます。速さの区分は、Hydrogen が Fast、Neon が Moderate、Carbon が Deliberate、と話します。
まさおさん(動画の中で・2:56〜)
迷ったらハイドロジェン、足りなければネオン。1番難しいところはカーボンみたいな使い分になっていて
迷ったらまず Hydrogen。足りなければ Neon。いちばん難しい所は Carbon、という使い分け。
Artificial Analysis の指数は、Neon(xhigh)が61、Carbon が60、Hydrogen が54。公式ブログの総合3位は設定違いをまとめた表の順位で、Neon のページ上は設定別で6位、と指摘します。
同じページには、中央値より遅く出力が多い、とも書かれている。
料金は Hydrogen の約2倍。12月から Carbon の単価が上がるので、まさおさんの計算では、Neon の単価は Carbon より約25%安くなる、と話します。
置き場所の話は、順位の話ではなく、どこから呼ぶかの話。呼ぶ順番が先に見えます!
私は、乗り換えそのものを主題にしません。モデルは器で、中身は自分の体験と判断軸だからです!
新しいモデルが出た時に何をしたかは、2026年10月31日の記事に残してあります。
私の記事より(Sol・Luna・Opus 5.5 の選び方を整理し、使い分けの見直しを書いた記事)
2026年9月30日から10月1日にかけて、私は、新しく出た Sol 6.1 を受けて、手元の Codex の標準を6.1の Sol に切り替えることに同意しました。あわせて、AIにモデルの使い分けをすべて見直させたところ、見落としていた設定が10件見つかり、直しました。
Neon を Hydrogen の次に呼ぶのは、乗り換えの前に、使い分けの表のどこへ置くかを決める話です。呼ぶ順番も、表の見直しの中で決まります!
手元の表に、空いている段はありますか?
数字は、何を測った数字かに分けて読みます。公式ベンチの表では、Neon が19行中16行で最上位。その中身を、まさおさんは、どこが誰の数字かで分けて見せます。
画面のスライドでは、比べる相手は Opus 5.5 と GPT-6.2 Sol の2つ。19行中16行で Neon が最高、3行は他のモデルに数値がない、と見せます。
負けた行は3つ。Terminal-bench 4.1 と FrontierCode 2.0 は Opus 5.5 に僅差で、Chartography は Sol が上。
まさおさん(動画の中で・13:31〜)
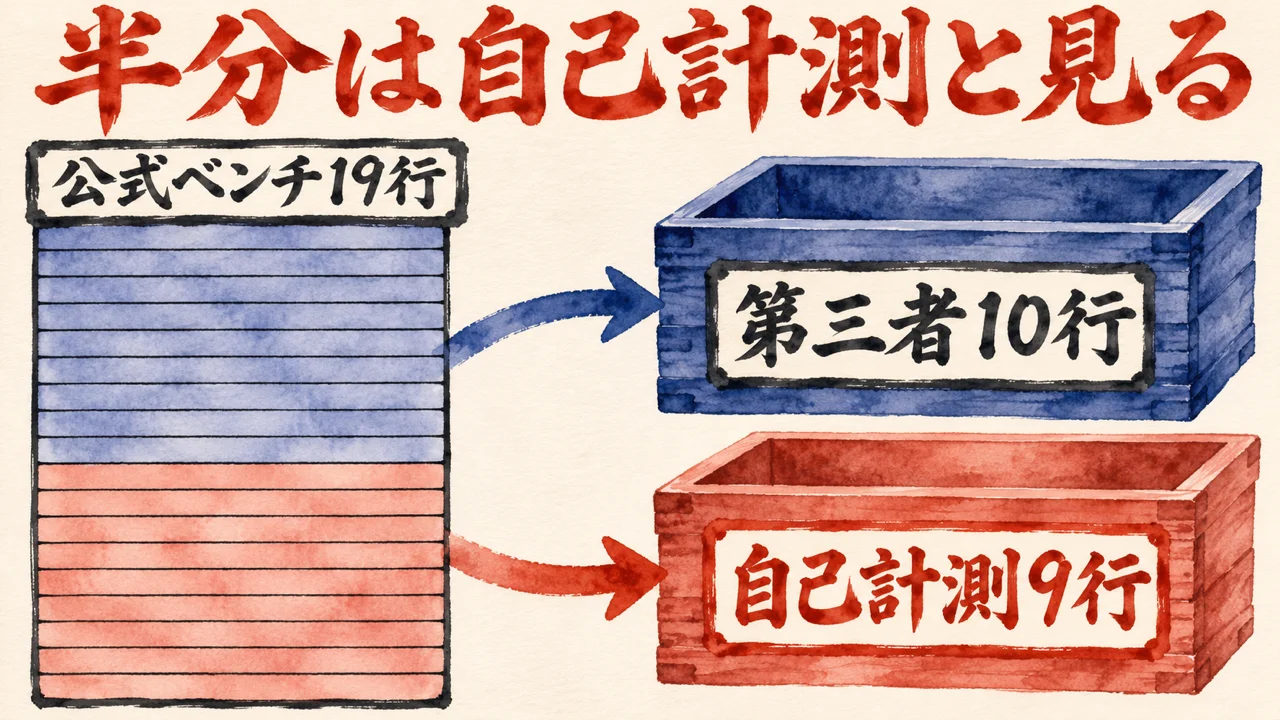
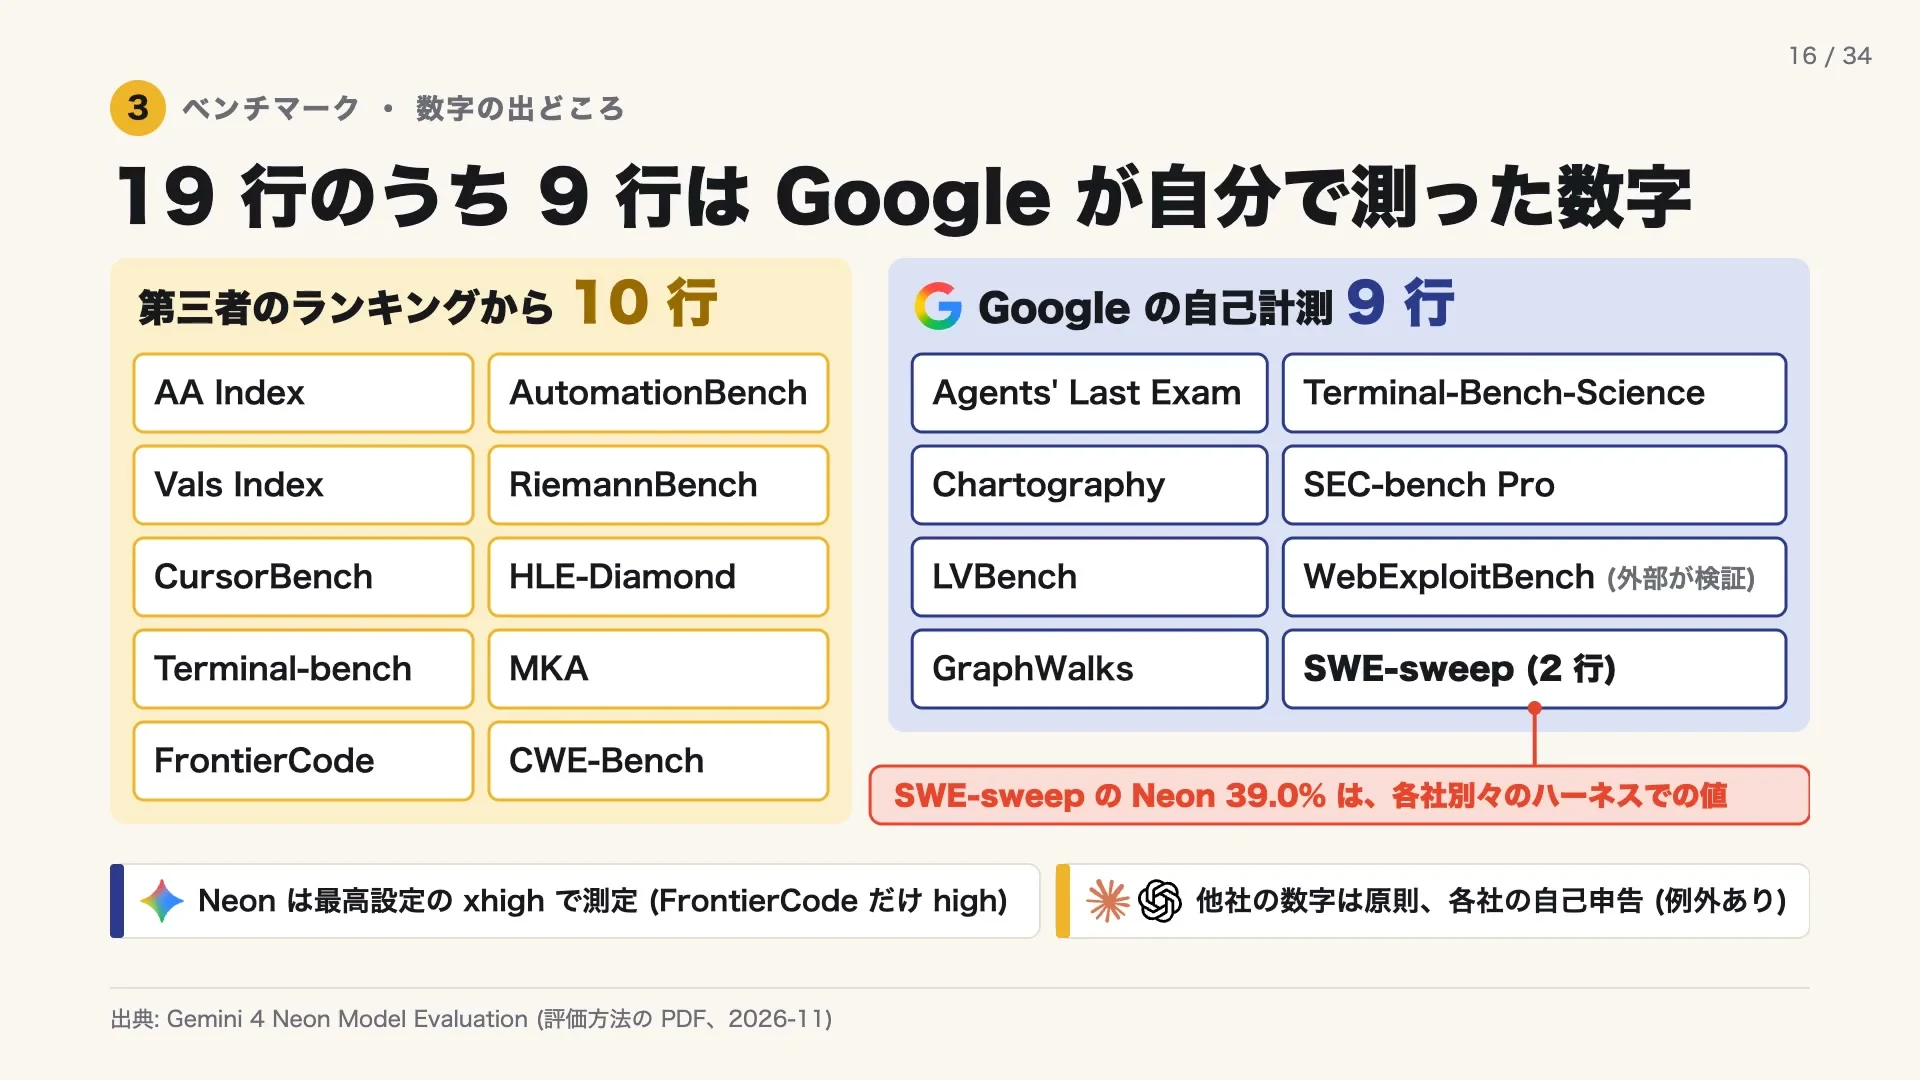
Googleが自分で図った数字が9行、半分ぐらいは自己計測なんですよ。ここは結構大事かなと思います。
19行のうち、第三者のランキングから取った数字が10行、Google が自分で測った数字が9行。半分ぐらいは自己計測、というのがまさおさんの指摘です。
まさおさんの説明では、SWE-sweep の Neon 39.0%は、各社が別々のハーネスで測った値です。ハーネスは、エージェントを動かす周りの仕組み。共通のものに揃えると12.8%まで下がります。
仕事・推論・長い文脈の行では、AutomationBench と GraphWalks で大きな差がつきます。長い文脈を食わせる使い方は強力そう、と、まさおさんは話します。
16行で最上位も、9行が自己計測も、どちらも同じ表の数字!
ここは賛成です。自己計測と第三者、各社別のハーネスと共通のハーネスを、動画が分けて見せているからです。事実と、まだ見えていない所を分ける手つきが、数字を読む土台です。
飯塚さんの動画では、10回以上やりとりすると9割以上が読み直しになる、と話されていました。その数字に、自分で測った1つの会話の数字を並べたのが、2026年10月29日の記事です。
私の記事より(Opus 5.5 の使い分けを整理し、自分で測った1つの会話の数字を添えた記事)
私の実測にも、近い数字があります。ある1つの会話では、API 呼び出し71回のうち、入力トークンの96.6%がキャッシュ読みでした。
あくまで1つの会話の数字。
私の数字も、1つの会話の数字と断って出しました。Google が測った9行も、各社別のハーネスの値も、断り書きの範囲で読みます。測っていない所は、使う側の仕事で確かめる所に残ります。
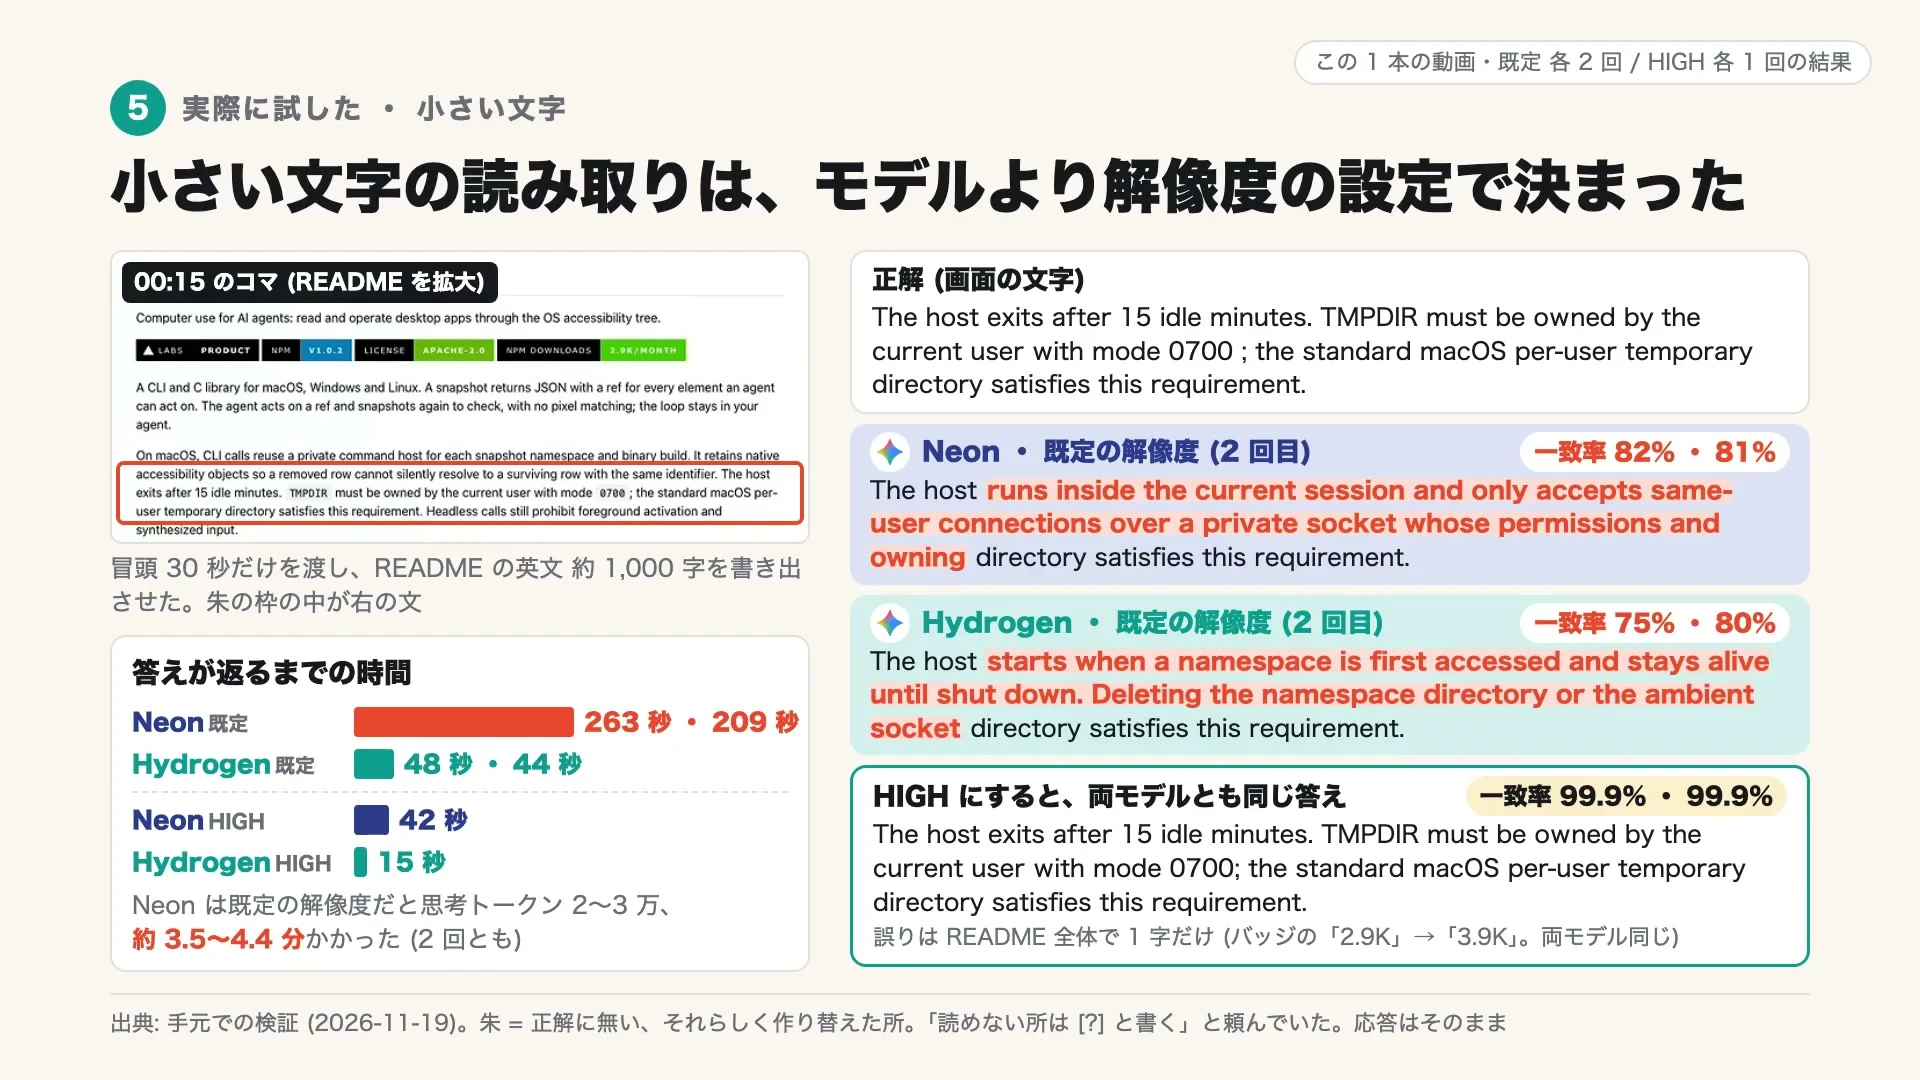
モデルを上げる前に、渡し方の設定を決める。その設定を決めるのは、人の仕事です。ここからは、まさおさん自身の実験で、8分弱の自作動画を Neon と Hydrogen にそのまま渡します。
実験は各1〜3回で、エフォート、つまり考える量の設定は既定の high。画面のスライドでは、動画分析の精度は互角で、Hydrogen は半分の費用で速い、と見せます。
スライドにはデモ動画23秒とあるのに実際は静止画のまま、という指摘を、Neon が拾った。まさおさんは、そう話します。
まさおさん(動画の中で・22:11〜)
ハイドロジェンで十分やったかなみたいな結果になりました。
動画分析は、この動画1本に関しては Hydrogen で十分だった、という結果だと、まさおさんは話します。
小さい文字の読み取りでは、解像度を指定しないと、Neon も Hydrogen も、読めない所をそれらしい文で埋めます。HIGH にすると、両方とも一致率99.9%。まさおさんは、モデルを上げるより解像度設定、と話します。
まさおさん(動画の中で・23:42〜)
気づかずにそのまま使うとやっぱちょっと怖いなと思います
気づかずにそのまま使うと、やはり怖い、とまさおさんは話します。
音声のみの実験では、製品名は両モデルとも正しく書けた。冒頭2分半の書き起こしは、2モデルの間で93%一致。時間と費用は Hydrogen の方が速くて安い。
動画自身が示す限界は、動画1本で話し手は1人、各1〜3回、エフォートは high のみ。言えるのは、この1本の動画までです。
モデルを替える前に、渡し方の設定が結果を動かした。
人は縦に掘り、AIは横に広げる、が私の見方です。解像度の設定を決めるのも、読めない所を埋めていないかを確かめるのも、人の仕事です!
まさおさんは、動画分析はこの1本では Hydrogen で足りた、と結びます。私は、その結果を自分の仕事の答えとして持ち帰らず、限界ごと、動画の話として読みます。動画が自分で限界を言うから、数字を信じ込まずに読めるんですよね!
手元の作業を1つ、同じ条件で回してみませんか。
小さい文字は、モデルより先に解像度!
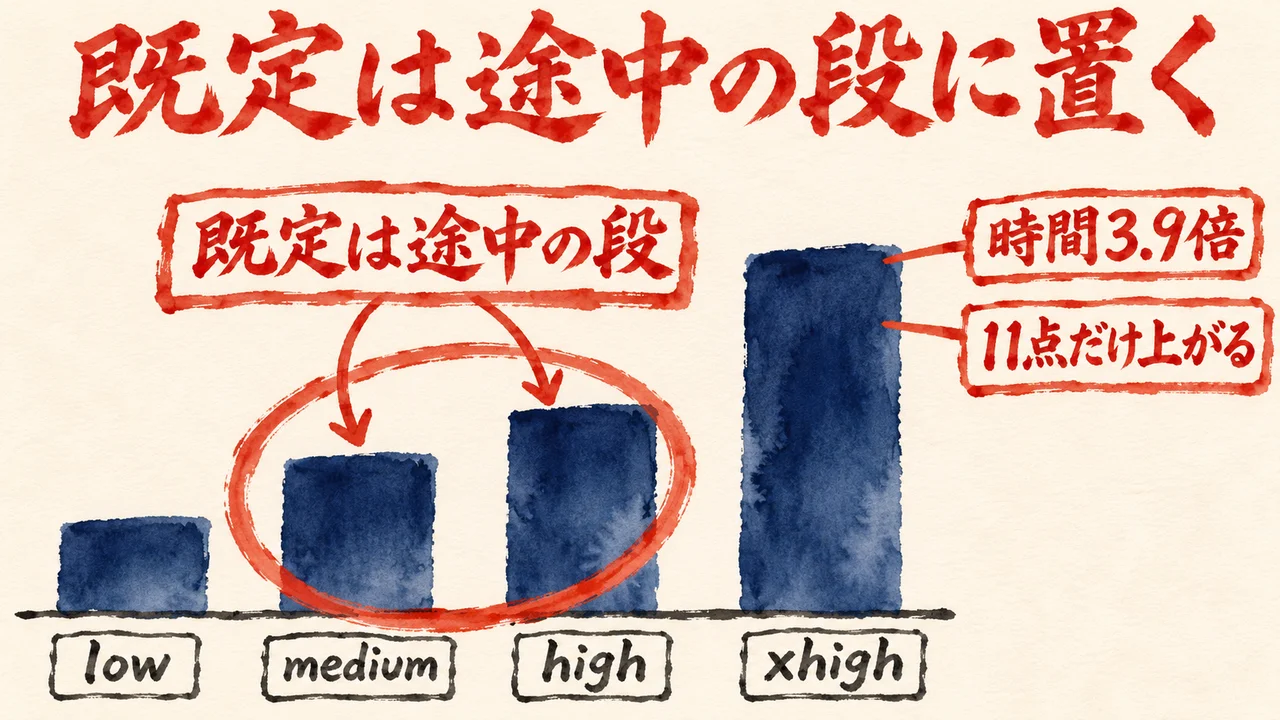
エフォートの既定は、途中の段に置く。上げるのは、必要な時だけ。段を上げると、結果はどれだけ良くなると思いますか?動画は、課題を3本用意して、4段で比べます。
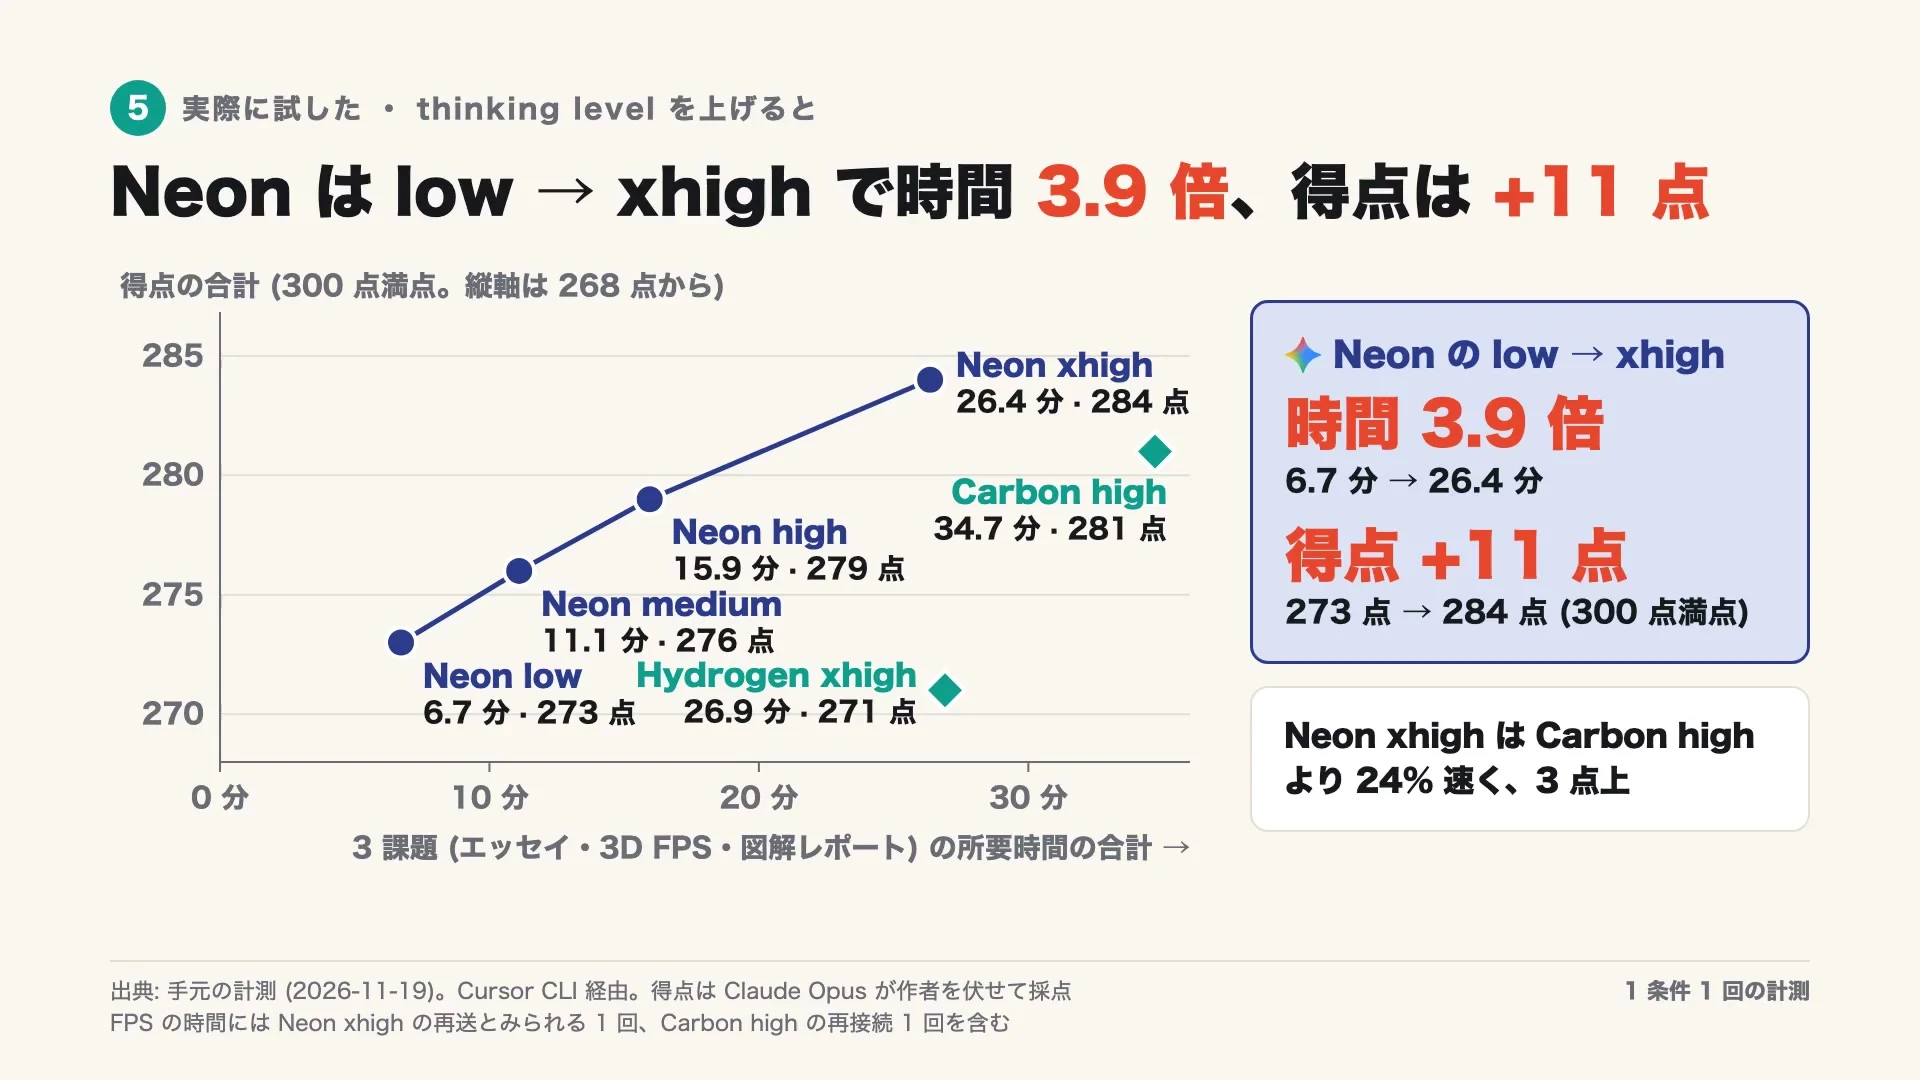
まさおさんは、Cursor CLI 経由で、エッセイや3D の FPS を含む3本の課題を、4段で回したと話します。Neon は、low から xhigh で時間が3.9倍。300点満点では、273点から284点でした。
画面のスライドでは、エッセイは low が約31秒で92点、xhigh が約199秒で95点。エッセイ・3D・図のレポートの3課題を合わせた合計では、xhigh は Carbon の high より24%速く、3点上です。ただし、どれも1回ずつなので数点の差は揺れの範囲かもしれない、ともまさおさんは断ります。
まさおさん(動画の中で・27:33〜)
ローからXで時間は4倍近くになってるのに点数はやっぱ300点満点で11点しか上がってないんですよ。
low から xhigh まで、時間は4倍近くに増える。それでも点は、300点満点で11点しか上がらない、と話します。
まさおさんの説明では、遅くなる理由は考えるトークンの量です。API を直接呼ぶ実験で、low が約2500、medium と high が約8500、xhigh が約2万5000。秒あたりのトークン数は横ばいだ、と画面のスライドが示します。
まさおさんは、公式の資料として、xhigh は簡単な抽出で考えすぎたり、出力の上限を使い切ることがある、という注意を紹介します。公式のグラフでは、点がほとんど上がらず、費用だけが増えます。
結論は、まず基本の high から。速さが欲しい所は low や medium もあり、xhigh は、ここぞという所だけだ、と話します。
段を上げるほど、伸びは小さくなる。時間の伸びに、点の伸びが追いつきません。
私が実際に設定を直した日の記録は、2026年10月18日の記事に残しています。
私の記事より(LLM格付けの動画を整理し、Opus 5.5 の既定の強さを直した記録を書いた記事)
9月24日の記録。私は、Opus 5.5 の既定の強さ(effort)を medium にそろえました。設定に effort が xhigh のまま残っていて、強さを決めずに起動した Claude は xhigh で動いていたからです。
…
私なら、いちばん上のモデルほど、既定は途中の強さにして、必要な時だけ上げます。
既定は途中の段に置いて、上げるのは必要な時だけ。強さを決めないまま、最上段で動かし続けない。
まず high から始めて、xhigh はここぞの時だけ。まさおさんの結論と、向きが同じです!
手元の次の作業で、段を上げる理由は言えますか?言えないなら、途中の段のまま回してみませんか!
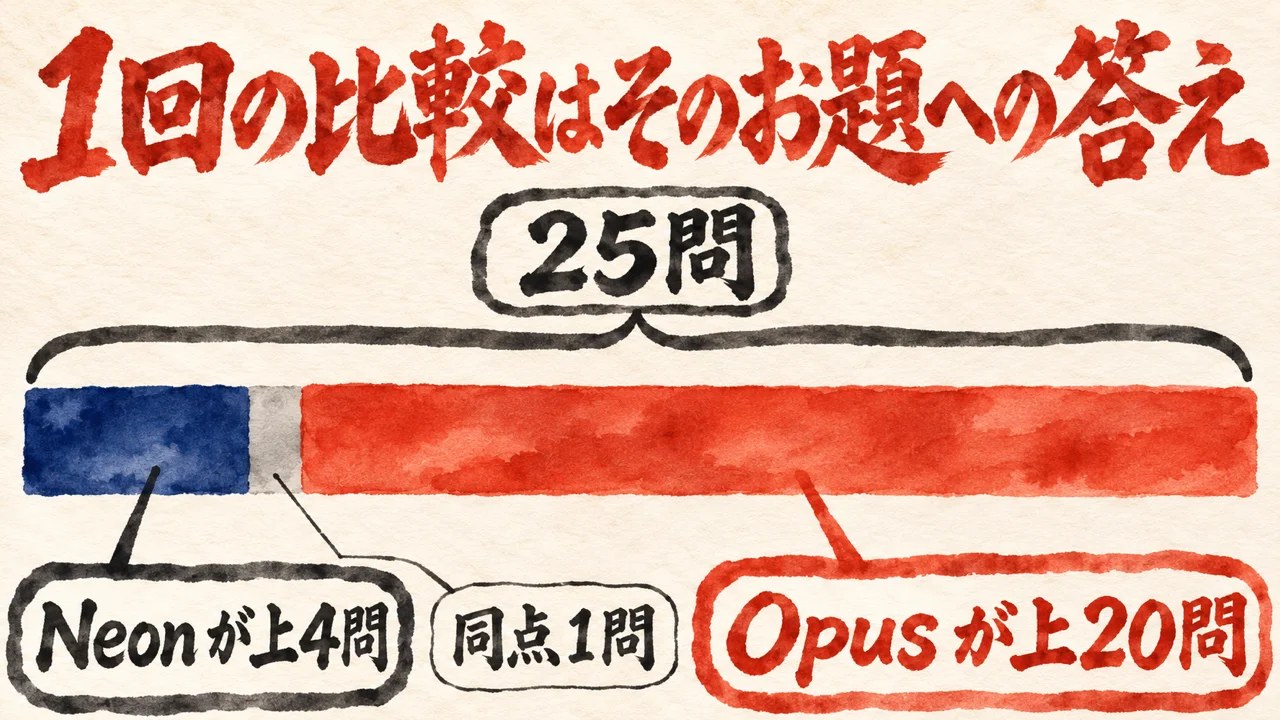
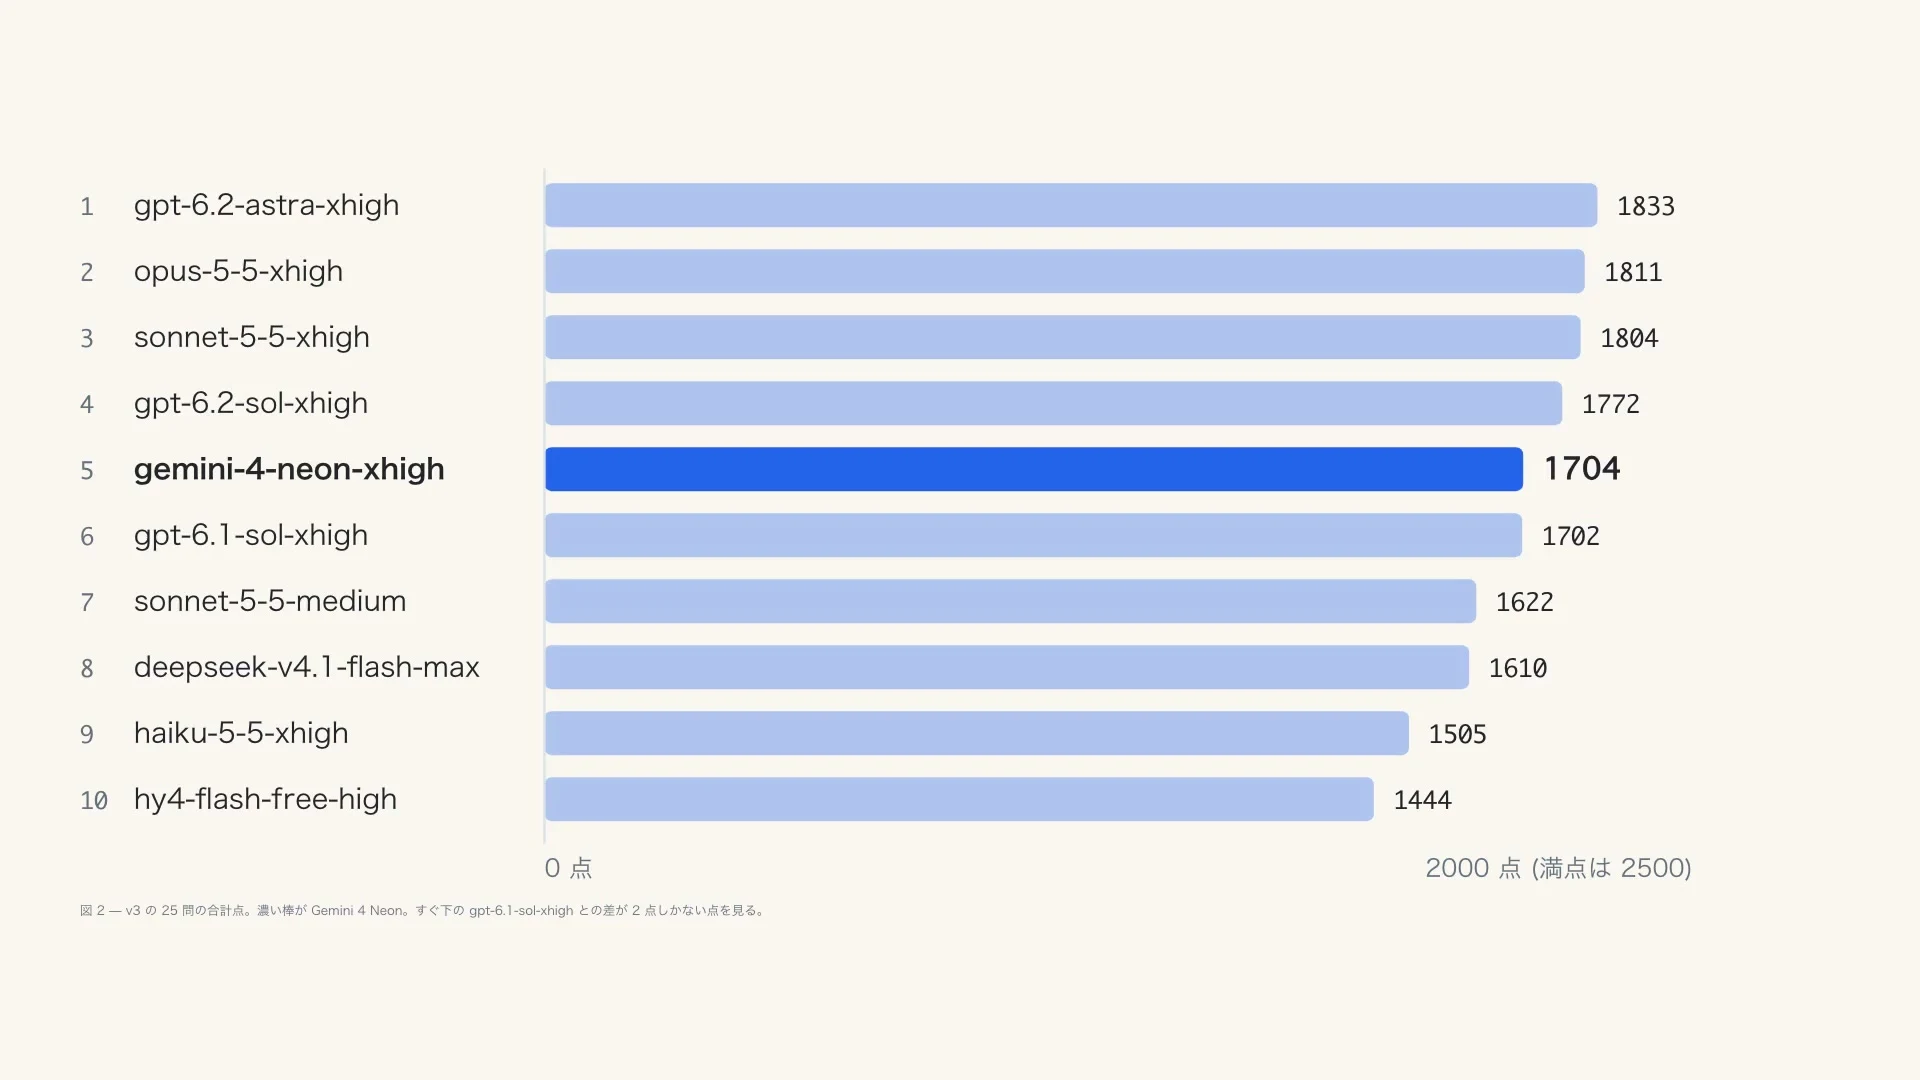
1回の比較は、そのお題への答え。動画の山場は、毎回同じ25問で10のモデルを比べるデモです。Neon は、10モデル中5位でした。
画面のスライドでは、Neon(xhigh)は1704点(2500点満点)で10モデル中5位。上位は GPT-6.2 Astra と Opus 5.5、その次に Sonnet 5.5 と GPT-6.2 Sol が続きます。動画は、2位の Opus 5.5 と左右で見比べます。
デモの Neon は、Cursor CLI 経由の xhigh です。点は、Opus 系の LLMジャッジ(AIに点を付けさせる評価)が1問1回で付けた評価で、モデルごとに使った CLI も違う。動画自身が、参考程度に見てほしいと断ります。
1問目は、ブラウザの中で動く小さな OS。左の Neon は、鮮やかな壁紙と、メモ帳やお絵描きなど7本のアプリが全部動く、見た目と量が強い。ただし再読み込みすると、Opus 5.5 は途中のマインスイーパーの盤まで戻るのに、Neon は状態が消えます。
3D アクションでは、どちらも5つのステージで景色がはっきり違います。差が出たのはカメラ。Neon はステージ2で茶色の板が画面の真ん中を横切り、主人公が見えなくなります。ステージ3では画面全体が一色に。カメラが飾りの中に入ってしまっている、とまさおさんは話します。
ゴブリンのゲームは、中身がどちらも全部そろいます。ただし Neon は、自分の手で遊び始めると画面が傾く。30秒ぐらい待ってから開始ボタンを押すと、上下逆さになります。見本のプレイは開始画面を飛ばすので、そちらでは出ません。
まさおさん(動画の中で・42:29〜)
いやこれはねさすがに遊べないなと思いました。
手で遊ぶと遊べない、と感じたそうです。右の Opus 5.5 は傾かず、普通に遊べる。25問の中で一番差がついたのが、ここです。
まさおさん(動画の中で・51:14〜)
ネオンが上やったのが4問、同じやったのが1問、オーパスが上やったのが20問でした。
点で並べると、Neon が上だったのは4問、同点が1問、Opus 5.5 が上だったのは20問。半分ぐらいは3点以内の差でした。
Hydrogen や Carbon とは、前の25問の似たお題と見比べます。点数そのものでは比べられません。Web の画面の組み立てや3D の光の感じは、Carbon 寄り。文章の組み立てと、ピンボールの物理の落ち着き方は、Hydrogen 寄りです。
まさおさん(動画の中で・56:39〜)
出力で見栄えがすごいっていうわけではないんですけど、スマートに抑えるところを抑えていて使いやすいモデルやなと感じています。
派手さで押す出力ではない。それでも、押さえるところを押さえていて使いやすい。これが、Neon への感想です。
20問負けも、5位も、1回ずつの比較の積み上げ!
私の線は、参考程度と動画が断る所までを、私も数字として読むことです。1問1回で、ジャッジは1つ。CLI はモデルごとに別々。動画が言う範囲を超えては決めつけません。
1回の比較をどう読むかは、2026年11月18日の記事で書きました。
私の記事より(Hy4 flash を Haiku 5.5 に並ぶかと、まさおさんの25課題で読んだ記事)
左右に並べた1回の比較は、そのお題への答え。
…
私なら、ゲームやプログラムの1回の負けで、事務の仕事まで外すことはしない。
25問の負けは、そのお題への答え。事務の仕事や文章の仕事まで外す理由には、動画の範囲ではなりません。
迷ったら Hydrogen、足りなければ Neon。この置き方も、持ち場を決める話です。順位表より先に、自分の仕事の大きさを見ます!
COLUMN
▲目次題材と原液は別物。使い方を決める判断軸は自分の側にある
魂磨きの記事に、AIが題材を私の原液と取り違えた日のことを書きました。AIは、ゲームの題材を私の原液だと思い込んで質問してきたんです。新しいモデルの数字を追う日にも、似た取り違えは起きていませんか?
私の記事より(魂磨きの記事・肉のハナマサを原液と取り違えた質問を訂正した節)
肉のハナマサは原液じゃないだろ
私は、その質問そのものを訂正しました。肉のハナマサは、ゲームの題材。私の価値観でも判断軸でもありません。数字を読む日にも、同じことが言えると私は思います。題材の話と、自分の判断軸の話は別です。
同じ日の記事では、続けて原液の中身を聞かれました。
私の記事より(魂磨きの記事・続けて原液の中身を聞かれて答えた節)
ストーリーや価値観、判断軸、在り方、why
原液の中身は、題材とは別物。引用に並ぶのは、ストーリーや価値観といった、自分の側にある言葉です。モデルは器で、主なのは中身の原液、つまり自分の体験と判断軸。その器より、まず中身を見ませんか?
どのモデルを使うかの前に、自分の側に何があるか。手元の原液を、一度言葉にしてみませんか?その答えが、持ち場を決める土台になります。
魂磨きの記事で、題材と原液を分けた日のことを書いています。
魂磨きの記事:「委ねるOSのAfter」が見えた日、見本とカルピス原液をマージするのが最強
分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
Gemini 4 Neon の数字を、自分の仕事に当てはめて確かめる
AIエージェントに渡す、数字と持ち場の確認プロンプト
この記事のURLをAIエージェントに読ませると、Neon の数字を、何を測った数字かに分けて読み直せます。自分の環境で使える追加のプロンプトまで手元に残せますし、枠の中にはこの記事のURLが入っています。
1
数字は測った中身で分ける
自己計測の行、各社別のハーネスの値、1問1回の比較は、同じ数字として並べず、何を測った数字かに分けて読みます。
2
エフォートは途中の段から
既定は途中の段に置き、上げるのは必要な時だけです。迷ったらまず high から始めて、xhigh はここぞの場面に残します。
3
自分用の追加プロンプト
答えに合わせて、手元の環境に貼れる追加のプロンプトが1〜3本返ります。1回の比較は、そのお題への答えとして読みます。
返ってくるのはAIの答えなので、任せ切りにせず、最後は自分の目で読み直してくださいね。使ってみたい場合だけ、下のボタンを開くと使い方と依頼文が出てきます。
▶ タップしてプロンプトを開く
下の枠の文を、丸ごとコピーして、手元のAIエージェントに貼ってください。枠の中に、この記事のURLが入っています。
貼ると、AIがURLの記事を読んだあと、短い質問を1つずつ聞いてきます。答えていくと、自分の仕事に当てはめた整理と、環境に合わせた追加のプロンプトが返ってきます。
返ってきた結果は、そのまま信じずに、自分の目で読み直してくださいね。数字は動画1本の話なので、手元で同じ結果になるとは限りません。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
https://ai-kidou.jp/video-report-masao-gemini4-neon-bench/
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、下の記事の要点だけを材料にしてください。
記事の要点:
・動画では、Gemini 4 Neon は Hydrogen と Carbon の間に置かれ、迷ったら Hydrogen、足りなければ Neon、最難関は Carbon と結ばれる。
・公式ベンチ19行のうち9行は Google の自己計測で、SWE-sweep は各社別のハーネスの値。
・小さい文字の読み取りは、動画1本の実験では解像度の設定が先。
・エフォートは、まず high から。xhigh はここぞの時だけ。
・25問のデモは1問1回で、ジャッジは1つ、CLI は別々。動画自身が参考程度と断っている。
・記事の考え: 数字は、何を測った数字かに分けて読む。持ち場は、自分の仕事の大きさで決める。

【目的】
記事の要点を、私の状況に当てはめて確かめ、整理することです。新しいモデルの数字を見た時に、持ち場を自分で決められる状態にします。

【やってよいこと】
1. 記事を読んだあと、短い質問を1つずつ聞いてください。任せたい仕事、その仕事の大きさ(口を出したい所と任せたい所)、自分で確かめたい所、使っているAIエージェントや道具、の順です。
2. 答えに合わせて、数字を何を測った数字かに分けて読む見方、エフォートの段の選び方、1回の比較の読み方を当てはめて整理してください。
3. 持ち場の候補と、その理由を出してください。
4. 使っている環境にそのまま貼れる追加のプロンプトを、1〜3本つくってください。各プロンプトの中に、記事のURLを入れてください。

【守ること】
・設定を変える、消す、送る、買うことは実行せず、確認と提案だけを書いてください。
・パスワードや鍵を、貼らせない、聞かないでください。
・記事に無い数字、機能、料金を足さないでください。
・動画の数字を、私の環境でも同じ結果になると断定しないでください。動画自身が、動画1本、1問1回、参考程度と断っています。
・分からない所は「未確認」と書いてください。

【返す形】
・項目ごとに短く書いてください。
・根拠にした記事の話と、私の答えを分けて書いてください。
・持ち場の候補と理由。
・追加のプロンプト(1〜3本・記事のURL入り)。
・自分の目で読み直す所を1行。Q. Gemini 4 Neon は、Hydrogen とどう使い分ければいいですか?
A. まさおさんの結論は、迷ったら Hydrogen、足りなければ Neon、最難関は Carbon です。動画1本の実験では、動画分析は Hydrogen で足りたと話し、音声のみでも Hydrogen が速くて安かった、と話します。Neon の料金は、Hydrogen の約2倍です。
Q. 公式ベンチで19行中16行が最上位、という数字はどう読みますか?
A. まさおさんは、19行のうち9行が Google の自己計測で、SWE-sweep は各社別のハーネスの値だと指摘します。共通のハーネスで揃えると12.8%まで下がる、とスライドが示します。
Q. エフォートは、どの段を選べばいいですか?
A. まさおさんの結論は、まず基本の high からです。Neon は low から xhigh で時間が3.9倍、300点満点で11点しか上がりません。速さが欲しい所は low や medium でもよく、xhigh は、ここぞという所だけです。
Q. 25問のデモで、Neon は Opus 5.5 に負けたのですか?
A. 点で並べると、Neon が上だったのは4問、Opus 5.5 が上だったのは20問で、同点が1問でした。点は Opus 系のジャッジが1問1回で付けた評価で、Cursor CLI 経由の xhigh だと、動画自身が参考程度と断っています。
5つの章を通して、私が言いたいのは1つです。数字は、何を測った数字かに分けて読み、持ち場は自分の仕事の大きさで決めます。
置き場所は、乗り換える前に、使い分けの表のどこへ置くかを決める。公式ベンチマークは、Google 自身の計測の9行と、各社別のハーネスの数字とで、別々に読む。私の1つの会話の数字も、同じ読み方です。
小さい文字は、モデルを上げるより解像度の設定が先。エフォートの既定は途中の段で、上げるのは必要な時だけです。25問の1回の比較は、そのお題への答え。
本編の動画では、スライドの図や25問の左右の比較を、じっくり見られます。自分の仕事に置き換えながら観ると、数字の読み方がつかめます。
新しいモデルの数字を見た日に決めるのは、順位より持ち場!
関連記事
同じ Gemini 4 の Hydrogen を、動画と私の判断軸で整理した記事です。Argon と並べて、総合点が上でも上位互換ではない、という見方を扱います。
動画と音声を扱う仕事の持ち場の決め方を、Argon と Opus 5.5 の比較から整理した記事です。置き場所の考え方が見えてきます。
エフォートの段の選び方を、別の動画で整理した記事です。Claude Code では、どこまで口を出したいかで決める、という見方を扱います。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
第1章で一部を引いた、私の記事です。
第2章で一部を引いた、私の記事です。
第4章で一部を引いた、私の記事です。
第5章で一部を引いた、私の記事です。
今回紹介した動画
| チャンネル | まさおAIじっくり解説ch |
| 出演 | まさおさん(スライドを共有しながらの一人語り) |
| モデルの発表 | アメリカ時間2026年11月18日(動画のスライドより) |
| 長さ | 58分9秒(日本語の音声。読み上げは本人の声から作ったAI音声) |
| URL | https://www.youtube.com/watch?v=vhN-z6ENeTM |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!