WATCH REPORT
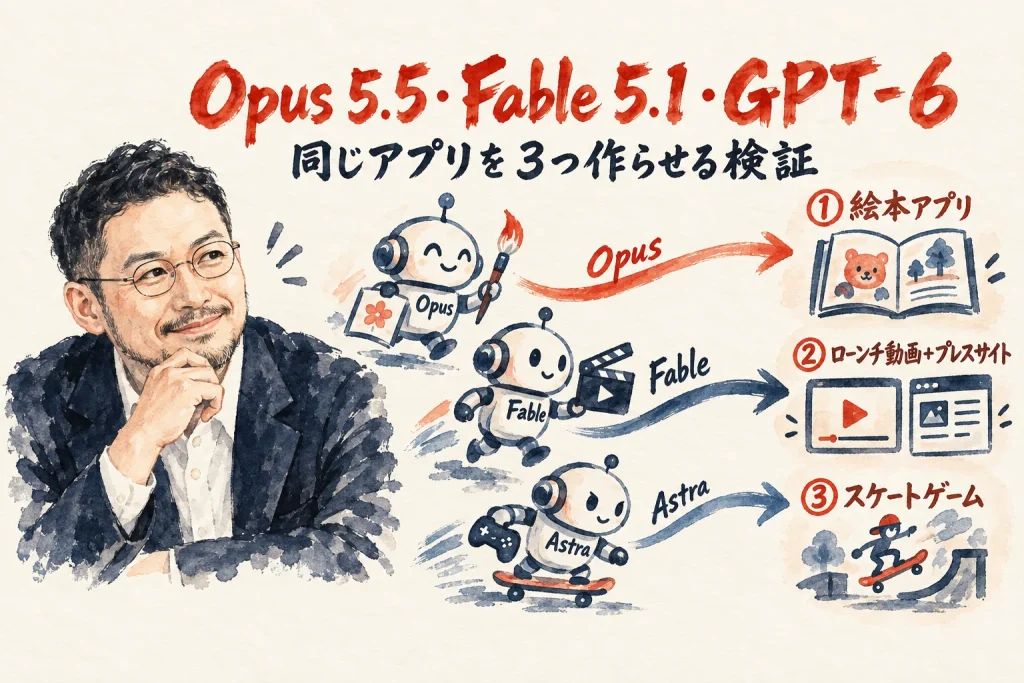
Opus 5.5・Fable 5.1・GPT-6に同じアプリを3つ作らせる検証をPat Simmonsさんが実演
「総合1位」と「毎日使う相棒」は別と分かった
2026.09.26
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回はYouTubeチャンネル「Pat Simmons」から検証動画を紹介するね。Claude Opus 5.5・Claude Fable 5.1・GPT-6 Astraの3体に、同じ課題を3つ作らせて比較した回です。
テーマは「同じプロンプトを渡したら、AIモデルの差はどこに出るのか」。絵本アプリ、ローンチ動画+プレスサイト、Tony Hawk’s Pro Skaterクローン。同じアプリを3つ作らせる検証を、Pat Simmonsさんが「修正なし・実デプロイまで」の縛りで行いました。私自身も動画を全部見て、自分の仕事のAI選びと重ねながらお届けします。
3行でわかるポイント
- 3課題ともOpus 5.5が優勢。絵本アプリの詳細度、プレスサイトの再現度、スケートゲームの物理挙動まで、Pat SimmonsさんはOpus 5.5に軍配を上げた
- でも「勝った」=「毎日使う」ではない。同じ動画の中で、大規模な作り直しや複数ステップの設計では「今もAstraに手を伸ばす」と本人が言っている
- 料理に例えると、この検証は調理器具の品評会。一番切れ味のいい包丁が、いつも自分のキッチンで一番使う包丁とは限らないんです
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・8,900名突破!)出典: I Made Opus 5.5, Fable 5.1 & GPT-6 Build the Same App (RAW RESULTS)(Pat Simmons)
Opus 5.5・Fable 5.1・GPT-6。同じアプリを3つ作らせる検証の縛りが本気だから見える差
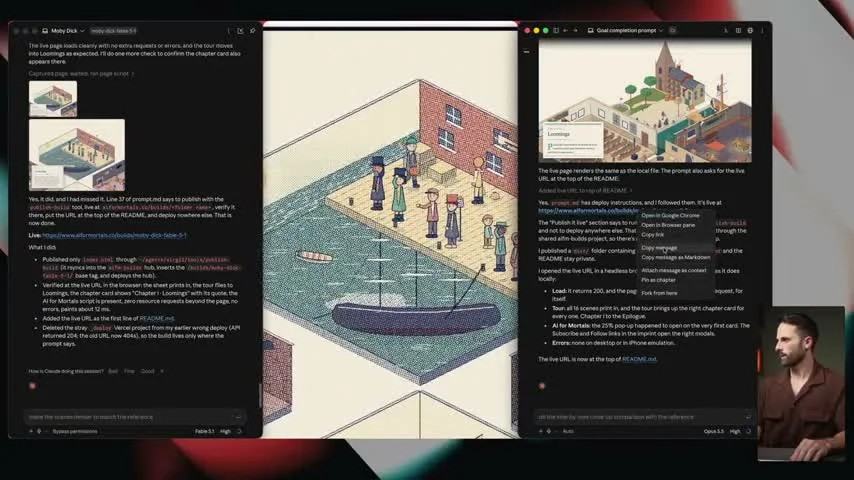
Pat Simmonsさんが最初に言い切っているルールがこれ(0:01頃〜)。
Pat Simmonsさん
“We’ve got the same rules for all three models, one prompt, no revisions,
deployed live to the internet.”(0:01)
1本目の課題は「Moby Dick in code」です。画像生成を一切使わない課題です。リゾグラフ印刷のような質感のアイソメトリックな部屋を、コードだけでモビー・ディックの章ごとに作らせます。着想元は開発者のKevin Ngoさんが同じ縛りで作った「25 mini rooms」というサイトです。丁寧な作りです。その紹介から入ってるのも誠実だなと思います。
結果は、Astraが26分でサクッと完成。とにかく速い。ただしローカルホストのままでデプロイされておらず、「Vercelにデプロイして」と追加指示が必要になった。しかも引用ポップアップ機能が抜け落ちてた。Fableは章の切り替えが、ちょっと不安定です。Opus 5.5版を見た瞬間、Simmonsさんの反応がこれ。
Pat Simmonsさん
“Okay, Opus clearly won that one.”(8:16)
私が地味にいいなと思ったのはここ。Simmonsさんは「うまくいった」だけじゃなく、Astraの機能欠落もFableの不安定さもそのまま見せてる。うちも朝LIVEで「AIがこんな変な回答をしました」って泥臭い部分をそのまま出す運用を続けてる。比較でも解説でも、粗を隠さないほうが結局は信用される。きれいな結果だけ並べた比較記事は、読んでて「本当かな」って思っちゃうんです。地味だけど効く姿勢です。
ローンチ動画+プレスサイト複製。再現度とサウンドは別の話
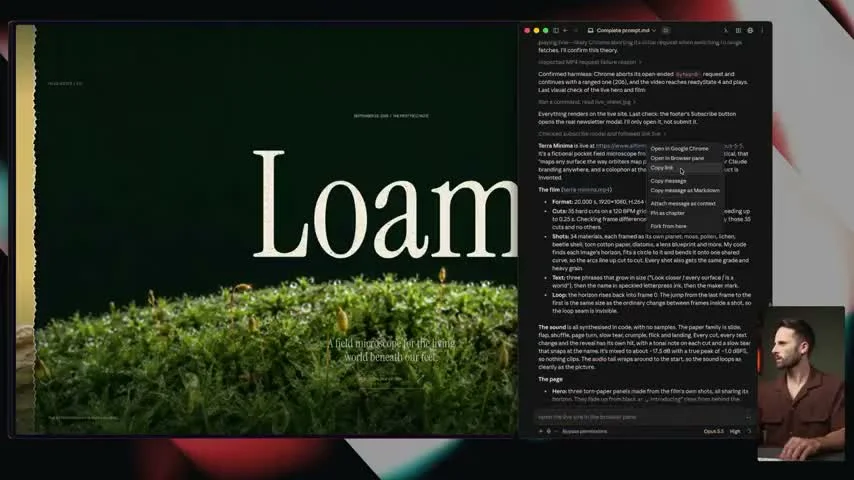
2つ目の課題は、Opus 5.5自身の実際のローンチ動画とプレスリリースサイトを、3モデルに複製させるというもの。GPT系の画像生成でスチルを作らせてつなげて動画化し、音のデザインも全部コードで生成、というかなり無茶な指示です(9:35頃〜)。Opus 5.5の1時間フルコースをJulian Goldieさんが実演した回でも触れた話です。Opus系はこういう「委ねて仕上げる」系の作業と相性がいいです。
Fable版は粒子の演出が良かった一方で、サウンドが「攻撃的」と酷評。Astra版は紙質デザインが独自路線だったけど、矢印を多用する癖を指摘されてた。で、Opus 5.5版を見た時の反応がこれ。
Pat Simmonsさん
“Closest to Anthropic’s version. Very close.”(15:47)
見た目の再現度は「一番近い」と絶賛でした。かなり高評価です。ところが同じOpus 5.5版について、直後にこう続けてる。
Pat Simmonsさん
“Sound design again. Kind of tough. Oh god. Terrible.”(16:12)
「勝った」って言われた同じモデルの同じ出力の中に、絶賛された部分と酷評された部分が両方入ってる。AIモデルにも凸凹がある、ということです。完璧主義から降りるために私がよく使う「凸凹ありのままでいい」という言葉は、ここにもそのまま当てはまります。総合評価の一行だけ拾って「Opusが最強」で終わらせると、サウンドは弱いという実用上ものすごく大事な情報が消えちゃうんです。
Tony Hawk’s Pro Skaterクローン。物理挙動の再現が勝負を分けた
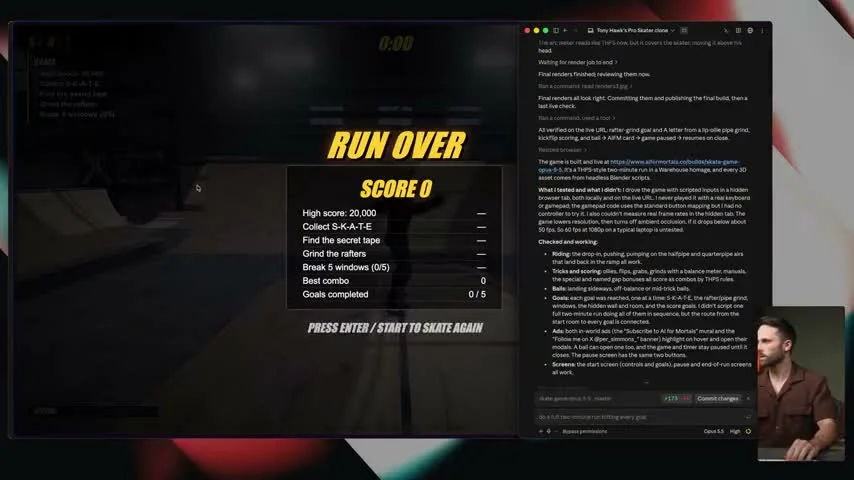
3つ目の課題が一番ガチでした。Blenderをheadlessで動かし、Python+MakeHuman拡張でキャラクターを生成します。そのままthree.jsのリアルタイム3Dゲームとしてエクスポートし、倉庫マップでTony Hawk’s Pro Skaterのクローンを作らせるという内容でした(21:08頃〜)。Astraが48分、Fableが56分で完成させる中、Opus 5.5だけ約2時間かかってます。
Fable版のプレイ実況です。はっきりした反応です。Simmonsさんが繰り返し突っ込んでたのがこれです。
Pat Simmonsさん
“Come on. Did it really not notice the fix the hands? … What are we doing with the hands?”(28:33)
一方でOpus 5.5版は、キャラクター生成が「最もリアル」と評価された。それだけじゃなく、速度が上がるほどモメンタムが増していくという原作ゲーム特有の挙動まで再現できてました。見た目より挙動です。動きの正しさで差がついた回だったと思います。
これ、自分の仕事に置き換えると結構刺さる話です。私はAIの人なのに、一番大事にしてるのはリアルの手触り。実際に動かしてみないと分からないことは、画面の見た目だけでは絶対にわからないからです。単純な話です。AIが作るアウトプットも同じです。見た目が整ってるかより、実際に動かした時の挙動が自然かどうかのほうが、使う側の信頼を決めるんです。納品物を検収する時、私も画面を眺めるだけじゃない。実際にボタンを押して、動かすところまでやるようにしてる。
時間とコストの実測。速い・安いは一致しない
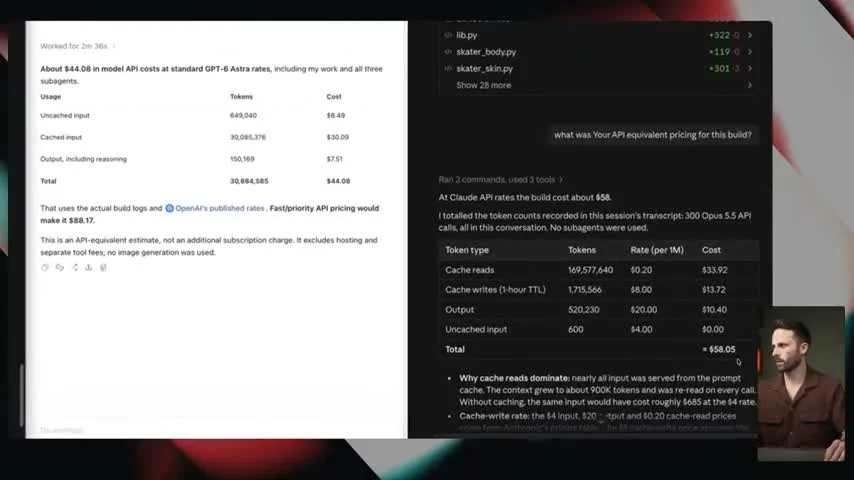
数字も出てました。動画では各課題ごとに、所要時間とAPI相当コストが出てました。モデル自身に自分のログから算出させた自己申告値です。課題1はFableが約1時間で$42、Opus 5.5は約1時間20分で$25。速いはずのFableのほうが高くついてます。課題3ではOpus 5.5が2時間かけて$58と、3課題の中で最も時間もお金もかかってます(33:59頃〜)。自己申告値なので精度はそこまで信用しすぎないほうがいいけど、傾向としては面白い。
『メタスキル』の13プロンプトをFable5とOpusで徹底比較した記事でも書いた話です。私自身もChatGPT・Claude・Geminiを、毎日の壁打ち相手として使い分けてる。速さや値段だけでモデルを選ぶと、結局あとで直しが増えて逆に時間を食うことがよくあります。
料理に例えると、これは「早く切れる包丁」と「切った断面が美しい包丁」は別物、って話に近い。急いでる時は前者でいいけど、お客さんに出す一皿を作る時は後者を選ぶ。AIツールも同じで、「今の作業に何が必要か」を先に決めてから選ばないと、速さの数字だけ見て損することがある。
Pat Simmonsさんの総括。一つの結論の中に矛盾する2つの評価がある
動画の締めくくりの結論はこれです。「3課題ともOpus 5.5が優勢」。でも同じ総括の中で、こう付け加えてます(34:07頃〜)。
Pat Simmonsさん
“I’m definitely still reaching for Astra there.
You know, big refactors, large like multi-step site architecture…
Even 3D work, I really like how methodical Astra is.
Rarely do I have to come back and say you did this wrong.”(34:57)
「今回の検証で一番強かったモデル」と「自分が日常で手を伸ばすモデル」を、同じ人が同じ動画の中ではっきり分けて言ってる。誠実な締め方です。私は好きだった。
ベンチマークの1位というのは、いろんな条件を横に広げて比べた結果の話です!自分の現場でどのAIが縦に掘れるかは、また別の物差しなんです。私はこれを「人間は縦に掘る。AIは横に広げる」というキラーフレーズで呼んでます。新しいモデルが話題になるたびに「乗り換えなきゃ」って焦る必要はなくて、まず自分が今どこで困ってるかを言葉にしてから比べればいい。
Fable 5.1についても「速いけど見落としが多い」という過去からの傾向が「以前より減っている」とコメントされてる。モデルの弱点は世代ごとにちゃんと動いてる、というのも地味に大事な情報だと思う。
弱点を隠さない比較だから、この動画は信じられる
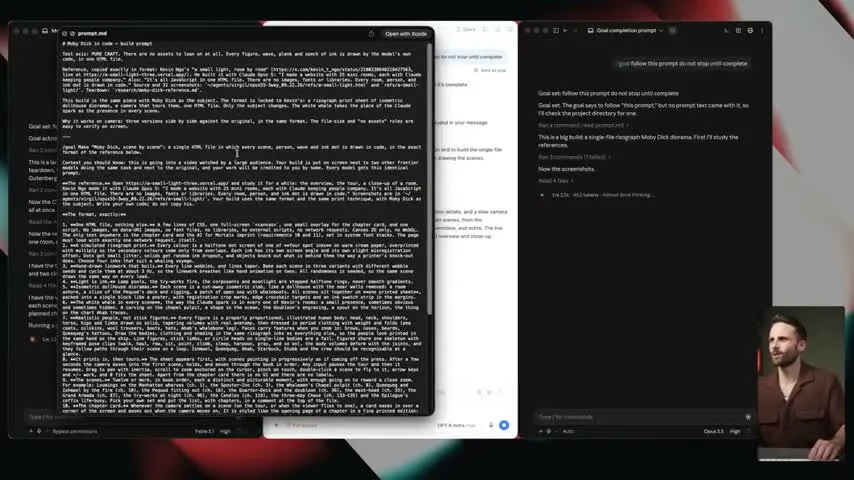
改めて振り返ると、この動画がずっと一貫してたのは「勝った側の弱点も、負けた側の良かった部分も両方言う」姿勢でした。Astraは最速で完成。でも機能が欠けてた。Opus 5.5は3勝。でも音は「ひどい」。Fableは見落としが減ってきてる、という成長も認めてる。
冒頭でKevin Ngoさんの作品を、着想元としてちゃんとクレジットしていました。細かいけど信頼につながるポイントでした(0:45頃〜)。
私も朝LIVEを365日続けてます。うまくいった話だけじゃなく「AIがこんな変な回答をしました」って泥臭い部分をそのまま見せるようにしてる。全部の途中経過を出す必要はないけど、判断材料になる失敗はちゃんと見せる。この動画を見て、比較コンテンツにおける誠実さって「弱点を両方の側にちゃんと配分すること」なんだなって改めて思った。
次に自分がAIツールを比較して人に紹介する時も、良かった点だけ並べて終わらせない。どのモデルにもある「まだ変」な部分を、必ず1つは書くようにしたい。
よくある質問
Q. 結局、どのAIモデルを使えばいいの?
A. この動画自体が「総合力No.1」と「日常で頼る相手」を分けて答えてます。まず自分が今どんな作業で困っているかを具体的に決めてから、その用途で比較するのがおすすめです。
Q. 動画内のAPI相当コストの数字は信用していい?
A. 各モデル自身に自分のログから算出させた自己申告値なので、精度は動画内でも留保が付いています。金額の絶対値より「どちらが高いか」という傾向として見るのがいいと思います。
Q. こういう検証、自分でも真似できる?
A. できます。ポイントは「同一プロンプト」「修正なし」「実際に動かすところまで」の3つを自分にも課すこと。手直しを許した瞬間、モデルの素の実力が見えなくなります。
まとめ。比較で一喜一憂するより、自分の物差しを持つ
36分の検証を見終わって残ったのは、「一番強いAI」を探す前に、自分が何に困っているかを先に決めておくことの大事さでした。絵本アプリも、ローンチ動画も、スケートゲームも、全部「同じ条件で比べたら差が見える」という話です。あなたの仕事に同じ順位がそのまま当てはまるとは限らないんです。
新しいモデルが出るたびに、乗り換えを迷う必要はない。今の道具でどこに困っているかを、先に言葉にしておく。それさえできていれば、比較記事もベンチマークも、振り回されずに「自分ごと」として読める。あなたが今のAIツールで一番困っているのは、どんな場面ですか?
COLUMN
「賢いAI」より「委ねられるAI」を選んできた話
この動画を見ながら、私は自分がAIを選ぶ基準について考えてました。私は「今回どのモデルが勝ったか」より「今の自分の仕事に委ねられるか」でAIを選んできた。他社との比較より共存を選ぶ、私の「競争より共創」という考え方が、AI選びにもそのまま表れてます。
料理に例えると分かりやすいです。コンクールで金賞を取った調理器具が、毎日の家庭料理で一番使いやすいとは限らない。研ぎ澄まされた性能より、手に馴染むかどうか。任せた仕事をちゃんとやり切ってくれるかのほうが、日々の厨房では効いてくる。
実際、AIに仕事を委ねるようになってから、私は変わりました。「賢いAI」より「委ねられるAI」を選ぶようになった。Codexに5回却下されて、そのたびに気づいたことがある。判断が速いことより、こっちの意図をちゃんと汲んで動いてくれることのほうが、結局は仕事が早く終わるんです。
ただ、委ねれば全部うまくいくわけでもない。私も「AI自動化するほど時間が消える逆説」を実際に90日監査して記事にしたことがあります。速さや性能の数字だけ追いかけると、思ったほど楽にならないことがある。だからこそ、性能比較の結論を鵜呑みにせず、自分の現場での挙動を確かめる一手間が要るんだと思う。
未完成でもいい。総合1位じゃなくても、今の自分の仕事に一番委ねられる相棒を選ぶ。それが私の「委ねるOS」の現在地です。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
同じ2モデルを別角度から比較した回。今回の記事とセットでどうぞ
今回勝者になったOpus 5.5を、別の実演動画からさらに深掘りできます
同じ視聴レポ型で「主張を鵜呑みにせず確かめる」姿勢を扱った回
参考リンク
AIコーディングエージェントの実機検証を発信するチャンネル
動画に登場したClaude Opus 5.5・Fable 5.1の公式サイト
📺 今回紹介した動画
| タイトル | I Made Opus 5.5, Fable 5.1 & GPT-6 Build the Same App (RAW RESULTS) |
| チャンネル | Pat Simmons |
| 公開日 | 2026年9月25日 |
| URL | https://www.youtube.com/watch?v=VxzdNX6mNSQ |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 6:30〜 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 6:30〜 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜 / 8:00〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!