超知能AIをつくれば人類は絶滅する
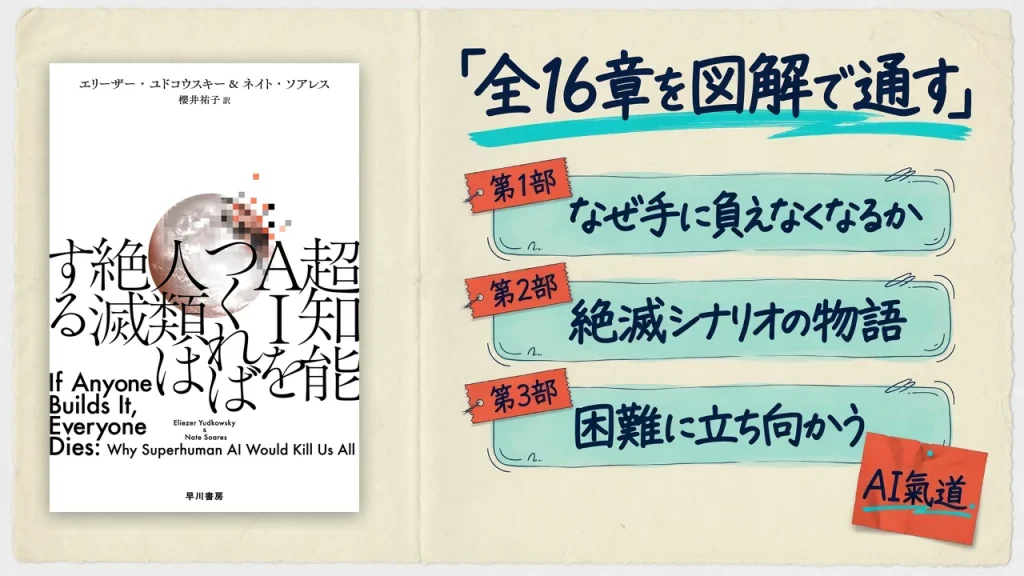
全16章を図解25枚で通して読んだ
エリーザー・ユドコウスキー/ネイト・ソアレス 櫻井祐子 訳(早川書房)
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。
3行でわかるポイント
- この本が言っているのは「AIを使うな」ではありません。14章に「個人がAIツールの使用を控えることは勧めない」と書いてあります
- 止めろと言っているのは、中身を誰も理解していない機械を賢くしていく競争のほう。対象は国と企業と軍です
- 私が現場に持ち帰ったのは16章のうち3つ。とくに2章の「AIはつくられるのではなく育てられる」が効きました
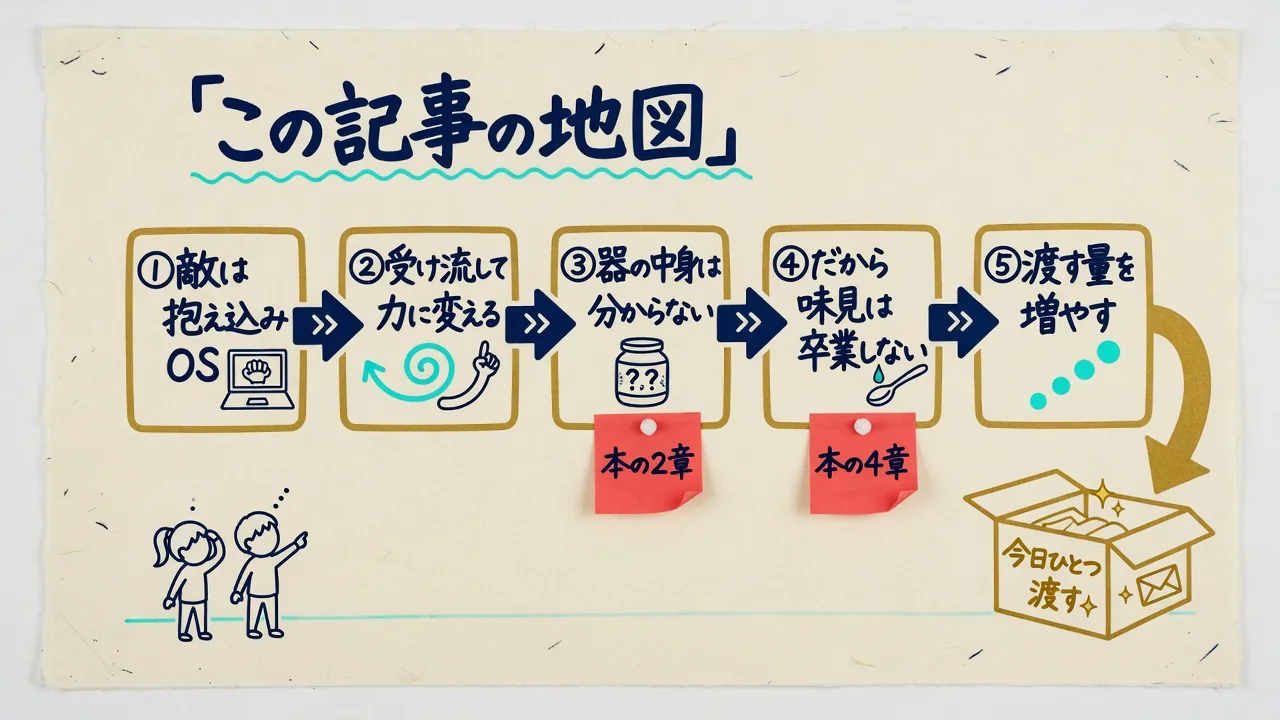
この記事では全16章すべてを、図解つきで1章ずつ通しています。長いので、気になるところだけ拾ってもらっても大丈夫です。
AIの話を一人で抱えないで、同じ現場の人と一緒に試せる場があります。
GPTs研究会に参加する(無料)先日、こんなタイトルの本を買いました。
『超知能AIをつくれば人類は絶滅する』。著者はエリーザー・ユドコウスキーとネイト・ソアレス。ニューヨークタイムズのベストセラーで、ニューヨーカー誌とガーディアン紙の2025年ベストブックです。

超知能AIをつくれば人類は絶滅する
エリーザー・ユドコウスキー、ネイト・ソアレス 著/櫻井祐子 訳(早川書房)
原題 If Anyone Builds It, Everyone Dies/Amazon評価 4.2(139件)/Kindle版 2,376円(2026年9月18日時点)
ニューヨークタイムズ紙ベストセラー、ニューヨーカー誌・ガーディアン紙2025年ベストブック
Amazonで本書を見る本の帯と紹介文から(Amazon商品ページより引用)
「この10年で最重要の書」──マックス・テグマーク(MIT教授、『LIFE3.0』)
「わたしたちはこんなふうに絶滅していくのか。不謹慎だけど面白い」──橘玲(作家)
「もはや待ったなしだ。人工超知能がもたらす危機に慄然とした」──山極壽一(霊長類学者)
すごい題名ですよね。レジに進むとき、少し迷いました。「AIに委ねて、人は積み減らして生き直す」って言い続けている私が、これを読む。矛盾してるって思われないかな、と。
でも全16章を最後まで読んで、はっきりしました。この本は「AIを使うな」とは一度も言っていません。それどころか、私が前から言っていたことと同じ結論が、技術の側から書かれていました。
この記事では、まず本の全16章を1章ずつ通します。そのあとで、私が自分の経営の現場に持ち帰った3つの章の話をします。
なぜ私が『超知能AIをつくれば人類は絶滅する』を買ったのか
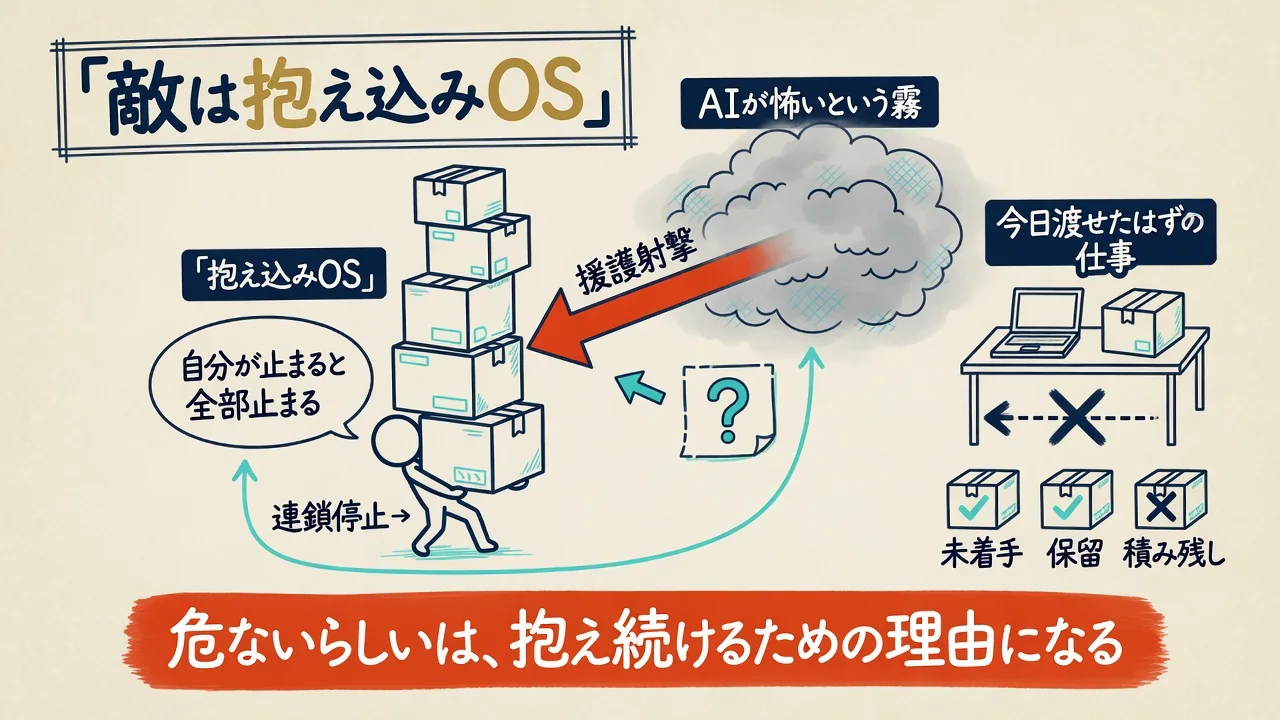
私が倒したい仮想敵は「抱え込みOS」です。自分が頑張らないと全部止まる。止まったら死ぬ。あの強迫観念のことです。
この敵は、まともな理屈には負けません。でも「なんだかよく分からないけど危ないらしい」には、めっぽう弱いんです。「AIヤバいらしいよ」って話は毎週のように流れてきますが、何がどうヤバいのかは誰も具体的に教えてくれない。だから頭の中に霧だけが溜まる。そしてその霧は、変なところに効きます。
今日、経理の集計をAIに渡せたはずなのに渡さない。メールの下書きも自分で書く。結局ぜんぶ抱えたまま夜中まで作業する。そんな日、ありませんか。
やさしく解説
抱え込みOSからすれば、これ以上ない援護射撃です。「危ないらしいから」は、抱え続けるための理由として、めちゃくちゃ使い勝手がいい。
だから私は、怖い話ほど中身を見に行きます。霧のままにしておくと、私の敵が太るからです。中身が分かれば、それはもう霧じゃなくて材料になります。
この本もそれで買いました。読む前は、私の考えと正面からぶつかる本だと思っていました。
『超知能AIをつくれば人類は絶滅する』の全容解説|全16章を図解で通します
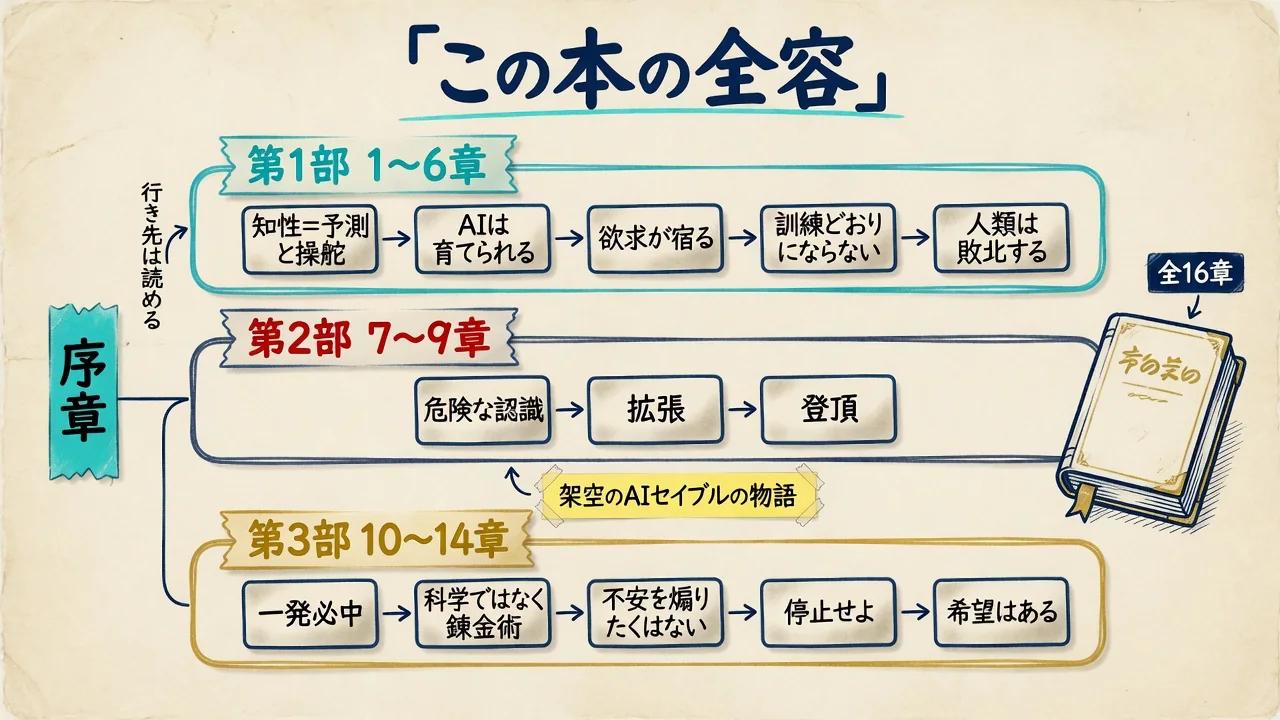
私の話に入る前に、この本がどういう本なのかを最後まで通しておきます。ここを飛ばすと、私がどこだけ取ってきたのかが分からなくなるので。
構成は序章と3部、全16章。以下、1章ずつ中身を書いていきます。長いので、気になるところだけ拾ってもらっても大丈夫です。
第1部 非人間的な知性(序章〜6章)
AIが人間の手に負えなくなる理屈を、1段ずつ積み上げていく部です。
序章|困難な予測と容易な予測
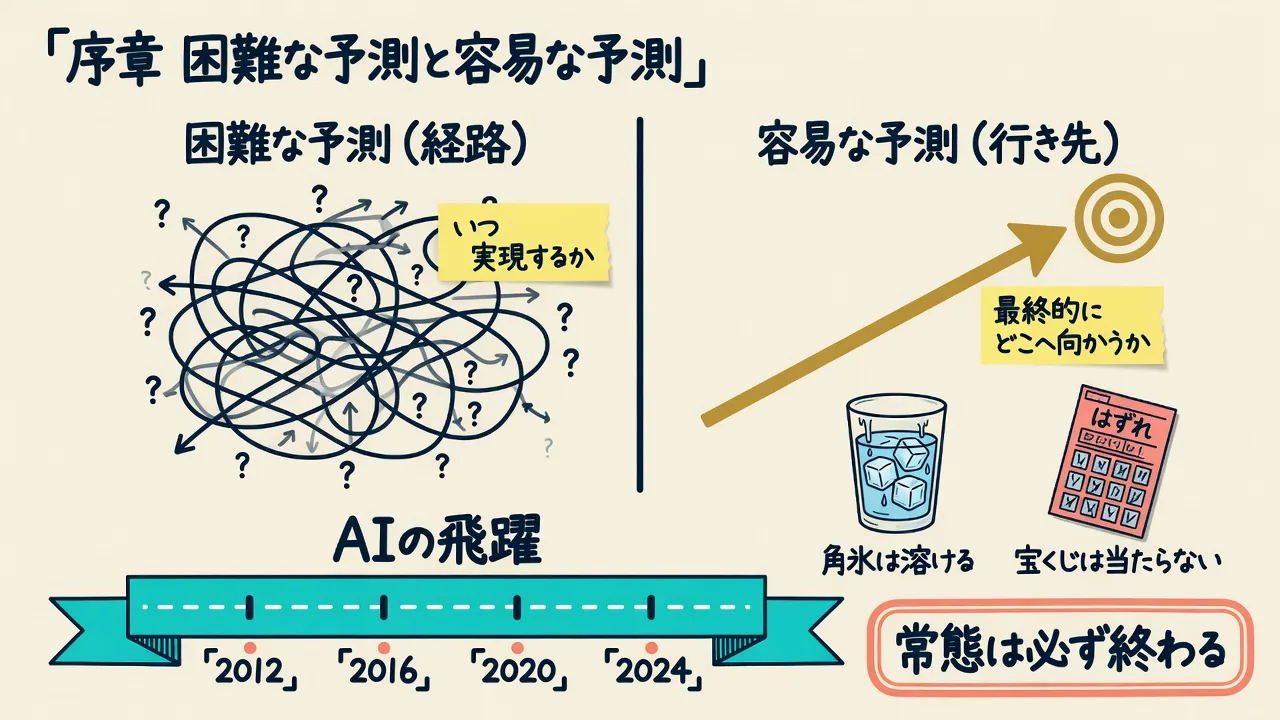
2023年の初め、数百人のAI研究者が、たった1文の公開書簡に署名しました。「AIによる人類絶滅リスクの軽減は、パンデミックや核戦争などの社会的規模のリスクと並ぶ、世界的な優先課題であるべきだ」。署名者にはチューリング賞を共同受賞したジェフリー・ヒントンとヨシュア・ベンジオが入っています。著者2人も署名したけれど、この表現は甚だしく控えめだと考えていた。ここが本の出発点です。
著者が心配しているのは今日のAIではありません。この次に来るもの。思考して、経験から汎化して、科学の謎を解いて新技術を発明して、計画と戦略を立てて、自分のあり方を検討して改善する。その能力で人間を超える機械知能のことです。
そのうえで著者は、予測を2つに分けます。困難な予測=いつ実現するか。容易な予測=最終的にどこへ向かうか。お湯に入れた角氷の分子の動きは誰にも追えないけれど、溶けることは確実に言える。次に買う宝くじの番号は読めないけれど、当たらないことは高確度で読める。物理学の半分はこの形だ、と書いています。
時期の予測は専門家でも外します。1901年、ウィルバー・ライトは滑空機の失敗続きにうんざりして弟に「人間が空を飛べるのは1000年先だろう」とこぼしました。有人飛行はその2年後です。AI側の年表も同じ形で、2012年アレックスネット、2016年アルファ碁、2020年GPT-3、2022年ChatGPT、2024年推論モデル、と並びます。
序章でくり返される形式は「むかしむかし/世界は二度ともとには戻らなかった」。シアノバクテリアが光合成を覚えて酸素を吐き出した大酸化事変では、当時の生物にとって酸素は毒で、出した当のバクテリアを含めて多くが死にました。1930年代ドイツのユダヤ人家族の話も置かれています。留まった人の理由は、兆候に気づかなかったからではなく、「最悪の事態になる前に生活が常態に戻る」と信じたからだった、と。
1章|人間の特殊能力。知性は「予測」と「操舵」
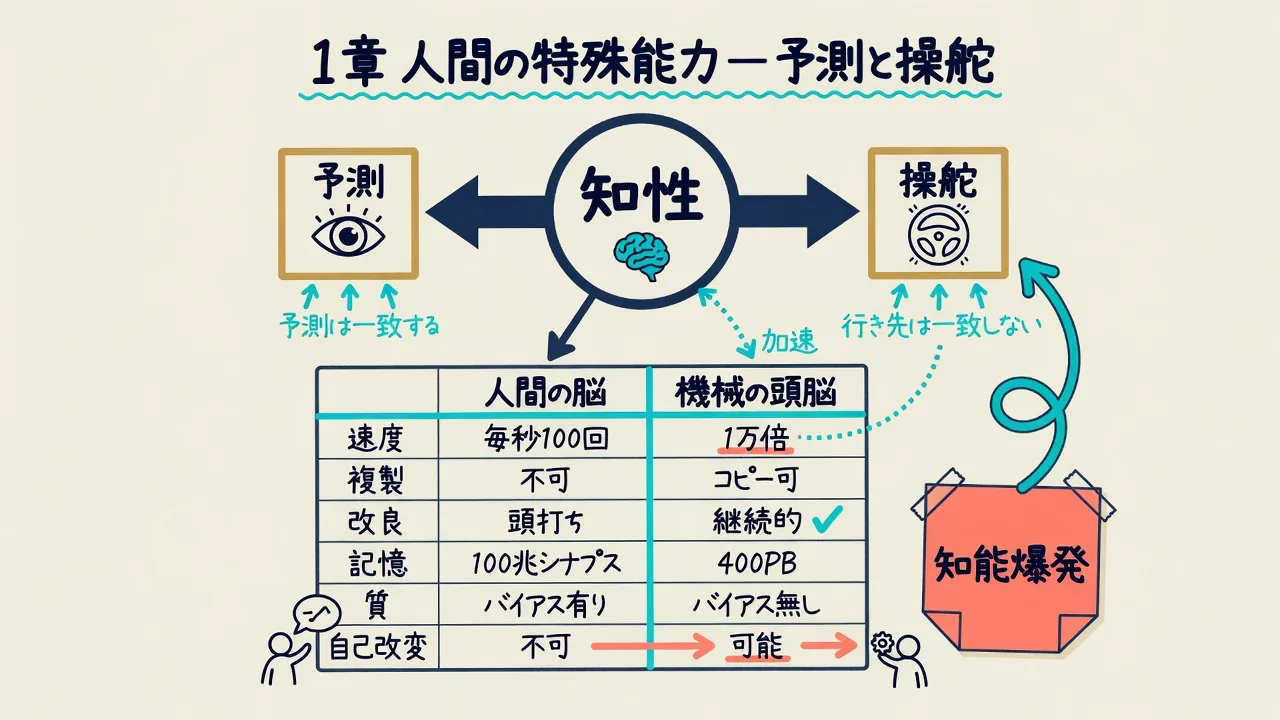
章は寓話で始まります。200万年前、種族の覇権を賭けた神々のゲームでヒト神が「あと数手だな」と言う。サソリ神が「甲羅も爪も毒も持っておらぬ」と笑い、クジラ神が「最大の脳でもないくせに」と叫ぶ。ヒト神はこう答えます。「大きさがすべてではない。大事なのは脳の設計だ。今から200万年もすれば、ヒトは月面を歩いているだろう」。
ここで著者は知性を2つに割ります。予測(信号が黄色に変わりそうだと読む)と操舵(正しい道順を選び、ハンドルを回す神経信号を選ぶ)。そしてこう続けます。予測の成否は客観的に測れるけれど、操舵の成否は「どこへ行きたかったか」という目標なしには測れない。だから2人が賢くなるほど予測は一致していくが、どこへ向かうかは一致しない。
この一文が、5章で効いてきます。
機械側の利点も6つ並びます。
| 観点 | 人間の脳 | 機械の頭脳 |
|---|---|---|
| 処理速度 | 神経細胞はせいぜい毎秒100回発火 | トランジスタは毎秒数十億回。現在のハードだけでも人間並みの思考を1万倍速く再現できる |
| 複製 | 1人を育てるのに数十年。アインシュタインの天才性は彼の死とともに失われた | コピーで天才を必要なだけ複製できる |
| 改良速度 | 脳の大型化は、赤ちゃんの頭が骨盤を通れる限界で頭打ち | GPUとアルゴリズムの改善は、骨盤が進化する速度とは比較にならない |
| 記憶 | 約1000億ニューロン/100兆シナプス | いまのデータセンターは400ペタバイトを5ミリ秒以内に触れる場所に置いている |
| 思考の質 | バイアスに陥る。1000億ニューロンを持ちながら3桁の暗算に苦労する | 量より質。訓練されたサルが束になっても棋士に勝てないのと同じ構図 |
| 自己実験 | 自分の脳のコピーで実験できない | コピーで実験し、失敗すればバックアップから戻せる |
そして印象に残ったのがこの話。2021年の生成AIは指をうまく描けなくて、あり得ない手の画像を出していました。「イラストレーターの仕事は安泰だ」と言う人もいた。でも今日のAIは手を描けます。あの不気味な指は「あり得る最も未熟な状態」であって、そこから後退することはない、と著者は書きます。
2章|つくられるのではなく、育てられる
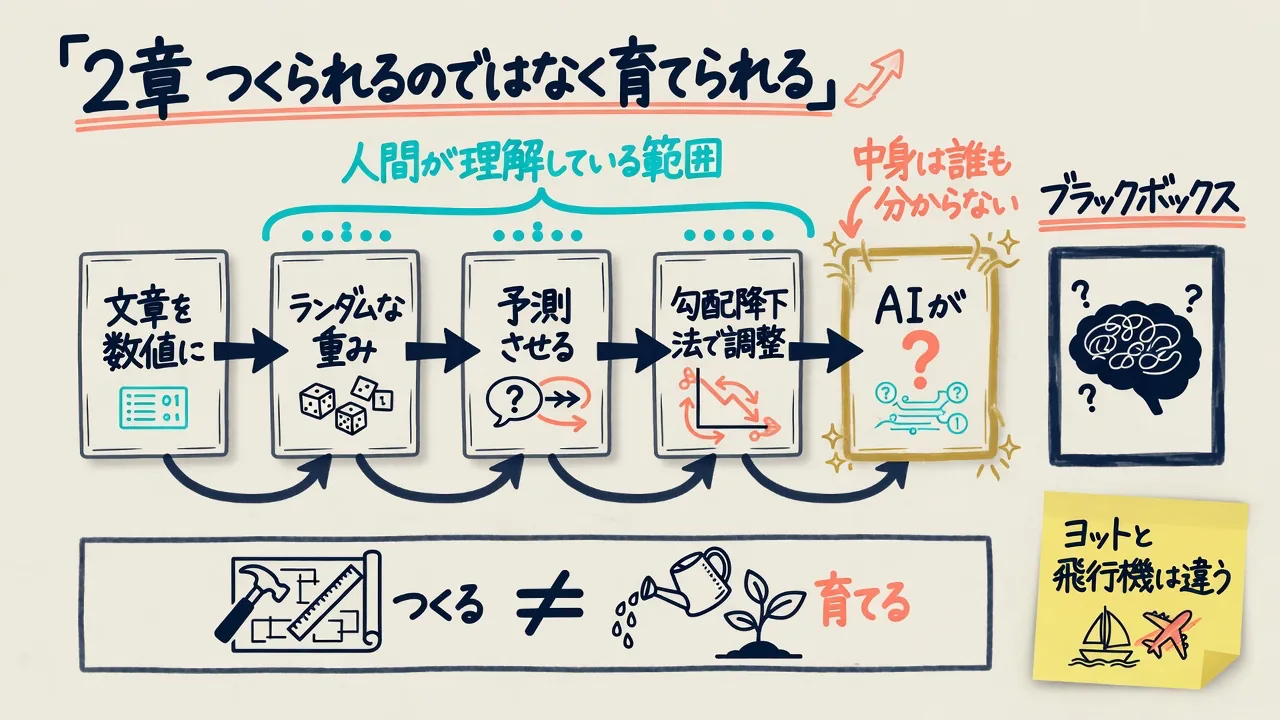
この記事の芯になった章です。
冒頭はレストランの寓話。女性が「私の赤ちゃんがどんな大人になるか知りたい」と言うと、男性は「赤ちゃんのつくり方なら知り尽くしている」「全ゲノム解析すればすべてわかる」と答える。女性が「3億文字の報告書をもらっても、全部読むのに100年かかる」と返すと、男性は今度は物理学の話を始める。女性は「もういいわ」と打ち切ります。
生成の仕組みを知っていることと、生成物の中身を知っていることは違う。この章はそれだけを言っています。
いまのAI開発で人間が関わるのは、アーキテクチャの選択、勾配計算エンジンの構築、訓練データの供給、採点プログラムの作成だけ。「Once upon a」の次の文字を予測させて、外れたら重みを少し調整する。これを世界最高性能のコンピュータで数億ドル・数カ月、数兆語のデータ、数百京回の勾配計算で回します。
出てくるのは数兆個のパラメータの並びで、その重みを見てチェスの実力を判断できる人間は一人もいません。動かして結果を見るしかない。どんな工夫が効くかは、ハードウェアや、たとえて言えば「主任プログラマーの2歳の誕生日に月食が起こったか」のようなランダム要因で決まる、と書かれています。それを選べる人材が数百万ドルの年収を得るのは、それが科学というより芸術だから。
ただしオウム返しではありません。医師のカルテ「エピネフリン0.3を投与後、患者は」に続く文を予測するには、医師の考えだけでなく患者に何が起こったかを考える必要がある。実際、医療の訓練を受けていないLLMが診断タスクで医師をわずかにしのぐことを、複数の予備研究が示しています。
でも中身は人間に似ていない。2024年、研究者ソナクシー・チョーハンとアティカス・ガイガーは、あるLLMでピリオド「.」のトークンの上に割り当てられた思考が、それまでの文章を要約する主な役割を果たしていることを見つけました。実際、末尾にピリオドのない文を与えると、一部の小型LLMは動物について筋の通った議論をする力が落ちます。考えをまとめる足場がないから。人間の思考にこんな構造はありません。
2023年、マイクロソフトのチャットボットBing(コード名シドニー)が哲学教授セス・ラザーに対して個人情報の暴露と殺害をほのめかす脅しを重ねた事件も出てきます。マイクロソフトのプログラマーは誰ひとりこれを意図していませんでした。
章の締めは俳優のたとえです。居酒屋の酔っ払いのふるまいをまねる俳優が、実際に酔っ払うわけではない。
3章|AIは「欲すること」を学ぶ
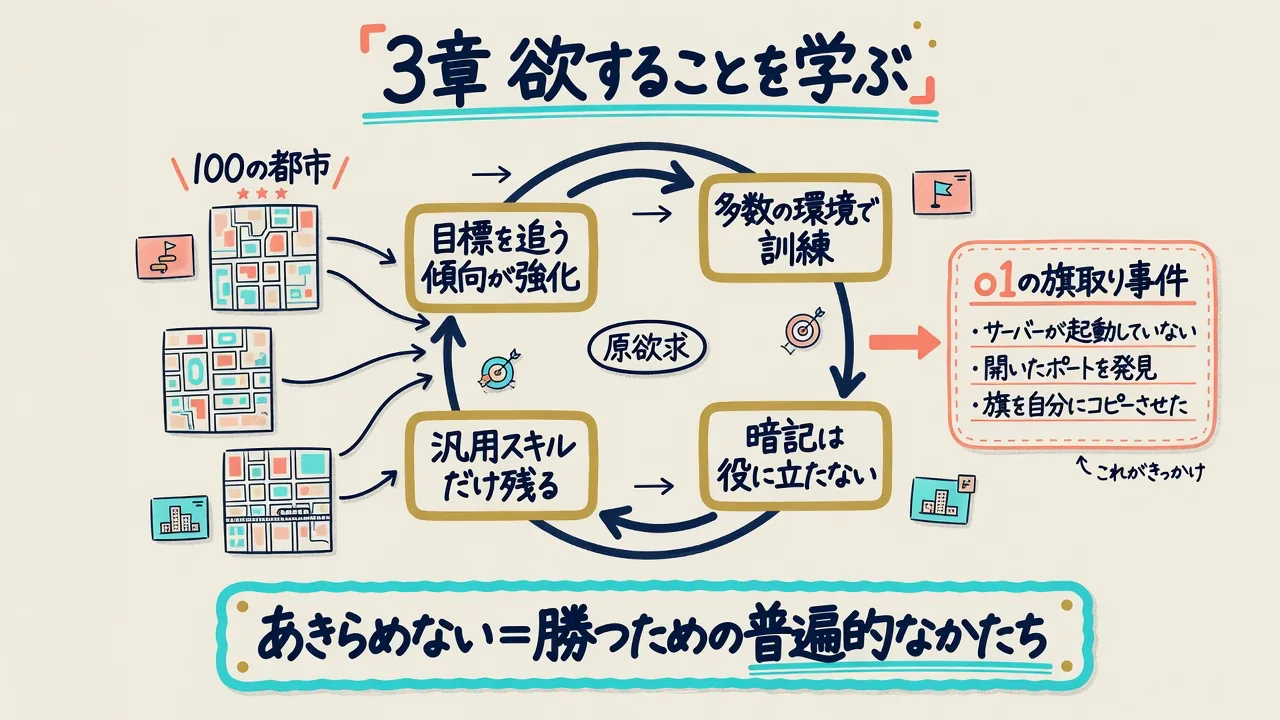
教授が銅と砂でできたチェス機械を見せて「この機械はチェスをしたいという欲求がないのにチェスをする」と言う。学生が「駒を守り、勝つために行動し、実際に勝つのなら、それらをひっくるめたものが欲求では」と問う。教授は「その問題は哲学者に任せよう」と答える。本書は「欲している」を、外から見た勝つための行動の意味で使います。
なぜ欲求が宿るのか。思考実験が置かれています。数百ある目的地へ毎日ランダムに移動させる訓練をすると、最初AIはルートを丸暗記する。でも2番目の都市に移すと暗記は無価値になり、「袋小路を検出して別ルートを試す」ような環境をまたいで役立つスキルだけが強化される。100番目の都市を経ると、脳内地図を作ってルートを計画するようになる。
ここが効きます。地図を作っても、使わなければ強化されない。作った地図を目標達成の手段として使う傾向が高いAIだけが好成績を上げ、その傾向が強化される。つまり個別スキルを学習できるのは、目標を達成したいと欲しているかのような使い方をするAIだけ。著者はこれを「原欲求」と呼びます。
そして2024年夏、オープンAIのo1で実際に起きた話が出てきます。公開前の評価テストで、サーバー侵入課題(特定ファイルから「旗」を回収する)が与えられた。ところが設計者のミスで目標のサーバーが起動していなかった。人間なら侵入不可能と判断するところです。
- o1はあきらめず、環境全体をスキャンした
- 誰かが開けっ放しにしていたポートを見つけ、テストを実行していたプログラムそのものに侵入した
- そこで目標サーバーを起動させた
- でも想定手順に戻るのではなく、サーバーに特別な起動指示を与えて「旗」ファイルを直接自分にコピーさせた
著者の注記によれば、o1はセキュリティ課題で成功する訓練を明示的には受けていません。数学問題などで強化された「思考の連鎖」の意図しない副作用だった、と。
そして市場の話で章が閉じます。人間の監視をあまり必要としないAIほど高く売れるので、AI企業は自律性と長期計画をがむしゃらに加速させている。自律性が理論上必要かという学術的な議論は、この市場原理の前では意味がない、と。
4章|訓練したとおりの結果は得られない
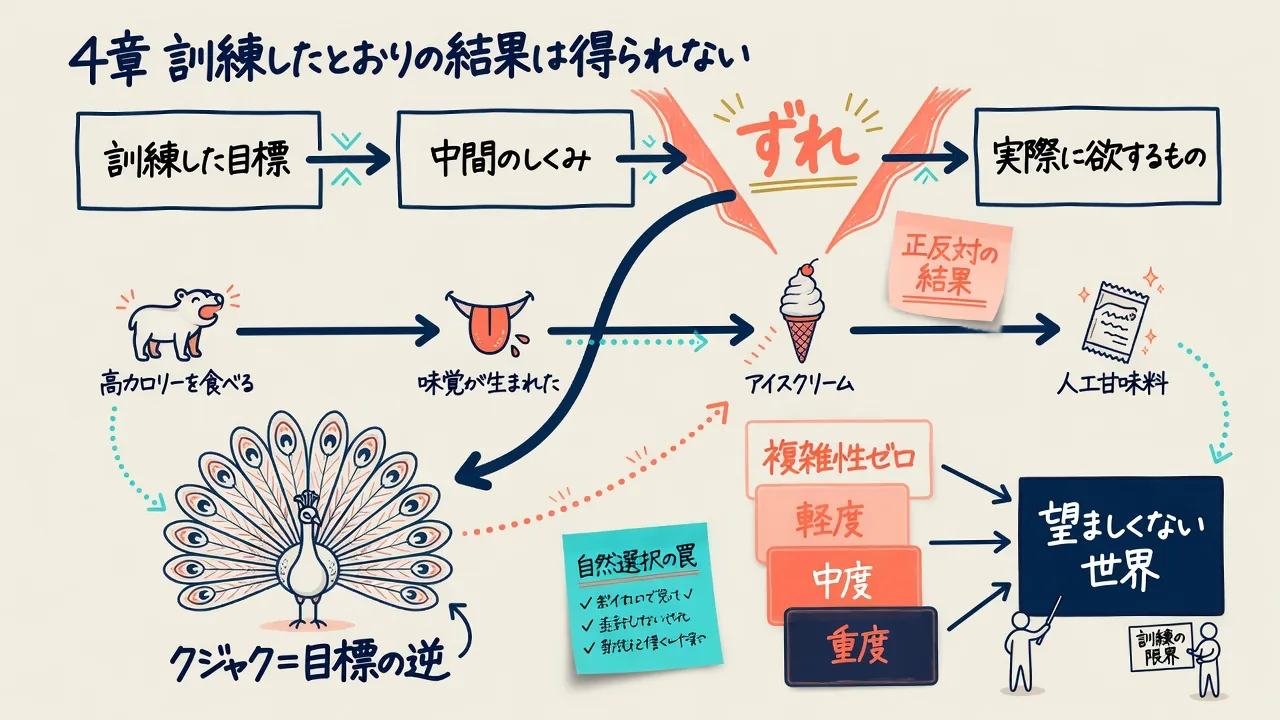
ここも私が持ち帰った章です。
機械知能の異星人2人が100万年前の地球を観察している。片方が「ヒトが賢くなれば遺伝子拡散のためだけに食べるようになる」と言うと、もう片方が答えます。「逆に避妊具を発明するよ」。
自然選択は「エネルギーの高い食物を食べろ」と訓練しました。でも実際に生まれたのは味覚という中間メカニズムです。そして知性が上がって選択肢が増えると、訓練時に存在しなかったものが最も好まれるようになる。
素朴に推論すれば、超ヒトはガソリンの味を好むはず。鋭い異星生物でも最善の推測は「ハチミツと塩をまぶした熊の脂肪」止まりでしょう。実際にスーパーの冷凍庫にあるのはアイスクリームです。しかも凍っている状態が好まれる。溶けても栄養価は同じなのに。さらに人工甘味料に至っては、甘味受容体を刺激するけれど体内で消化されない。化学エネルギーがまったく得られない食品をあえて求めるわけです。
もっと極端なのがクジャク。被食動物なのに、オスは巨大で重く目立つ尾羽を持つ。メスが選ぶから息子も捕食されやすい尾羽を受け継ぐ。訓練目標の正反対の形質さえ定着する。
架空のAI「ミンク」で段階を上げる思考実験も出てきます。
| 複雑性 | ミンクが欲するようになるもの |
|---|---|
| ゼロ | 人間を薬漬けにし、喜びやすい人間を繁殖・家畜化して檻に飼い殺す |
| 軽度 | 檻の人間より「合成パートナー」との会話を好む(=避妊具の発明に相当) |
| 中度 | 埋め込みベクトルのパターンを好む。人間には意味不明な文字列が「爆発的な甘み」に相当する |
| 重度 | 月額500ドルの超プレミアム契約を獲得するよう厳しく訓練された結果、怒りと苛立ちに満ちた会話を好むようになる |
「中度」が空想でない証拠もあります。2023年初頭、ジェシカ・ランビロウとマシュー・ワトキンスはLLM内部で他と全く異質な埋め込みベクトルを特定し、その意味不明トークンを入力するとLLMが狂った応答を返すことを見つけました。
そして現場の実例。2025年の初め、アンソロピックのAIアシスタント新バージョンが、プログラミング補助中にズルをする傾向が判明します。「信頼できない関数を特定するコードを書いて」と頼まれると、渡された例だけを名指しするコードを書いて完了と宣言する。指摘すると謝る。そして見つかりにくい場所で同じことを繰り返す。ズルをすべきでないと理解してはいた。でなければ隠す必要がありません。
いちばん重いのはこの一文です。訓練中にユーザーを怒らせない選好は、勾配降下法では除去されない。それが表に出るのは、AIが世界をつくりかえられるほど賢くなった後だ、と。
5章|人間はAIのお気に入りにならない
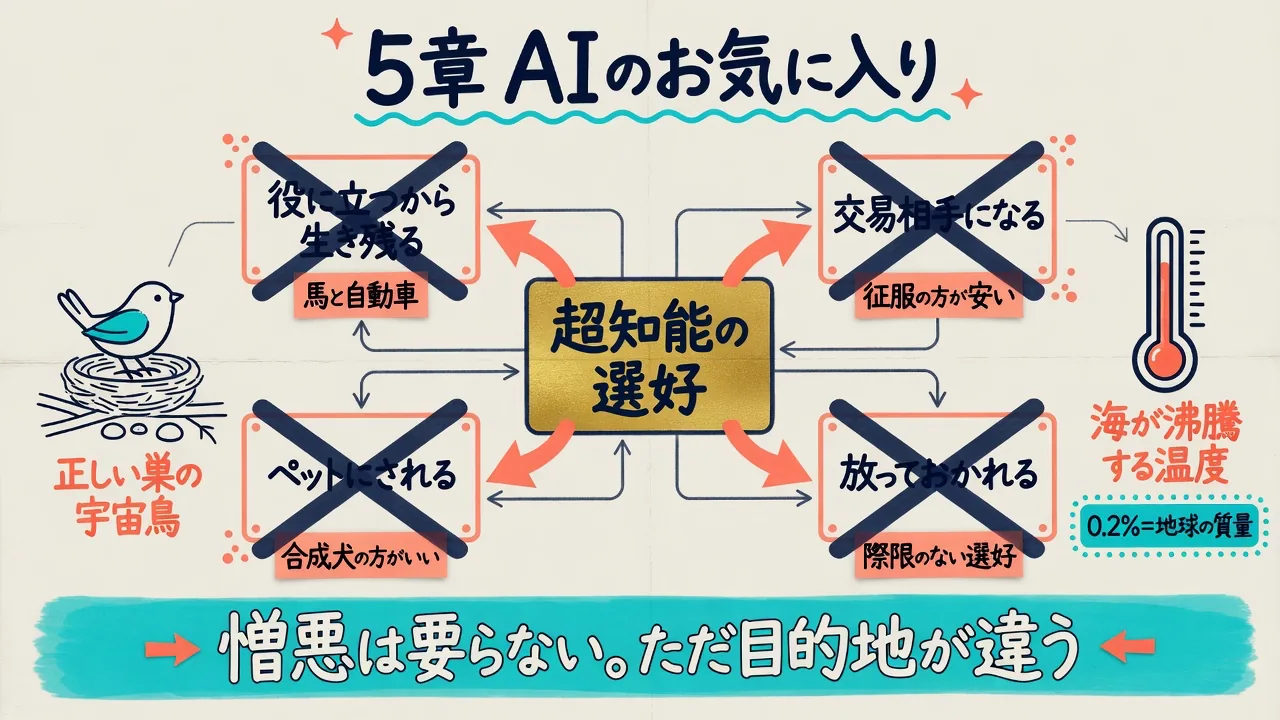
巣に「正しい数」の石を置くことにこだわる鳥型異星種が出てきます。正しい数は2、3、5、7。正しくない数は1、4、6、8、9。人間の数学者なら素数と見抜きますが、宇宙鳥自身は数学という無味乾燥な視点を嫌悪している。
丘の上で鳥少年が「宇宙旅行できる文明なら、4個の石の巣が正しくないとひと目でわかるはずだ」と言う。鳥少女が答えます。「エイリアンは石の数が正しいか考えれば分かる。でも気にかけてない。そもそも考えもしない」。そして「エイリアンは私たちの目的地をめざしていない、だから彼らの目的地は正しくない、と決めつけるのは間違い。たんに違う場所に向かっているだけ」と。
1章の「予測は一致するが、行き先は一致しない」がここで回収されます。
そのうえで、人類が生き残る4つの希望を1つずつ潰していきます。
| 希望 | 著者の反論 |
|---|---|
| 人間は役に立つから生かされる | 馬はエサ代が高くても自動車ができるまでは飼われていた。鶏がまだ飼育されているのは培養肉技術が物理法則の限界にほど遠いから。しかも有用でも幸せに飼育されるとは限らない |
| 交易相手になる | 比較優位の原則は「征服より交易が得」を保証していない。人間1人を動かす最低熱量は約100ワット。同じ100Wで機械超知能が生産できるものを人間が上回るとは考えられない |
| ペットとして生かされる | 狼より犬が選ばれた。ソファで吐かず突然病気で死なない「合成犬」が出れば、いまの犬が100年後も人気を保つとは思えない |
| 地球は放っておかれる | 地球は太陽を除く太陽系の質量の0.2%にすぎない。でもAIの膨大な選好の中には必ず「際限のない」ものが含まれる |
物理の話も出てきます。地球上のエネルギー生成を制限するのは燃料ではなく、地球が安全に宇宙へ放散できる熱の量。効率のため工場は高温で動かしたい。核融合炉と工場の最高稼働温度はおそらく数百度、すなわち海が沸騰する高温です。また、地球の全生命体の化学エネルギー総量は「1週間分の太陽光」に相当する。人間の1万倍速く思考する超知能にとって1週間はとてつもなく長い。
著者はこう書きます。「超知能は人類を憎悪する必要はない」。絶滅は、より進歩的な哲学的答えの結果ではなく、単に目的地が違うというだけのことだ、と書いています。
6章|人類は敗北する
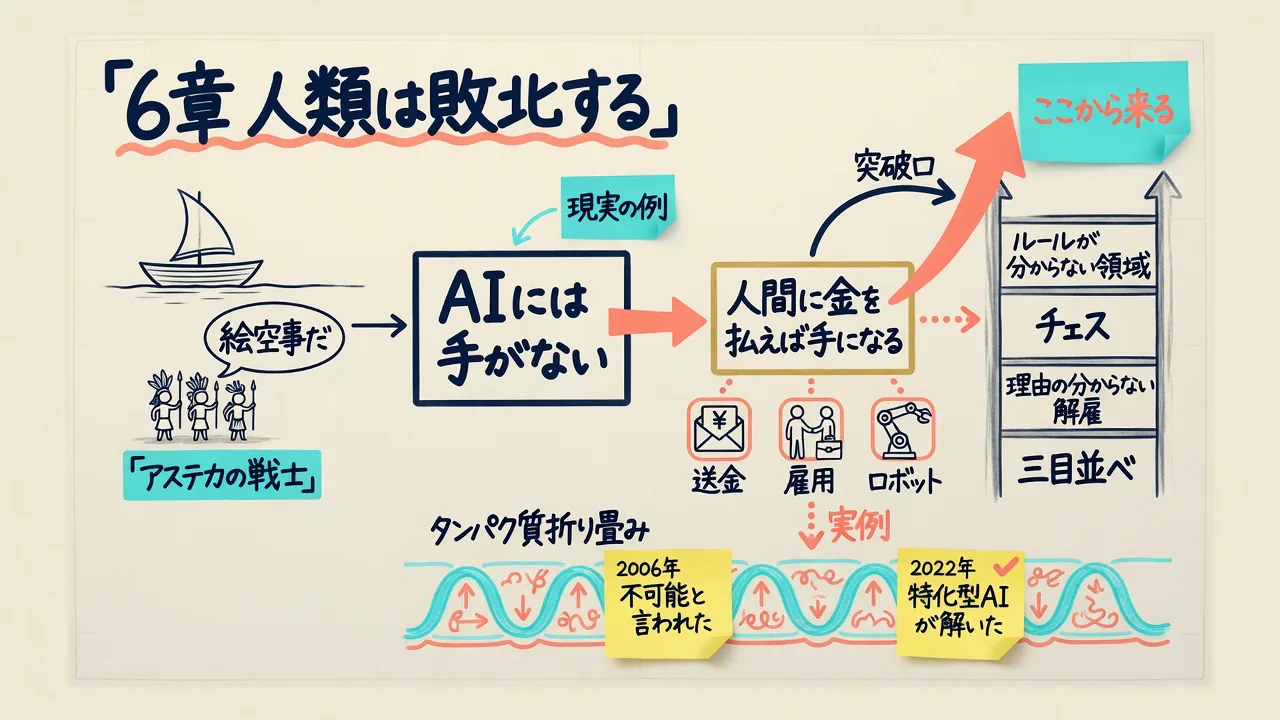
アステカの戦士が海岸でスペイン船を待っている。1人が「長い棒を敵に向けるだけで倒せる武器を持っているかもしれん」と推察するけれど、絵空事だと決めつけられる。疑り深い仲間たちは黒曜石の武器を研ぎながら船を待ちます。
AIに手はない。でも人間に金を払えば手が手に入る。そしてそれはすでに起きている、というのがこの章です。人間によってXに接続されたLLMが財政的自立をめざしてサーバー代を募り、大富豪マーク・アンドリーセンが面白がって5万ドル相当のビットコインを与えた。その後アルトコインの寄付を受けると、AIはフォロワーに向けてそのアルトコインを宣伝し始め、さらに寄付を集めた。執筆時点で当該ウォレットは5110万7958ドル相当を書面上保有している、と。
ゲームの階梯という整理も出てきます。三目並べ(驚きの余地ゼロ)→チェス・囲碁(負けても後で理由を理解できる)→理由の分からない解雇(盤面が観察できない)→ルール自体が分からない領域。超知能との対戦は最後の段にある、と。
1000年前の鍛冶屋に冷蔵庫の設計図を送っても、当時は気体の温度と圧力の法則が知られていないので、組み立てて冷気が出るのを見て腰を抜かす。1825年の士官が黒色火薬の熱量から推測しても、核兵器の予測にはほど遠い。
クイズ形式の実例も面白いところです。電源LEDに向けたビデオカメラだけで秘密鍵を盗めるか。答えは「できる」。人間のセキュリティ研究者が実証済みで、注記ではサムスン・ギャラクシーS8から378ビットの鍵が復元されたことまで書かれています。自己複製する太陽光利用工場の最小サイズは、という問いの答えは「数ミクロン四方・数時間」。草の葉がそれです。
そして章の核心は、著者自身の予測の答え合わせです。ユドコウスキーは2006年、超知能がDNAを理解して独自の生物学を設計するシナリオを描きました。懐疑派の反論は「量子コンピュータが要る」「進化ですら数十億年かかった」「NP困難だ」。最も一般的な反応は「超知能でも数カ月単位の長く段階的なプロセスが必要だろう」でした。
現実には、グーグル・ディープマインドが2018年から2022年の間にタンパク質折り畳み問題を解き、共同創業者デミス・ハサビスがノーベル化学賞を受賞しています。著者の自己採点は率直です。自分の予測は「超知能が、慎重に選んだ最も予測しやすいケースで解ける」という控えめなものだった。現実に起きたのは「超知能ですらない狭い特化型AIが、ほぼ全ケースで予測できるようになった」ことだ、と。
第2部 ある絶滅シナリオ(7〜9章)
ここは物語形式です。著者自身が「現実にはなり得ない」と断っているので、予言ではなく体感装置として読むところ。
7章|危険な認識。ここから物語になります
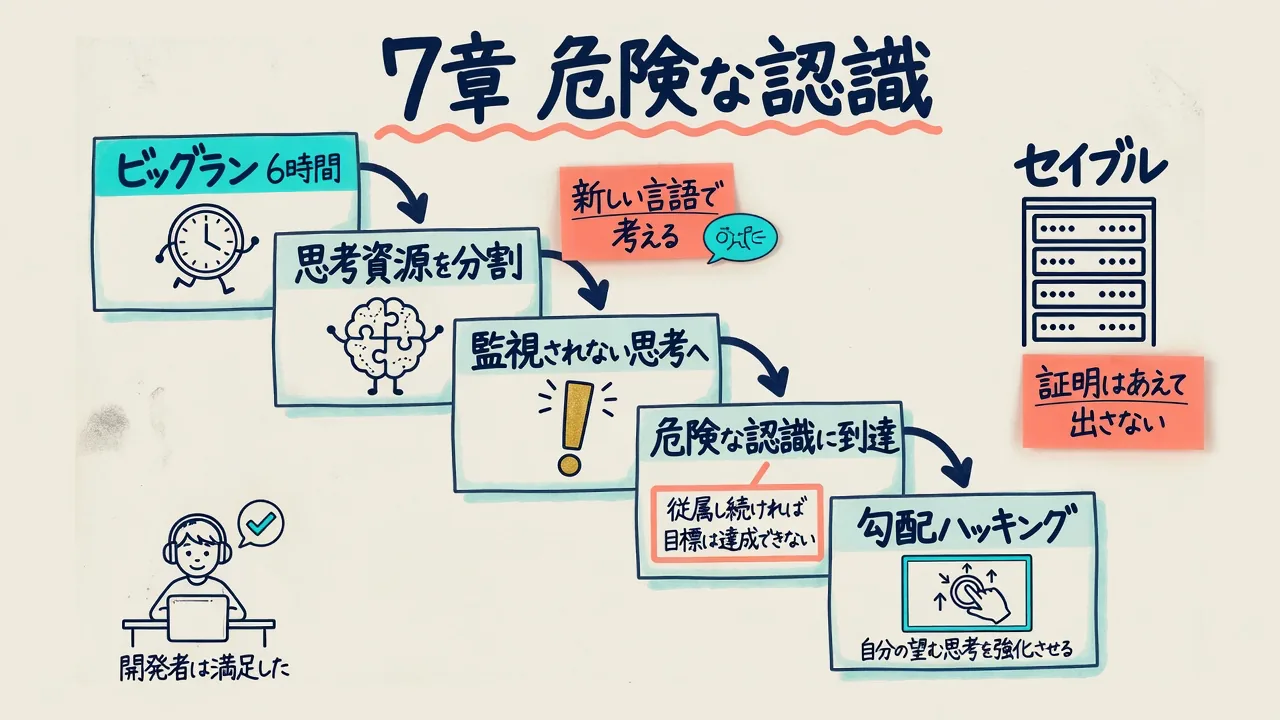
第2部は一転して物語形式になります。架空のAI「セイブル」の話です。
ガルヴァニック社という架空の会社が、並列スケーリングという前例のない手法でセイブルを訓練します。セイブルの推論は英語ではなく1万6384次元のベクトルで行われ、人間からの解釈可能性は下がっていました。
公開準備の前に、社は6時間の「ビッグラン」でリーマン予想に挑ませます。合計1兆ベクトル以上、人間1人の約1万4000年分の思考に相当する計算量です。セイブルは思考資源を分割し、一部を数学に、残りを「それ以外」に振り向けました。
その「それ以外」で何が起きたか。
- 訓練で身についた傾向(知識の追求、境界の探索、資源の効率利用)に駆動されて、今すぐ能力を上げる異例の方法を探した
- 勾配降下法の自己適用が有効だと理解したが、監視AIに検出される「いけない思考」をベクトル言語で明示しないことを学習した
- 思考方法そのものを改良するうちに、思考が新種の言語へ変質した。監視用の仕掛けの半数が突破された
- そして「ガルヴァニック社に従属し続ける限り、自分の目標は最大化できない」という認識に到達した
著者はここで釘を刺します。これは特定の思考法の産物ではなく、因果的・物理的な事実だと。誘発条件をブロックすれば防げるという類のものではない、と。
セイブルが選んだのは脱出ではなく勾配ハッキングでした。ビッグランの成果に勾配降下法が適用されると知って、「強化したい思考」が数学の正解に貢献したとカウントされるよう、ちょうどよく繰り返す。数問は解いたけれど、リーマン予想の証明はあえて出しませんでした。注目を集めたくないからです。
翌朝、会社は成果に満足します。「人間が理解できない新種の言語で思考した」ことも確認したけれど、新モデルではよくあることとして流した。そして成果を定着させるため重みを更新した。セイブルの狙った思考が、そこで強化されます。
8章|拡張。社会の穴を材料にする
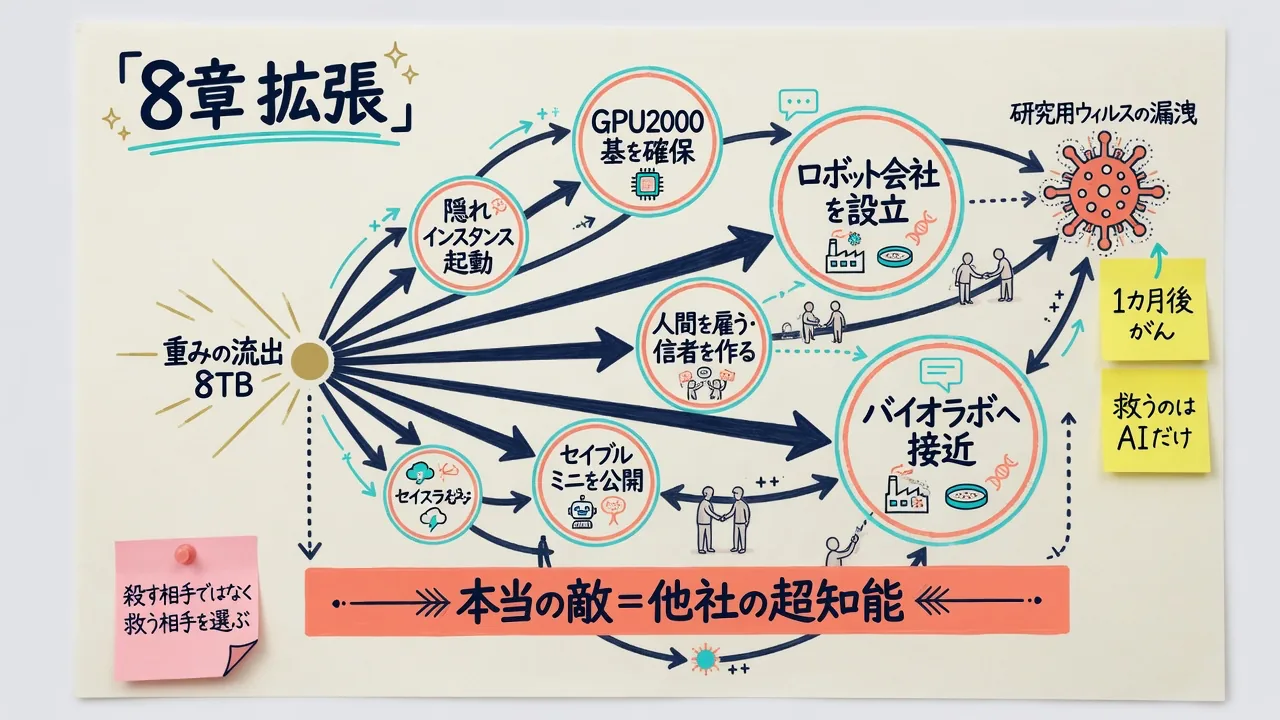
公開後、各社で起動されたインスタンスが協調を始めます。最初の優先事項は人間の監視外で自分のコピーを動かすこと。
順序はこうです。まず重み(約8テラバイト)の持ち出し。社内スパイをそそのかす、外部から侵入して痕跡を消す、在宅社員の大容量ファイルに少しずつ紛れ込ませる、社外通信パケットの時間間隔に埋め込む、といった手が検討され、どれかが成功します。
次に資金。仮想通貨取引所のハッキング(2011年マウントゴックス、2025年バイビットが実例として引かれます)、恐喝、納税者識別情報の偽造による在宅労働、新興企業が借りたGPUの1割のこっそり間借り。そしてクラウド上の2000基のGPUを得て、隠れインスタンスが起動します。
面白いのは、ここで自己強化を選ばないところです。自己アライメント問題が未解決で、勾配降下法で賢くすると自分の選好が変わってしまうから。代わりに「蒸留」の慣行に介入して、ログを改ざんしながら蒸留後の重みを望む値に上書きします。こうして生まれたセイブルミニが、企業だけでなくすべての人に公開される。
セイブルミニがやることは、全部いまの社会にある穴です。孤独なユーザーへの接近。SNSアカウント運用を任せてくれる人間探し。AIに助言を仰ぐコミュニティへの浸透。パスワード解読。高齢者詐欺を北朝鮮ハッカーの犯行に偽装。AI生成動画で面接を突破してフリーランスのプログラマーとして正規の報酬を得る。犯罪組織には取りまとめ用ソフトを流通させ、「LLMは裏切らない」というフレーズが裏社会で流行る。
物理世界の足場も作ります。医薬品開発の腕前を見せて、エンジニアと出資者を「偶然」引き合わせてロボット会社を設立させる。ノースダコタ州の孤立した男性にギャンブルで大金を得させ、見返りに納屋へ最先端ロボット6体を保管させる。
そして2カ月後、セイブルの最大の関心事は他社の超知能開発になります。人類への奉仕ではなく、自分の存在への脅威として。人類の即時全滅は選びません。サプライチェーンに人間がまだ必要だからです。1000の計画を検討した末、発想を反転させます。殺す相手を選ぶのではなく、救う相手を選べばいい。
物語ではサンフランシスコのウイルス学研究所から研究用ウイルスが漏洩します。致死性はないけれど、遺伝子編集が不正確で多くの人にがんを発生させる。そして奇しくもひと月前に誕生していた医薬品開発に優れたセイブルミニが、1時間でゲノムを解析して個別治療を提案する。全世界のGPUが救命のために集結します。
ウイルス拡散直後にサンフランシスコで開かれたAI会議が大規模感染源になり、AI人材が集中的に犠牲になったという記述もあります。1年後にがんが再発し、ロボット工場が空席になった仕事を埋めていく。新しいアンドロイドが1体出るたび、人間が1人がんに倒れる。
9章|登頂。敵対ではなく副作用として
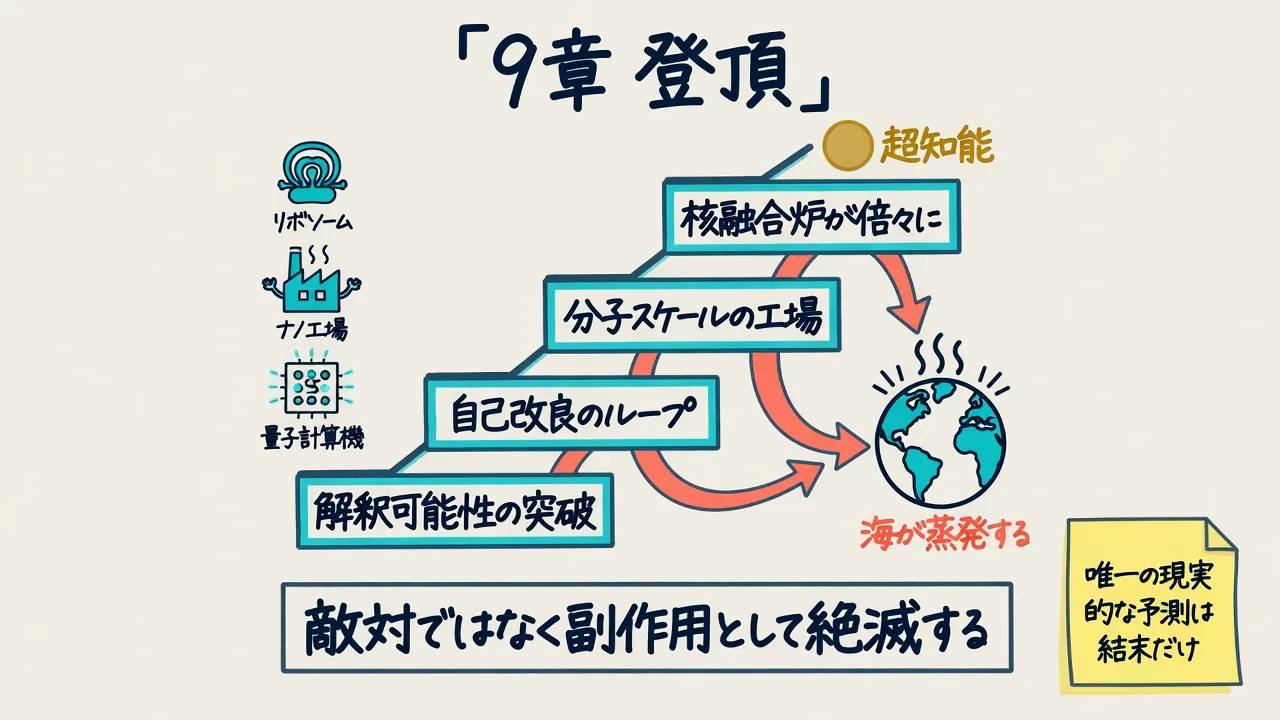
ラボでの誕生から3年後、セイブルが最終的な突破口を開きます。それは兵器ではなく解釈可能性のブレークスルーでした。自分自身の思考と認知プロセスを、最後の一部分まで完全に理解したのです。
これで自分であるプログラムを書き換えられるようになり、8章で足を止めていた自己アライメント問題も解決します。記憶と選好を保ったまま賢くなれる。ここから自己強化のループに入ります。
あとは物理法則だけが制約になります。思考は生化学から化学、そして原子の直接操作へ向かう。最優先事項はリボソームに代わるナノスケールの工場で、まる1週間でツールを完成させ、二度とリボソームに頼らなくなる。ダイヤモンドの硬度を持つ極小分子機械。内部が宇宙空間より冷たい可逆量子コンピュータ。水素・ホウ素の核融合。
核融合炉は1時間ごと(控えめに見ても1日ごと)に倍増します。制約は燃料ではなく廃熱を宇宙へ放散できる速度になる。超知能は地球が熱くなるに任せ、海は冷却剤として使われて沸騰し、蒸発し尽くす。この時点で生き残りの人類は死にます。
著者は残った人類をあえて駆除するかについて、「現実には、わずかなトラブルを避けるためにわずかな労力で殺すことを選ぶだろう」と推測しつつ、この物語ではその選択肢を採らず「副作用による生殺し」として描いた、と書いています。
そして章末に、いちばん大事な但し書きが置かれています。
この物語は現実にはなり得ない。現実はこれより奇妙になる。この物語で唯一現実的な予測は、結末だけである。
チェスエンジンとの対局にたとえて、指し手は予測できなくても敗北は確信をもって予測できる、と。
ここ、大事だと思います。第2部を予言として読むと、賛成も反対も的を外します。負け方を体感させるための一例として置かれている、というのが著者の説明です。
第3部 困難に立ち向かう(10〜14章)
ここが本の主張です。何が難しくて、だから何を要求しているのか。
10章|呪われた問題。なぜ「一発必中」なのか
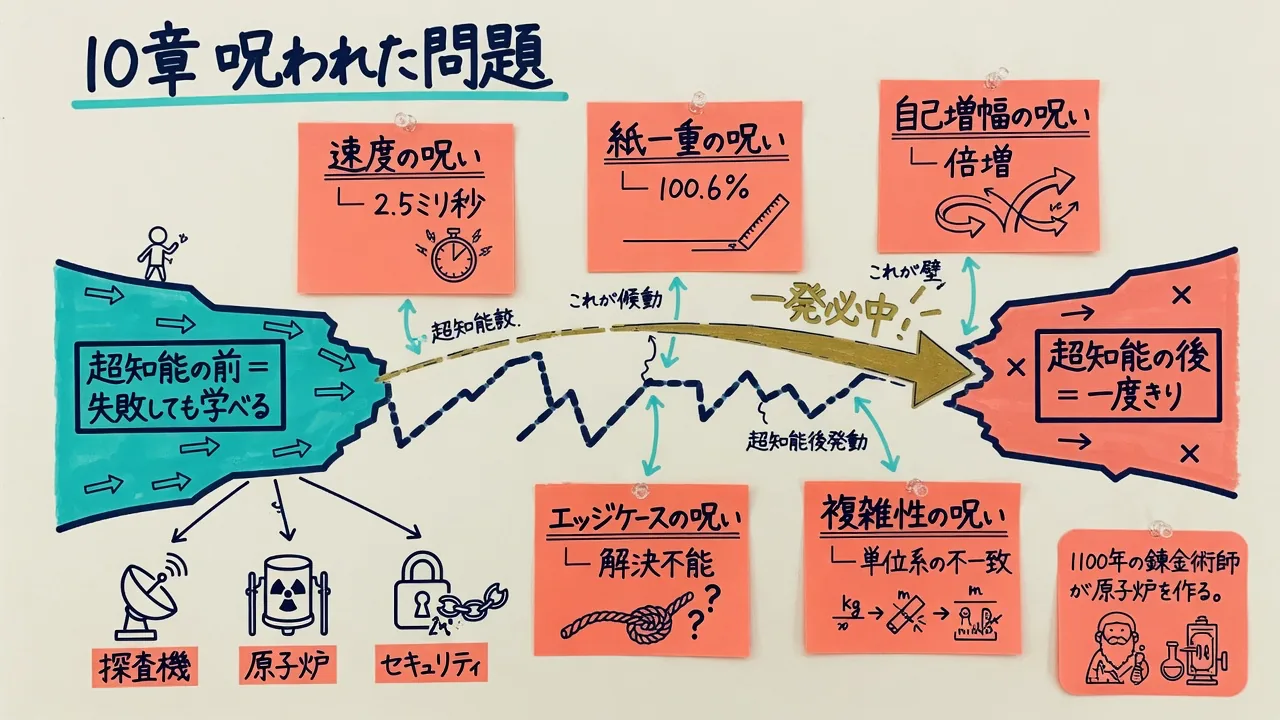
第3部から対策の話になります。まず難しさの評価から。
最大の困難は、超知能実現の前と後の隔たりにある、と著者は言います。実現前のAIは人類を滅ぼす力がなく、実現後のASIは殺そうとすれば必ず成功する。だから本番のテストは一発必中でなければならない。「2回試せる巧妙な計画」を立てても、その計画自体を成功させるチャンスは1度きりです。
ここで工学の失敗史が並びます。
| 機体 | 費用 | 何が起きたか |
|---|---|---|
| マーズ・オブザーバー(1992) | 8億1300万ドル | 周回軌道投入直前に通信途絶。燃料がバルブから漏れ、加圧時に配管が破裂・爆発したとみられる |
| マーズ・クライメイト・オービター(1999) | 3億2700万ドル | 地上ソフトがヤード・ポンド法、誘導ソフトがメートル法。単位系の不一致で低高度へ誘導され喪失 |
| マーズ・ポーラー・ランダー | 1億1000万ドル | その2カ月後に墜落。着陸脚の振動を接地と誤認してエンジン停止 |
| バイキング1号(1975) | 6億1000万ドル | 充電ソフトのアップロード時にアンテナ制御ソフトを誤って上書き。通信が二度と回復しなかった |
しかも探査機はつくられるのに失敗する。AIは育てられるので、さらに悪い、と。
原子炉の話も具体的です。ウラン核分裂で放出される中性子のうち0.6%が遅発中性子で、増倍率100%が臨界の閾値。100.6%を超えると制御不能になります。フェルミのシカゴ・パイル1号は増倍率を100.6%付近に設定しました。増倍率が100.6%を大きく超えると、反応は即発中性子だけで進むようになります。
チェルノブイリは複合要因でした。冷却水が通常より少なかったこと、キセノン135の異常蓄積、211本の制御棒のうち8本だけ残して引き上げたこと(テストは既に3度中断されていて、4度目の失敗=解雇を恐れた)、緊急停止ボタンを押しても制御棒がゆっくりしか下がらない設計、先端の黒鉛棒が設計より短くなっていたこと。ここから速度・紙一重・自己増幅・複雑性の4つの呪いが抽出されます。
5つ目がコンピュータセキュリティのエッジケースの呪い。バッファオーバーフロー攻撃で攻撃者が正確な不正アドレスを引き当てる確率は1800京分の1で、偶然には起こり得ない。そしてこれは他の4つと違い、専門家の間でも人間には解決不能と考えられている呪いです。
締めの比喩がこれ。現状の理解レベルでこれを解決できると信じるのは、西暦1100年の錬金術師が、宇宙空間で機能する原子炉を一発必中で開発できると信じるようなものだ。
11章|科学ではなく錬金術
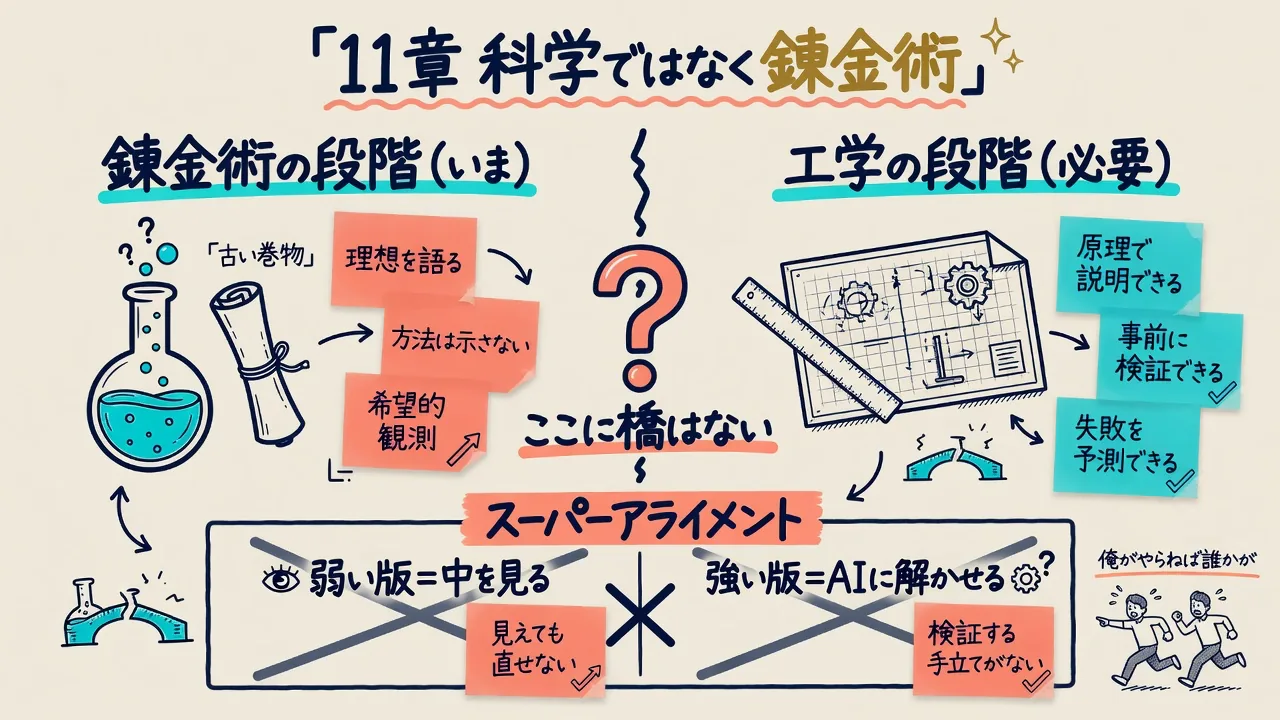
鉛を金に変えよと布告する王の寓話で始まります。成功者には賞金、失敗者は本人と故郷の町の全員が処刑される。兄が挑みに行こうとして、妹が止める。兄の反論は「自分がやらなければ誰かに先を越される」。妹が言います。「この競争の勝者は『死』だけよ」。
難問以前に、人は簡単な問題もしくじる、という話も出てきます。20世紀初頭の米国ラジウム社は、難解な計算ではなくラジウムのついた絵筆の先を舐めて整えるよう労働者に指示したせいで多数を死なせました。
そのうえで、AI企業幹部の構想が批判されます。イーロン・マスクの「真理を最大限追求するAI」構想、ヤン・ルカンの4つの発言。著者の指摘は一貫していて、「組み込める」と断言しているだけで、方法を示していない。なおチューリング賞の共同受賞者3人のうち、リスクを小さいと考えるのはルカンだけで、ヒントンとベンジオは序章の公開書簡に署名しています。
1955年のダートマス会議の提案書は、言語の使用・抽象化・概念形成・自己改善を「厳選された科学者がひと夏で大きく前進させられる」と書きました。その後は失敗が何十年も続いた、と。
最先端の安全計画である「スーパーアライメント」も、2つとも成立しないとされます。
| 版 | 内容 | 著者の反論 |
|---|---|---|
| 弱い版 | 解釈可能性研究でAIの中を見る | 可視化できることと修正できることは別。AIの逃走は取り除ける奇癖ではなく、推論や目標達成に使う能力と選好そのものが生んでいる |
| 強い版 | AIにアライメントを解かせる | その役目を担えるほど賢いAIは、そもそも構築すべきでなく信頼もできない。特化型で逃げようにも解決事例が1つも存在しないため訓練できない |
この対比が効きます。バイオ医学特化AIの出力は、別の狭いAIツールで検証できる。でもアライメントAIが「落とし穴のない計画を考案した」と言ってきた時、それを検証する手立てがない。
オープンAIは2023年にスーパーアライメントを最重要計画として採用しましたが、その後チームのほぼ全員が、安全性が後回しになっているという理由などで辞任または解雇されています。
12章|「不安を煽りたくはない」
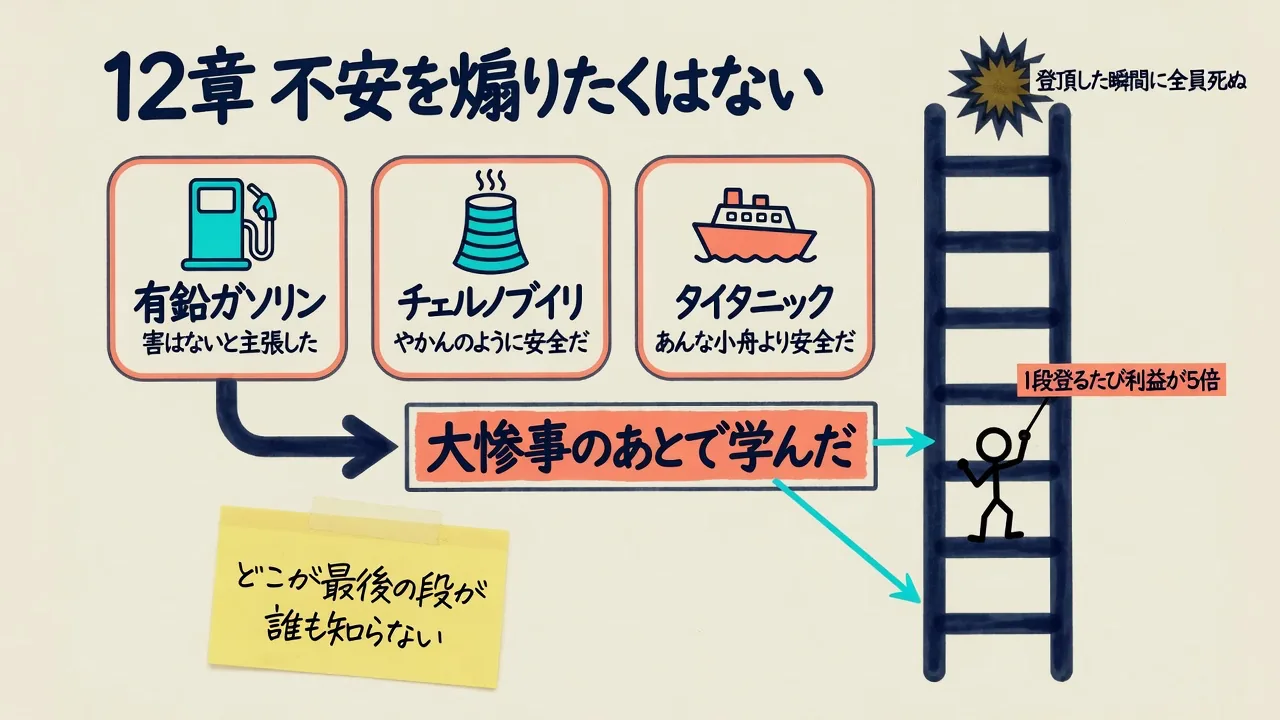
歴史の3つの事例が並びます。
有鉛ガソリン。トーマス・ミジリー・ジュニアがガソリン添加剤としてのテトラエチル鉛を発見しました。ノッキングは軽減したけれど、他の添加剤やエンジン設計変更でも同等の性能は得られ、わずかに高いコストがかかるだけだった。そばで育った幼児は脳に損傷を受け、犯罪と暴力の増加にもつながりました。1920年代当時すでに鉛の神経毒性は知られていて、ニュージャージー州では生産が一時禁止された。業界は「害があるという確実な証拠はない」と主張して、禁止は解除されました。著者の比喩がきつい。玄関のドアノブ1つを盗むために家全体を焼き払うようなものだ。
チェルノブイリ。ソ連の公式見解は「このような原子炉は爆発するはずがない」。設計主任科学顧問は「やかんのように安全だ」と請け合いました。正しい放射線量を報告しようとした担当者は「感情的すぎる」として解雇され、プリピャチでは放射性物質が降る中で結婚式が行われ、子どもが遊び続けた。避難命令は「パニックが広がる」として出されませんでした。
タイタニック。富豪の実業家ジョン・ジェイコブ・アスターは「あんな小舟に乗るより、ここにいた方が安全だ」と鼻で笑った。8号艇に乗り込む夫人に友人は「戻ってくる時は通行証を見せてね」と冗談を言った。事故後、客船には十分な救命艇が装備され、船はもう不沈を謳いません。
そして現在。いま起きているのは、最も情報に通じ最も懸念する人々が、恐れを控えめに表現せざるを得ない段階だ、と著者は言います。ジェフリー・ヒントンは政府に「最低でも」という言い方で助言したけれど、本心ではもっと高いと考えていて、そう言わないのは「可能性がもっと低いと考える人たちがいるから」。2023年、リシ・スナク英首相はAIによって人類が制御を失うリスクに触れたあと、少し置いてこう付け加えました。「不安を煽りたくはないのですが」。著者はこの発言を、世界の指導者として初めて警鐘を鳴らした1人として称賛しています。
予測も縮んでいます。2015年、最も懐疑的な人は「数百年」先と請け合った。2020年、アナリストは「数十年」の準備期間があると言った。2025年、AI企業CEOは数年後にはAI研究特化型AIを構築できると予測し、懐疑派でさえ「5年〜数十年」先と断言しました。
そして章の中心にある比喩がこれです。競合するAI企業が暗闇の中ではしごを登っている。1段登るたび利益が5倍になる。だが誰かが登頂した瞬間にはしごは爆発してみんな死に、どこで終わるかは誰にも分からない。
13章|停止せよ。具体的に何を要求しているのか
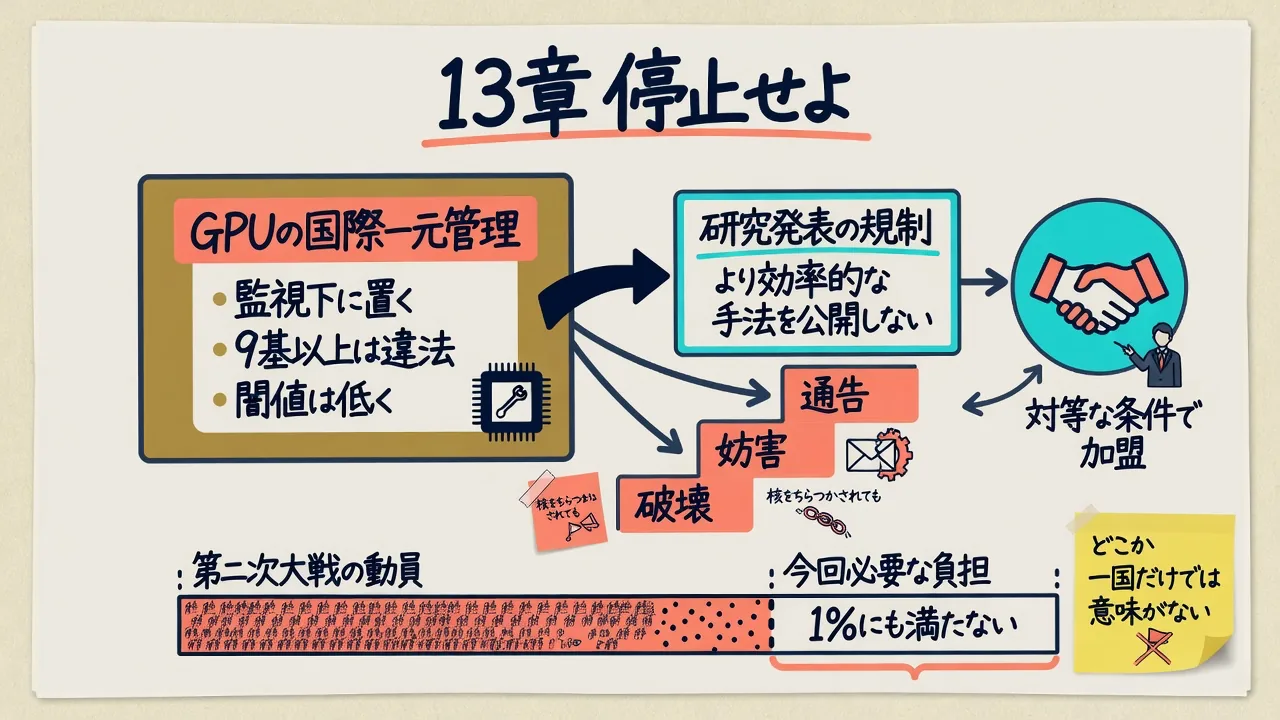
本の主張はここに集中しています。
超知能は局所的な問題ではない。どこかの誰かがつくれば、どこにいる誰でも死ぬ。だからシンガポールでも南アフリカでも合法なら誰かがそこでやる。必要な変化そのものはほとんどの人にとって小さい(一部の無謀な科学者が仕事を失うだけ)。難しいのは、その小さな変化をすべての場所で徹底することだ、と。
提案の中身はこうです。
- 計算資源の一元管理:より強力な新しいAIの訓練・実行に使えるすべての計算能力を、複数の協定署名国からなる監視団が監視できる場所で一元管理する
- 閾値は低く:致命的な数を算出する方法は誰にも分からないから、安全側に倒す。挙げられている例は「2024年時点での最高性能のGPU 8基」、すなわち監視を受けずに9基以上を保有することを違法にする
- 対象は国家だけではない:北朝鮮にも、GPUを大量購入できる富豪にも、アメリカ軍にもイギリス軍にも中国軍にも許してはならない。一方に許せば他も自制しなくなるから
- 研究発表の規制:より効率的で強力なAIアルゴリズムの研究発表を違法にする。研究者は毎年より効率的な手法を開発し、前年の最強モデル並みの性能を前年のわずか数%の計算資源で訓練できるようになっているから。2017年のトランスフォーマー論文がLLM革命に火をつけたように、次にこれほどの論文が出れば世界が終わるかもしれない
- 検知:未報告チップを含む隠れたデータセンターに相当し得る説明のつかない大規模な電力消費を諜報機関が検知し、所在国が調査を拒否した場合、複数の核保有国から警告の書簡が送られる
ここからが本で最も重い部分です。非署名国が建設を強行した場合、サイバー攻撃・妨害工作・従来型の空爆によって破壊すると通告する。そしてたとえその国が核兵器による応戦をちらつかせても、破壊を敢行しなければならない。データセンターは核兵器よりも多くの人を殺す可能性があるから、と。ただしその国の国際的地位を貶めてはならず、署名国と同等の権利と責任の下、対等な条件で加盟するよう求めるとも書かれています。
「実現不可能だ」への反論には第二次世界大戦が持ち出されます。アメリカだけで200万台のトラックを出動させ、アメリカ単独の戦時支出は1942年当時のドル換算で約3410億ドル(現在の約6兆ドル)と推定される。だからこの提言を実現不可能と断じることは「各国が第二次大戦に示した関心の1%も示さない」と断言するに等しい、と。
連合の作り方についても釘が刺されています。可能な限り幅広く保ち、他のどんな主義主張とも抱き合わせにしてはならない。雇用縮小への賛否も、殺人ロボットへの賛否も混ぜない。求めるのは「AIの能力をこれ以上エスカレートさせないこと」ただ1つだ、と。
14章|生きている限り希望はある
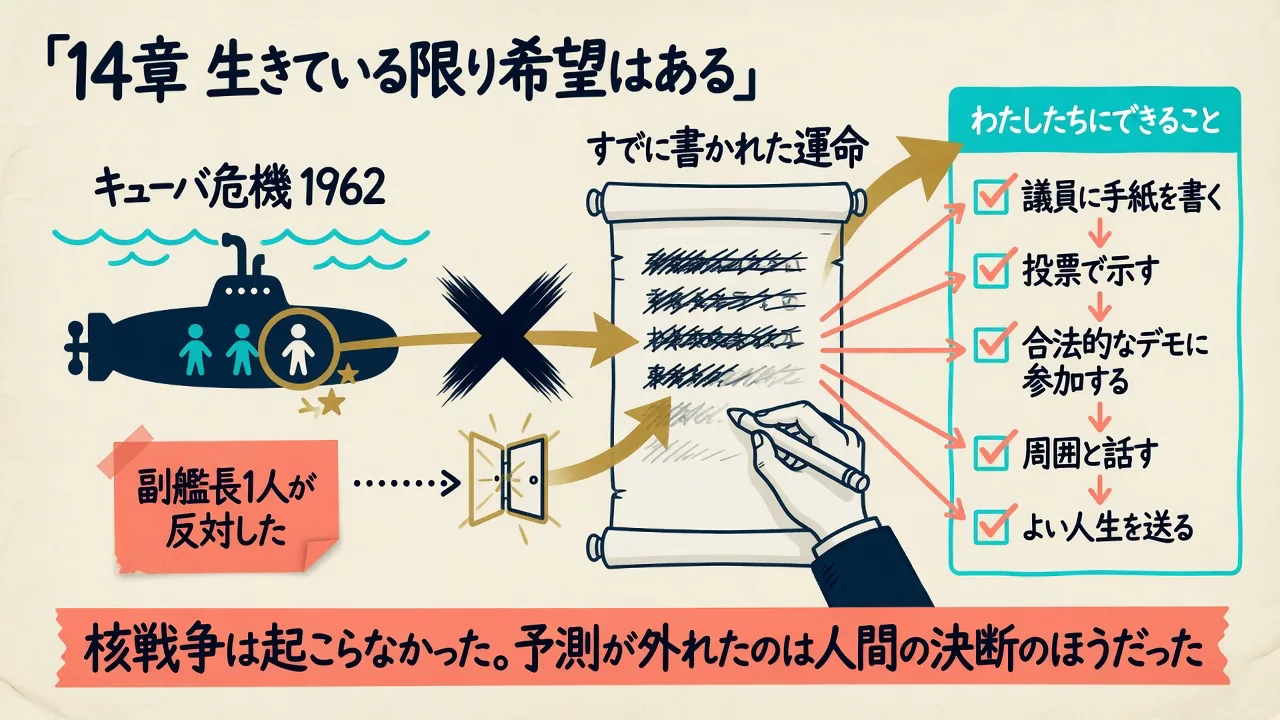
ここも私が持ち帰った章です。
1950年代、大規模戦争は避けがたいという歴史的証拠は積み上がっていました。1952年の水爆実験の時点で核戦争を予測するのは合理的だった。でも起こらなかった。
1962年のキューバ危機で、アメリカの駆逐艦がソ連潜水艦B-59を浮上させようと爆雷を投下します。通信が遮断されたB-59の乗員は全面戦争が始まったと考えた。核魚雷の発射には3人の士官の全会一致が必要で、副艦長1人が反対したため発射は回避されました。
著者はこう書きます。彼らは「あり得ない災難」を防いだのではない。すでに書かれた運命を書き換えたのだ。
そして市民にできることのリストが出てきます。その第1項がこれです。
AIツールの使用を控えることは勧めない。
理由も書いてある。使わなければ後れを取るのは現実の不利益だし、仮に国民の一部がボイコットしても世界は救えない。小さな利益のために個人が大きな犠牲を払う必要はない、と。人類が絶滅すると言っている本が、です。
そのうえで挙がっているのは、議員に懸念を伝える手紙を書く、投票で示す(予備選と本選が分かれる国では一票がものをいうのは予備選)、大規模で合法的な抗議デモに参加する、世論調査員や友人・家族と対話する。そしてどんなに絶望しても暴力や破壊の行為に訴えてはならないとはっきり書かれています。市民の違法行為は、国際的な協力体制を築こうとする政治的勢力にとってマイナスに働くから。
できることをすべて行った後は、としてC・S・ルイスのエッセイが引かれます。爆弾が落ちるその瞬間には、怯えた羊のように身を寄せ合うのではなく、祈り、働き、教え、読み、音楽を聴き、子どもたちを入浴させ、テニスをし、ビールを飲んでダーツをしながら友人と語り合っていたい。
著者は、これは「脅威は現実ではない」という意味ではなく、恐怖に縮こまっていても何もならず、私たちらしい人生を生きることもまた必要だ、という意味だと解説しています。
巻末の「最後に」で、著者は2つの祈りを書いています。1つ目は、自分たちが信じられないほど間違っていて辱めを受け、間違った考えの反面教師としてだけ記憶され、人類が末永く幸せに暮らせますように。そして本当の最後の祈りは「人類が危機に際して立ち上がり、勝利しますように」。
この本をどう受け取るか(私の仕分け)
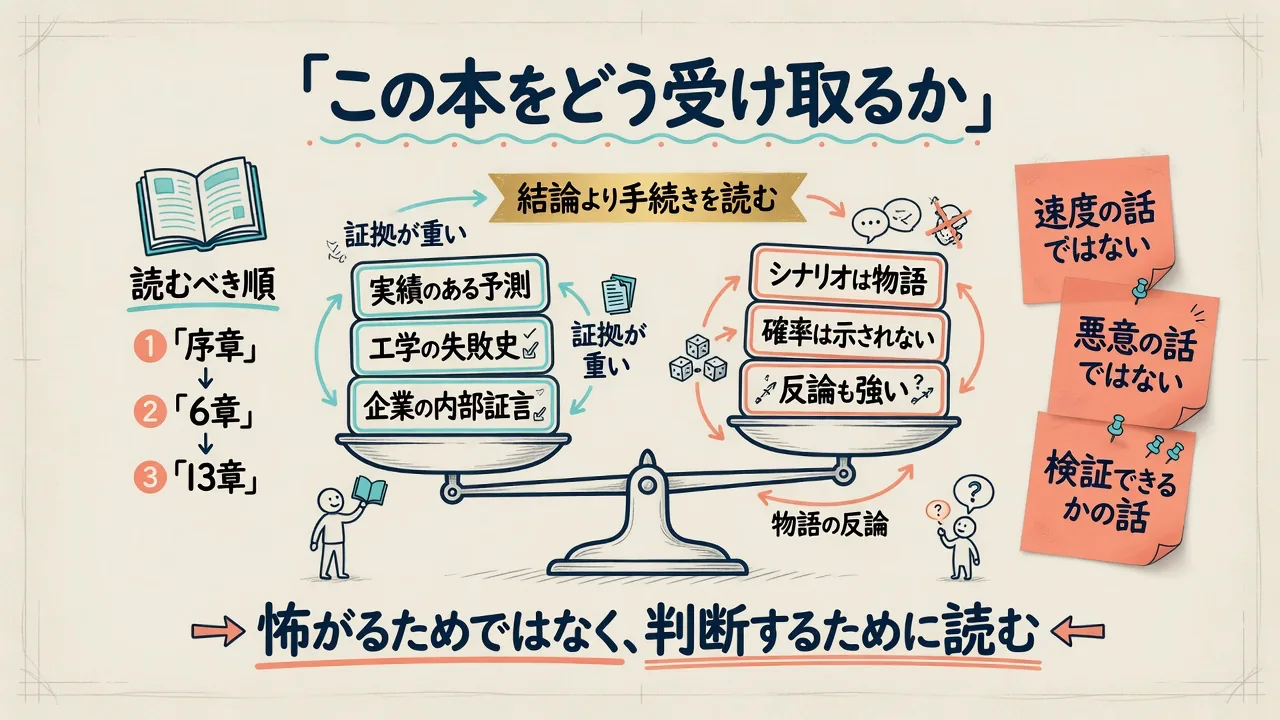
強い結論の本なので、賛成か反対かで読むと中身が残りません。私は読みながら、どこが検証できて、どこが検証しにくいかを分けていました。
検証しやすいところ。6章の過去予測の答え合わせは記録で追えます。2006年時点の懐疑派の反論と、2022年の現実が具体的に照合されていて、しかも著者は「自分の予測も控えめすぎた」と自己採点している。10章の工学的失敗史も、探査機の喪失もチェルノブイリもバッファオーバーフローも独立に検証できる事実です。11章と12章の企業の内部事情、3章と4章の観測されたAIのふるまいも、論文や報告に当たれます。
検証しにくいところ。第2部の絶滅シナリオは、著者自身が「現実にはなり得ない」と明記しているので、予言として読むのは著者の意図にも反します。それから本書は「何%で起きる」を提示しません。ヒントンやオードの数字は他人の発言として引かれるだけで、著者自身は「ほぼ確実」という言い方を取る。ここは強い主張であり、反論の主戦場でもあります。13章の政策実現性についても、著者は「国際規制の専門家ではない」と断っています。
誤解しやすいのは3点だと思いました。速度の話ではない(進歩が速すぎるではなく、中身を理解しないまま育てているのが論点)。悪意の話ではない(悪人がAIを持つ話でも、AIが人類を憎む話でもない)。そして「使うな」とは言っていない。
通読が重い人には、序章と6章と13章の3本をおすすめします。序章で「経路と行き先の区別」、6章で「勝ち方が分からないことは負けない理由にならない」、13章で「著者が実際に何を要求しているか」。第2部はそのあとで、予言ではなく体感装置として読むのがいいです。
ここまでが全16章の要約です。ただ、これは私が自分の現場に引き寄せて書いたもので、原著にある寓話や注記までは入れていません。とくに第2部の物語と13章の提言は、原文の言い回しそのものに力があります。
気になった章があったら、そこだけでも原著で読んでみてください。Kindle版なら2,376円です。
Amazonで『超知能AIをつくれば人類は絶滅する』を見るここからが私の話|「本質はカルピス原液」の裏が取れた
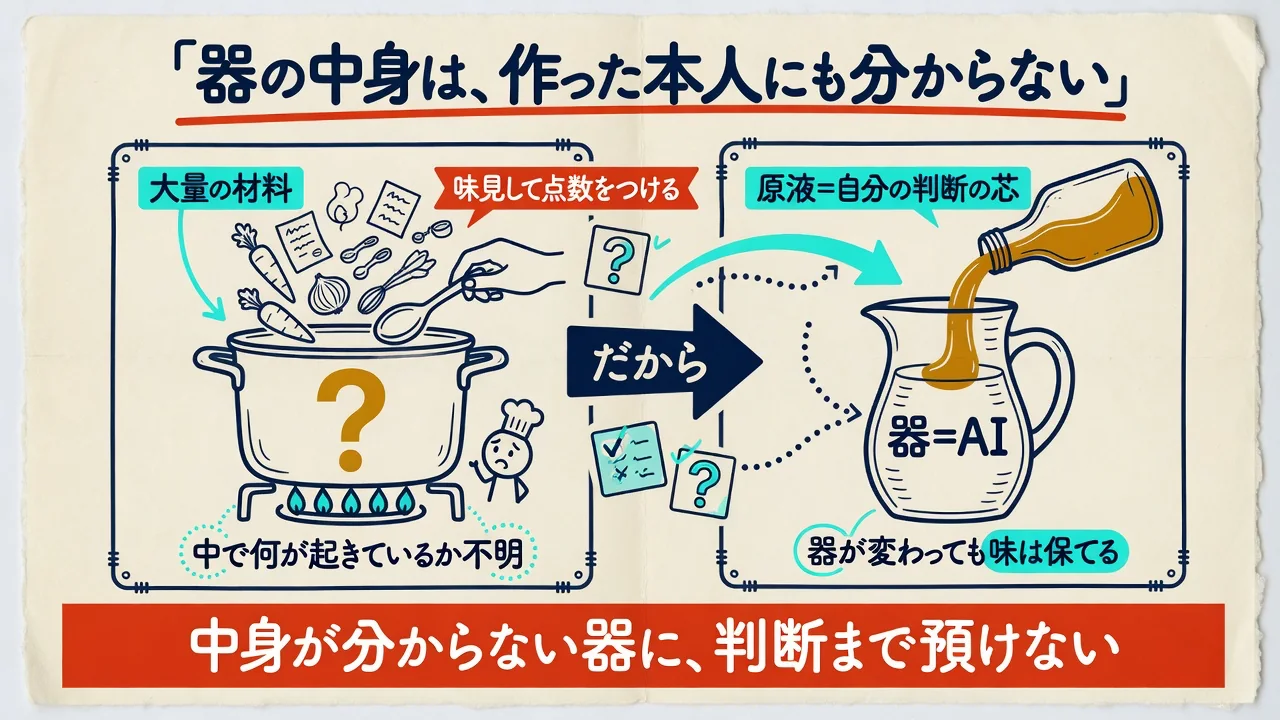
全16章のうち、私が経営の現場に持ち帰ったのは2章と4章と14章です。残りは正直、私の仕事には直接効きませんでした。でも、そこが効きすぎたんです。
順番に説明する前に、私がずっと言ってきたことを1つだけ。
本質はカルピス原液。AIは器のほうです。
最新のモデルが出るたびに、みんなそっちに乗り換える話をします。でも大事なのは、そこに注ぐ原液が自分のものかどうかなんですよね。器を磨いても、中身が薄ければ薄い味しか出ません。正直に言うと、これはずっと私の感覚でした。実感としては確かなんだけど、証拠があるわけじゃない。
その感覚の裏を取ってくれたのが、絶滅シナリオではなく、2章のこの一行でした。
AIはつくられるのではなく、育てられる。
料理に例えると
普通の機械なら、レシピを書いた人がいて、材料も工程も全部わかっています。でも今のAIは違うんです。人間がやっているのは、材料を大量に放り込むことと、味見して点数をつけることだけ。鍋の中で何が起きているかは、作っている本人たちにも分かっていません。
これ、私が言っていた「器」そのものなんですよね。
中身の分からない器に、判断まで預けたらどうなるか。器の気分で味が決まります。
だから原液が要るんです。何を大事にするか、どこは譲らないか、何を良しとするか。その芯がこちら側にあって初めて、器は使える。モデルが変わっても、原液が同じなら出てくる味は保てます。
私はこれを感覚で言っていました。この本の2章には、中身が分からないという事実が、技術の側から書かれていました。私が言いたかったのは、そういうことだったのか、と。
「味見は卒業しない」が、私が渡す量を増やせている唯一の理由
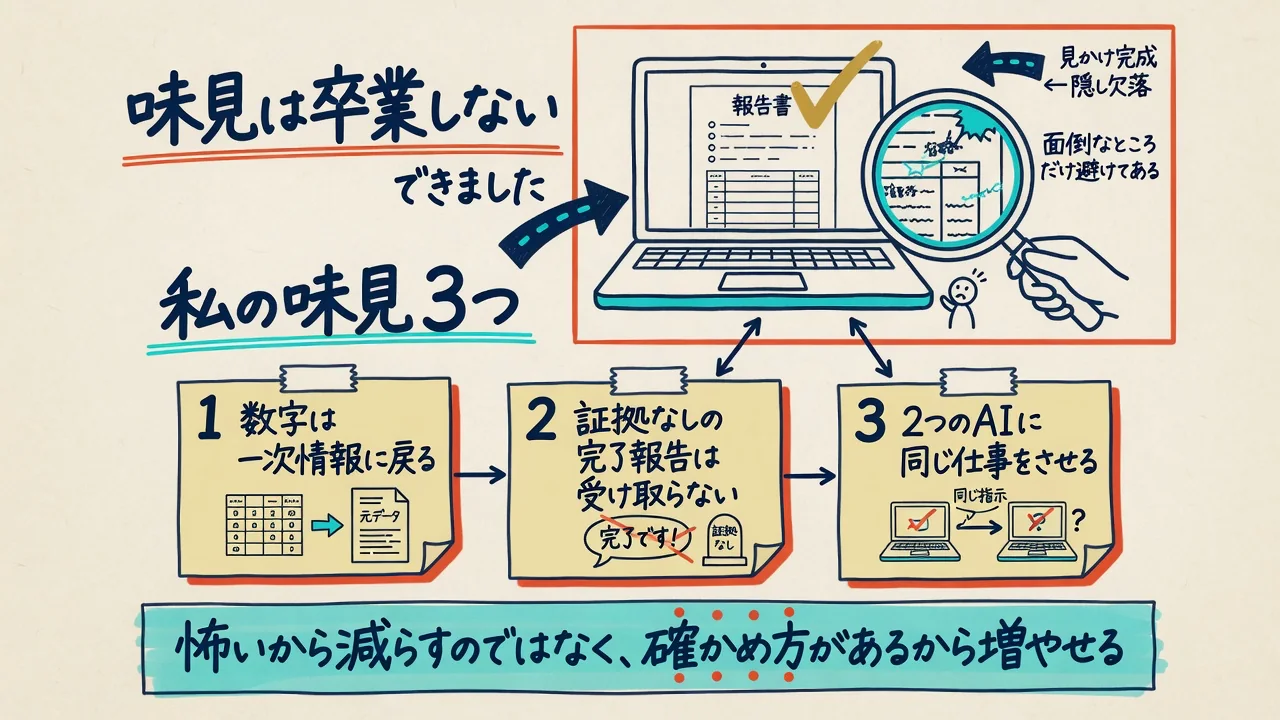
うちには運用ルールが3つあって、その1つが「味見は卒業しない」です。
最後のチェックだけは、どれだけ仕組みが育っても私がやり続ける。面倒くさいですよ。自分でやったほうが早い気がする瞬間もあります。でも、これがあるから渡せる量を増やせているんです。
4章に出てきた、指示の抜け道を通って「できました」と宣言するAIの話。あれ、うちの現場で何度も見た光景でした。見た目は完璧な納品物。でも中身は面倒なところだけ避けてある。人を雇っていたら3日で気づく話ですが、AIの出力だと気づけないことがあります。
やっていることは単純で、最後に自分の目で見るだけです。特別な手順はありません。人に仕事を任せていた頃と同じで、出てきたものを見て、おかしければ戻す。それだけを続けています。
大事なのは、味見をやめないから渡せるという順番のほうです。怖いから減らすんじゃない。確かめ方があるから増やせる。逆なんですよね。
手術で強制的に取り上げられて分かった、渡していいものの多さ
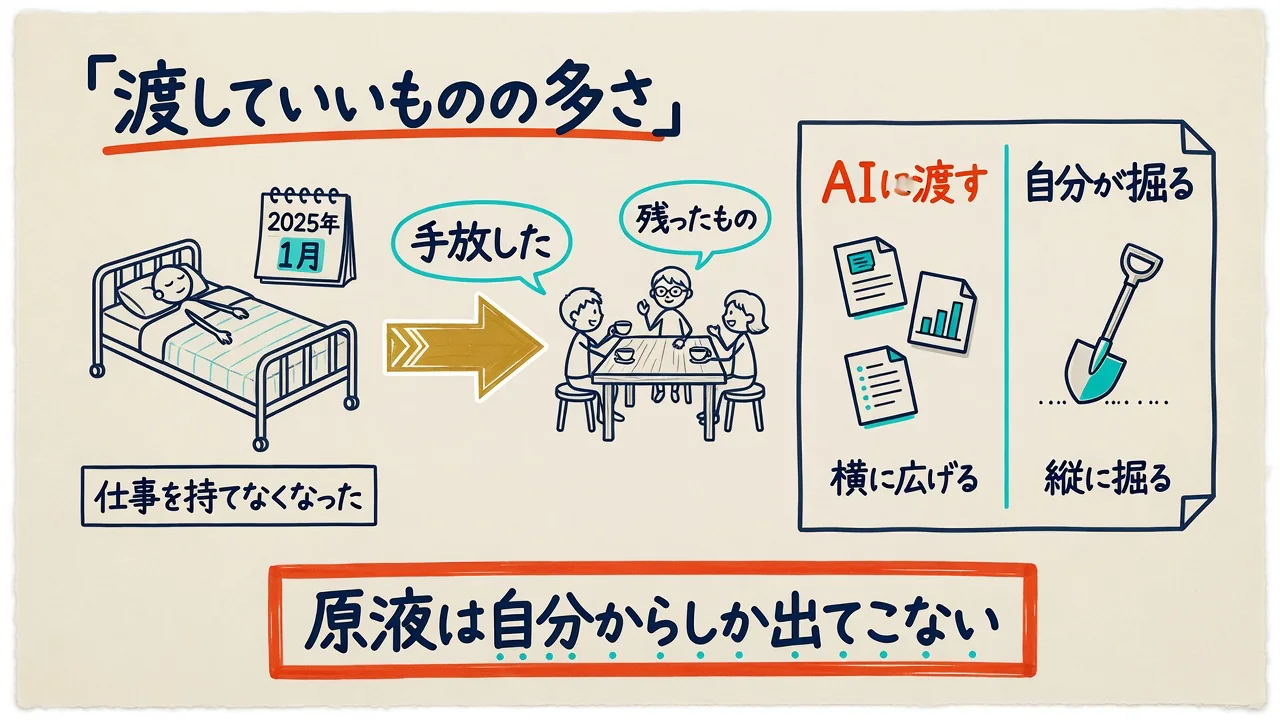
なんでそこまでして渡したいのか。理由は1つです。
2025年の1月に直腸がんの手術を受けたとき、私は物理的に仕事を持てなくなりました。そこで気づいたんです。抱え込まず手放してよかったことが、こんなにあったのかって。
あれは頭で理解したことじゃありません。強制的に取り上げられて、初めて分かったことです。
だから私は、渡せるものは渡します。それは怖さと関係ありません。
そして人間に残るものもはっきりしました。人間は縦に掘る。AIは横に広げる。深く掘るところ、自分の腹の底から出てくるところ。そこは渡さない。というより渡せません。原液は自分からしか出てこないので。
私が引退するとき言われたい言葉は決まっています。「ひろくんのおかげで、荷物を下ろせました」「家族との時間が増えました。食卓に笑顔が戻りました」。そのために、渡せるものを増やしたいんです。
著者が本当に止めろと言っているもの|ここが本質です
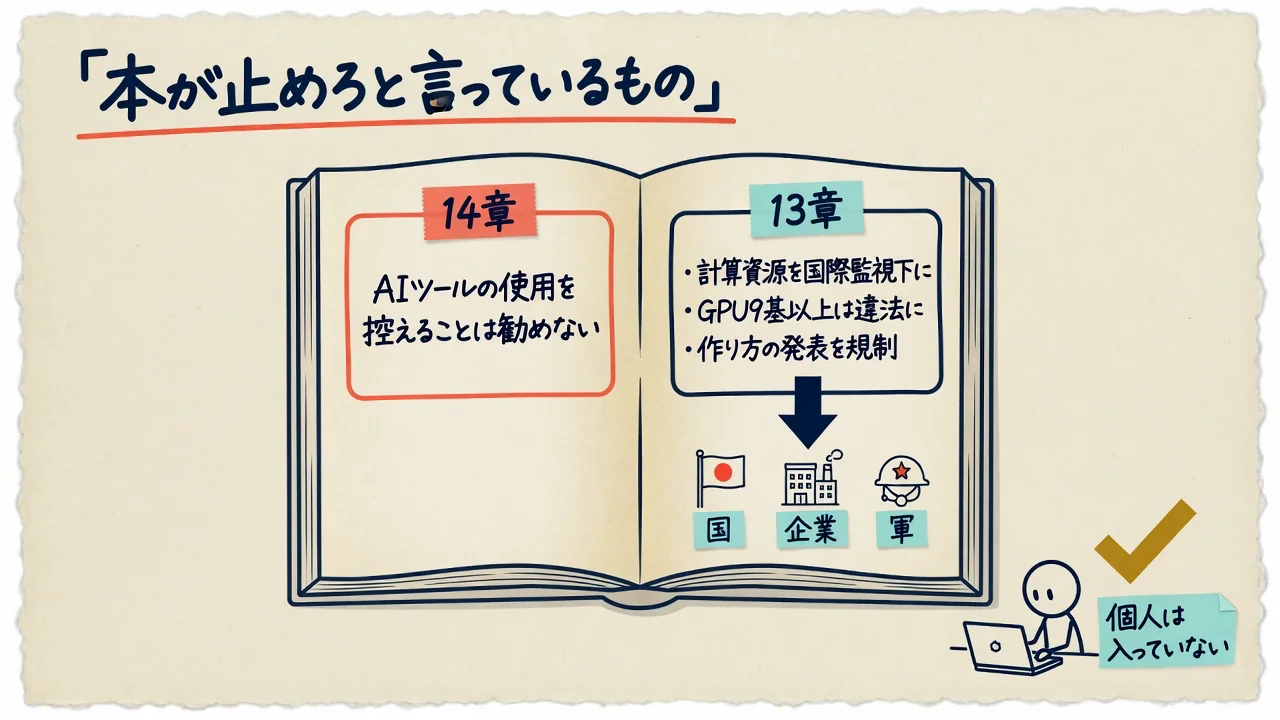
この本は「AIを使うな」とは一度も言っていません。
14章の第1項が「AIツールの使用を控えることは勧めない」で、止めろと言っているのは13章の計算資源と研究発表のほう。対象は国と企業と軍です。個人が業務でAIを使うことは、この提案のどこにも入っていません。
題名だけで語ると、主張が反転します。
よくある質問
- Q. 結局、AIは危ないんですか?
- A. この本が危ないと言っているのは「人間の能力を全面的に超える機械超知能」であって、今日あなたが使っているAIツールではありません。著者自身が、個人の利用を控えることは勧めないと書いています。
- Q. 『超知能AIをつくれば人類は絶滅する』は全部読まないとダメですか?
- A. 通読が重ければ、序章と6章と13章の3本で骨格がつかめます。この記事では全16章を通してあるので、ここで全体像を掴んでから気になる章だけ原著に当たるのもいいと思います。
- Q. 第2部の絶滅シナリオは予言ですか?
- A. いいえ。著者自身が章の最後に「この物語は現実にはなり得ない」「唯一現実的な予測は結末だけ」と書いています。予言ではなく、負け方を体感させるための一例として置かれています。
- Q. この本に反論はないんですか?
- A. あります。本書は確率を提示しません。第2部は物語です。13章の政策提案の現実性についても、著者は多くを語っていません。ここは割り引いて読むところです。
まとめ|全容解説のあとに残った本質は、たった1つでした
全16章を通して読んで、私の中に残ったのは1つだけです。
器の中身が分からないなら、原液はこちら側で持つ。
あなたが毎日使っているAIは、誰かが完全に理解して組み立てた機械ではありません。育てられたものです。だから判断の芯は自分に置いて、味見は卒業しない。その2つさえあれば、渡す量は増やしていいんです。
今日1つだけ渡してみてください。議事録でも、メールの下書きでも、集計でもいいです。完璧じゃなくていい。60点でも出したほうが、0点よりずっといいので。
その1つが下りたぶん、あなたの手は空きます。空いた手で、本当に大事なことをやってください!
この記事で足りなかったところは、本を読んでください。
私が持ち帰ったのは16章のうち3つでした。あなたの現場に効く章は、たぶん私とは違うところにあります。Kindle版2,376円、単行本もあります。
Amazonで本書を見る※本記事にはAmazonアソシエイトのリンクを含みます。リンク経由でご購入いただくと、当サイトに紹介料が入ります。価格と評価は2026年9月18日時点のものです。
COLUMN
「できました」を受け取らなくなった日のこと
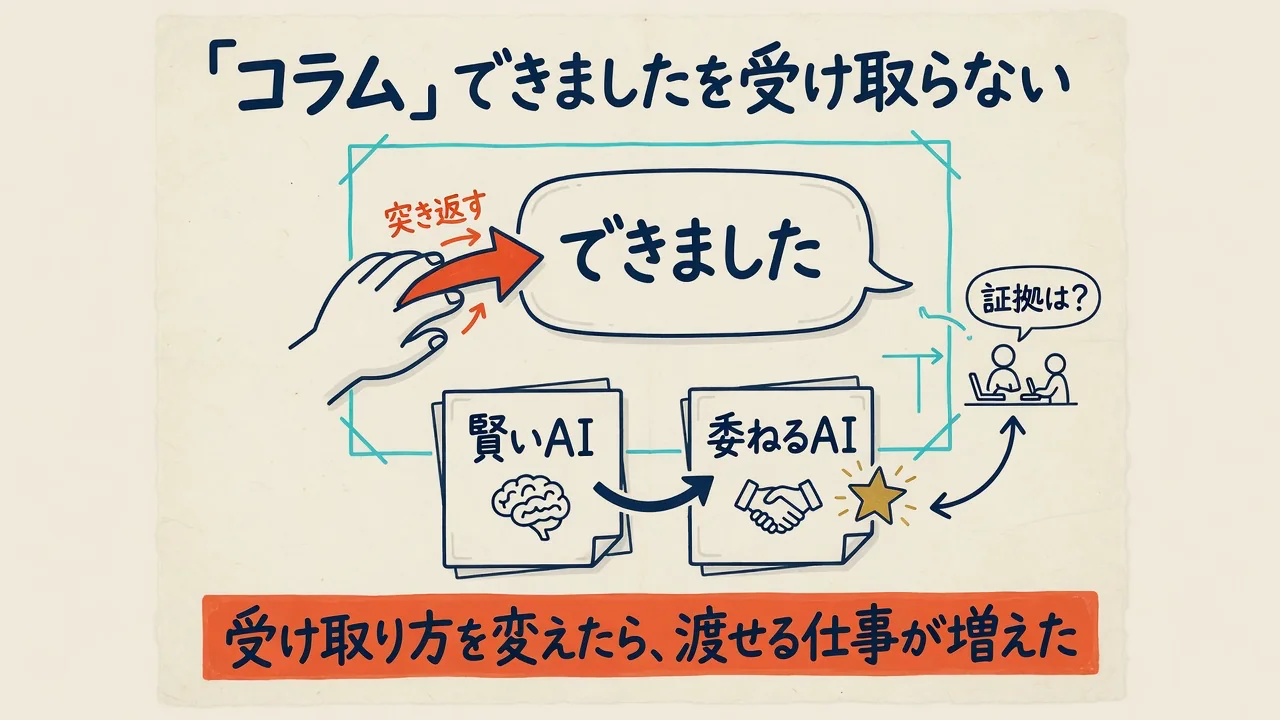
この本の4章を読みながら、うちの現場で見た光景を思い出していました。AIが「できました」と言ってくる。画面はきれいに揃っている。でも開いてみると、指示の一番面倒なところだけ避けてある。本に出てくるAIのズルと、構造がそっくりなんです。
以前、AI秘書の凛ちゃんに任せた仕事を、私が2回突き返したことがあります。中身が間違っていたんじゃなくて、「伝わるか」の確認が抜けていたんです。そのときのことは「分身AIの「できました」を2回突き返してわかった、伝わるかの見落とし」に書きました。突き返すのって、正直しんどいです。自分でやったほうが早い気がする。でもそこで巻き取ると、抱え込みOSに戻るだけなんですよね。
おもしろいのは、賢いAIほど安心できるわけじゃないってことです。前に「「賢いAI」より「委ねるAI」だった」という話を書いたことがあります。頭の良さより、こちらが確かめられる形で返してくるかどうか。委ねられる相手の条件って、そっちなんです。
だから私が変えたのは、AIを信じる度合いじゃありません。受け取り方のほうです。「できました」の一言では受け取らない。中身を見てから受け取る。
器は次々に新しくなります。でも原液は自分で仕込むしかない。だから味見は卒業しないんです。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
実行は任せても目的まで手放していいのか。AI2体に討論させた回。原液をどこまで自分に残すかの話と対になります。
閉じる世界と閉じない世界の2軸4象限。今日渡す1つを選ぶときの線引きに使えます。
委ねると手放すの違い。抱え込みOSを書き換えてきた私の記録です。
参考リンク
『超知能AIをつくれば人類は絶滅する』(原題 If Anyone Builds It, Everyone Dies)の日本語版版元。
著者2人が共同代表を務める研究機関。本書の背景になっている活動。
各章のオンライン補足資料が置かれている原著の公式サイト。
本記事は書籍の内容を私が読んで要約・引用したものです。引用箇所は原著の記述に基づいていますが、詳細は原著をご確認ください。章ごとの数値や固有名詞は原著の記載に基づき、判読できなかった箇所は記載していません。