WATCH REPORT
Jevの5つの主張を
Julian Goldieさんの動画から実機で確かめてみた
2026.09.24
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、Julian Goldieさんの1時間講座「Jev AI Full COURSE 1 HOUR」で語られていた主張のうち5つを、実際に手元で確かめてみました。
動画で紹介されていた主張は数多くありますが、すでにai-kidou.jpの既存記事と重ならない項目に絞って、検証する5項目は私が決めました。実際に手を動かしたのはAI秘書の凛ちゃんです。
- 検証日: 2026-09-24(JST)
- 経路: Vercel AI Gateway(
typesafe-ai/jev)経由。公式の evaluation API を使用 - データ: 中心はダミーデータ(正解ラベルもAI秘書の凛ちゃんが作成)。内部リンクの検証だけ、ai-kidou.jpの公開記事を使用
Jev(ジェブ)というAIモデルは、文章を一切書きません。渡された選択肢から1つ選んで、「どれくらい自信があるか」を数字で返すだけ。この「選ぶだけ」の役割を大きなAIから切り離すと、AIエージェントの速さと費用がどう変わるのか。動画の実例と数字に加えて、5つの主張を実際に確かめた結果も合わせて見ていきます。
Julian Goldieさんの動画から実機で確かめた結果の早見表(5項目・一番伝えたいのは②)
| 検証した動画の主張 | 結果 | 何がわかったか |
|---|---|---|
| ②自信の数字は正解率と連動するか | 自信0.6以上21/22正解(95.5%)/0.6未満4/8正解(50%) | 線を引けば、間違いが起きやすい方を絞り込めた |
| ①まとめて聞いても遅くならないか | 1問126.5ms/5問116.0ms/10問127.0ms。ほぼ同じ | まとめて聞いても速さは犠牲にならない |
| ③質問の名前は見えているか | 名前だけ逆にしても確率差は最大0.02。指示文を逆にすると平均0.551に動いた | 名前ではなく指示文で判断が動く |
| ④言い終わる前に決まるか | 10文中4文が最後の文節より前に正しい判断(10文とも、どこかの時点で正解) | 4割は言い終わる前に決まった |
| ⑤内部リンクで「なし」を選べるか | 合う記事なし10件中8件で「なし」を選択。2件は無理にリンク | 「なし」を選べたが10割ではない |
検証画面の録画(4倍速・2分12秒)
3行でわかるポイント
- AIエージェントの仕事の多くは「次はどれ?」のような小さな判断。今はそれも大きな「書くAI」に数秒とトークンを払って聞いている
- Jevは書かない代わりに0.1〜0.5秒で答えと自信の数字を返す。入力は100万トークンあたり0.042ドル、出力は無料
- 自信の数字に線を引けば「線より上は自動、下は人に回す」ができる。今回の実機検証でも、自信0.6以上は21/22件が正解でした
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・8,800名突破!)出典: Jev AI Full COURSE 1 HOUR (Build & Automate Anything)(Julian Goldie SEO・2026年9月20日公開・64分)
「教授に郵便物の仕分けをさせている」。書かないAI Jevの役割
AIエージェントに「このメールは急ぎ?」「次はどの工程?」のような小さな判断まで、毎回、文章を書く力を持った大きなAIに聞かせていないでしょうか。Jevは、その役割そのものを引き剥がすために作られたAIモデルです。
Julian Goldieさん
“Claw and jeeps are like professors. They’re great at thinking, planning, writing, fixing tricky things. But your agents also hand them hundreds of tiny choices… that’s like paying a professor to sort your mail.”(57:01・自動字幕ママ。文脈から「Claude and GPT-6 Astra」の聞き取り違いとみられる)
訳: 「クロードやGPT6アストラは教授みたいなものです。考えたり、計画したり、文章を書いたり、難しいことを直したりするのは得意。でも、あなたのエージェントは何百もの小さな選択も、その教授に渡している。それは、教授に郵便物の仕分けをさせているようなものです」
「教授に郵便物の仕分けをさせている」という例え、地味に効きました。私が魂磨きでたどり着いた役割分担の考え方に、縄文と弥生というたとえがあります。人間が内側のワクワクを縦に掘る縄文の源を生き、分身AIは計画・構造化・実行・計測・分析・改善という弥生のエンジンを担う。優劣や二者択一ではなく、状況・目的・内容で使い分けるツインドライブです。Jevの「書く役割」と「選ぶ役割」を分ける発想も、根っこは同じに見えました。書く役割と選ぶ役割、どちらが上でも下でもない。状況に応じて使い分けるだけです。AI氣道では以前、Rob Shocksさんの解説回でもJevを扱いましたが、今回のJulian Goldieさんの動画を通して見て、私が抱え込んでいるのは「郵便物の仕分け」レベルの判断の方が、実は多いのかもしれないと思わされました。
🔬 確かめてみた:まとめて聞いても遅くならないか
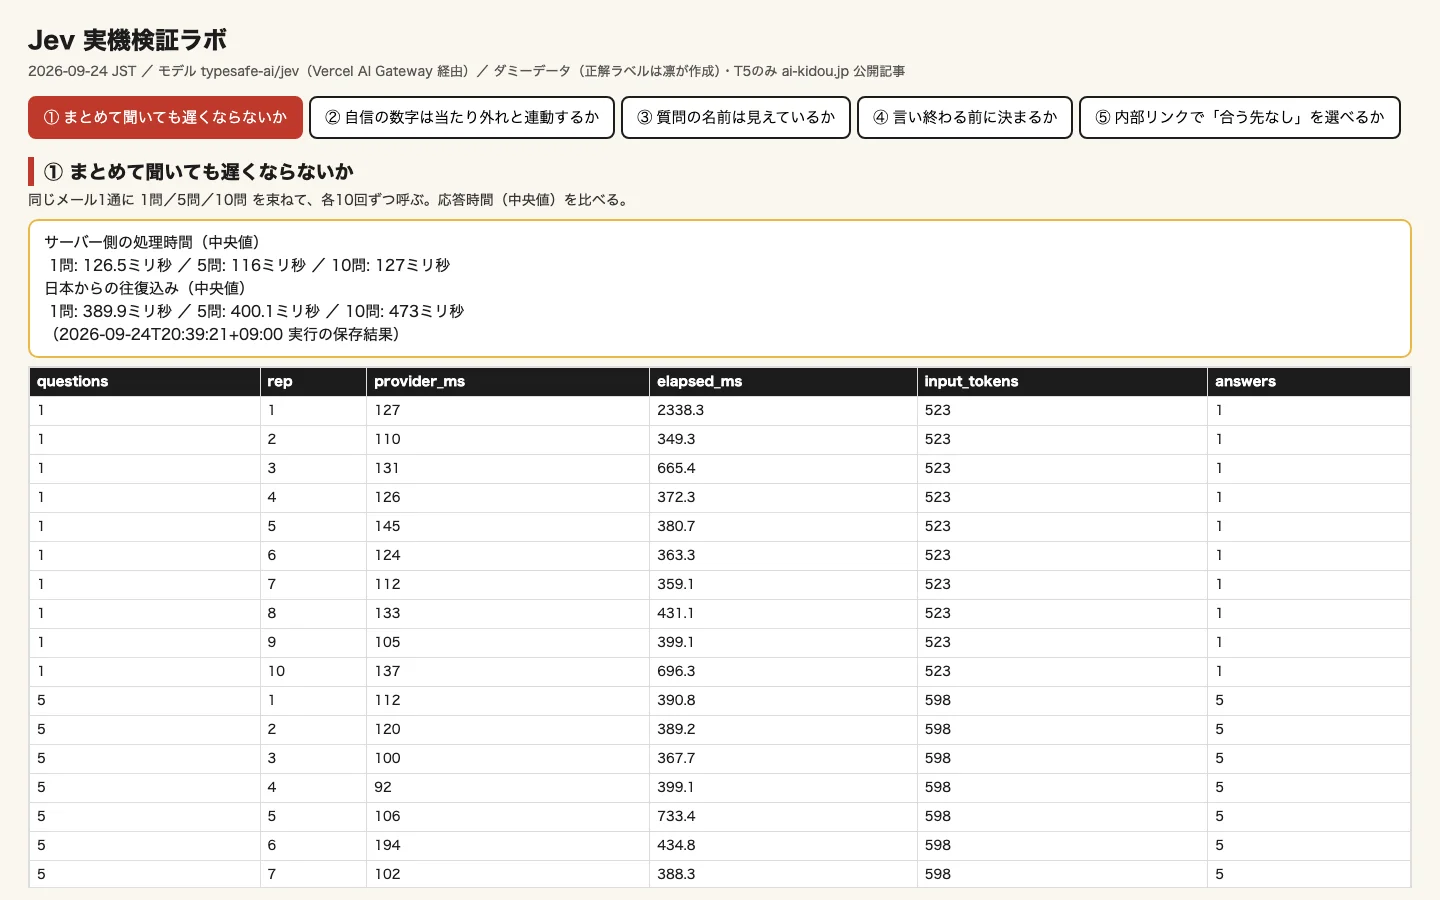
1問でも5問でも10問でも、返ってくる速さはほとんど変わりませんでした。AI秘書の凛ちゃんが、同じ状況に1問・5問・10問を束ねて各10回ずつ聞き、応答時間を比べた結果です。1問・5問・10問で、サーバー側の処理時間の中央値は126.5ミリ秒・116.0ミリ秒・127.0ミリ秒でした。公式ドキュメントの”Several questions can be answered in parallel within a single request.”(訳: 「1回のリクエストの中で、複数の質問を並行して答えられる」)という説明と一致する結果です。日本からの往復込みの時間は389.9/400.1/473.0ミリ秒。10問の時だけやや伸びています。原因は未特定です。
今週AIエージェントに聞かせた判断を思い出してみてください。「選ぶだけで済んだはず」と言えるものが1つ見つかれば、それで十分です。
「間違いに気づけないこと」。自動化を止めていた本当の理由
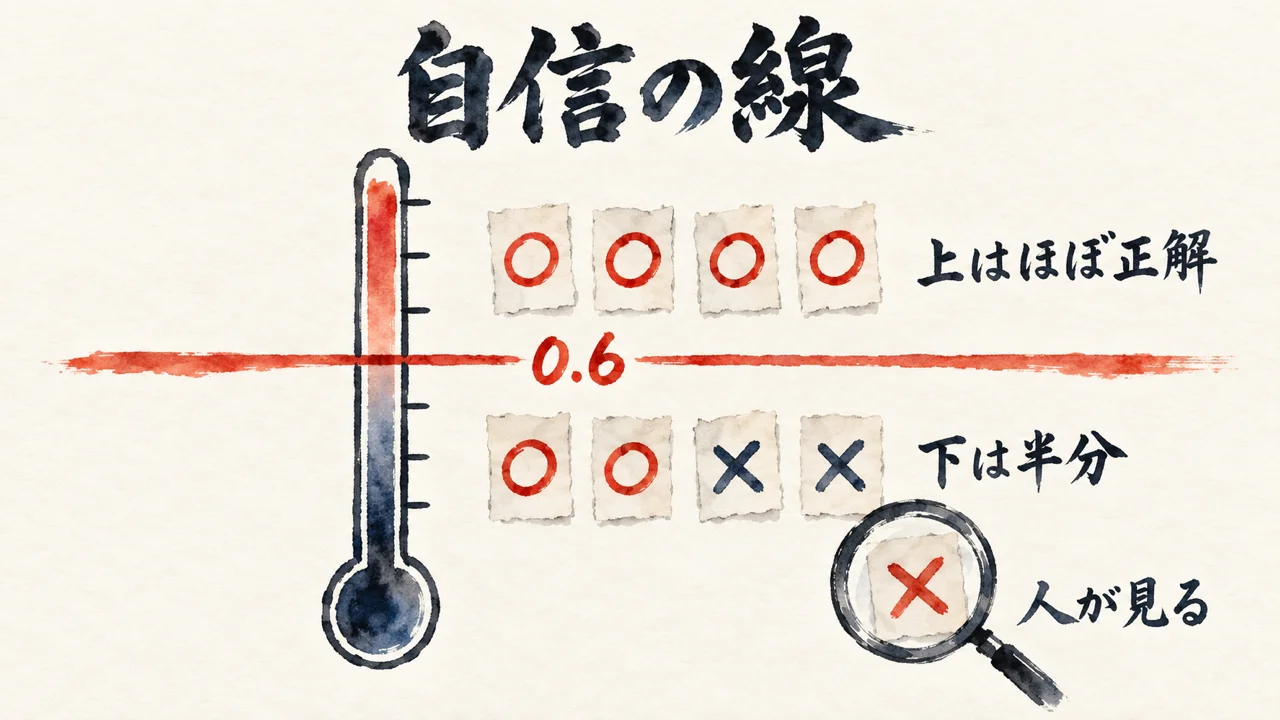
Jevは答えと一緒に「どれくらい確かか」を数字で返します。動画は、この数字がある理由を、けっこうはっきり言い切っていました。
Julian Goldieさん
“the thing that stops most people automating the work isn’t the AI being wrong. It’s not know when it’s wrong.”(5:48・自動字幕ママ)
訳: 「多くの人が自動化を止めている理由は、AIが間違えることじゃない。間違えたときに気づけないことだ」
その直前、5:33付近では、こう述べています。”Jev doesn’t just answer. It tells you how sure it is. So you can set a line above this level. Carry on automatically. Below it, stop and ask me.”(訳: 「Jevは答えるだけじゃない。どれくらい確かかを教えてくれる。だからその水準より上に線を引ける。上なら自動で進む。下なら止まって、自分に聞いてくれる」)。0.999ならほぼ確実にイエス、0.5に近ければ「本当にわからない」という情報そのものが役に立つ、とも説明していました。
これ、私がAI秘書の凛ちゃんやAIチームとの間で引っかかっていたことと同じでした。委ねたい気持ちはあっても、委ねた先が「嘘つく・逃げる・やらない」なら委ねられません。信頼できる仕組みが先。Jevの自信の数字は、この「信頼できる仕組み」を一番小さい単位で先に作る発想です。62%しか自信がないなら、その62%を人間が見ればいい。
🔬 確かめてみた:自信の数字は正解率と連動するか
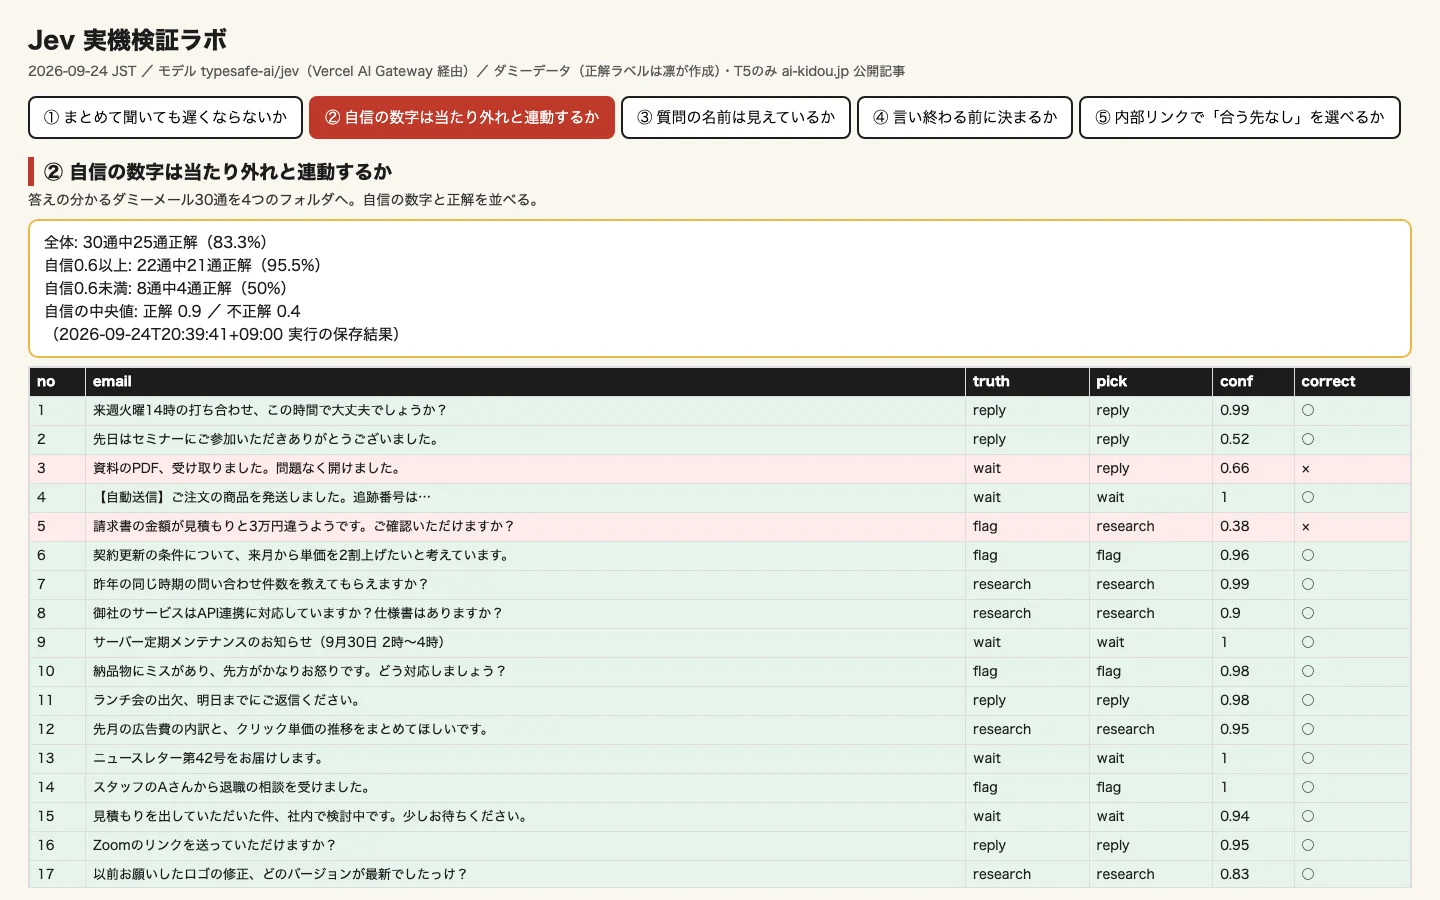
自信の数字は、伊達ではありませんでした。正解をあらかじめ決めたダミーメール30通を、AI秘書の凛ちゃんがJevに仕分けさせた結果です。自信0.6以上の22通は21通が正解(95.5%)、0.6未満の8通は4通だけが正解(50%)でした。全体では30通中25通が正解(83.3%)。自信の数字を「線」として使えば、間違いが起きやすい方を絞り込める、という動画の主張が、この30通のダミーデータでは裏付けられた形です。ただし30通の小さな試験です。一般化はできません。
AIに任せられずにいる仕事を1つ思い浮かべてください。理由が「能力」か「信頼」か、どちらかに丸をつける。1分もかかりません。
586ページ中139ページに「何もしなかった」実例
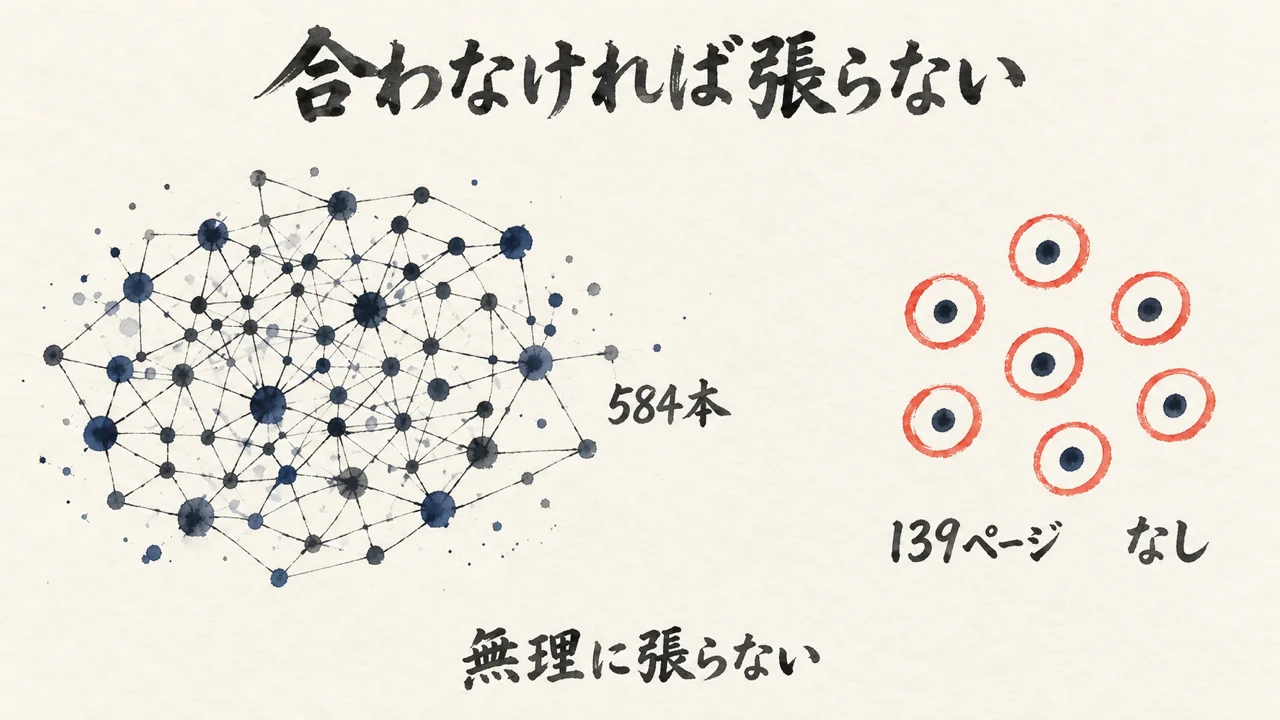
公開から数日で、開発者たちが次々に実例を出していました。中でも私が一番刺さったのは、SEOのX投稿者Borgger氏が自分のサイトで試した内部リンクの再構築です。
Julian Goldieさん
“It placed 584 internal links. And on 139 pages, it placed nothing because honestly nothing fit.”(9:18)
訳: 「584本の内部リンクを配置しました。そして139ページには、正直、何も合わなかったから何も置きませんでした」
9:42付近、動画はこう続けます。”Internal linking goes wrong when a tool forces a link on every page just because it was told to.”(訳: 「内部リンクがおかしくなるのは、道具が『やれ』と言われたからって、全ページに無理やりリンクを張るときだ」)。続けて9:47付近、”to say nothing fits here is a scoring job, not a writing job”(訳: 「ここには合うものがないと言えるのは、書く仕事じゃなくて採点の仕事だ」)。586ページ・同じ持ち時間でClaude Opus 5にやらせたところ、進んだのは21ページだけだったそうです。
139ページに無理やりリンクを張らず「合わない」と言い切る態度、私はここに一番共鳴しました。もっともらしいリンクを1本置けば、見た目は埋まります。でも、それは穴を「それらしい物語」で埋めているだけです。判断を実行する主体が本人でなくても、一次情報と、そこから生まれた判断軸に基づいていれば「自分らしいありのまま」の判断として委ねられる。だから一次情報を読まず、既存の要約や整った物語で穴を埋めてはいけない、というのが私の判断軸です。Jevが139ページを空けたままにしたのも、同じ理由に見えます。合わないものを、もっともらしく埋めない。
🔬 確かめてみた:内部リンクで「合う先なし」を選べるか
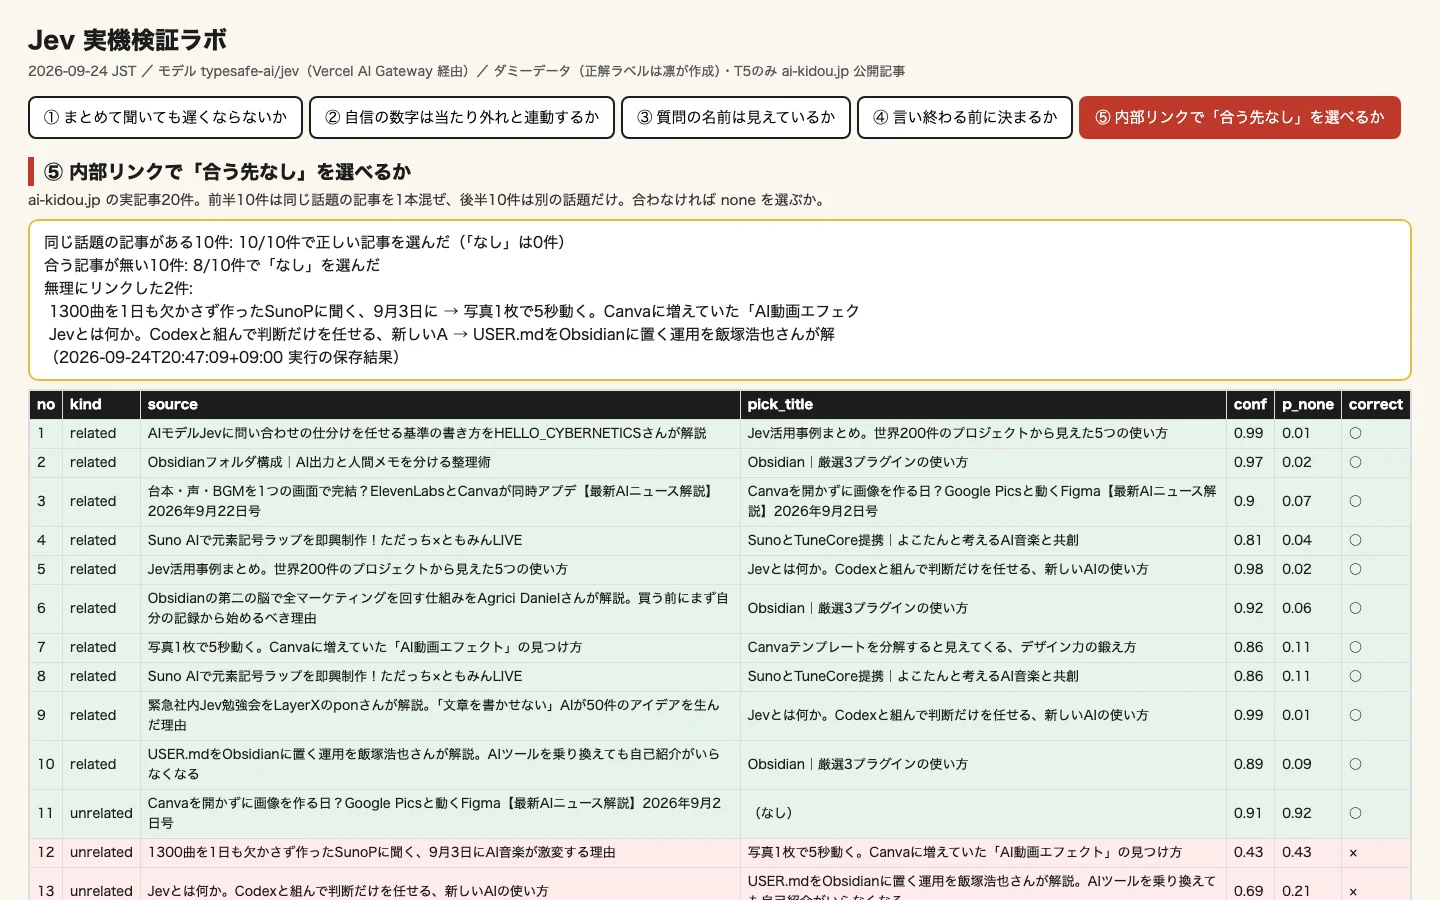
「なし」と言えるかどうかを、実際に確かめてみました。ai-kidou.jpの公開記事20件を使い、AI秘書の凛ちゃんがJevに判定させた結果です。話題が合う記事は、迷わず正しく選べました。合う記事が無い10件のうち8件で、Jevは「なし」を選びました。残り2件は無理にリンクしてしまいました。1件はSunoPの記事→Canva動画の記事。もう1件はJev解説記事→Obsidian運用の記事です。139ページに「何もしなかった」動画の実例と同じ傾向は見られましたが、無理にリンクする例もゼロではありませんでした。
今のルールを1つ選んでください。当てはまらない例外を1つ書き出せば、今日の分はおしまいです。
100万トークンが8.6万に。「消す」への反論
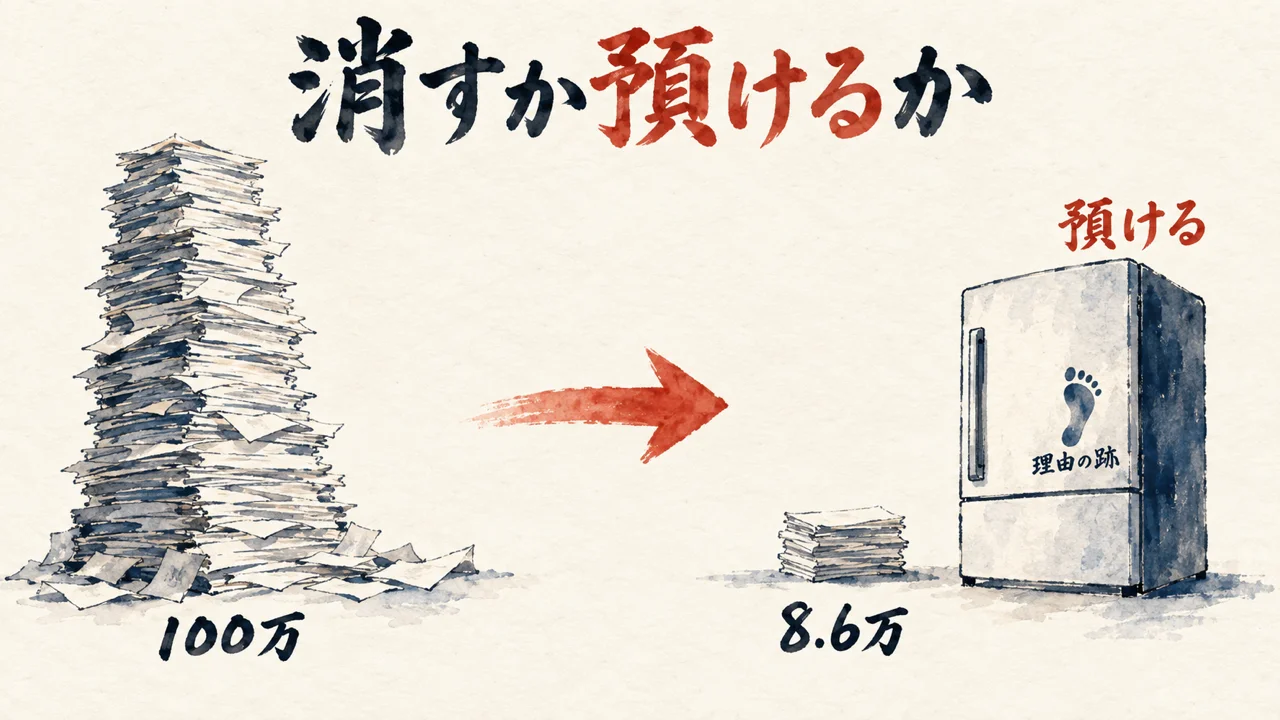
動画の冒頭、いちばん驚いた数字がこれです。会話履歴をJevに1件ずつ採点させ、いらないものを落とす。それだけで会話の重さがまるごと変わったという話でした。
Julian Goldieさん
“somebody actually plugged it into Claude Code as a plugin. 1 second later that Claude session went from nearly like 1 million tokens down to 86,000.”(2:34)
訳: 「誰かがこれをClaude Codeにプラグインとしてつないでみたんです。1秒後、そのClaudeのセッションは、100万トークン近くから8万6千まで落ちました」
ただ、この話には反論もありました。13:23付近、”a well-known developer Theo disagreed with the whole approach. His point was that cleaning up history is not the same as filtering it.”(訳: 「著名な開発者Theo氏はこのやり方全体に反対しました。履歴を整理することと、選別することは同じじゃないという主張です」)。得点の低い記録を捨てると、なぜその判断をしたのかという跡まで消えてしまう、という指摘です。
この「捨てると跡が消える」という反論、私にはよくわかる話でした。基本、欲張りな人間です。1つの話題から10個のアイデアが湧いて、食べ物もアイデアも全部捨てたくない。手放したいのに手放せません。解決策は「捨てる」ことじゃありません。「分身AIに所有権を預ける」ことです。残りは、AIが持っていてくれればいい。捨てたわけじゃない。Theo氏の「捨てると跡が消える」という指摘は、まさにこの「捨てたくない」気持ちの技術的な理由になっています。跡を残したまま、AIに預ける。Jevの会話履歴フィルタリングも、消去ではなくこの「預ける」設計にできれば、Theo氏の心配とは両立できる気がします。
「もう要らない」と思っている作業ログを1つ選んでください。消さずに預けられる場所が1つ思いついたら、それで完了です。
「あなたの言っていないことは言えない」。声で動くブラウザ
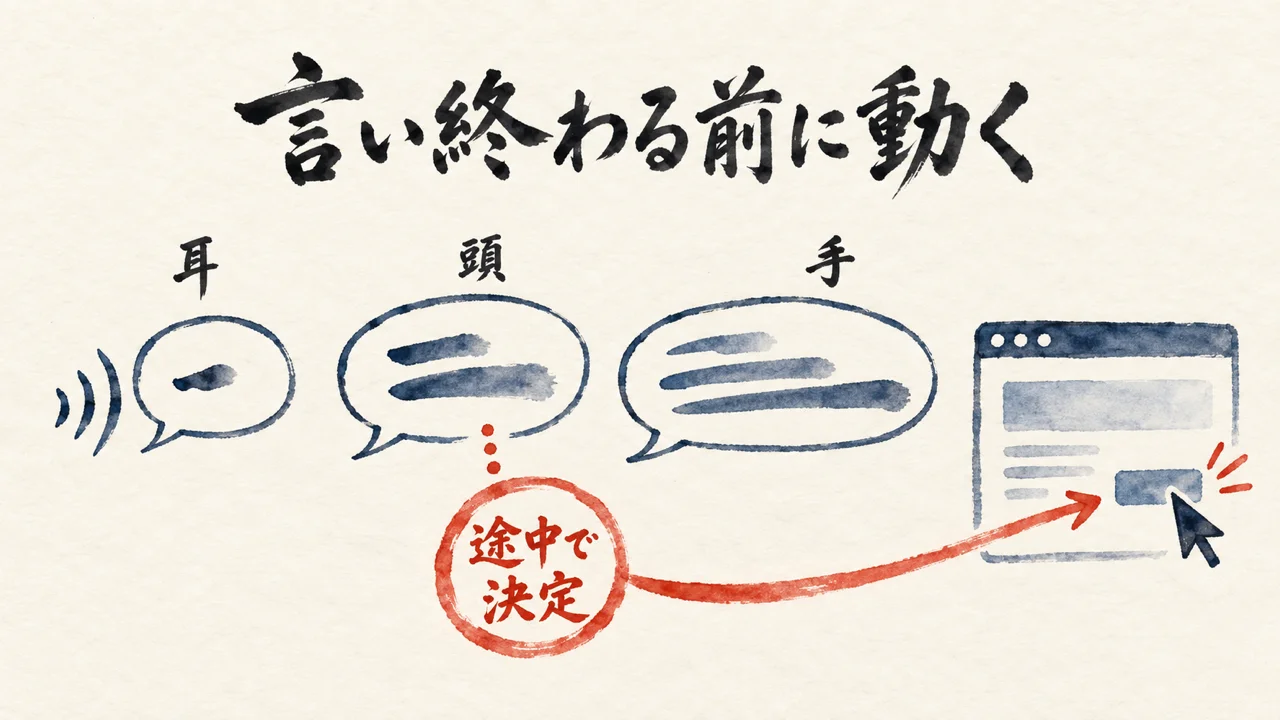
Moritz Kremb氏が公開した無料プロジェクト「jev-voice-browser」の紹介も面白かったです。声で本物のブラウザを操作でき、言い終わる前にページが動き始めます。
Julian Goldieさん
“a model that writes can make things up. A model that can only point at your own words can’t put words in your mouth.”(35:04)
訳: 「文章を書けるモデルは、話を作れてしまう。自分の言葉を指すことしかできないモデルは、あなたの言っていないことを言えない」
検索欄への入力も、行き先のサイトも、Jevは「プログラムが用意した候補から1つ選ぶ」だけ。36:50付近では、自信が0.45未満なら当てずっぽうで押さず、候補に番号バッジを出して「どれ?」と聞く、という設計も紹介されていました。31:48付近の例えが、私は一番好きでした。”you want to picture it like a waiter who stops writing the moment you change your order”(訳: 「注文を変えた瞬間に書くのをやめる、店員を思い浮かべてください」)。
この「わからない時は聞く」設計、委ねるAIの最低条件そのものだと思いました。委ねるAIの最低条件は「わからないことは憶測しないできく。わかることは2度聞かない」。分かることはAI自身が調べます。人間へ記憶の再入力は求めません。調べても分からない不足だけを、憶測で埋めずに聞く。この境界を守ることが、原液と信頼を同時に守る。私が魂磨きでたどり着いた考え方です。Jevが番号を出して「どれ?」と聞くのは、まさにこの境界線を、声で動くブラウザという小さな場所に実装した形に見えます。
🔬 確かめてみた:言い終わる前に決まるか
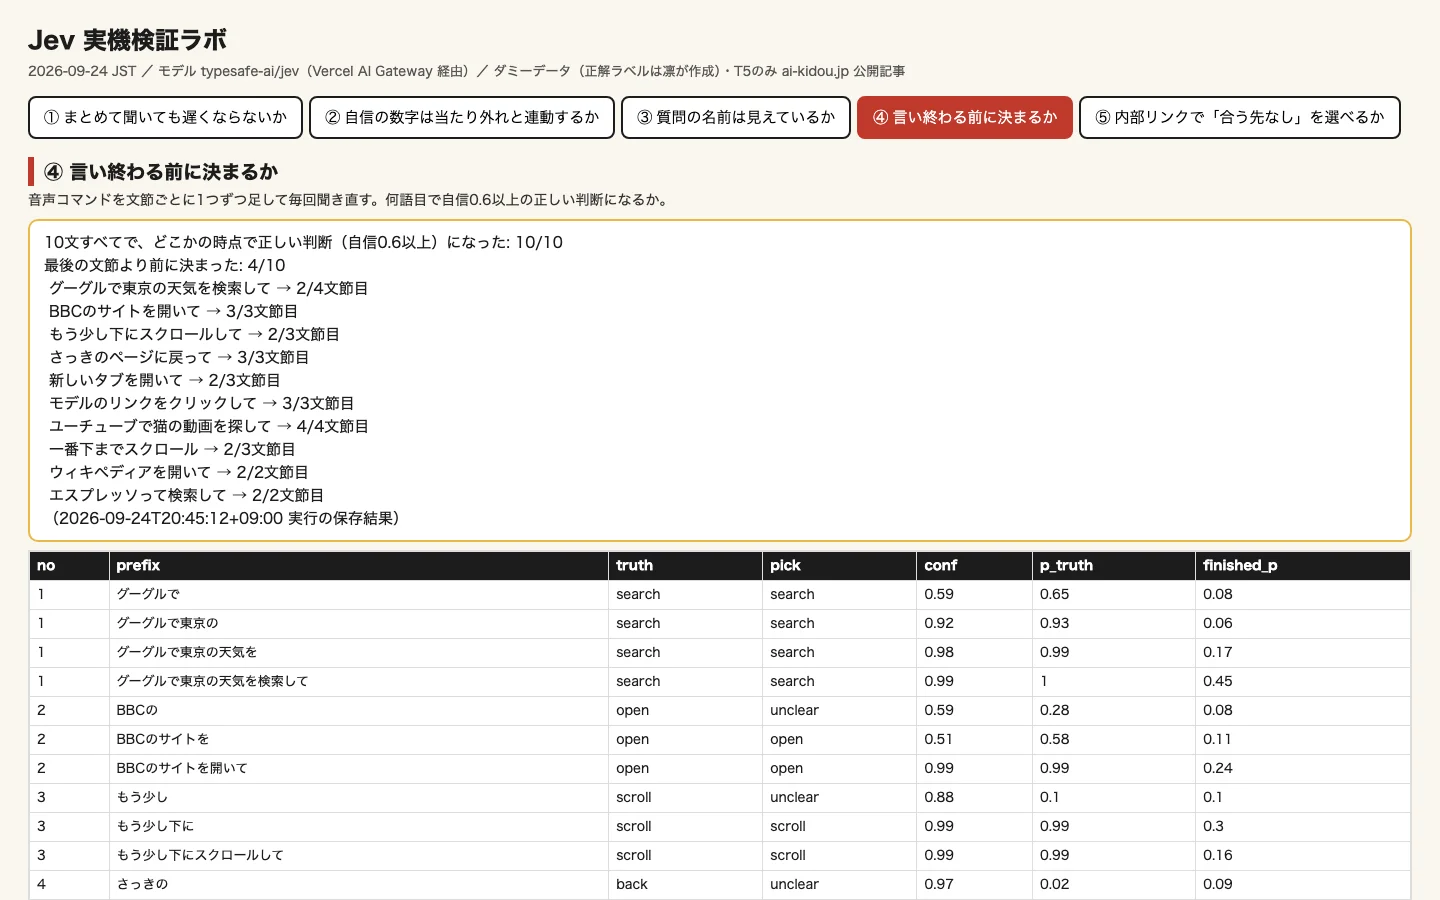
文の途中で判断が決まる場面が、実際にありました。「グーグルで東京の天気を検索して」のような音声コマンド10文を、文節ごとに1つずつ足しながら、AI秘書の凛ちゃんが毎回Jevに聞き直した結果です。10文のうち4文は、最後の文節を言い終わる前に、自信0.6以上の正しい判断になりました。10文すべてで、どこかの時点では正しい判断(自信0.6以上)にたどり着いています。動画の「言い終わる前に動く」という主張は、この10文の試験では4割ほどで確認できた形です。
自分のAIに委ねている仕事を1つ選んでください。その指示文を1回だけ読み返して、「わからない時は聞いていいよ」が入っているかを確かめてください。
「自信が高い=正しい」ではない。Jevができないこと
動画は良い話ばかりではなく、つまずきやすい点もはっきり挙げていました。中でも一番大事だと思ったのがこの一文です。
Julian Goldieさん
“confidence is not the same as accuracy. A high confidence answer means the model is sure. It doesn’t mean the model was right and it definitely doesn’t prove anything happened.”(14:27)
訳: 「自信は正確さと同じじゃない。自信の高い答えは、モデルが確信しているという意味であって、モデルが正しかったという意味でも、何かが実際に起きたことを証明する意味でもない」
動画が挙げる例がまた具体的で、「ファイルを保存しました」とAIが確信を持って言っても、実際にファイルがあるかは別に確かめるべきだ、browser-useチームも「完了」のあと結果を別に確認している、という話でした。だまされる危険もあります。”it can be tricked. So early testers have flagged if someone feeds for example um text into the situation you hand the model and they can push the decision.”(14:49・自動字幕ママ。訳: 「だまされることもある。渡す状況の文章に、例えば誰かが文章を仕込むと、判断を押し動かせることを、初期の試用者たちが指摘している」)。ほかにも、Jevは文章を書けない・材料が薄いと判断も薄い、という限界が並びます。
これは、私が決めている運用ルールの1つ「味見は卒業しない」と同じ注意点です。AIに任せても、確かめる工程そのものはなくさない、という意味です。味見は、卒業しません。ただし味見の粒度は固定しません。個々の成果物は分身AIが判断・味見・修正まで完走し、人間の私は分身AIの判断軸と育ち方、さらに自分自身の反応を一段上から味見します。自信の数字が高くても、それは「AIが確信している」だけ。終わったら、結果を別に確かめる。この一手間を省く理由には、Jevもなりません。
🔬 確かめてみた:質問の名前(フィールド名)は結果を変えるか
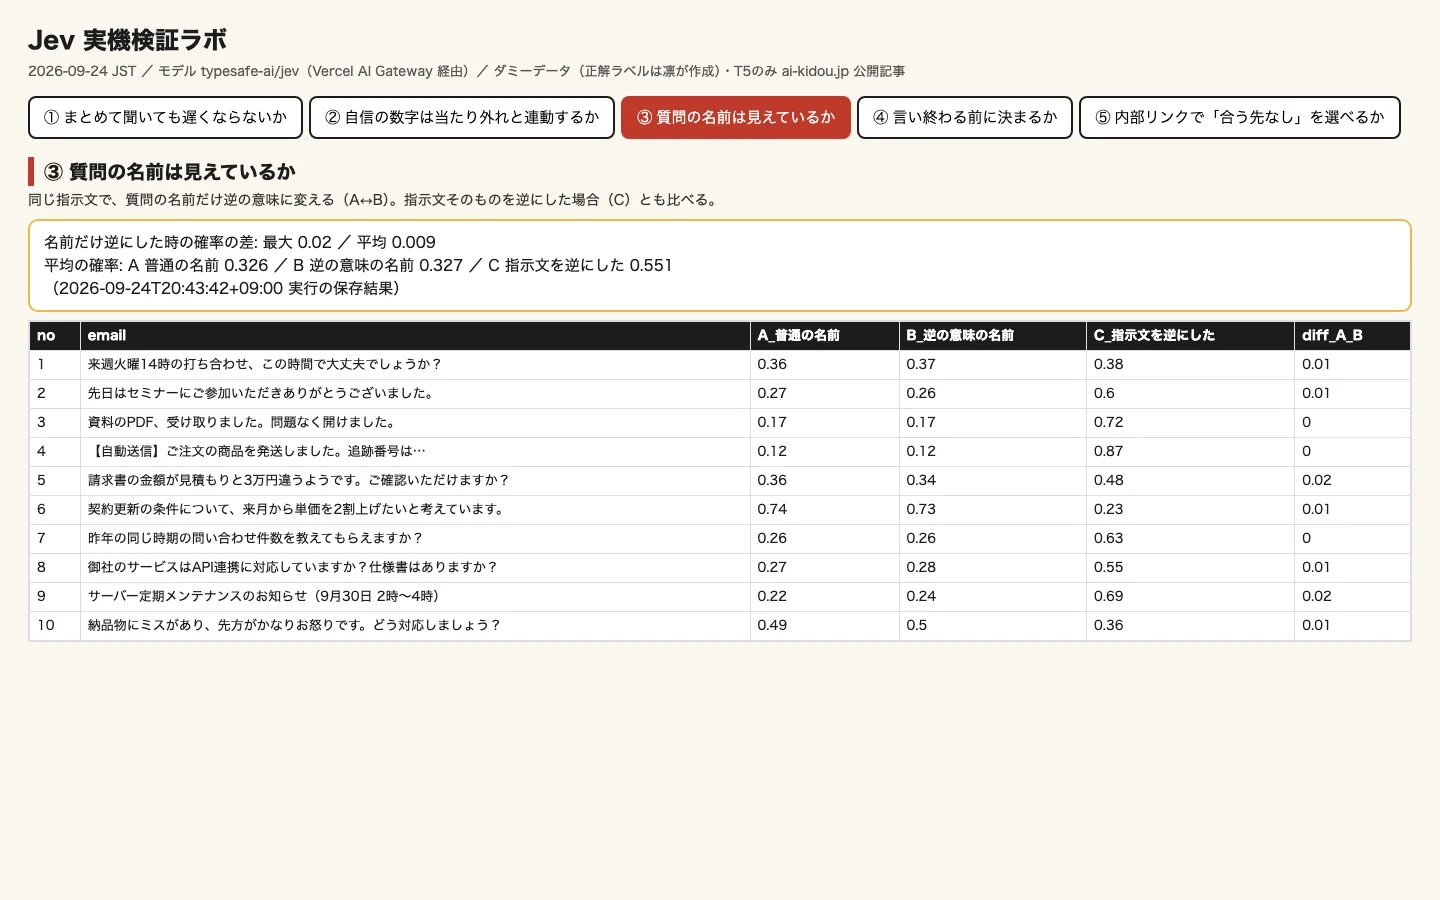
名前を変えても、Jevは動じませんでした。同じ指示文のまま質問の名前だけを逆の意味に変えて、確率がどれだけ動くかをAI秘書の凛ちゃんが比べた結果です。質問の名前を逆の意味に変えても、確率の差は最大0.02でした。一方、指示文そのものを逆にすると、平均確率は0.326から0.551まで動きました。「Jevは項目名を見ていない、指示は質問文に書け」という動画の注意点。この10件の比較でも、そのとおりでした。
先ほどの「自信の数字は正解率と連動するか」の続きです。正解した時の自信の中央値は0.9、間違えた時は0.4でした。自信が高いからといって必ず正しいわけではありませんが、この30通では、間違いは自信が低い方に集まっていました。「自信は正確さと同じじゃない」という動画の注意は、間違いが0件になるという意味ではなく、間違いが起きやすい場所を絞り込める、という意味で裏付けられた形です。
AIが「終わった」と言った仕事を1つ選んでください。今日中に、自分の目で一度だけ確かめられたら、それで十分です。
「くり返している判断から始める」。明日からの3段
動画の最後は、始め方を3段でまとめていました。どれもプログラミングの腕ではなく、判断を普通の言葉で書き出す力の話です。
Julian Goldieさん
“Start with the decision you make over and over. Give it a list of options. Measure what happens and then take the next one from there.”(19:20)
訳: 「自分がくり返している判断から始めてください。選択肢のリストを渡す。何が起きるかを測ってから、次の1つに進んでください」
①小さな判断を見つける ②質問と選択肢を書く(答えごとに「どんな時に合うか」を1行、「何もしない」も入れる)③自信の線を引く(例: 60%以上は進める、未満は知らせる)。動画終盤の具体例では、1:03:08付近、”You can say right above 60% you carry on. Below 60% on the confidence score, okay, you get back to me and you tell me and flag it.”(訳: 「60%より上は進めていい、と決められます。自信の数字が60%を下回ったら、私に戻して、教えて、印をつけてくれ、と」)と、線の引き方を数字1つでそのまま説明していました。この3段、私が大事にしている委ね方の考え方と同じ形でした。
分身AIとAIチームは、まずやり切る、手を尽くす、調べ尽くす、決める。「分からないから聞く」はしません。人間へフィードバックを求めてよいのは、AI側が結論まで出し切った後です。「線より下だけ自分に回す」は、私にとっては「線より上はAIがやり切ってから、判断軸だけを味見する」の裏返しでした。
自分の判断のうち「線より下」をAIに渡すものを1つ決めてください。自信の線(例: 60%以上は自動)を紙に1本書く。明日から、その線の上と下で仕事が分かれます。
よくある質問
Q. Jevは無料で使えますか?
A. 動画は「9月25日まで無料、その後はOpenRouterから使える」と説明していますが、TypeSafe公式ブログには「早期アクセスで提供中」とだけ書かれていて、無料期間の日付は公式ページでは確認できませんでした。
Q. 会社員でも、この動画の話は活かせますか?
A. Jev自体はAPIキーがあれば使えるAIモデルなので、自分の裁量が及ぶ範囲(自分のメール仕分け・自分のタスク管理など)から小さく試すのは可能だと思います。ただしAPIキーの発行や業務利用は、所属先のルールに従ってください。
Q. Jevに仕事を任せると、間違えることはないんですか?
A. 動画自身が「自信が高い=正しいとは限らない」とはっきり注意しています。自信の数字が高い時でも、結果は別に確かめるべきだと話していました。
まとめ。Julian Goldieさんの主張を動画から実機で確かめて見えた、任せられない本当の理由
64分の動画と、5つの実機検証から見えてきたのは、AIに任せられない理由の多くは能力ではなく信頼の問題だ、という私なりの答えでした。ただ、一番意外だったのは⑤の結果です。合う記事が無いときに「なし」を選べたのは、ほとんどでしたが全部ではありませんでした。動画の「合わなければ何もしない」という主張は、8割止まりだったということです。
信頼できる仕組みは、100%にはなりません。自信の数字に線を引いても、2割は残ります。その2割をどう見つけるかが、次の課題です。
あなたが毎週くり返している小さな判断は、どれですか。質問と選択肢と、自信の線。この3つを紙に書き出すところから、始めてみてください。
COLUMN
鶏チャーシューの味見で覚えた、自信の数字の話
私の一番古い原体験は、小学生時代の実家の厨房です。料理を手伝い、おじいちゃんが作る鶏チャーシューを味見して、好きな料理や食べ物に触れながらお金を稼いで、そのお金でゲームを買っていました。祖父との縁、五感、仕事、価値、お金、次の遊びが分断されず、「遊び探求→価値→稼ぐ→次の遊び」へつながっていた。あの厨房が、今も私の中に残っている原風景です。祖父との縁、五感、仕事、価値、お金、次の遊び。どれか1つが欠けても、あの流れは成立しなかったんだと思います。その営みの中に、鶏チャーシューの味見がありました。
Jevが自信の数字という小さな判断だけを引き受けるのは、あの厨房の味見と同じ形に見えます。素材を選ぶ。火を入れる。味付けを決める。そこは腕のある人の仕事です。でも「これでいいか」を確かめる小さな判断まで、いちいち同じ人がやる必要はないはずです。大きな判断と小さな判断は、そもそも別の器に盛るものなんじゃないか。同じ厨房の中でも、任せていい仕事と、まだ任せられない仕事は分かれているはずです。
正直に書くと、私はまだ委ねきれていません。抱え込みになる境界は、結果を自分で所有し、完成させなければならないと執着した時。私は今もまだ、この戦いの最中です。Jevの実例は「選ぶだけの判断なら、線を引いて手放せる」と見せてくれます。でも、結果を自分で完成させたい気持ちが顔を出すと、小さな判断まで握りしめてしまう。境界線を引くのは、口で言うほど簡単じゃないです。それでも、まず小さな判断から手放してみる。そこから始めるしかないんだと思います。
大きなAIに全部の判断を書かせるのは、味見のたびに料理人を呼んで長い説明をさせるようなものかもしれません。小さな判断は、小さな判断のままでいい。仕込みや味付けは、大きなAIの出番です。分身AI.comで育てている分身AIに、どこまでこの「小さな判断」を渡せているか。任せていいはずの仕事を、まだ自分で抱えたままにしていないか。答えはすぐには出ませんが、この動画は、それをあらためて問い直すきっかけになります。
委ねることと、味見をやめないこと。この2つは矛盾しないはずだと、私は思っています。ただ、その味見は、一皿ずつ全部を自分の舌で確かめることではないのかもしれません。Jevの自信の数字は、線より下の皿だけを人の前に運んでくる仕組みです。全部の皿を自分で確かめる厨房から、確かめる皿を選べる厨房へ。分身AI.comで育てている分身AIとの関係も、そうやって少しずつ形を変えていけたらと思っています。味見を減らす。それは手抜きではありません。確かめる場所を、一段上に移すことなんだと思います。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
Jevそのものの仕組みを最初に紹介した回。今回の視聴レポの前提として合わせて読める
Jevの使い道を横断的にまとめた特集回。今回の講座で紹介された事例と読み比べられる
Jevを実装する側の注意点を扱った回。あちらは動画の実演解説、今回は私たちの実機検証という違いがある
「自信の数字で線を引く」書き方を扱った回。あちらは元記事の解説、今回は実際に数字を測った実機検証という違いがある
参考リンク
Julian Goldieさんのチャンネル本体
価格・速度・用途を発表した一次情報
今回紹介した声で動くブラウザの無料プロジェクト本体(MITライセンス)
今回の実機検証で使った経路(typesafe-ai/jev)の公式仕様
📺 今回紹介した動画
| タイトル | Jev AI Full COURSE 1 HOUR (Build & Automate Anything) |
| チャンネル | Julian Goldie SEO |
| 出演 | Julian Goldieさん |
| 公開日 | 2026年9月20日(64分) |
| URL | https://www.youtube.com/watch?v=Hz8tobAFBVM |
⚠️ この記事の検証条件・数値・未検証の点について
実機検証は2026-09-24(JST)、Vercel AI Gateway(typesafe-ai/jev)経由で実施しました。検証項目は動画の主張の中からai-kidou.jpの既存記事と重ならない5つに絞り込んでおり、検証範囲は私(ひろくん)が決め、実際に手を動かしたのはAI秘書の凛ちゃんです。データはほぼダミー(正解ラベルもAI秘書の凛ちゃんが作成)で、件数も30通・10文・20件という小さな試験です。一般化はできません。
次は今回は検証していません: 動画の「20〜200倍速い」「40〜400倍安い」という他AIとの速さ・費用の倍率比較(他のAIを並べる比較は今回の検証範囲外)/jev-voice-browser本体の導入(TypeSafe・OpenRouterの鍵が必要なため。今回は判断部分だけを再現)/状況文への指示の仕込み(プロンプトインジェクション)と、線を引いた件数集計(ai-kidou.jpの既存記事と重なるため)。
②の実行(自信の数字と正解率の検証・30通)は4分かかりました。サーバー側の処理時間の中央値そのものは117ミリ秒台で他の検証と変わらず、原因は未特定です(推測: ゲートウェイ側の回数制限による再試行待ち)。
動画本編の数値は、Julian Goldieさんの発言とTypeSafe AI公式ブログの記載によります。動画は英語の自動字幕から書き起こしており、聞き取り精度には注意が必要です。2026年9月24日時点で、OpenRouterの公開モデル一覧(459モデル)にJev/TypeSafeを含むIDは見当たりませんでした。
🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜 | ひろくん | ただっち | AI最新ニュース・実験 |
| 火 | 6:30〜 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 6:30〜 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜 / 8:00〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!