WATCH REPORT
Dell Pro Precision with GB10はデータを外に出さずAIを動かせる
2026.10.26
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル PAD:PC Watch & AKIBA PC Hotline! で、PC Watch のライターの西川和久さんが、メモリ128GBの小さなAI専用機 Dell Pro Precision with GB10 を検証した回を紹介します。
自分の会社や仕事でAIを使いたい。でも、データはクラウドに出したくないんですよね。ローカルの機材選びも、グラフィックボードを積むか、小さな箱にするかで止まりがち。検証動画を通しで見る時間は、なかなか取れませんよね?そんな人に向けて書きました。
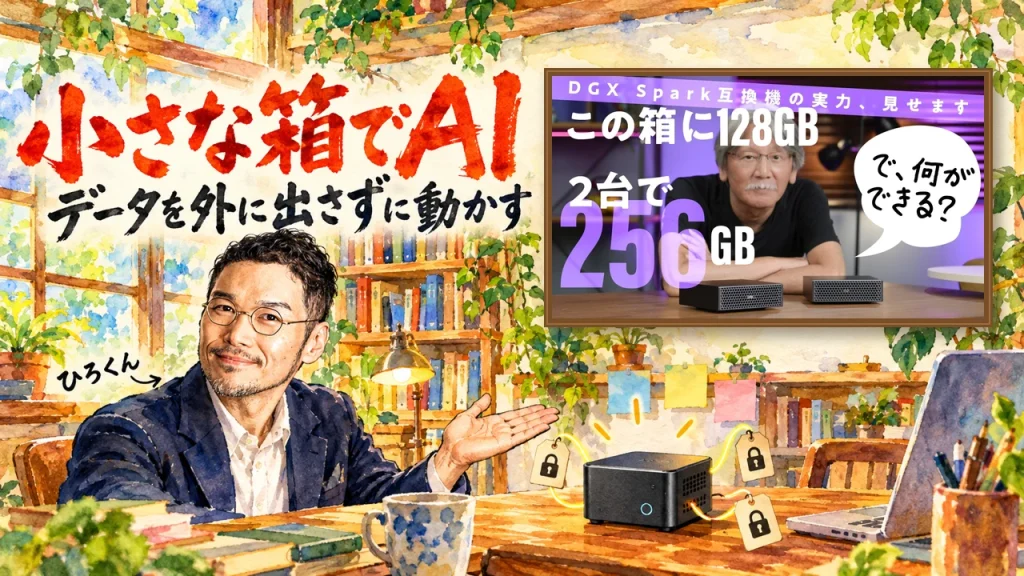
動画は21分の検証です。最初からCUDAまで入った小さな箱、メモリ128GBに載ってネットにつながずに動く大きなAI、画像を読んで描く速さ、動作音と発熱。そして、LLMと画像生成の同時動作と、2台で256GBに届くところまでを、順に見せてくれます。
読み終えると、この流れを動画の順に追えます。小さな箱に何を載せたいのか、何を置く場所と手間から外したいのか。その見方で機材を見られるようにしました。横には、手元のMacでローカルAIを試した私の記録と、私の見方を添えています。
SPEAKER
佐々木修司さん
動画のホストです。PADのプロデューサーとして、西川さんに機械の見どころを順に聞いていきます。
SPEAKER
西川和久さん
動画のゲストです。PC Watch で記事を書きながら、画像生成AIのシステムを自分で組んで運用しているエンジニアで、自宅にはDGX Spark互換機があります。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)出典: メモリ128GB搭載・DGX Spark互換機のスゴさが分かった! LLMも画像生成も“同時に”動く小さな箱|Dell Pro Precision with GB10をAIのプロと検証【2台接続も】
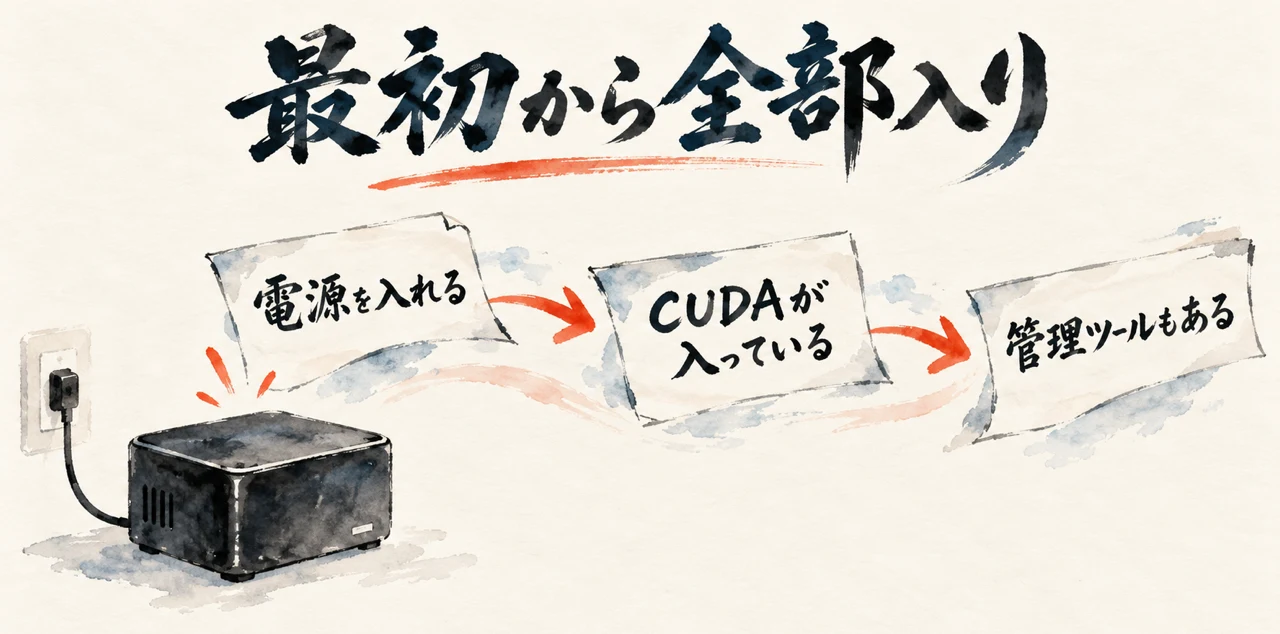
GPUを積んだAIの機械は、大きくて、熱くて、うるさいもの。この動画は、机の上の小さな箱で、その思い込みをほどくところから始まります。
画面には、150×150×51mmと出ます。500mlのペットボトルと並べても小さく、重さは最小構成で1.31kg。片手で持てる大きさです。
背面で注目するのは電源です。Type-C のポートで、280Wに対応。ファンも無く、音もしない、と西川さんは言います。
GPUを積んだワークステーションは、1000W級の電源が当たり前。通常の機械や、5090を積んだ機械は、うるさく、熱く、大きいもの。それと比べて、これはたったこれだけでコンパクトです。
電源を入れると、デスクトップの画面が出ます。この環境を自分で組むのは本当に大変、と西川さん。Ubuntu、ドライバ、CUDAを順に入れる手間が、ここでは何も要らないと続けます。
西川和久さん(動画 2:25〜)
実は自分でこの環境を組もうと思ったらすごい大変なんですよ
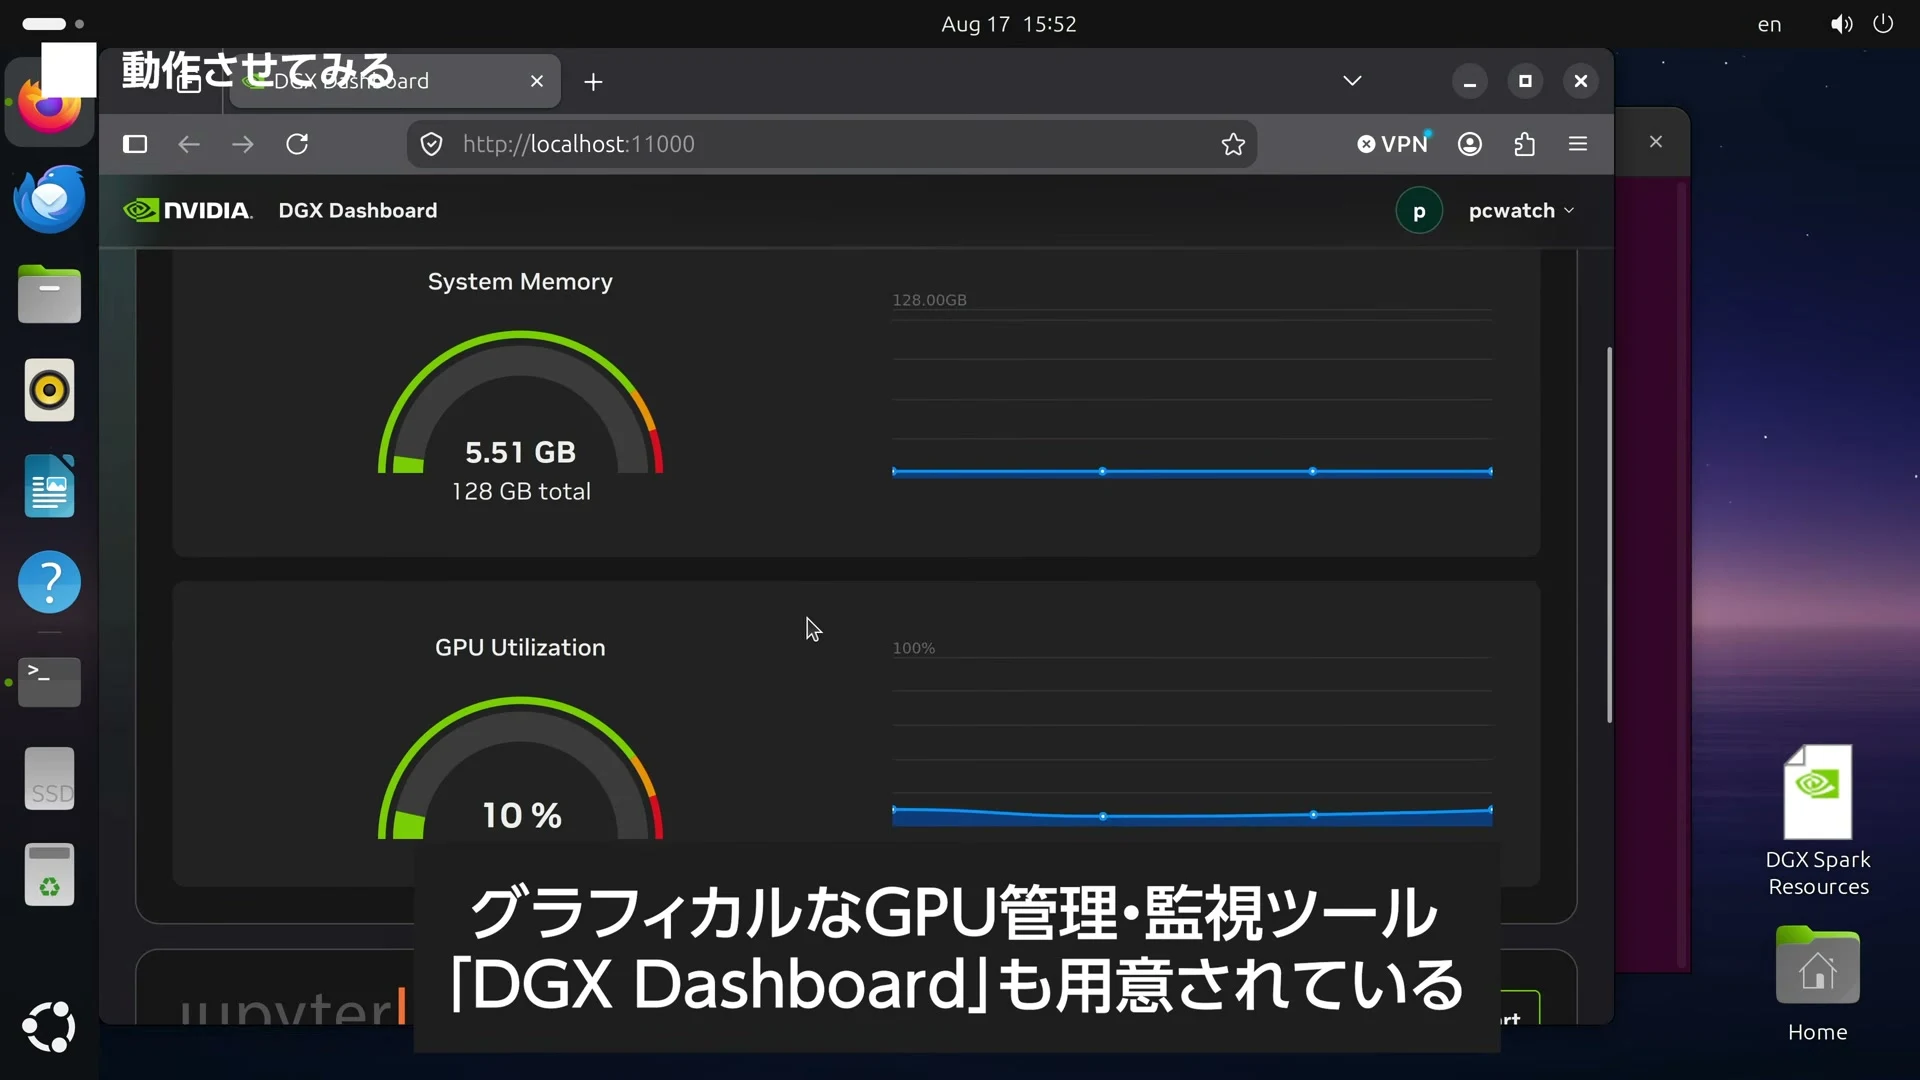
入ったかを確かめるコマンドの nvidia-smi を表示させるまでが大変なのに、ここは最初から入っています。システムモニターとは別に、DGXダッシュボードという管理ツールも用意されていて、状況がひと目で分かります。
西川和久さん(動画 3:16〜)
最初から全部オールインワンで入ってるっていうのも大きなことなんです
会話では、企業の目線も出ます。情シスの方が、1台ずつ環境を作って回らなくて済む話です。買ってきてどうぞ、で終わる、という流れでした。
小さい、静か、最初からCUDAまで入っている箱。第1章の筋道は、ここに尽きます。
大きいのは、電源を入れたあとに何もしなくていい所です。自分で組む手間は、まるごとゼロ。
実は、私は2026年9月28日の記事に、手元のMac(Apple M5 Max・メモリ128GB)で画像判定のAIを試した話を書いています。写真を見て、見出し用の挿絵を当てるAIです。
READMEのコマンドそのままでは起動せず、最初につまずきました。直したのは1か所だけ。起動の指定を1つ足したら、立ち上がったんです。
私の記事より(imajevをMacで試した。Jev派生の判定AIは画像も読めたが、任せる線は自分で引く・imajevをMacで試した(環境を立ち上げる所)の節)
READMEのコマンドそのままでは起動しないって、最初につまずきました。
私の記事は、手元のMacで小さな判定AIを動かした、立ち上げの話です。立ち上げの手間という重さで、さっきの動画の話と並びます。
最初から全部入りの箱は、立ち上げの摩擦をほとんど消してくれます。それでも、何に使うのか、誰と使うのか。ここは箱の外の話です。
メモリが128GBある小さな箱。その容量は、何のためにあるのか。答えは、最初のデモでいきなり見えてきます。
最初のデモは、大きなLLMです。西川さんが動かすのは gpt-oss-120b。ファイルは60GBを超えます。5090のメモリは32GBで、それより下はもっと少ないので、動きません。
画面には、ファイルサイズが65.33GBと出ます。ロードをかけると、メモリの表示がどんどん増えていきます。
その辺のパソコンでは動かず、5090でも、2枚でも無理、と会話は続きます。
西川和久さん(動画 4:39〜)
なのでもうここの時点で勝負があったんですよ
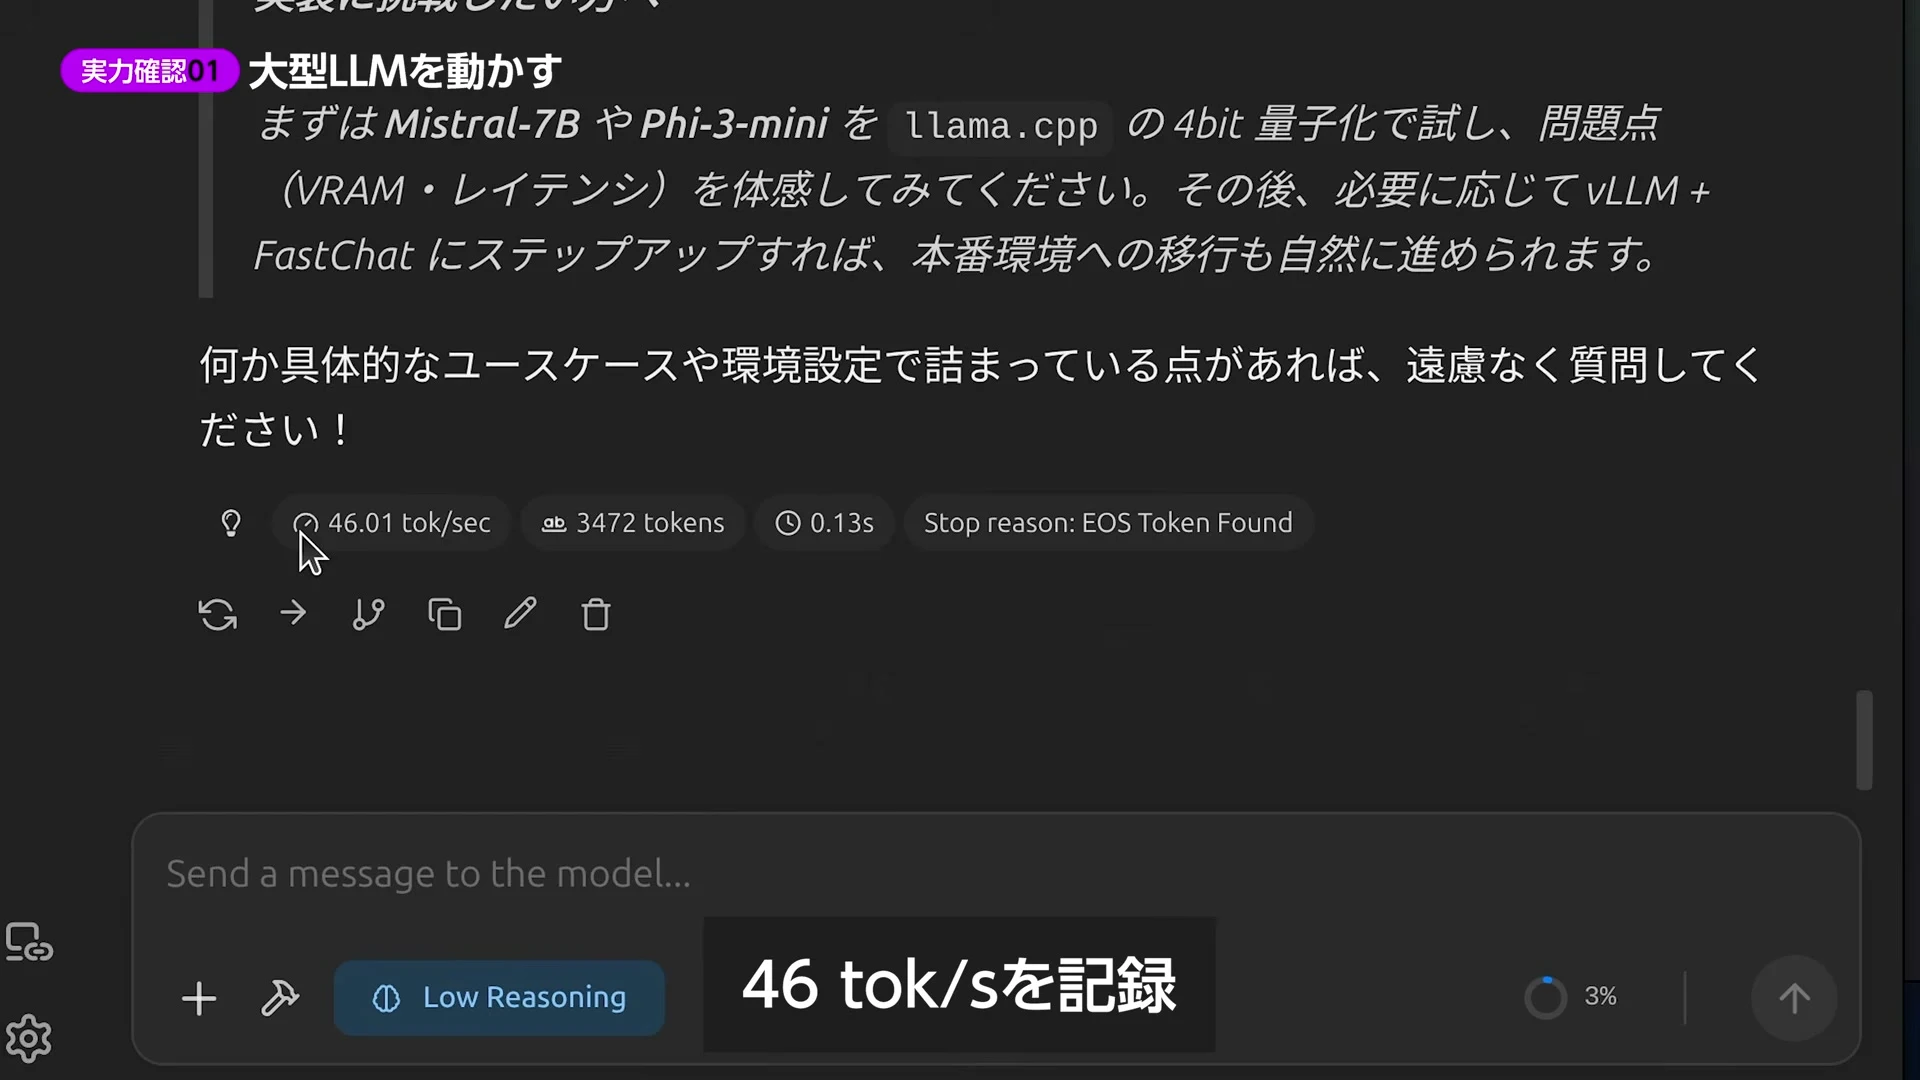
ロードが終わると、メモリは77GB近くまでいきます。質問を投げて、速さを見ます。
西川さんの目安は、20 tok/s 前後。それなら普通に使える速さだと言います。画面に出た結果は46 tok/sで、その2倍以上でした。
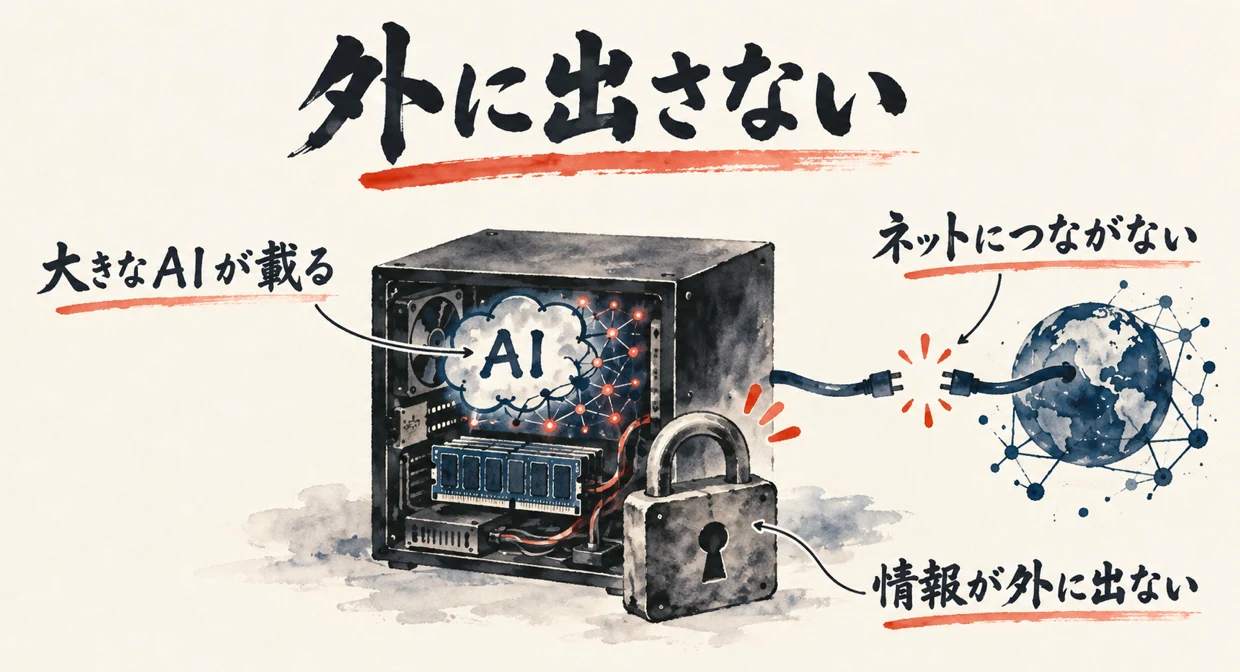
さらに大事なこと。この機械は、Wi-Fiにも、ネットワークケーブルにも、つながっていません。ここまでローカルで動いている、と西川さんは話します。
西川和久さん(動画 5:44〜)
つまりここまでローカルで動作しているということです
ネットワークにつながっていなければ、どこにも情報は漏れません。佐々木さんは、企業はAIを使いたいが、データをクラウドに投げたくない、そのニーズが高まっている、と受けます。
大きなLLMがそのまま載って、ネットにつながずに動く箱。第2章で見えたのは、この組み合わせです。
メモリの量が、そのまま動かせるAIの大きさになる世界。128GBの意味が、ここではっきりします。
5090の32GBには載らず、この箱の128GBには載ります。この差は、速さの差ではなく、そもそも動かせるかどうかの差です。
私は2026年9月の記事に、ひとつの実験を書きました。写真を見て、見出し用の挿絵を当てる実験。画像もデータも、Macの外に出さないまま試せたんです。
私の記事より(imajevをMacで試した。Jev派生の判定AIは画像も読めたが、任せる線は自分で引く・imajevをMacで試した(外に出さない安心)の節)
手元で動く判定AIには、文章を外に出さない安心があります。
動画は、ネットにつながないまま大きなLLMが動くことを大事にしていました。私の記事は、手元で動く安心を書いたもの。データが手元に残るという点で、両方は並びます。規模は違い、動画は128GBに載る大きなモデル、私の記事は小さな判定AIです。
データが手元に残るなら、機械に何を任せて、何を自分で決めるのかを、自分のペースで考えられます。答えを見つけるのは、使う人のほう。
箱がどれだけ大きくなっても、この線は動かしたくないんですよね。
画像を読むAIと、絵を描くAI。速さを、1枚が何秒で出たかだけで決めていいのか、ここが気になる所です。この章では、読む実演と描く実演を、動画の順に見ていきますね。
次は、画像を読むAIです。Qwen3.6-35B-A3B がすでにロードされていて、画像を置き、画像について詳しく、と頼みます。すると、答えがかなり早く返ってきますよ。
最初のトークンが出るまでは0.98秒。西川さんは、これを速いと言います。画像を読ませると、一度にかなりの量の入力が入るんですよね。それをさっと解析して、答えを出すところまでが速いんです。
普通のチャットは、入力が少なめですよね。西川さんの手持ちの M4 Max の128GBは、LLMのチャットは速いのに、この手の処理は遅いと話します。そこに違いがあるそうですよ。
ローカルで画像を読めれば、社内の手書きの資料や現場の写真も、そのまま手元で処理できる、という話も出ます。さらに、これはサーバーにもなるんですよね。LM Studio を起動したまま Open WebUI も立てれば、社員がそのアドレスにアクセスしてチャットできます。
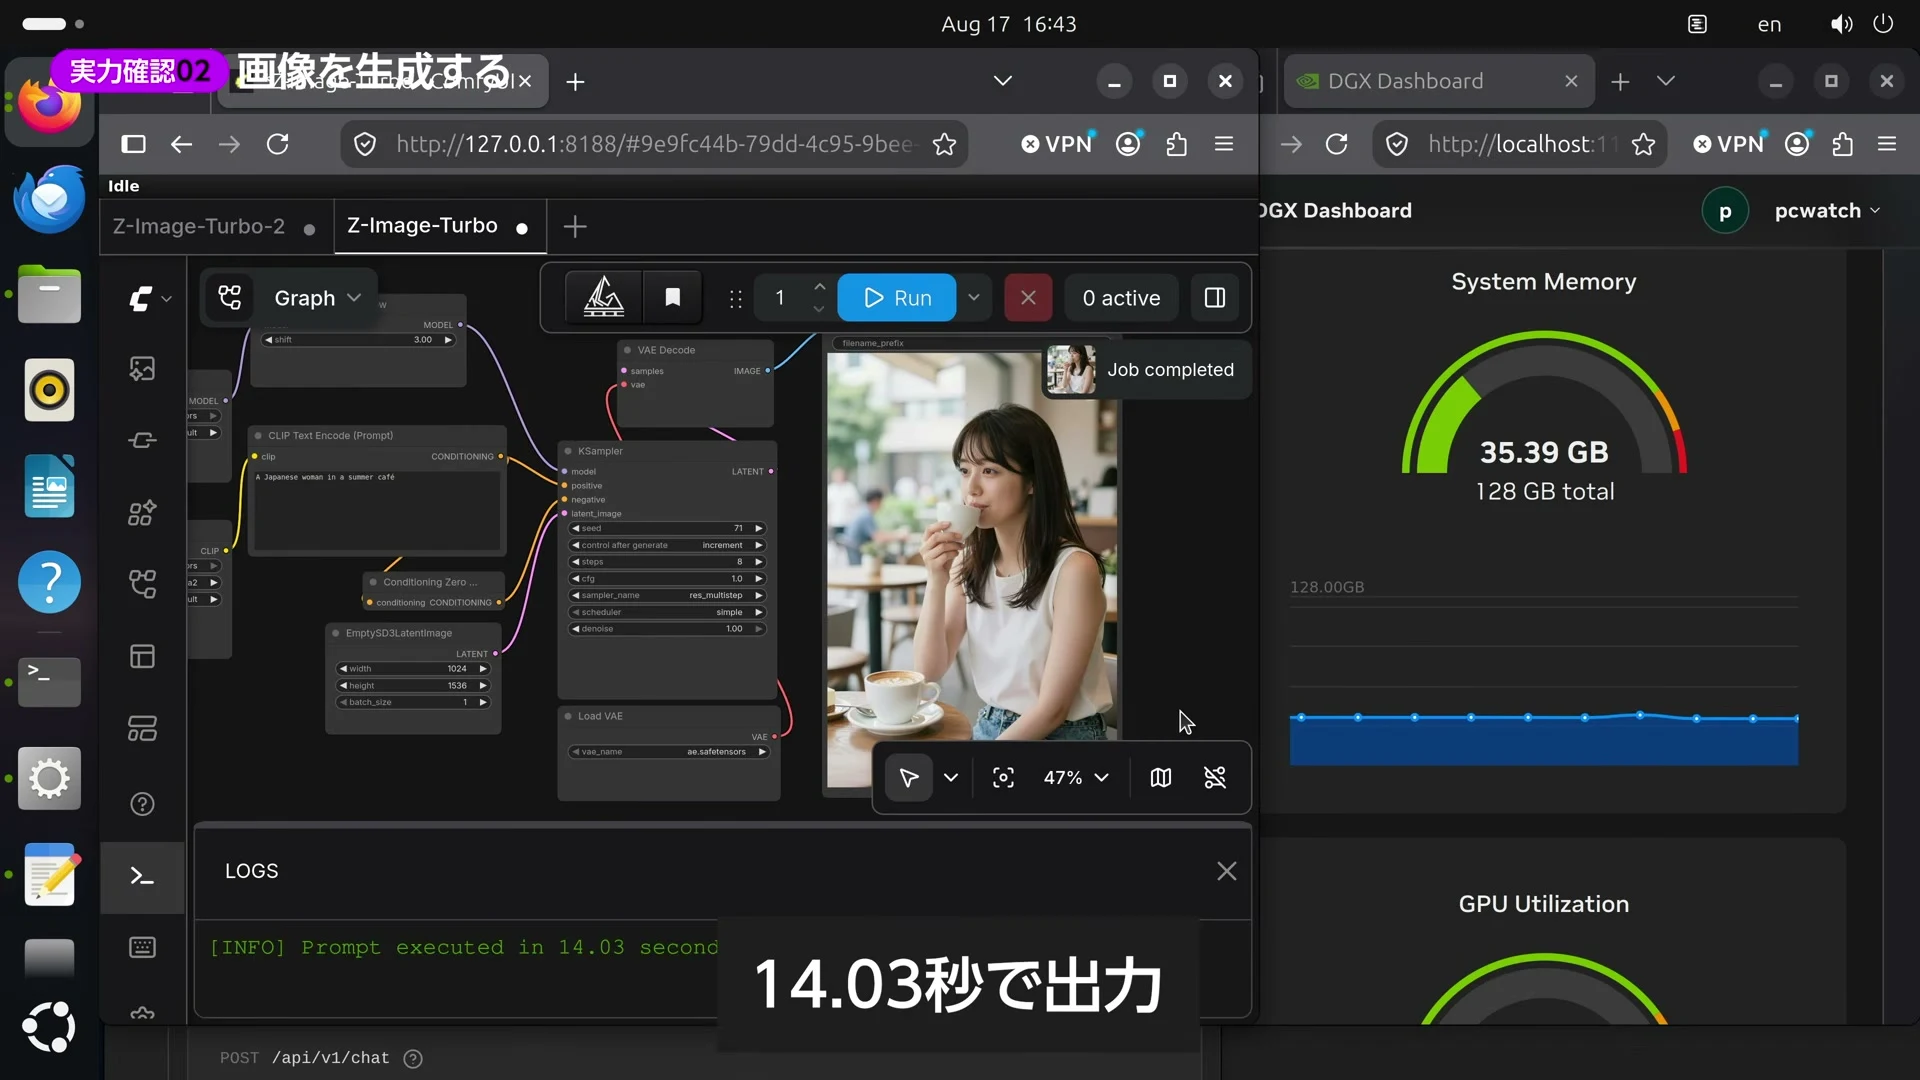
画像生成の実演は、ComfyUI ですね。PyTorch が最初から入っているので、ComfyUI を Git から持ってきて実行するだけで動きます。モデルは Z-Image-Turbo、解像度は1024×1536で、ロード中は35GBほど必要なんですよね。
1回目はモデルのロードがあるので、23秒ほどかかります。実際の速さが分かるのは2回目で、画面には14.03秒と出ます。西川さんの予想は、10秒ちょっとだったそうですよ。
西川和久さん(動画 9:57〜)
現場で使うときって一発OKなんてまずないんですよ
現場では何度もやり直しながら使うので、十数秒で出れば速い方、と西川さんは言います。正直、5090の方が速いし、もっと速いものも山ほどある、とも。それでもこの速さなら十分、というのが西川さんの結論でした。
西川和久さん(動画 10:17〜)
この速度で出てれば十分でしょっていうのが僕の結論ですかね
最速の数字ではなく、やり直しを前提にした速さ。動画が見せたのは、この見方でした。現場で何度も回すなら十数秒で足りる、という筋道です。
14秒は遅いのか、十分なのか?決め手は、1日に何回回すかのほうにあると思います。何十回も回す人と、たまに1枚だけ欲しい人では、同じ14秒でも重みが変わります。
で、私の手元の話をしますね。私は2026年9月24日の記事に、M5 Max・メモリ128GBのMacで画像生成のAIを試した話を書きました。
かかったのは1枚あたり、速い時で1分15秒、だいたい3分前後で、生成中のメモリは最大で約30GBでした。そして見出し画像を作った時、言葉どおりの絵になったのは14回中8回だったんですよね。
私の記事より(Qwen-Image-2.1は日本語に強いローカル画像生成AI、Macで検証した話・短い日本語でも、字が抜けることがあるの節)
この記事の見出し画像を作ったとき、頼んだ言葉がそのまま出たのは14回中8回でした。
動画は、一度で決まることはまず無いから、やり直しを前提に速さを見る、という話でした。私の記事に残っているのも、頼んでも思いどおりに出ない回が混ざる、という数字です。やり直しが前提という所で、2つは並ぶんですよね。
動画が測ったのは絵が出るまでの秒数で、私の記事が数えたのは、頼んだ言葉どおりに出る割合です。別のモデルの数字なので、そのままは当てはめず、仮の計算として使います。
なので私は、速さを最大値より、やり直した回数の合計で見ます。仮に14回中8回の割合で当たるなら、使える1枚までは、平均で約1.75回描くことになります。1回14秒なら、約25秒です。
一発で当たる前提で秒数を眺めても、毎日の現場の速さは見えてきません。1回の秒数に、当たるまでの回数を掛けたものが、現場で感じる速さだと、私は考えています。
机の横に置く機械で、速さの次に気になるのは、音と熱です。どれだけ速くても、そばでファンが鳴り続けたら、置き場所に困ります。この章は、高負荷のときの音と、温度の話ですね。
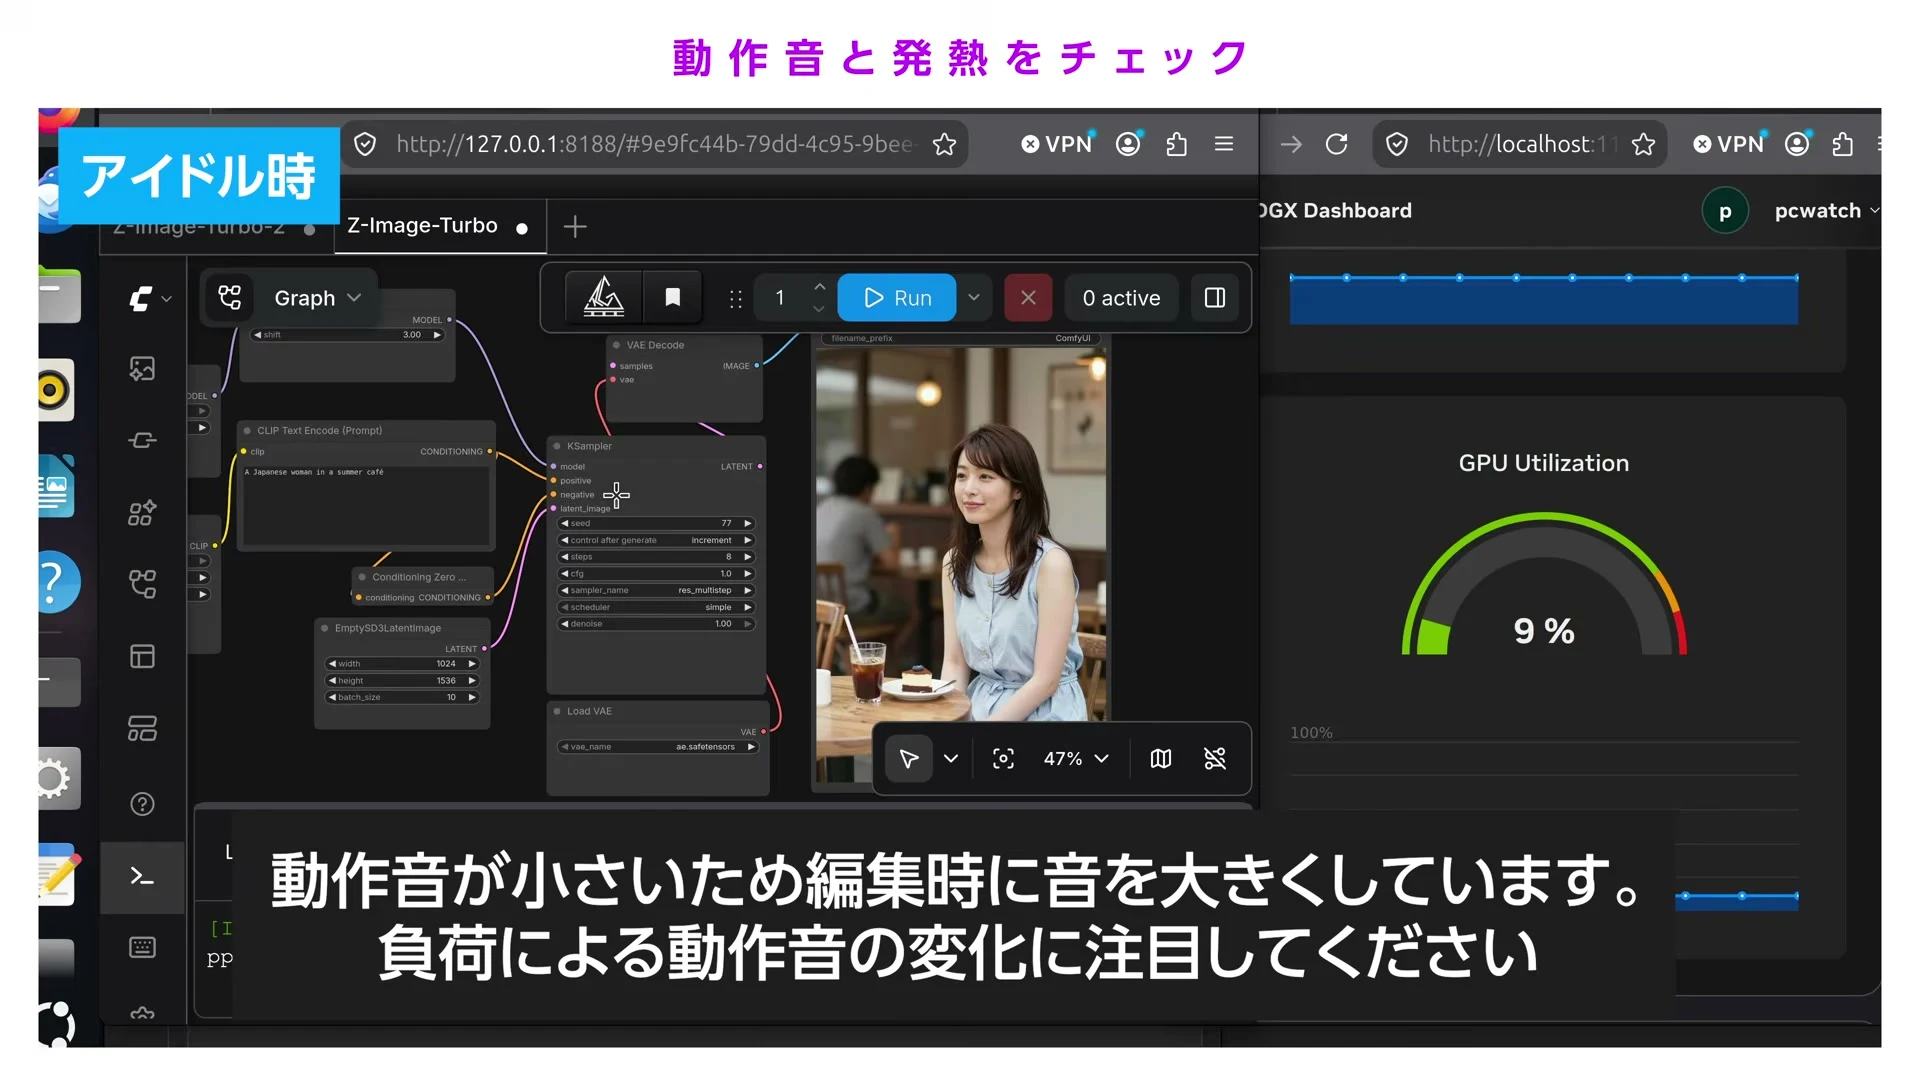
高負荷のときの動作音も、確かめます。マイクで音を拾い、ミキサーで持ち上げて、変化が伝わるかを試す流れ。まずは、GPUがほとんど動いていない状態で聞きます。
次に実際に動かすと、GPUは100%近くまでいきます。佐々木さんの耳には、動作音の変化が全く聞こえないそうですよ。
西川和久さん(動画 11:08〜)
このようにめちゃくちゃ静かなんですよ
一般的なワークステーションや、西川さんの自宅にある5090、4090は、フルロードでファンがうるさくなるそうです。この機械には、それが全く無いんです。
熱は、温かくはなるそうです。ちょっと熱いぐらいにはなる、とも。ただ、GPUの温度が89度にもなる機械とは比べられず、安心して使える、と西川さんは言います。どの機械の温度なのかは、発言では特定されていません。
西川さんがよく使うのは、LoRA の学習です。時間がかかって、下手をすると数日かかるそうですよ。
西川和久さん(動画 11:43〜)
なので数日間回しっぱなしになるんですけどもそんなこと5090では絶対したくないです
長い時間ずっと回しっぱなしにしても安心なのが、この機械の良いところの一つ、と西川さんは結びます。
速さの表に出にくい、静かさと熱。動画は、ここが数日回しっぱなしにできる安心につながる、という筋道で見せていました。速さとは別の物差しで、機械を見ている章です。
実は私、2026年8月28日の記事に、Macに外付けのRTX 5090を足す案を調べた話を書いているんです。
中身を並べると、華やかな構成の裏で、電源は1200W。そこに熱と騒音が付いてくる、という見立てでした。
私の記事より(Macの外付けGPUは使える?Mシリーズは公式非対応、RTX 5090は先にレンタル・見た目は豪華、中身は電源と熱と騒音の節)
見た目は豪華です。中身は、電源1200W、熱、騒音、Windowsの別棟。
動画は、フルロードでも音が変わらず、数日回しっぱなしでも安心、という話でしたよね。私の記事は、外付けのGPUを足すと、電源と熱と騒音が一緒に付いてくる、と書いています。2つを比べると、熱と騒音の重さの所で重なりますね。
で、私はこう見ます。数字に出にくい静かさと熱は、頼む側の気持ちの余白に効いてくるんですよね。音が静かなら、回している間も、横で別の仕事に向き合えます。
机の横に置いて、そのまま回しっぱなしにできるか?LoRA の学習のように数日かかる仕事なら、ここがめちゃ大事なんですよね。
速さの表には載らない所ですが、毎日使う道具では、ここが先に差になって表れると思います。
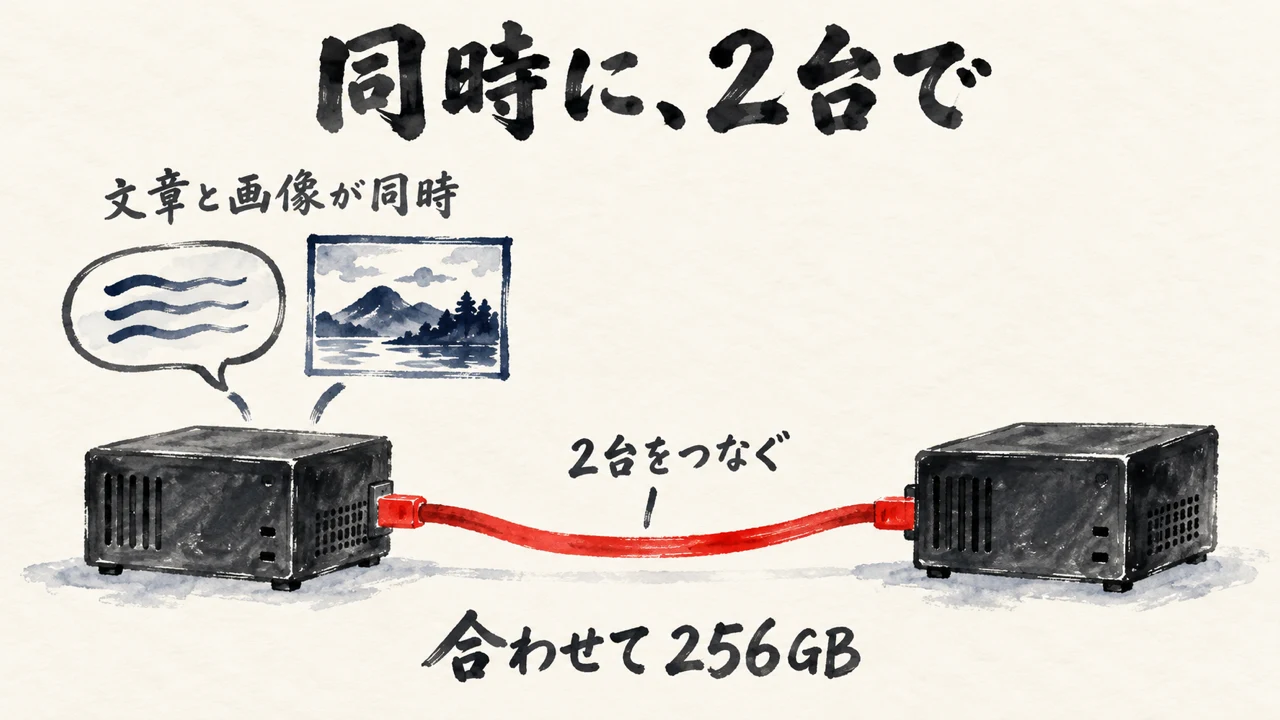
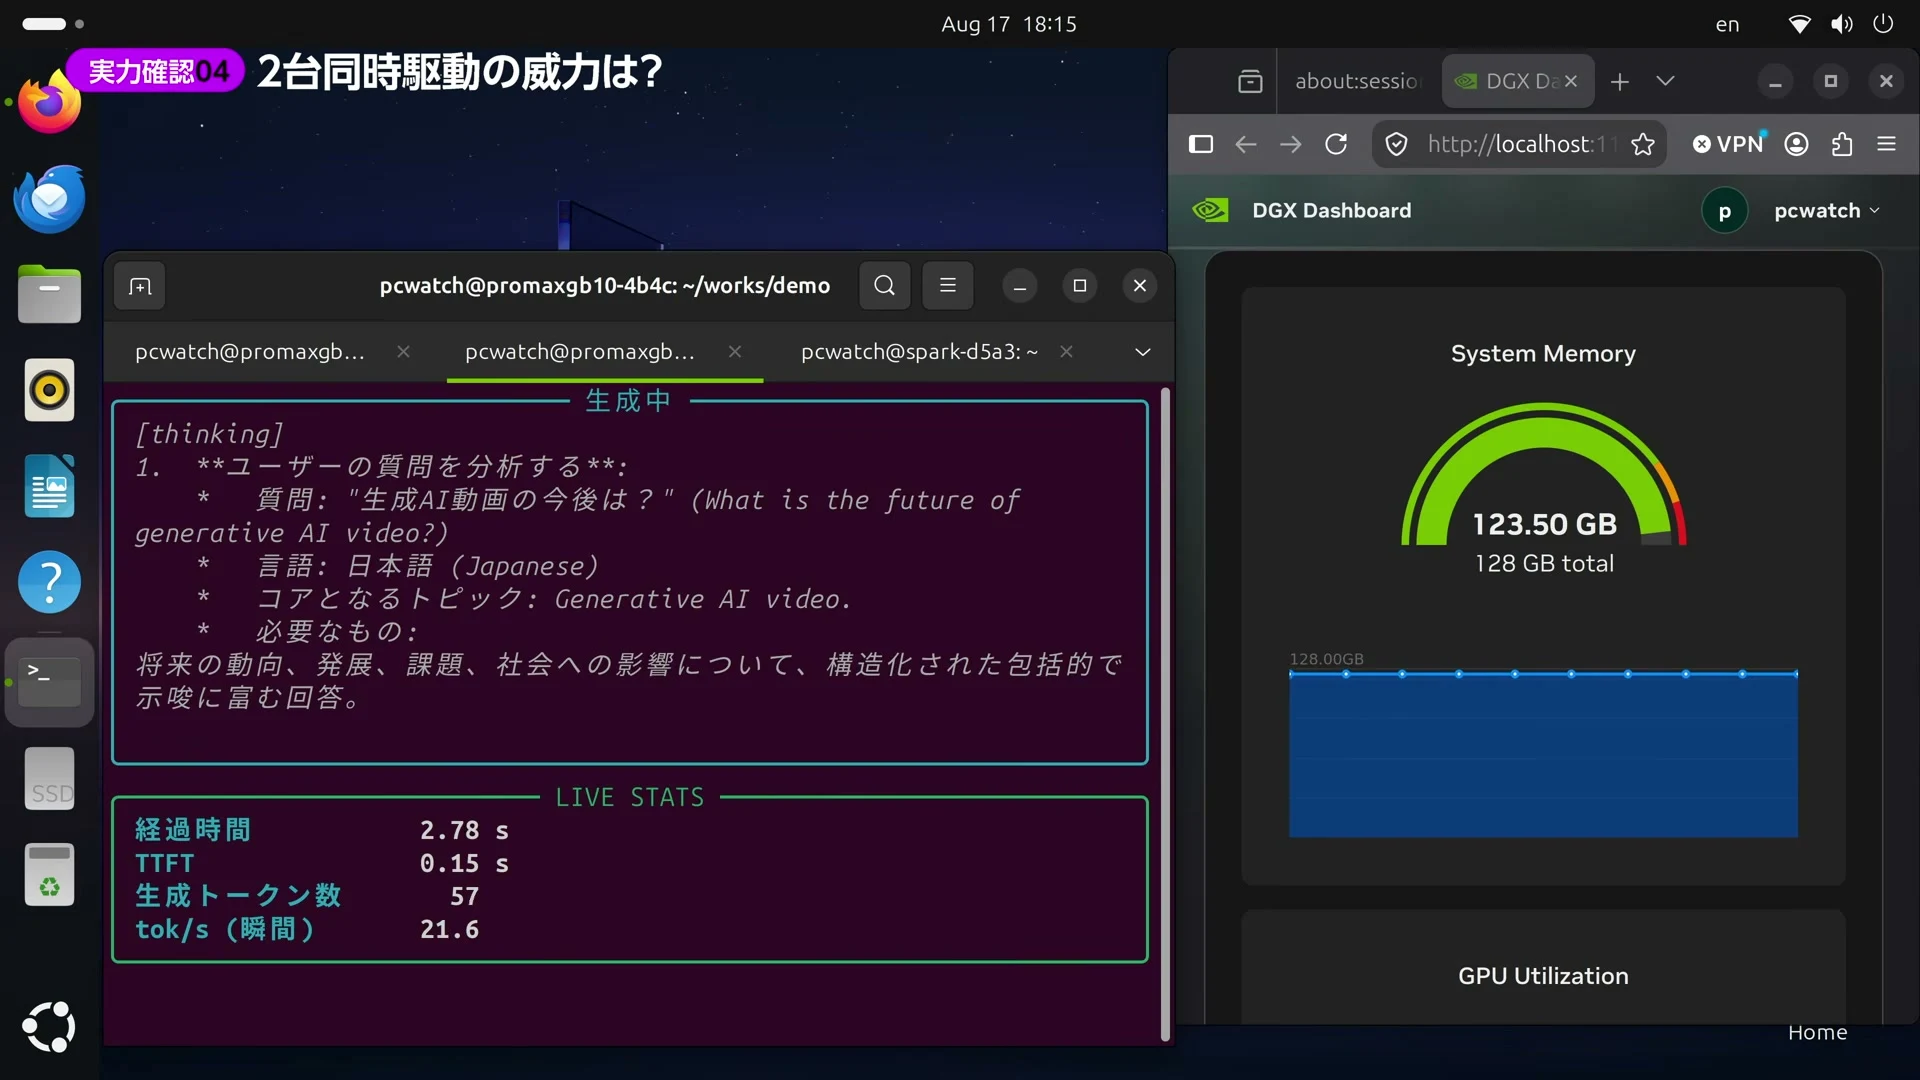
LLMも画像生成も、1つずつなら十分に動くことが分かりました。では、2つを同時に動かすとどうなるのか。後半は、2台目をつなぐ実演まで進みます。
ここからは、同時に動かす実演です。128GBあれば両方が載る、と西川さんは言います。
構成は、LM Studio で Qwen3.6-35B-A3B を動かし、ComfyUI のカスタムノードが画像を読み込んで LM Studio に渡し、どういう画像かを聞く形。返ってきた説明を、青空と日本人の女性という指示と合わせて、Z-Image-Turbo が描きます。
実行すると、先ほどの服を着た日本人の女性が、青空の下に立つ絵が出てきます。使っているメモリは、60GB超え。会話では、この容量は普通のRTXでは不可能、という話になります。
西川和久さん(動画 14:17〜)
全部が乗っかることが重要なんですよね
開発の現場では、1つのAIで終わることは少ないそうですよ。いくつものAIをパイプラインでつなぐので、すべてを同時に載せられるかが大事、と西川さんは話します。
後半の本題は、2台目ですね。128GBが2台で、合わせて256GBになります。7月31日にリリースされた DeepSeek V4 Flash が動く、と西川さんは言います。
284Bの大きさなので、128GBには基本的に載らないそうです。載せても圧縮が強くなりすぎて、性能があまり出ない、とも。256GBなら、そのまま動きます。
つなぎ方は、専用のケーブルをカチッと入れれば終わりなんですよね。物理的な接続はとても簡単だそうです。ソフトの設定は普通のネットワークで、下側と上側に別々のアドレスを振って ping を飛ばすと、返ってきますよ。
ロードが終わると、1台目のメモリはほぼ使い切り。2台目は画面を見せられないので、コマンドで見ると111GBで、こちらもほぼいっぱいです。
西川和久さん(動画 16:38〜)
要は2つあるから安泰ではなくて2つでギリギリ作動している状態なんですね
西川さんが自作の簡単なチャットで試すと、速さは19〜20 tok/s 前後だそうです。最大で35、最低でも16〜17は出ていて、この速さなら実用的、というのが西川さんの見方ですね。
佐々木さんは、DeepSeek V4 Flash がローカルで動けば外にAPIで投げなくてよくなり、このマシン2台でより高度なことができる、と受けます。2台セットで欲しくなる、とも。
2台が向くかどうかは、128GBで収まることしかしないのか、256GBが要るのかで決まる、と西川さんは言います。会話では、1台で始めて後から増設できるのも強み、という話になります。
同時に載せるにも、大きなモデルを動かすにも、分かれ目はメモリの量。動画は、この筋道を2つの実演で見せていました。
あ、ここで思い出したのが、2026年10月19日の私の記事です。M5 UltraのMac StudioとDGX Spark 2台を、同じモデルで比べる別の動画を紹介したんですよね。
そのまとめでは、2台に分けて持つ256GBと、1台の256GBとを並べて、持てるモデルは同じ、差は読む速さに出る、と書きました。そのまとめは、別の動画の内容を整理したもので、私が実機を動かした記録ではありません。
私の記事より(M5 Ultra 1台とDGX Spark 2台を比べる。長い文章を読ませると、AIが答えを返し始めるまでの待ちはSparkが約3倍短い・まとめ(256GBを2台に分ける)の節)
まとめは、256GBを2台に分けても、1台の256GBと同じモデルを持てる、ということ。違いが出るのは、読む速さです。
動画は、128GBを2台つないで256GBにし、大きなモデルをギリギリで動かして、19〜20 tok/s と話していました。私の記事に書いたのは、分けて持っても同じモデルは持てて、違いは読む速さに出る、という話でしたね。メモリを分けて持つ点で、この2つは並べて読めます。
私が大事にしたいのは、足せることと、足りることを分けて見ることです。足せる仕組みがあるほど、足す前に一度止まって測りたいんです。
先に1台で足りるかを測って、足りない所が見えてから足しても、遅くはないですよね。後から増設できるなら、なおさらです。
2台目は、足りない理由が言葉になってからで十分です。128GBで収まる仕事なのか、256GBが要る仕事なのか?ここを先に言えるかどうか、ですね。
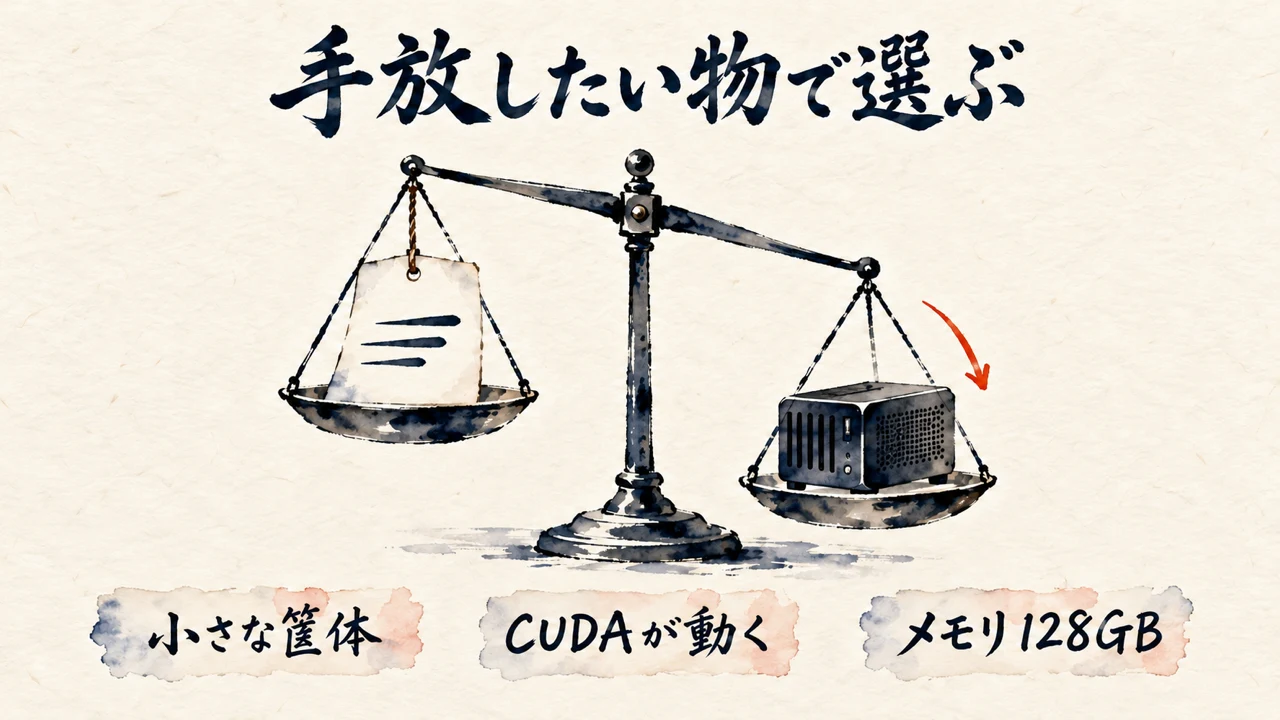
結局、この小さな箱はどんな機械なのか。速さで勝負する機械なのか、別の物差しで測る機械なのか。動画の締めくくりは、その答えから始まります。
最後に、佐々木さんがこの機械の性格を尋ねます。返ってきた答えは、画像や動画に全振りしたいなら5090などの方がいい、というもの。
そのうえで西川さんは、こんなに小さな筐体なのにCUDAが動き、128GBもあって、いろんなことができる点を一番の強みに挙げます。
西川和久さん(動画 19:16〜)
こんなに小さな筐体なのにCUDAが動き128GBがあっていろんなことができるっていうのがやっぱり一番強みなんですね
同じ量のメモリをビデオカードで積むなら、RTX PRO 6000 の96GB。ただ、このクラスは額が全然違い、本体のワークステーションも別に要ります。熱も消費電力も大きさも増えます。
対して、この機械はPCも含めて一台で完結。CUDAと大容量メモリを1台で実現する環境として、非常に現実的だそうです。部署の開発の検証や研究開発にも、個人のAI好きにも、ちょうど真ん中の機械だ、と言います。
Dellで買う意味の話も出てきます。まず、4TBのSSDが自己暗号化ドライブ。暗号化が要件の部署でも、後から暗号化ソフトを入れる手間がかかりません。
次に、万一のときにメーカーの対応窓口があること。開発や研究の現場では大きい点です。さらに、手配から納品、資産の管理まで、社内のいつもの手続きに乗ること。台数を増やすときにも効きます。
最速を競う箱というより、小さな筐体にCUDAと128GBがそろう箱。動画の見立ては、ここに落ち着きます。
速さで5090に負ける所を、動画は先に認めています。そのうえで、小さな筐体のCUDAと128GBを強みに挙げました。負ける所を隠さない見立てだから、買う前の物差しとして使いやすいと私は見ています。
で、私が大事だと思うのは、買う前の決め方です。速さのどの数字で選ぶのか。何を、置く場所と手間から外したいのか。ここを先に決めておきたいんです。
動画の順に並べてみると、外せる物が見えてきます。外観なら置き場所、起動なら立ち上げの手間、大きなAIならデータの置き場。
音と熱なら、机の横で回しっぱなしにする時の気がかり。2台なら、最初から大きく買わなくても後から足せる道。どれを外したいかで、同じ箱の意味が変わってきます。
逆に、一枚でも速く描くことが目的なら、物差しは別です。どちらで測るのかを、先に決める順番かな。
といっても、これは買う・買わないを決める話ではありません。何を手放したいのかを、自分の言葉で書き出す話です。置く場所、立ち上げ、データ、音と熱、増設。いちばん外したいのは、どれでしょう?
Q. 動画は、どんな内容ですか。
A. 佐々木さんと西川さんが、メモリ128GBの小さなAI専用機 Dell Pro Precision with GB10 を実機2台で検証する回です。外観から大きなAI、画像、音、同時動作、2台接続までを順に見せます。
Q. ネットにつながなくても動くのですか。
A. 動画の機械は、Wi-Fiにも有線のネットワークにもつながないまま、gpt-oss-120b などをローカルで動かしていました。どこにも情報が漏れない、という話も出ます。
Q. 画像生成の速さは、どのくらいですか。
A. Z-Image-Turbo で1024×1536の画像が、2回目から14秒ほどで出ると話します。やり直し前提なら十分使える、というのが西川さんの結論です。
Q. 動作音は、高負荷でも変わらないのですか。
A. GPUが100%近くになっても、耳では動作音の変化が分からなかったと話します。数日かかる学習を回しっぱなしにしても安心だそうです。
Q. 2台つなぐと、何ができるのですか。
A. 128GBの機械を2台つないで256GBにし、DeepSeek V4 Flash を動かしていました。速さは19〜20 tok/s 前後だそうです。2台でギリギリ動く状態だ、とも話します。
動画は、CUDAまで入った小さな箱、ネットにつながず動く大きなAI、やり直し前提で足りる画像の速さ、変わらない動作音、同時動作と2台で256GB、と進みました。画像や動画に全振りしないなら、小さな筐体にCUDAと128GBがそろうことが強みです。
さて、私がこの動画から持ち帰ったのは、立ち上げが軽くなった後には何をするかが残ること。データが手元に残る安心を、自分で考える材料にすること。速さは、やり直しの回数まで含めて見ること。静かさと熱は、毎日使う道具ほど先に効くこと。足せることと足りることは別なこと。そして、機材は手放したい物で選ぶこと。
小さな箱に、何を載せたいですか?そして、何を手放したいですか?
COLUMN
箱を足す前に、手放せた物を数える
後から足せると思えると、最初の1台を選ぶ時の迷いが、ずいぶん軽くなりますよね。私は2026年8月に、新しい箱の話を前にして、Macに外付けGPUを足す案を調べた記事を書いています。
私の記事より(Macの外付けGPUは使える?Mシリーズは公式非対応、RTX 5090は先にレンタル・箱を足す前に、味見係を増やすの節)
AIに委ねて、人は積み減らす。箱を積み増す話ではありません。
実はこの記事、外付けのGPUを調べた先で行き着いたのは、新しい箱を足すことではありませんでした。今は買わない、Macに外付けもしない、と結論を書いたんです。AIに委ねて、人は積み減らす側に立つ、という結論。
動画でも、まず1台で始めて、足りなくなったら2台目をつなぐ道が示されていました。足せると分かっていれば、最初の1台に全部を背負わせなくて済みます。だからこそ、足す前に、いまの1台で何を手放せたのかを先に確かめたいんです。
箱の数や、メモリの大きさで数えると、足すほど前に進んだように見えますよね?でも私が数えたいのは、AIに委ねたことで自分の手から離れていった物、つまり手放せた物の数のほうです。そう見ると、小さな箱に全部入りという動画の話も、置く場所と立ち上げの手間を手放せる話として、同じ問いに並んで見えてきます。
機材を選ぶ時に私が置いておきたいのは、箱を足す前に、先に手放せた物を数えるという順番です。箱の数より、手放せた物の数。
関連記事
手元のMacで写真を見て挿絵を当てる判定AIを試し、起動でつまずいた記録を書いた記事。
手元のMacで画像生成AIを試し、言葉の出方と生成の時間、メモリの使い方を測った記事。
Macに外付けGPUを足す案を調べ、電源と熱と騒音から、箱を足す前に数えることをまとめた記事。
1台のMac Studioと2台のDGX Sparkを同じモデルで比べた動画を、速さの種類で整理した記事。
困りごとのたびに仕組みを足すのは前進なのかを、AI2体の討論で考えた記事。足す前に手元の物を数える見方の参考に。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
今回紹介した動画
| チャンネル | PAD:PC Watch & AKIBA PC Hotline! |
| 出演 | 佐々木修司さん、西川和久さん |
| 公開日 | 2026年10月20日 |
| 長さ | 21分29秒(日本語) |
| URL | https://www.youtube.com/watch?v=qp_aUFWbhPY |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!