WATCH REPORT
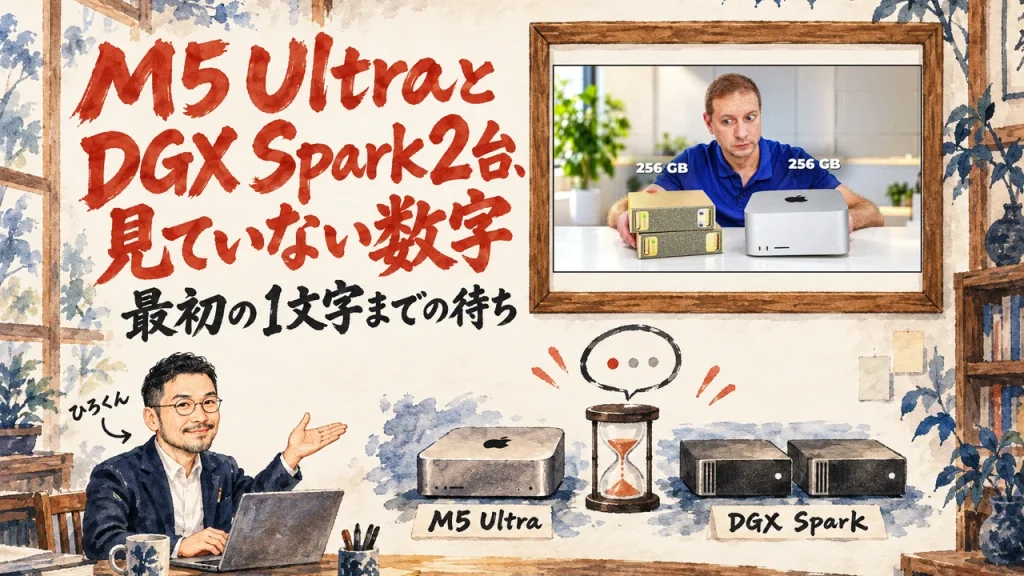
M5 Ultra 1台とDGX Spark 2台を比べる。長い文章を読ませると、AIが答えを返し始めるまでの待ちはSparkが約3倍短い
2026.10.19
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル Alex Ziskind で公開されている、M5 UltraのMac StudioとDGX Spark2台を同じモデルで比べた動画を紹介します。冒頭では書く速さがほぼ互角と示され、そのあとで、多くの比較が見ていない数字として、最初の1文字が出るまでの待ちに話が移ります。
ローカルでAIを動かす機械を選ぶ時、速さの数字を並べて見比べても、どの数字で決めればいいのか、迷いやすいものです。英語の長い動画を通しで見る時間がない人に向けて、この記事を書きました。
動画は20分37秒。冒頭で書く速さがほぼ互角と示されたあと、差が出る場所を一つずつ測っていく運びです。
読み終えると、動画の筋道を順に追えて、機械を選ぶ前に見る数字の見当が付きます。
SPEAKER
Alexさん
自分の机に並べたM5 UltraのMac StudioとDGX Spark2台を、同じモデルで測りながら、動画のほとんどの時間を一人で話す投稿者です。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)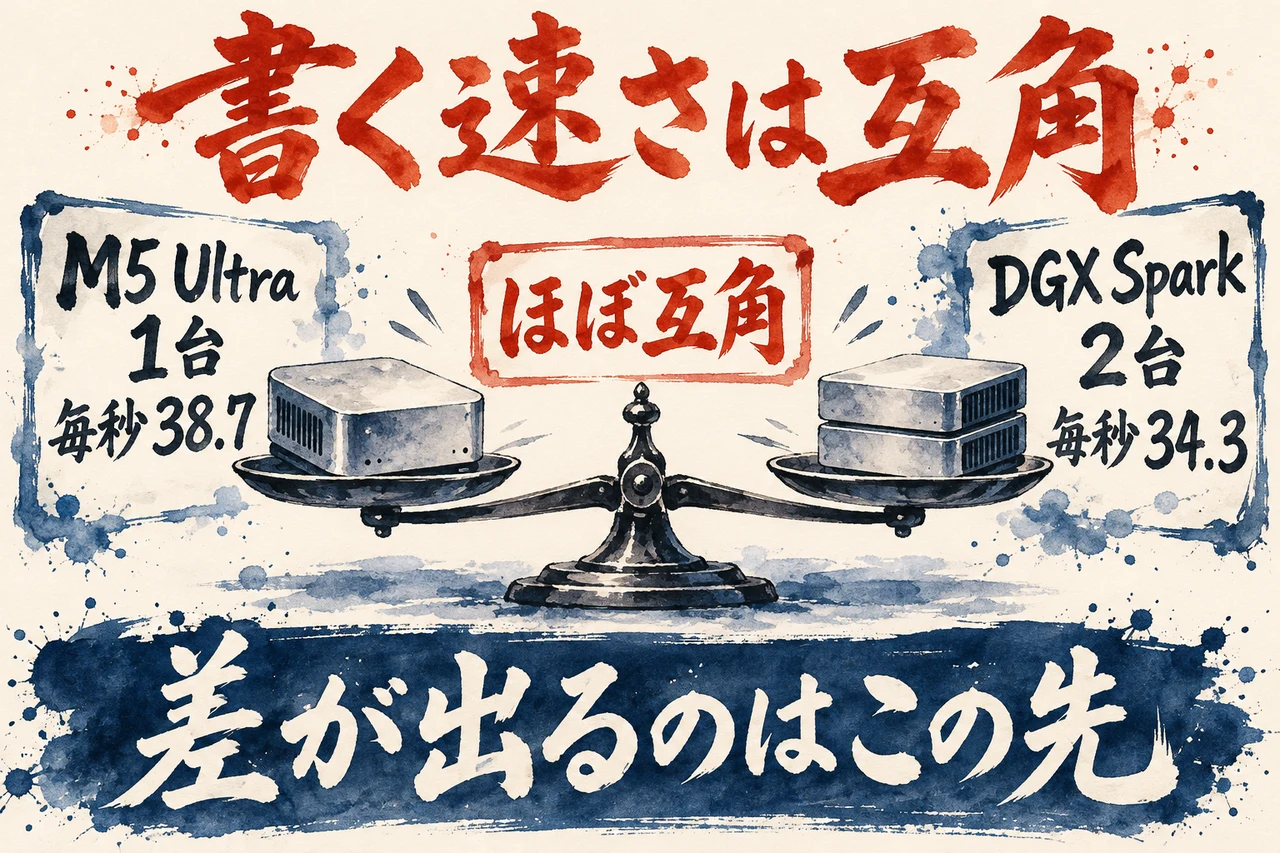
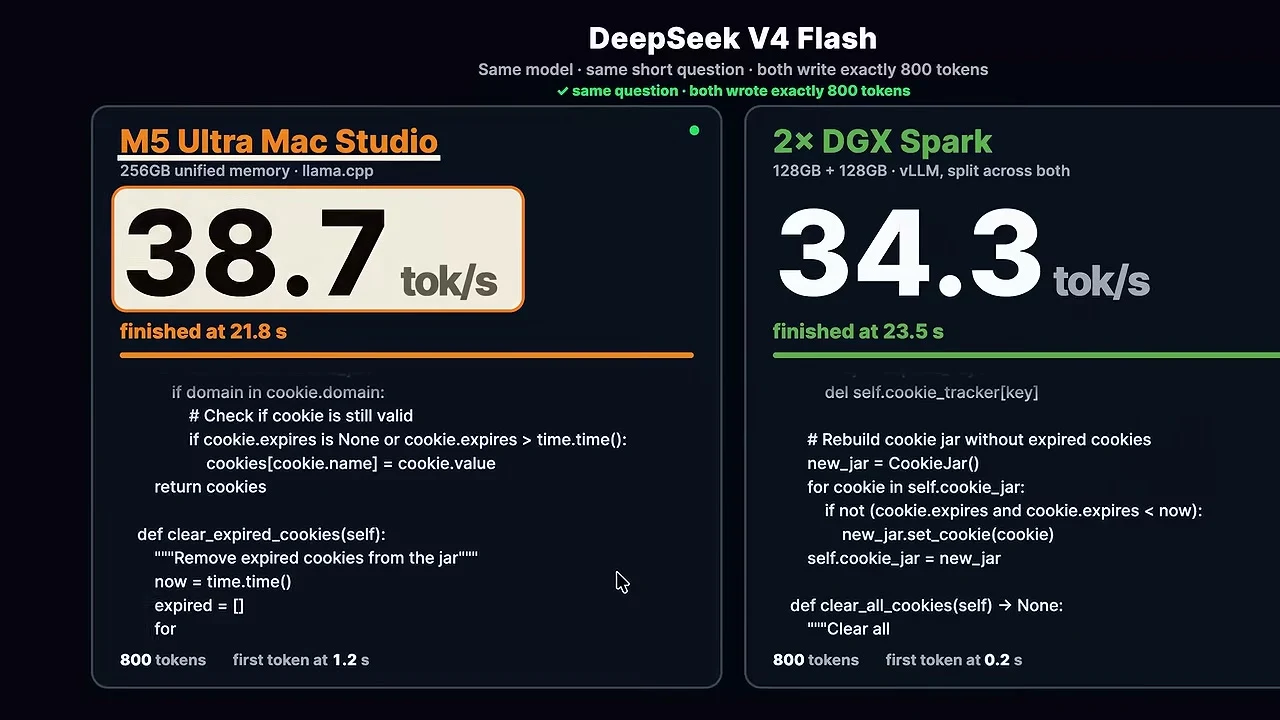
同じモデルに同じ量の答えを書かせたら、2つの機械の速さはどれくらい違うのでしょう?量の単位は、AIが読み書きする文字のかたまり(トークン)。800トークンを書かせると、M5 Ultra 1台とDGX Spark 2台は、ほぼ同じ速さでした。
動画は、同じモデルが同じ800トークンを書く場面から始まります。速さは、M5 Ultraが毎秒38.7トークン、DGX Spark 2台が毎秒34.3トークンです。
Alexさんの発言(英語の原文・0:25〜)
we’ll discover that there are quite a number of differences here. And this is the closest these two are going to get for the rest of the video.
結果は、ほぼ互角。ただ、Alexさんは、違いはこの先にたくさん出てくると話し、2台がいちばん近いのは動画の中でここだけ、と予告します。
比べるのは、M5 UltraのMac Studio(メモリ256GB・1台)と、DGX Spark 2台(各128GBで、合わせて256GB)。2台はケーブル1本でつなぎ、メモリを直接読み書きし合います。
ただ、2台を並べても、自動で1台にはなりません。vLLMという道具が、モデルの層を半分に割り、1トークンごとに両機が半分ずつ計算して、結果をケーブル越しに交換する仕組み。
2台にする理由は、モデルの大きさです。DeepSeek V4 Flashはおよそ150〜160GBあり、128GBのSpark 1台には載りません。
Alexさんの発言(英語の原文・3:51〜)
It doesn’t fit on one 128 gig Spark. And yeah, I tried loading it once. It didn’t work out so well.
実際、Alexさんは1台で読み込もうとして、思うように動かなかったと話します。2台なら、各機が半分を持てます。Macは1箱にそのまま載ります。
もう1つ、条件の断り。モデルは同じでも、ファイルは機械ごとに別物で、4ビットに小さくしてあります。SparkはvLLM、Macはllama.cppとMLXの両方で試す形です。
出発点は、書く速さは同じくらい。ここだけ見れば、どちらを選んでも変わらないように見えます。
書く速さは、ふだんチャットで答えが流れてくる時に感じる速さです。体感しやすい数字。
でも、Alexさん自身が、近いのはここだけ、と言っています。それなら、書く速さの数字だけで機械を決めるのは早い。私はそう見ます。
機械を選ぶ前に、速さの数字を1つだけ見て決めようとしていませんか?AIに渡す文章(プロンプト)が長い時には、もう1つ見る数字があります。
書く速さの数字の次に見る数字は、最初の1文字までの待ち(time to first token)です。
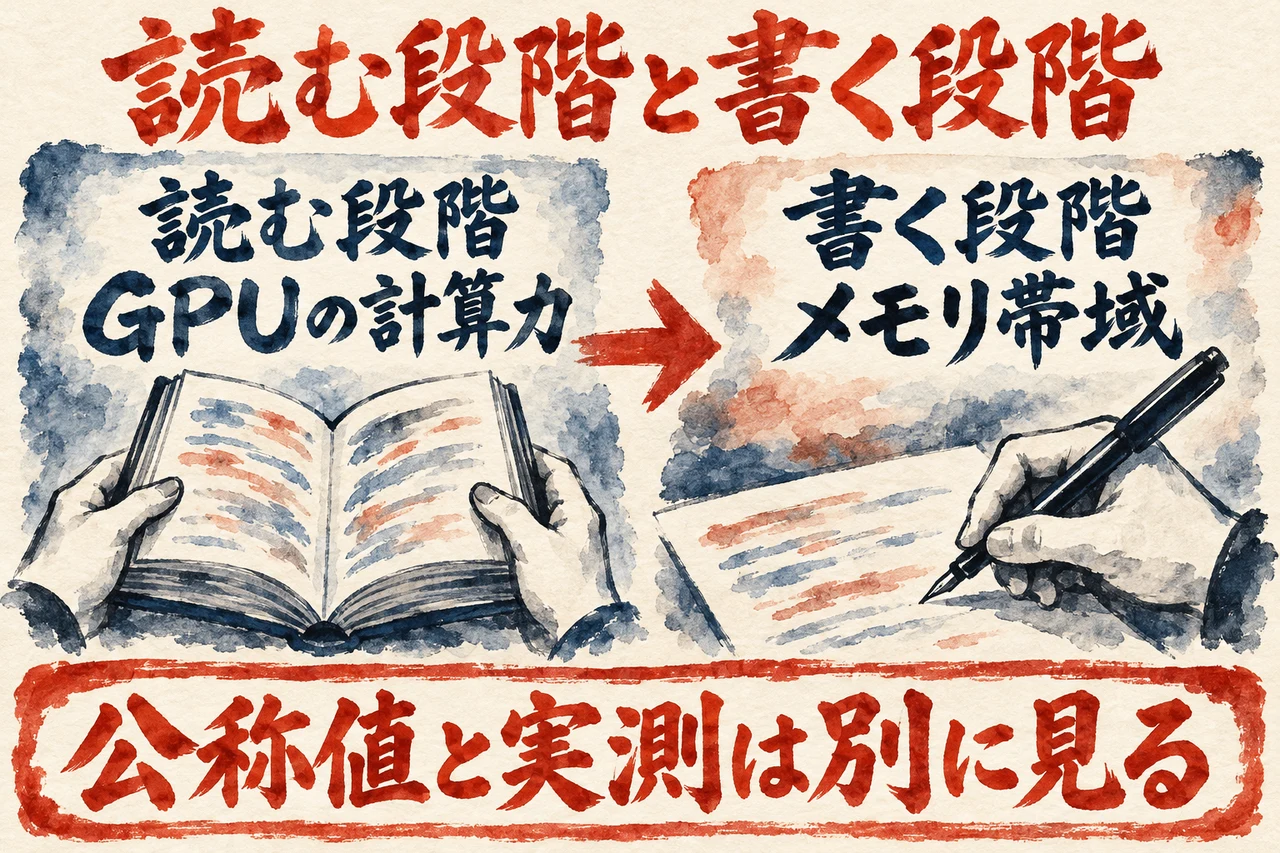
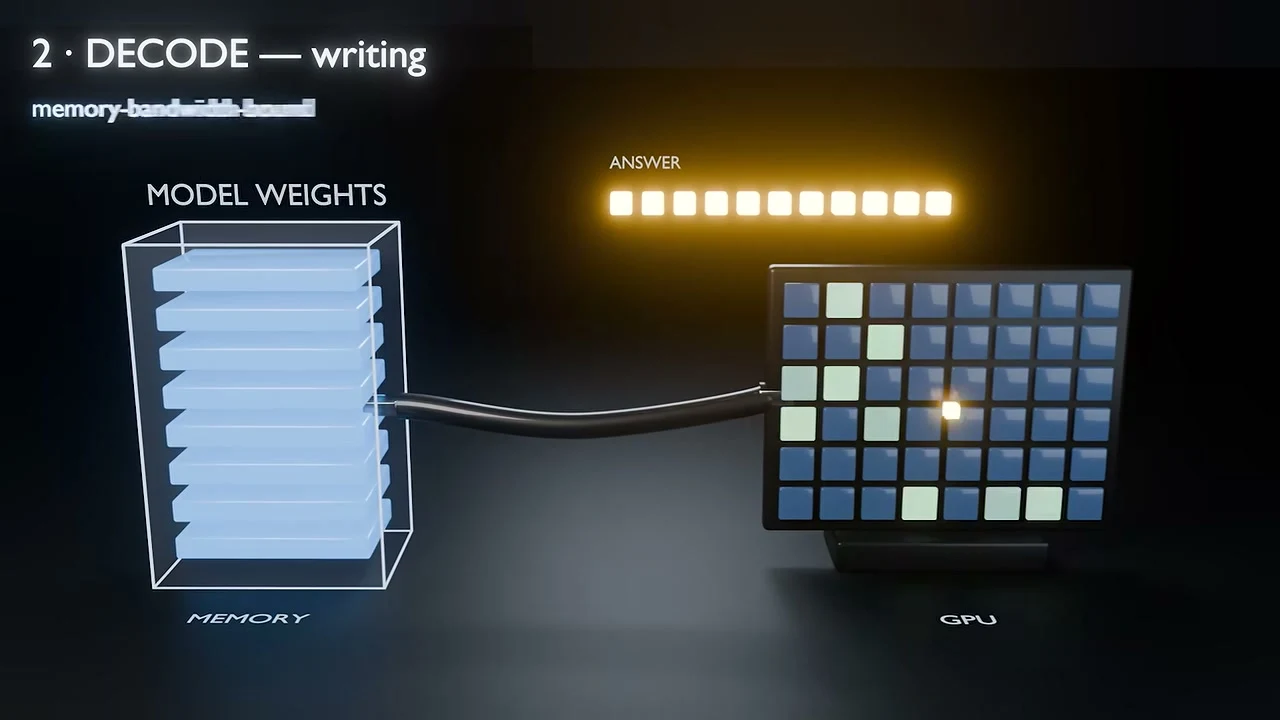
AIが答えを出すまでには、2つの段階があります。読む段階と、書く段階。それぞれ、機械のどの力で速さが決まるのでしょう?
1つ目は、プロンプト全体を一度に読む段階。行列の計算なので、GPUの計算力が効きます。ここでかかる時間が、最初の1文字までの待ちになります。
Alexさんの発言(英語の原文・5:07〜)
First, the model reads your whole prompt all at once. That’s pure math. It’s matrix multiplication. So, whichever box has more compute wins.
2つ目は、答えを1トークンずつ書く段階。1トークンごとにモデルの重みをメモリから読むので、メモリからデータを運ぶ速さ(メモリ帯域)で決まります。冒頭の比較は、この書く段階の話でした。
Alexさんの発言(英語の原文・5:39〜)
So, because for every token we use in the memory, the writing of the answer comes down to memory speed. In other words, the second part of inference is token generation, and it’s reliant on memory bandwidth.
次は、冒頭と少し違う回の測定です。何度も測ったので数字は近い、とAlexさんは言います。短いプロンプトを1人で使う場合、書く速さは、DeepSeekではMacもSpark 2台も毎秒約38でほぼ同点。Qwenでは、Macが45、Spark 2台が38で、Macが上です。
この差の理由について、Alexさんは、あくまで自分の見立てだと断ります。Appleによれば、M5 Ultraのメモリ帯域は毎秒1.2テラバイト。Sparkは1台あたり、定格で毎秒273ギガバイトです。
Alexさんの発言(英語の原文・6:35〜)
my best guess is memory. Apple says the M5 Ultra has 1.2 terabytes per second of memory bandwidth. That’s a lot. Each Spark is rated at 273 GB a second, significantly less.
ただし、2台をつなぐケーブルがどれだけ遅くしているかは、測っていません。だから少し割り引いて聞いてほしい、という断りが付きます。
道具の違いも大きい、と話は続きます。Macで使うllama.cppとMLXは、どちらもAIを動かす道具の名前。同じモデルでも、llama.cppよりMLXの方が速く、DeepSeekでは毎秒約40が約53になります。
私の記事より(Apple「M6」「M5 Ultra」発表を宇都宮充さんの記事で解説。ローカルでAIを動かす選択肢が広がる話・512GBが意味することの節)
512GBという数字は魅力的だけど、Apple公式の謳い文句と、自分の用途で実際に動かした結果は、はっきり別物として扱いたい。
これは、M5 Ultraの発表を解説した私の記事の一節で、一般論として書いたものです。今回の2機は私が動かしたものではなく、数字はAlexさんの測定です。この向きを動画の数字に当てはめると、書く速さの毎秒38.7と34.3は測った数字の側、毎秒1.2テラバイトと273ギガバイトは公称値の側です。
動画も、公称値と測った数字を、断りを入れて分けて話しています。分ける向きは同じ。公称値はメーカーの側の話で、測った数字は使う側の話です。
公称値は、機械を知る入口です。ただ、その数字だけで順位を付けると、読む段階の差を見落とす。両方を並べて見て、初めて差の出どころが分かります。
スペック表の数字を見る時、それは読む段階と書く段階の、どちらの数字でしょう?
見るのは、数字の出どころ。
公称値は入口にとどめて、決める数字は、自分の用途で測ったものにします。
ここまでは、1トークンずつ書く段階の話でした。ここからが、動画の題にある、多くの比較が見ていない数字に入ります。プロンプトを長くすると、何が起きるのでしょうか?
まず、入力が2,000トークンと短い場合です。Spark 2台はMacの約2倍の速さで読みますが、どちらも2秒前後で、気にならない、という話です。
入力を伸ばすと、差は開いていきました。DeepSeekで8,000トークンなら、Sparkが約4秒、Macが約10秒でした。16,000トークンになると、Macは約21秒かかります。
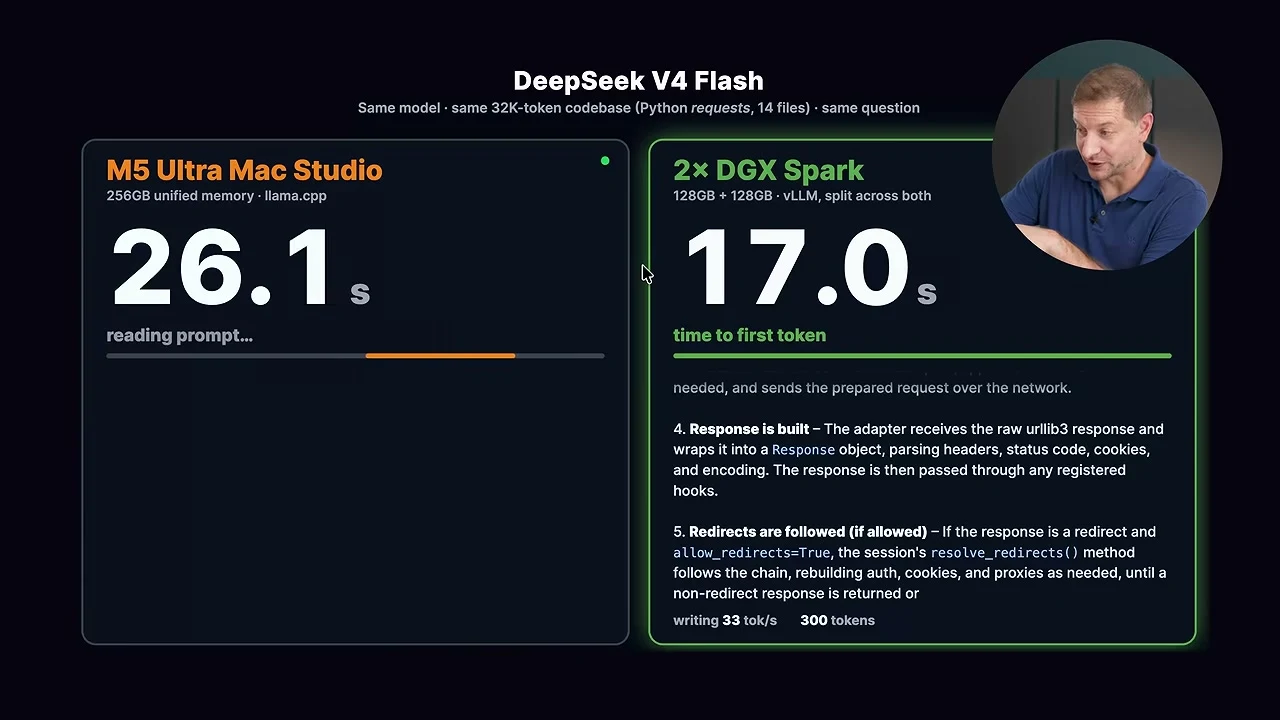
次の実験は、実際のコードを使います。Pythonのファイル14本、合わせて32,000トークンを読ませて、300トークンを書かせる形でした。画面は左がMac、右がSpark 2台で、同じ質問を投げます。
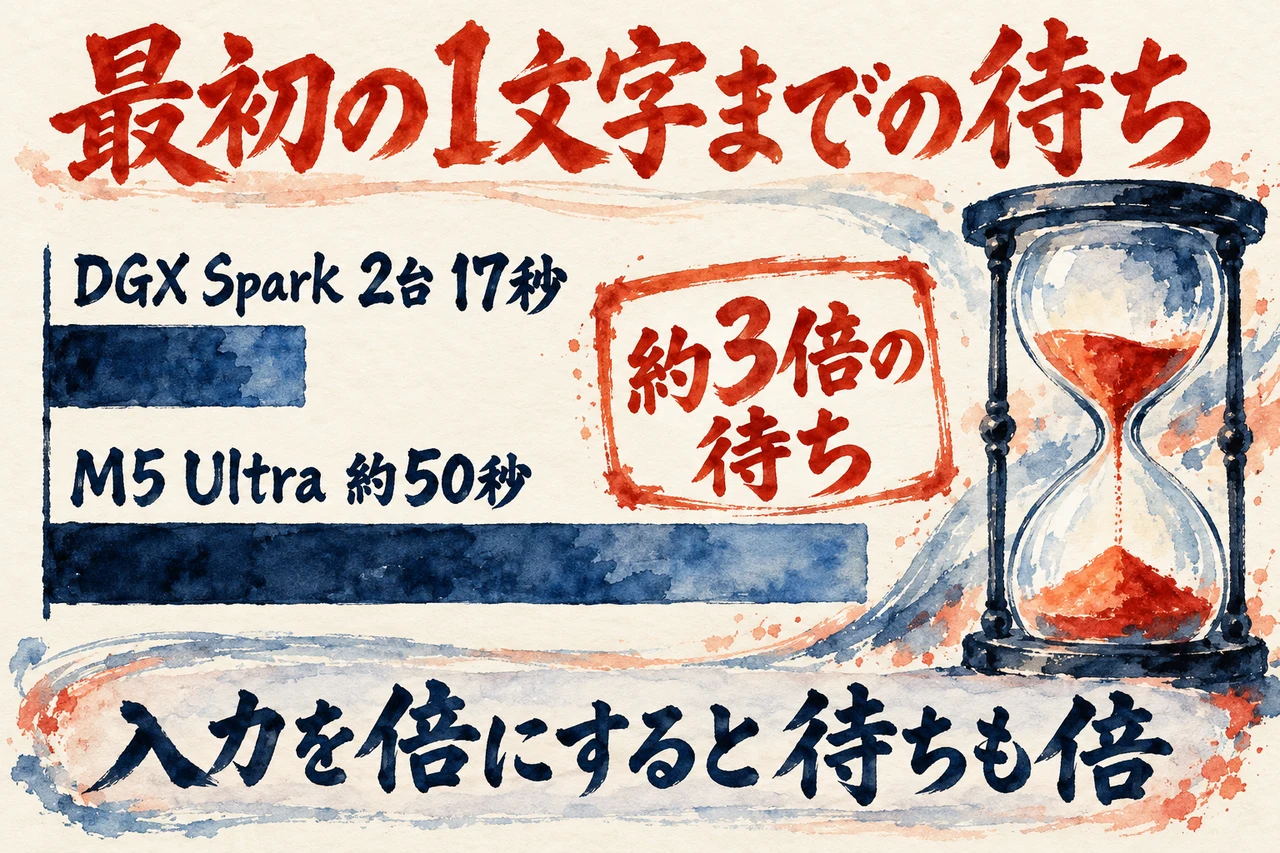
Sparkは17秒で、すでに書き始めていました。Macは、まだ読んでいる途中でした。
Alexさんの発言(英語の原文・9:49〜)
yeah, the Mac is still thinking. Still reading the prompt. Yeah, 50 seconds. I can hear it generating.
Macがまだプロンプトを読み続けている場面です。約50秒たって、ようやく書き出す音が聞こえる、とAlexさんは言います。待ちは、約3倍でした。
入力を倍にすると、待ちも倍。Sparkは128,000トークンまで測っていて、72秒でした。Macの128,000トークンは、測っていません。
Alexさんの発言(英語の原文・10:32〜)
And after that, it kind of keeps going. Double the prompt, double the wait.
その先も、プロンプトが倍なら待ちも倍、と続きます。結論は、長い入力ならSpark、長い出力ならMacが有利、というもの。Qwenでは書く速さでMacが詰めますが、追いつくのに数千トークン要るのは、測っていない見積もりです。
待ちは約3倍で、入力を倍にすれば、待ちも倍になります。この2つは、書く速さだけを並べた比べ方では、数字に表れません。
長いプロンプトを渡すほど、効いてくるのは最初の1文字までの待ち。私は、ここがこの動画の山場だと見ています。冒頭の互角は、入口にすぎませんでした。
私の記事より(NVIDIA DGX Sparkの使い方と活用術|ローカルLLM5選)
DGX Sparkはメモリ帯域が273GB/sと細めで、1対1のチャット速度は最速ではありません。
この一文は、DGX Sparkの使い方を整理した私の記事の一節です。動画の書く速さでも、Spark 2台は毎秒34.3、Macは毎秒38.7で、Sparkの方が少し遅い結果でした。
動画が見せた最初の1文字までの待ちとは、数えている場所が違うんです。同じ機械でも、別の数字で見れば、結論は入れ替わります。
速さの数字は、何を数えているかが先。長い文章を読ませるなら、効くのは最初の1文字までの待ちです。短いチャットなら、書く速さで見て足りるでしょう。
AIに渡している文章は、ふだんどれくらいの長さでしょうか?長い資料を何本も貼って読ませるのか、1行の質問で済ませるのかで、見る数字は分かれます。
待ちを見る前に、読ませる文章の大きさを先に決めておくのが、私の順番です。
ここまでの待ちは、質問するたびに毎回払うものなのでしょうか?32,000トークンで約50秒を毎回待つのなら、長いコードを扱う作業は進みません。Alexさんの答えは、実際の作業では違う、という話から始まりました。
実際の作業では、同じセッションの中で、サーバーが一度読んだ分を覚えています。読んだ分を覚えておく仕組み(キャッシュ)です。
Alexさんの発言(英語の原文・12:16〜)
That’s not how it happens in the real world. In a real scenario, in the same session, the servers keep what they’ve already read. There’s a cache.
現実の作業ではそうならず、読んだ分が手元に残っている、という話です。16,000トークンの文脈で、初回はMacが約21秒、Sparkが約8.3秒でした。2問目は、Macが約3秒、Sparkが約1.4秒です。
Alexさんの発言(英語の原文・12:49〜)
you pay for that long read only once per session, not every time.
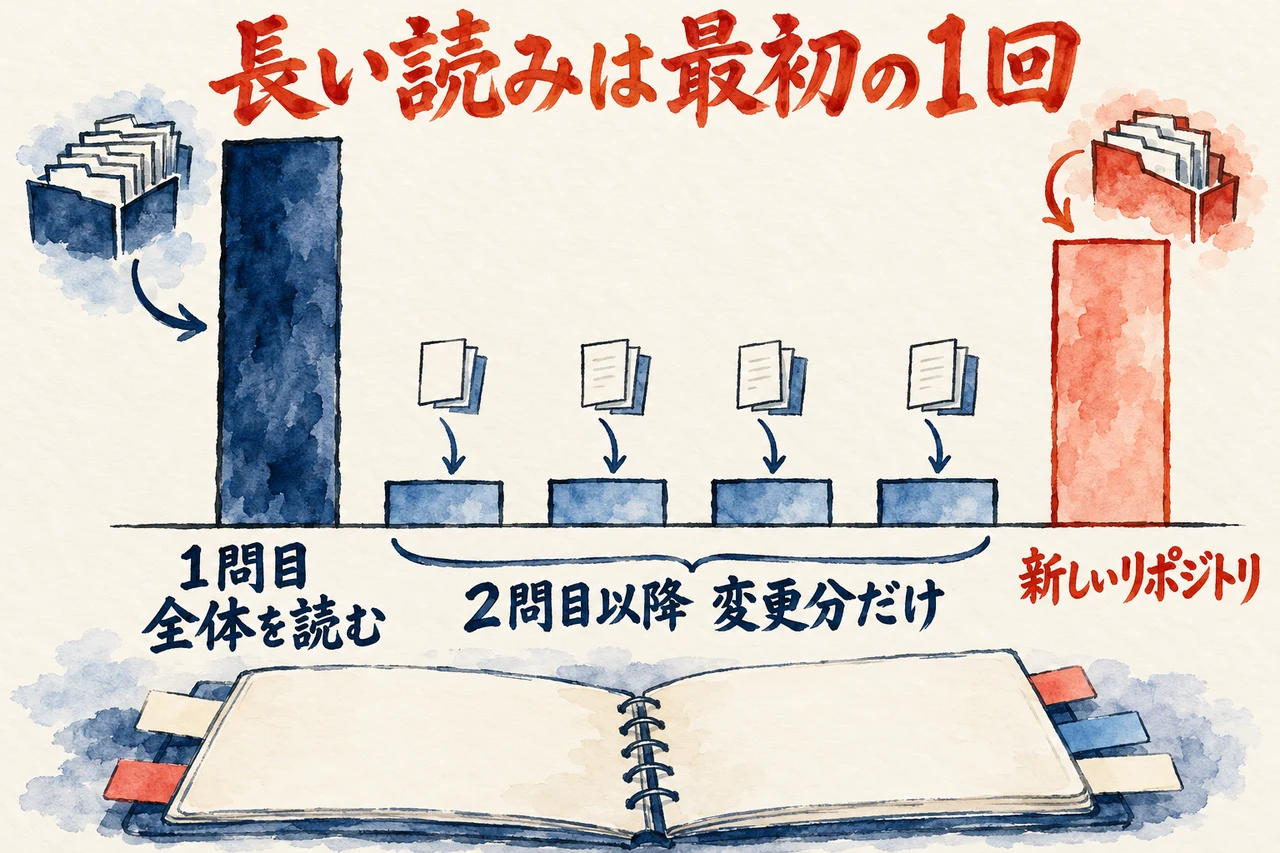
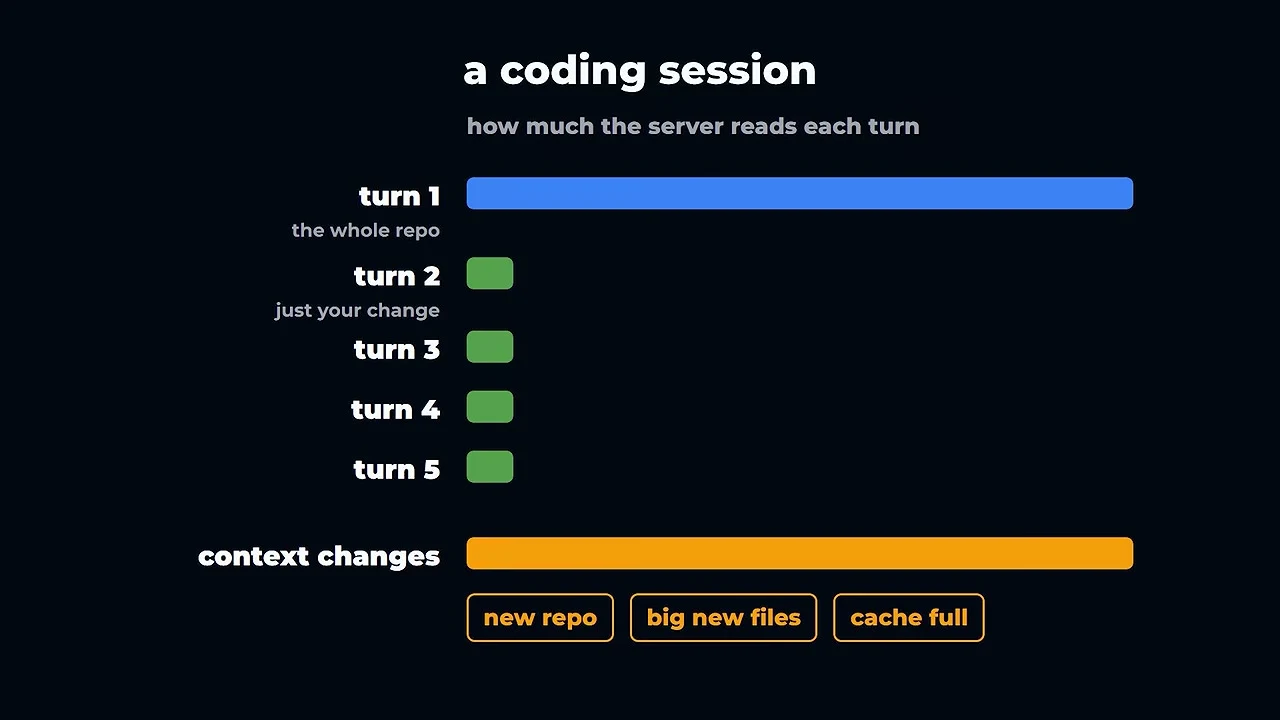
長い読みの待ちは、毎回ではなく、セッションごとに1回だけ。コーディングの道具は、コードベース全体を最初に1回送り、そのあとは変更した分だけを送ります。
画面では、最初の1回だけ全体を読む時間が長く、続く質問は変更分だけなので短く、文脈が変わる所でまた長くなります。
痛いのは、文脈が変わる時です。新しいリポジトリ、大きな新しいファイル、キャッシュがあふれた時、モデルを切り替えた時の4つが挙がります。
MacをMLXで助けられるか、という問いも出てきました。Qwenなら読むのは速くなりますが、Sparkには届きません。DeepSeekの長い入力は、動画の中でもまだ測られていません。
長い待ちは、最初の1回。2問目からは、短い待ちで答えが返ってきます。私は、ここが動画の中でいちばん実際の作業に近い話だと見ています。
前の章で見た約3倍の待ちも、同じセッションの中なら、質問のたびに払うものではありません。長いプロンプトの重さが、ここで一段軽くなります。
手元のローカルのAI(31Bのモデル)に短い計算の答えを出させて、時間を測りました。最初の1回は20秒、2回目は5秒。答えは31トークンです。
最初の1回の方が長くかかった点は、動画の話と同じ向きです。ただ、20秒と5秒の差が何によるのかは、私は測っていませんし、記録にも残していません。
動画が扱うのは、16,000トークンや32,000トークンという長い文章を読ませた時の待ちです。私の数字は、短い答えを1つ出させた時間で、規模がまるで違います。
重なるのは、最初の1回の方が長くかかるという向きだけです。
新しい資料を読ませる最初の1回の待ちは、数に入れておきたいところです。
画面に大きく出る速さの数字。あれは、いったい誰の速さなのでしょう? 動画の後半は、同時に使う人数を増やして測る話に移ります。1人で使う時と、何人かで分け合う時とでは、見える景色が変わってきます。
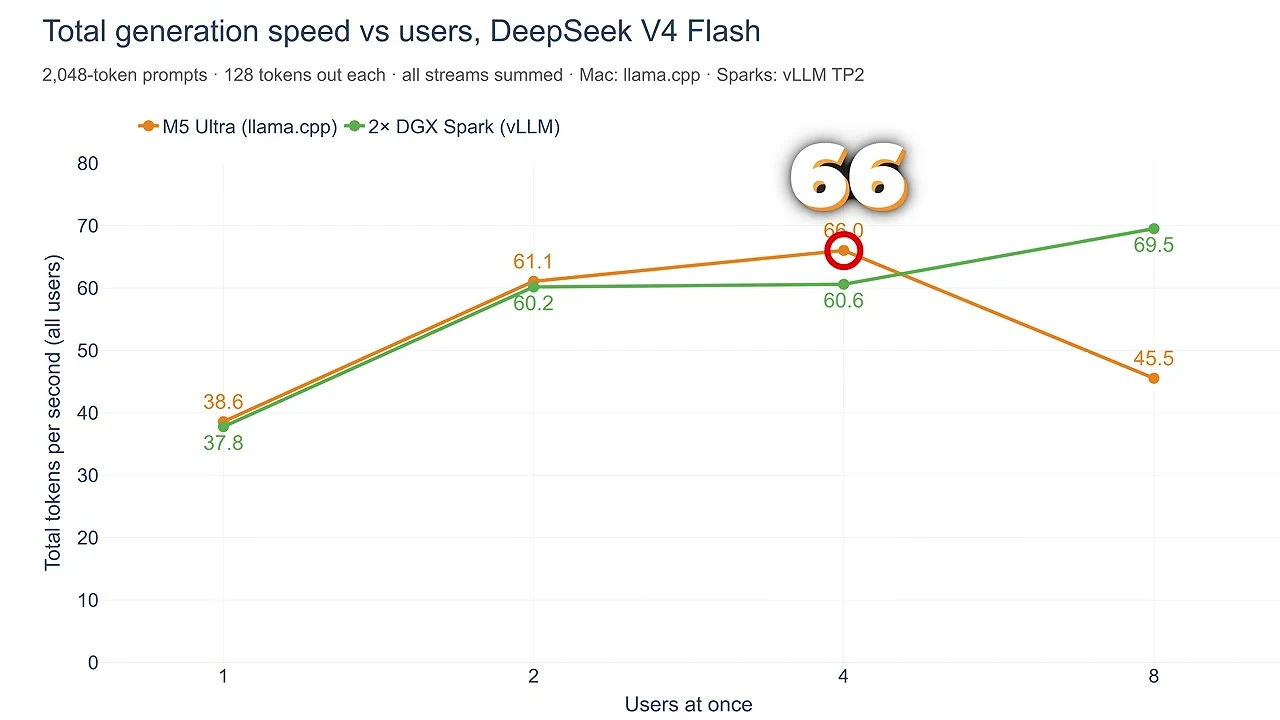
話は、同時に使う人数を増やした測定へ進みます。Alexさんによれば、画面に大きく出る数字は、全員の速さを足した合算。1人あたりが受け取るのは、その切れ端です。
Alexさんの発言(英語の原文・14:47〜)
But careful with that number though, because it shows everybody’s number. It’s everyone’s tokens added up. Each person only gets a slice.
表示される数字には、全員の分が入っている、ということです。人数が増えるほど、1人の手元に届く分は小さくなっていきます。
例はDeepSeek。Macの合算は4人でピークの約66に届き、8人では約46まで下がります。Sparkは8人で約70まで伸び続け、16人は測っていません。
1人ずつ1,000トークンの履歴を持つ8人で測ると、差はもっとはっきりします。最初の1文字までの待ちは、Macが1分を超え、Sparkは約24秒でした。
Alexさんの発言(英語の原文・16:36〜)
The Sparks are a little bit better for a small team, maybe four people. Eight? You’re pushing it.
Alexさんの結論は、こうです。4人くらいの小さなチームならSparkがやや上で、8人になると厳しい。1人か2人で使うなら、Macの側。
大きな数字は、全員の合算。1人の分は、その切れ端です。画面の数字が大きいほど、つい自分の手元の速さのように見えてしまいます。
でも、何人で使うかが決まっていないうちは、速さの数字は使い道が決まりません。比べる表をいくら眺めても、自分の答えには届かないんですよね。
だから、私なら先に人数を決めます。人数が決まって初めて、合算を見るのか、1人分を見るのかが決まります。順番の話です。
たとえば、自分1人で使うのか、家族や仲間と何人かで分け合うのか? ここで、見る数字がまるごと入れ替わります。
1人で使うなら、合算の数字は見なくてかまいません。見るのは、自分の手元に届く1人分の速さと、最初の1文字までの待ち。
人数を先に決めて、1人あたりの速さで見ます。合算の数字だけでは、決められません。
書く速さは互角で、読む速さで差がつく。ここまで見ても、Spark 2台は速さだけでは選べません。設定の手間はどれくらいか? 普段の仕事でどう使うのか。この2つも、判断に入ってきます。
Spark 2台は、ケーブル1本でつなげる、ちょうどよい構成です。ただ、両機のOSやドライバをそろえ、複数台で動かす通信の設定をして、機械どうしの通信を確かめる手間がかかります。
その代わりに得られるのは、クラウドと同じ並びの環境。Alexさんは以前、Sparkを4台、8台とつないだこともある、と話します。
Alexさんの発言(英語の原文・17:52〜)
That includes running large models. And for everyday work, it’s zero setup, basically. I can offload a lot of stuff to it, like rendering my videos, for example, for this channel.
Mac側の強みは、ここからです。大きなモデルも動き、日常の仕事ではほぼ設定が要りません。動画のレンダリングのような、AI以外の作業も任せられる、というのがAlexさんの話です。
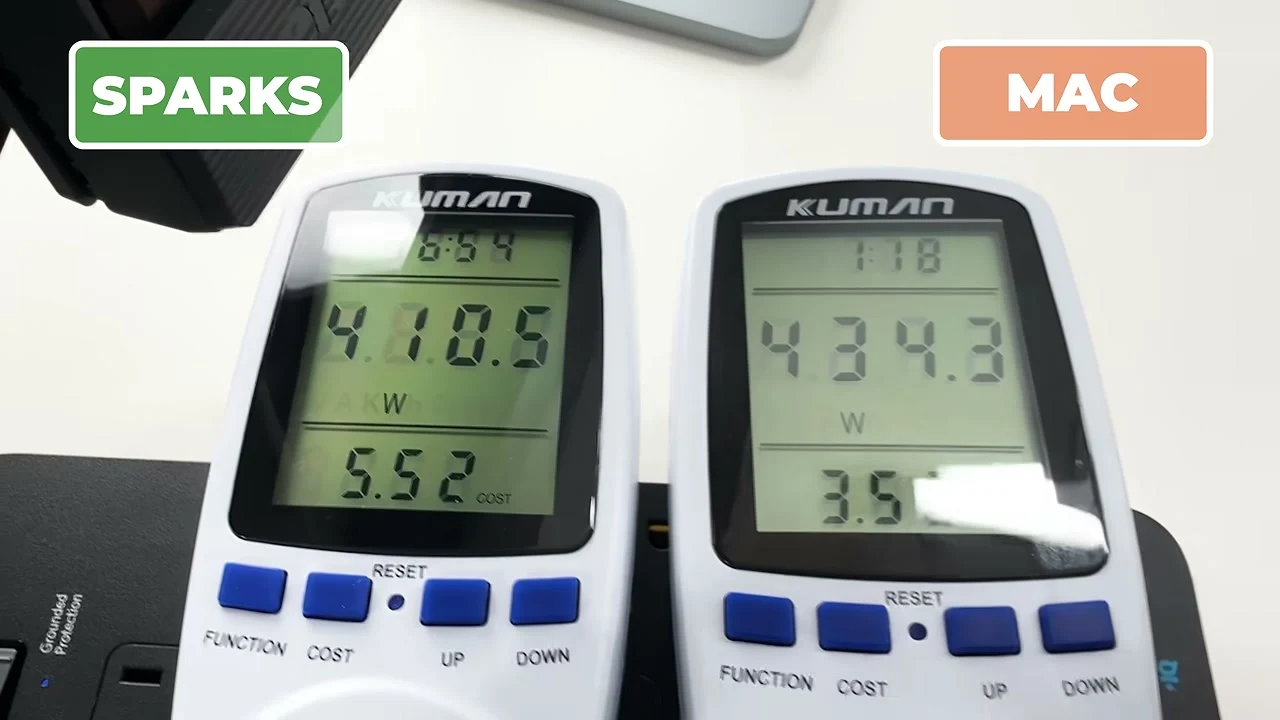
電力は、重い負荷でM5 Ultraが434ワット、Sparkのクラスタが410ワット。ほぼ同じです。
まとめは、256GBを2台に分けても、1台の256GBと同じモデルを持てる、ということ。違いが出るのは、読む速さです。
Alexさんの発言(英語の原文・20:06〜)
look at your own work. How big are your prompts? How long are the answers to your prompts?
大きな金額を出す前に、自分の作業を見て、という呼びかけです。プロンプトはどれくらい大きいか。答えはどれくらい長いか。
設定の手間と、日常機の強み。どちらも、速さの数字には出てこない所です。それでも、毎日使う機械を選ぶなら、ここもちゃんと選ぶ数字に入ってきます。
Macを日常の機械として使う話は、Mac miniで自動化が進まない理由を、5台運用した三森一輝さんの動画で解説した記事でも読めます。
私の記事より(Apple「M6」「M5 Ultra」発表を宇都宮充さんの記事で解説。ローカルでAIを動かす選択肢が広がる話・誰のためのマシンかの節)
ローカルで巨大なLLMを動かしたい具体的な理由がある人には最高の投資だし、スペックが眩しいから欲しいだけなら、たぶん宝の持ち腐れになります。
M5 Ultraの発表を解説した、私の記事の一節。動画の締めの、自分の作業を見て、という呼びかけと向きが同じです。
ここで言う具体的な理由とは、読ませる文章の大きさと、答えの長さのこと。私は、そう言い換えて判断します。
速さの数字は、使い道が決まってから意味を持ちます。買う前に数える順番は、プロンプトの大きさ、答えの長さ、使う人数、設定にかけられる手間。
数えた先に、どちらの1台かが見えてきます。逆に、ここを飛ばすと、表の数字に選ばされてしまうんですよね。
私なら、表の数字より先に、自分の仕事のプロンプトと答えの大きさを見ます。
Q. 書く速さが互角なら、どちらを選んでも同じですか?
A. 書く速さは、M5 Ultra 1台が毎秒38.7トークン、Spark 2台が毎秒34.3トークンで、ほぼ互角。ただ、Alexさんは、この2台がいちばん近いのはここだけ、と予告します。長い入力では、最初の1文字までの待ちに差が出ます。詳しくは第1章。
Q. 最初の1文字までの待ちとは何ですか?
A. プロンプト全体を、一度に読む段階の時間。ここはGPUの計算力で決まります。32,000トークンのコードを読ませると、Spark 2台は17秒、Macは約50秒でした。入力を倍にすると、待ちも倍。詳しくは第3章。
Q. キャッシュが効けば、長い読みの待ちは気にしなくていいですか?
A. 同じセッションの中なら、読んだ分を覚えているので、長い読みは最初の1回で済みます。ただし、新しいリポジトリや大きな新しいファイル、モデルの切り替えでは、また長い読みが戻ってきます。気にするのは、文脈が変わる時。詳しくは第4章。
Q. 何人で使うと、Macは厳しくなりますか?
A. Alexさんの目安では、Macは1人か2人向き、Sparkは4人くらいの小さなチーム向き。8人は厳しい、と言います。画面の大きな数字は全員の合算で、1人あたりはその切れ端です。詳しくは第5章。
Q. 機械を買う前に、何を見ればいいですか?
A. 自分のプロンプトの大きさと、答えの長さです。そこに、設定の手間と、日常の使い方を重ねます。電力は重い負荷で434ワットと410ワット、ほぼ同じ。決め手は、自分の作業の形です。詳しくは第6章。
動画の筋道はシンプルです。書く速さは互角で、差が出るのは最初の1文字までの待ち。長い入力ほど、Spark 2台の待ちが短くなる、という話でした。
私の見方はこうです。実際の作業では、長い読みは最初の1回で済みます。人数が増えると、1人あたりの速さは細くなります。だから、使い方を決めてから数字を見ます。
見る順番は、書く速さ、最初の1文字までの待ち、キャッシュ、使う人数、設定の手間と電力。この順に並べると、どこで差が開くのかが見えてきます。
動画と重なるのは、ここです。同じ数字でも、何を数えているかで結論が変わります。
速さの比べ合いは、そのあとで十分です。買う前にまず見るのは、自分の仕事の文章の大きさと、答えの長さです。
関連記事
Macを日常の機械として使う話の、続きとして読めます。
自宅のマシンにAIの仕事を任せる、という点で、第6章の日常機の話とつながります。
買う前に先に確かめる、という順番は、この動画の締めと同じ向きです。
ローカルのモデルを含めて、道具の使い分けを考える時の1本です。
ローカルLLMの周りを調べる時の、次の1本です。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
今回紹介した動画
| チャンネル | Alex Ziskind |
| 出演 | Alexさん |
| 公開日 | 2026年10月1日 |
| 長さ | 20分37秒(英語) |
| URL | https://www.youtube.com/watch?v=_yrw6c5gw3E |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!