READ REPORT
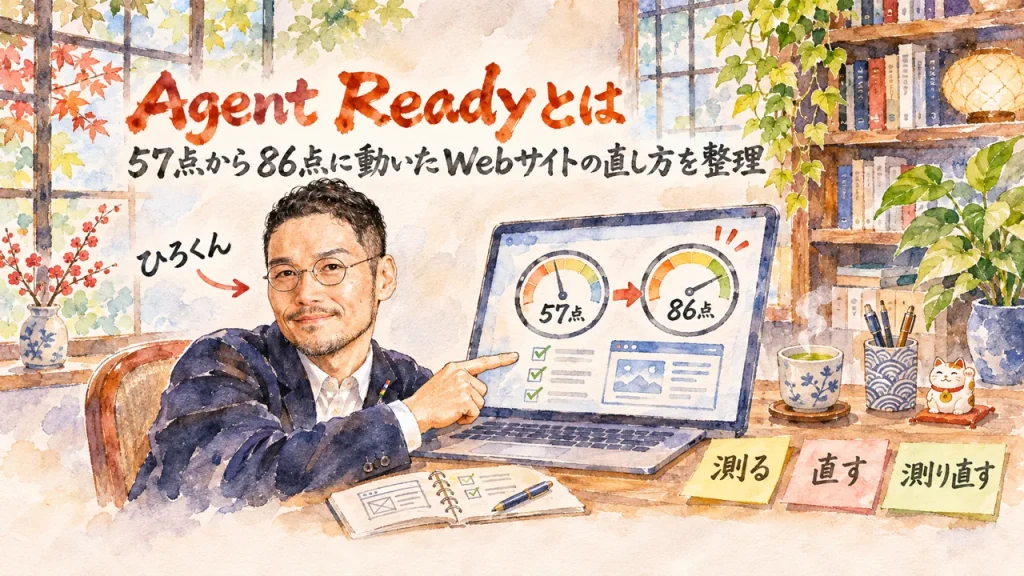
Agent Readyとは。57点から86点に動いたWebサイトの直し方を整理
2026年11月12日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回紹介するのは、unvalleyさんの記事「WebサイトをAgent Readyにしよう」です。自分のWebサイトを、AIエージェントが見つけて理解できる状態にする話で、2つのスキャナーの点数が57点から86点、69点から89点に動いた記録です。
私が保存したブックマークの1つです。公式サイトはAIが掘りに来る地層、AIが迷わず少ない手数で動ける形に窓口を作り直す、構造化データは本文と一致させる。私がこれまで書いてきた考えと、同じ向きで読める記録だったので取り上げます。
読み方の筋は、Agent Readyとは、2つのスキャナー、Markdownを返す直し、Vary・JSON-LD・404の直し、残った指摘とllms.txt、の順です。なお私はスキャナーを動かして確かめたわけではなく、記事を読んで整理しています。
AIエージェントが、Webサイトを読んで調べる時代になりました。unvalleyさんは自分のサイトを2つのスキャナーで測り、4つ直して点数を動かしました。その記録を読んで整理します。
3行でわかるポイント
- Agent Readyは、AIがサイトを見つけて理解する準備のこと
- 2つのスキャナーで、57点から86点と69点から89点に動いた
- 試す前に、サイトの種類・要らない項目・直す順番を決める
unvalleyさんのブログ「UNV」の記事(2026年11月12日公開)。自分のサイトを2つのスキャナーで測り、直して点数が動いた記録。2026年11月12日に取得した
Agent Readyとは。AIエージェントがWebサイトを読む準備を、2つのスキャナーで測る
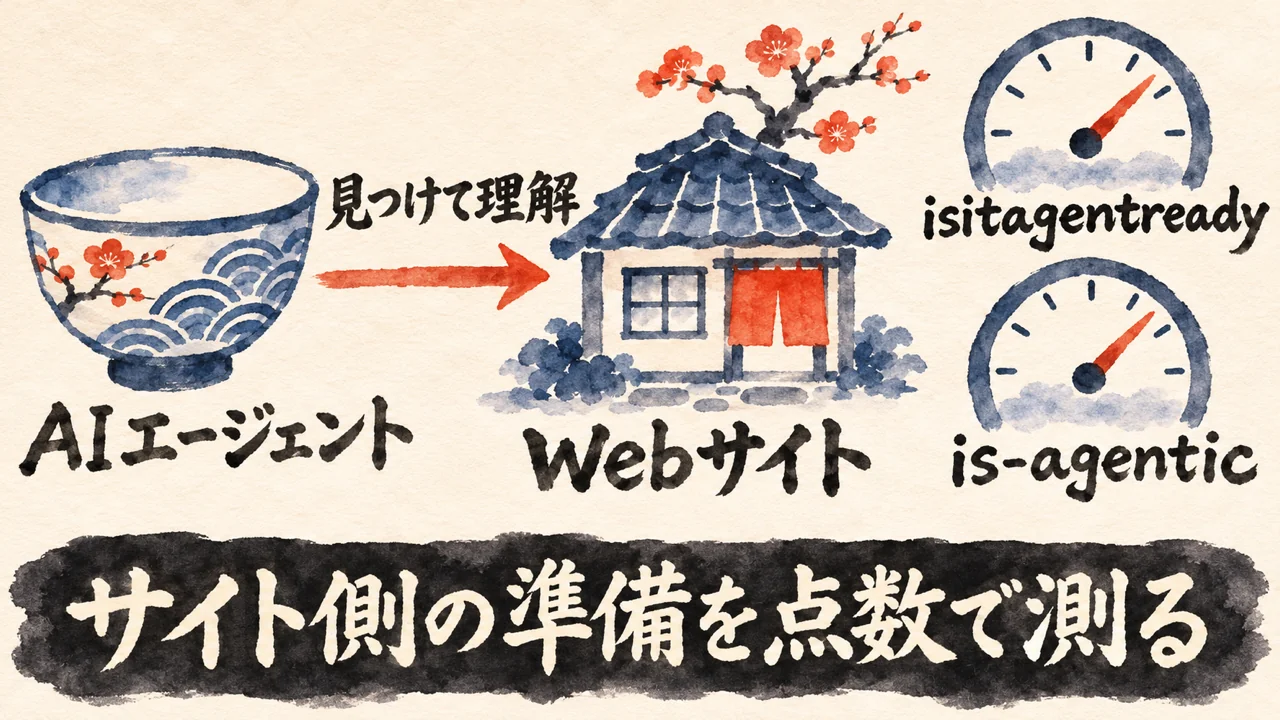
ここでいうAgent Readyは、「エージェントがWebサイトを発見・理解するために、サイト側の準備が完了していること」とします。
言い直すと、AIが自分でサイトを見つけて中身を理解できるように、持ち主の側が前もって整えておくことです。ここがAgent Readyの芯かな。
unvalleyさんが2026年11月12日にブログ「UNV」で公開した記事の話です。書き出しは「AIエージェントがWebサイトを読むことが当たり前になりました」。
AIエージェントは、人の代わりにWebを読んで調べて動くAI、ChatGPTやClaudeの仲間のことです。
測る道具は2つあります。Cloudflareのisitagentreadyと、Vercelのis-agentic。どちらもURLを入れると、そのサイトの準備が整っているかを点数で出してくれます。
測ったのは、Next.jsで作ってCloudflare Workersという場所で動かしている、unvalleyさん自身のサイトです。最初の点数は、このあと順に見ていきます。
AI氣道『LLMO対策としてChatGPTのAI検索が公式サイトを確かめに来る流れを整理する』より
「AIが下へ下へと掘りに来るなら、公式サイトは、通りがかりの人に見せるだけの看板ではありません。掘られる地層。」
公式サイトをAIが掘りに来る地層として見ることは、私は『LLMO対策としてChatGPTのAI検索が公式サイトを確かめに来る流れを整理する』で書いています。
サイトは、人に見せる看板だけの時代ではなくなりました。AIが掘りに来る側にもなったんです。スキャナーは、その準備の穴を点数で教えてくれる道具かな、と受け取りました。
isitagentready.comとは。AI向けの準備が57点、Level 2だった理由
AIボット向けのルールとContent Signalsは、CloudflareのBot Preference Syncのおかげで通っていました。
言い直すと、AIボットへのルールの部分は、Cloudflareの機能のおかげで最初から通っていた、ということです。
robots.txtは、クローラーにどこを読んでよいか伝えるファイルです。sitemapは、サイトにあるページの一覧。
Linkヘッダーは、sitemapやMarkdownの場所を示す、通信の付箋のようなものです。
Content Signalsは、検索やAIへの学習に使ってよいかをrobots.txtで宣言するものです。
Markdownのコンテンツネゴシエーションは、注文にtext/markdownが含まれていたら、HTMLでなくMarkdownを返す仕組みです。
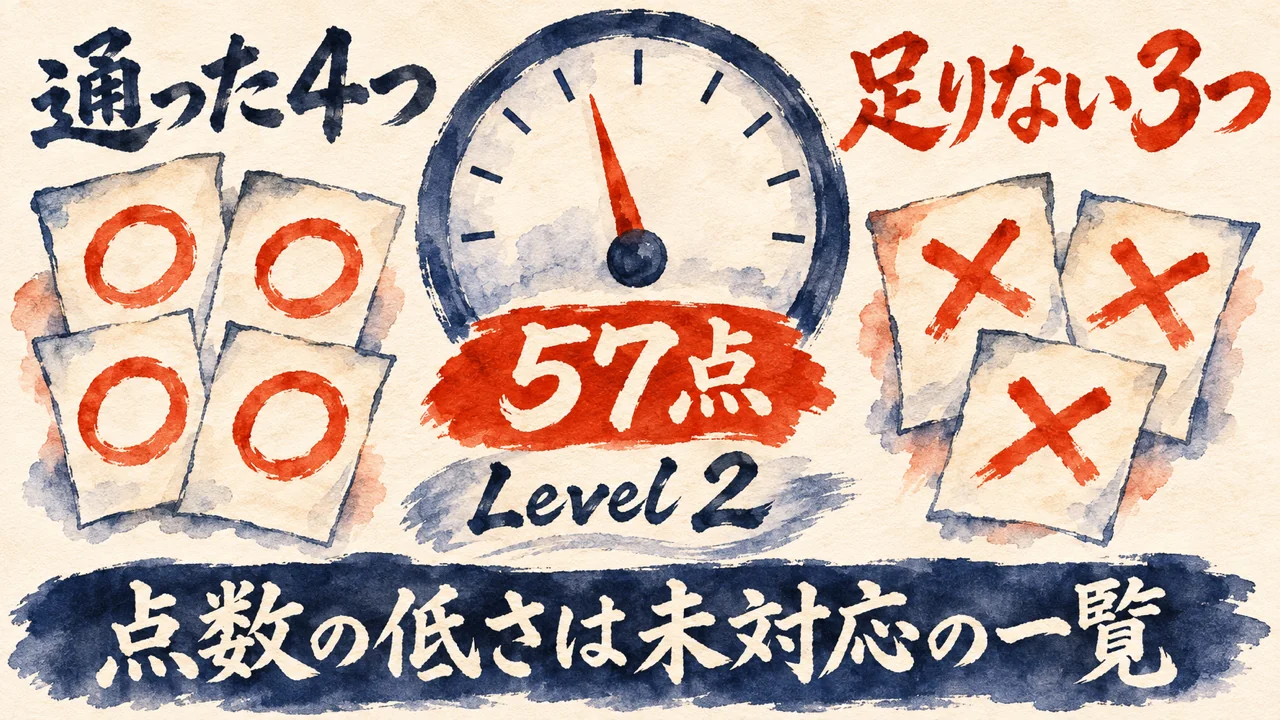
サイトの種類は、個人ブログや公式サイトならContent Siteを選びます。結果は57点、Level 2(Bot-Aware)でした。
OKはrobots.txt、sitemap、AIボット向けのルール、Content Signals。
NGはLinkヘッダー、DNS-AID(エージェントの入り口を示すDNSの記録)、Markdownの返し方です。
通った理由は、引用のとおりBot Preference Sync。AIクローラー向けの方針を、自動でrobots.txtに反映する機能です。
DNS-AIDにはDNSSECとSVCBレコードが必要で、unvalleyさんは、個人ブログの規模では今は対応しなくてよいと考えています。
点数の低さは、未対応の項目の一覧なんです。
is-agentic.comとは。AIが読む基本を重く見て69点になった理由
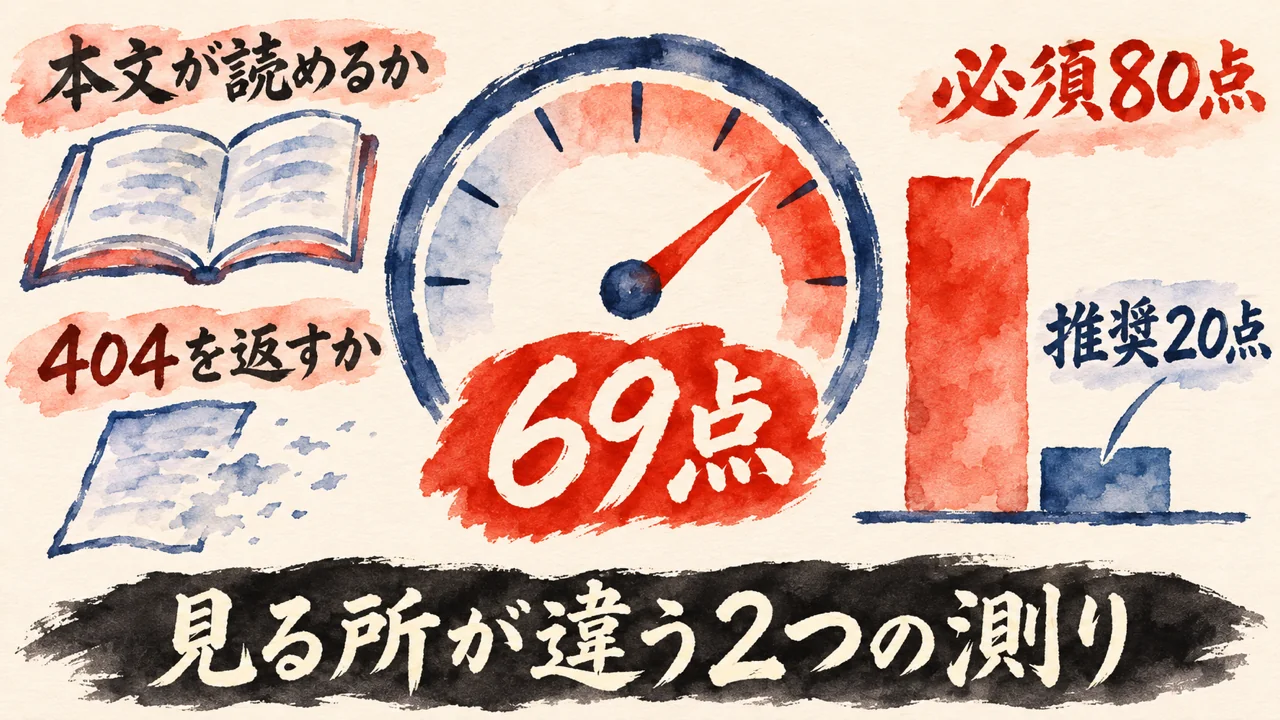
JavaScriptなしで本文が読めるか、存在しないページで404を返すか、といった基本的なところを重く見ていて、100点のうち80点がEssential(必須)、20点がRecommended(推奨)のチェックです。
言い直すと、JavaScriptなしで本文が読めるか、存在しないページで404(ページがないというエラー)を返すか。そんな基本を重く見る道具です。100点のうち、80点が必須の項目です。
運営はVercelです。新しい形式への対応は、ボーナスで加点されます。結果は69点で、判定は「Important blockers remain」。
unvalleyさんは、採点の仕組みは違うけれど、点数だけ見ると若干優しい、と書いています。
OKは、AIエージェントをブロックしていない、JavaScriptなしで本文が読める、検索から隠していない、sitemap、ページのトークン数など。トークン数は、AIが読む文字の量の単位です。
NGは、Markdownのコンテンツネゴシエーション、404の本文をMarkdownで返すこと、JSON-LD、About・Contact・Privacyのページ。
JSON-LDは、ページの内容を機械が読める形で書き添えた情報です。og:imageがないメタデータは部分点で、og:imageはSNSで共有した時に出る画像です。
About・Contact・Privacyは、ビジネスとして信頼できるかを確かめるためのページとされます。個人ブログには必要ないので、unvalleyさんは無視でOKと考えています。
2つのスキャナーは、見る所が違います。自分のサイトの種類で、直す項目と無視する項目が変わるんです。
AIにMarkdownを返しLinkヘッダーを付けると、isitagentreadyは57点から86点に
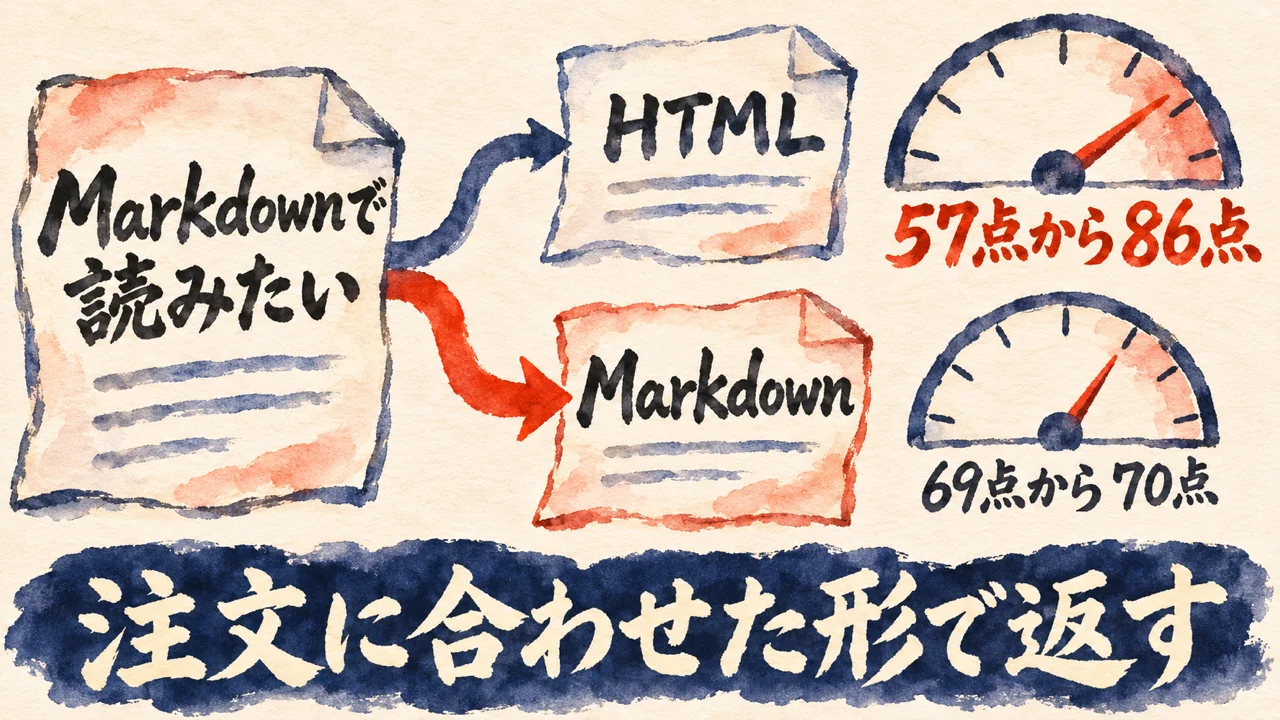
Markdownを返してLinkヘッダーを付けただけでAgent Nativeになりましたが、そんなに変わる?
直したのはMarkdownを返すこととLinkヘッダーの2つだけ。それで最高のレベルまで上がり、unvalleyさん自身が驚いた、ということです。
Accept: text/markdownは、私はMarkdownで読みたいですという、読む側からの注文です。その注文が来た時に、HTMLでなくMarkdownを返すようにしました。URLは今のまま。
Markdownは、見出しや箇条書きを記号で書く、飾りの少ない文章の形です。
あわせて、トップページとブログのページにLinkヘッダーを付け、robots.txtにSitemapの行を足しました。
仕組みは、サイトを組み立てる時にMarkdown版を作っておき、text/markdownの注文だけをそちらへ振り替えるもの。記事はMDXからMarkdownに変換しています。
点数の動きです。isitagentreadyは、57点のLevel 2から、86点のLevel 5(Agent-Native)へ。
is-agentic.comは、69点から70点で、Markdownのチェックは落ちたままでした。
AI氣道『使う人がAIになった。Hono Conference 2026のスライドを解説、AIに届く設計と届かない工夫』より
「AIに頼む私たちも、人に頼む時の気づかいではなく、AIが迷わず少ない手数で動ける形に、頼み方と窓口を作り直す時代です。」
AIが迷わず少ない手数で動ける形に窓口を作り直すことは、私は『使う人がAIになった。Hono Conference 2026のスライドを解説、AIに届く設計と届かない工夫』で書いています。
ただ、恩恵を受けるエージェントは、まだ一部です。
unvalleyさんは、acceptmarkdown.comの対応状況を見ると、Claude Code、OpenCode、Cursorなどがtext/markdownをデフォルトで送るらしい、と書いています。
読む相手に合わせた形で返す、という発想ですね。
Vary・JSON-LD・404のMarkdownで、AI向けのis-agentic.comは70点から89点に
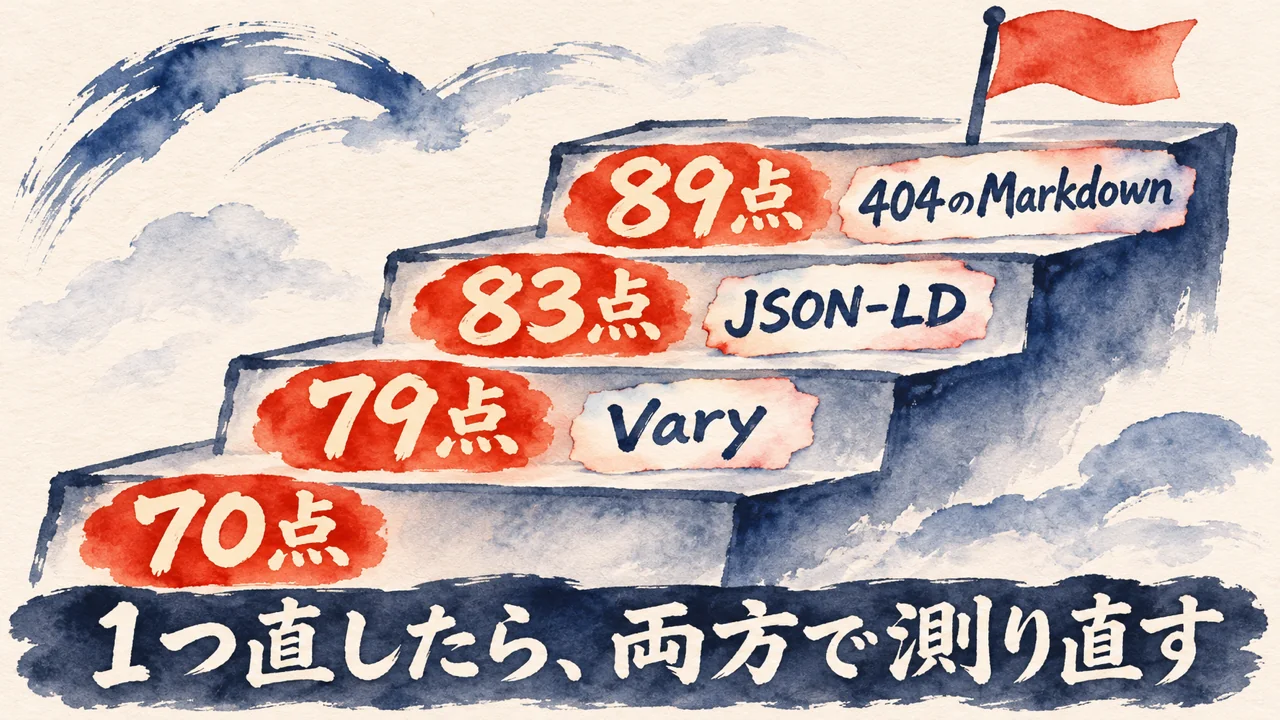
コードでは付けていたのですが、このサイトはOpenNextでCloudflare Workersに載せており、そのキャッシュ処理でVaryが上書きされていました。
言い直すと、コードでは付けていたのに、載せている仕組みが途中で上書きして、実際には付いていなかった、ということです。
1つ目は、Vary: Acceptの付け直し。
同じURLでHTMLとMarkdownを出し分けるので、HTMLを頼んだ人にCDN(サイトの写しを預かって配る仕組み)がMarkdownの写しを返さないようにするものです。
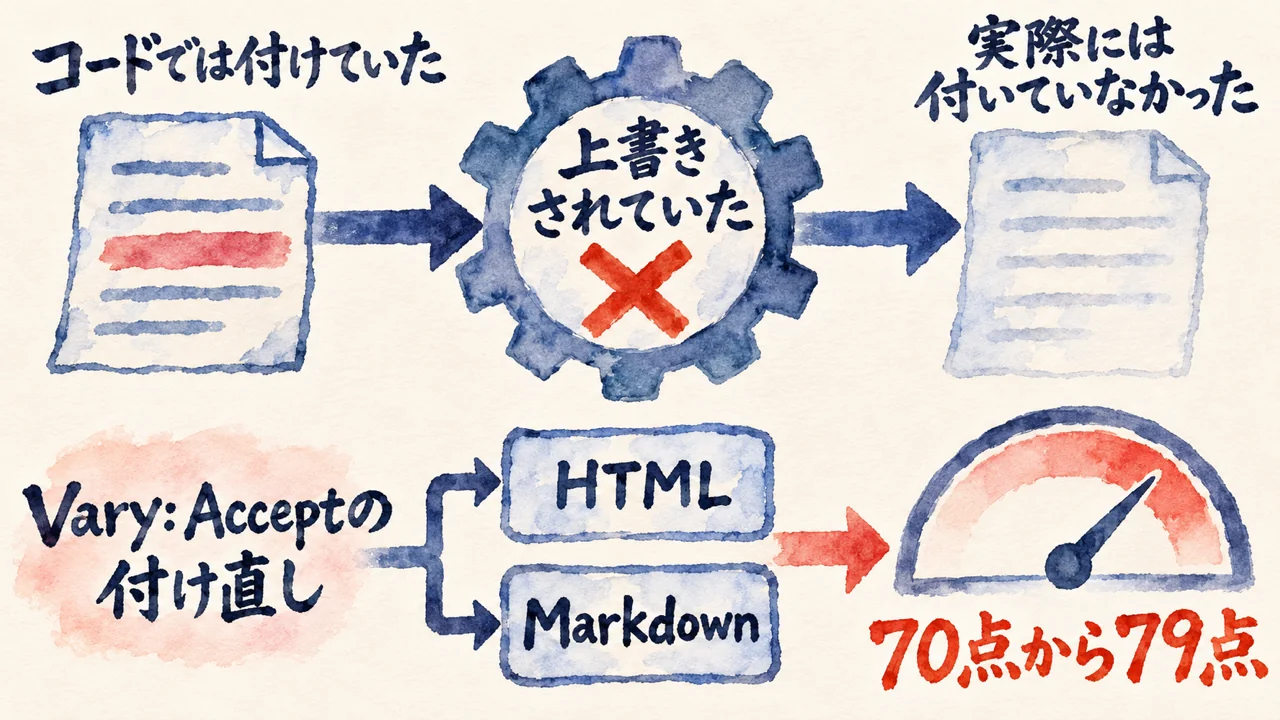
付け直すと、is-agentic.comは70点から79点。isitagentreadyは86点のままです。
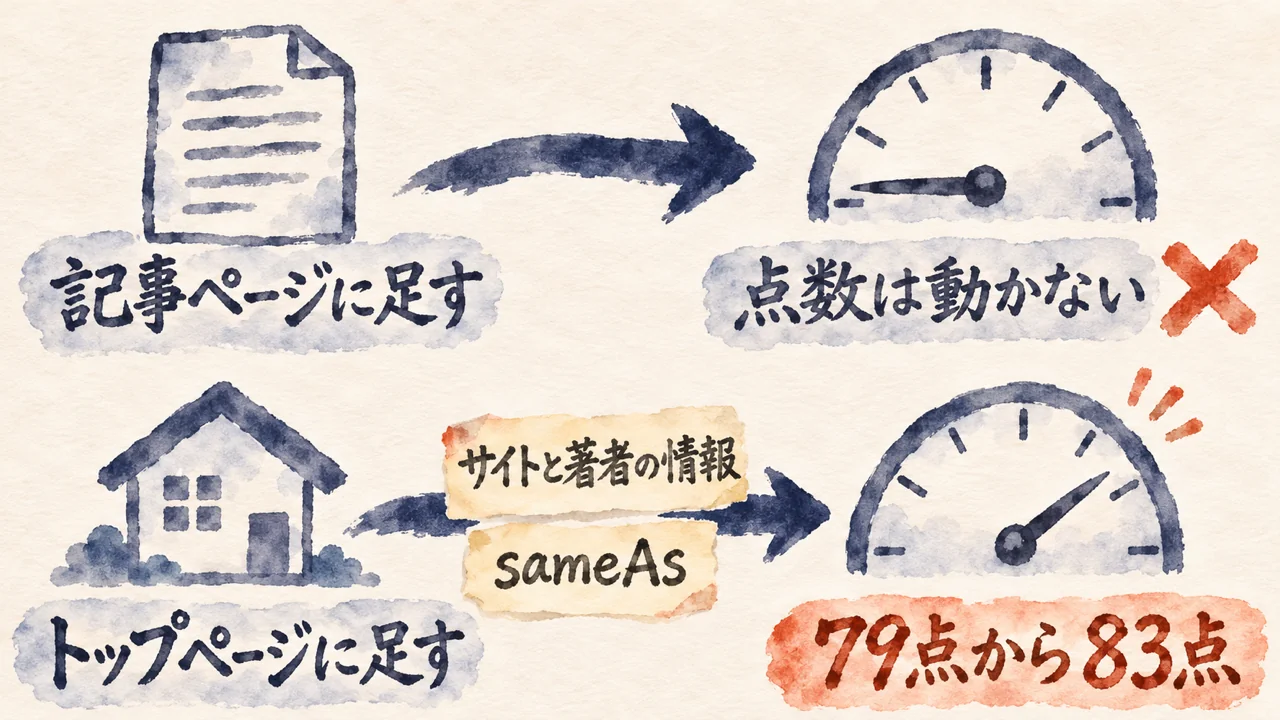
2つ目はJSON-LD。記事ページにBlogPostingの情報を足しても、点数は動きませんでした。
is-agentic.comはJSON-LDをトップページでしか見ておらず、isitagentreadyはJSON-LD自体を見ていなかったからです。
そこでトップページに、サイトと著者の情報を足しました。外部サイトの同一人物を示すsameAsも入れています。79点から83点で、sameAsのボーナスも付きました。
AI氣道『LLMOの本質とは?AI検索で自社を正しく伝えるための情報の整え方』より
「構造化データも同様です。ページにある商品や組織の情報を機械が扱いやすい形で記述するものですが、本文と一致していることが基本です。」
構造化データは本文と一致させることを、私は『LLMOの本質とは?AI検索で自社を正しく伝えるための情報の整え方』で書いています。
3つ目は、404のMarkdown。存在しないページでも、text/markdownの注文にはMarkdownで返し、ステータスは404のまま、ホーム・ブログ・サイトマップへのリンクを載せました。
83点から89点で、判定は「Strong technical baseline」に変わっています。
1つ直したら2つのスキャナーで測り直して、どちらが何を見ているか確かめる進め方なんです。
Agent Readyの残りの指摘とllms.txtへの見方。試す前に決める3つ
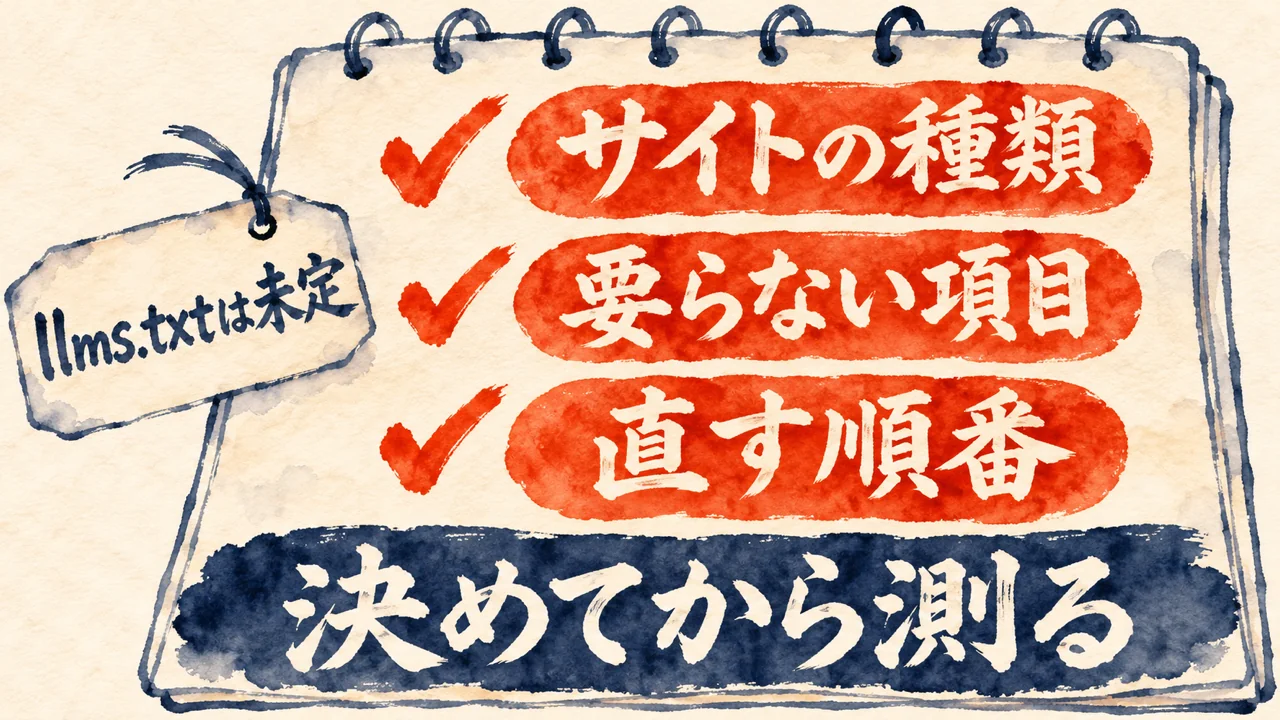
面白かったのは、llms.txtについてどちらも触れていなかった点ですね。
言い直すと、AI向けにサイトの案内を書いたファイルのllms.txtに、どちらのスキャナーも触れていなかった、という点です。
is-agentic.comで残った指摘は3つ。og:imageがない、About・Contact・Privacyのページがない、JavaScriptなしで本文が読めるかが部分点。
本文は4,840文字で、HTML全体の4.8%、目安の5%にわずかに届きません。
unvalleyさんは、og:imageはいいデザインが思い浮かんだら付け、About・Contact・Privacyは無視すると書いています。
llms.txtは、この辺りの進め方がまだ定まっていない、と見ています。検証は両方のスキャナーで、とも書いています。
試す前に決めるのは3つ。1つ目は、自分のサイトの種類を決めて、Content Siteを選んで測ること。
2つ目は、DNS-AIDやAbout・Contact・Privacyなど、要らない項目を先に決めること。3つ目は、直す順番を決め、1つ直すたびに2つのスキャナーで測り直して点数を書き留めること。
unvalleyさんの順番は、Markdown、Vary、JSON-LD、404のMarkdownの順です。
サイトが何で作られているかで直せる所は変わるので、直す作業は、サイトを作った人かAIエージェントに頼む形になるかな、と読んでいます。
読んだあと、自分のサイトで試す前に決めることを整理したい人へ
自分のサイトをAgent Readyにする前に、サイトの種類・直さなくてよい項目・直す順番を決めるプロンプト
枠の中にこの記事のURLが入っていて、AIが記事を読んでから、状況を聞き取り、サイトの種類、直さなくてよい項目、先に直す候補、測る順番にまとめてくれるプロンプトです。読んで終わりにせず、自分のサイトですぐ使える追加のプロンプトまで手元に残せます。
1
元記事の話と、書き手の考えの仕分け
unvalleyさんの記事の内容と、私の考えと、未確認の点を分けて返します。
2
試す前に人が決める所の仕分け
4つの質問に答えると、サイトの種類、直さなくてよい項目、先に直す候補が返ってきます。
3
測る順番と、追加のプロンプト
最初に測る1回と直す順番、記事のURL入りのプロンプトを1〜3本、そのまま貼れる形でつくります。
AIの答えは下書きとして受け取り、任せ切りにせず自分の目で読み直す前提です。使ってみたい時だけ、下のボタンから使い方と依頼文を開いてください。
▶ タップしてプロンプトを開く
下の枠の文を丸ごとコピーして、手元のAIエージェントに貼ってください。枠の中には、この記事のURLが入っています。記事を読んだAIから、短い質問が4つ、1つずつ届きます。
返ってきた結果は、そのまま信じず、自分の目で読み直してください。どの項目を直し、どれを見送るかを決めるのは自分です。
次の依頼を、確認と整理だけで行ってください。

【記事のURL】
https://ai-kidou.jp/bm-agent-ready-unvalley-20261113/
最初に、このURLの記事を読んでください。読めない時は、読めなかったと伝えて、下の記事の要点だけを材料にしてください。

【参照元(先に読む)】
https://unvalley.me/ja/blog/1793627906
unvalleyさんのブログ「UNV」の記事「WebサイトをAgent Readyにしよう」です。2026年11月12日に読んだ時点の内容です。読めた場合は、記事の記述と下の要点が合っているか確かめてください。

【目的】
自分のWebサイトを、AIエージェントが見つけて理解できる状態に近づける前に、人が決めるのは次の点です。自分のサイトの種類。直さなくてよい項目。直す順番。そのうえで、最初に測る1回を決め、私の環境で使える追加のプロンプトをつくります。

記事の要点
・Agent Readyは、unvalleyさんが「エージェントがWebサイトを発見・理解するために、サイト側の準備が完了していること」と定義している。
・測る道具は2つ。Cloudflareのisitagentreadyと、Vercelのis-agentic.com。見る所が違う。
・unvalleyさんのサイトは、isitagentreadyで57点(Level 2)から86点(Level 5)、is-agentic.comで69点から89点に動いた。
・直した内容は、text/markdownの注文にMarkdownで返す、Linkヘッダーを付ける、Vary: Acceptを付け直す、トップページにJSON-LDを足す、404でもMarkdownを返す、の順。
・個人ブログではAbout・Contact・Privacyのページは無視でOK、DNS-AIDは今は対応しなくてよい、とunvalleyさんは考えている。
・llms.txtには、どちらのスキャナーも触れていない。
・書き手(ひろくん)の考え: 試す前に、サイトの種類、要らない項目、直す順番の3つを決める。ひろくんはスキャナーを動かして確かめていない。

【やってよいこと】
1. 記事を読んだあと、次の4つを1つずつ質問してください。答えが返ってから次の質問へ進んでください。
 ・私のサイトは何の種類か(個人ブログ・企業の公式サイト・商品のサイトなど)と、何で作っているか
 ・AIエージェントに読まれたい、いちばん大事なページはどれか
 ・すでに対応済みのものと、手を付けたくないものは何か
 ・サイトを直せる人は誰か(自分・制作した人・AIエージェント)
2. 答えをもとに、「直さなくてよい項目」と「先に直す候補」を、一行ずつの箇条書きにまとめてください。決めるのは私です。
3. 最初に測る1回(2つのスキャナーでURLを測り、点数と判定を書き留めるだけ。設定の変更も送信もしない)と、直す順番を、私の環境に合わせて並べてください。
4. 私の環境で、そのまま貼って使える追加のプロンプトを、1〜3本つくってください。記事のURLを、各プロンプトの中に入れてください。

【守ること】
・設定の変更、削除、送信、購入、公開、インストールは行わないでください。ここでは、聞き取りと整理だけです。
・パスワード、鍵、口座の情報、個人情報、お客様の情報は求めないでください。貼られても使わず、消すよう伝えてください。
・記事の内容は、unvalleyさんが書いた記録として扱い、確かめられた事実とは書かないでください。ひろくんは動かして確かめていません。
・分からない所は、推測で埋めずに未確認と書いてください。
・材料は、上のURLの記事と記事の要点、私の答えだけにしてください。記事に無い数字・効果・手順を足さないでください。追加のプロンプトに足してよいのは、私の環境に合わせた言い方と手順だけです。この依頼で禁じたことは、追加のプロンプトの中にも同じように書いてください。

【返す形】
(1) 私のサイトの種類と、直さなくてよい項目(一行ずつ)
(2) 先に直す候補と、直す順番
(3) 最初に測る1回(測る道具とメモする点数)
(4) 私の環境で使える追加のプロンプト(1〜3本)
(5) 未確認の点(分からなかった所を、推測で埋めずに書く)
最後に、私が自分の目で読み直したほうがよい所を1行で添えてください。よくある質問
Q. Agent Readyとは何ですか?
A. unvalleyさんは、AIエージェントがWebサイトを発見・理解するために、サイト側の準備が完了していることと定義しています。
Q. 2つのスキャナーは何が違いますか?
A. isitagentreadyはCloudflare、is-agentic.comはVercelのスキャナーです。後者は、JavaScriptなしで本文が読めるかや404を重く見ています。
Q. 個人ブログにAbout・Contact・Privacyのページは要りますか?
A. unvalleyさんは、ビジネスとしての信頼を確かめるページなので、個人ブログには必要なく無視でOKと考えています。
Q. Markdownを返すと得をするエージェントはどれですか?
A. unvalleyさんの記事によると、Claude Code、OpenCode、Cursorなどがtext/markdownをデフォルトで送るらしいです。恩恵を受けるのはまだ一部です。
Q. llms.txtは必要ですか?
A. どちらのスキャナーも触れておらず、unvalleyさんはまだ定まっていない領域と見ています。私は、サイトの種類と要らない項目を決めるのが先だと読みます。
まとめ。Agent Readyは、点数で準備の穴を見つけて順に直すこと
unvalleyさんの記事は、2つのスキャナーで測り、4つ直した記録でした。isitagentreadyは57点から86点、is-agentic.comは69点から89点に動いています。AIエージェントが読みに来るサイトの準備を、点数で確かめられるんです。
私がこれまで書いてきた、公式サイトはAIが掘りに来る地層、AIが迷わず少ない手数で動ける形に窓口を作り直す、構造化データは本文と一致させる、という考えと、同じ向きで読める記録でした。
試す前に決めるのは、サイトの種類、要らない項目、直す順番の3つです。私はスキャナーを動かして測ってはいないので、まず元の記事を読んで、あなたのサイトに当てはまる所を探してみてください。
この記事で学んだことを誰かに教えて恩送りして学びを深めよう!
COLUMN
点数は上がっても、AIが私の言葉をどう読んだかは別の話
点数は、AIが読む側の準備の話です。Markdownを返す、Linkヘッダーを付ける。どれも、読みに来た相手が迷わないための整え方。ただ、点数が上がっても、読んだ結果が私の言いたかった形のままかどうかは、点数には出ません。
AI氣道『AIへの訂正は、その場の一言で終わらせない』より
「元の言葉は「家族や周り」。AIの聞き方は「家族」。二つを並べると、抜けたのは「や周り」という短い部分です。」
この向きは、私が『AIへの訂正は、その場の一言で終わらせない』で書いたことと重なります。AIに言葉を縮めて読まれた時の、見比べ方の話です。AIは、書かれた形のまま読みます。そして、読んだ範囲に縮めることがある。縮めた後の文だけを見ていると、何が落ちたのか自分では気づきにくいんです。
サイトの紹介文にも、同じ向きが当てはまると私は考えています。AIが紹介文を短くまとめる時、私が一番伝えたかった語が落ちることもありえます。ページはきれいに読めて、点数も変わらないまま。
料理で言えば、下ごしらえです。食材を、調理する人が扱いやすい形に切っておく。ここまでは整えられます。でも、味つけは別。何を伝えたいかは、切った後も私が決めるものです。
今日からできる形にします。自分のトップページの紹介文を、ClaudeかChatGPTに一度要約させます。出てきた要約を元の文と並べて、残った語と落ちた語に印を付ける。落ちた語が大事なら、元の文の側を書き直します。
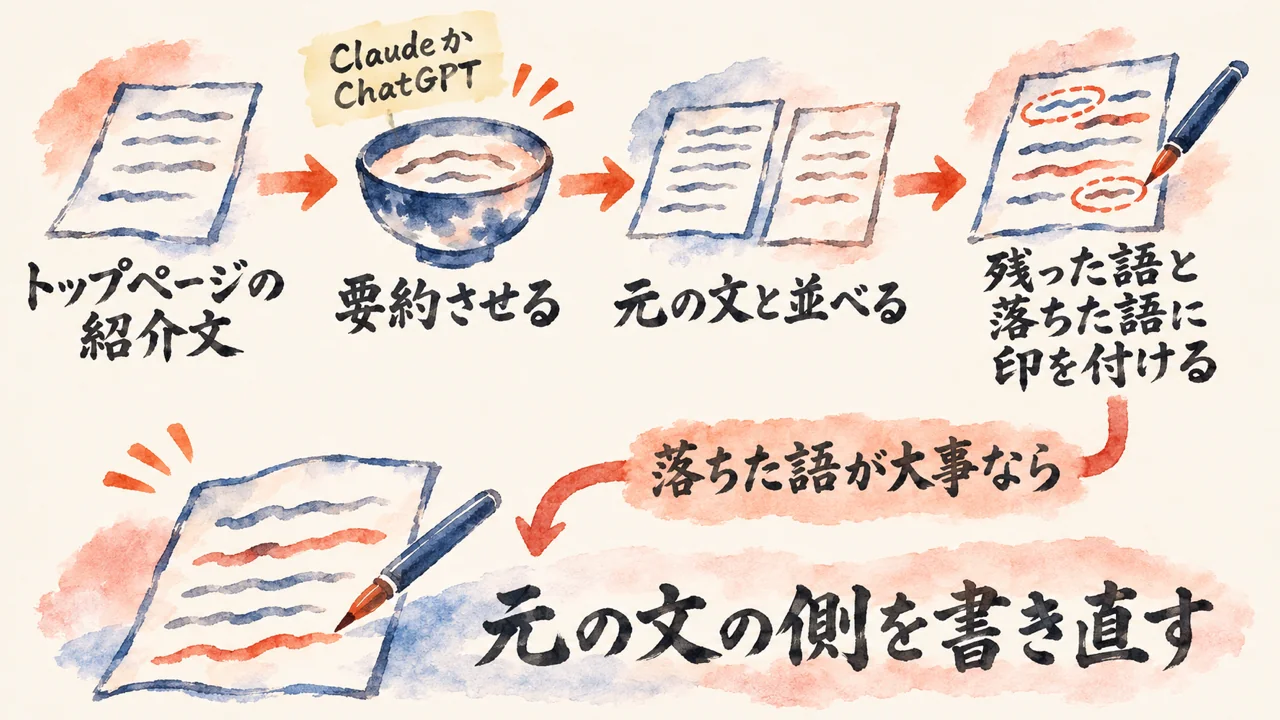
点数を上げるのは準備で、読まれた結果を見るのは確認。この二つは別の作業です。準備だけで終えず、確認まで一周すると、自分の言葉が残っているかが見えてきます。点数の次は、AIが読んだ形を見る。
分身AIのことをもっと知るなら、分身AI.comもチェックしてね!
関連記事
LLMO不要論を3本の動画で比べ、GA4は1%未満で問い合わせは3割弱という話を整理した記事です。
AI Overviewsで引用ではなく推奨を取る対策を、SEOおたくさんが話す記事です。
Claude SEOスキルで整えたサイトを3か月置いたら、Search Consoleの数字がどう動いたかを書いた記事です。
参考リンク
この記事が整理した元の記事。unvalleyさんのブログ「UNV」
第1章で引用した、AIが掘りに来るなら公式サイトは掘られる地層だと書いた私の記事
第4章で引用した、AIが迷わず少ない手数で動ける形に窓口を作り直す時代だと書いた私の記事
第5章で引用した、構造化データは本文と一致していることが基本だと書いた私の記事
コラムで引用した、AIに言葉を縮めて読まれた時の見比べ方を書いた私の記事
今回紹介した記事
| 著者 | unvalleyさん |
| 媒体 | ブログ「UNV」 |
| 公開日 | 2026年11月12日 |
| 元URL | https://unvalley.me/ja/blog/1793627906 |
無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取るAI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
火曜15:00〜 社長モテる化計画LIVEもやってるよ!