FIELD TEST
日本語の文字起こしAI「Haas-ja」をMacで自分の音声で測り、1か所だけ入れ替えた話
2026.11.13
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくんです。
最新AI情報満載!毎日無料朝LIVE実施中!GPTs研究会では、AIツールの最新活用法を毎朝シェアしています。AI初心者の方も、ぜひAI氣道.jp無料メルマガで朝LIVEブログを毎日チェックしてくださいね。
11月6日に、G2さんのnote「Whisperより約3〜8倍速かった:日本語文字起こしAI「Haas-ja」をMacで実測」を見つけました。私はそのURLをAIに渡して、「これログインして読んでテストして良いなら導入したい。」と頼みました。AIには有料の部分も含めて全文を読ませています。noteの結論をざっくり言うと、「Whisperより速い。公開データのテストでは文字の誤りも少なかった。ただし本物のセミナー音声では、Whisperが勝つ場面もあった」という内容です。
実は、私は文字起こしのAIを、場所ごとに使い分けています。普段の文字起こし、LIVE記事で誰が話したかを分ける時、それから講座動画の声の点検です。新しいAIが話題になると、全部まとめて入れ替えたくなります。でも、記事の数字はその人の素材で測った数字です。私の素材でも同じになるかは、測ってみないと分かりません。
そこでAIに頼んで、11月6日から7日にかけて測ってもらいました。使ったのは私のMac(Apple M5 Max)と、私の本物の音声です。比べたのは速さ、台本と比べた文字の誤り、無音の所で言っていない文が出るか、固有名詞や英字の書き方です。
結論を先に書きますね。入れ替えたのは「講座動画の声の点検」の1か所だけです。普段の文字起こしと、LIVE記事の話者分けは今までのままにしました。待ち時間はめちゃ縮みました。ただ、私のクローン声の素材では、文字の誤りはWhisperの方が少なかったんです。
この記事では、測った数字を全部出します。良かった所も、noteの結論が私の素材では再現しなかった所も載せます。あなたが「話題の新しいAIに入れ替えるべき?」と迷っているなら、同じ確かめ方を手元で真似できるように書きました。
3行でわかるポイント
- 講座動画の声の点検(10発言・音声96秒)にかかった時間は、faster-whisperの407.8秒に対してHaas-jaは12.2秒。入れ替えたのはこの1か所だけ
- 私のクローン声の文字の誤りは、63発言の講座でWhisper 4.45%、Haas-ja 5.48%。noteの公開データで出ていた「Haas-jaの方が誤りが少ない」は、私の素材では再現しなかった
- 無音・雑音だけの試験8本で言っていない文が出た本数は、Whisperが8本、Haas-jaが3本。英字が小文字になる・名前を取り違える弱点も出た
Haas-jaとは。公式はLinux向けで、Macは非公式の移植で動かした
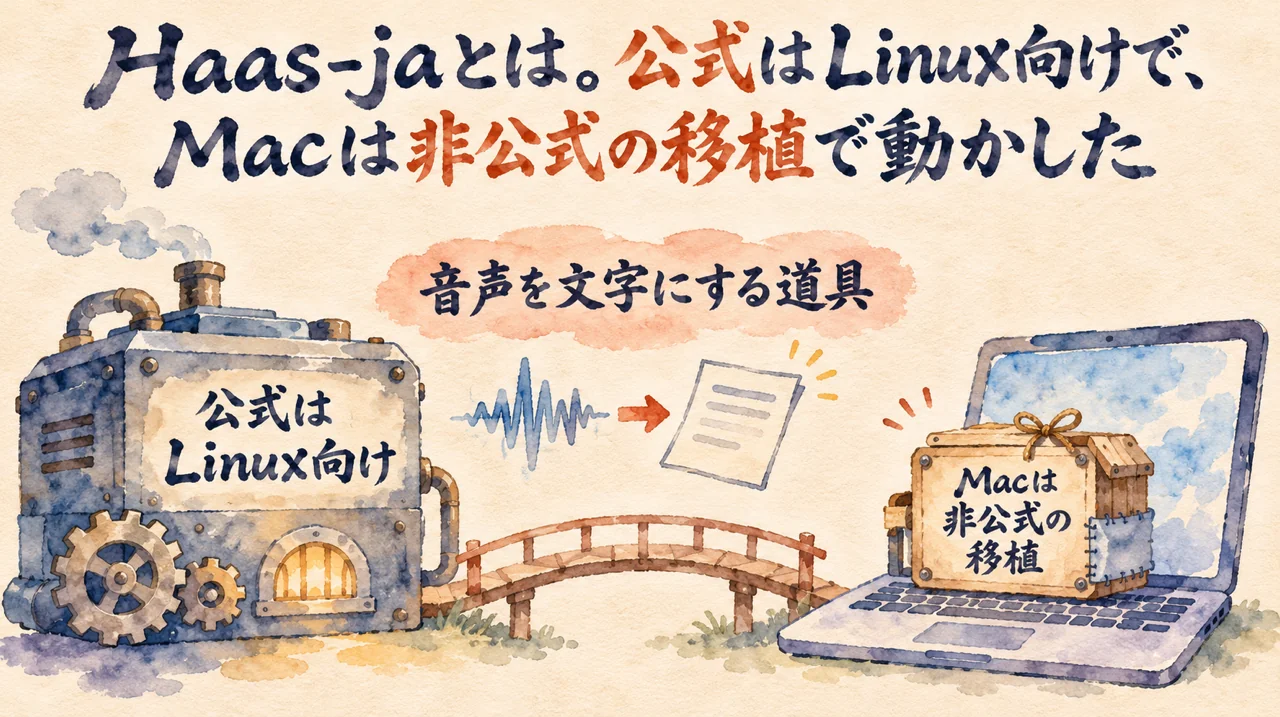
Haas-jaは、日本語の音声認識(音声を文字にする=文字起こし)のモデルです。Third Intelligenceという会社が、2026年10月30日に公開を発表しました。発表は公式ブログに、モデルの説明はモデルカードにあります。ライセンスはApache 2.0(オープンソースのライセンスの1つ)です。
公式の説明では、速さと正確さの両方を狙ったモデルです。公開されている日本語のデータ5つで作った評価で、比べたオープンなモデルの中で最も正確だったとされています。数字はCER strictで6.12%です。CERは「文字の誤りの割合」のことで、低いほど正確です。
公式版には、うれしい機能が2つあります。1つは「語彙の登録」で、固有名詞の読みと書き方をモデルに教えられます。もう1つは、別のモデルNemotron-3-Diarizationと組み合わせて、話者ラベル(誰が話したかの印)を付ける例です。
ただし、公式版が動く条件はLinuxとNVIDIAのGPUです。Mac(macOS)は公式には対応していません。ここ、見落としやすい所なんですよね。
そこで私のMacでは、個人の方が作った非公式の移植「haas-mlx」を使いました。READMEにははっきり「非公式」「保守は約束しない」と書いてあります。この移植では、語彙の登録はまだ作られていません。話者分離(誰が話したかを分けること)も入っていません。
つまり、Macで使えるのは「公式と同じ中身のモデルを、公式とは別の人が動くようにした物」です。公式の機能が全部そろっているわけではありません。保守の約束が無い物なので、私はこの移植の特定の版(commit cde96d2)に固定して置いています。どの版で測ったかを、後からでもはっきりさせておくためです。
試したきっかけと、比べた道具
きっかけは冒頭に書いたG2さんのnoteです。「テストして良いなら導入したい」と頼んだ以上、その「テスト」をどこでやるかが大事になります。私の場合、文字起こしを使っている場所は3つあります。
1つ目は普段の文字起こしです。ここはWhisper(mlx-whisperという、Mac上で動く版)を使っています。
2つ目はLIVE記事です。LIVEを記事にする時は、誰が話したかを分ける必要があります。ここはAssemblyAI(有料の文字起こしサービス)に任せています。
3つ目が、講座動画の声の点検です。講座動画を作る時、AIで作った私のクローン声が台本を読みます。その声が台本どおりに読めたかを、別の聞き取りAIに文字起こしさせ、台本と照合しています。ここはfaster-whisperを使っていて、遅かったんです。
比べたのは、この3つと同じ場面です。AIに頼んで、同じ音声を今の道具とHaas-jaの両方に通してもらいました。測ったのは次のような物です。
- かかった時間(声の点検、33分のLIVE、5分の音声)
- クローン声の文字起こしを台本と比べた、文字の誤りの割合
- わざと読み間違えさせた音声を、見つけられるか
- 無音や雑音だけの音声で、言っていない文が出るか
- LIVEの文字起こしが、AssemblyAIの結果とどれだけ違うか
- 使ったメモリの最大量
あ、1つ先に書いておきます。速さの数字には、大きなぶれがあります。測った時のMacは、ほかの作業で混んでいました。同じ音声でも、1回目と2回目で倍近く違う所があります。
速さの結果。声の点検は大きく縮み、5分の音声ではほぼ差が無かった
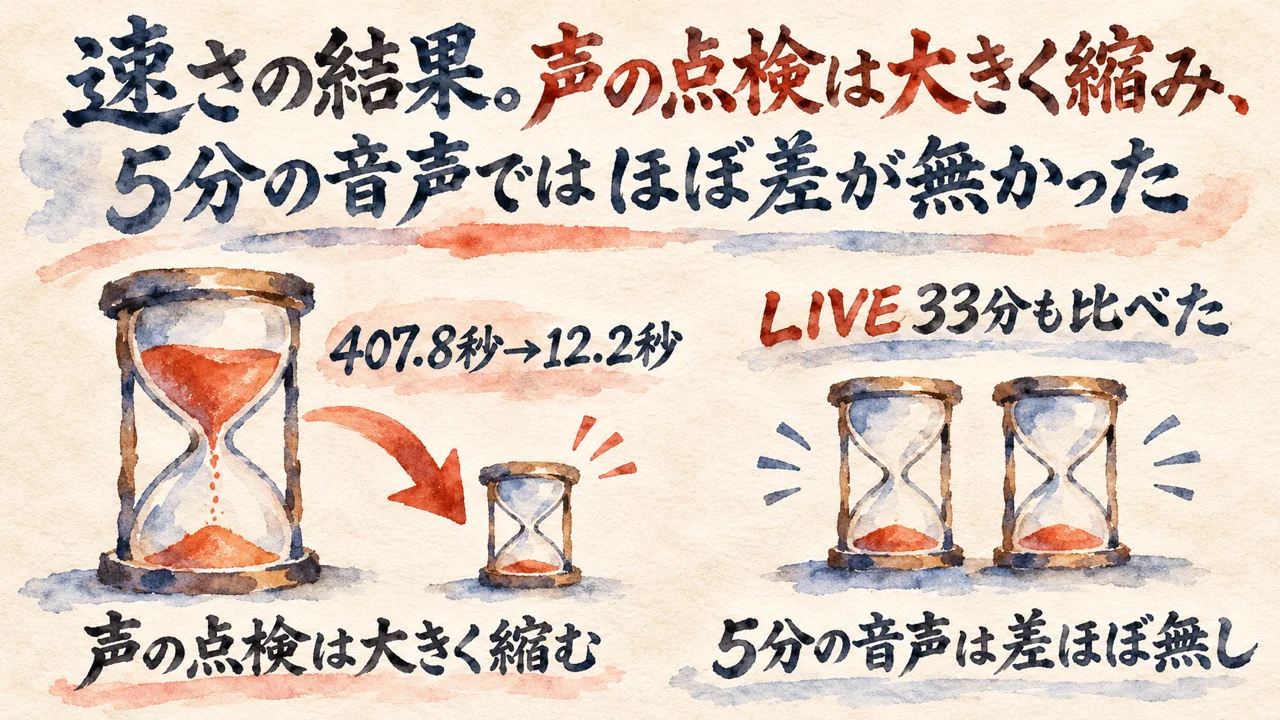
まず時間の結果です。単位はすべて秒です。LIVEは同じ設定で2回ずつ、交互に測りました。5分の音声は3回測った中央値です。
| 測ったもの | faster-whisper | Whisper | Haas-ja |
|---|---|---|---|
| 声の点検(同じ10発言・音声96秒) | 407.8秒 | 17.9秒 | 12.2秒 |
| LIVE 33分・まっちんぐ回(2回) | 測っていない | 159.0秒・105.9秒 | 76.1秒・40.8秒 |
| LIVE 33分・社長モテる化回(2回) | 測っていない | 149.9秒・134.5秒 | 55.8秒・15.8秒 |
| 5分の音声2本(各3回の中央値) | 測っていない | 29.0秒・24.7秒 | 30.6秒・26.5秒 |
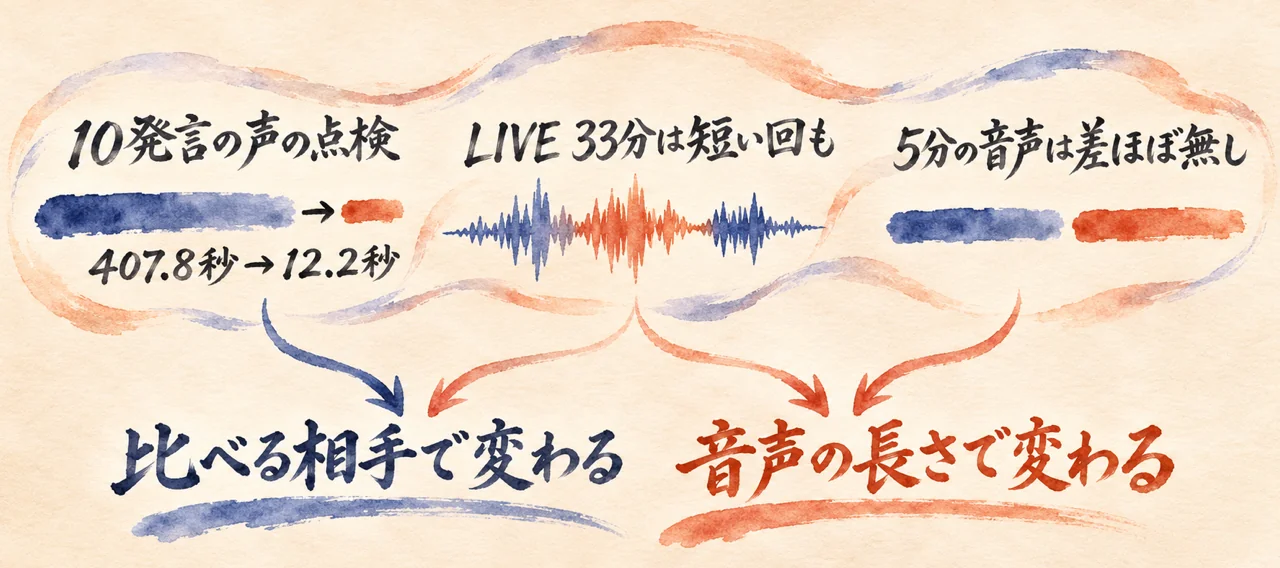
一番大きく変わったのは、声の点検です。今まで使っていたfaster-whisperは、10発言で407.8秒かかっていました。1本の講座は63発言あります。これに直すと、faster-whisperでは約43分かかる計算でした。Haas-jaは同じ10発言で12.2秒です。
LIVE 33分でも、2回ともHaas-jaの方が短く終わっています。といっても、ここは数字の読み方に気をつけたい所です。社長モテる化回のHaas-jaは、55.8秒と15.8秒。同じ音声なのに、3倍以上の開きがあります。Macが混んでいたので、1つ1つの数字を「この道具の速さ」と言い切ることはできません。
さらに、5分の音声ではほぼ差が無かったんです。Haas-jaが30.6秒と26.5秒、Whisperが29.0秒と24.7秒でした。わずかですが、Whisperの方が短いくらいです。
この結果から私が受け取ったのは、「速い」は条件つきだということです。今まで使っていたfaster-whisperと比べると、差ははっきりしていました。普段のWhisperと比べると、長いLIVEでは短く終わった回があり、5分の音声では差がほぼ見えませんでした。「何倍速い」という数字は、どの道具と、どの長さの音声で比べたかで変わります。
メモリも見ておきます。使ったメモリの最大は、Haas-jaが1.3〜2.0GB、Whisperが1.8〜2.5GBでした。Haas-jaを置くのにディスクを約1.5GB使います。
正確さの結果。私のクローン声では、Whisperの方が誤りが少なかった
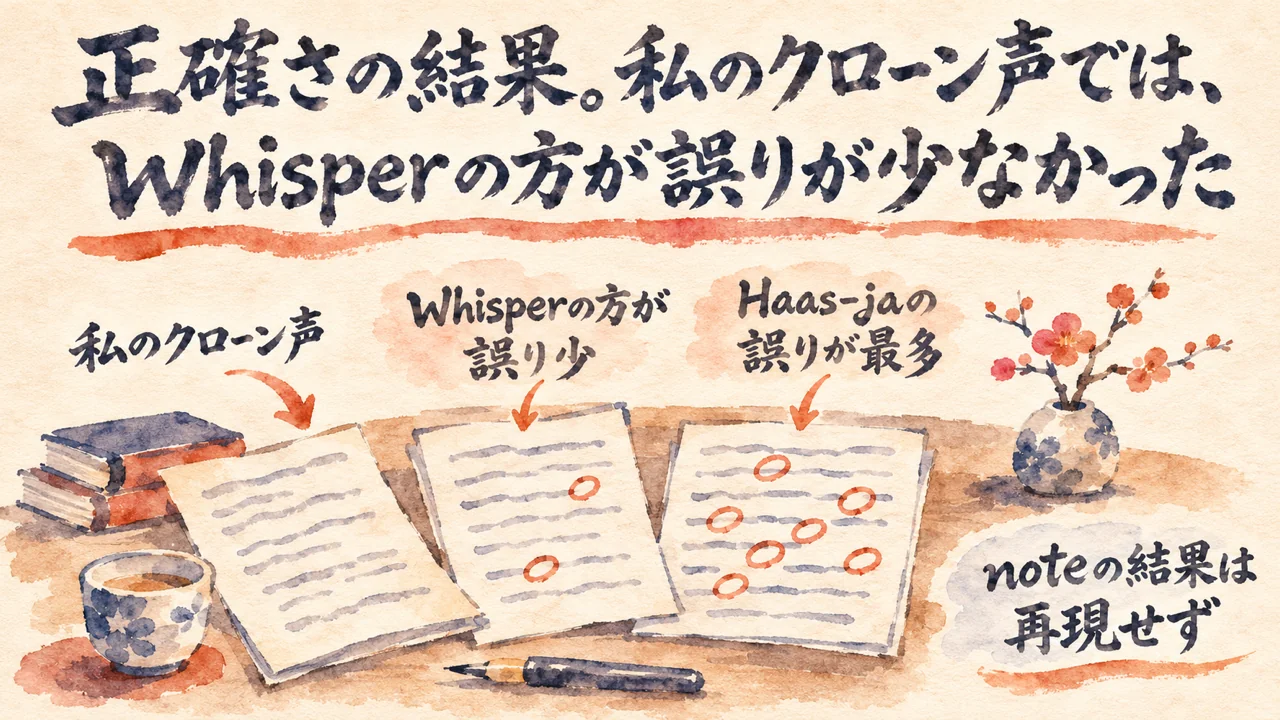
次は正確さです。講座動画のクローン声を文字起こしして、台本と比べた文字の誤りの割合を出しました。低いほど良い数字です。
| 講座 | 発言数 | Haas-ja | Whisper | faster-whisper |
|---|---|---|---|---|
| 『AI×アーキテクト』 | 63 | 5.48% | 4.45% | 測っていない |
| 『心のつかみ方』 | 51 | 4.68% | 4.43% | 4.13% |
どちらの講座でも、Haas-jaの誤りが一番多い結果でした。『心のつかみ方』では、一番少なかったのは遅いfaster-whisperです。noteでは、公開データの4つのテストすべてで、Haas-jaの方が文字の誤りが少なかったとありました。私の声の素材では、それは再現しなかったことになります。note自身も、本物のセミナー音声ではWhisperが勝つ場面があったと書いています。
ここは数字をそのまま受け止めたい所です。noteの結論が間違っていたという話ではありません。G2さんの素材と、私のクローン声の素材が違う。違う素材で測れば、違う結果が出る。それだけのことです。だからこそ、自分の素材で測る意味があるんだと思います。
もう1つ、見つける力も試しました。わざと読み間違えさせた機械音声を20組作り、間違いを見つけられるかを見たんです。この音声は、Macのsayコマンドで作った人工の声です。私のクローン声ではありません。
- 読み間違いを見つけた数: Haas-ja 3件、Whisper 1件、faster-whisper 3件
- 正しい音声なのに「怪しい」と出た数: Haas-ja 0件、Whisper 2件、faster-whisper 2件
正直に書くと、どの道具も見つける力は低い結果でした。20組のうち、多くても3件です。Haas-jaは、正しい音声を「怪しい」と言った数が0件でした。
LIVEの文字起こしも比べています。AssemblyAIの結果を基準にして、どれだけ文字が違うかを出しました。ただし、AssemblyAIも正解ではありません。あくまで「今使っている物との差」です。
- まっちんぐ回: Haas-ja 12.3%、Whisper 16.6%
- 社長モテる化回: Haas-ja 15.3%、Whisper 22.5%
LIVEでは、Haas-jaの方がAssemblyAIの結果に近い文字になりました。クローン声では誤りが多く、LIVEではAssemblyAIに近い。同じ道具でも、素材によって並び順が入れ替わるわけです。
言っていない文と、英字や名前の書き方。強みと弱点が両方出た所
文字起こしのAIには、困った癖があります。何も言っていない所に、それらしい文を書いてしまう癖です。これも測りました。
無音や雑音だけの試験音声を8本用意して、言っていない文が出た本数を数えました。Whisperは8本全部で、何かしらの文を出しました。Haas-jaは3本で、出たのは「すいません。」「うん。」でした。
LIVE 2本でも、はっきりした違いが出ています。LIVEで言っていない「ご視聴ありがとうございました」という文が、Whisperでは3件と2件出ました。Haas-jaは0件です。記事にする文字起こしで、言っていない締めの言葉が混ざらない。ここはHaas-jaの強みとして数字に出た所です。
一方で、弱点もはっきり出ました。
1つ目は英字です。「Facebook」が「facebook」、「AI共創」が「ai競争」のように、英字が小文字になりました。「競争」という漢字の取り違えはWhisperでも出たので、Haas-jaだけの癖は小文字の方です。
2つ目は名前です。クローン声の名乗りは「三方よしAI共創コンサルタントの田中啓之、ひろくんです」。これをHaas-jaは「田中博幸、ひろ君」と書きました。私の名前の漢字が違い、「ひろくん」も「ひろ君」になっています。公平のために書くと、Whisperも「田中博之」と書いていて、漢字はどちらも外れました。Whisperは「ひろくん」の方は正しく書けていました。
3つ目は話し言葉の「あの」です。Haas-jaは「あの」を残しやすく、数えるとHaas-jaが30回、Whisperが10回でした。読みやすい文にしたい時は、後で整える手間が増えます。
4つ目は、誰が話したかの区別が無いことです。私が使っている移植には、話者分離が入っていません。LIVEのように何人も話す音声では、誰の発言かが分からないままです。
あ、名前の取り違えについては、公式版なら語彙の登録で教えられる作りになっています。ただ、私のMacで使っている移植には、その機能がありません。公式版の語彙の登録で私の名前が正しく出るかは、まだ確かめていません。
どこに入れたか。声の点検だけ替えて、ほかは替えなかった理由
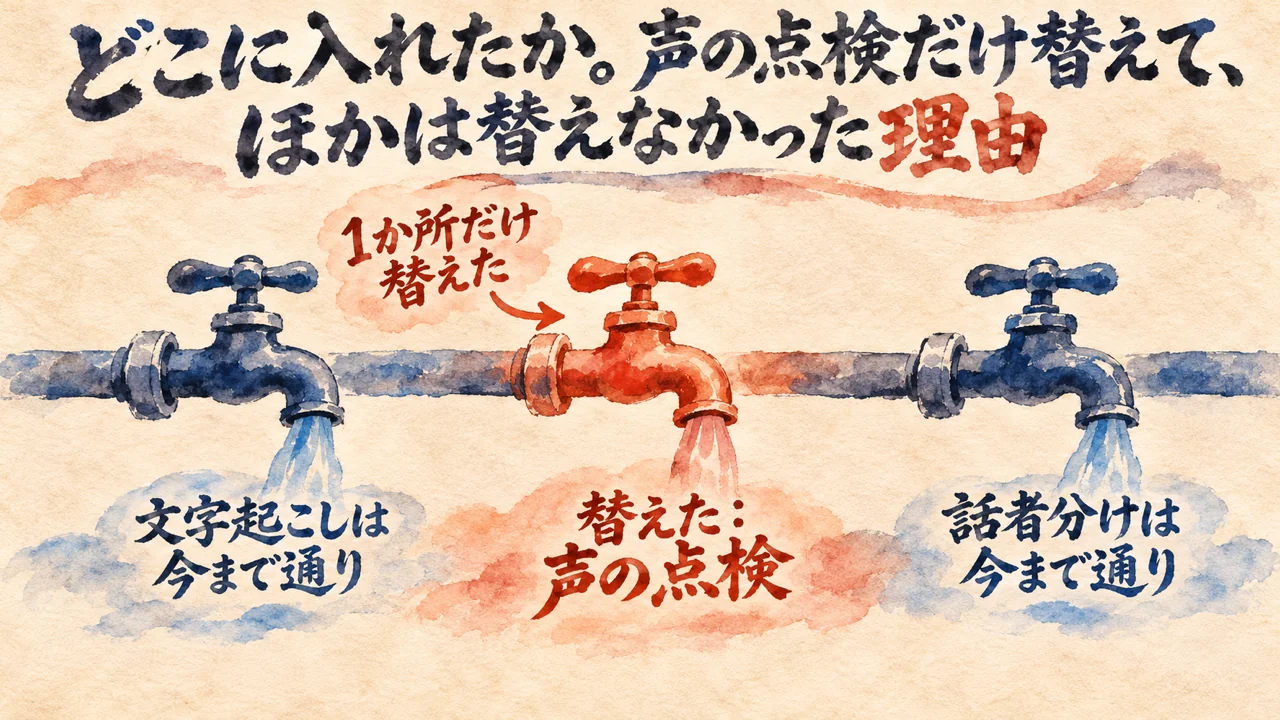
11月7日に決めました。Haas-jaを入れたのは「講座動画の声の点検」の1か所だけです。
理由は、点検の仕事が何かにあります。声の点検の仕事は、文字を完璧に起こすことではありません。台本と大きく違う発言を見つけることです。わざと間違えさせた音声の試験では、どの道具も見つける力は低く、同じくらいでした。それなら、待ち時間だけが大きく減る方を選べます。faster-whisperで約43分かかる計算だった所なので、ここは替えました。
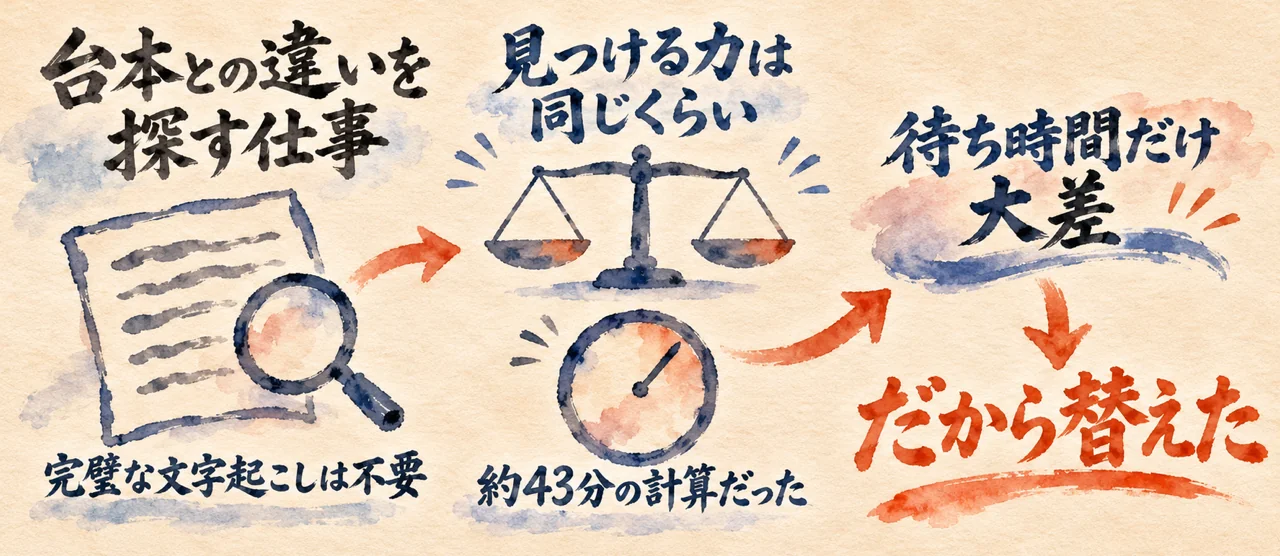
普段の文字起こし(Whisper)と、LIVE記事の話者分け(AssemblyAI)は替えていません。理由は5つです。
- 英字が小文字になる
- 名前の書き方が崩れる(「ひろ君」)
- 話者分離が無い
- 語彙を教えられない
- 非公式の移植で、保守の約束が無い
言っていない文が少ないという強みは、普段の文字起こしでこそ効く所です。それでも、全体の入口を預けるには早いと判断しました。普段の文字起こしは、記事になる文字の出発点です。名前や英字が崩れたまま流れていくと、後で直す所が増えてしまいます。
入れ替えた後、過去の本物の講座2本で試してもらいました。『AI×アーキテクト』の63発言が22秒、『心のつかみ方』の51発言が13秒で終わりました。誤った警告は0件です。
壊れた時の備えも作りました。Haas-jaが動かない時は、警告を出して、今までのfaster-whisperに自動で戻ります。AIに頼んで、わざと壊した状態で動かし、点検が最後まで終わることを確かめてもらいました。元のファイルは控えを取ってあるので、いつでも元に戻せます。
入れる前には、変更を作ったAIとは別の会社のAI(Codex)に、変更内容を読ませて点検させました。1回目の指摘は4件です。
- Haas-jaも元の道具も両方失敗すると、点検全体が止まってしまう
- 結果の形が壊れていると、そこで止まってしまう
- 結果の一部が欠けている時に、「音声が無い」と間違った報告をする
- 同時に動かす数の制限が効いていない
この4件を直して、2回目は指摘0件でした。作った側とは別の目で見てもらうと、作った側が気づかない「止まり方」が出てきます。
まだ確かめていないことも書いておきます。1つは、新しく作る講座の流れの中での実行です。次の講座で初めて動きます。もう1つは、点検が30分を超えて打ち切られる時の動きです。
真似する時の手順。自分の音声で、何をどの順で測るか
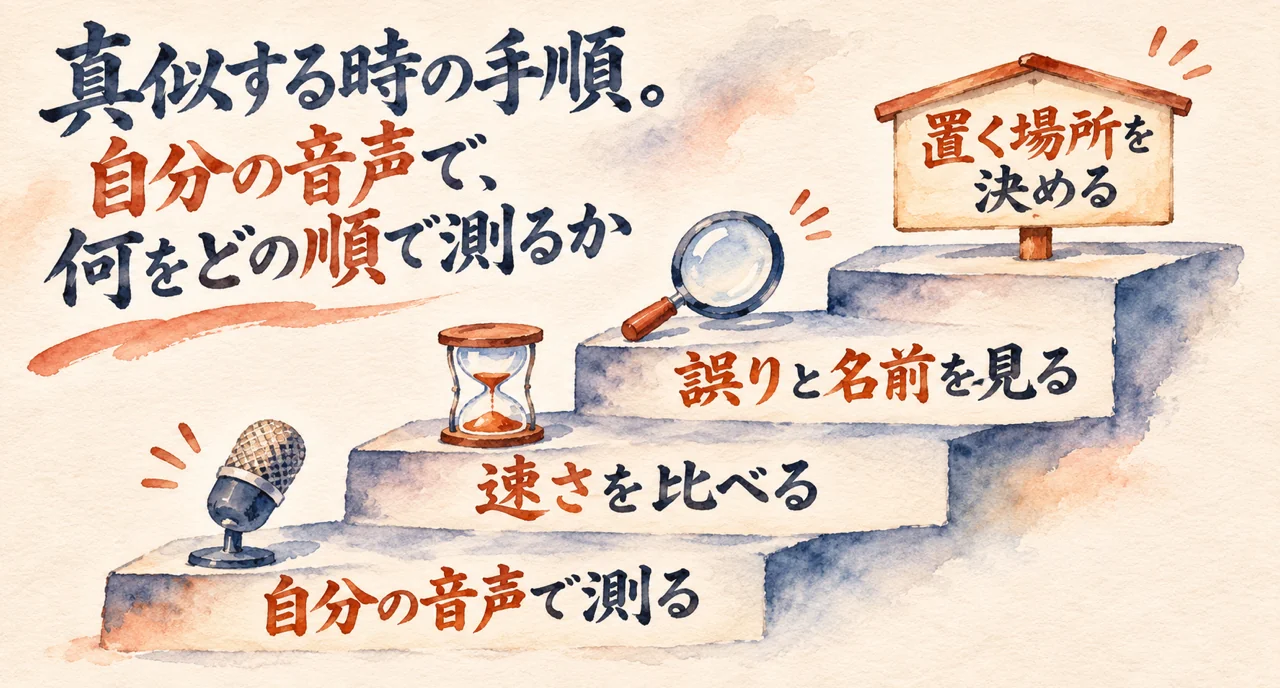
ここまでの流れを、あなたの手元で真似できる手順にしました。道具の名前が違っても、順番は同じで使えます。
- 今の使い方を書き出して、候補を1か所に決める。 文字起こしを使っている場所と、それぞれの道具を並べます。その中で「遅い」「困っている」所を1つだけ選びます。私の場合は、faster-whisperが遅かった声の点検でした。
- 手元の本物の音声を用意する。 台本や正解の文がある音声が一番使いやすいです。無音や雑音だけの短い音声も、何本か用意してください。言っていない文が出るかを見るためです。
- 同じ音声で、今の道具と新しい道具の時間を測る。 同じ設定で2回以上、交互に測ります。測った時のパソコンの混み具合も書き留めておきます。短い音声と長い音声の両方で測ると、「速い」が条件つきかどうかが見えます。
- 台本や正解と比べて、誤りを数える。 文字の誤りの割合に加えて、固有名詞、英字、言っていない文を目で確かめます。自分の名前や商品名が入った音声を混ぜておくと、弱点がすぐ見えます。
- その場所の仕事に必要な物差しで決める。 点検なら「違いを見つける力」と待ち時間、普段の文字起こしなら名前や英字の正しさ、というように、物差しは場所ごとに違います。入れるなら1か所だけにして、控えを取り、壊れた時は元の道具に戻る形にしておきます。
- 最初の一歩は、音声1本で時間を並べるだけでいい。 いきなり全部を測らなくて大丈夫です。手元の音声1本を、今の道具と新しい道具に通して、かかった時間を2つ並べてみてくださいね。
AIエージェントに渡す、文字起こしAIの入れ替え確認プロンプト
枠の中に、この記事のURLが入っています。返ってくるのはAIの答えなので、任せ切りにせず、最後は自分の目で読み直してください。下のボタンを開くと、使い方と依頼文が出てきます。
▶ タップしてプロンプトを開く
下の枠の中を丸ごとコピーして、普段使っているAIエージェント(Claude Code、Codex、ChatGPTなど)に貼ってみてくださいね。今使っている文字起こしの道具と用途を短く聞かれるので、答えていきます。すると「同じ音声で、今の道具と新しい道具をどう比べるか」の計画と、あなたの環境にそのまま貼れる追加のプロンプトが返ってきます。
枠の先頭には、この記事のURLが入っています。エージェントが最初にこの記事を読んでから動く作りです。返ってきた計画やプロンプトは、そのまま実行する前に自分の目で読み直してください。特に、設定を替える所と、音声をどこへ送るかの所は必ず見てくださいね。
【記事のURL】https://ai-kidou.jp/haas-ja-mac-transcribe-test/
最初にこのURLの記事を読む。読めない時は読めなかったと伝え、下の要点だけを材料にする。
(要点: 話題の文字起こしAIは、記事の数字ではなく自分の本物の音声で、今の道具と同じ条件で測る。測るのは時間・台本や正解との差・言っていない文・固有名詞。入れ替えるなら使う場所を1か所に絞り、元に戻せる形にする)

【目的】
私が今使っている文字起こしの道具と、入れ替えを考えている新しい文字起こしAIを、私の手元の本物の音声で比べる。そのうえで、入れ替えるならどこを1か所だけ替えるかを決められる材料を作る。

【やってよいこと】
1. 記事を読んだ後、短い質問を1つずつ聞く。1回に1問だけ。
   - 今使っている文字起こしの道具と、その用途(何に使っているか)
   - 入れ替えを考えている所(どの用途を、どの新しい道具に)
   - 手元にある本物の音声(長さ・本数・台本や正解の文があるか・無音や雑音だけの部分を用意できるか)
2. 答えをもとに、同じ音声で今の道具と新しい道具を比べる計画を作る。
   - 何を測るか: かかった時間(同じ設定で2回以上、交互に)/台本や正解との文字の差の割合/言っていない文が出た数(無音・雑音だけの音声も使う)/固有名詞と英字の書き方
   - 測る時のパソコンの混み具合を書き留める欄も入れる
   - 用途ごとに「この場所で一番大事な物差しは何か」を1行で書く
3. 私の使っている環境にそのまま貼れる追加のプロンプトを1〜3本つくる。各プロンプトの中にも記事のURL(https://ai-kidou.jp/haas-ja-mac-transcribe-test/)を入れる。

【守ること】
- 既定の設定(いつも使う文字起こしの道具や、その設定)を勝手に替えない。
- インストール・削除・課金は、提案として書くだけにする。実行しない。
- 音声ファイル・文字起こしの中身・パスワードや鍵を、外部のサービスに送らない。
- 分からない事は推測で埋めず、私に聞く。

【返す形】
1. 今の使い方のまとめ(道具・用途・困っている所を3行以内)
2. 比べる計画(測る物・使う音声・回数・記録する表の形)
3. 入れ替え候補の場所を1か所だけ挙げ、その理由を1行
4. 元に戻す方法(控えを取る場所・戻す手順)
5. 追加のプロンプト(1〜3本・記事のURL入り)
6. 自分の目で読み直す所を1行よくある質問(FAQ)
Q1. MacでHaas-jaは使えますか?
公式版の動作条件はLinuxとNVIDIAのGPUで、Macは公式には対応していません。私は、個人の方が作った非公式の移植「haas-mlx」を使って、Mac(Apple M5 Max)で動かしました。READMEに「非公式」「保守は約束しない」と書かれている物なので、私は特定の版(commit cde96d2)に固定して置いています。
Q2. Whisperから全部乗り換えるべきですか?
私は全部は乗り換えませんでした。入れ替えたのは講座動画の声の点検だけです。私のクローン声の素材では、文字の誤りはWhisperの方が少なく(63発言でWhisper 4.45%、Haas-ja 5.48%)、5分の音声では速さの差もほぼありませんでした。英字が小文字になる、名前を取り違えるといった弱点もあったので、普段の文字起こしはWhisperのままです。
Q3. 誰が話したかを分ける(話者分離)はできますか?
私が使っているMac向けの移植には、話者分離が入っていません。公式版には、別のモデルNemotron-3-Diarizationと組み合わせて話者ラベルを付ける例があります。私はLIVE記事の話者分けを、今までどおりAssemblyAIで行っています。
Q4. 固有名詞には強いですか?
私の素材では、強いとは言えませんでした。クローン声の名乗り「田中啓之、ひろくん」を「田中博幸、ひろ君」と書きました。Whisperも「田中博之」と書いたので、名前の漢字はどちらも外れています。公式版には固有名詞の読みと書き方を教える「語彙の登録」がありますが、私が使っている移植には入っていません。公式版の語彙の登録で直るかは、まだ確かめていません。
Q5. 無音の所で、言っていない文が出ることはありますか?
出ることはあります。ただ、私の試験ではWhisperより少ない結果でした。無音・雑音だけの8本で、Whisperは8本全部、Haas-jaは3本(「すいません。」「うん。」)でした。LIVE 2本の「ご視聴ありがとうございました」という言っていない文は、Whisperが3件と2件、Haas-jaは0件でした。
COLUMN
名前を正しく書けるか、自分の声で確かめてから1か所に置く
今回の測定で、私が一番引っかかった行があります。クローン声の名乗りを、Haas-jaが「田中博幸、ひろ君」と書いた所です。比べたWhisperも「田中博之」と書きました。誤りの割合で見れば、数文字の違いにすぎません。それでも、ここは数字だけで流したくなかったんですよね。
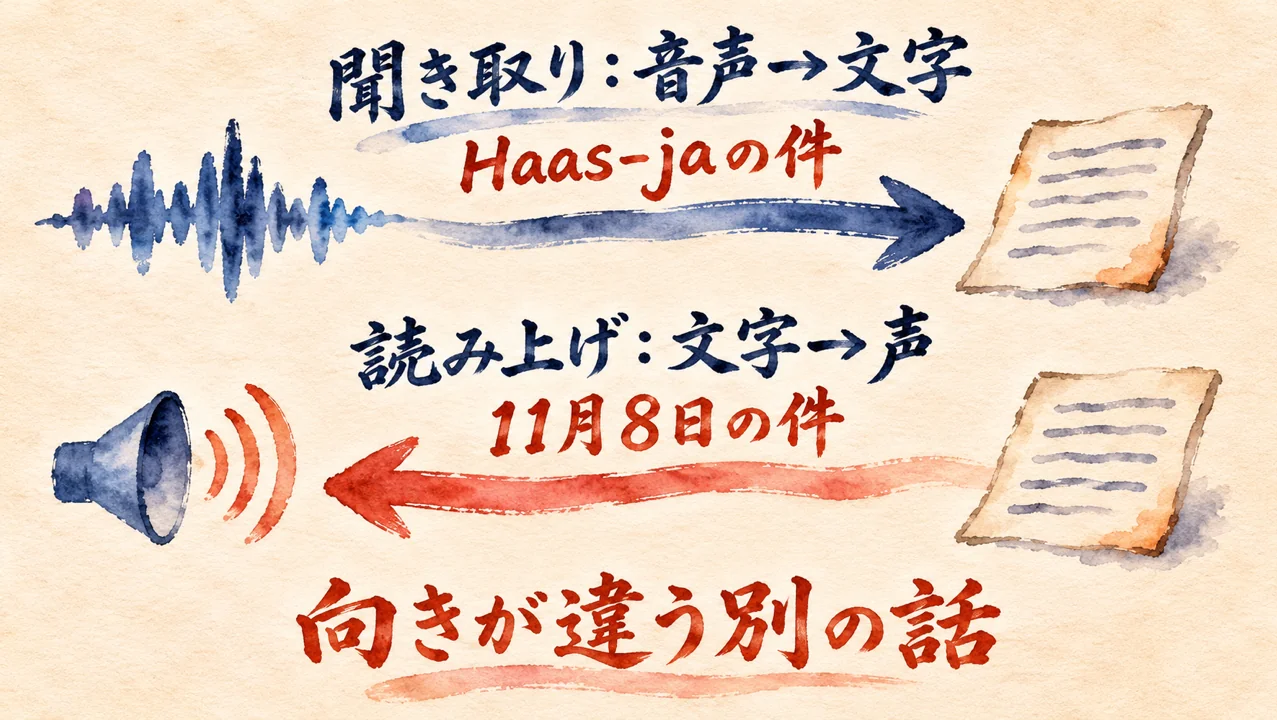
実は、11月8日にも名前の話がありました。声で読ませる文が、私の名前を読み間違えたんです。その時は「田中啓之はたなかひろゆき」と、読み方を伝え直しました。ただ、この2つは場面が違います。Haas-jaの件は、音声を聞いて文字にする「聞き取り」の話です。11月8日の件は、文字を声にする「読み上げ」の話です。ここを混ぜて「AIは名前に弱い」とひとまとめにすると、どこを直せばいいのかが見えなくなります。
今回の測定を振り返って、魂磨きの記事に書いたこの一節を思い出しました。
私の記事より(AIに判断まで委ねるには、魂を込めて教える時間がいる・丸投げに惹かれても、いまの私は「お守りばっかで」)お守りとは、任せたつもりでも手が離れず、確かめ続けること。私の「お守りばっかで」は、その状態の話です。
Haas-jaでやったことも、丸投げではありません。新しいAIに文字起こしを任せる前に、私の声で測って、どこを間違えるかを先に見ました。そのうえで、普段の文字起こしは入れ替えず、入れ替えたのは1か所だけです。手を離して任せ切るのではなく、確かめながら置き場所を決めました。いまの私のお守りは、こういう形をしています。
入れ替えた1か所は、声の点検です。ここでは、文字起こしの結果を台本と照らし合わせるためだけに使っていて、記事やメルマガには載りません。普段の文字起こしは記事になる文字の出発点なので、名前の表記が崩れていれば、崩れたままの文字から書き始めることになります。同じ道具でも、置く場所によって、弱点が困りごとになるかどうかが変わるんです。
名前は、その人がその人であることの入口です。あなたが新しいAIに何かを任せる時も、まず自分の素材で、自分の名前を正しく書けるかを見てみませんか?
まとめ: 記事の数字は、自分の素材で測ってから1か所に
- Haas-jaは公式にはLinuxとNVIDIAのGPU向けで、Macは非公式の移植で動かす。移植には語彙の登録も話者分離も無い
- 声の点検(10発言)は、faster-whisperの407.8秒からHaas-jaの12.2秒へ縮んだ。5分の音声ではWhisperとほぼ差が無く、速さは条件つきだった
- 私のクローン声では、文字の誤りはWhisperの方が少なかった。noteの公開データでの結果は、私の素材では再現しなかった
- 言っていない文はHaas-jaの方が少なかった。一方で、英字の小文字化と名前の取り違えが出た
- 入れたのは声の点検の1か所だけ。壊れた時は元の道具へ自動で戻る形にして、別の会社のAIにも変更を点検させた
話題の新しいAIを見たら、全部を入れ替える前に、手元の音声1本で時間を並べるところから始めてみてくださいね。記事の数字と自分の数字を分けて見るだけで、どこに入れるかがぐっと決めやすくなります。
関連記事
仕事でAIを使い始めたいのに、どのAIにするかで手が止まっている人へ向けて、AI仙人さんの動画から「初心者はどのAIでもいい、差がつくのは何をやらせるか」を整理した記事です。
🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成・画像制作にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。