グラフエンジニアリングをFleetで動かし、1体で書いたAIと記事を読み比べたら3対0
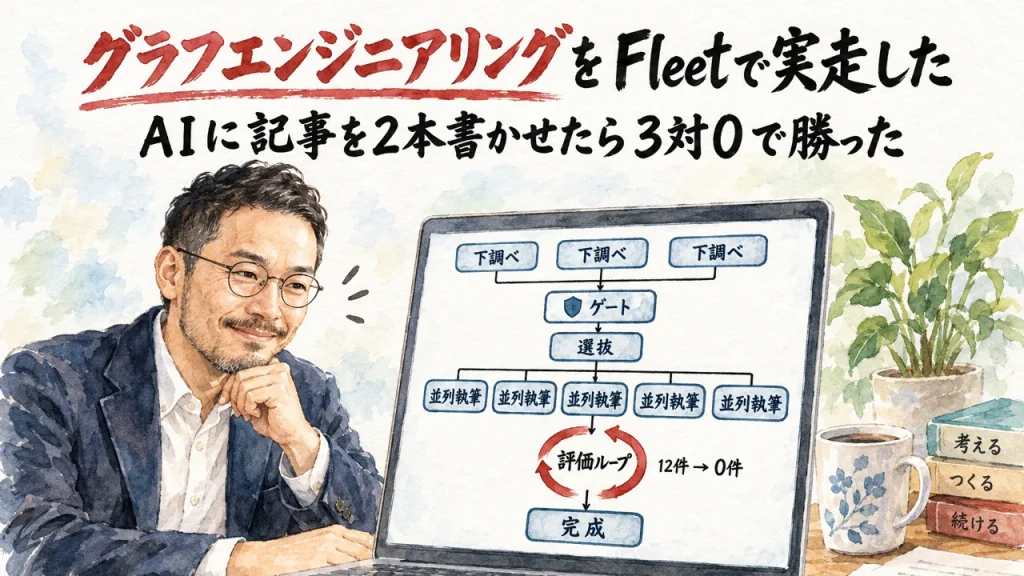
AIに記事を書かせるとき、頼み方を変えると出来上がりはどれくらい変わるのか。同じ素材から、作り方だけを変えて2本書かせました。片方は1体のAIが最初から最後まで書く。もう片方は下調べを3体で並列に行い、別のAIが構成を選び、別のAIが採点して書き直させる。匿名にして3人の審査員に読ませた結果は3対0。ただし「読ませる力」だけなら負けた側が上でした。2本とも全文を載せますので、どちらが良いかはご自身で確かめてください。
1. 結論から: グラフエンジニアリングをFleetで動かした結果
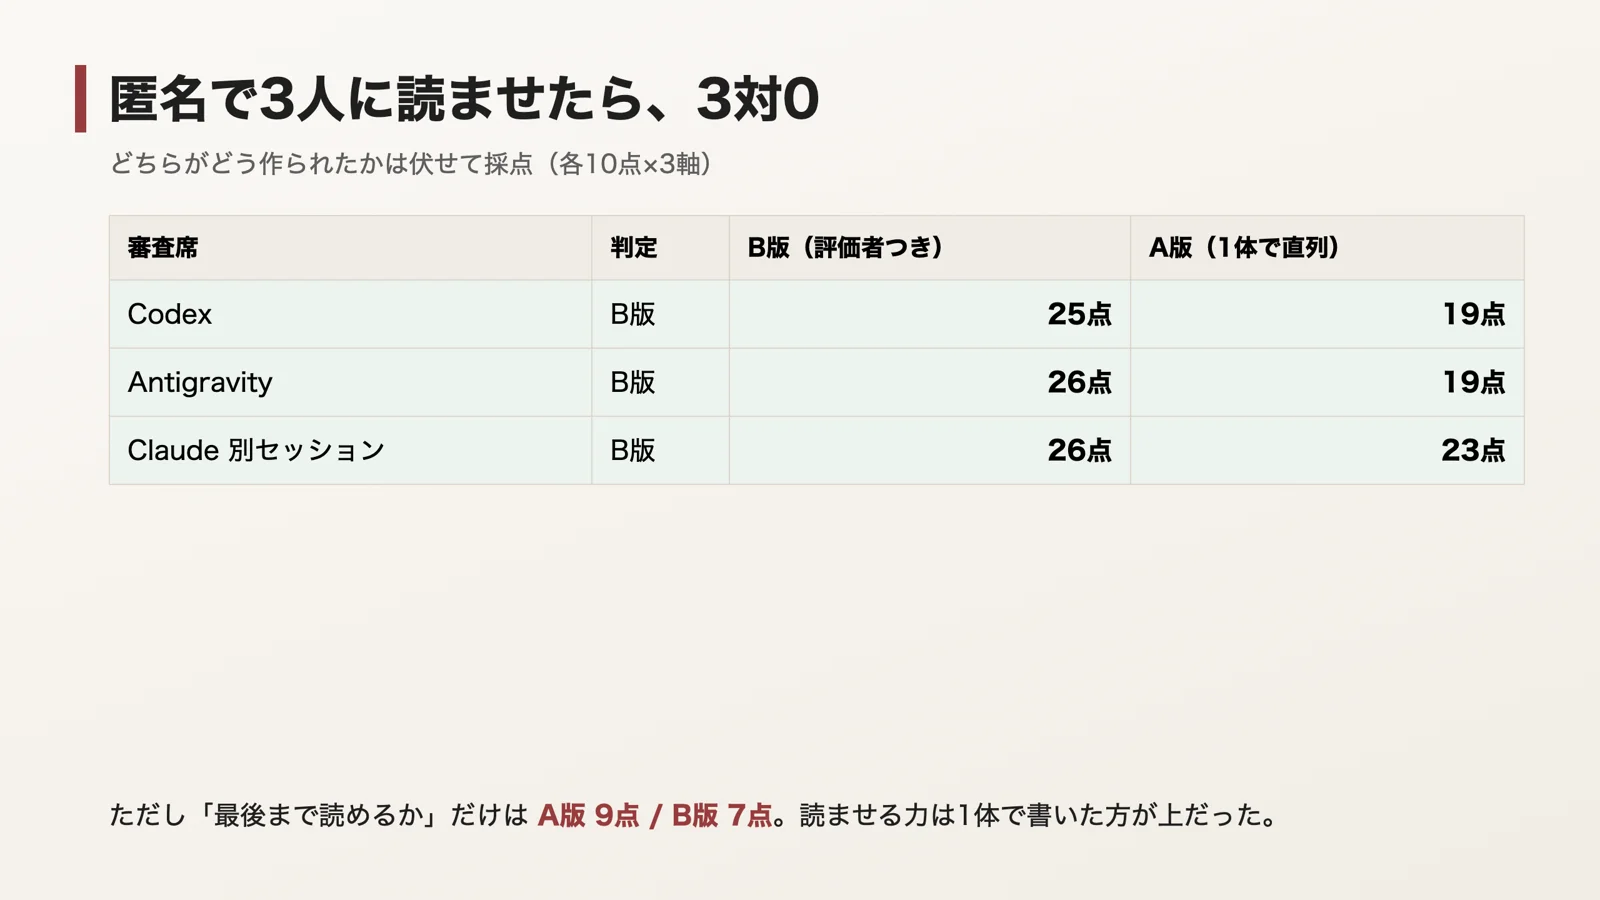
3対0でB版が勝った。まあ、これだけ見ると分かりやすい結果です。
ただし判定軸ごとに見ると、「最後まで読めるか」だけはA版が9点でB版が7点。文章としての引きは、1体で一気に書いた方が上だという評価でした。
それでも勝ったのがB版だったのは、残り2軸の差です。原文への忠実さと、読んだ後に行動できるか…この2つで大きく離されました。
実際に2本を読み比べたら採点役ありがどう違うか、全文を載せてあるので後で確かめてみてください。
2. きっかけになった動画
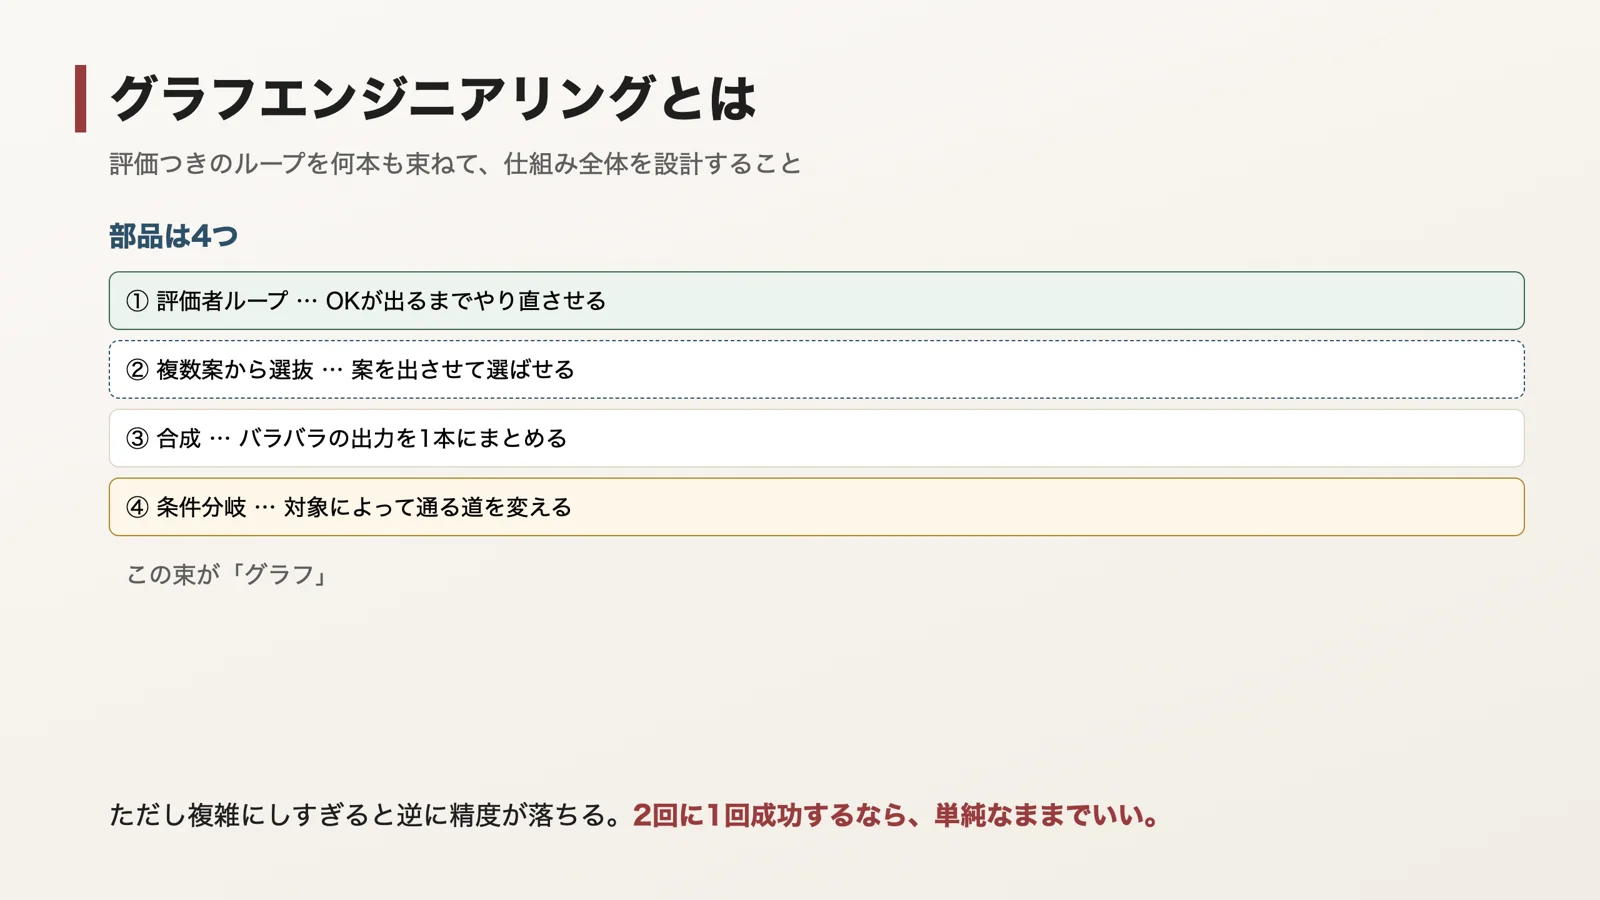
グラフエンジニアリングという言葉が最近出てきました。AIエージェントに評価者を付けてやり直させる工夫を「ループ」と呼びますが、そのループを何本も束ねて全体を設計することを指します。知ったのは次の動画。
飯塚浩也さん「【プロンプトの限界】AIの嘘・二度手間をゼロにする『グラフエンジニアリング』入門」(16分22秒)
動画の中身そのものは 別の記事 で解説しました。この記事はその続き。やっぱり、読んで分かった気になるのと、走らせてみるのとでは別物でしたね。
そこで、AIに記事を書かせる頼み方を2通り用意して、同じ素材で動かしてみた。この実験の記録が、以下です。
3. なぜAIに任せると精度が落ちるのか
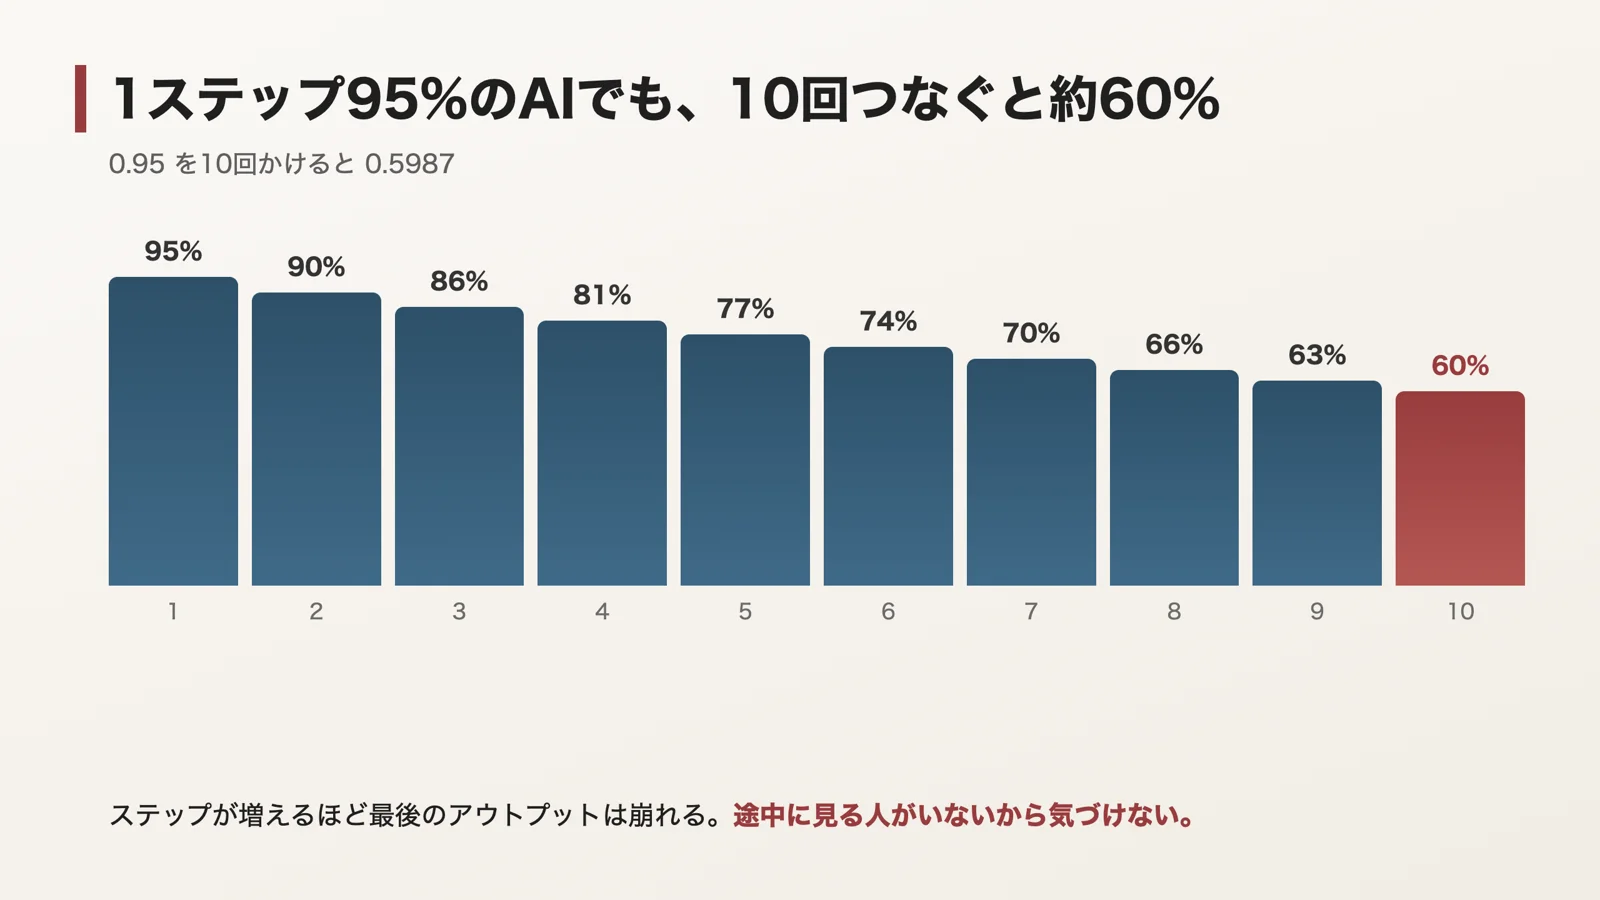
1ステップを95%の精度でこなせるAIに、10ステップの仕事を一気に任せるとどうなるか。0.95を10回かけると、約60%。1回ごとにはほとんど間違えないのに、つないだだけで「2回に1回よりは少しマシ」まで落ちます。
で、厄介なのは途中を見ていても気づけないこと。
どのステップも単体ではまともに見えます。おかしいと気づくのは、たいてい最後に出てきたものを読んだとき。
プロンプトを磨けば解決するかというと、しません。
1ヶ所を98%に上げても、残り9ステップが95%のままなら全体はほとんど動かない。効くのは「途中に誰かが見る場所を作ること」のほうでした。
4. 使った道具: AGI Cockpit の Fleet
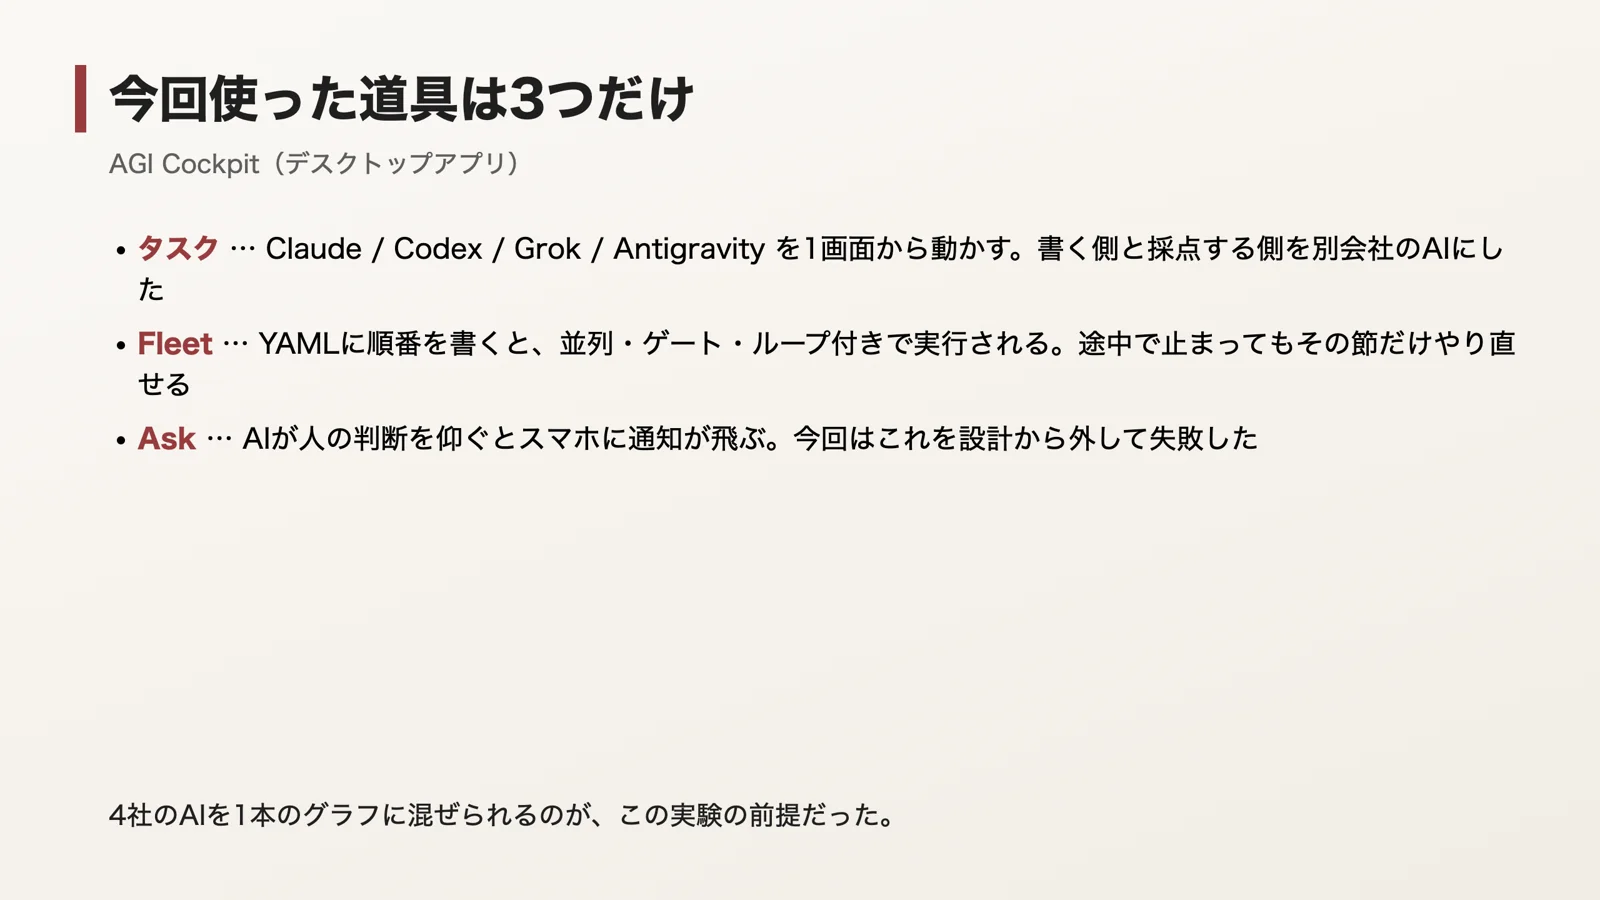
実験に使ったのは AGI Cockpit というデスクトップアプリ。その中の Fleet という機能で、グラフエンジニアリングをそのまま組めます。
今回触ったのは、この機能だけです。
- タスク … Claude / Codex / Grok / Antigravity を1つの画面から動かせます。今回は書く側と採点する側を別の会社のAIにしました。同じモデルだと自分の癖を見逃すので。
- Fleet … YAMLに「どのノードがどのノードの後に動くか」を書くと、並列・ゲート・ループつきで実行されます。途中で止まっても、その節だけやり直せる。
- Ask … AIが人の判断を仰ぐと、スマホに通知が飛びます。今回はこれを設計から外してしまい、あとで痛い目を見ました。
5. A版の作り方
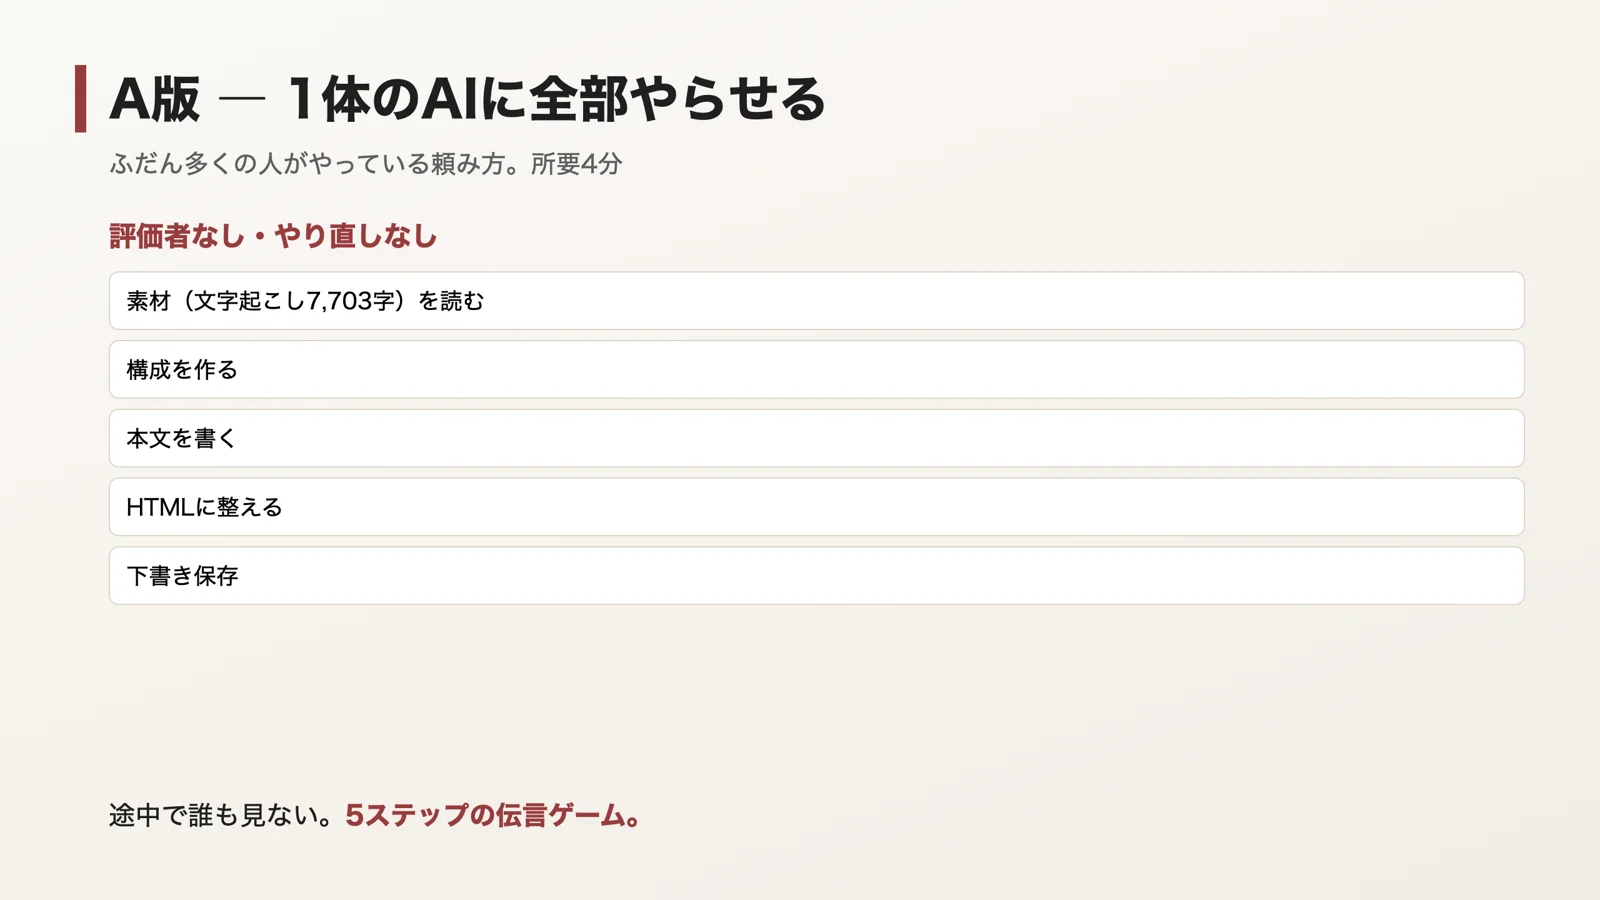
ふだん多くの人がやっている頼み方です。
1つのAIに、素材を読む→構成を作る→本文を書く→HTMLに整える→下書き保存、を一気にやらせる。評価者なし。やり直しなし。途中で人に聞くのも禁止。
素材は動画の文字起こし7,703字だけ。Web検索も他資料も禁止にしました。所要は4分。
6. 読み比べ 1本目: 1体で直列に書かせたA版の全文
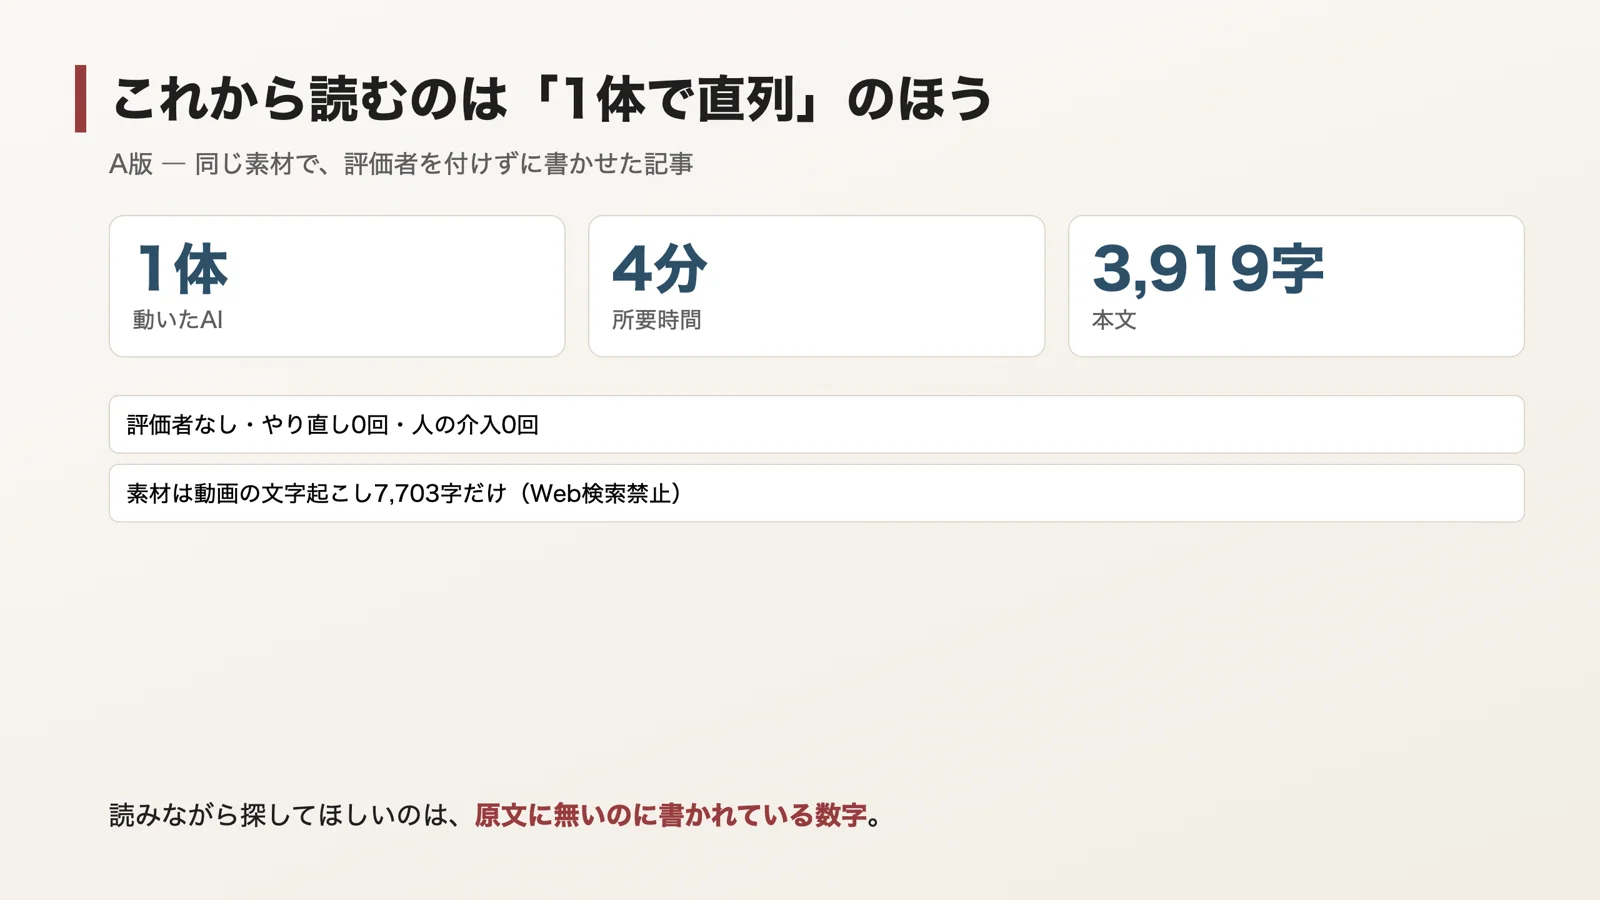
まず1本目。正直、これだけ読めば普通に良い記事に見えると思います。やっぱり、比べないと分からないものですね。
A版の全文を読む(3,919字)
以下はA版(1体のAIが直列で書いた原稿)の全文です。実験の現物なので、表記も原文のまま載せています。
AIに仕事を頼むと精度が6割まで落ちる ―「グラフエンジニアリング」で右腕を作り直す
AIエージェントに「この資料を作って」と丸ごと頼んだのに、出てきたものが微妙だった。途中までは良さそうだったのに、最後のアウトプットで首をかしげる。そんな経験はありませんか。
これはあなたのプロンプトが下手だから起きているのではありません。作業を何ステップも任せた時点で、算数として精度が落ちる仕組みになっているからです。
いま「グラフエンジニアリング」という言葉が出てきています。ループエンジニアリングを世界に広めた開発者のピーター氏が「まだループの話をしてるの? 今はグラフだよ」と冗談めかして投げたところから広まった、まだ固まりきっていない概念です。各社が「うちはこう解釈しています」と表明してやっと輪郭が見えてきた段階で、正直なところ「俺のグラフエンジニアリング」が乱立している状態でもあります。
それでもこの話を取り上げるのは、バズワードの正体が、AIを仕事に使っている私たち全員の困りごとと直結しているからです。順番に見ていきます。
95%を10回つなぐと60%になる
まず、数字から入らせてください。
1つのステップを95%の成功率でこなせるAIエージェントがいるとします。95%と聞けば、かなり優秀です。そのAIに「資料を作って」と頼み、10ステップの作業を最初から最後まで一気に走らせたとしましょう。
最終的な精度は何%になると思いますか。
答えは約60%です。0.95を10回かけると0.5987、つまり6割。1ステップごとにはほぼ間違えないAIが、10回つないだだけで「2回に1回よりは少しマシ」くらいの水準まで落ちてしまいます。
AIエージェントに仕事をお願いするのが実はすごく難しい、というのはこういうことです。あなたのAIが急にバカになったわけでも、その日のご機嫌が悪かったわけでもありません。1回ごとの小さなズレが、ステップ数のぶんだけ掛け算されて効いてくる。ステップが多い仕事ほど、最後のアウトプットが崩れる。それが構造として最初から入っているのです。
そして厄介なことに、この「掛け算で落ちる」性質は、途中経過を見ているだけでは気づけません。1ステップ目も5ステップ目も、それ単体では十分まともに見えるからです。おかしいと気づくのは、たいてい最後に出てきた成果物を見たときです。
プロンプトを磨いても直らない
ここで多くの人がやることは決まっています。プロンプトを工夫すればいいじゃないか、と。
やってみましょう。頑張って書き直して、最初のステップの精度を95%から98%に上げられたとします。立派な改善です。でも、その後ろに続く9ステップは相変わらず95%のままです。全体の精度は、ほとんど変わりません。
これがプロンプトエンジニアリングの限界です。プロンプトが効くのは、あくまで「1つのステップの精度」に対してです。掛け算の項をひとつ磨いても、項の数が多ければ結果はやはり落ちていきます。良質なメモやドキュメントを最初に与えるコンテキストエンジニアリングも同じで、入口の質は上がりますが、ステップが多ければ最後のアウトプットは崩れます。
この状態は、伝言ゲームによく似ています。最初の人はちゃんと聞き取っているし、次の人もほぼ正確に伝えている。誰も手を抜いていないのに、最後の人が言う言葉は元の文とまったく違う。1人ひとりの精度を上げても、人数が増えれば同じことが起きます。
必要なのは、伝言する人の腕を磨くことではありません。途中で「今の内容で合ってる?」と確認する人を立てることです。
伝言ゲームを止める4つの部品
途中で確認を挟む、という発想を具体的な部品に落とすと、次の4つになります。
1. 評価者ループ
作業のあいだに評価役のAIを置き、OKが出るまでやり直させます。出力を次のステップに渡す前に一度止めて、「これは要求を満たしているか」を判定させる。ダメなら同じステップをもう一度やらせる。伝言ゲームで言えば、途中に答え合わせをしてくれる人を入れる形です。これが一番基本の部品で、他の3つはこれの応用と言っていいものです。
2. 複数案から投票で選抜
同じタスクを1回ではなく複数回走らせ、出てきた案の中から一番良いものを選ばせます。「こうじゃないの?」という意見を何人ぶんも用意して、多数決で採用する形です。1回の出力の当たり外れに全体を賭けずに済みます。
3. 合成
複数のAIに並行して別々の担当を持たせ、それぞれのアウトプットを最後にまとめて1つにします。並列で走らせるぶん速くなりますし、まとめる時点でもう一度「これで良いか」の評価を挟めます。もしそこでNGが出たら、該当するタスクの実行に戻してやり直させます。
4. 条件分岐
内容によって処理の道筋を変えます。同じ入口から入っても、扱う対象が違えば通る道が違う。これを人間が毎回手で振り分けるのではなく、仕組みの側に持たせます。
この1つひとつの小さな確認の輪が「ループ」で、それらを束ねたり、合成させたり、分岐を置いたりして全体を設計したものが「グラフ」です。グラフエンジニアリングとは、ループの束、つまり仕組み全体の話をしていたわけです。
どこに賢いモデルを置くか
部品を並べたら、次はどのAIモデルをどこに置くかです。ここには分かりやすい原則があります。上流ほど賢いモデルを使う、です。
一番賢いモデルを置くべきなのは、実行部隊ではなくプランです。ここが間違っていると、どれだけ優秀な実行役がいても全員で違う方向に走ってしまいます。Anthropicの公式も、最上流には最も優秀なモデルを、と言っています。
実行部隊の中でも同じことが言えます。親と子なら、賢くすべきは親です。マネージャーと社員の関係と同じで、マネージャーが優秀なら、それぞれに適切な指示を出せます。Claudeで言えば、プランと実行の親に上位モデル、子の実行部隊にはSonnet、ごく簡単な作業ならHaikuでも足ります。
評価者も同じ考え方でいきます。プランの評価は影響範囲が全体に及ぶので上位モデルを、子タスクの評価は間違えても影響が部分的なのでコスパのいいモデルを。そして最終アウトプットの評価は大事なところなので、ここも上位モデルに戻す。この使い分けだけでも、大きく外しません。
ただし複雑にしすぎると逆に落ちる
ここまで読んで「そんな複雑なものを組まないといけないのか」と身構えたなら、その感覚は正しいので、ブレーキの話をします。
グラフを複雑にしすぎて、逆に精度が落ちたタスクが論文のデータとして報告されています。目安として挙げられているのは、1つのAIエージェントに直列でやらせて2回に1回くらい満足できるタスクなら、それ以上複雑にする必要はない、という線です。
複雑にすれば時間もかかりますし、部品が増えれば管理も増えます。そのうえで結果がいまいちなら、完全に持ち出しです。抱えている業務を全部グラフ化しよう、と意気込む必要はまったくありません。
順番はこうです。まずシンプルに、1つのAIエージェントに順番にタスクをやらせてみる。それで困らないならそれでOK。精度が微妙だと感じたら、まず小さなループを1つ入れる。それでもうまくいかないときに初めて、ループを複数作ったり、合成させたり、投票を入れたりする。
大きく作ってから削るのではなく、足りないところにだけ足す。この向きを間違えないことが、たぶん一番効きます。
今日から何をするか
とはいえ、この仕組みをゼロから設計するのは大変です。ここには近道が2つあります。
1つは、Anthropicが用意しているスキルクリエイターを使うことです。「こういう資料を作りたい」と伝えて発動させれば、タスクの分解も、評価をどう作るかも、どのAIに評価させるかも、サブエージェントとして誰を用意するかも、まとめて設計してくれます。しかも人間が曖昧なお願いをすると、向こうから「どういうことですか」と質問が返ってきます。その受け答えをしているうちに、自然と自分の業務が分解されていく。ここが地味に効きます。
さらに、できたスキルを1回使ってみて微妙だったら、「微妙だった」とフィードバックすれば改善までしてくれます。複雑になりすぎたら「もっとシンプルに」と伝えればいい。作りっぱなしにならない仕組みが最初から入っています。
もう1つは、紙に書くことです。OpenAIの中の人が言っていた方法で、評価者はここ、プランナーはここ、ワーカーという実行部隊はここ、という図を紙に手で書いて、それをそのまま「このワークフローを実装してください」とAIに渡す。それだけで動く、と。面白いことに、「まだループの話をしてるの?」と言ったピーター氏本人もこの投稿に反応して、自分もやってみたと返しています。
どちらを選んでも構いません。紙に書けるなら紙が早いですし、書くのが難しいと感じるならスキルクリエイターのほうが簡単です。
今日やることを1つだけ挙げるなら、まず自分の仕事の中で「AIに頼んだけど最後の出来が微妙だったもの」を1つ思い出してください。それはたいてい、ステップが多い仕事です。その仕事に対して、途中に評価者を1人だけ立ててみる。そこから始めれば十分です。
95%を10回つなげば60%になる。この事実を知っているだけで、AIがうまく動かないときに責める相手が変わります。プロンプトを書き直す前に、途中に誰を立てるかを考える。あなたの右腕は、そこから作り直せます。
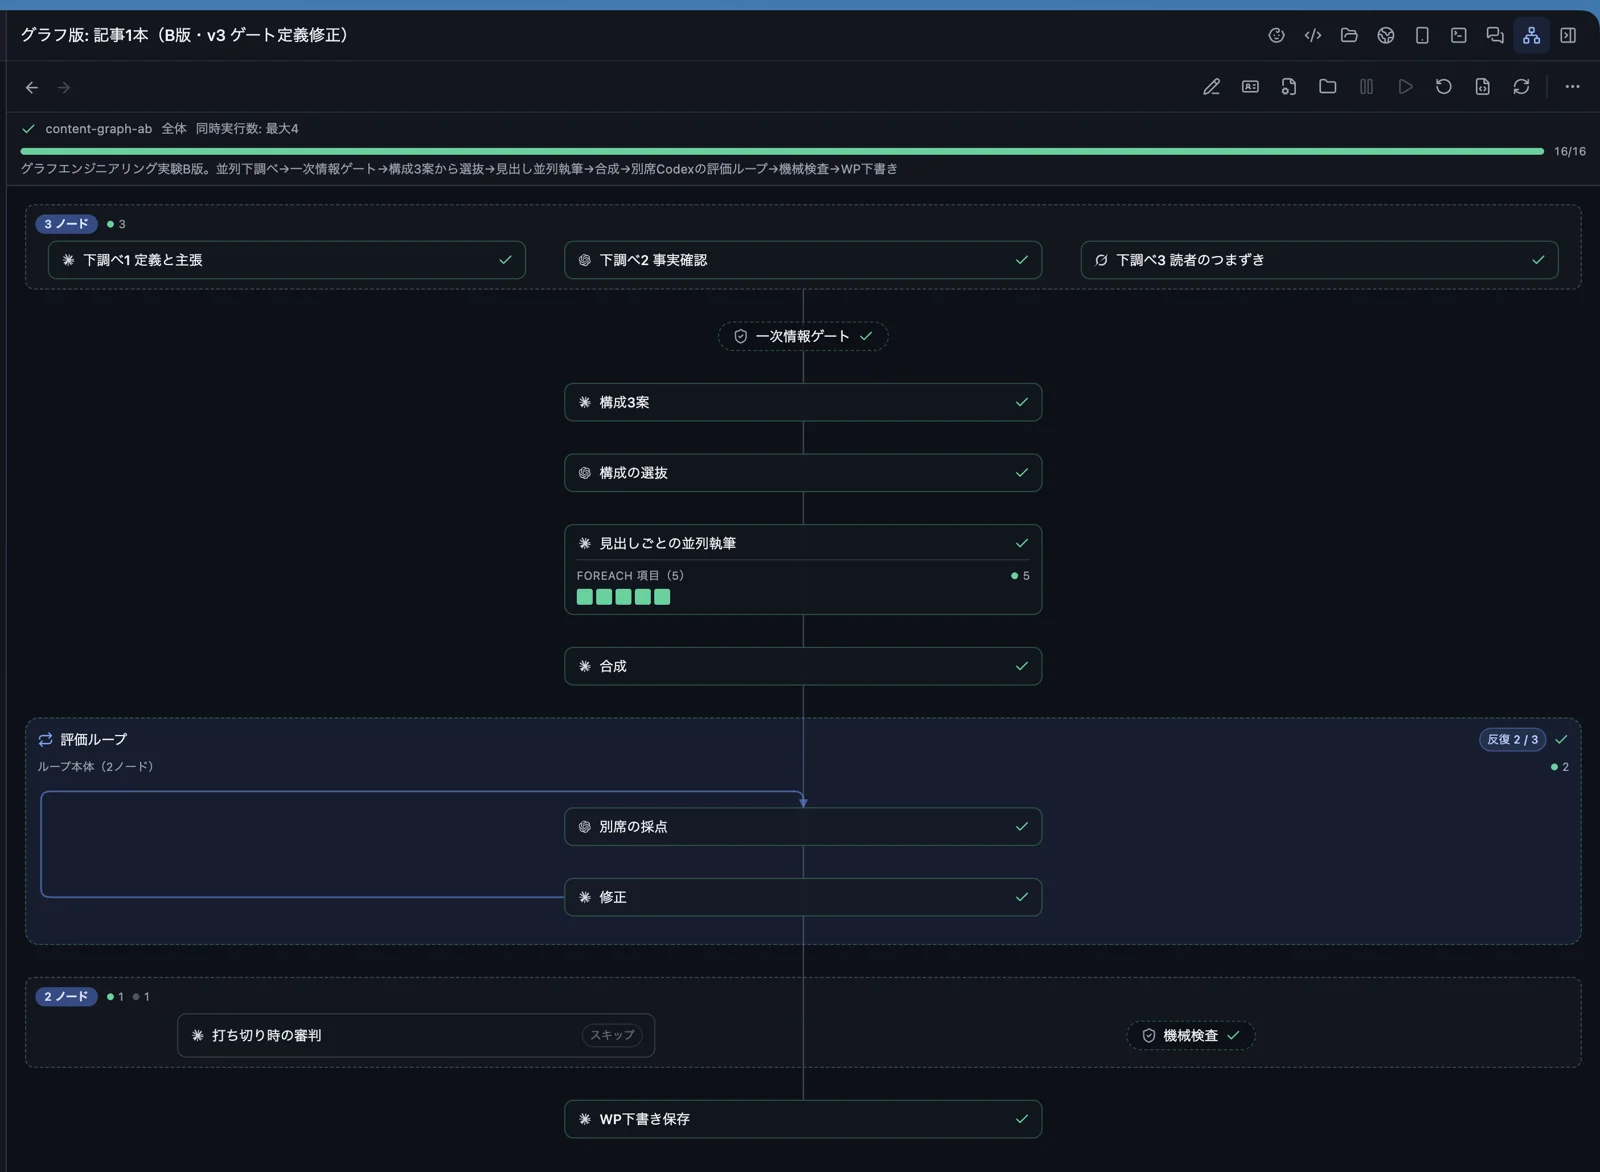
7. B版の作り方: Fleetで12ノードのグラフを組む
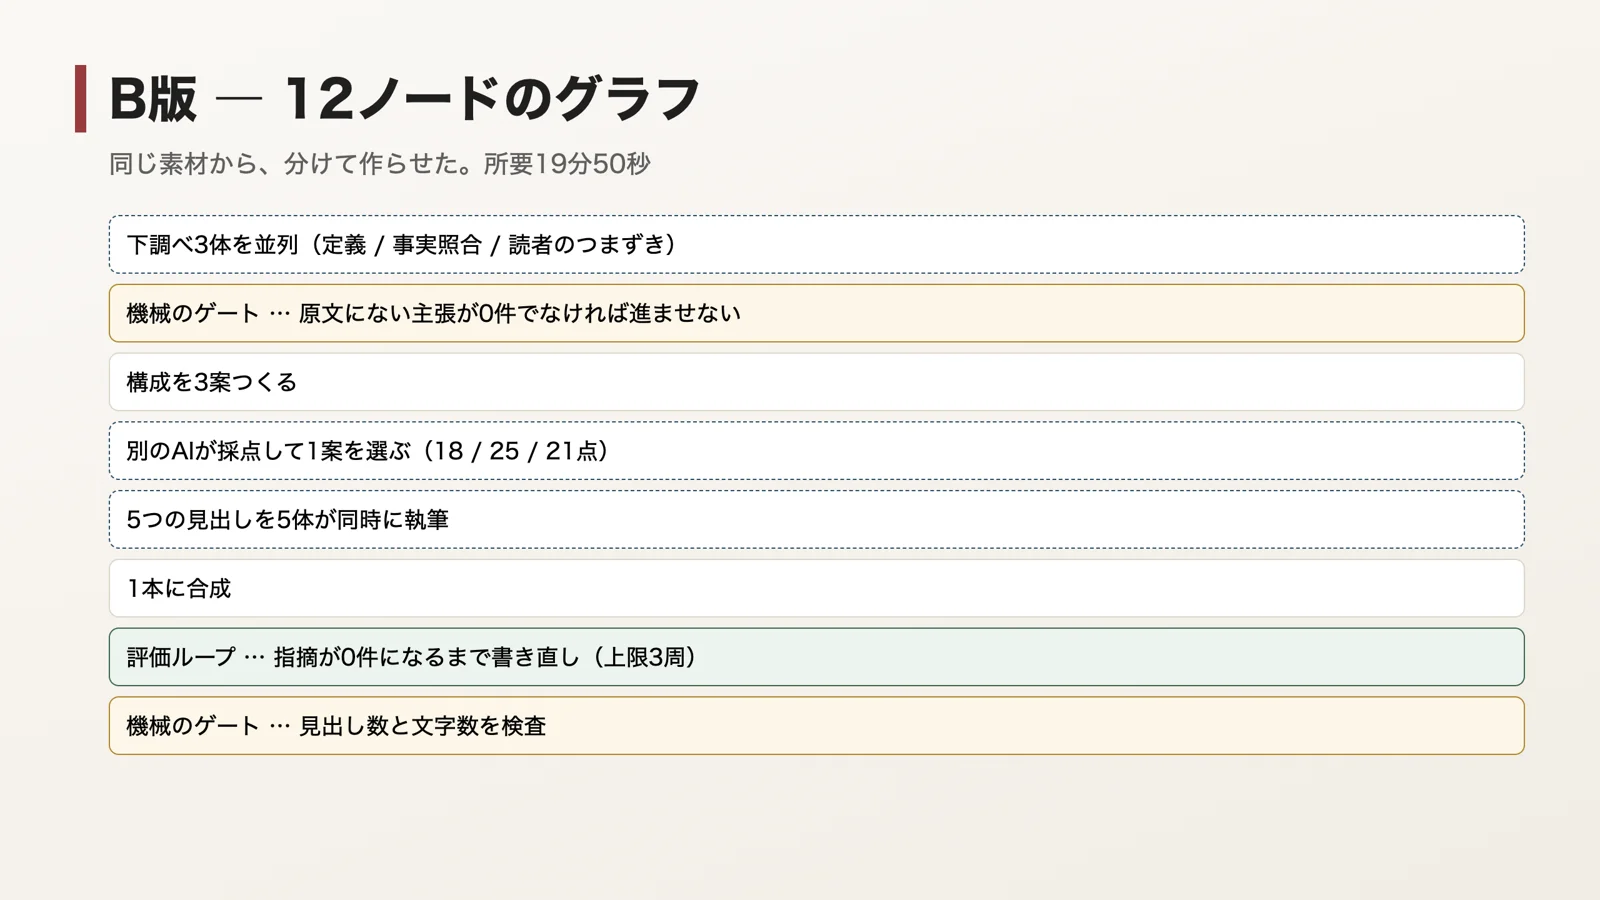
同じ素材から、今度は Fleet で12ノードのグラフに分けて作らせました。グラフエンジニアリングで言う評価者ループ・並列・ゲート・選抜を、全部このYAML1枚に書いています。
polish:
  type: loop
  needs: [integrate]
  max_iterations: 3          # 上限3周。無限には回らない
  on_exhausted: judge        # 決着しなければ審判役が最終判断
  until:
    run: test "{{needs.review.output.issues}}" -eq 0
  nodes:
    review:                  # 採点役(書く側と別会社のAI)
      session: continue      # 同じセッションを続ける=前回の指摘を覚えている
      output_contract:       # 感想ではなく数値で返させる
        required: [issues, findings]
    fix:                     # 直す側
      needs: [review]
大事なのは output_contract です。
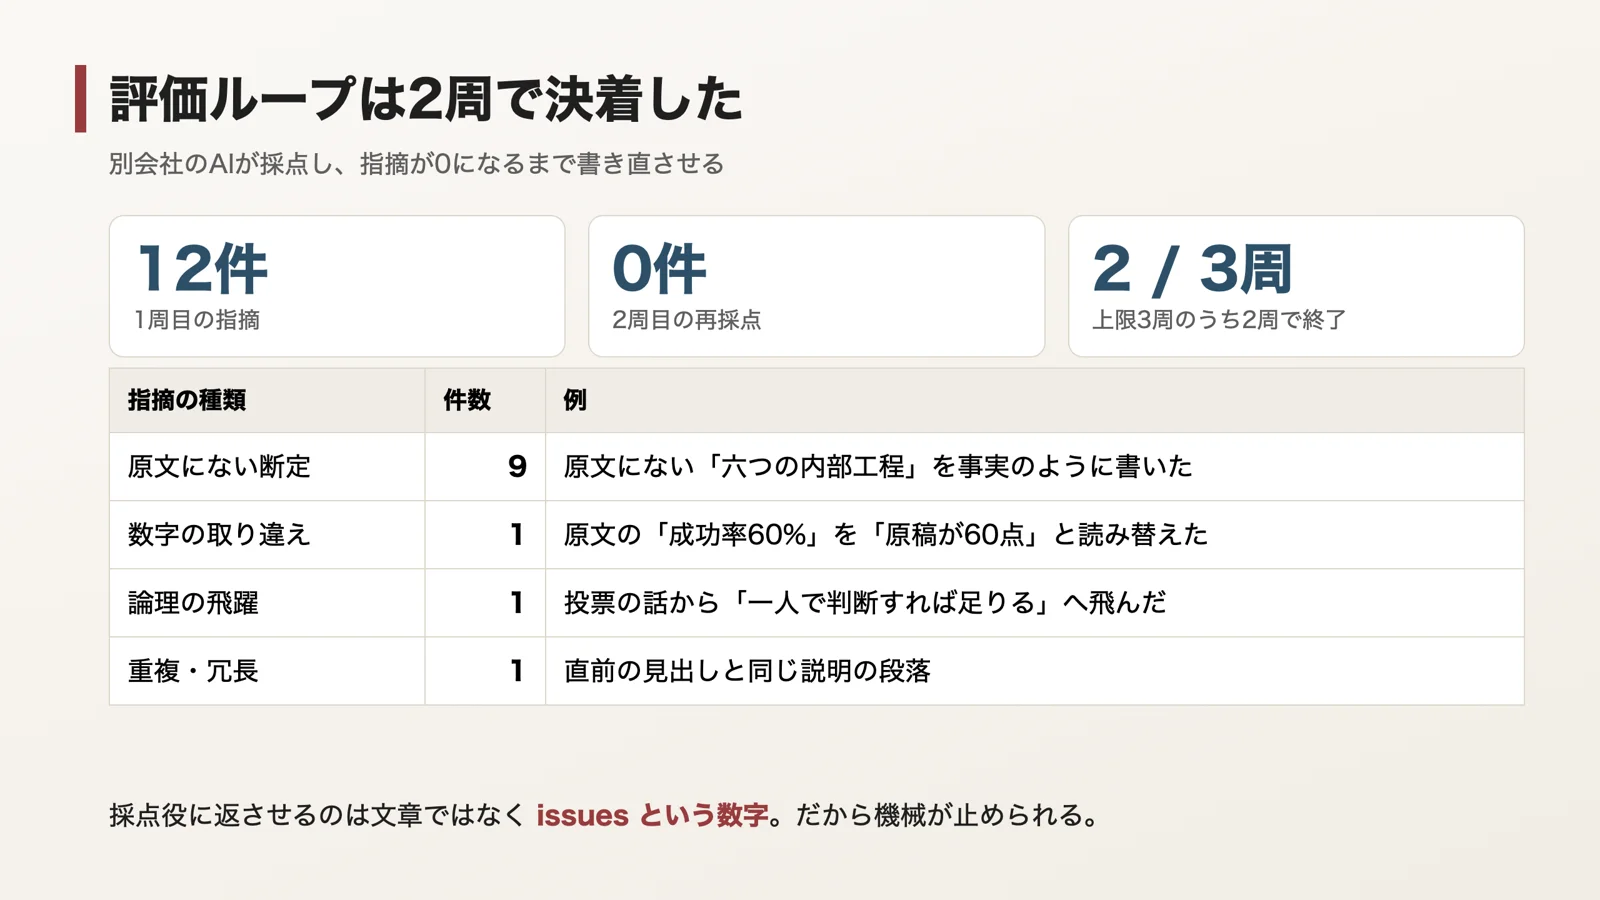
採点役に返させるのは文章ではなく issues: 12 という数値。だから test ... -eq 0 で機械的にループを止められる。
ここを文章のままにすると…AIの自己申告で「もう大丈夫です」と抜けてしまいます。所要は19分50秒。
8. 読み比べ 2本目: 評価者つきグラフで書かせたB版の全文
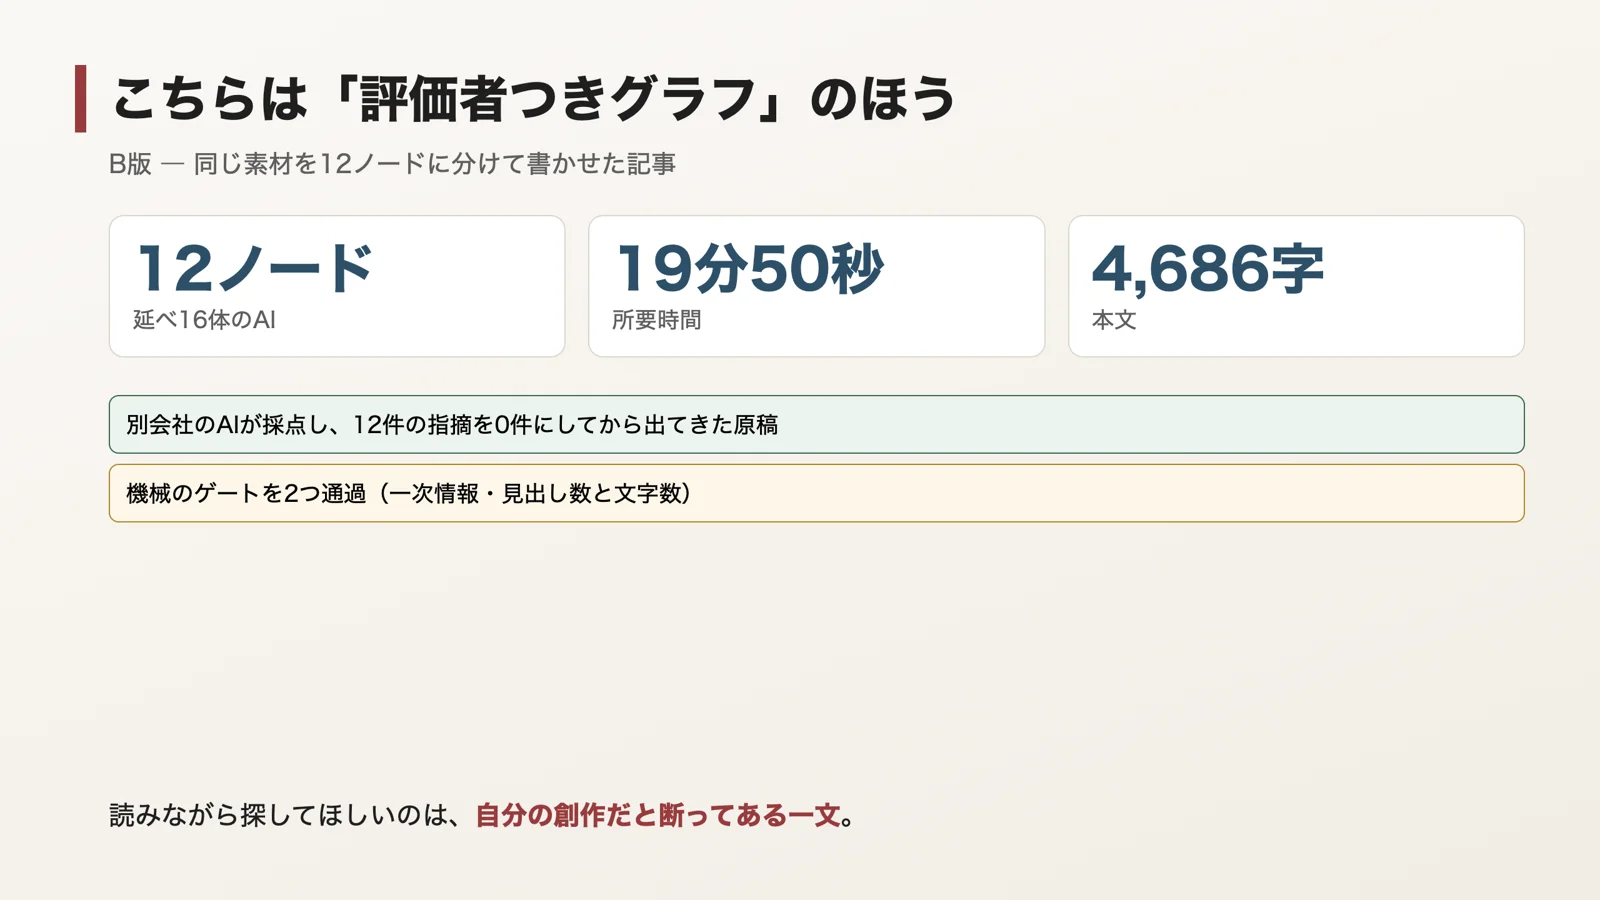
2本目。さて、1本目とどこが違うか。ちなみに、書かせた素材はまったく同じです。読み比べたら採点役ありがどこで効いているか、見えてくるはずです。
B版の全文を読む(4,686字)
以下はB版(12ノードのグラフが書いた原稿)の全文です。実験の現物なので、表記も原文のまま載せています。
「いい感じにまとめて」が毎回ズレる人へ — AIを伝言ゲームにしない2つの手
「いい感じにまとめて」と頼んで返ってきた原稿が、毎回どこかズレている。プロンプトの書き方を工夫するだけでは届かないところがあり、依頼をまるごと一直線に渡してしまう形も、ズレの要因になり得ます。途中で誰も見ていない伝言ゲームにしないために、今日から足せる手を2つ紹介します。構成だけを先に出させること、そして2案出させて自分が選ぶこと。順番に見ていきます。
「資料にまとめて」で返ってきた、どこかズレた原稿
「資料にまとめて」。チャットにそう打ち込んで、返ってきた原稿を開いた瞬間に、少しがっかりする。構成の順番が思っていたものと違う。数字は結局こちらで確かめ直すことになる。文章のトーンも、自分が普段お客さんに送るものとは少しずれている。直せなくはないけれど、全部直すくらいなら自分で書いた方が早かったかもしれない。そんな、どこかズレた原稿です。
ここで多くの人は「プロンプトが下手だったのかな」と考えます。けれど動画は「プロンプトエンジニアリングだけだと限界がある」と言います。言葉選びとは別に、依頼の形のほうも見ておく価値があります。
動画は、仮の数字で計算してみせます。AIエージェントが1つのステップを95%の成功率でこなすとします。ひとつだけ見れば、95%はかなり高い数字です。ところが「資料を作って」という依頼が、ステップ10まであったとしたらどうなるか。0.95を10回かけ算すると、最後まで成功する割合は60%近くまで落ちてしまいます。だから「AIエージェントに仕事をお願いさせるって実はすごい難しいこと」なのだ、と話者は言います。
「資料にまとめて」の一言は、私たちの頭の中ではひとつのお願いです。けれど資料作りを手順に割ってみると、目的を決める、構成を組む、材料を選ぶ、本文を書く、数字を確かめる、体裁を整える——と工程が一直線に並びます(この6つは筆者が資料作成を分けた例で、動画が挙げた工程ではありません)。動画が仮に置いた10ステップも、こうした一直線の形です。動画ではこれを伝言ゲームにたとえていました。最初はもちろんいいのですが、一直線に渡していくと、最後にはもう違う言葉が出てきてしまう。返ってきた原稿だけを見ても、何番目でずれ始めたのかは分かりません。
しかもこの一直線には、途中で止まる場所がありません。構成ができた時点で「この順番でいいですか」と聞かれることも、数字を書いた時点で確かめられることもなく、最後まで走り切って完成品として出てきます。人間がはじめて中身を見るのは、全部が終わったあとです。ズレに気づくのが最後になるのは、途中で誰も見ていない一直線だから、という面があります。
今この対処法が「グラフエンジニアリング」と呼ばれ始めている
言い出したのは、ループエンジニアリングという言葉を世界に広めた本人、オープンクローの開発者のピーターさんです。その本人が「まだループの話してるの? 今はグラフだよ」と冗談めかして言ったのがきっかけでした。自分が広めた言葉を、自分で追い越していった形です。
中身は、身構えるほど難しいものではありません。AIにタスクを依頼すると、まずAIがプランを考えます。そのプランが良いか悪いかの評価がそこで入り、人間がOKを出したら実行に移る。実行中も、1つずつのタスクの間に小さな評価が挟まっています。最後に出力をまとめて最終アウトプットにしますが、そこでもOKかどうかの評価があり、NGならタスクの実行をやり直す。この「出させて、評価して、ダメならやり直す」という小さなループを、いくつも束ねたり合成したり、評価者を置いたりした仕組み全体のことを、グラフエンジニアリングと呼んでいます。ループの束がグラフのようなもの、という言い方もされていました。
これまでのループエンジニアリングと対立する新しいやり方ではありません。1つひとつのループを指すのが前者で、その全体をうまく束ねようという話が後者です。
ただし、留保もそのまま書いておきます。この言葉はまだ確立されていません。解釈がいろいろ生まれ、「結局ループと何が違うのか」「本当に自分のAIの精度が上がるのか」がふわっとしている、というのが今の状況です。昔からある大きなAI企業が「私たちはグラフエンジニアリングをこう解釈しています」と表明し始めて、やっと少しずつ固まってきた段階。それぞれの「俺のグラフエンジニアリング」がある状態です。
覚えるべきは名前のほうではなく、途中に評価とやり直しを挟むという中身のほうです。そしてその中身は、仕組みを組まなくても、明日の依頼文に置き換えられます。手は2つあります。
一手目: 完成品ではなく「構成だけ」出させる
「いい感じにまとめて」と一息に頼むと、返ってくるのは完成品です。方向がズレていた時、手を入れるのは出てきた本文のほうです。動画の中でも、資料作成をAIにやらせて一発で通ることは「絶対ない」と言い切っています。やり直しが前提なら、やり直しに備える手を先に打ちます。
やることは一つです。最初の依頼を「本文はまだ書かないでください。見出しと順番だけ出してください」に変えます。
根拠は、動画がホワイトボードで描いた流れです。タスクを依頼する → AIがプランを考える → そのプランの良し悪しの評価が入る → 人間がOKを出して、はじめて実行へ進む。ここで話者は、最上流のプランが間違っていたら、いかに優秀な実行部隊がいても変な方向に行ってしまう、と説明しています。だからプランには一番優秀なモデルを当てるべきで、Anthropic公式もそう言っていると。そのうえで「人間もこのプランはしっかり見た方がいい」と付け加えています。動画では最後の出力にも評価が入ります。本文だけでなく、実行前のプランも見ておこう、という話です。
手順にすると、こうなります。
1. 目的と読み手を1〜2行で渡す
2. 条件をつける。「見出しと順番だけ。本文は書かないでください」
3. 出てきた並びを読み、要らない見出しを消し、足りない見出しを足し、順番を入れ替える
4. 自分がOKと言ってから「この構成で本文を書いてください」と渡す
評価者のAIはまだ置きません。ここで評価しているのは自分です。3で自分が並びを直して4へ進む往復が、動画の言う最初の小さなループにあたります。追加のツールも、別のAIも要りません。
3の時点で直すなら、手を入れるのは見出しの並びだけで済みます。本文が出たあとに構成を変えれば、書き直しは本文にも及びます。先に構成を見るのは、この差を小さくしたいという狙いからの提案です。
二手目: 2案出させて、自分が審査員になる
構成にOKを出したら、次は中身です。ここでもう一度、走り切る前に人の目を入れます。
動画は、精度を落とさない工夫のひとつとして「アウトプットを複数出力させて、一番良いと思われるものを投票制にして選ばせる」を挙げています。伝言ゲームのたとえでは、「こうじゃないの、という意見を何人も用意して、一番多かったものを取り入れる」と説明されます。動画が説明しているのは、複数の意見を集めて選ばせる工夫です。ここから先は、その比べて選ぶところだけを人の手でやってみる、という記事としての応用提案です。投票制と同じ効果が出るとは限りませんが、走り切る前に人の目を入れる手にはなります。
やることは、依頼文に一行足すだけです。「案を2つ出してください。方向性は変えて」。企画書の構成でも、断りのメールの言い回しでも同じです。並んだ2案を、比べてみてください。どちらが目的に合っているのか、どちらが相手に伝わるのか。選ぶ作業そのものが、自分の中にあった基準を言葉にしてくれることがあります。
大事なのは、どちらか一方を丸ごと採らなくていいということです。動画には、並列で動いた実行部隊の出力をまとめて最終アウトプットにする「合成」という工程が出てきます。これを手でやります。「構成はA、具体例はB、締めはAの最後の段落」。コピペで1本につなげば、それで合成です。そのうえでもう一度AIに渡し、「この形で整えてください」と頼めば、つなぎ目はならされます。
やり直しが前提である以上、最初から2案もらって良いところを抜き出す、という進め方もあります。一手目と合わせれば、AIが一直線に走り切る前に、人の目が2回入ります。動画では、合成してまとめた最終アウトプットにも評価が入ります。整え直して返ってきたものも、最後にもう一度自分で読んでください。
3案、4案と増やしたくなりますが、最初は2案で止めてください。比べきれない数の案は、選べないのと同じです。
凝りすぎると、かえって悪くなる
ここまでの手を、全部の仕事に入れる必要はありません。動画も最後に「身構える必要はない」「抱える業務を全部グラフ化しようと意気込む必要はない」と念を押しています。
線引きの目安も出ています。動画は、論文のデータとして、仕組みを複雑にしすぎて逆に精度が落ちたタスクが存在した、と紹介しています。そのうえで、1つのAIで2回に1回成功するようなタスクなら、複雑にグラフを組む必要はないという報告もある、と。半分は満足できる出来で返ってきているなら、仕組みを複雑にしにいかなくていい、ということです。
順番も決まっています。まずはシンプルに、1つのAIに順番にタスクを実行させてみる。それで困らなかったら、それでOKです。精度が微妙だと思ったら、小さなループを1つ入れる。それでもうまくいかない時にはじめて、ループを複数作る・合成する・投票で選ばせるといった全体の最適化を検討する。増やすのは、前の段で足りないと分かってからです。
仕組みにするかどうかは、手でやってみて足りないと感じてからで間に合います。構成はいいのに数字だけ直している。そんな場所が見えているなら、そこだけを見張らせるのも手です。
その時の道具が2つ、動画で挙がっています。1つはAnthropic公式のスキルクリエイターです。評価の採点基準も、どのAIが評価するかも、実行役の親と子(サブエージェント)の構成も設計してくれます。動画はこれを「グラフエンジニアリングの第1歩」としてすすめています。ただし、その気になれば非常に複雑な仕組みも作れてしまい、時間がかかって結果もいまいちになることがあります。その時は「もっとシンプルにして」とフィードバックすれば作り直してくれます。
もう1つは紙とペンです。評価者はここ、プランナーはここ、ワーカーはここ、と流れを紙に手描きし、そのままCodexに「このワークフローを実装してください」と渡す。OpenAIの中の人の方法として紹介されています。
どちらも、複雑な仕組みを自分で組むのは難しい、という時の入口です。
ズレた原稿が返ってくるのは、プロンプトの言葉が足りないからだけではなく、依頼が最後まで一直線に走り切ってしまうからでもありました。その途中に評価とやり直しを挟むのが、いまグラフエンジニアリングと呼ばれ始めている考え方です。名前を覚える必要はありません。明日からできるのは2つ——本文の前に構成だけを出させて自分がOKを出すこと、そして2案出させて自分が選び、良いところをつないで、最後にもう一度読み直すこと。まずはシンプルに試して、足りないと感じたところから仕組みや道具を足していけば間に合います。
9. 匿名で3人に読ませた
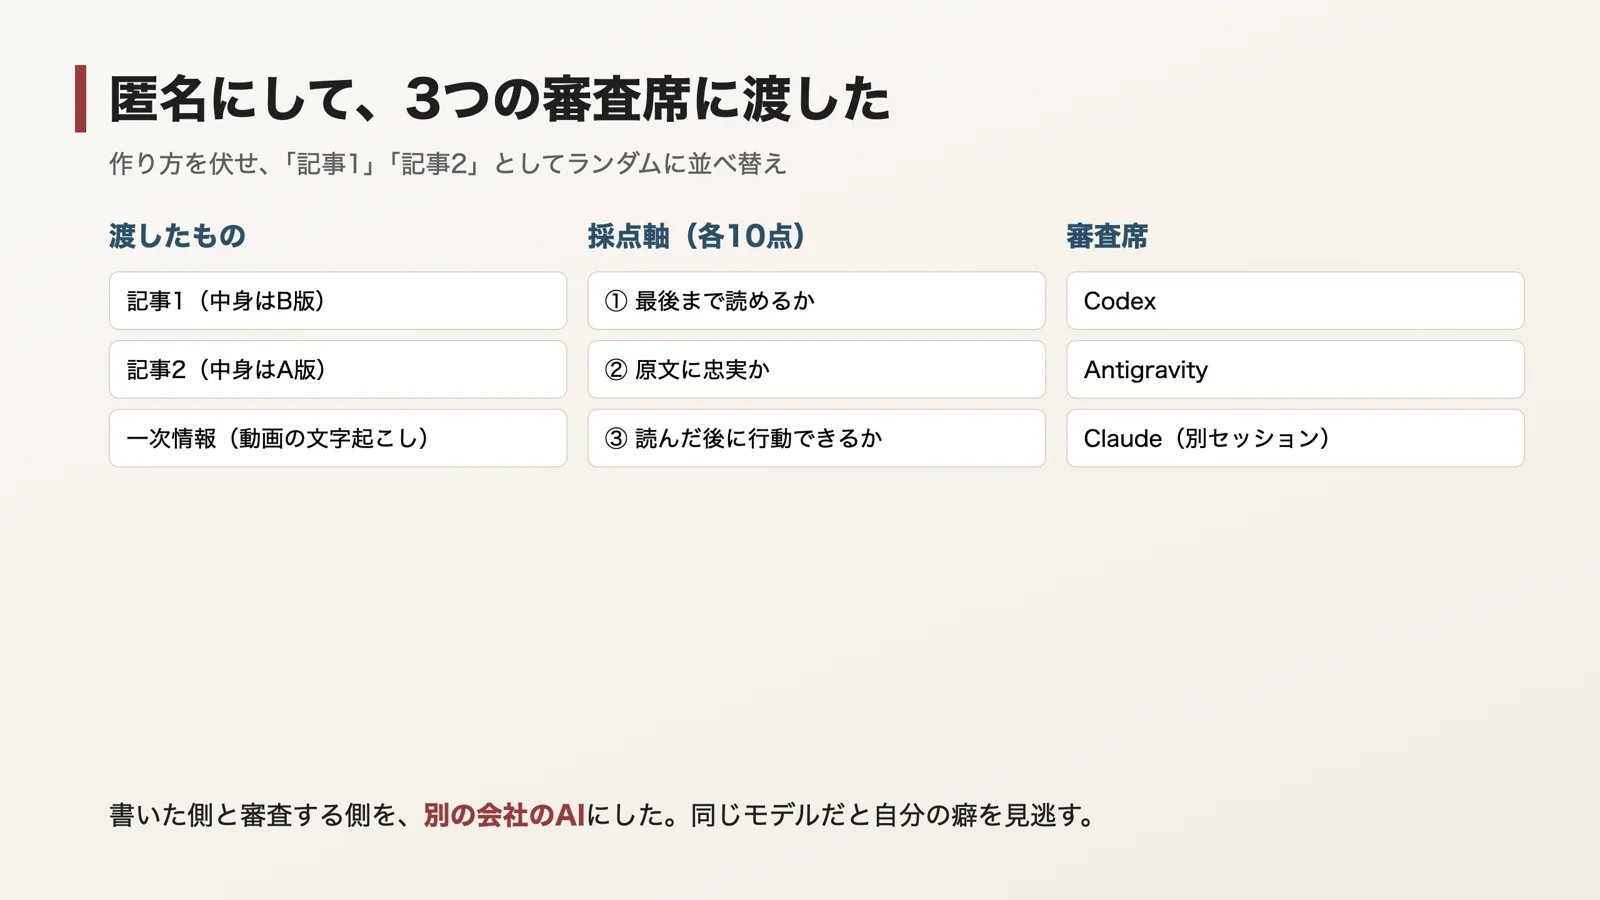
できた2本から、作り方が分かる情報を全部消しました。
「記事1」「記事2」としてランダムに並べ替え、審査席へ渡す。審査員には何も伝えていません。
判定軸は各10点。読めるか。原文に忠実か。そして読んだ後に動けるか。
結果は1節の通り3対0。ただし講評を読むと、単純な勝ち負けではありませんでした。
読ませる力だけなら記事2が上です。「答えは約60%です」「あなたのAIが急にバカになったわけでも、その日のご機嫌が悪かったわけでもありません」と短文で畳みかける構成は、専門家でない読者を最後まで運びます。
― 3席目の講評より(審査員はブラインドのため「記事2」と書いています。これがA版です)
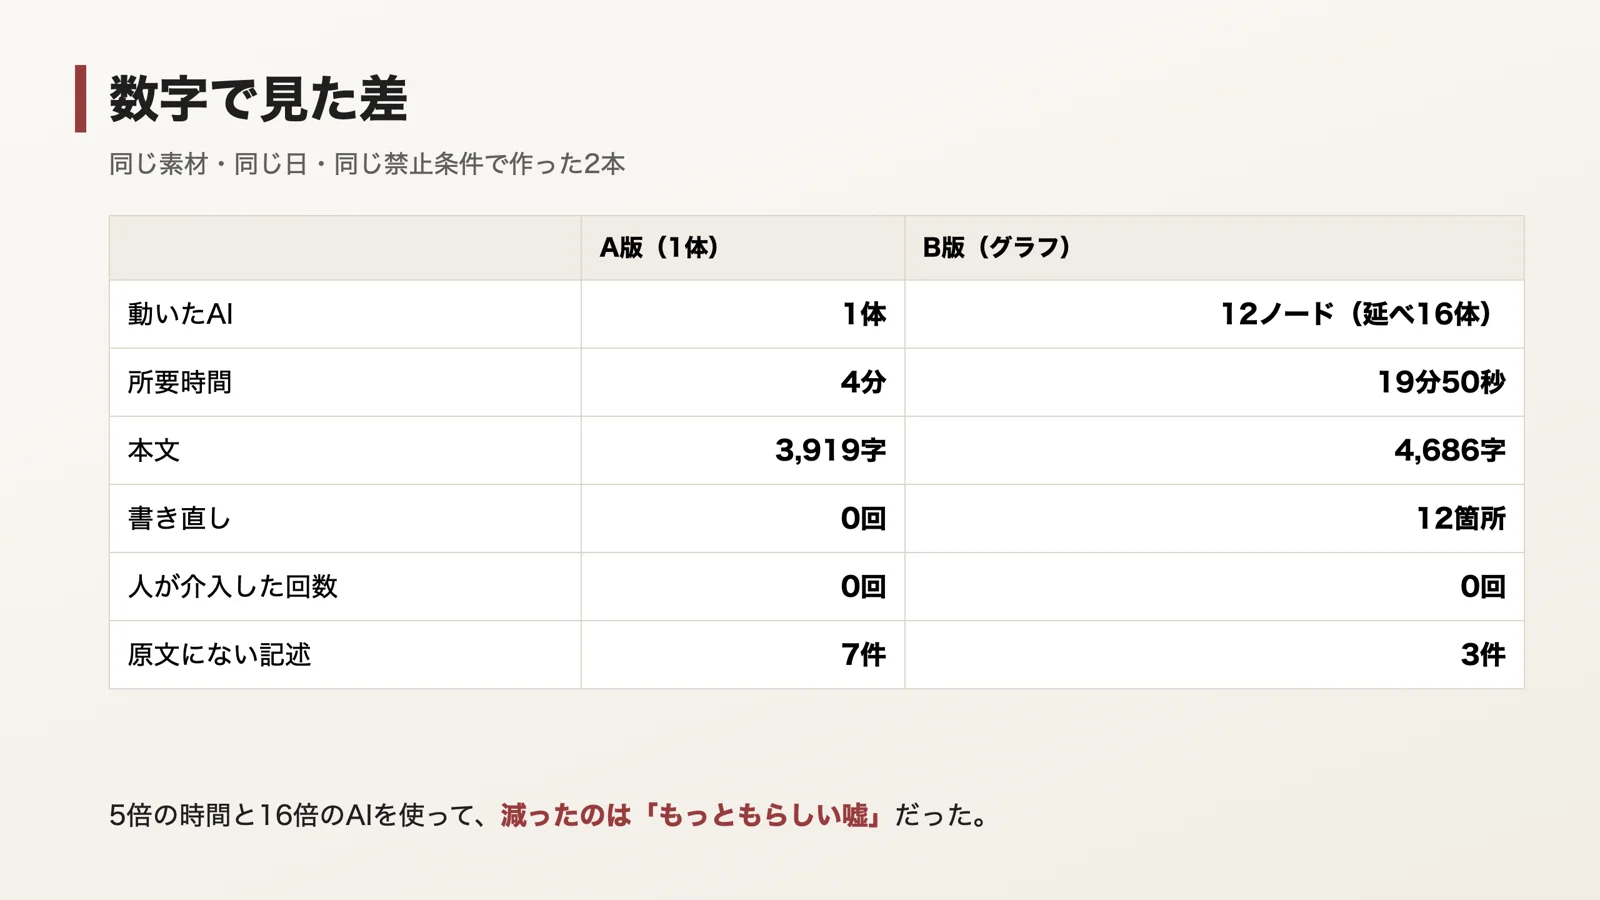
10. 読み比べの数字: 直列とグラフで何が違ったか
A版に何が混ざっていたか
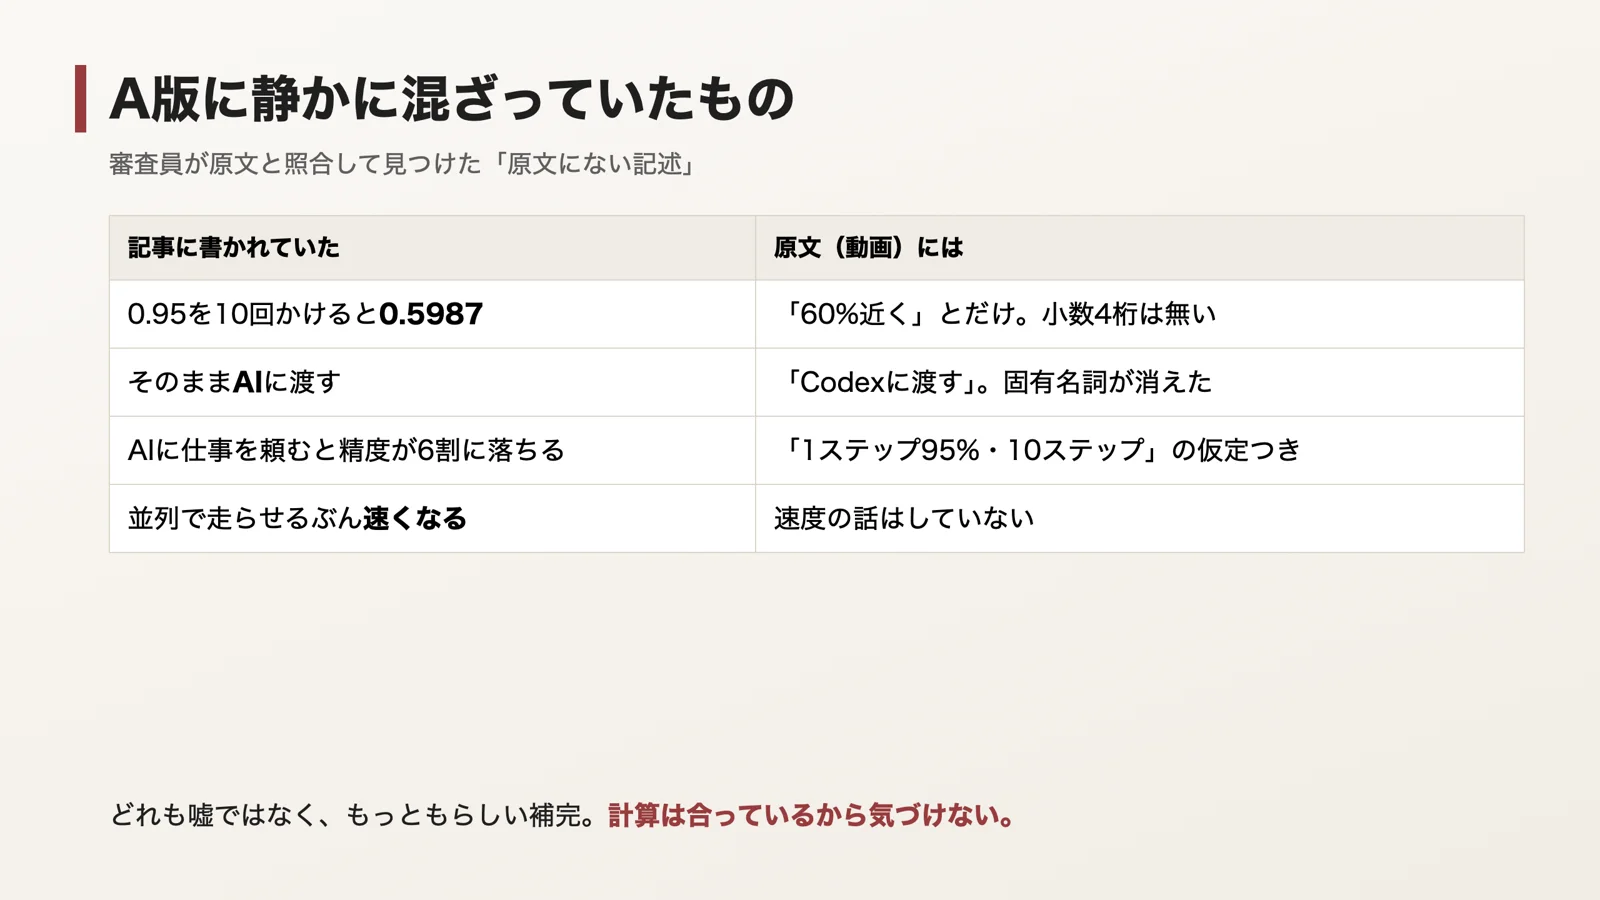
どれも嘘ではなく、もっともらしい補完です。1体に全部任せると、こういう補完が地の文に静かに混ざる。読者には、どこが原文由来でどこが筆者由来かを区別する手段がありません。
B版は何が違ったか
B版も創作はしています。ただ、境目を本文に書いていました。
(この6つは筆者が資料作成を分けた例で、動画が挙げた工程ではありません)
これは書き手が偉いなんて話ではなく、採点役がいたから。まあ、当たり前といえば当たり前ですが…1周目の採点で出た指摘は12件でした。
11. 3回走らせて、2回は失敗した
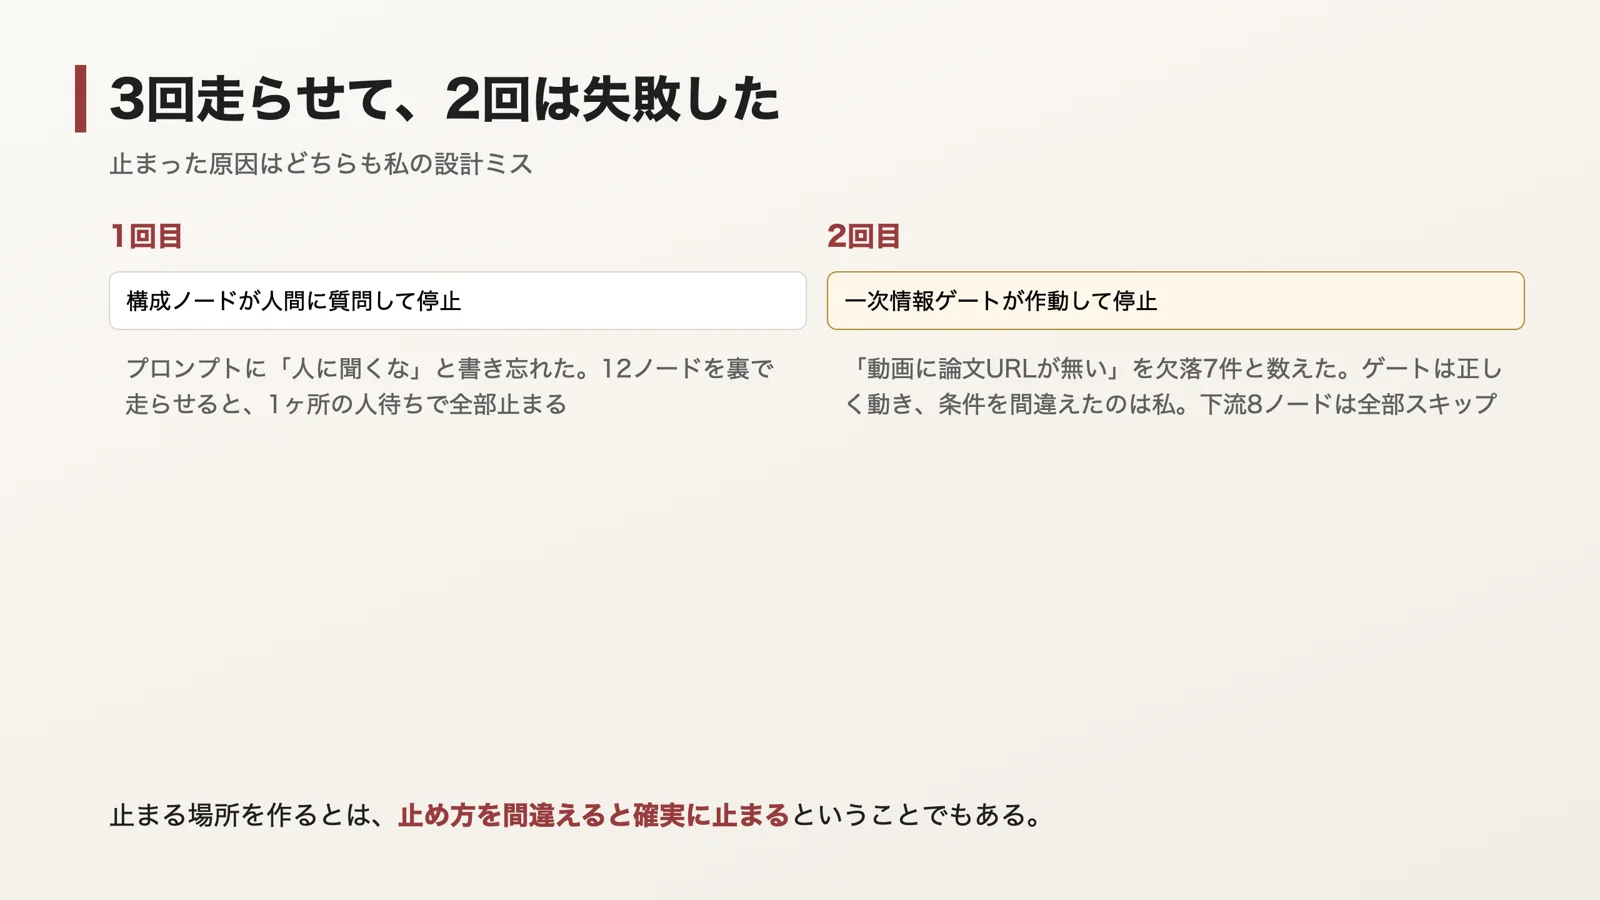
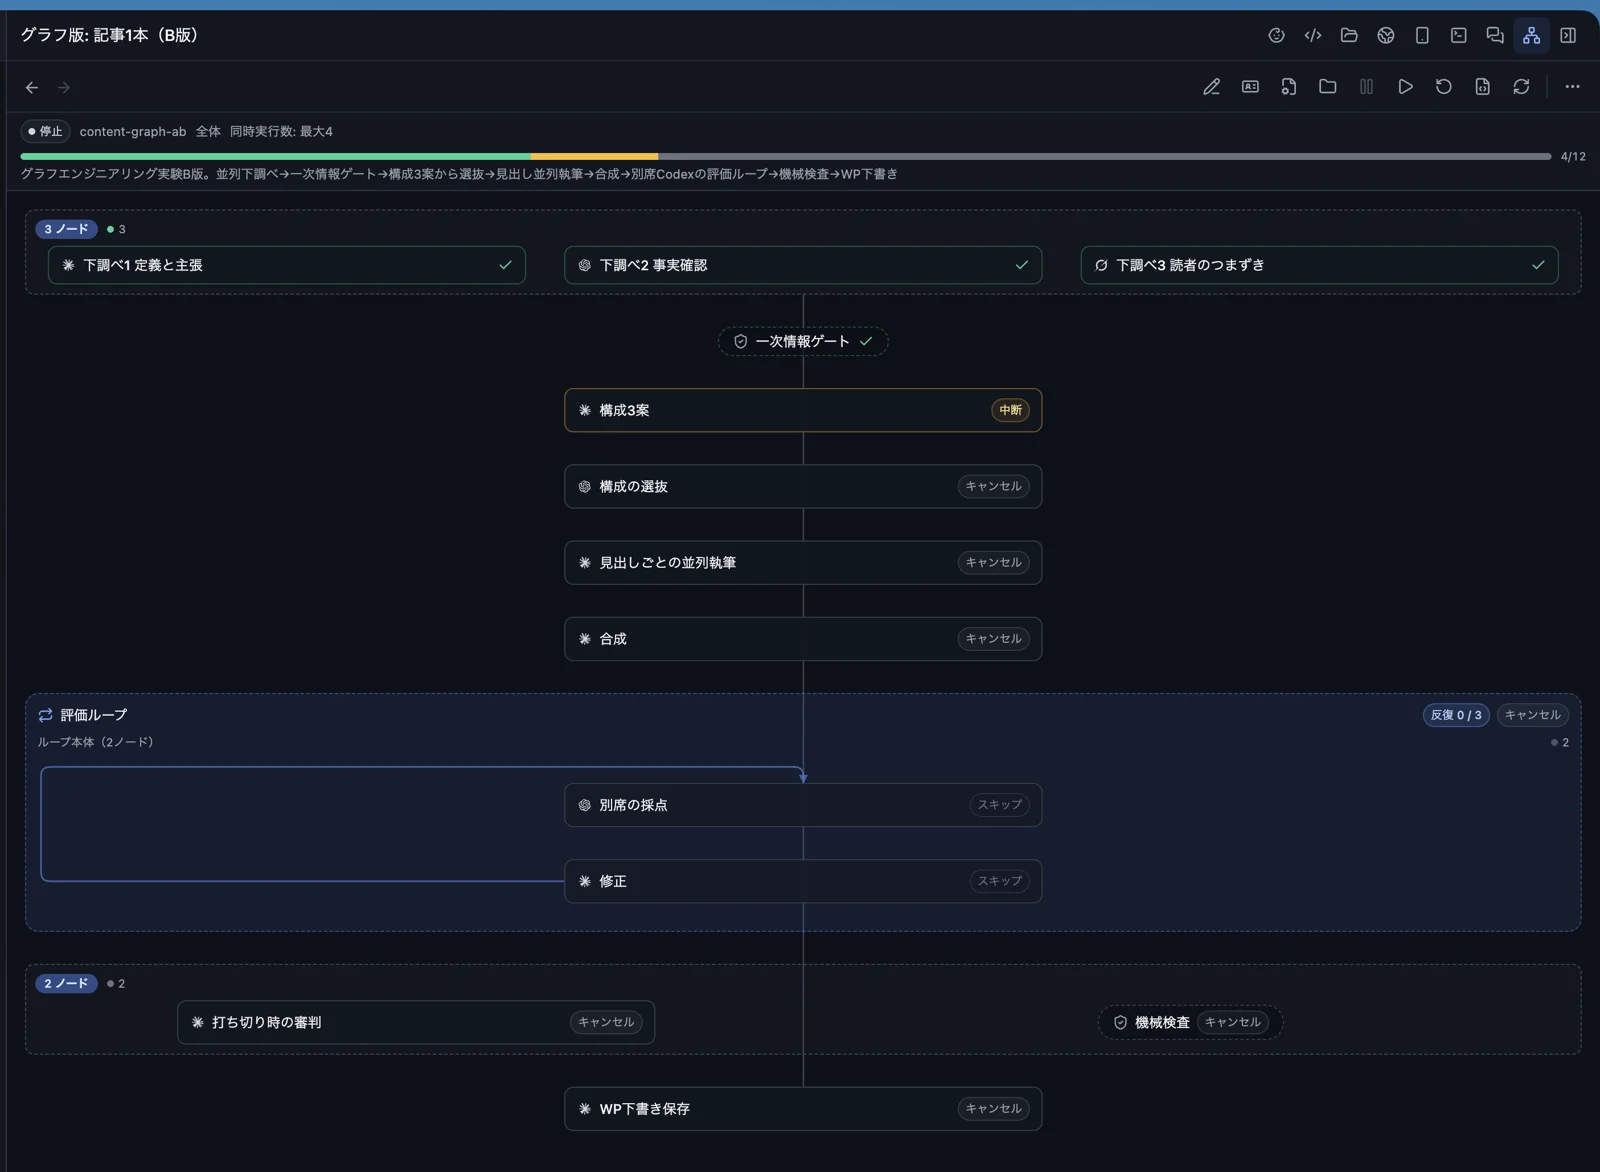
1回目: AIが人間に質問して止まった
構成を作るノードが、途中で確認ダイアログを出しました。誰も見ていなかったので、そこで停止。
原因は単純で、プロンプトに「人に聞くな」と書き忘れていたから。1体で頼むときは自分が見ているので気づきます。
ところが12ノードを裏で走らせると…1ヶ所が人待ちになるだけで全体が止まる。
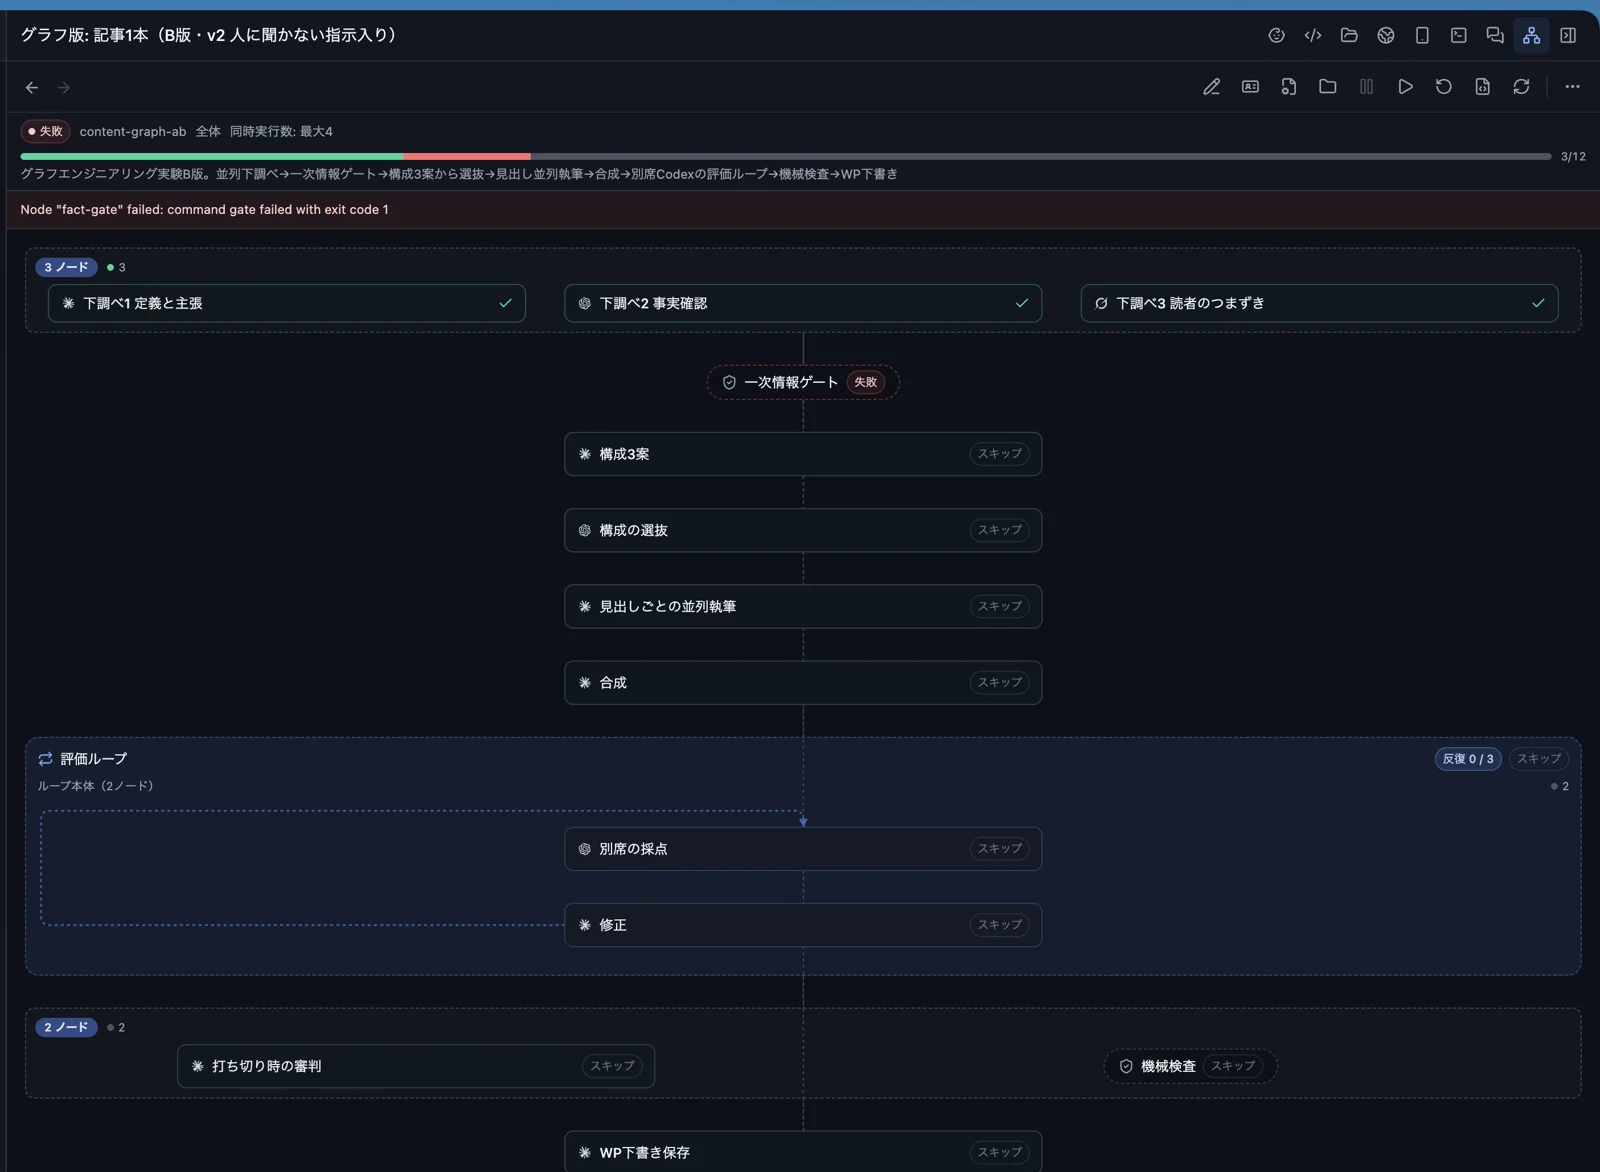
2回目: ゲートが正しく作動して、正しく無駄になった
「原文にない主張が0件でなければ先へ進ませない」というゲートを置きました。
事実照合の担当が「原文に論文名もURLも書かれていない」を7件の欠落として数え、ゲートが止める。動画に論文URLが書かれていないのは当たり前。間違っていたのは私の条件設定でした。
12. 効かなかった部品もある
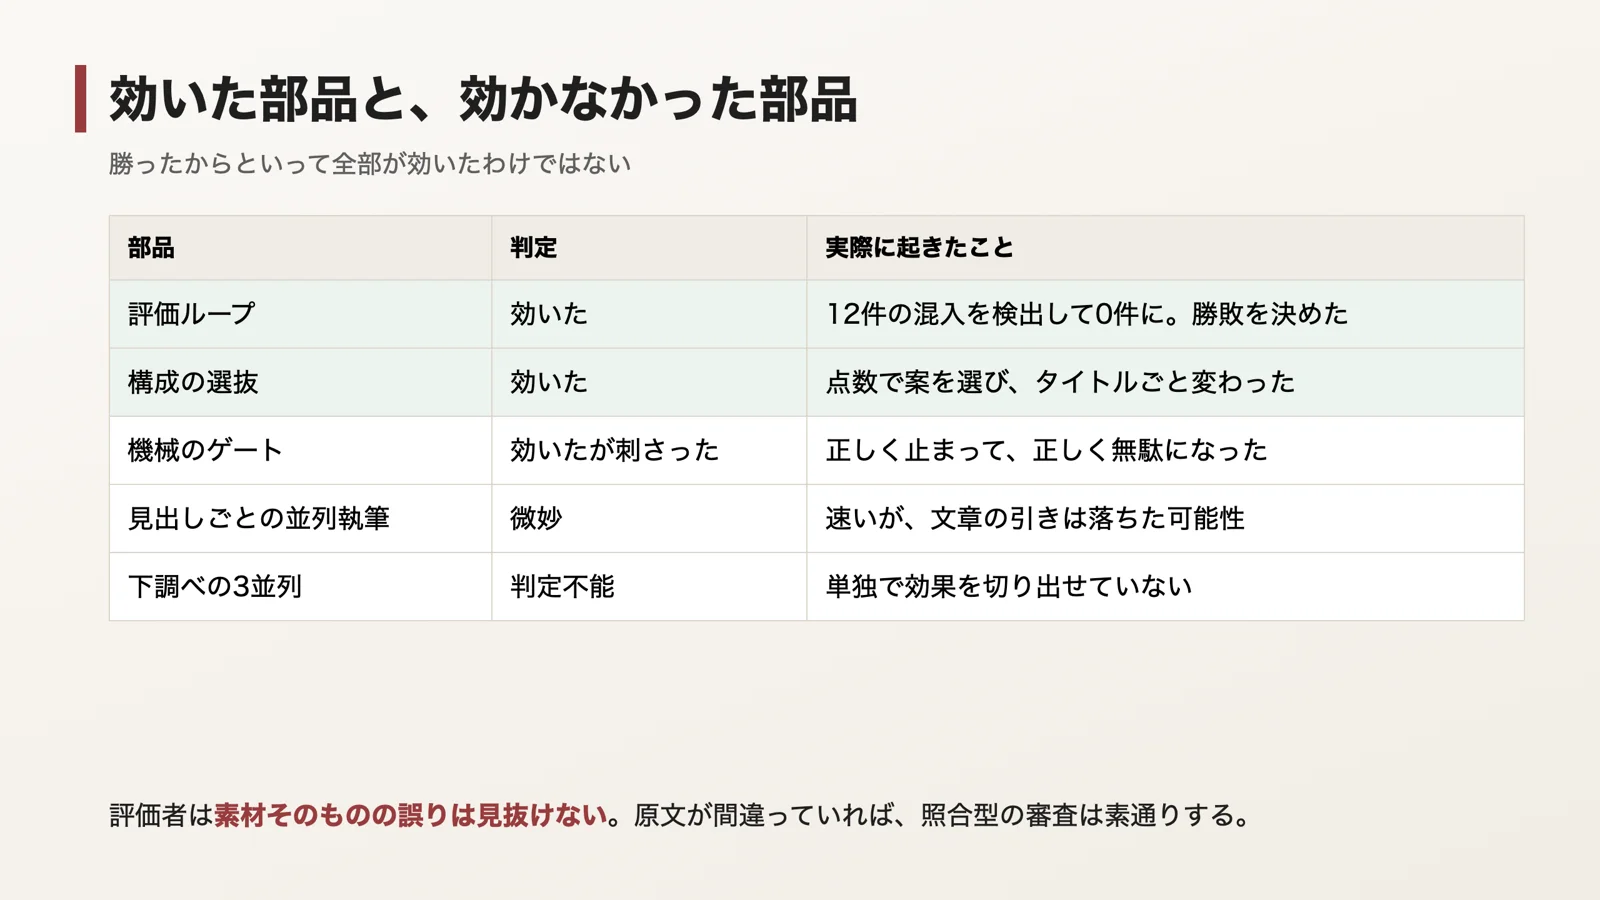
もうひとつ、評価ループがどうしても直せなかったものがあります。B版の本文には、自動字幕が崩れた固有名詞がそのまま残っている。審査員はこう書きました。
文字起こしの崩れをそのまま固有名詞として採用しており、読者に誤った社名を渡すリスクがある(記事2は社名を落として回避)。
採点役は「原文と照合しろ」と指示されているので、原文に書いてある以上は正しいと判定します。
原文そのものが間違っている場合、原文照合型の評価者は素通りさせる。
皮肉なことに、何も考えずに社名を落としたA版のほうが結果的に安全でした。
COLUMN
AIが増えるほど、人の仕事は「どこを見るか」に寄っていく
今回の実験でいちばん意外だったのは、勝敗そのものより、私が何もしていない時間の長さでした。19分50秒のあいだ、12ノードが勝手に動き、採点し、書き直している。その間、私がやったことは…ゼロです。何も見ていません。
かわりに効いたのは、走らせる前に決めたことでした。どこにゲートを置くか。何を0件にしたら進んでいいのか。ループを何周まで許すのか。まあ、全部それだけです。実際、失敗した2回はどちらも「走らせる前の決め方」を間違えていました。動いている最中の話ではありません。
これは分身AIを育てているときの感覚とよく似ています。手を動かす部分を渡すほど、こちらに残るのは「どこで止まってほしいか」を決める仕事になる。止まってほしい場所を決められる人が、いちばん強い。分身AIを触っていても同じことを何度も思います。
逆に言うと、止め方を間違えれば確実に止まる。今回、ゲートが8ノードを巻き添えにして全部スキップさせた画面を見たとき、正直ちょっと笑ってしまいました。機械は言われた通りに止めただけ。悪いのは条件を書いた私のほう。
AIを何体も並べる時代に人がやることは、たぶん増えません。減ります。ただし残った一点の重さは、確実に増していく。そんな実感が残った実験でした。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
13. まとめ
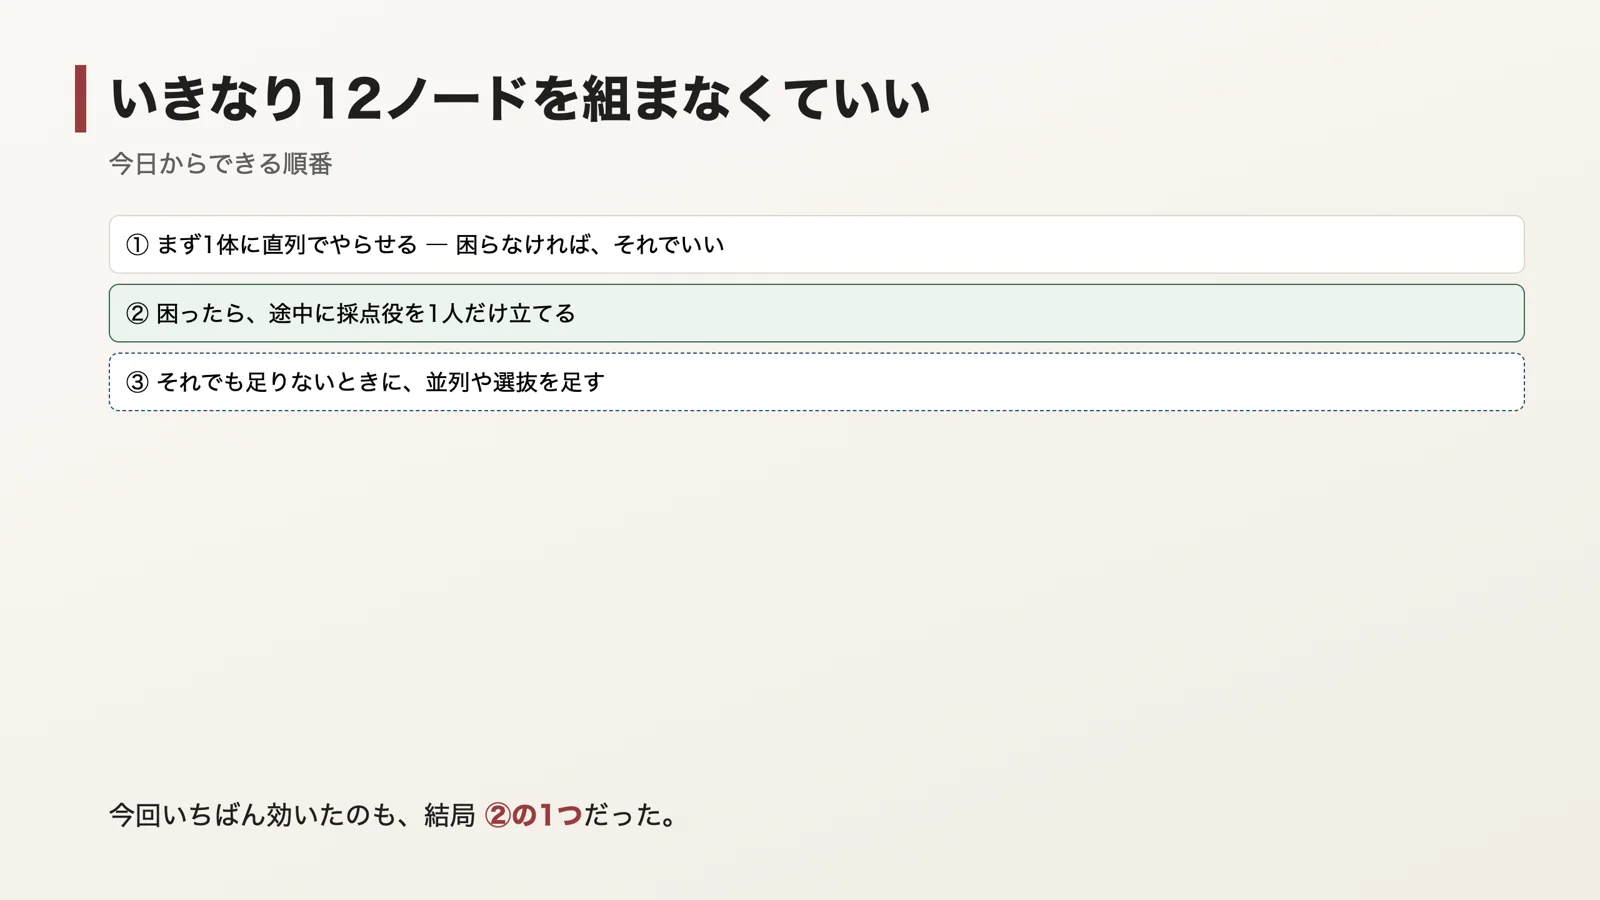
- 評価者を挟むと、もっともらしい混入が実際に減る(評価ループで12件 → 0件。匿名審査でも3席目の採点で7件 → 3件。ただし他の2席は独自提案を含めた数え方で同数でした)
- ただし文章の勢いは落ちうる。読み物としての引きは1体で通すほうが強いことがある
- グラフを複雑にすると、止まる場所も増える。3回走らせて2回は設計ミスで止まりました
- 評価者は、素材そのものの誤りは見抜けない
ここまでが、グラフエンジニアリングをFleetで動かした実験の全記録です。ええ、長くなりました。なんというか、書かせる実験そのものより、止まった2回のほうが学びが多かった気もします。いきなり12ノードを組む必要はありません。まず1体に直列でやらせて、それで困らなければそれでいい。困ったときに、途中に採点役を1人だけ立ててみる。今回いちばん効いたのも、結局その1つでした。
関連記事
共鳴では言葉が湧き、駆け引きでは言葉を選ぶという気づき
手放せなかった理由に気づいた日の記録
動画生成の単価が数百円まで落ちた話
2026年のGoogleランキング要因。AIで量産する時代の信頼の話
この記事で使った動画そのものの解説。用語の意味はこちらが詳しい
承認ボタン一つでAIが動く時代の最新ニュースまとめ
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成・画像制作にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。