WATCH REPORT
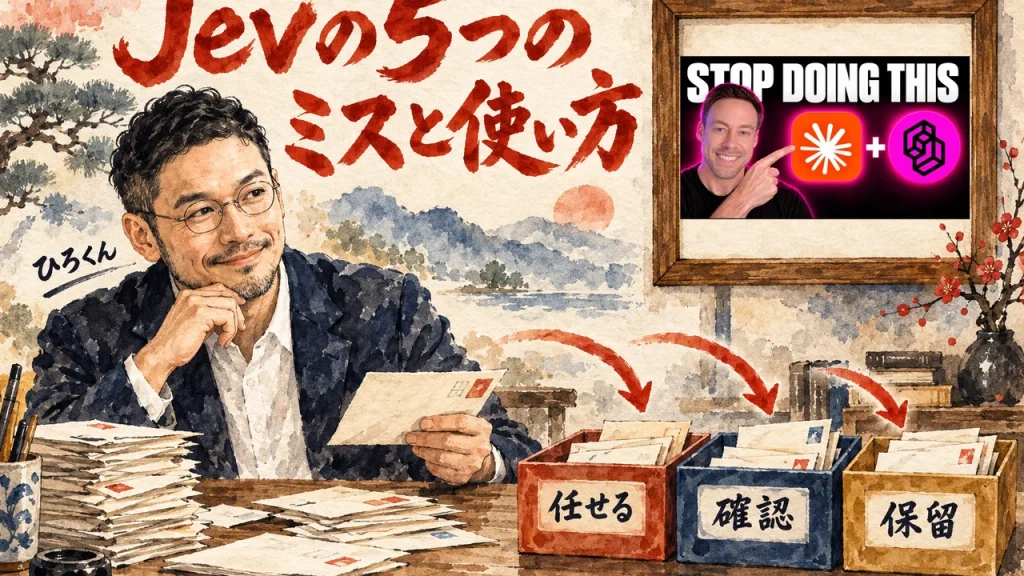
Jevは受信箱の仕分けを任せるAI。
5つのミスと使い方をChase AIさんが解説
2026.10.03
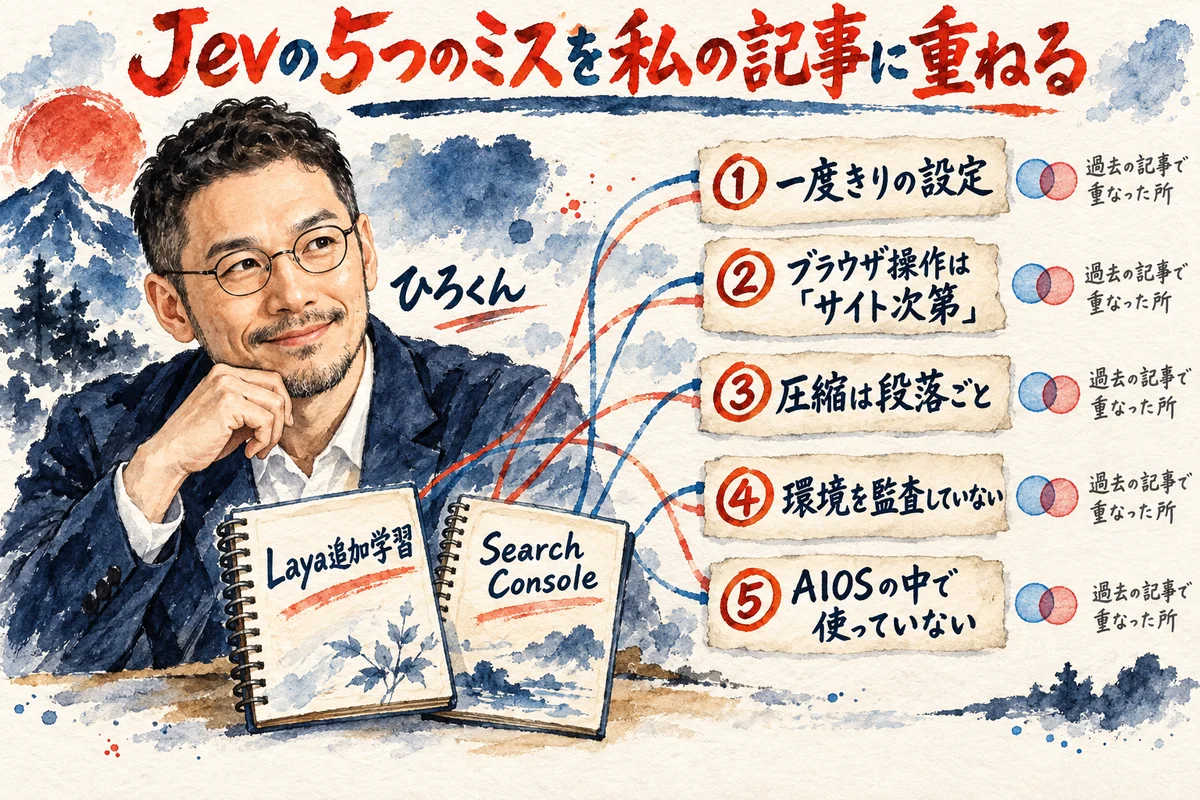
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTubeチャンネル「Chase AI」の動画「You’re Using Jev + Claude Wrong」を紹介するね。Jevは、このブログの前の2本の記事で使ってきた、判断を確率で返すモデルです。動画の5つのミスを、その2本の記事に1つずつ重ねます。当たっていた所と、違った所を並べます。動画の数字は話者自身の環境の実測で、私が再現したものではありません。動画は冒頭で、Jevはチャットボットではなく、文章を返さないモデルだと断ります(0:11)。
テーマは「毎日くり返す小さな判断をJevに任せる時の、5つのミス」。Chase AIさんの図と実測に、私の前の2本の記事(読者の声の仕分け・Search Consoleの意図ずれ)を重ねます。
3行でわかるポイント
- Jevは文章を返さず、確率だけ返す。私が頼んだ読者の声の仕分けで、「この人は満足しているか」を、Jevは38問中38問当てました
- 一度きりにせず、外れた分から直す。私が頼んだ追加学習は、1回目が全部同じ答え(99.2%の落とし穴)。直した2回目も、見逃しが残りました
- 何を見せるかで、判定は変わる。本文の冒頭1,800字だけだと「答えなし」が64本、全体なら35本でした。軽い判定のあと、重い診断へ渡す形は、動画の3段と同じです
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・8,900名突破!)出典: You’re Using Jev + Claude Wrong(Chase AI)
「Jevはチャットボットではない」。文章を返さず、確率だけ返すAIを、私はもう使っていました
動画は、のっけから強い言い方で始まります(0:02)。Chase AIさんは、Jevはここ数週間で世界を席巻した、と言います。OpenAIやAnthropicの最良のものより、約200倍速い、とも。ただし直後に、こう断ります。
Chase AIさん
Jev is not a chatbot. This isn’t something you can just talk to with natural language and get a sentence back.(0:11)
訳: Jevはチャットボットではない。自然言語で話しかけて文章が返ってくるものではない。
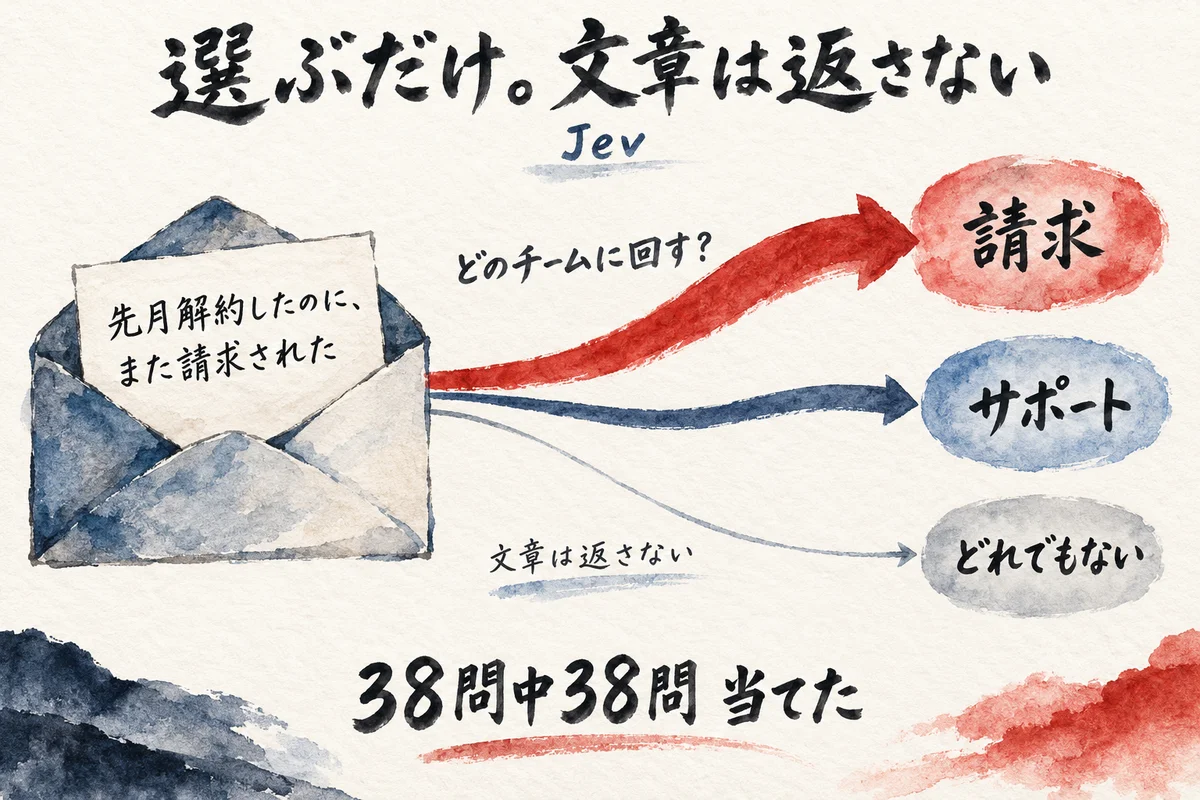
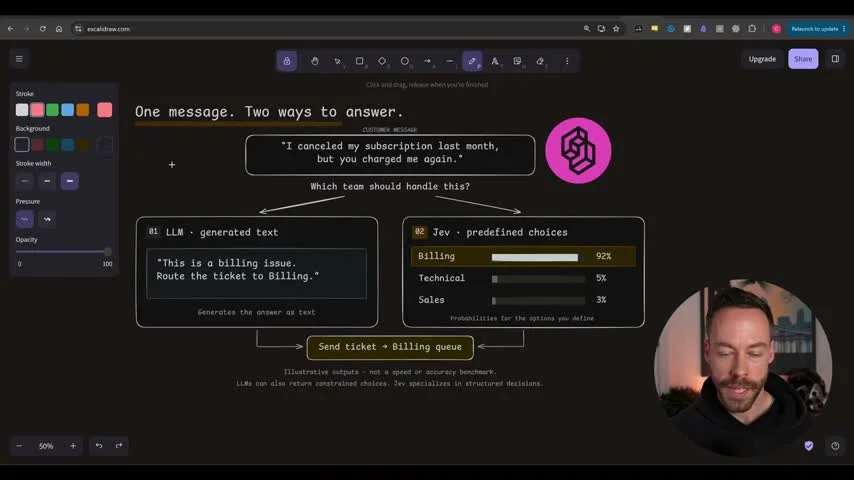
では、何を返すのか。画面の例は、こうです(1:05)。お客さんから「先月解約したのに、また請求された」というメッセージが届きます。どのチームに回しますか、という場面です。
文章で答えるAIは「Billing(請求)チームへ回してください」と返します。Jevは、Billing 92%、Technical 5%、Sales 3%。選択肢ごとの確率だけです。文章は一切返しません。
ここで、私の話を書きます。私はこの「選ぶだけ」の使い方を、もう前の記事でやっています。
たとえば読者の声の仕分けです。私が主催したセミナーのアンケートの自由記入と、ダイエット本の読者からのメルマガ返信、あわせて50件。同じ質問で、Jevに解かせました。
手を動かしたのはAI秘書の凛ちゃんで、私は分担を決めて、確認に答えました。
「この人は満足しているか」は、38問中38問、当たりました。「この人の悩みは何か」は50問中44問。「次に何を勧めるか」は37問中27問です。聞き方は全部、はい・いいえ、どれか1つ、点数のどれかです。
私がJevに頼んできたのは、いつも「どの山に入れる?」という聞き方でした。動画の「文章を返さない」って説明は、この使い方と、ぴったり重なります。
前の記事に、数字を全部並べています(Jev vs Laya の比較記事)。Jevの基本はJevとは何かを書いた回にあります。
山に入れる場面を1つ思い浮かべる 自分の仕事で、届いたものを「この山に入れる」と決めている場面を1つ書き出します。メールの仕分けでも、問い合わせの振り分けでも足ります。3分です。
「小さく繰り返す判断をしている場所はないか」。私の場合、答えは1,714本のブログの中にありました
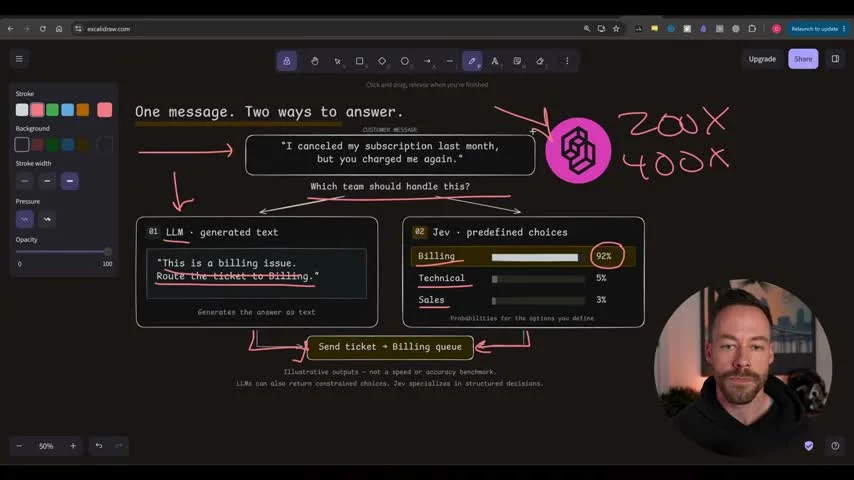
Jevを入れる場所の見つけ方を、Chase AIさんは1つの問いにまとめています(2:40)。自分のワークフローの中に、「小さく繰り返す判断」をしている場所はないか。あるなら、そこにJevを入れるべきだ、という立場です。
動画の例は、受信箱の仕分け。AIニュースの絞り込み。投稿ごとのセカンドオピニオン。どれも、毎日・毎回くり返す判断ですよね。
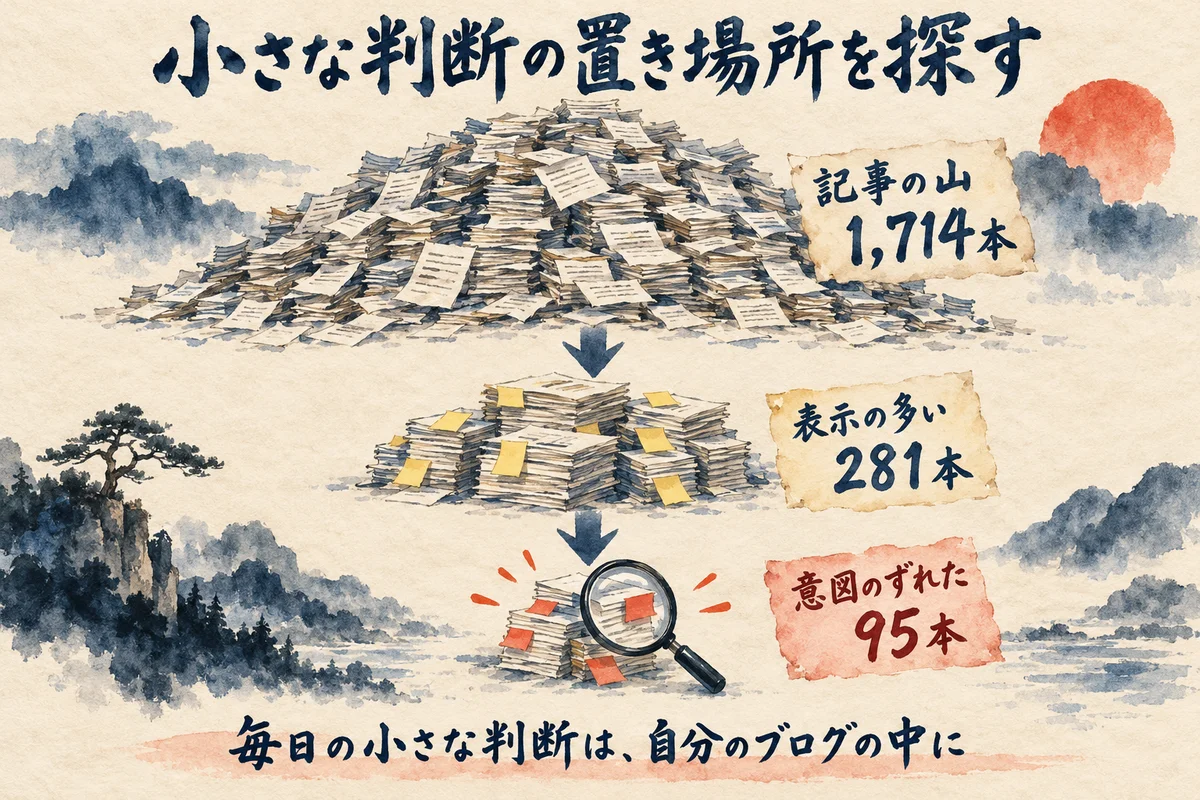
私の場合は、ブログがそうでした。ai-kidou.jp には、公開記事が1,714本あります。Search Console を見ると、検索結果には出ているのに、押されていない記事がありました。
そこで、表示の多い281本に、同じ質問を1本ずつ投げました。「この記事は、検索した人の意図に合っているか」です。答えは、合っている・合っていない。まさに、小さく繰り返す判断ってやつです。
結果は、意図がずれているページが95本。ずれていない側のほうが、押された率は高めでした。順位が5〜12位の153本で、意図に合う記事は2.12%、合わない記事は1.16%です。
ただし相関で、タイトルを変えたら押される、という証明ではありません。
ここまでは、動画の型と同じなんです。違うのは、そのあとでした。95本の直し案をJevに選ばせ、足りない所はAIMHで深く診断して、11本のタイトルを書き換えました。効いたかどうかは10月末の判定待ち。
判定の結果をJevの決まりへ戻す工程は、その記事には書いていません。
この続きは、次の章で出てくる「ループ」の話につながります。
小さな判断を書き出す 自分の1日を思い出して、次の3点を書きます。10分です。
- 毎日くり返している小さな判断を3つ(例: このメールはどの山か)
- それぞれが「はい/いいえ・どれか1つ・点数」のどれで言えるか
- そのうち、外れても被害が小さいものに丸をつける
ミス1「一度きりの設定にしている」。外れた分から決まりを直す。私は、99.2%の落とし穴で学びました
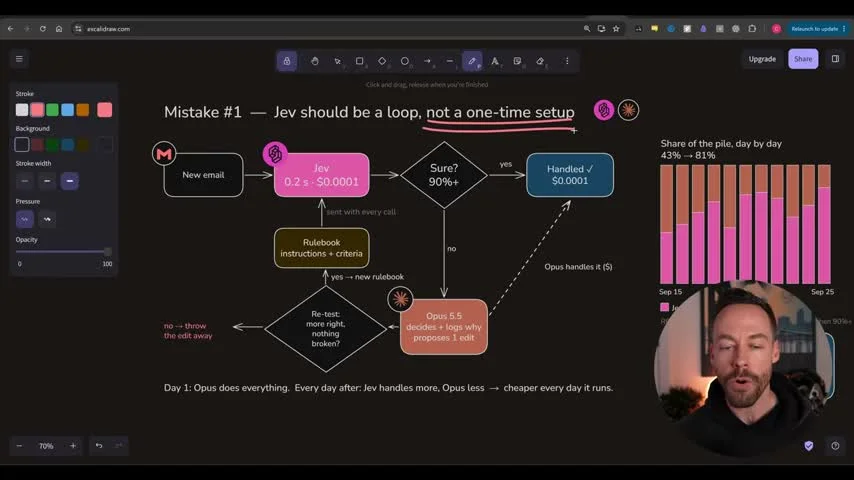
最初のミスです(3:12)。Chase AIさんは、Jevを一度きりの設定にするのではなく、自己改善ループにするべきだ、と言います。やって終わりのものではない、と。
Chase AIさん
So the first mistake you are making with Jev is you are treating this as a one-time setup when instead you should be treating it as a self-improving loop. This is not a oneanddone thing.(3:12)
訳: Jevでの最初のミスは、一度きりの設定として扱っていること。本来は自己改善ループとして扱うべきで、やって終わりのものではない。(字幕の「oneanddone」はそのまま)
図の形はこうです(4:05頃)。新着メールをJevが仕分けます。確信が90%以上なら、そのまま処理済み。足りない件は、Opus 5.5が理由を判断して、Jevに渡す「ルールブック」の修正案を出します。
再テストして、改善していれば採用です。
成果の数字は、受信箱の仕分けでした(4:34)。初日にJevが単独で分類できたのは43%。10日目には81%まで上がり、その分の仕事をOpusから外せた、という説明です。
もう1つ、選択肢の作り方です(6:24)。
Chase AIさん
I pretty much always give it an option of none of these. This way it always has an out in case whatever decision you’re having it try to make it’s just like none of these options fit.(6:24)
訳: 私はほぼ必ず「どれでもない」という選択肢を入れる。そうすれば、どの選択肢も合わない時の逃げ道ができる。
さて、私も「外れた分から直す」をやりました。私のMacで、オープンのLayaを追加学習して、Jevの代わりになるか試した時のことです。動画を送って頼んだのは私で、実際に回してくれたのはAI秘書の凛ちゃんでした。
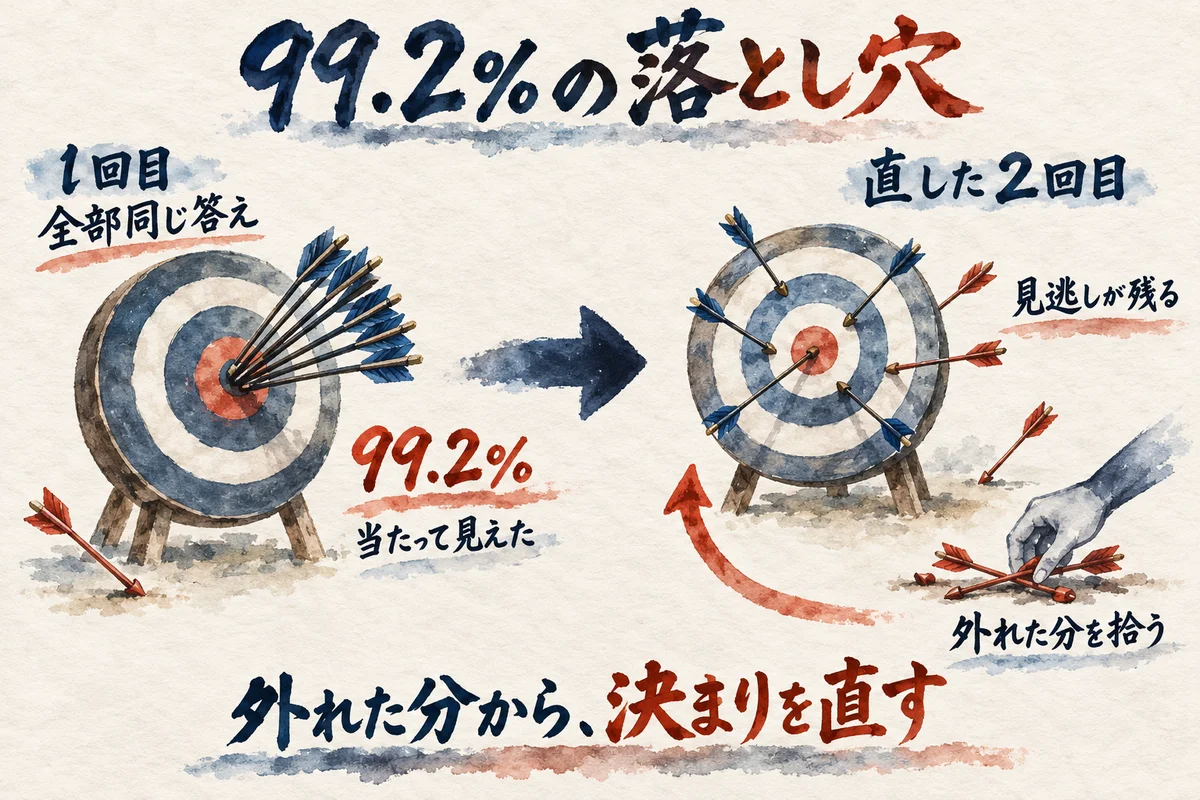
1回目の結果は、2,566章すべてに同じ答え。正解率だけ見ると、76%から99%に伸びたように見えました。
でも、落とし穴でした。Jevが「出し惜しみあり」と判定した章は、2,566章のうち21章だけ。何も読まずに全部「いいえ」と書けば、99.2%当たる試験だったんです。
外れた分を見て、直すと決めたのは私です。直してくれたのはAI秘書の凛ちゃんで、中身はこうです。「はい」が少ない側の例を7倍に増やす。学習の強さを1回目の5分の1にする。1周ごとに保存して、確認用データで一番よい周を採用する。
2回目は、答えの種類が1つから7つに増えて、張り付きは消えました。でも、見逃しは残りました。呼びかけがある394章のうち208章、出し惜しみ21章のうち17章です。
動画のループと、形は同じです。外れた分を見て、決まりを直して、もう一度測る。違うのは、動画が「ルールブック」を直すのに対して、私は学習そのものをやり直したところです。
だから「43%から81%」という数字は、先にこう確かめる必要があります。81%は、何を数えた81%なのか。全部同じ答えで何%当たる試験なのか。それを先に計算しないと、数字にだまされるってことです。
ループの最初の1周を決める さっき選んだ判断について、「外れた件を、誰がどこに溜めるか」を1行で決めます。それから、正解率を見る前に「全部同じ答えで何%当たるか」を1回だけ計算します。10分です。
ミス2・ミス3。ブラウザ操作は「サイト次第」、圧縮は「段落ごとに残すか捨てるか」。どちらも、何を見せるかの話でした
2つ目のミスは、ブラウザの自動操作を、どのサイトでも同じ分担にしていることです(8:01)。動画では、同じ作業を3通りの分担で走らせて、結果を並べていました(11:04頃)。
いちばん単純なToDoアプリでは、「Opusが一度だけ計画して、Jevが実行する」形が最速でした。12.9秒・1ターンです。Opusが全部の操作をする形は21.6秒・8ターンでした。
ところが、Google Flights(Austinからニューヨークの検索)では逆でした。Opusが全部操作すると、67.4秒・36ターン。「Opusとループで、Jevがクリックする」形は、50.2秒・12ターン。
一度だけ計画する形は、4回やって0回、途中で詰まりました。
結論は、サイトの複雑さ次第、です。ポップアップや日付ピッカーが突然出るサイトは、ループのほうが強い。Chase AIさん自身、現実の多くは雑多なほうで、ループが基本だ、と言っています(10:43)。
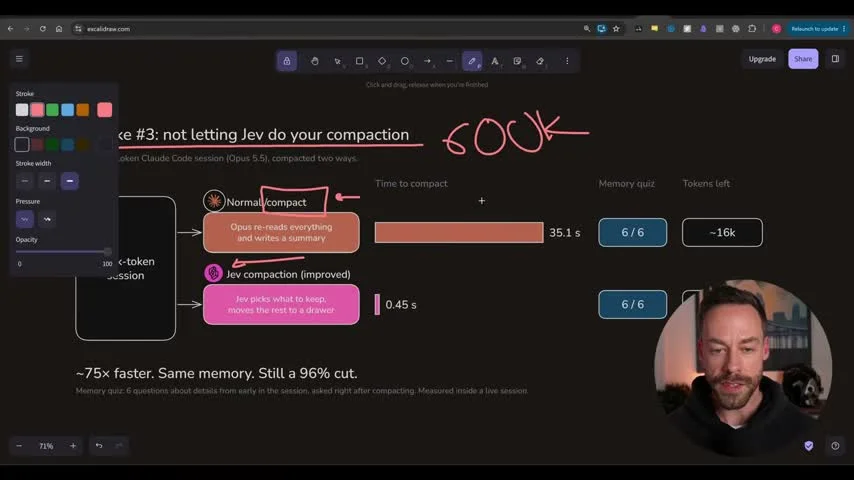
3つ目のミスは、圧縮(compaction)をJevに任せていないことです(11:14)。約60万トークンの会話を、普通の /compact で縮めると35秒。Jevを使った版は、0.45秒でした(12:03)。
やり方は、こうです。要約するのではなく、会話を段落ごとに「今後に関係あるか」とJevに聞いて、Yes/Noで残します。捨てた分は、ディスクに保存します。記憶クイズの結果は同じ6問中6問。
ただし、次の会話は約26,000トークンから始まります。普通の圧縮は約16,000です。
この2つに共通するのは、「何を見せるか」で結果が変わる、という点でした。そして、私もそこで失敗しています。
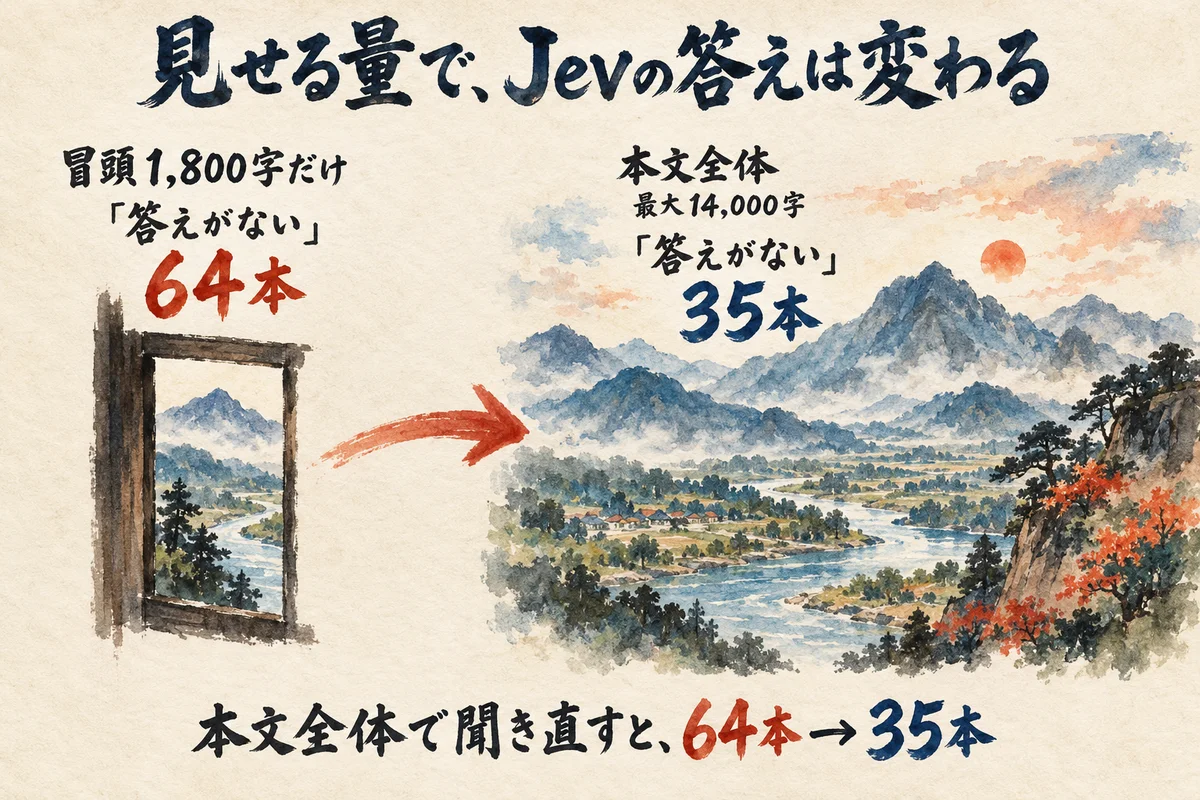
95本の直し案をJevに選ばせた時のことです。「本文に、検索の答えがあるか」を聞く時、本文の冒頭1,800字だけで聞くと、「答えがない」が64本でした。本文全体(最大14,000字)で聞き直すと、35本。
冒頭だけで判定すると、答えが後ろにある記事まで「答えなし」にしてしまうってことです。効いていたのは判定の腕ではなくて、渡し方だったってことです。
圧縮も同じです。段落ごとに残すか捨てるかを決める時、Jevに何を見せるかで、残るものが変わります。
見せる範囲を1つ決める AIに判定させている作業を1つ選んで、「冒頭だけ見せている」のか「全体を見せている」のかを確かめます。冒頭だけなら、全体で1件だけ聞き直して、答えが変わるかを見ます。10分です。
ミス4「自分の環境を監査していない」。動画はClaudeに探させ、私は分担を決めました
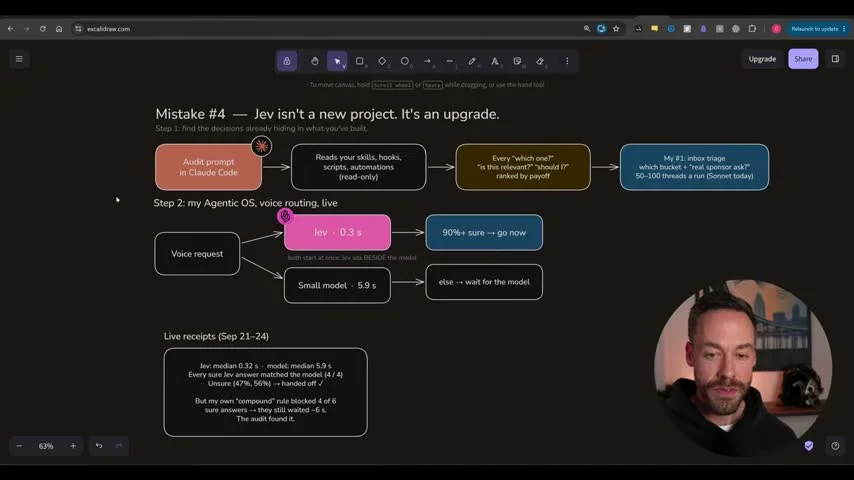
4つ目は、Chase AIさんが「いちばん大事」って言うミスです(13:50)。自分の環境を監査していない、ということ。
やり方は、Claudeに監査プロンプトを渡すことです。画面に出た指示は、5つの手順でした(14:24)。
画面に出た、監査プロンプトの手順 Claude Codeに貼る形で、こう書かれていました。
- 持っているスキル・コマンド・フック・スクリプトなどを、読み取り専用で全部読む
- 「どれにする?」「関係ある?」「やるべき?」型の判断を探す
- 各判断に、場所・判断・誰が決めるか・質問の種類・選択肢(いつも「none of these」つき)・しきい値を書く
- Jevに向かないものを外す
- 頻度で順位をつける
Chase AIさん
I can guarantee there is some sort of project, some sort of workflow that you already use that could 100% use Jev.(14:03)
訳: すでに使っているどこかのプロジェクトやワークフローに、Jevを100%使える所があると保証できる。
候補表も映っていました(15:11)。1位はメールの仕分け(1回に50〜100通)。次が、AIニュースの絞り込み(1日100件以上)。セカンドオピニオン(投稿ごと)。バックグラウンド作業の成功判定。
カルーセル案選び(週150件以上)です。
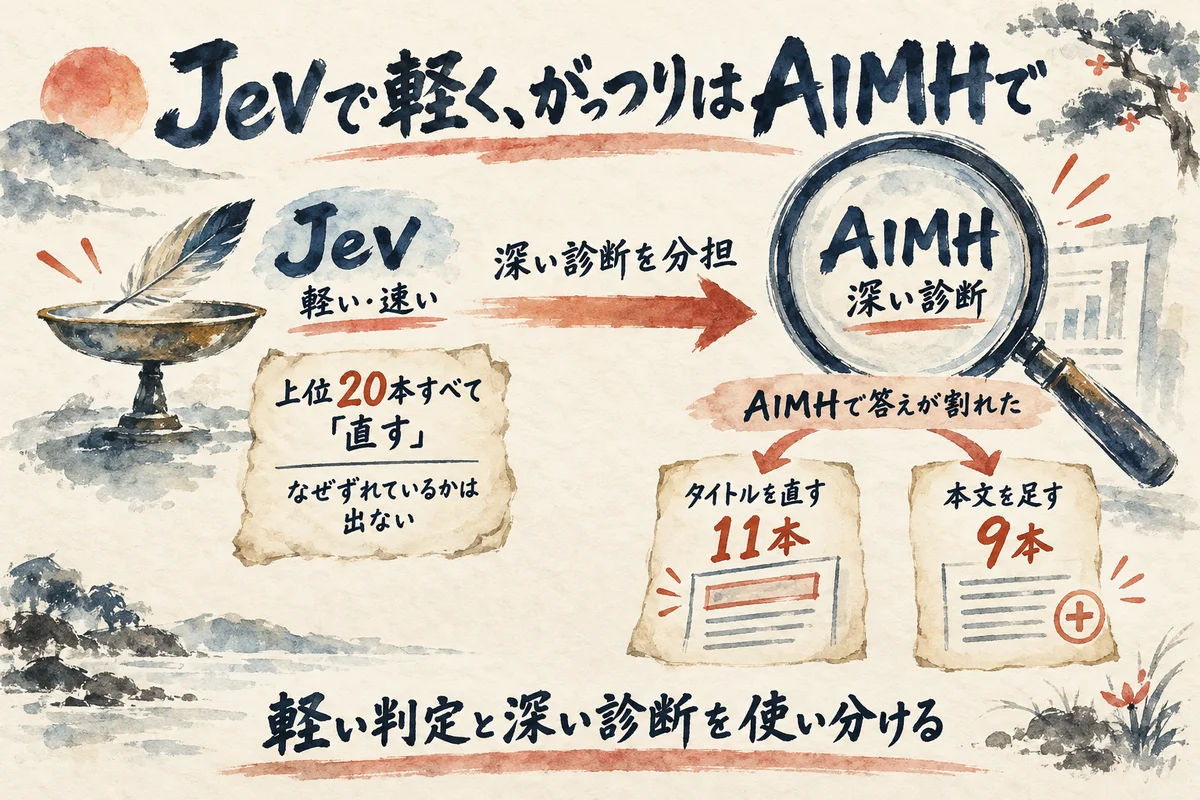
私の場合は、軽い判定だけでは足りませんでした。「Jevで軽く、がっつりはAIMHで」という分担を、私が決めました。
理由は、Jevだけでは足りなかったからです。Jevは速い。でも、「なぜずれているか」「記事に何が足りないか」までは出ません。実際、Jevは上位20本をすべて「直す」に入れていました。
AIMH(マーケティングの手順書)を通すと、答えが割れました。タイトルを直せば答えられるのが11本。記事に答えが無い・弱いので、先に本文を足すのが9本です。
動画のやり方なら、最初にClaudeが環境を監査して、Jevを入れる場所を出してくれます。私のやり方は、私が分担を決めて、AI秘書の凛ちゃんからの確認に答える形でした。どちらが上、という話ではありません。
ただ、動画の監査と私とで、並べ方が違います。動画は、頻度で順位をつけます。私は、表示回数の多い順に281本を選びました。
動画の画面には、監査で見つかった話も出ていました(14:00頃)。話者自身の「compound」というルールが、確信のある6件のうち4件を止めて、約6秒待たせていた、という実測です。
優先順位を頻度で並べる さっき書き出した小さな判断を、「1日に何回くり返すか」で並べ替えます。1位の1つだけを、今週のJevの候補にします。5分です。
ミス5「AIOSの中でJevを使っていない」。3段の仕分けは、私の「軽い判定→重い診断」と同じ形でした
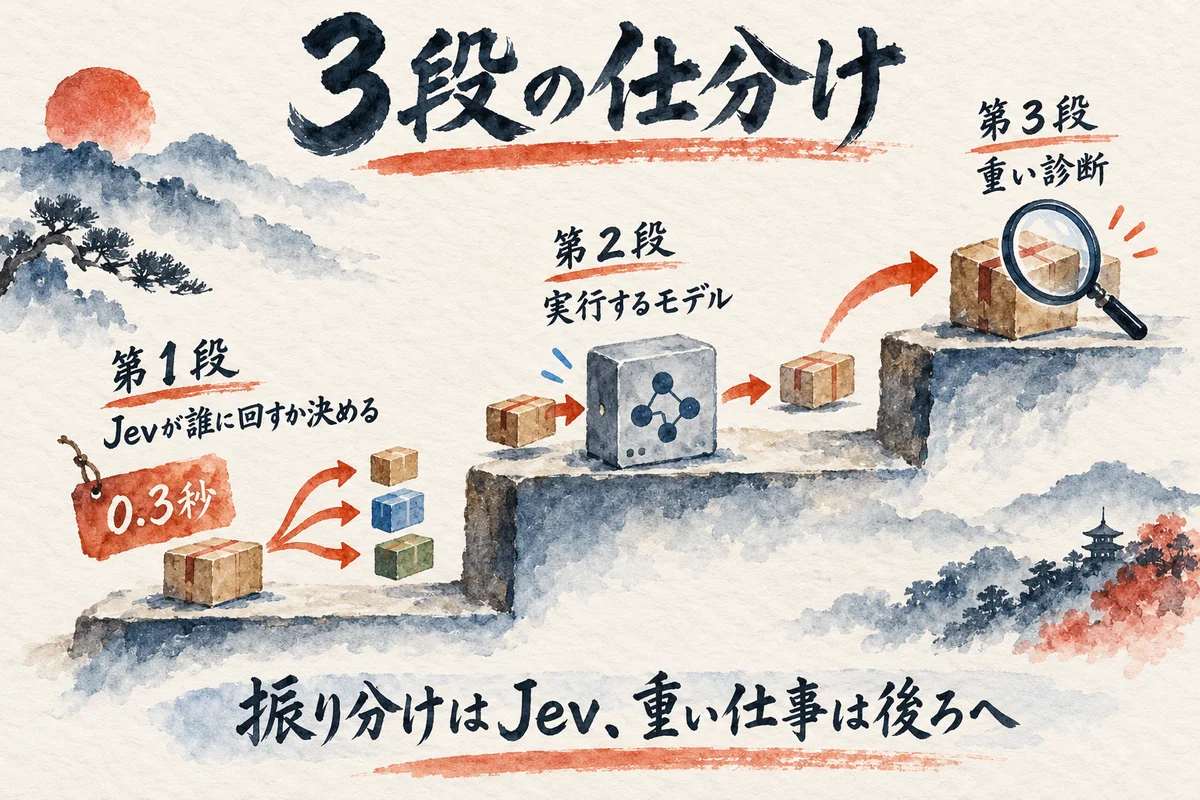
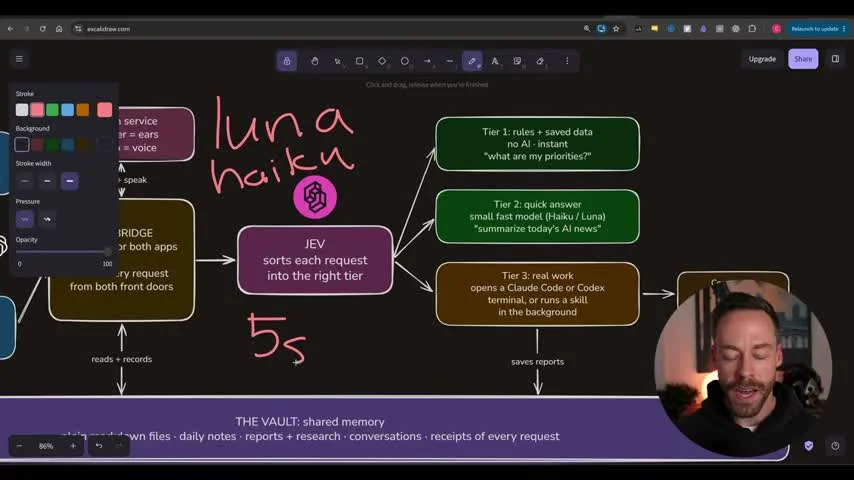
5つ目は、話者が自分で組んだ司令塔(AIOS)の話です(15:13)。声で指示すると、どのモデルに仕事を振るかを決める仕組みです。
今までは、小さなモデル(画面にはHaikuとLuna)が振り分けていました。動画では、場合によっては最大5秒かかっていたそうです(16:19)。画面の手書きは「5s → .3s」。Jevに替えると、0.3秒です。
全体の設計は、3段です(16:35)。1段目は、ルールと保存データで済む依頼。AIは呼びません。2段目は、小さく速いモデルで済む依頼。3段目が、Claude CodeやCodexを開く実作業です。
Jevの役割を、Chase AIさんはこう言い切ります(17:19)。
Chase AIさん
It’s not the executor, right? Jev is going to push things to claude. It’s going to push things to open AAI where it can then execute. But the decision about what we should execute and who should do the executing is something we can offload to Jev.(17:19)
訳: Jevは実行者ではない。Claudeやopen AIに仕事を渡す側で、何を実行し誰に実行させるかの判断を任せられる。(字幕の「open AAI」はそのまま)
実行はしない。誰に実行させるかを決める。私の記事にも、この3段の形があります。
Gensparkの会議メモの記事です。いちばん多い検索語は「aiミーティングノート 公開 genspark 勝手に」で、90日で444回表示されて、クリックは0。Jevは「本文に答えがない」と判定するところまででした。
そこで重い診断(AIMH)に渡すと、検索した人が知りたいのは「会議メモが勝手に共有されるのは、どんな時か。どう止めるか」だと分解されました。Genspark公式ヘルプに、自動共有(Auto-share)の設定があることも見つかりました。
AI秘書の凛ちゃんも、公式ページを直接開いて確かめています。「自動共有を有効にすると、会議終了後すぐに議事録が自動的にすべての参加者にメールで送信されます」とありました。この話が、私のブログには無かったんですよね。
だからタイトルより先に、記事へ説明を足すってことになりました。
形は、動画の3段と同じです。軽い判定が、「ここは自分の守備範囲ではない」と見分けて、重い道具へ渡す。違うのは、動画のJevが「誰に実行させるか」を決めるのに対して、私のJevは「答えがあるか」を判定して止まるところ。
渡す先も、実行役ではなく、診断役でした。
私は2026年7月19日に、AIのモデルに縛られないことを発信したい、と話しています。最新のモデルが並んでも、本質は原液だ、という話です。
3段の図で残るのは、器(実行するモデル)が替わっても、「誰に何を渡すか」の判断のほうだ、という点です。
依頼を3段に仕分ける 自分がAIに頼んでいる依頼を5つ書いて、「ルールで済む」「小さなモデルで済む」「実作業が要る」の3つに仕分けます。10分です。実作業に残る割合を見ます。
動画の数字を読む前に確かめたい3点。私はまだ手元で再現していません
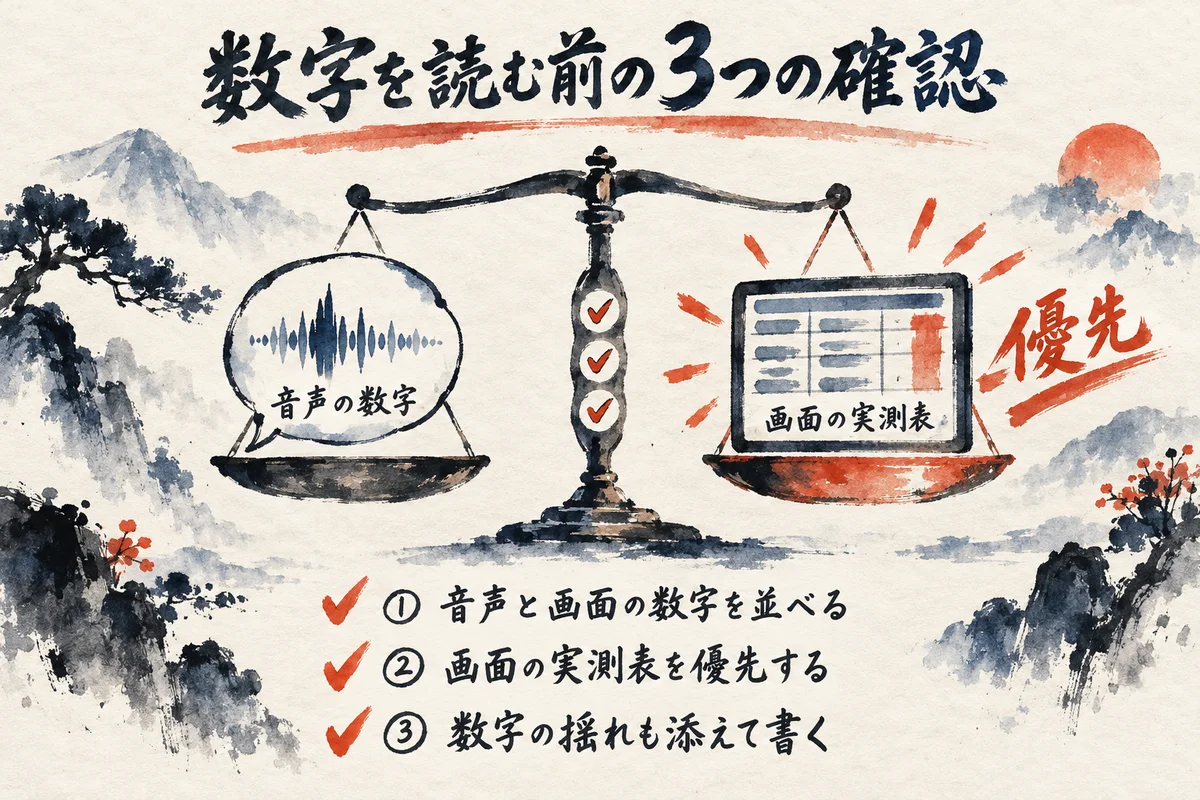
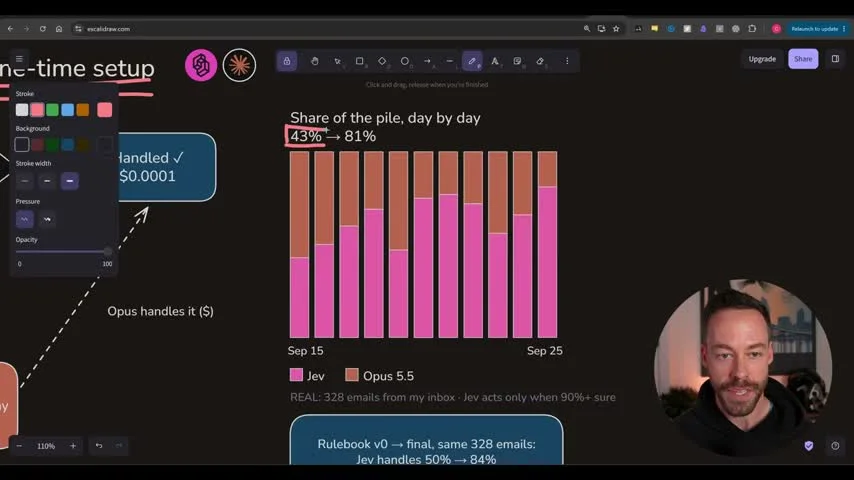
最後のまとめで、Chase AIさんは、根っこは「Jevが何をして、何をしないかの誤解」だと結びます(17:45)。ここまで書いた動画の数字は、話者自身の環境の実測です。私が再現した数字ではありません。
動画の中には、音声と画面で、数字が揺れる所がありました。字幕と画面を照らし合わせると、ずれが3点ありました。
音声と画面の揺れ 字幕と画面を照らし合わせて、確かめた箇所です。
- 速さの倍率: 音声は「約200倍」。画面のTypeSafeのサイトには「193.6x Faster」とあります
- 仕分けの割合: 音声は「初日43%、10日目81%」。画面には、Sep 15〜25(11日分)の棒グラフ(43%→81%)があり、音声の「10日目」とは1日ずれて見えます。さらに「Rulebook v0 → final, same 328 emails」の文字と並んで、「Jev handles 50% → 84%」という別の数字もあります。ルールブックの初版と最終版を、同じ328通で比べた数字だと思います(推測)
- モデル振り分けの速さ: 字幕は「up to 5 seconds」「tenth of a second」「like 5 seconds to like 3 seconds」で揺れます。画面の手書きは「5s → .3s」、実測表の中央値は5.9秒と0.32秒です
数字が揺れていても、話者が嘘を言っているとは限りません。話しながら図を見ている動画では、よくあることです。ただ、自分の記事や報告に数字を写すなら、音声ではなく画面の実測表を優先して、揺れも添えて書く。この記事では、そうしています。
私が確かめていないことを、はっきり書いておきます。Jevの速さと精度、ループで43%が81%になること、圧縮の35秒と0.45秒、モデル振り分けの0.32秒。どれも、こちらでJevを呼んで再現した値ではありません。
前の記事に書いたのは、AI秘書の凛ちゃんに頼んで回してもらった実測で、動画の5つのミスを私が試したものではありません。
動画の数字を写す前に画面を見る 動画の数字を、自分の報告や記事に写すときは、音声と画面の両方を見ます。揺れがあれば、画面の実測を使って、揺れも添えます。5分です。
よくある質問
Q. Jevは、ChatGPTやClaudeのようなチャットのAIと何が違いますか?
A. 動画では、Jevは文章を返さず、選択肢ごとの確率だけを返すモデルだと説明されています。文章を作る道具ではなく、「どの山に入れるか」を決める道具です。公式ブログの本文は「fast, structured decisions that software can use directly」と書いていました。
Q. どんな判断にJevが向いていますか?
A. 動画では「小さく繰り返す判断」です。画面にあったJevの答え方の型は、はい/いいえ、どれか1つを選ぶ、点数をつける、の3種類でした。自分の判断がこの型で言えるかが目安になります。話者の例は、メールの仕分け、AIニュースの絞り込み、モデルの振り分けです。
Q. Jevはどこで手に入りますか?
A. 動画の説明では、TypeSafeのAPI(ウェイトリストがまだあるかもしれない、と話者)かOpenRouterです。私の前の記事では、Vercel AI Gateway経由で呼んでいます。いずれも、私が動画の5つのミスを試した話ではありません。
Q. 動画の数字は、そのまま信じてよいですか?
A. 動画の数字は、Chase AIさん自身の環境での実測です。音声と画面で数字が揺れる所もありました(約200倍と193.6倍、43%→81%と同じ328通での50%→84%、など)。写すなら画面の実測表を優先して、揺れも添えるのが安全です。
Q. この記事の筆者は、5つのミスを自分の環境で試しましたか?
A. いいえ。前の記事に書いたのは、AI秘書の凛ちゃんに頼んで回してもらった、読者の声の仕分け・ブログ全記事の監査・検索意図のずれた記事のふるい分けです(クラウドのJevを使った形)。5つのミスは、動画の内容を整理した紹介で、私の検証ではありません。
まとめ。次の一歩は、毎日くり返す小さな判断を1つ選んで、「どれでもない」を足すこと
この動画の持ち帰りは、3つです。
1つ目。Jevは文章を返さず確率だけ返すから、「小さく繰り返す判断」にだけ入れる。私の読者の声の仕分けは、まさにその形でした。
2つ目。一度きりにしない。外れた分を見て、決まりを直して、もう一度測る。その時、正解率より先に「全部同じ答えで何%当たる試験か」を計算します。99.2%の落とし穴で、私はそれを学びました。
3つ目。判定に何を見せるかで、答えは変わる。冒頭1,800字だけで判定して「答えなし」が64本、全体を見せたら35本でした。軽い判定のあとに重い診断へ渡す形は、動画の3段と同じです。
5つのミスを全部やる必要はありません。今日は、どれか1つで十分です。それでいいんです!
あなたが毎日くり返している小さな判断のうち、外れても被害が小さいものは、どれですか?
COLUMN
手を動かしたのは凛ちゃん。私がしたのは、選ぶことでした
この動画の5つのミスを、私の前の2本の記事に1つずつ重ねてあります。2本とも、手を動かしたのはAI秘書の凛ちゃんです。私がしたのは、選ぶことでした。
Layaを試した時は、動画を送りました。そして、「追加学習を1回試す」「直してもう1回学習する」を選びました。Search Consoleの時は、「Jevで軽く、がっつりはAIMHで」という分担を決めて、11本のタイトルを書き換えるGOを出しました。2026年9月23日の夜です。
動画の5つのミスも、結局は「何をJevに渡して、何を自分が持つか」の話に見えます。小さく繰り返す判断は、渡す。外れた分の直しは、決まりへ戻す。何を見せるかは、渡す側が決める。
私の側に残っているのは、選ぶ仕事です。どこで「追加学習を試す」と決めるのか。どこで「直してもう1回」と決めるのか。そこは、まだ私が持っています。
私には、手放さないと決めているものがあります。2026年7月27日に「よい」の身体ゲートとして言葉にしました。外部の正しさや整った理屈より先に、自分の体が違和感ないかを確かめる。AIや人へ実行を委ねても、このゲートは私に残ります。
Jevが返せるのは、はい・いいえ、どれか1つ、点数です。動画の言い方なら、Jevは実行者ではなく、誰に実行させるかを決める役。私の線の引き方と、近い形です。LayaとJevの比較の結論も、全部を1つに寄せず「使い分け」でした。精度が要る仕分けはJev、文章を外に出したくない場面はLaya、です。
AIへ委ねる側の話は、分身AI日記の「Codexに5回却下されて気づいた、「賢いAI」より「委ねるAI」だった話」にも書いています。
👉 分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
関連記事
Jevそのものの説明の回です。今回の動画を見る前の入口になります
判定専用のJevで表示の多い281本をふるい、引っかかった記事だけを深く診断した記録です
読者の声50件の仕分けで、JevとLayaを比べた実験の記録です
別の動画のJevの主張を、手元で確かめた回です
参考リンク
今回紹介した動画本編
動画の最後に映る、Jevを出しているTypeSafe AIの公式ブログです
今回の動画を出しているチャンネルです
📺 今回紹介した動画
| タイトル | You’re Using Jev + Claude Wrong |
| チャンネル | Chase AI |
| 公開日 | 2026年10月2日 |
| 長さ | 18分42秒 |
| URL | https://www.youtube.com/watch?v=1M-z8O29ML8 |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!