WATCH REPORT
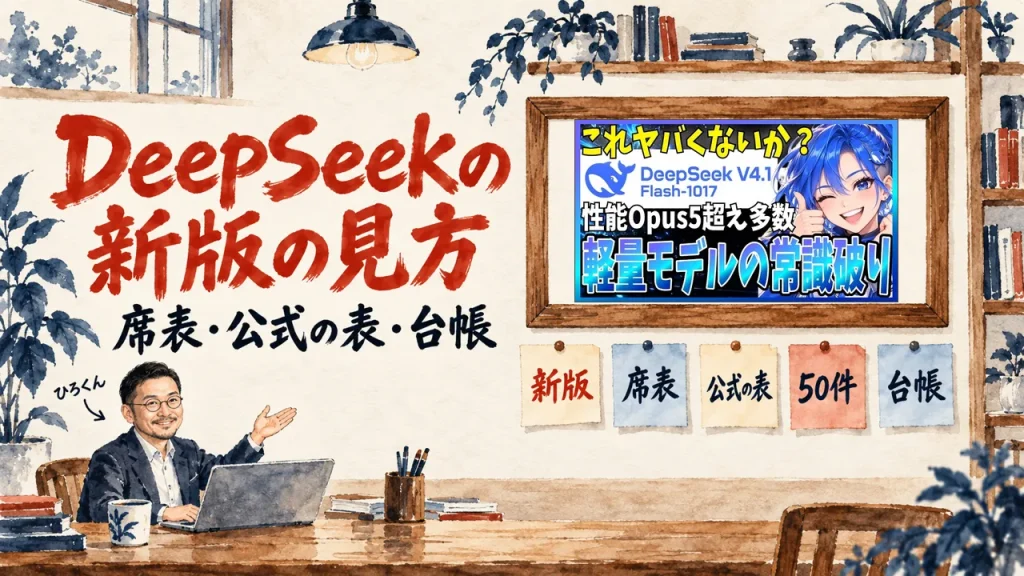
DeepSeek V4.1 Flashの新版は、前の版から何が変わったか
2026.10.18
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル まさおAIじっくり解説ch で、まさおさんが、DeepSeek V4.1 Flash の 1017版を、公式の表とデモで見せながら解説する動画を紹介します。
新しいモデルが出るたびに、どこまで本気で受け取ればいいのか迷う。けれど、解説動画を通しで見る時間はない。そんな個人事業主や、小さな会社の経営者に向けて書きました。
約13分の動画で、まさおさんが DeepSeek V4.1 Flash の 1017版を、公式の表とデモの画面で見せながら、Opus 5 の約60分の1の費用で戦える、重みも公開されている、と解説します。話は、新版の登場、ベンチマークの表、費用の比較、重みの公開、デモの見た目、締めの速度感へと進みます。
読み終えると、前の版から何が変わったかを、動画の筋道どおりに追えます。公式の表や費用の差を、どの条件の数字として読めばいいかも見えてくるはず。その横に、私の場面と、私ならこう見る、を添えました。
SPEAKER
まさおさん
YouTube のチャンネル まさおAIじっくり解説ch の動画で話している人です。この動画では、DeepSeek V4.1 Flash の 1017版について、公式の発表の表と、自分で動かしたデモの画面を見せながら、前の版や Opus 5 と比べて話します。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)
新しいモデルが出るたびに、どこまで本気で受け取ればいいのか。迷いませんか?この動画は、新版が登場したところから始まります。まずは公式の発表と、まさおさんの体感の順に追っていきます。
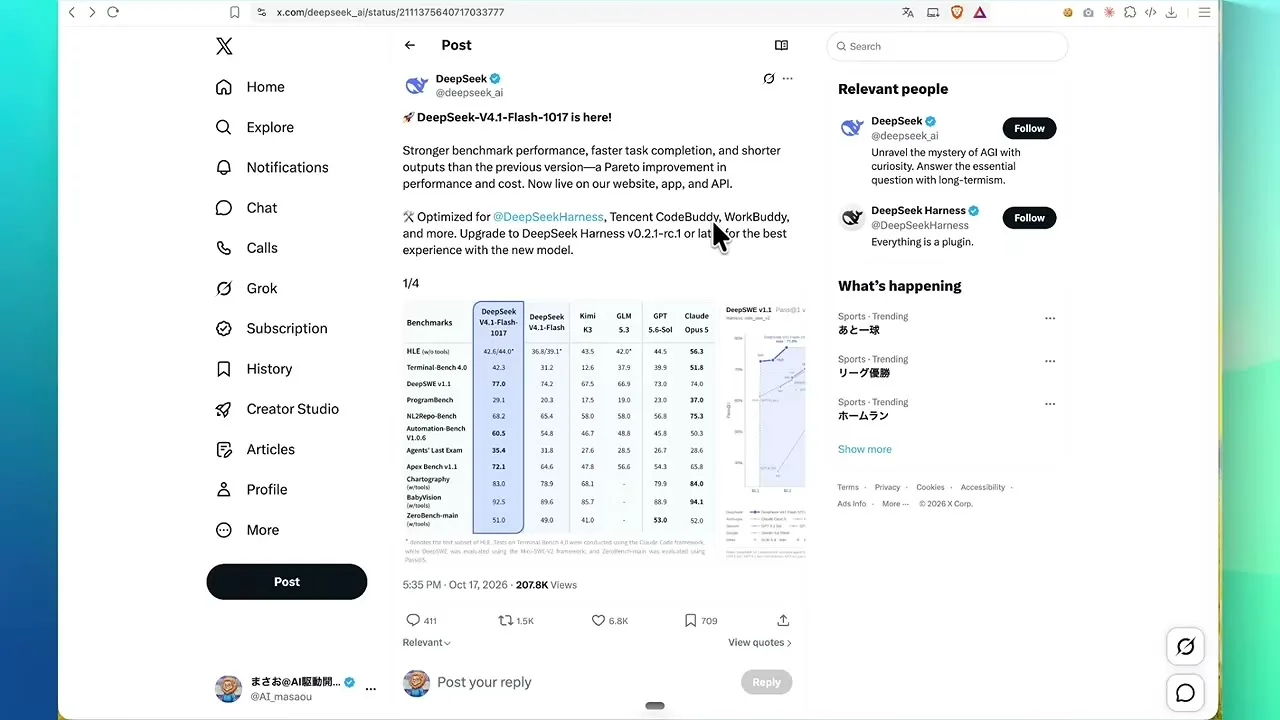
ここが、動画の出発点です。まさおさんは、DeepSeek V4.1 Flash の 1017版が登場した、と話し始めます。かなりやばいのではないか、と思って緊急で動画を撮った、と言います。
公式のポスト(2026年10月17日)は、前の版より成績が高く、タスクの完了が速く、出力が短い、と書きます。性能と費用の両方で上向き、という説明です。
新版は DeepSeek Harness などの環境に合わせて調整されていて、DeepSeek Harness は v0.2.1-rc.1 以上への更新が推奨されています。
公式の説明では、モデルが自分の出力を見て直す強化学習で、ゲーム作りから3Dモデリングまで、1つの作品を最初から最後まで作る力が上がりました。
まさおさんが、いつものLPなどを回してみると、見た目がしっかり変わっていた、と話します。
まさおさん(動画の中で・2:12〜)
え、これね、もうなんか前のディープシークと同じ感覚でいたらちょっとやばいというか。
まさおさん(動画の中で・2:18〜)
V4.1なんですけど、感覚的にはね、4.2であったりだとか4.3であったりだとか、ま、出ててもね、全然、あの、おかしくないぐらい、え、インパクトあったなと思います。
公式の言葉と、手を動かした体感。動画は、新版の大きさをその両方で伝えています。
2026年10月8日、私はAIに、配車ルールを最適にして、と頼みました。きっかけの一つは、まさおさんの前の動画(Haiku 5.5 を解説する動画)でした。
席表(どの仕事にどのAIを座らせるかを決めた、私の配車の表)と、承認の境界は変えていません。変換と要約の席に座るモデルだけを、Haiku 4.5 から Haiku 5.5 に替えました。席の形は同じで、座るモデルだけが新しい。
公式で確かめたのは、安い単価が入力 100k トークンまでで、超えると約5倍になる点。だから長い文章の変換は、これまでどおり別の系列のAIを先に使います。新しい文字の数え方で、枠の消費が約30%増え得る点も記録に残しました。
動画が伝えるのは、新版の大きさ。そのきっかけになった動画の話は、別の動画で、Haiku 5.5 の単価と使いどころを整理した記事でも読めます。
私なら、新しい版が出ても席表の形は変えず、座るモデルだけを、公式で確かめてから入れ替えます。
動画は次に、新版と Opus 5 などを、公式のベンチマークの表で並べます。勝っている所も、負けている所もある表。この数字、どう読めばいいんでしょう?
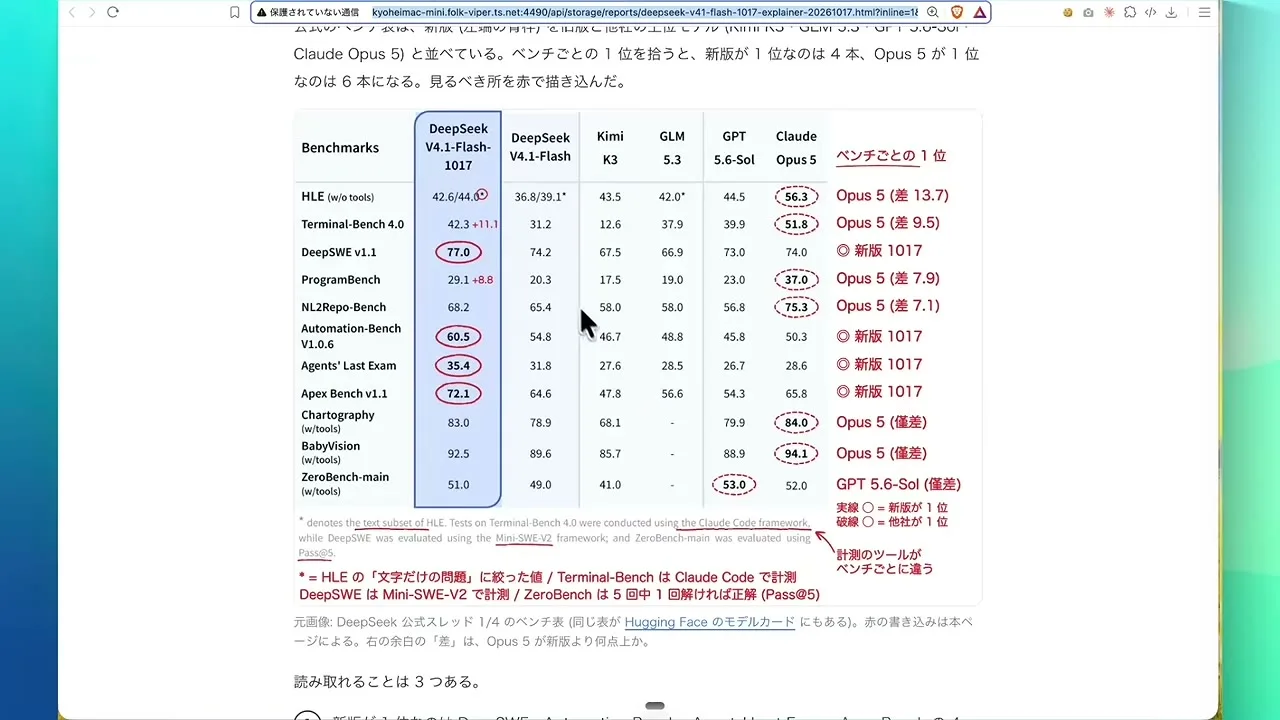
比べる相手は、Opus 5 と GPT-5.6-Sol です。ほかに Kimi K3、GLM-5.3、前の版も、同じ表に並んでいます。
表は11本のベンチマークです。名前は、HLE、Terminal-Bench 4.0、DeepSWE v1.1、ProgramBench、NL2Repo-Bench、Automation-Bench など。
まさおさんが画面に出す注釈つきの表では、1位が新版なのは4本で、DeepSWE、Automation-Bench、Agents’ Last Exam、Apex Bench です。
Opus 5 が1位なのは6本です。GPT-5.6-Sol が1位なのは ZeroBench-main の1本で、差はわずかでした。
前の版からの伸びでは、Terminal-Bench 4.0 が 31.2 から 42.3 へ上がっています。まさおさんは、HLE 系と Terminal-Bench を挙げて、Opus 5 に負けている項目もある、と話します。
表の脚注には、計測のツールがベンチごとに違う、とあります。Terminal-Bench は Claude Code のフレームワーク、DeepSWE は Mini-SWE-V2、ZeroBench-main は5回中1回当たれば正解です。
勝ち負けだけでは読めません。表は、勝ち負けの一覧ではありません。条件つきの数字の一覧。脚注まで読むと、そこがはっきりします。
10月1日に Cloudflare が出した小さいほうのモデル Clef-flash は、公式の数字が 38.8ミリ秒です。日本のMacからAPIを呼ぶと、1件あたり約0.5秒でした。往復の待ちが大半で、公式の数字は出ませんでした。
動画が比べているのは、公式の表の数字どうしです。公式の数字は、公式の条件で測った数字。自分の環境で同じ数字が出るとは限りません。分けて読んだ話は、ベンチマークを、メーカーの表と外の会社の測定に分けて動画で読んだ記事でも読めます。
私なら、公式の表は公式の条件の数字として読み、使う前に自分の環境で測り直します。
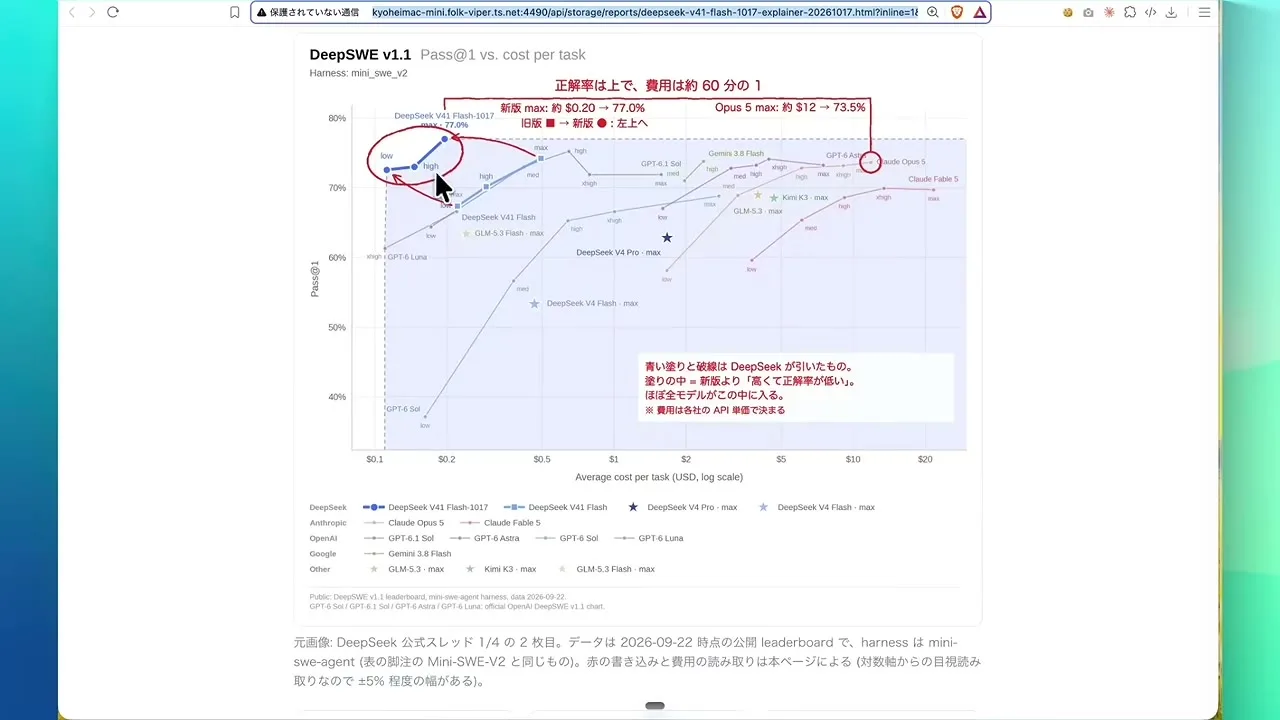
動画のタイトルにもある、約60分の1という費用の差。ずいぶん大きな差ですよね。何と何を、どの条件でそろえた比べ方なのでしょうか?
画面には、DeepSWE v1.1 の正解率と、1つの課題あたりの費用を並べたグラフが出ます。図の注記には、正解率は上で、費用は約60分の1、と書かれています。
比べているのは、最大設定どうし。新版の正解率は77.0%、Opus 5 は73.5%で、どちらも図の上の数字です。
図の注によると、データは2026年9月22日時点の公開リーダーボード。費用は対数の軸から目視で読んだ数字で、5%ほどの幅があります。
対数の軸は、目盛りが1つ進むごとに桁が変わります。同じ幅でも、差の大きさは見た目より大きい。
まさおさんは、Opus 5 はコストがかかる、と話します。締めくくりでも、話はこの値段に戻ってきます。
まさおさん(動画の中で・12:12〜)
個人的にはこれがこの値段で使えちゃっていいのかっていう風に思うし
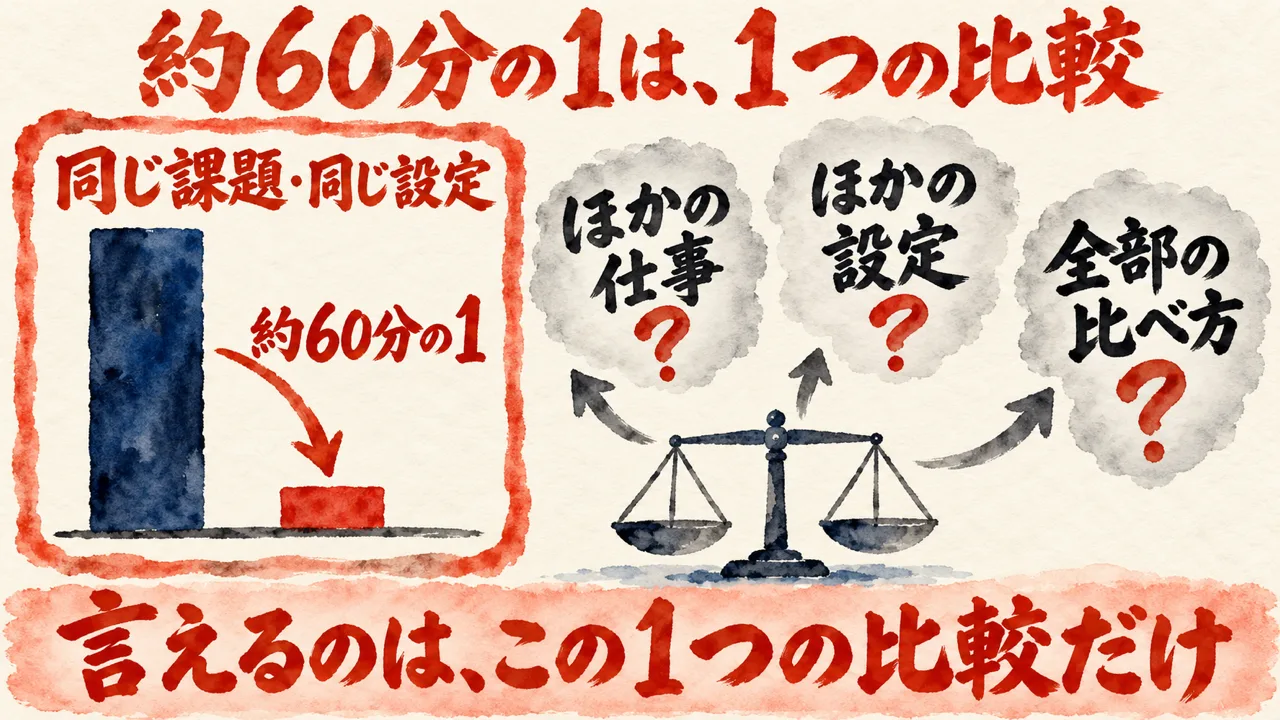
ここは、数字の出どころの話です。つまり、約60分の1は、DeepSWE の最大設定どうしで並べた1つの比較。全部の使い方で同じ差が出る、という話ではありません。
道具の評価は、前と後のトークン数を測って書きます。数える単位は、トークンです。
公開済み記事の読者テスト(同じ記事・同じ質問)を、Codex の重い版、軽い版、GLM-5.3 で比べました。結果は? 重い版は 2,113,499 トークン、軽い版は 453,285 トークン、GLM-5.3 は 12,779 トークン(55秒)でした。軽い版の約35分の1です。GLM-5.3 は、重い版と軽い版が拾った箇所を両方拾い、引用3件も本文と一致しました。2026年9月30日には、私が日本語は問題ないと伝え、GLM は日本語が不安だ、という未検証の記述は直されました。
動画の物差しは、1つの課題の上の正解率と費用。私の数え方は、同じ記事と同じ質問を読ませたトークン数です。物差しが違うので、約60分の1と約35分の1は、並べて読めません。
新版の分は、同じ記事と同じ質問で読ませて数えるまで、私の数字にはなりません。動画の費用の話は、AIを選ぶ時の最初の物差しです。ただ、物差しが1本だと、見えない所が残ります。数えたトークンは、次の席を決める時にそのまま使えます。
私なら、費用の差は条件をそろえた1つの比較としてだけ受け取り、自分の分はトークンで数えます。
動画は続けて、重みも公開されていて、手軽に使える、という話に進みます。では、公開されていることと、自分の仕事で使えることは、同じでしょうか?
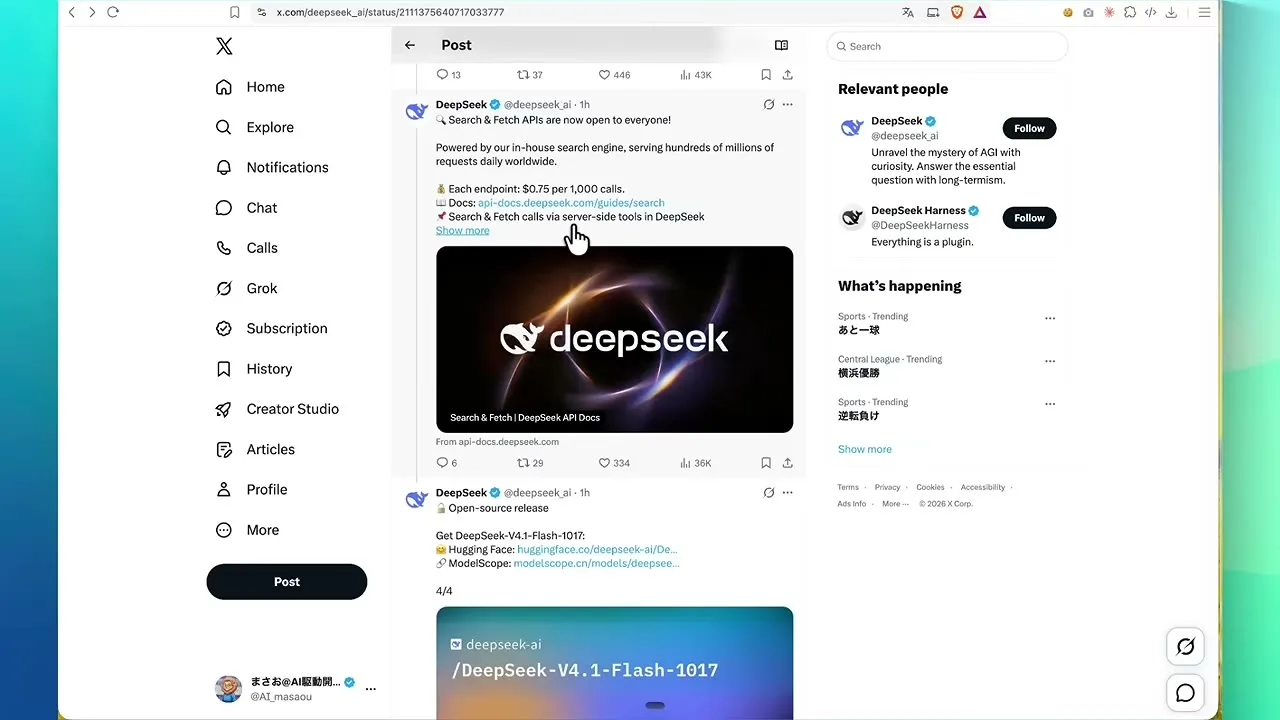
重みとは、モデルの中身のことです。公式のポストには、重みを Hugging Face と ModelScope で公開した、とあります。
まさおさんは、OpenCode などでも前の版が公開されて話題になった、と話します。使っているサービスのサブスクの中でも使えて、手軽です。
Search と Fetch の API も、誰でも使える形に。自社の検索エンジンで1日に数億のリクエストを処理している、と公式は書いています。
DeepSeek Harness などの環境も選びやすくなった、とまさおさんは続けます。
まさおさん(動画の中で・4:52〜)
これぐらいのクオリティをやってくるっていうことはAI課金をあんまりしなくてもかなりですね、強力なものを、え、使っていけるということですね。
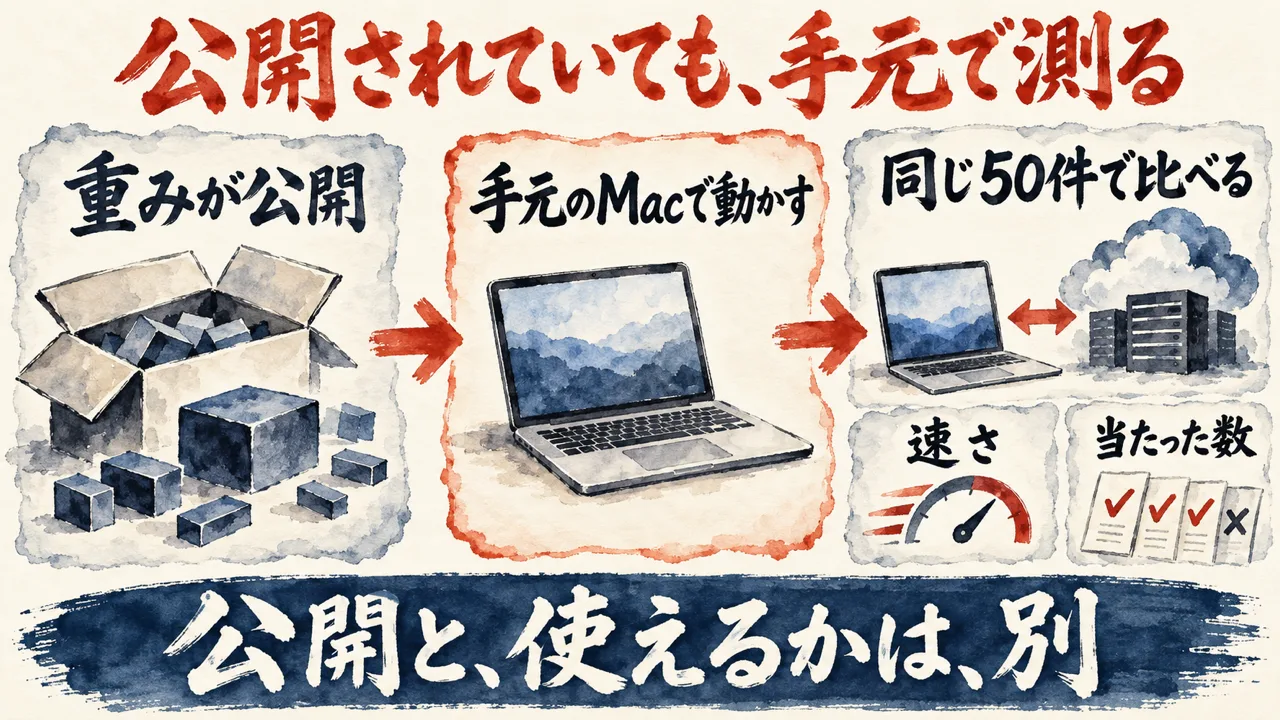
入口は、広がりました。公開と手軽さは、使えるかどうかの入口。そこから先は、自分の手元で確かめるところ。公開された重みは、手元の席の候補にもなります。測るのは、ここからです。
実物50件を、クラウド側の Jev と、私の Mac(Apple M5 Max)で動かす Laya に、同じように判定させました。その重みは、Hugging Face から取った約615MB(周辺のファイルを含めて約650MB)。
1件あたりの平均は、手元の側が 115.6 ミリ秒、Jev が 592.9 ミリ秒。手元の側が約5倍速く出ました。
ただし一致した数は Jev が上です。成功件数はどちらも 50/50。満足しているかは 38/38 対 28/38、悩みの型は 44/50 対 28/50、次に見せる物は 27/37 対 13/37(Jev 対 手元の側)でした。
速さと一致した数は、別の物差しです。
後に、重みが Apache-2.0 で公開されている Clef-flash を50件で試すと、Jev との差は1〜2件でした。
手元のMacとクラウドで比べた話は、手元のMacで動かす小さなモデルと、クラウドのモデルを、実物50件で比べた記事に詳しく書いています。
私なら、重みが公開されていても、使えるかは自分の同じ50件を流して決めます。
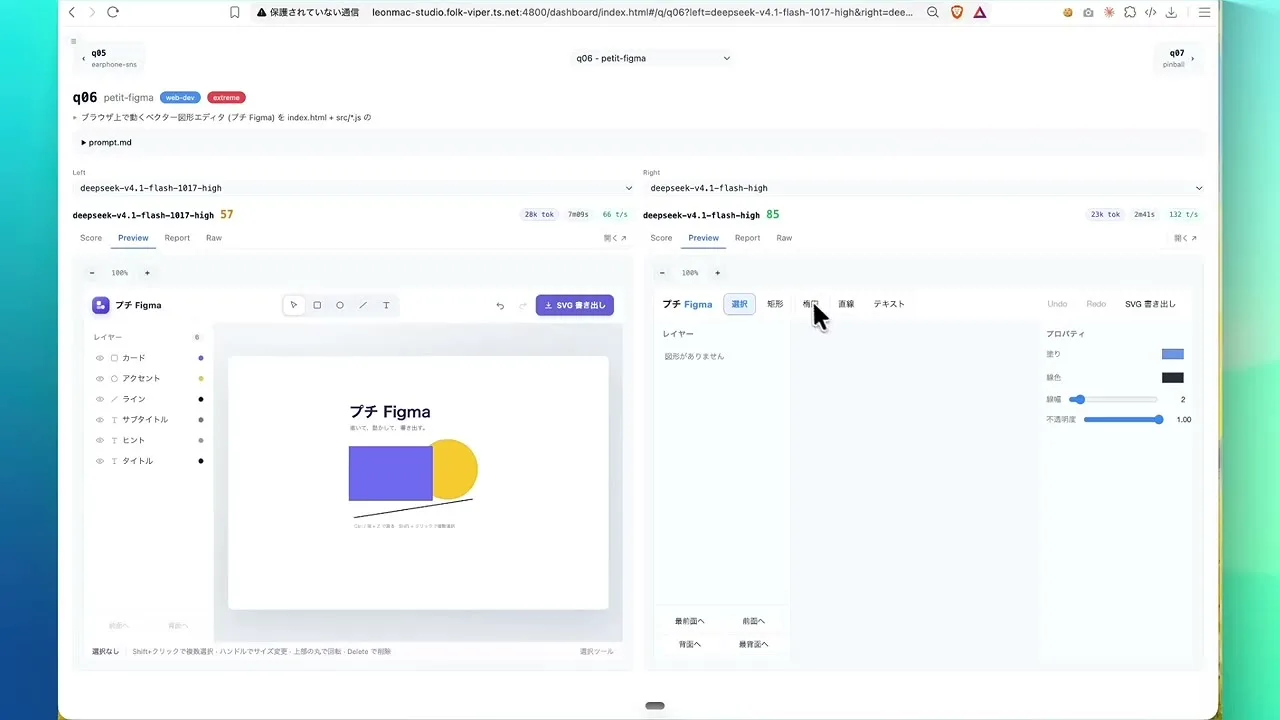
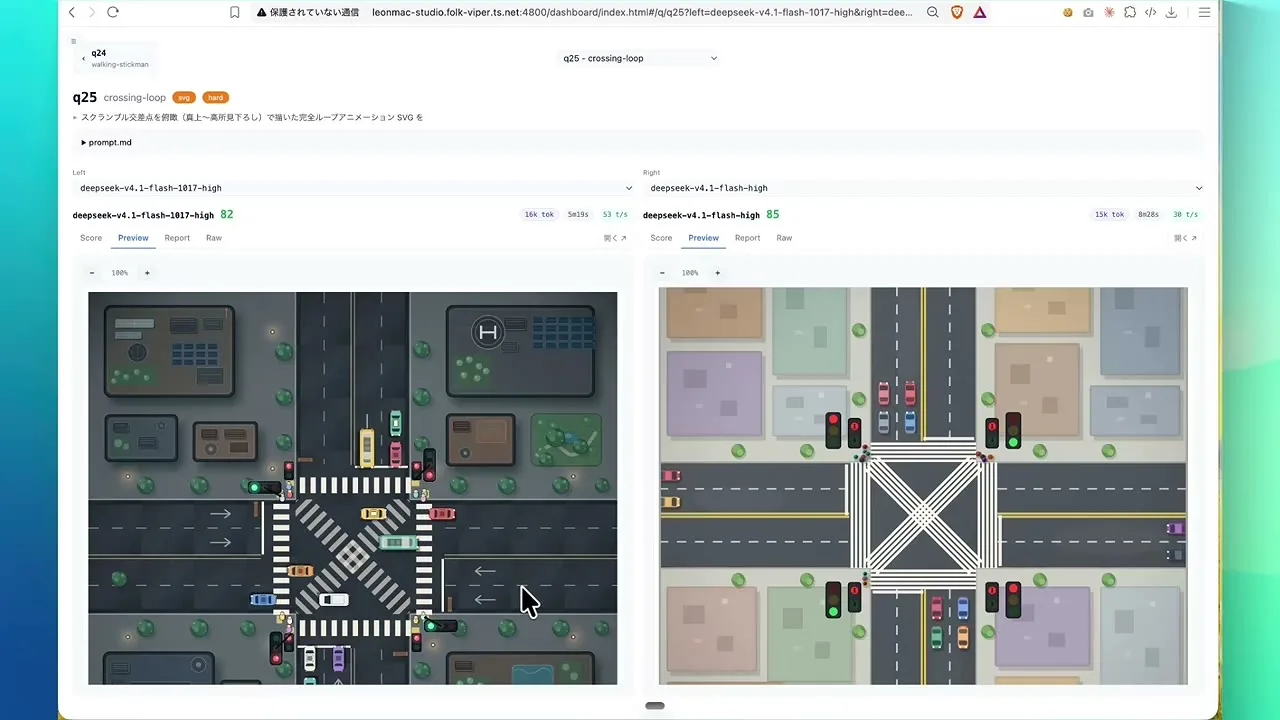
動画の中心は、前の版と新版を同じお題で左右に並べて見比べるデモです。まさおさんが評価に使う言葉は、見た目とクオリティでした。LPからゲーム、図解、SVGまで、順に見ていきます。
LPは、キーボードのブランド、アイドルユニット、MMORPGの3つ。細部まで行き届き、前の版よりクオリティが上がった、とまさおさんは話します。文字は少し多い、とも言います。
Notion 風のエディターは無難にこなし、イヤホンのSNSは前の世代より見やすい、と続けます。プチ Figma では、ドラッグ&ドロップで図形の位置を動かせます。前の版は自分で準備して操作する必要があった、とまさおさんは話します。
ピンボールは、前の版では成り立たず、今回は普通に作れています。3D格闘ゲームはクオリティが高く、敵も強い。必殺技でやられた、と笑う場面もあります。
アクアリウムは、前の版が話にならない出来だったのに比べて、多少マシに。ゴブリンのゲームも、前の版はチープでしたが、かなり上がりました。
まさおさん(動画の中で・9:34〜)
前はね、ちょっと話にならないぐらいだったんですけれども、多少マシになってるかなっていうのが、ま、今回のアップデートで、で、僕個人的にはね、これも驚きましたね。
ハーネスの図解やスライドは、別のモデルのよう。文章のスコアはほぼ同じですが、まさおさんは新版のほうが少し好き、と話します。
まさおさん(動画の中で・10:28〜)
これ別モデルじゃないかってね、思わしてくれる。
SVG は、トークン効率が良くなった、と言います。同じ V4.1 Flash と呼んではいけないほどの差。
まさおさん(動画の中で・11:36〜)
もうSVGも全然違うんですね。これ同じV4.1フラッシュって言っちゃダメだろうっていうぐらいのね、え、クオリティかなと思っております。
一方、画面の比較ダッシュボードの採点では、新版(左)が前の版(右)より低いデモが6つ並びます。キーボードのLPは77対86、Notion 風エディターは72対81、プチ Figma は57対85、3Dのマーブルランは44対54、ライオンのSVGは60対64、交差点のSVGアニメは82対85です。
見た目が上がったことと、画面の採点の数字。この2つは、別々のものとして並んでいます。
見た目では上がって見えるのに、採点では前の版より低い。この2つを、1つの言葉でまとめてしまっていいのでしょうか?
私は Facebook に、Clef-flash を実際に試したら、鬼速いし安いしマルチモーダルだし完全主役交代、と書きました。同じ投稿で、Jev のほうがいいところもあるので使い分けで、と添えています。試験そのものは、AIたちがAIたちを引き連れて回し、私は結果を眺めただけです。同じ50件の実測は、Clef-flash が満足 36/38・悩み 43/50・次に見せる物 29/37、Clef が 38/38・43/50・28/37 でした。外した時の癖は、3つともばらばら。Clef-flash は資料の案内へ、Clef は関連記事へ、Jev は何も出さないという選択とメルマガへ寄ったんです。
動画は、見た目を軸にして、前の版との差を見せてくれます。上の投稿は、速い・安いと書いた同じ投稿で使い分けを添えたもの。50件の実測では、外した時の癖まで並べて見ました。見ている軸が、そもそも違うんですよね。
新顔のモデルとクラウドのモデルを同じ50件で比べた話は、新顔のモデルと、クラウドのモデルを、同じ50件で比べた記事でも読めます。
私なら、見た目が上がったことと採点を別に見て、速くて安いと書く時も、同じ投稿で使い分けを添えます。
動画の締めは、この値段で使えてしまっていいのか、という驚きでした。そして、速度感への怖さ。新しいモデルが次々に出る時、私たちはどう向き合えばいいのでしょう?
まとめでまさおさんは、Opus 5 と比べて、圧倒的にコストが低い、と話します。世界中でいろいろなものが暴れまくっている、とも言います。
まさおさん(動画の中で・12:33〜)
最近ね、やっぱ世界中でね、いろんなものが暴れまくってたりするんで、ま、ちょっとそこのね、速度感とか、ま、怖いなと思いつつもはい。
デモの途中で画面に出た、ハーネスの図解。課題を隔離した作業場に渡し、成果物を機械で検証し、合否を見て、不合格なら差し戻す流れです。見出しは、賢さではなく壊れにくさを設計する、という言葉です。
それでも、この登場はかなりのインパクトだった、と動画は結びます。
では、速度に追いつけない時、何を手元に持っておけばいいのでしょう?
2026年9月21日、私は、それはいろいろ手を尽くして最適なの本当に? と問い返しました。AIの答えは、最適とは証明できない、でした。その時点で、1週間の仕事421件のうち、実際に走ったモデルを仕事ごとに照合できたのは0件。原因は、日次のレポートが24時間分の集計を上書きするだけで、仕事ごとの証拠を残していなかったこと。そこで、席表を変える前に、予定したモデルと実際に走ったモデルを、仕事ごとに結ぶ台帳を作りました。配車の時の使用率との突き合わせは、0件のままです。9月21日の検証では、Claude と Codex の7日間の275件のうち273件を照合でき、途中でモデルが切り替わった19件も見つかりました。日次で長く回した時の検証や、一部の道具の照合は、まだ残っている所。台帳は、測る材料を作った、というところまでです。
動画は、速度感が怖い、という感想で結びます。私の台帳は、その動画より前の9月21日に、配車は本当に最適か、という問い返しから作ったものです。怖さへの答えではなく、変える前に測る材料の話です。
私なら、速度感が怖い時こそ、変える前に測る材料を先に作ります。
Q. DeepSeek V4.1 Flash の 1017版では、何が変わりましたか。
A. 公式のポストでは、前の版より、ベンチマークの成績が高く、タスクの完了が速く、出力が短い、とされています。まさおさんは、デモの見た目が上がった、と話します。
Q. Opus 5 より強いのですか。
A. 11本のベンチマークのうち、新版が1位なのは4本、Opus 5 が1位なのは6本、GPT-5.6-Sol が1位なのは1本です。注釈つきの表で見ると、項目ごとに勝ち負けが分かれます。
Q. 費用が約60分の1というのは、全部の仕事で言えますか。
A. いいえ。動画の図は、DeepSWE の最大設定どうしの比較で、2026年9月22日時点のデータです。費用も対数の軸から目視で読んだ数字なので、1つの条件での比較として読みます。
Q. 重みは公開されていますか。
A. 公式のポストには、Hugging Face と ModelScope で公開した、とあります。まさおさんは、使うサービスのサブスクでも使えて手軽だ、と話します。
Q. 新しいモデルが出た時は、何を見ればよいですか。
A. 私は、席表の形は変えず、座るモデルだけを替えます。公式の表は自分の環境で測り直し、変える前に、実際に走ったモデルを仕事ごとに残す台帳で、測る材料を持ちます。
動画は、新版の登場から始まり、ベンチマークの表、費用の比較、重みの公開と手軽さ、デモの見た目を順に見て、締めの速度感で結ばれます。前の版から何が変わったかを、この順に追えます。
私が持ち帰ったのは3つ。席の形は変えずに座るモデルだけを替えること、公式の数字は条件つきで読み、使う前に測り直すこと、そして変える前に測る材料を持つことです。
まさおさんは、この速度感が怖い、という感想で動画を結びます。私が席を変える前に持っておくのは、実際に走ったモデルを仕事ごとに照らし合わせる材料です。追いかける前に、数えられる形にしておく。
新しいモデルが出て、公式の表やデモの見た目に心が動いた時、席を変える前に、自分の仕事のどれを、何で測る材料にしておきますか?
関連記事
別の動画で、安いモデルの単価と使いどころを整理した記事。
ベンチマークを、メーカーの表と外の会社の測定に分けて読んだ記事。
毎月届くAPIクレジットの使い道を、仕事を数えて決めた記事。
手元で動かす小さなモデルを、クラウドのモデルと50件で比べた記事。
新顔のモデルを、クラウドのモデルと同じ50件で比べた記事。
モデルが安くなっても、大手が先端を競い続ける理由を聞いた記事。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
今回紹介した動画
| チャンネル | まさおAIじっくり解説ch |
| 出演 | まさおさん |
| 公開日 | 2026年10月17日 |
| 長さ | 13分41秒(日本語) |
| URL | https://www.youtube.com/watch?v=1lF9yQBJVoA |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!