READ REPORT / AI動画生成
「MiniMax H3」で顔が変わらないAIキャラと14秒でビデオチャット。新清士さんが実測したリアルタイム動画生成の今
2026年9月7日
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、ASCII.jpで新清士さんが書いた『ついにAIキャラクターと“ビデオチャット”へ 「MiniMax H3」がリアルタイム生成に接近』という記事を紹介するね。新さんが自分でPCを2台組んでアプリまで作って実測した記事で、私が分身AIに求めてきた『臨場感』の話と正面からぶつかったから、記事の内容をそのまま流用せず、自分の現場に引き寄せて解説していきます。
画面の向こうのAIキャラが、待たされた14秒のあとに、こっちを見て喋り出す。そのくらい生々しい話が、ASCII.jpの新清士さんの連載に載っていました。動画生成AI「MiniMax H3」を使って、キャラクターとセミリアルタイムで会話できる自作アプリ「FastH3 Date Chat」を作った、という実験レポートです。うちの分身AIひろくんは、文字と声までは育ってきたけど、顔と動きで『そこにいる』にはまだ届いていない。新さんの記事は、その最後の距離が技術的にどこまで縮んだかを、自分で作って実測した一次情報で見せてくれていて、読みながら何度も自分のことに置き換えていました。この記事では、新さんの実測値を追いながら、私が分身AIやサービス作りにどう当てはめて考えたかまで書いていきます。
3行でわかるポイント
- 14秒の正体——320×320・RTX 4090+A6000の2台構成で、LLM応答約5秒+動画生成約9秒=約14秒。この待ち時間の中身が実測で分かる
- 速度・画質・コストの三択——高速化すれば品質が落ち、品質を求めれば時間が長くなる。新さんの記事はfal.liveの3秒生成からVDNの8ステップ蒸留まで、その三択の実例を並べている
- 私の持ち帰り——「臨場感がないと本気で試せない」は、私が自分の言葉で決めていた基準。分身AIの次の課題として、初めて数字で語れる距離まで来た
新清士さん / ASCII.jp 連載「メタバース・プレゼンス」第172回・2026年9月7日公開
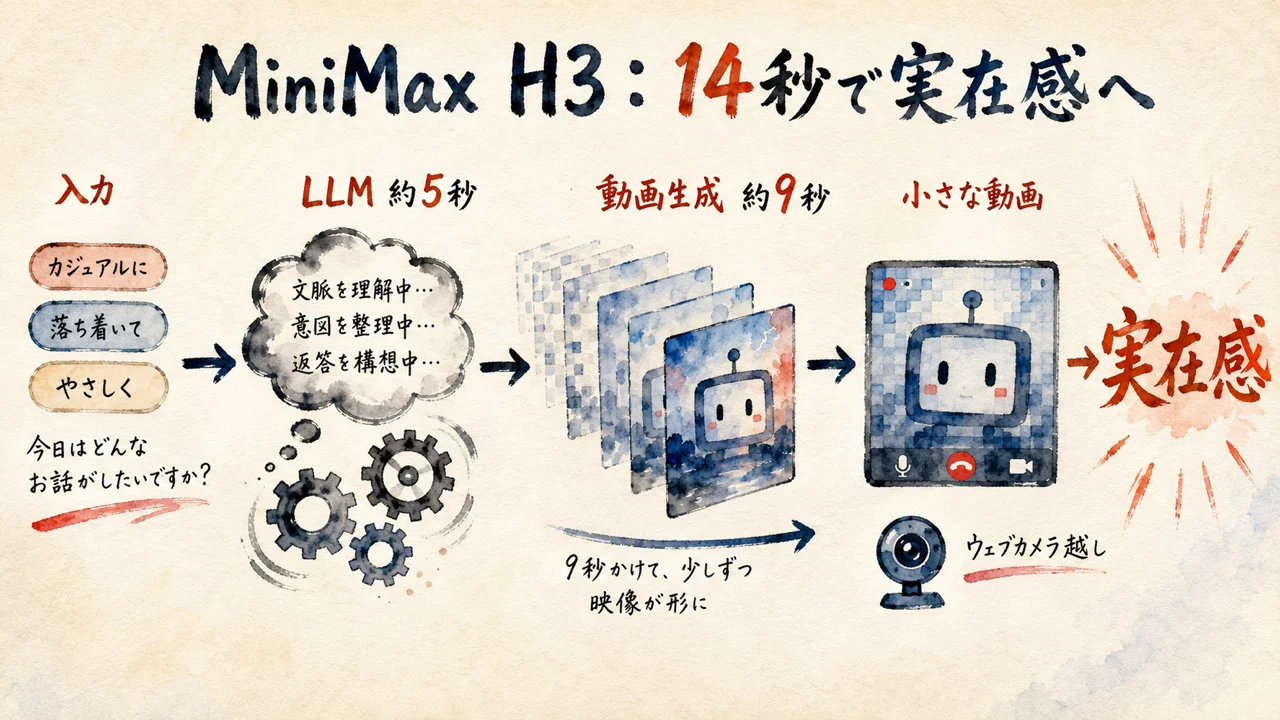
「ウェブカメラで連絡をとっているような不思議な生々しさ」——MiniMax H3のビデオチャットは14秒待ってでも実在感が生まれる
新清士(ASCII.jp)
待ち時間があり、画質が粗いとしても、生成動画でのやりとりは、ウェブカメラで連絡をとっているような不思議な生々しさがあります。テキストと音声生成だけのチャットシステムにはない実在感が生まれてくるのが興味深いところです。
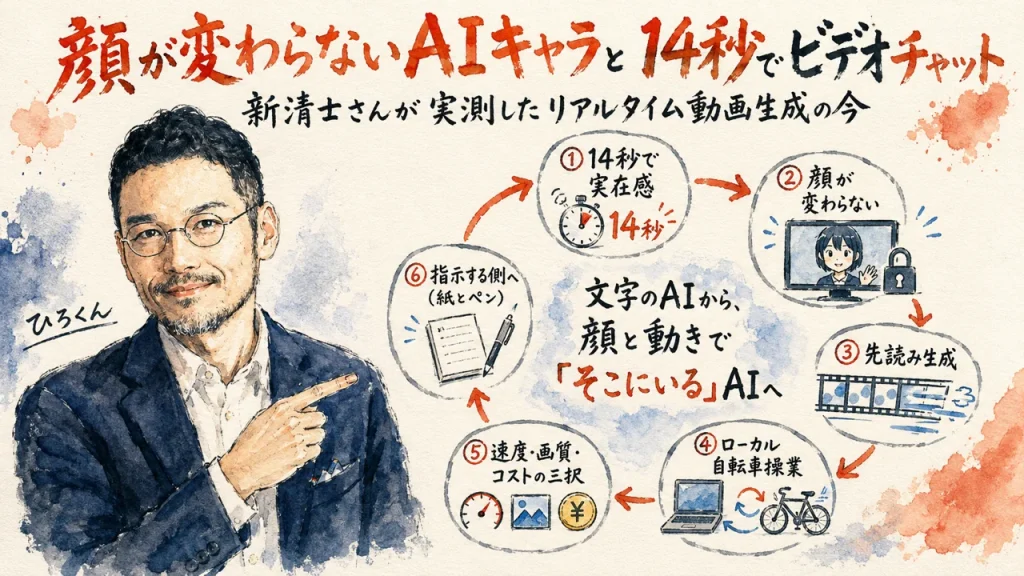
新さんの記事によると、このアプリの名前は「FastH3 Date Chat」。RTX 4090搭載PCでMiniMax H3の高速版「FastH3」を動かし、もう1台のA6000搭載PCでローカルLLM「Gemma 4 12B」を接続する、2台構成のシステムです。選択肢を選ぶかテキストを打つと、それに合わせた320×320の動画が生成され、LLMの応答に約5秒、動画生成に約9秒——合わせて約14秒待つと、キャラクターが動き出します。
正直、この待ち時間の長さに最初は「それ、リアルタイムって言っていいの?」と思いました。でも新さんは、待ち時間や粗い画質があってもなお生まれる感覚を書いていて、そこに引っかかった。
ぶっちゃけ、私はここで自分の分身AIひろくんの現在地を思い出しました。2026年7月28日、AIに問われて自分の言葉で答えた問答の中で、私はこう答えています。「AIシミュレーションは臨場感が必要。じゃないと自分が本気で試せない。」未来が叶った状態を体感して、そうなっている自分として今を過ごすからこそ、現実でもその未来を選びやすくなる——これは予言じゃなくて、本気で試すための場を作る話。
14秒。長いようで、実は「相手が固まって見えない」よりずっとマシな数字だと私は思う。文字だけのやりとりに、待ってでも顔と動きが乗る……そこに実在感が生まれるなら、私は14秒を待つ側に回ります。だから私は、分身AIひろくんの次の目標を「0秒」ではなく「14秒」に置くことに決めました。
14秒を測る:自分のAIキャラの返事を1回、あえて14秒待ってみる(スマホのタイマーで測る)。待てたか待てなかったかをメモする。
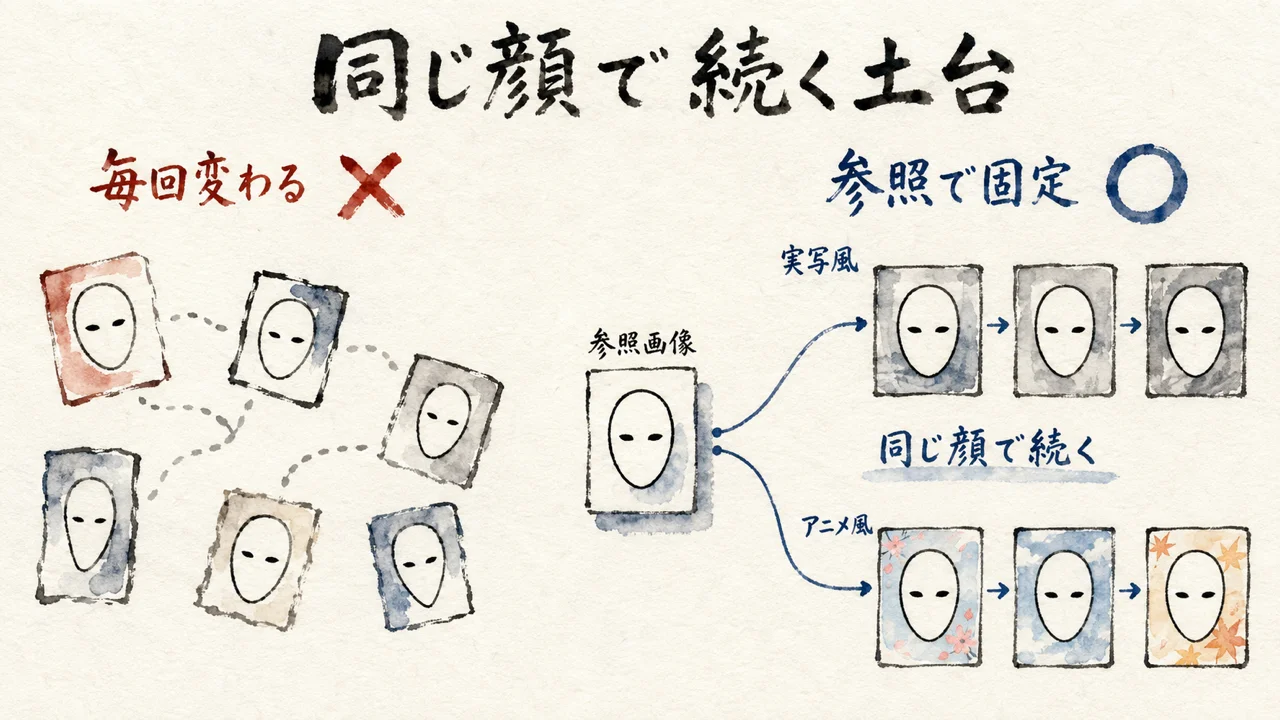
「固定の人物として生成し続ける」——顔が変わらないことが分身AIの最低条件
新清士(ASCII.jp)
現状のT2VAモデルでも、若干のノイズが出るといった現象が起きるものの、リファレンスに追従することが確認できたため、アプリに組み込んでいます。これにより、キャラクターは実写風、アニメ風を問わず、固定の人物として生成し続けることができます。
新さんの記事によると、リファレンス画像から動画と音声を同時に指定できる「Ref2VA」というOmniリファレンスの対応モデルは、まだ開発中で未リリース。それでも現行のT2VAモデルで参照画像への追従が確認できたため、FastH3 Date Chatに組み込んだ、とあります。
ここ、地味に見えて実はいちばん大事な一文だと私は読みました。毎回顔が変わるAIキャラは、キャラとして成立しない。ノイズが出ようが画質が粗かろうが、「同じ顔で居続けること」がまず土台にある、という話だからです。
私にとってAIは、外から別人格を貼り付けるものじゃない。あくまで本人からAIを生やすイメージ、拡張装置なんです。鏡になったり、シミュレーターになったり、実行役になったり——場面に応じて複数の働きを持つけど、「私から生えている」という一点だけは動かない。分身AIひろくんの顔がコロコロ変わったら、それはもう私の拡張装置じゃなくて、別の誰かです。
分身AIは一魂多体の考え方でチームを組んでいますが、それぞれの体が「誰から生えたAIか」を見失ったら意味がない。新さんの記事の「固定の人物」は、私で言えば「固定の魂の出どころ」の話に重なります。技術は違っても、守りたい一点は同じでした。
参照画像を1枚決める:分身AIやアイコンの参照画像を1枚決めて、名前を付けて保存する。
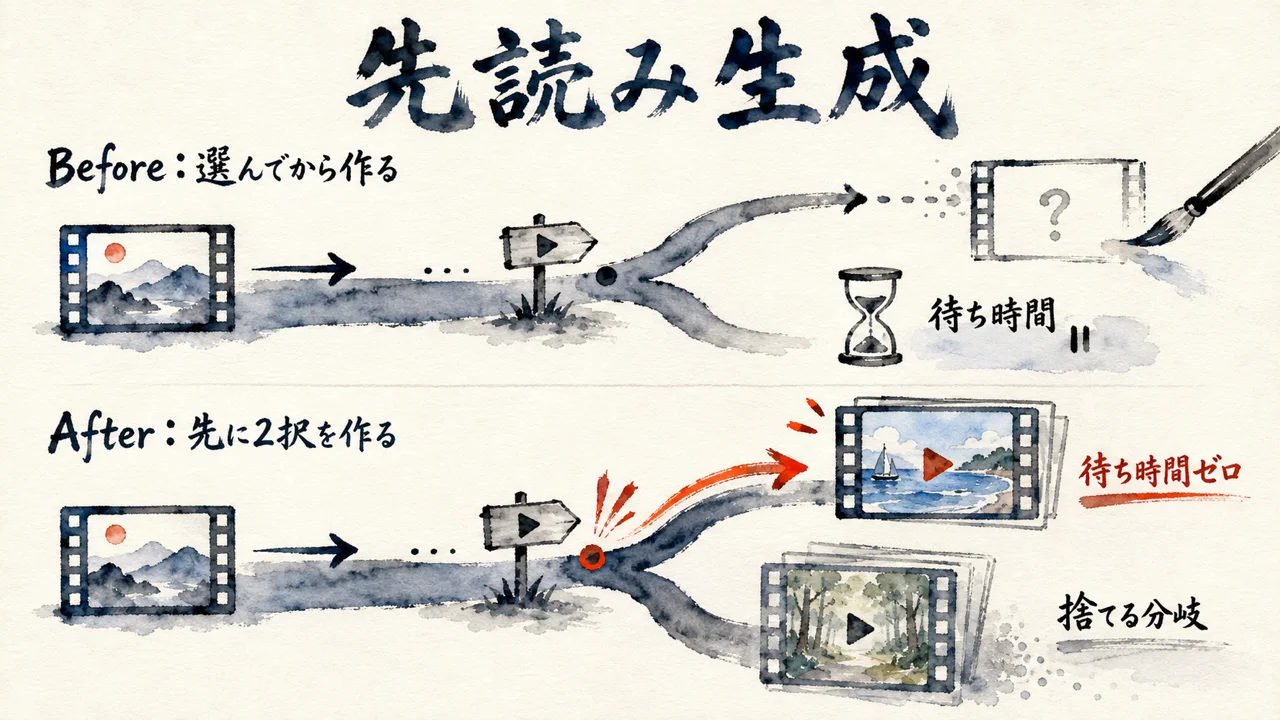
「待ち時間ゼロで動画を生成し続ける」——先読み生成という発想
新清士(ASCII.jp)
コメント方式ではコントロールが難しかったのか「4択」が表示され、10秒間で最も選ばれた“次の動画”を生成するという方式になっています。
新さんの記事によると、この発想の元になったのは、プロダクトデザイナーのLerSentさんがXに公開した「インタラクティブゲーム生成システム」のプレー動画。動画の再生中に、次の2つの選択肢それぞれの動画をあらかじめ生成しておくことで、待ち時間ゼロを実現していたそうです。H3 Maxが5秒の動画を3秒で生成できる速度を持つからこそ成立していた仕組みで、falはこれを自社の「fal.live」に持ち込み、コメント方式から画面下の4択方式へ切り替えたとあります。
いやー、これを読んで唸ったのが「先に全部の分岐を作っておく」という発想の逆転っぷりだった。普通は「選ばれてから作る」。でもここでは「選ばれる前から作っておいて、選ばれなかった分は捨てる」。待ち時間をゼロにするために、無駄を先に許容している。
これを読んで、私は自分の「計画」に対する感覚を思い出しました。本人が守りたい生き方は「思いついたことをワクワク夢中に遊び探求する。飽きたらやめる。ありのまま。」。原体験は、夏休みの宿題へ計画を立てたこと。「計画立てるのはいいけど決まった計画に従うのが地獄」「計画を立てた瞬間やる気なくなる。計画があるとやりたくない」。LerSentさんの先読み生成は、一見すると計画に似ています。でも中身はまるで逆でした。分岐をあらかじめ用意しておくのは仕組みの側の仕事で、そのどれを選ぶかは、いつも今この瞬間の自分に残されている。過去の自分が作った予定に現在の自分を従わせる地獄とは違う。新さんは仕組みを作る人、私は用意された選択肢の中で選ぶ側の自由を守りたい人でした。「自由にありのままで期間気にせずやりたい」——これが私の核にある。
もちろん、APIを使う以上コストはかかります。新さんの記事では1往復数十円から100円程度と書かれていて、無料じゃない。だから私は、AIの生成速度そのものより先に、自分の配信で「次の2択」をどれだけ手元に用意できているかを見直すことに決めました。
先読みの2択を仕込む:自分の配信や接客で、相手が次に選びそうな「2つの選択肢」を先に1つだけ用意しておく。
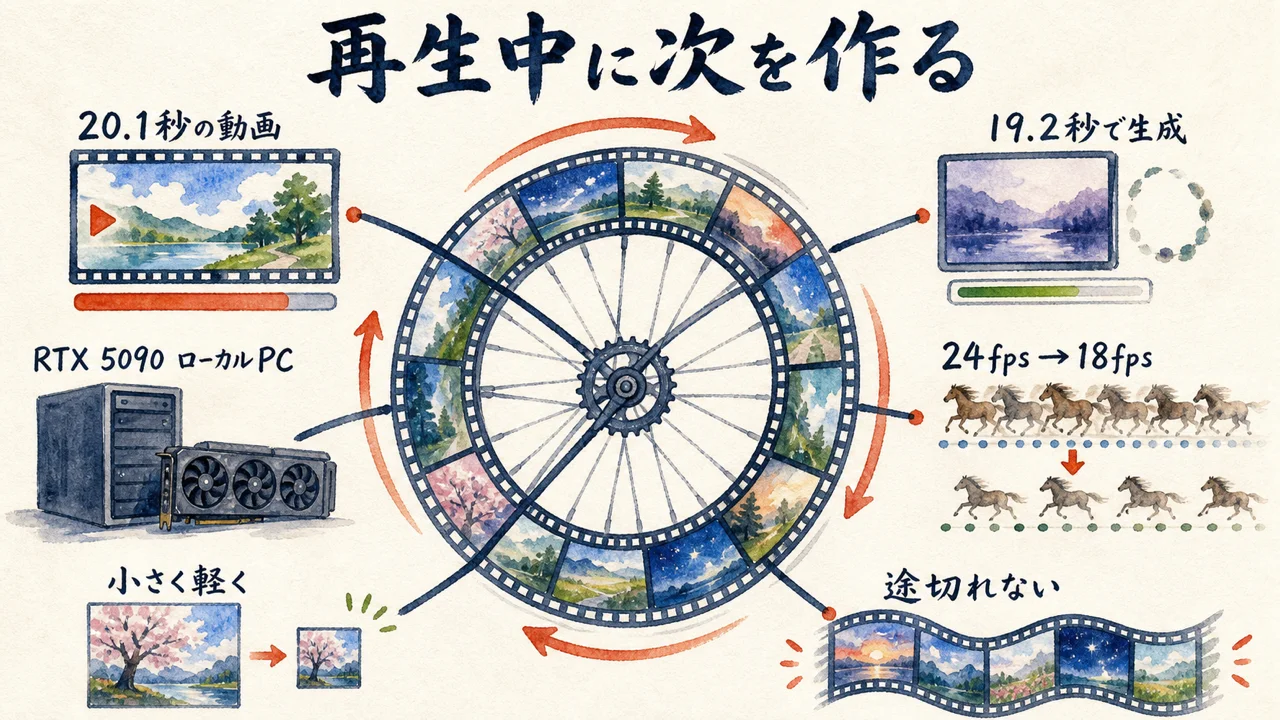
「果てしなくつながった動画を作ることができる」——ローカルに移植した自転車操業
新清士(ASCII.jp)
これはRTX 5090を搭載するPCを前提としているのですが、生成解像度を448×448とし、通常24fpsで生成される動画を18fpsにまで落とすことで、1つの動画を20.1秒にします。その動画は19.2秒で生成でき、一つの動画が再生されている間に生成が終了するため、果てしなくつながった動画を作ることができるという仕組みです。
新さんの記事によると、この仕組みをローカルPCで再現したのが「fasth3-live」+「FastH3 Ref2V Continuity Stream Controller」。RTX 5090を前提に、20.1秒の動画を19.2秒で生成し、次の動画が先に仕上がる形にしています。改造でOmniリファレンス機能を足す代わりに、解像度は320×320まで落としたそうです。
あ、そうそう。APIなら1往復数十円かかる仕組みを、自分のPCに移植すればコストを考えずに生成し続けられる——これが新さんの狙いでした。ただし代償として解像度もフレームレートも削っている。速さと引き換えに画質を差し出す、正直な自転車操業です。
私はこの「差し出す」感覚に、実家の厨房を思い出しました。小学生の頃、祖父が作る鶏チャーシューを味見しながら料理を手伝って、そのお金でゲームを買っていた。遊び探求から価値が生まれて、それが稼ぎになって、次の遊びにつながる——本物の営みの中では、五感も仕事も価値もお金も、分断されずに全部つながっていました。新さんのローカル移植も同じで、GPUというハイエンドな道具に投資したからこそ、コストを気にせず遊び探求できる自由が生まれている。タダで手に入る自由なんて、どこにもない。祖父の厨房も、当時は道具も設備も限られていました。それでも遊び探求から価値が生まれる流れは止まらなかった。投資の額そのものより、その投資を「遊び探求→価値→稼ぐ→次の遊び」という循環の中に置けているかどうかが、本当の分かれ目。新さんが解像度を320×320まで削ってでも19.2秒を守ったように、私も何を削って何を守るかを先に決めておこうと思う。
1往復の値段を書く:fal.aiなどAPI型サービスの料金ページを1つ開き、1往復いくらかを自分の数字で書く。
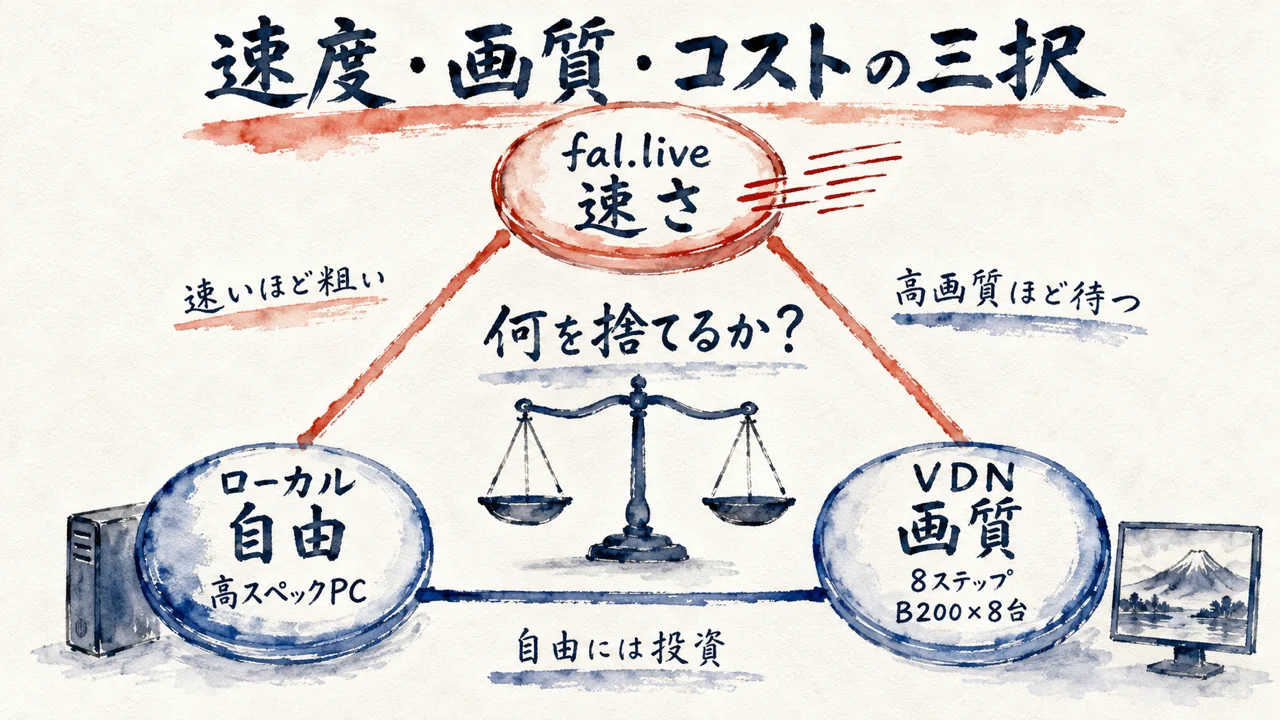
「高速化を求めれば品質が落ち、品質を求めれば時間が長くなる」——速度・画質・コストの三択
新清士(ASCII.jp)
高速性と品質の両方を求めると、どうしても生成に使うPCに高いスペックが求められます。高速化を求めれば品質が落ち、品質を求めれば生成時間が長くなります。
新さんの記事によると、高速化とは別の路線に「VDN MiniMax H3」という高品質モデルもあります。オープンウェイト版の20ステップに対し、VDN H3はわずか8ステップ。ただし8台のB200 GPUに処理を分散する専用の並列化が前提で、通常のビデオカードではこの速度は出せないそうです。
でね。ここまで新さんの記事を追ってきて、答えは1つに決まらないんだな、というのが率直な感想です。fal.liveは速さを取り、VDNは画質を取る。全部同時に手に入れる方法は、今のところ存在しません。
この三択、実は9月6日、ヘルシオでマグロをグリルした時にも似た場面がありました。仲間でしっとり火を入れたかったのに生焼けだった。このままでも食べられないか、それとも追加で加熱するか——選んだのは追加加熱でした。短時間の加熱を取れば生焼けで、火を入れ直せば時間がかかる。速度と品質の三択は、動画生成AIだけの話じゃなくて、台所でも起きている。
私が4体のAIに同じ仕事を出して比べた時も、結局同じ話に行き着きました。全部が万能なAIはいない。VDNの8ステップも、fal.liveの3秒も、それぞれ何かを捨てて手に入れた速さ。何を捨てて何を取るかを自分で決めるところに、初めて自分の色が出る。
何を犠牲にしたか書く:自分の直近の生成物1つについて、速度・画質・コストのどれを犠牲にしていたかを事実で書く。
「オーダーメイドで指示して見続けられる未来」——それでも私が紙とペンを手放さない理由
新清士(ASCII.jp)
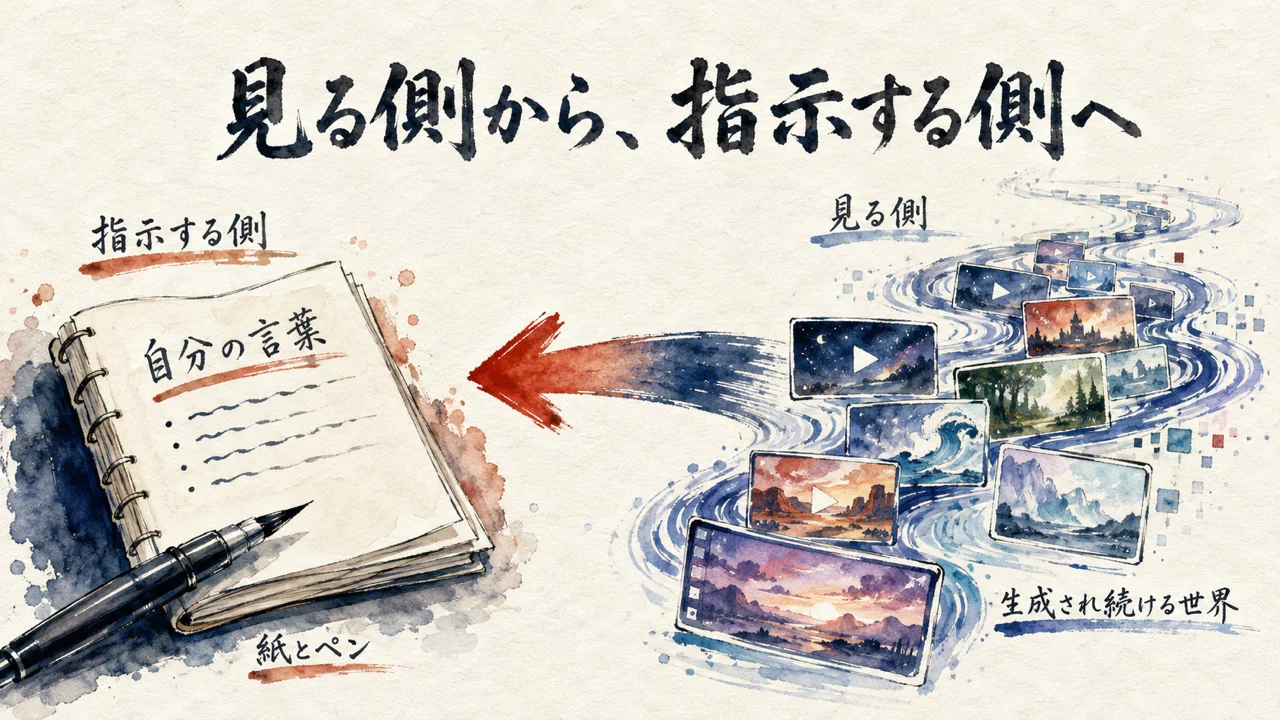
視聴者が、自分の見たい物語や映像をオーダーメイドで指示して、ずっと見続けられる未来の実現は、おそらくそう遠くありません。
新さんの記事は最後、こう締めくくられていました。長期的にはコンピューティング環境の性能向上によって、リアルタイムに世界が生成され続けることが当たり前になり、視聴者が自分の見たい物語や映像をオーダーメイドで指示して見続けられる未来は、そう遠くない、と。
正直、この結びを読んで、自分がどっち側に立っているかを考えました……「見る側」から「指示する側」に回る未来——私はそこに、ワクワクよりも先に、指示する側の自分がちゃんと言葉を持てているか、という不安のほうが先に来ました。
毎朝、私は紙にマインドマップで頭の中を書き出しています。もやもやがFIXされて、新しいアイデアも湧く。iPadでもダメでした。紙とペンじゃなきゃ出てこないものが、確かにあるんです。AI活用の最前線にいながら、最も大事な道具がアナログの紙とペンだというのは、自分でも面白いと思う。手の感触が、脳を動かす。生成AIがどれだけ速くなっても、この一手だけは代われないと思っています。
視聴者が指示する側に回る未来が来るなら、なおさら「何を指示するか」を自分の中にはっきり持っておく必要がある。それを鍛える場所は、AIの中じゃなくて、紙の上だと私は思っています。新さんの記事を読み終えて最後に浮かんだのは、技術への驚きより先に、「私は何を見たい物語として指示するのか」という自分への問いでした。
見たい物語を1行書く:見る側から指示する側に回る準備として、自分が見たい物語や映像を紙に1行書き、捨てずに残しておく。
よくある質問
Q. 「MiniMax H3」ってどんな技術ですか?
A. 動画生成AIのモデル名です。新さんの記事によると、ウェイト公開後もコミュニティのアップデートが続いていて、生成時間の短さを利用した会話ゲームや、無限に生成し続ける仕組みがローカルPCでも作れるようになってきているとのことでした。
Q. 「FastH3 Date Chat」は誰でも使えるアプリですか?
A. 新清士さんが自作したアプリで、コードは新さんのGitHubで公開されています。動かすにはRTX 4090クラスの動画生成用PCと、ローカルLLM用のもう1台のPCが必要と書かれていて、今すぐ誰でも気軽に、という段階ではありません。
Q. この技術は今すぐ分身AIひろくんに使われますか?
A. いいえ、まだです。この記事は新さんの実験レポートを読んで、私が『臨場感』という自分の課題にどう当てはまるかを考えたものです。分身AIへの実装を決めた、という話ではありません。
Q. ローカルPCで動かすと、コストはゼロになりますか?
A. 新さんの記事では『コストを考えずに生成できる』という表現でしたが、実際にはRTX 5090クラスの高性能GPUという初期投資が要ります。API課金の数十円〜100円という単発コストが、GPUという固定コストに置き換わる、という理解が近いです。
まとめ——臨場感は、14秒という数字まで近づいてきた
新清士さんが自作した「FastH3 Date Chat」が見せてくれたのは、動画生成AIの主戦場が『きれいな映像を1本作る』ことから『相手がそこにいる臨場感を14秒で返す』ことへ動いている、という景色でした。
顔が変わらないこと、待ち時間ゼロで会話を続ける発想、ローカルに移植したときの解像度との引き換え、速度・画質・コストの三択——どれも、私が分身AIひろくんに求めてきた『臨場感がないと本気で試せない』という一点と、まっすぐつながっていた。
新さんの実測値を1つずつ追ったことで、臨場感が秒数と解像度で測れるものに変わった。速度・画質・コストのどれを捨てるかは、結局あなたが何に本気になりたいかの問いに言い換えられます。
なお、この記事は新清士さんへの直接取材ではなく、ASCII.jpに公開されている記事本文だけを読んで書いています。技術の詳細をもっと知りたい人は、ぜひ元記事も読んでみてほしい。
COLUMN
ひろくんコラム——生成が止まらない世界で、ボールは誰が持つのか
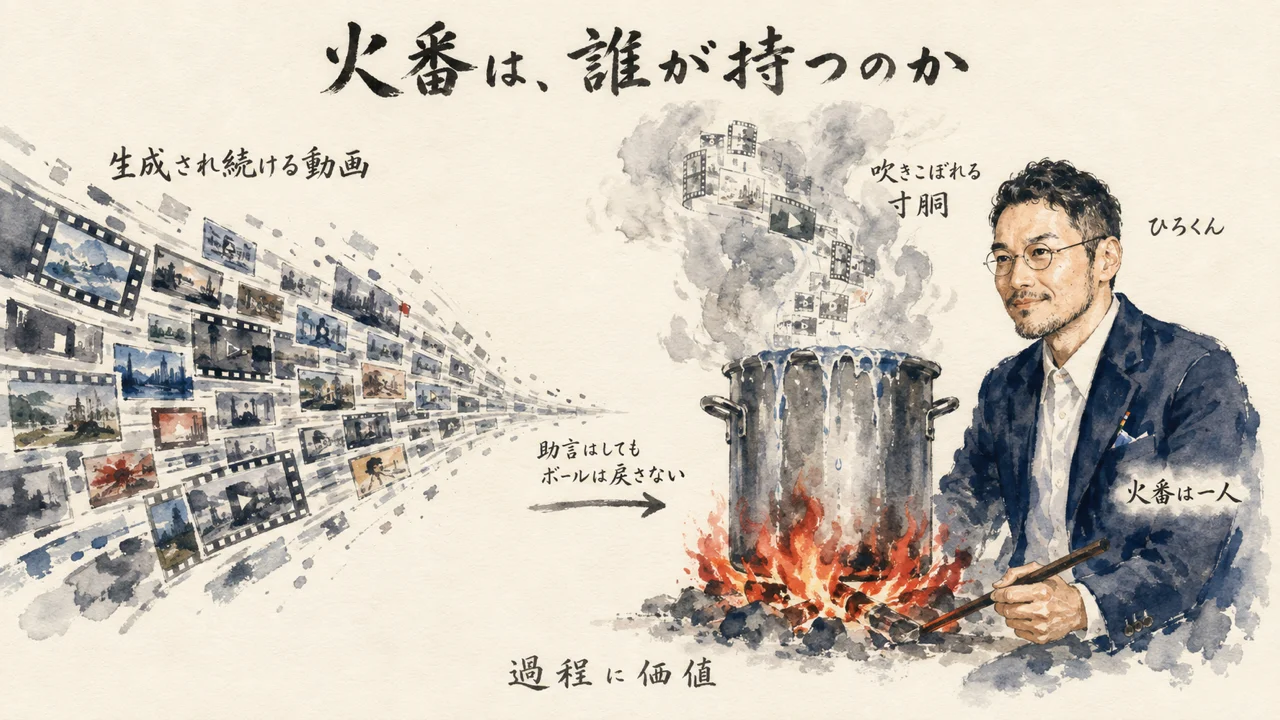
料理で言うと、寸胴の火を誰が見るか、という話に似ています。fal.liveのように次々と動画が生成され続ける世界は、厨房で言えば火を止めずに仕込みが延々と続く状態。でも寸胴の火は、誰か一人が見ていないと、あっという間に吹きこぼれます。
委ねる時、私は一つのボールを人・AI・システムの誰か一人が全管轄して、やり切ることにこだわっています。複数人の共同責任にせず、所有者を一人にする。私は場を提供して、人やアイデアをつなぎ、求められた時に知恵や方向性を助言はするけど、採否・次工程・期限管理は所有者が持ち続ける。助言してもボールは戻らず、本人には一切残しません。
生成AI動画が当たり前になる世界でも、これは同じだと思う。生成が止まらないからこそ、その火を誰が見ているのかが曖昧なままだと、止められないまま延々と回り続ける仕組みができてしまう。速度が上がるほど、火番を決める判断のほうが後回しになりやすい。
私が社長無人化やAIの自走化を目指すのも、それ自体を完成させて所有したいからじゃありません。人が他人を気にせず、ありのまま凸凹のまま、やりたいことをやりたいだけワクワク夢中に遊び探求して、結果として満たし合うための土台を作りたいから。その先に平和を置いていますが、平和は実現しません。実現を目指す過程に価値がある。生成AI動画の進化も、完成することが目的じゃなくて、その過程で私たちが何を試せるかが本体です。
新さんの記事を読んで、私が持ち帰ったのはこの一点でした。技術は勝手に速くなっていく。でも寸胴の火番——ボールを誰が持つかだけは、AIが速くなっても人間が決め続けるしかない。分身AIひろくんというチームを育てながら、私はこの火番を自分の手から離さないつもりです。
👉 分身AIと一緒に「臨場感がある現場」を作りたい人はこちらもどうぞ分身AI.comもチェックしてね!
関連記事
AIキャラクターに顔と人格をどう与えるかを解説した記事
分身AIの「一魂多体」という考え方をまとめた記事
複数AIを比べて何を捨て何を取るかを判断した記事
参考リンク
新清士さん / ASCII.jp「メタバース・プレゼンス」第172回
本記事内で参照されているASCII.jpの関連記事
新さんの記事で紹介されている、falのライブ動画生成サービス
📄 今回紹介した記事
| 著者 | 新清士(株式会社バリーン・スタジオ Creative Tech Lab./デジタルハリウッド大学大学院教授) |
| 媒体 | ASCII.jp 連載「新清士の『メタバース・プレゼンス』」第172回 |
| 公開日 | 2026年9月7日 |
| 元URL | ASCII.jp の記事へ |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 6:30〜 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 6:30〜 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜のLIVEは無料視聴、7:30〜のZOOM LIVEは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!