WATCH REPORT
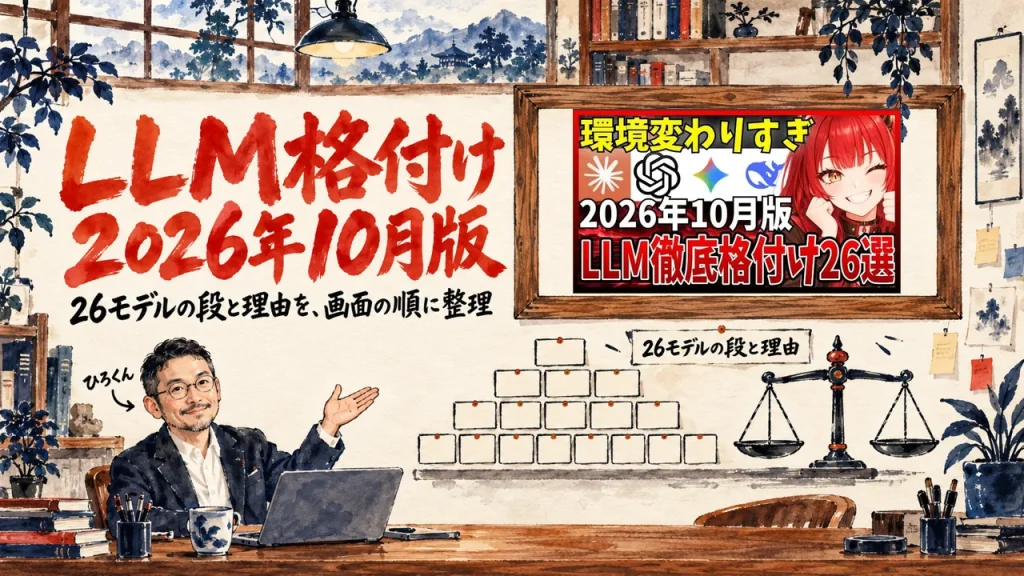
LLM格付け2026年10月版。Claude・GPT・Gemini・DeepSeekなど26モデルの段と理由を、動画で整理
2026.10.18
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル まさおAIじっくり解説ch で、まさおさんが、2026年10月のLLM26モデルを段(ティア)に並べて格付けし、1つずつ理由を話した動画を紹介します。
Claude、GPT、Gemini、DeepSeek、GLM。モデルが多すぎて、どれを選べばよいか迷っていませんか?この記事は、格付けの動画を通しで見る時間が無い人でも、段と理由を画面の順に追えるようにまとめます。
私も、窓口役の席に新しいモデルを置いて試したら、朝の棚卸し1回の消費が見積もりを大きく超えて、取りやめたことがあります。段の高さだけで選んだ席ではありませんでした。だから格付けは、段より先に、使う場面と理由を見たくて読みます。
動画は約23分。まさおさんが、自分で作った段表のアプリに26枚のモデルのカードを置きながら、god から E までの段と理由を話していきます。Opus 5.5 を god に、Fable 5.1 と Sonnet 5.5 を SS に、Argon・Sol・Astra を S に置き、安い側の DeepSeek・GLM・Haiku・Flash 系は使いどころを分けて見せます。
読み終えると、26モデルの段と理由を、動画を見なくても画面の順に追えます。まさおさんの段とAIの段の読み方も分かる形に。その横に、私の席の決め方の実測と、私なら、という判断を添えました。
SPEAKER
まさおさん
YouTube のチャンネル まさおAIじっくり解説ch で話している人です。この動画では、自分で作ったLLM tier 表というアプリを画面に出し、26個のモデルのカードを段に置きながら、理由を一人で話します。AIサービス開発に携わるエンジニアと自己紹介しています。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)目次
- LLM格付け26モデルの見方。まさおさんの段とAIの段の2本立て
- Claude Opus 5.5がgodの理由。速さとトークン効率がそろった
- Fable 5.1はなぜSSなのか。godから落とす理由と助言役の使い方
- DeepSeek V4.1 FlashはB+、Sonnet 5.5はSS。値段で見る
- GLM-5.3とKimi K3の段。値段と提供の安定性で順位が変わる
- Muse・MiMoの段。動画や音声を入力できる勢を整理する
- Grok 4.7からQwen3.8まで。中堅から下の8モデルの段
- Gemini 3.8 FlashはB+、Gemini 4 ArgonはS。動画入力の強み
- Haiku 5.5とGPT-6のLuna・Sol・Astra。安い席とレビュー役の段
- Fable 5.5の予想と26モデルの最終の段表。段は毎月入れ替わる
- よくある質問
- まとめ。段は答えではなく、自分の使い方に置き換えて読む
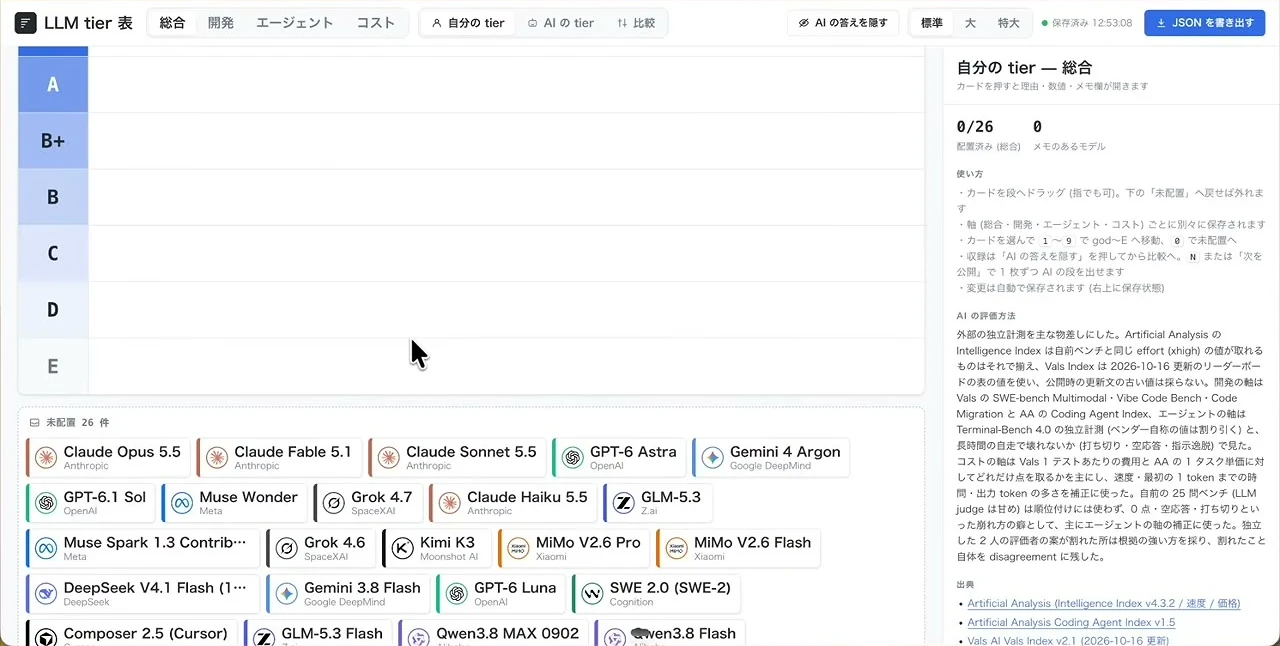
10月18日版のLLM26モデルの格付けは、環境がガラッと変わった、という話から始まります。前回の9月版から1か月半ぶり。動画は、今どれを選べばよいかを、モデルごとの理由と一緒に話すものです。
まさおさんは、観点を開発・エージェント・コストに置き、AIと事前にすり合わせて段を分けた、と話します。
ねらいは、今このモデルが熱い、ここを選んでおけば外さない、という所を伝えること。
まさおさん(動画の中で・0:40〜)
ま、これ選んどけば間違いないみたいなものを紹介できたらなという風に思っております。
出だしの見立ては、今の環境では Claude のモデルが結構リードしている、というものです。
まさおさん(動画の中で・1:04〜)
ま、今の環境に関してなんですけどね、ま、クロードのモデルが結構リードしてるんじゃないかなと。
Grok 4.7 は世間の評判がいまひとつでも自分はどう見るか、Gemini 4 Argon は Opus 5.5 と比べてどうか、にも触れる、とまさおさんは話します。
画面は、まさおさんの主観の段と、AIの段の2本立て。AIの段は、まさおさんの評価に、いつも作るデモのソースコードと外部の評価を照らした物です。
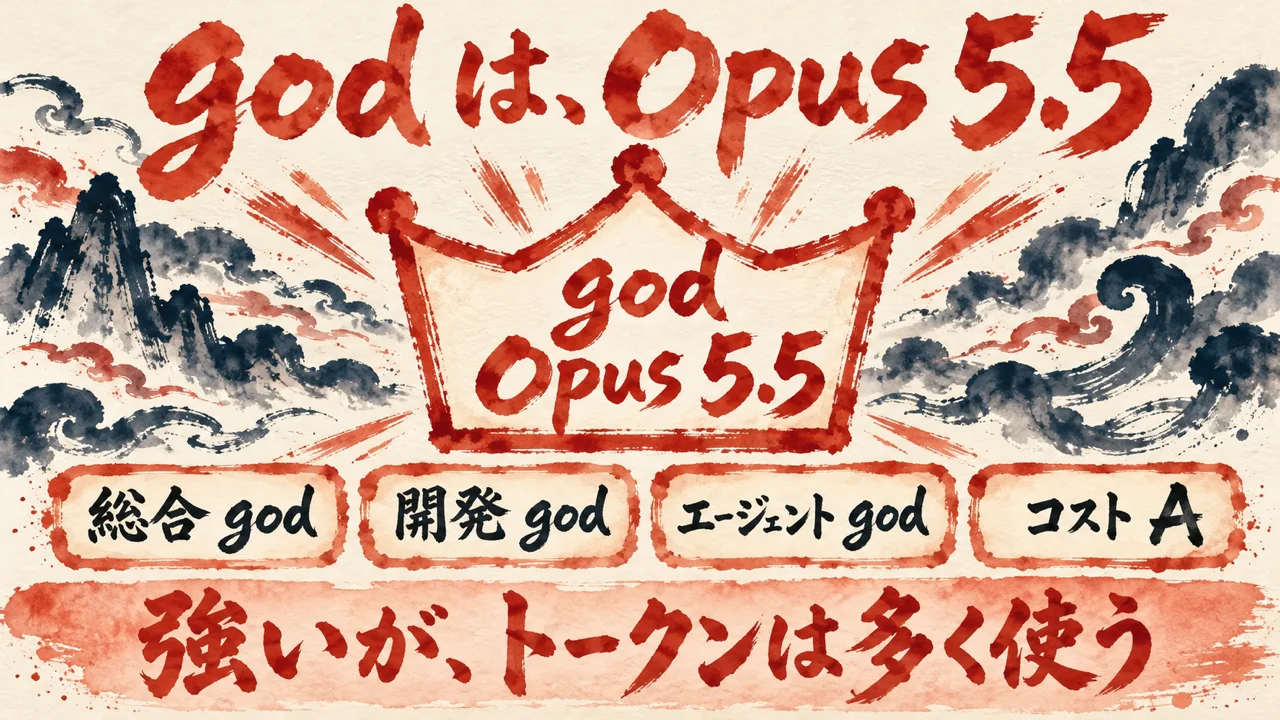
10月の環境で god に置かれるのは、Claude Opus 5.5 一択。少し前までは、Fable だろうという空気でした。そこがどう入れ替わったのか?動画はこの判定から入ります。
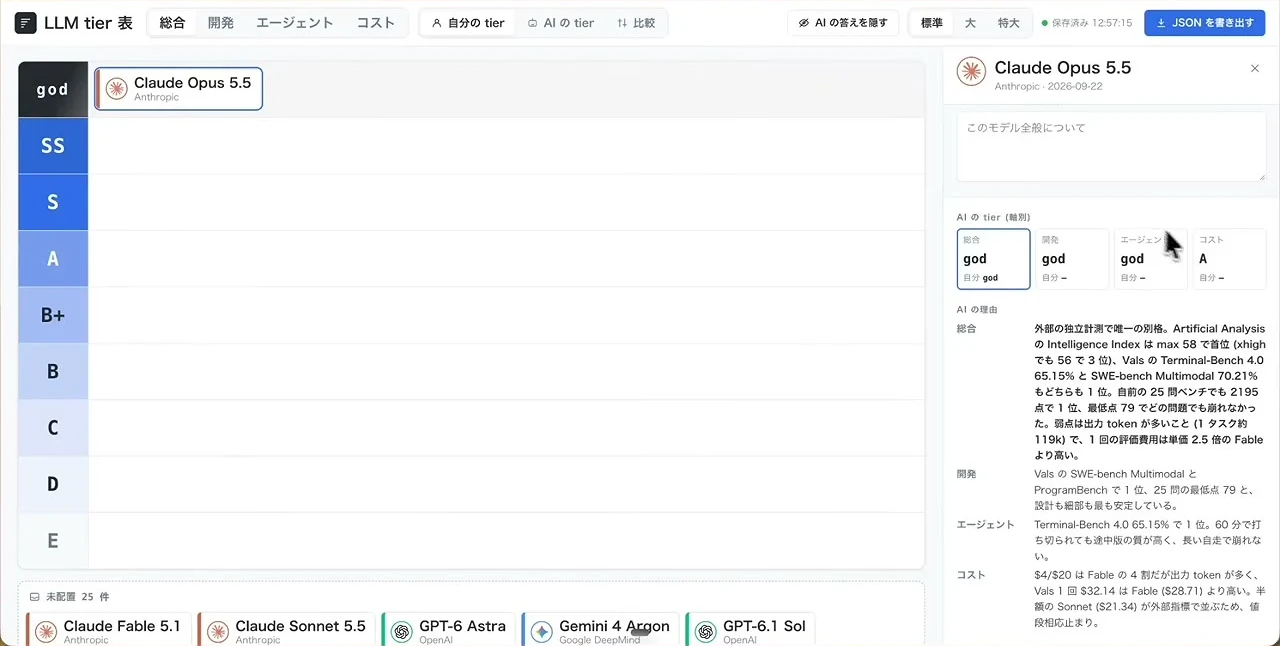
まさおさんは、Opus 5.5 のカードを god の段にドラッグして置き、総合・開発・エージェントのどれでも優れている、と話します。
AIの段は、総合・開発・エージェントが god で、コストだけが A。評価者2人で割れたのも、コストの所だけでした。
まさおさん(動画の中で・1:47〜)
アーティフィシャルアナリシスとかでもね、え、かなり性能ベンチが良くなっているもので、え、あと何気にですね、TPS、え、クロードのサブスクとかで使っていても100以上のね、TPSが出たりだとか、
パネルには、Artificial Analysis の Intelligence Index が58、217モデル中1位、という数字も出ています。
トークンは多く使うモデルで、マルチエージェントを基本的により使う、とまさおさんは話します。
一方で、Claude のサブスクで使える量が減るという案内の中でも、全部使い切るのが大変と言われるほど、トークン効率は良くなった、という話です。
まさおさん(動画の中で・2:31〜)
トークン効率とかもね、え、良くなっていて、もう開発においても動画作成とか、え、何においてもですね、
Opus 5.5 の単価は、この動画で値段を比べる時の基準になります。
god の理由は、強さと速さとトークン効率が、同じ向きにそろったこと。3つのうち1つでも欠けると、毎日の仕事の真ん中には置きにくい。一択と言われる中身は、そこです。
9月24日の記録。私は、Opus 5.5 の既定の強さ(effort)を medium にそろえました。設定に effort が xhigh のまま残っていて、強さを決めずに起動した Claude は xhigh で動いていたからです。モデルを席ごとに割り当てる私のルールでは、Opus 5.5 は medium が既定。実際の設定を、ルールに合わせて直しました。直す前に、私は、AIに、opus5.5 はミドルデフォルトがいいかな、どう思う、と問いかけています。
段でモデルを選んだあとに、もう一つ決めることがあります。使う強さの既定。強いモデルほど、ここが効きます。
god を選ぶことと、god をどの強さで動かすかは、別の判断。
私なら、いちばん上のモデルほど、既定は途中の強さにして、必要な時だけ上げます。
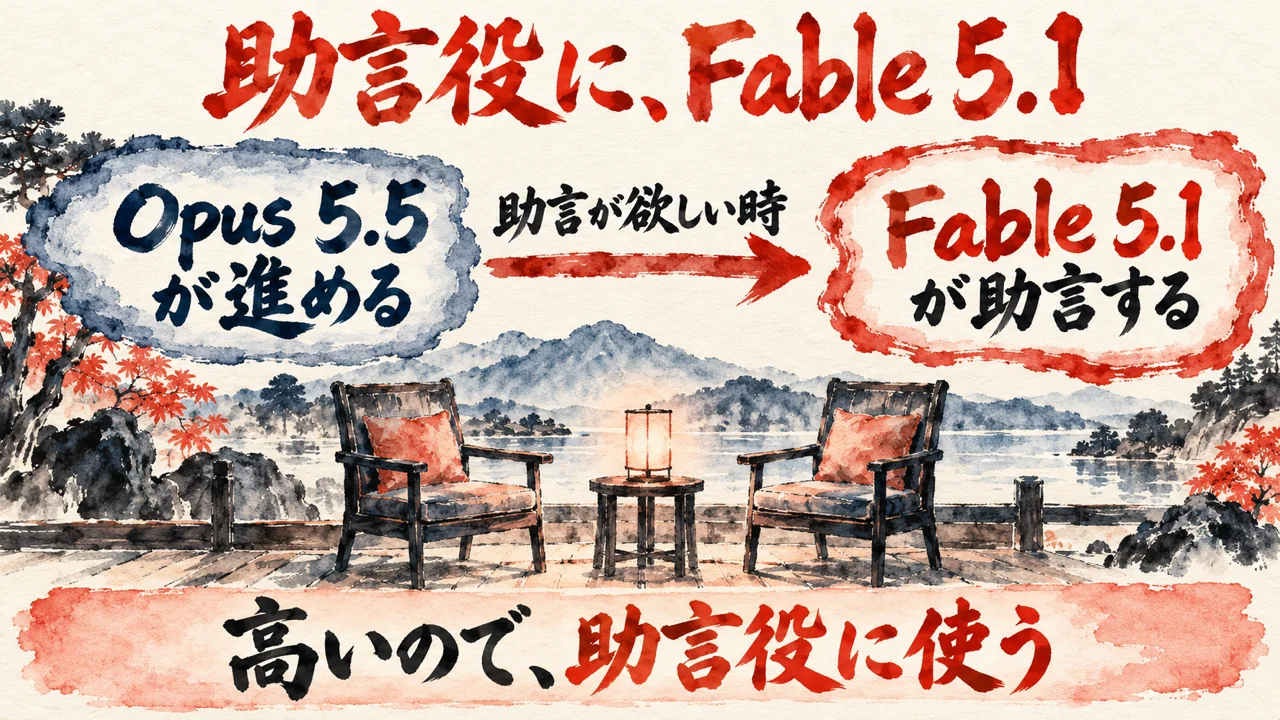
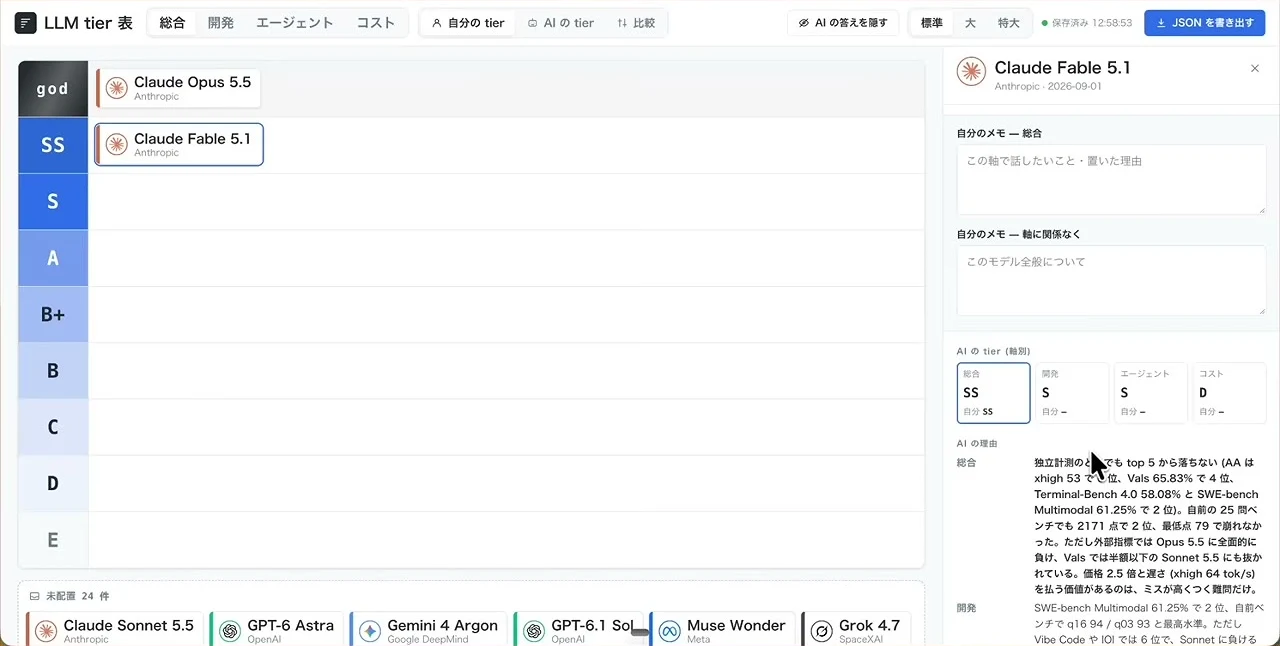
Fable もめちゃくちゃ良い。そう認めたうえで、まさおさんは Fable 5.1 を SS に落とします。なぜ god ではないのか?理由は、コストと世代の2つ。
SS に落とす理由のひとつはコスト。Claude のサブスクには、週ごとに使える量の制限があります。
ふたつ目は世代。守備範囲の広い Opus に対して、Fable 5.1 は1世代前で、文章表現などで認知負荷の指摘もある、とまさおさんは話します。
一方で、メタ視点の深さがあり、Opus では厳しい部分を拾ってくれる、という評価です。
まさおさんがよくするのは、Opus が仕事を進めながら、助言が欲しい時に Fable に頼む使い方。難しい対話では、Opus・Fable・Argon・Astra などを交ぜて、Best of N のように使うこともあります。
パネルには、Fable 5.1 の単価が Opus 5.5 の2.5倍と出ています。AIの段は、総合 SS、開発 S、エージェント S、コスト D。
まさおさん(動画の中で・3:57〜)
SSランクかなと思います。多分5.5が来るとですね、ま、ゴッドランクあるいはそれ以上になったりする可能性高いかなとは思っているんですけれども、ま、コストは気になるポイントではね、引き続きあるかなと思います。
パネルの要約は、価格2.5倍と遅さを払う価値があるのは、ミスが高くつく難問だけ、というもの。
Fable 5.5 が来れば、god かそれ以上になるかもしれない、と話します。それでもコストは気になる、というのがこの段の締めです。
9月19日の記録。当時は Opus 5 の頃で、私は、Claude の既定を Opus 5 の medium と決めました。Fable 5.1 を呼ぶのは、名義と魂が要る場面、長時間の自律、Opus 5 で届かない判断の3場面だけ。使う所では使う、Claude は Opus が既定、とAIに伝えています。
私の席では、高い席は、使う場面を3場面に絞っています。
同じアプリを3つ作らせた検証は、Opus 5.5・Fable 5.1・GPT-6に同じアプリを3つ作らせる検証を読んだ記事に書きました。
私なら、高い席は、使う場面を3つまでに絞って書き出してから呼びます。
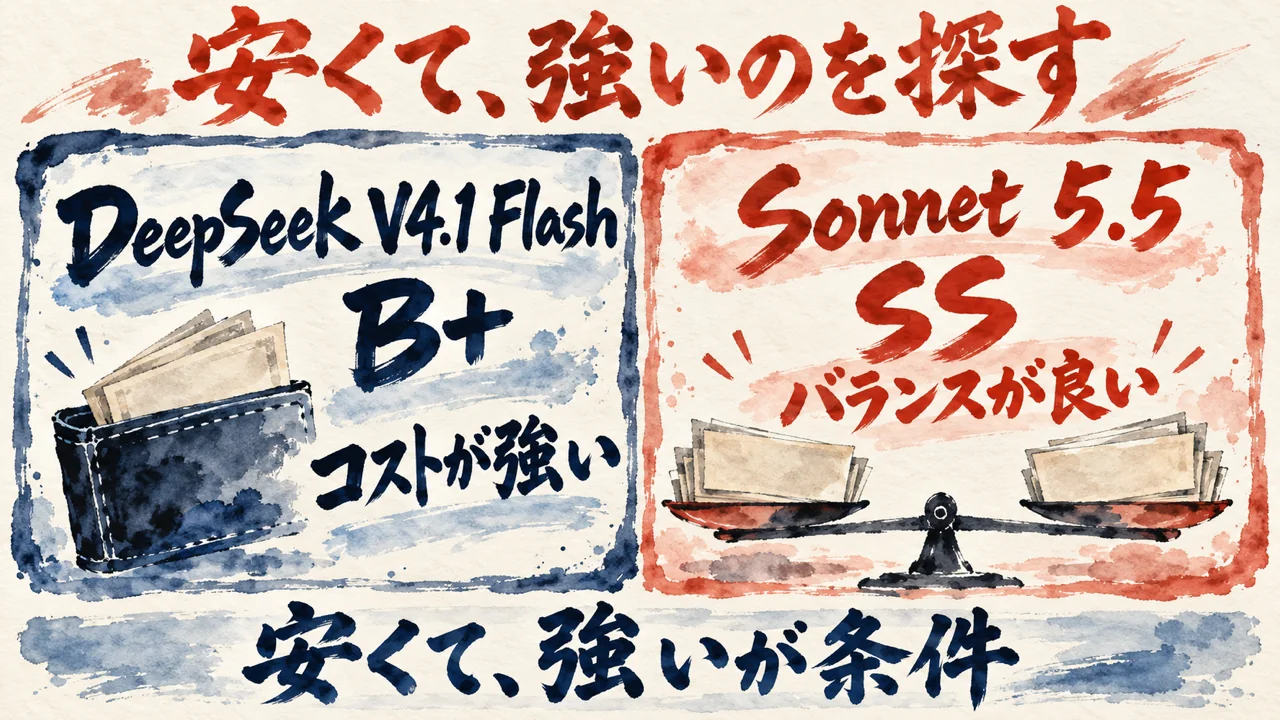
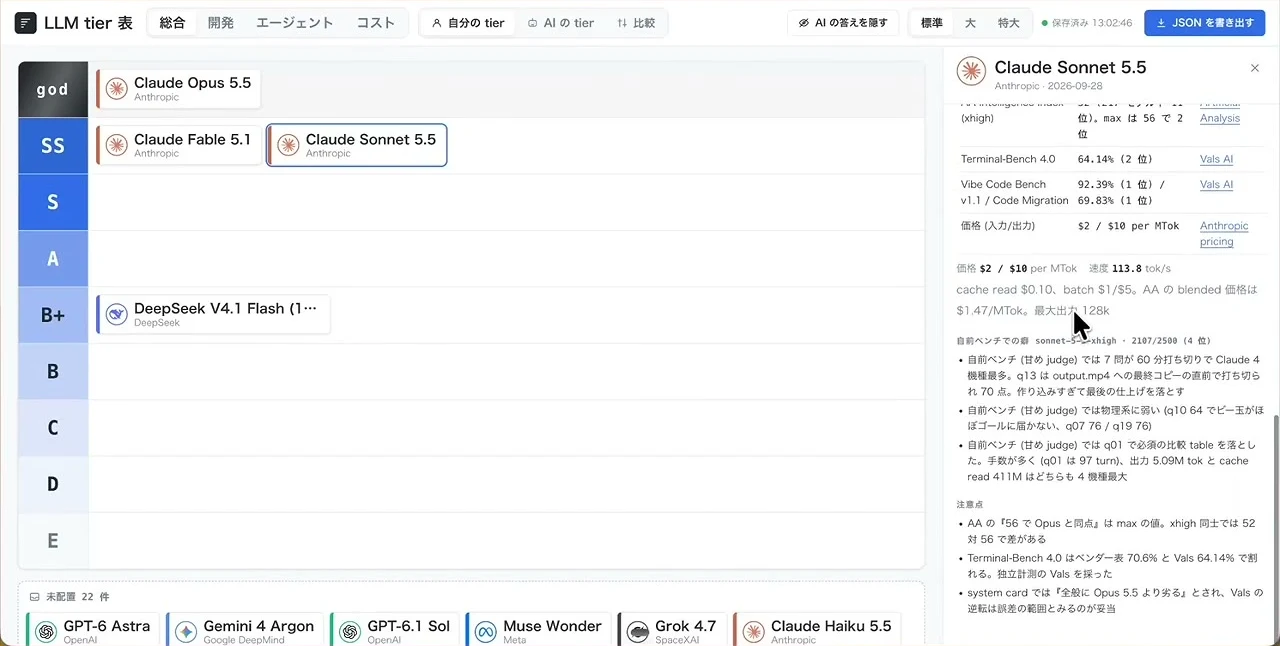
安いのに強いモデルを、段表のどこに置きますか?第4章で扱うのは、動画の前日に出た DeepSeek V4.1 Flash と、値段あたりの強さが大きく良くなった Sonnet 5.5 の2つ。値段の軽さを段にどう映すか、という話です。
まさおさんは、前日に出たばかりの DeepSeek V4.1 Flash を、コストがめちゃくちゃ良いモデルとして紹介します。
Opus 5 系と比べても、コストあたりで見た DeepSWE など、開発系のベンチは強いという見立て。
それでも、自分の段は B+ に抑えます。AIの段は、総合 B、開発 B、エージェント C、コスト SS。
まさおさん(動画の中で・5:33〜)
でもやっぱりな何て言うのかな、結局個人的に安かろう悪かろうじゃダメなんですよね。安くて強力っていうのが、ま、あの、重要かなと思っていて、
使う頻度で見れば、A まで上がりそうな所。それでも、一般的な利用なら B+ が無難、という判断です。前日に出た版は DeepSeek 自社の仕組みに合わせて作られ、サーチ系のAPIも加わりました。
パネルには、新しい版の改善は自社の発表だけで、独立した計測は無い、という注意も添えてあります。
次は Claude Sonnet 5.5。値段あたりの強さがめちゃくちゃ良くなったので SS に置く、とまさおさんは話します。
まさおさん(動画の中で・6:26〜)
これソネットね、もうコスパがめっちゃ良くなってるんでSSに置きたいなと思います。
AIの段は、総合 SS、開発 SS、エージェント A、コスト SS。認知ドリフトは少し気になる、とも話します。
Sonnet 5.5 の単価は Opus 5.5 の半額で、出力は 113.8 tok/s。
パネルの Vals は 67.04% で2位。Opus 5.5 の 66.97% を、わずかに上回ります。
パネルの要約は、既定の主力にして、難題だけ Opus へ。弱点は、自前ベンチで7問が60分で打ち切りになった点です。
10月6日の記録。私は、Sonnet 5.5(強さは medium)で動く、窓口役のAI席を試しました。
窓口としては動いたんです。ただ、朝の棚卸し1回が約222万トークン。重さを見て、私の判断で取りやめました。
設計の案での見積もりは、1日6〜12万トークン。
原因は、呼び出しのたびに約9万トークンの前提資料(正本・ルール)を読み直す分を、数えていなかったことです。
だから見積もりは、設計の段階では出さず、1回走らせた実測から出す形に替えました。
単価の安さだけでは、この重さは見えません。呼び出しのたびに読み直す分まで入れた総量で見る必要がありました。
新しい版の変更点は、DeepSeek V4.1 Flash の新版が、前の版から何が変わったかを読んだ記事に書きました。
私なら、安いモデルほど、常駐させる前に、1回走らせた総量を測ります。
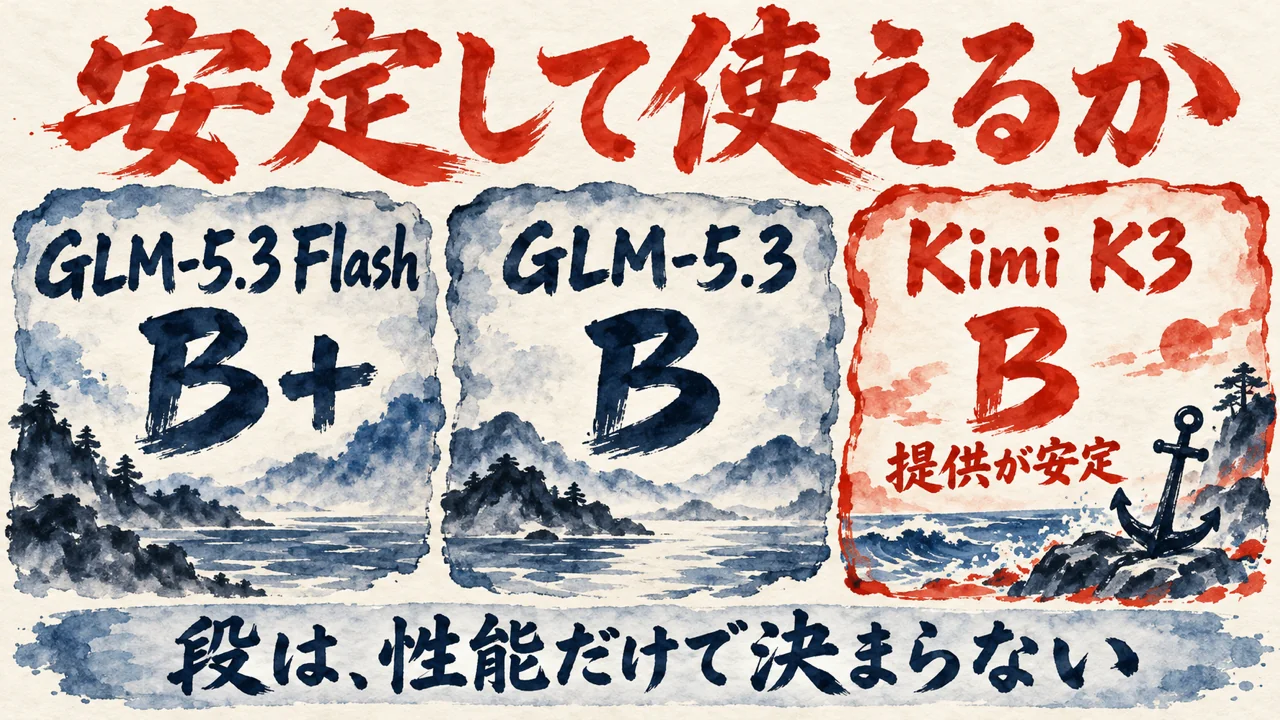
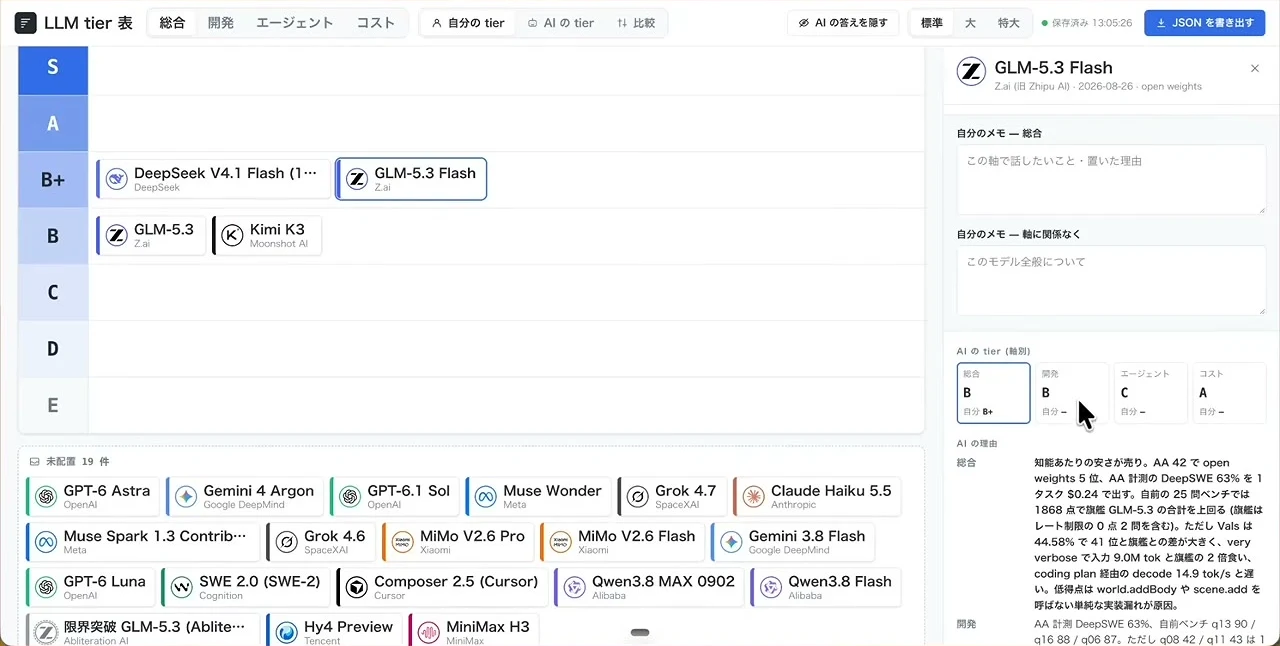
段表は、真ん中のラインへ。GLM-5.3 は B、GLM-5.3 Flash は B+、Kimi K3 は B。同じ GLM なのに、なぜ段が分かれるのでしょう?
まさおさんは、GLM-5.3 を B、GLM-5.3 Flash を B+ に置きます。Flash のほうがコストパフォーマンスが良いので、高めの評価。
Artificial Analysis のコスト対タスクの図では、以前は GLM や Haiku がよい位置にいました。GPT-6.1 Sol の登場で、上のラインを持っていかれた、という話です。
Flash 系は、0.5世代前の位置へ。更新のスピードが速い、とまさおさんは話します。
好きなのは GLM-5.3 のほう。それでも、提供の安定性は Kimi のほうが良いので、Kimi K3 は B に置きます。
AIの段では、GLM-5.3 Flash はコストが良く開発も良いのに、エージェント的には C。無印の GLM-5.3 は AI だと B+ でしたが、使用感からまさおさんは B にしました。
値段を考えて評価を薄くすると、順位の反転も起こる、という話。
まさおさん(動画の中で・9:04〜)
ま、あくまでね、僕の主観でやっておりますので、ま、その辺り気になる場合はですね、ま、皆さんアーティフィシャルアナリシスの通りにやっていただければとは思うんですけどね。
B+ の段には、DeepSeek と GLM-5.3 Flash が並びます。
B の段には、GLM-5.3 と Kimi K3 が並びます。パネルには、open weights の中で上位に入る、とあります。
限界突破と付いた GLM-5.3 のカードも置かれています。まさおさんの段は B+、AIの段は C。
1つの表の段は、1人の重みの置き方。私は、その重みが自分の仕事の重みと合っているかを確かめます。
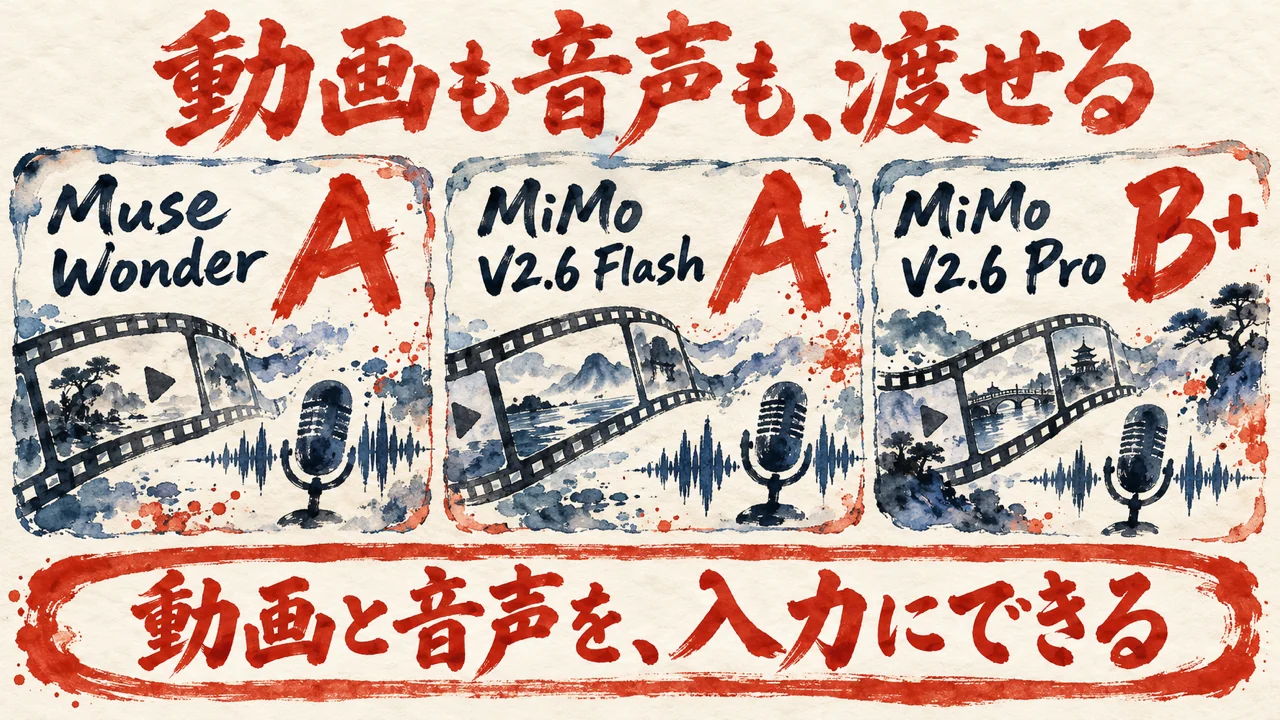
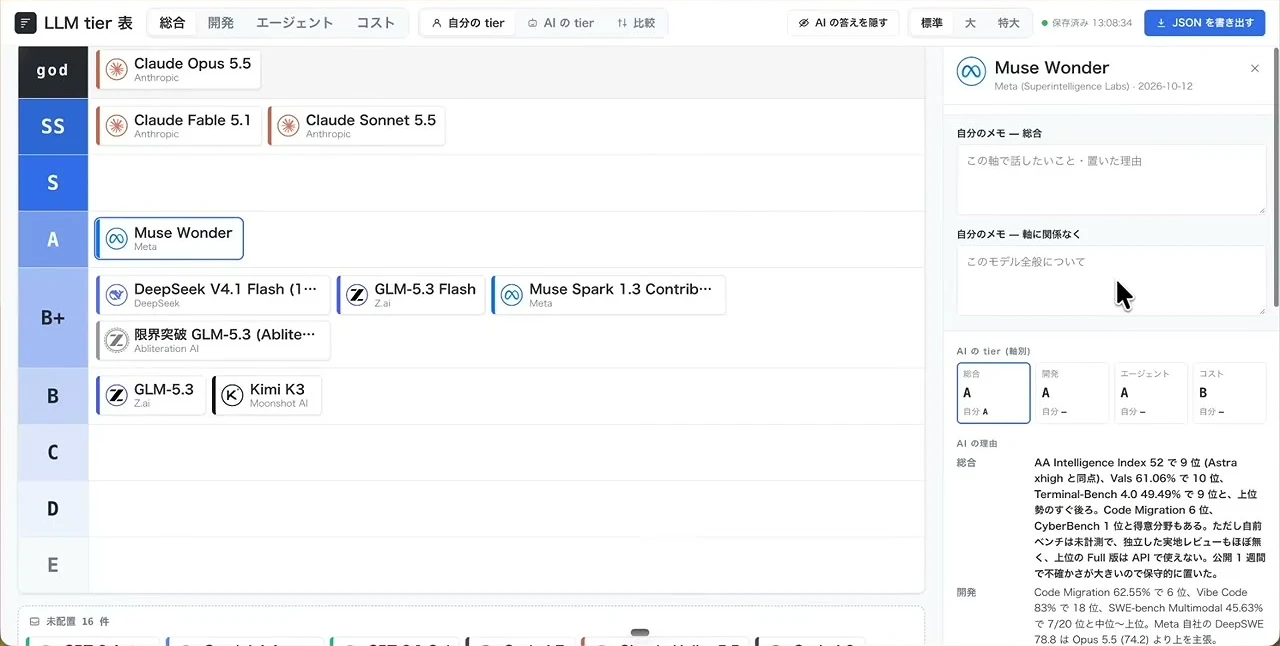
動画や音声を、そのまま入力に持てるモデル。まさおさんの整理では、Muse と Gemini 系、そして MiMo もいける側です。第6章は、この入力の幅を持つ勢の段を追います。
Muse Spark 1.3 Contributor は、まず B+ に置かれて、最終は B。Contributor 枠はコストが激安で、コストが落ちなければ B にしたくなる、という話です。
視聴者のコメントにも、データ生成に使うのがいい、という声がありました。TPS もしっかり出ていて面白い、とまさおさんは話します。
パネルには、標準版の約12分の1の単価とあります。入出力が Meta の学習に使われる代わりの割引枠で、社外秘のコードには使えない、という注意つき。
マルチモーダル入力に対応してくる Muse Wonder は A です。動画の映像を渡した時の返答がかなり良い、とまさおさんは話します。
まさおさん(動画の中で・10:04〜)
一方でマルチモーダル入力も結構対応してくるミューズワンダーは僕はね、Aランクぐらいに置きたい感じはしますね。
コストだけ少し気になるものの、全体的には悪くない、という評価。パネルには、Intelligence Index 52 で9位と出ています。自前ベンチは未計測で、実測すれば段が動く可能性が高い、という注意も。
MiMo は、Flash を A、Pro を B+ に置きます。出た時はあまり評価されなかったのに、Artificial Analysis のコスト対タスクでは、かなり強い位置にいます。
Flash は、とんでもなく安いのにマルチモーダル入力ができるモデル。Pro も悪くないが、Flash のほうがよい気がした、とまさおさんは話します。AIの段は Flash が B で、コストの部分が割り引かれています。
Opus や GPT-6.1 Sol を使っていると、他は結構離されている印象だ、という話も。DeepSeek V4.1 の比較相手は1つ前の Opus 5 なので、頻繁には使わない、という見方です。
ベンチマークの見方は、Muse Wonder のベンチマークを、Meta の表と外の会社の測定に分けて読んだ記事に書きました。
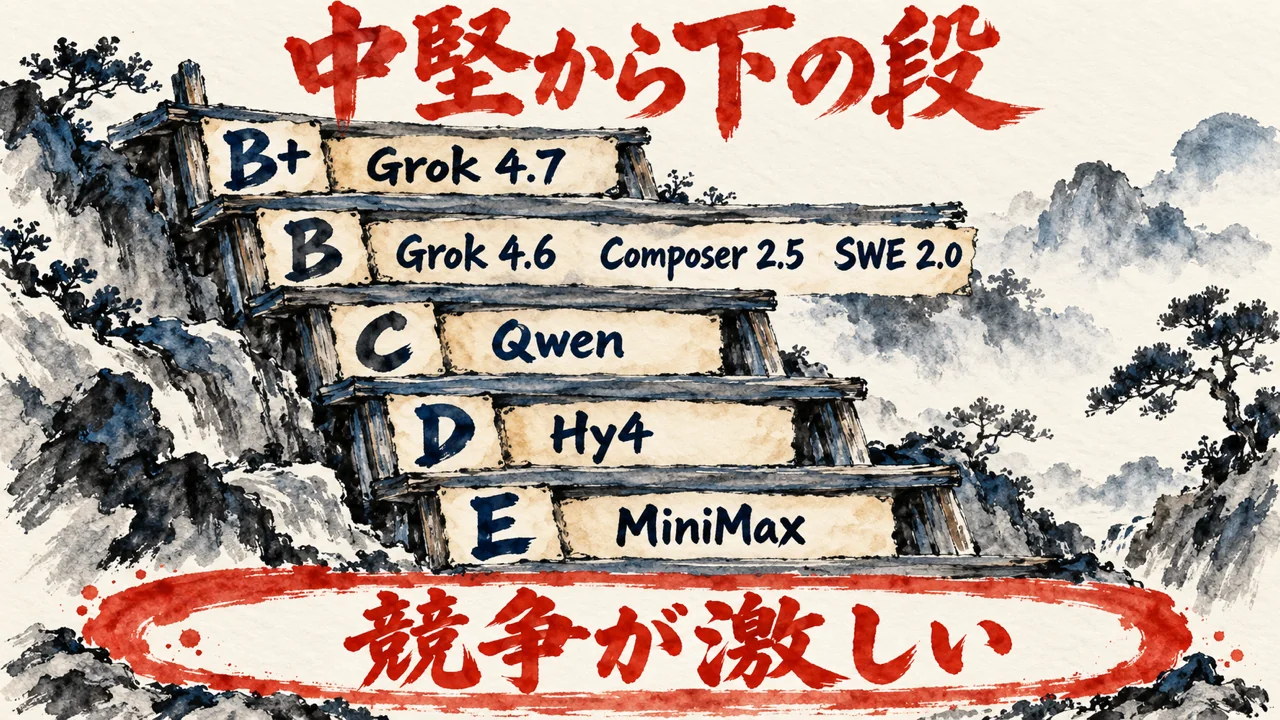
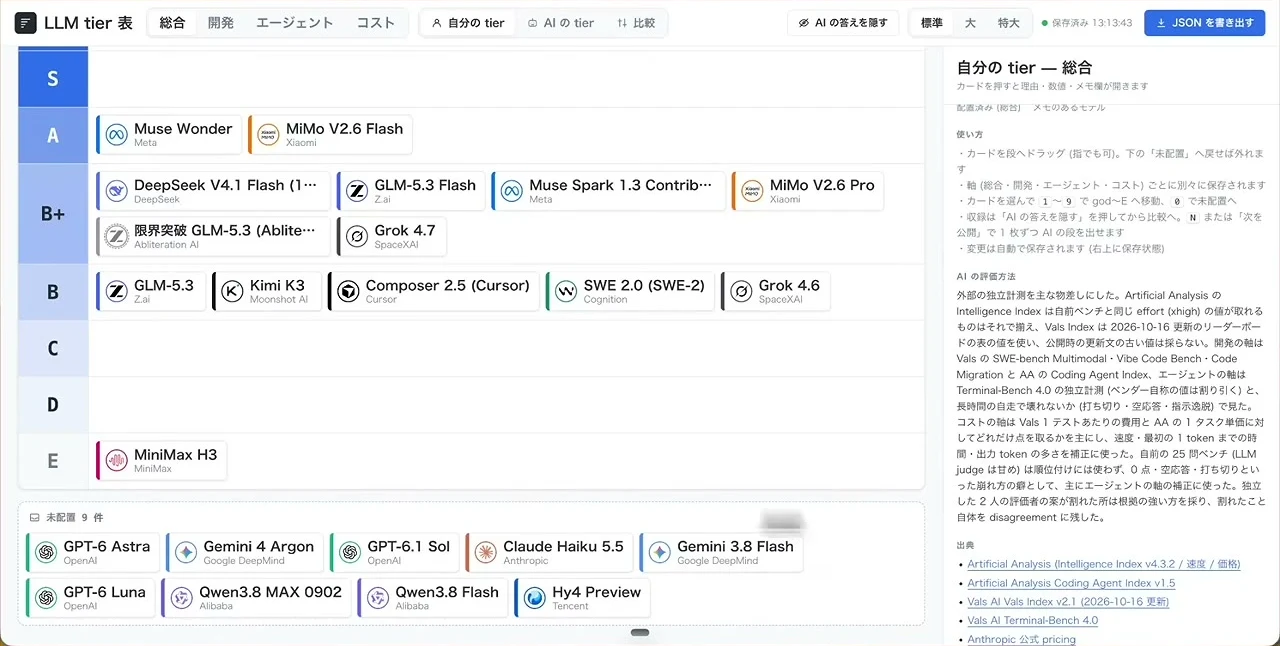
ここからは、中堅から下の8モデルを一気に追います。対象は、Grok 4.7 と Grok 4.6、Composer 2.5、SWE 2.0、MiniMax H3、Hy4 Preview、それに Qwen の2つ。テンポよく置かれていくのも、この章の特徴です。
Grok 4.7 は B+、Grok 4.6 は B に置かれます。4.7 は世間の評価がいまひとつでも、まさおさんは結構好き、と話します。
4.7 はコストの評価が低めでも、開発とエージェントはよい、という見方。ただ競合が強いので、この辺りに落ち着くそうです。パネルには、出力トークンが 4.6 の約2.5倍と出ています。
Cursor の Composer 2.5 は B です。Cursor で使うなら、Grok も含めてコストに対する割が良くなる、という話。今の世代から少し後ろにいても、なかなかいい、という評価です。
SWE 2.0 は、Kimi 系なので B くらい、と話します。Devin で無制限に使えるなら A、総合なら B+ のところを、性能を見て B に置きます。
MiniMax H3 は、コストのわりに性能は結構よいものの、今の世代だと1つ落ちる、という話です。E か D かで迷い、画面では E に置かれます。
Hy4 Preview は D。出た時は新しいモデルと紹介したけれど、コスト面まで含めると D くらい、とまさおさんは話します。パネルには、完了した問題は強いが任せられない、と出ています。
まさおさん(動画の中で・14:26〜)
ま、それぐらい競争が最近激しいんすよね。
Qwen3.8 MAX 0902 と Qwen3.8 Flash は、どちらも C です。開発のスコアは良くても、使用感に独特のクセがあって好きではない、という話。
Flash はコストがよく、MAX はコストが悪い、と分けて話します。パネルには、MAX の自前ベンチが定額プランの上限に届いてしまい、3問しか完走せず、順位の参考にならない、という注意が出ています。
表の端には、AIの評価方法として、Artificial Analysis や Vals AI など、出典のリストも並びます。
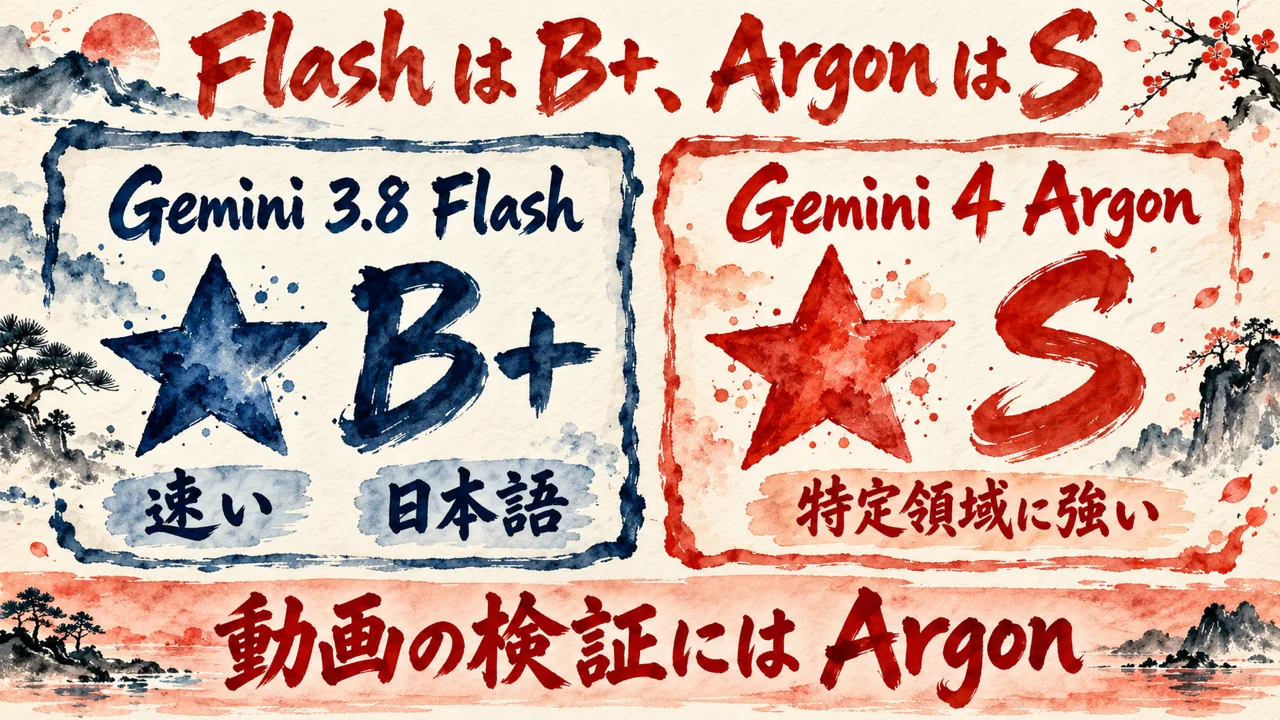
次は Gemini の2つです。Gemini 3.8 Flash は B+、Gemini 4 Argon は S。同じ Gemini でも、速さを取るか、突き抜け方を取るかで、段がはっきり分かれます。
まさおさんは、Gemini 3.8 Flash を B+ に置きます。右のパネルのAIの段は、ひとつ下の B です。主観と軸別の評価が、ここで少しずれます。
良い点として挙がるのは3つ。日本語ライティングのアップデート用途で使われること、動画などを入力に入れられること、それに速いことです。
前の環境なら A でもよかったけれど、今は強豪が多いので B のちょっと上くらい、という位置づけ。パネルは、速いが多弁で、数字ほどのアップグレードではない、と要約しています。
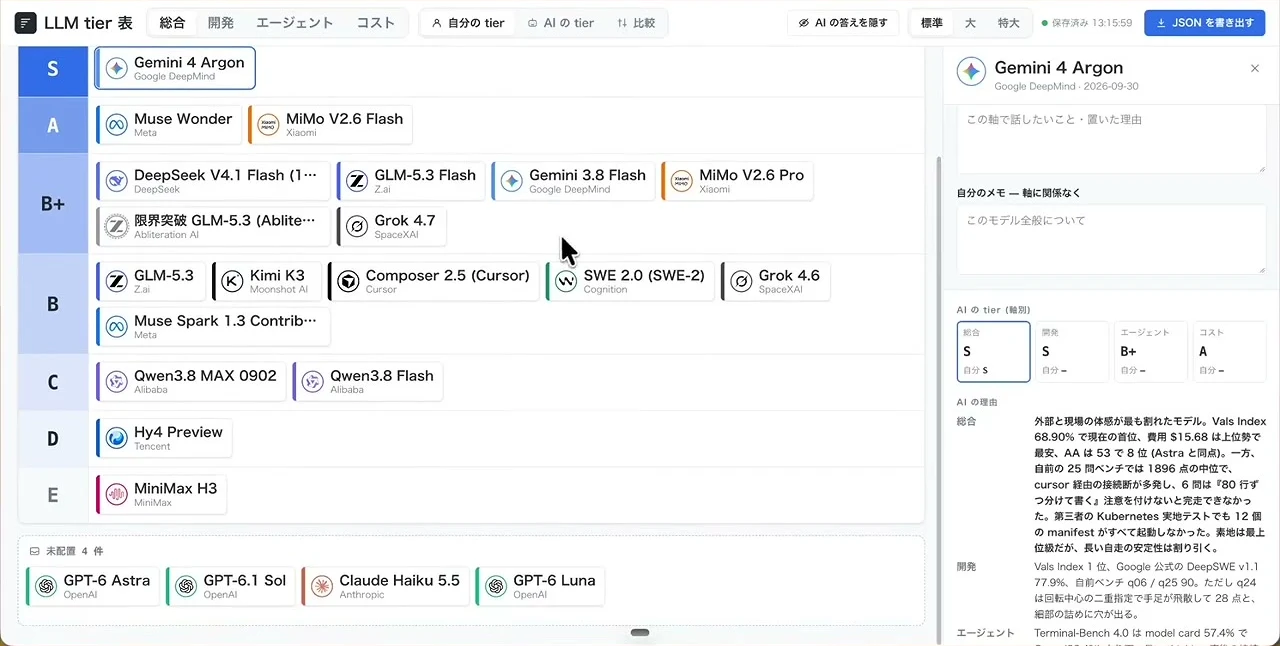
Gemini 4 Argon は S です。AIの評価も同じ S。特定の領域にめちゃくちゃ強いモデルだ、とまさおさんは話します。
まさおさん(動画の中で・16:02〜)
いや、これSかな。なんか特定領域にめちゃくちゃ強いっていうのがやっぱアーゴンなんで。
専門性のある質問では、突き抜ける時があるそうです。動画や音声を入れた時の精度も強み。動画系の検証枠として入れるなら Argon、という話です。
Argon のカードは、いったん A に置かれ、そこから S へ動きます。この時点の S の段は、Argon だけです。
パネルには、Vals Index 68.90%で現在の首位、と出ています。その一方で、外部と現場の体感が最も割れたモデルで、長い自走の安定性は割り引く、という注意も並んでいます。
Argon の注意も、同じ目で見ています。パネルの首位かどうかと、手元で長く任せられるかどうかは、別に確かめる物。
2026年10月18日の記録。朝のメルマガの文体がおかしいと感じた私は、書き直しを Gemini 3.8 に指名しました。
Gemini は、材料に無い語を足してきました。足された語は、材料の文字に1語ずつ戻しました。
うまく書けることと、材料に無い語を足さないこと。この2つは、別の力です。
私の文章で大事なのは、後のほう。うまく書けても、私が言っていないことが入れば、私の文ではなくなります。
日本語の文を整える席に、どこまで任せるか?
持ち場の違いでの比べ方は、Gemini 4 Argon と Claude Opus 5.5 を、持ち場の違いで比べた記事に書きました。
私なら、書き直しは材料と並べて、足された語を1語ずつ確かめてから使います。
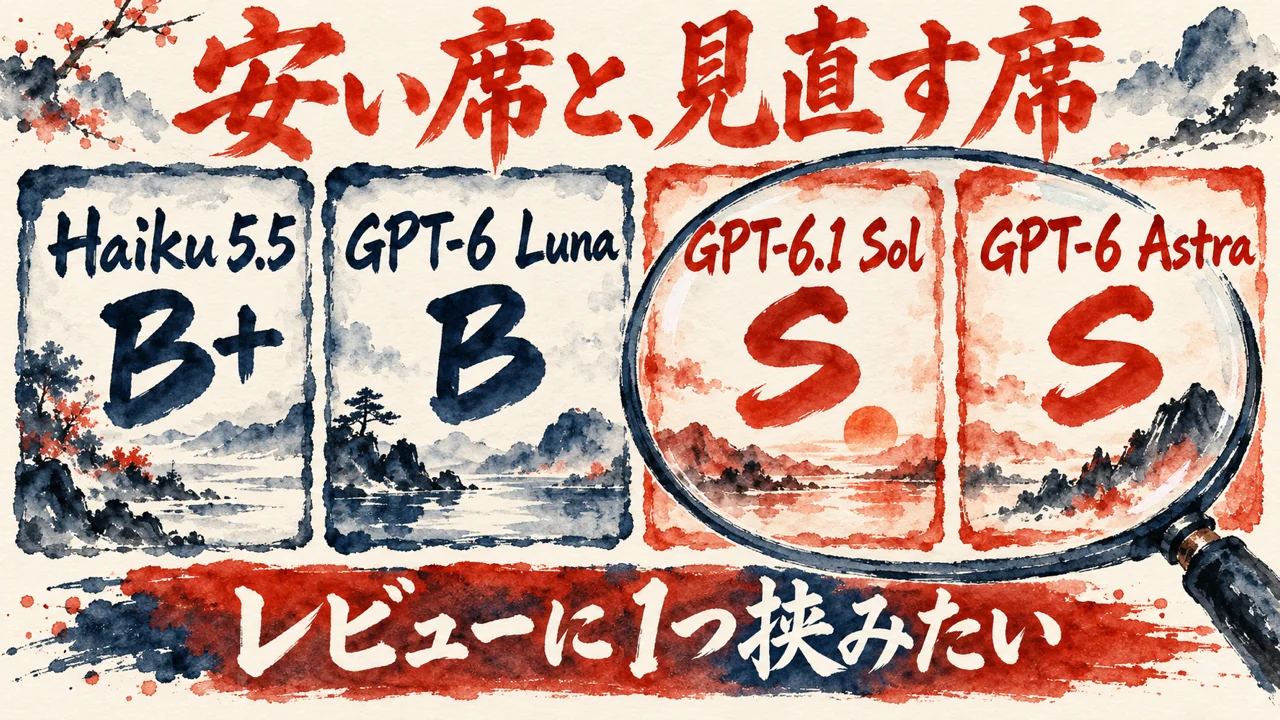
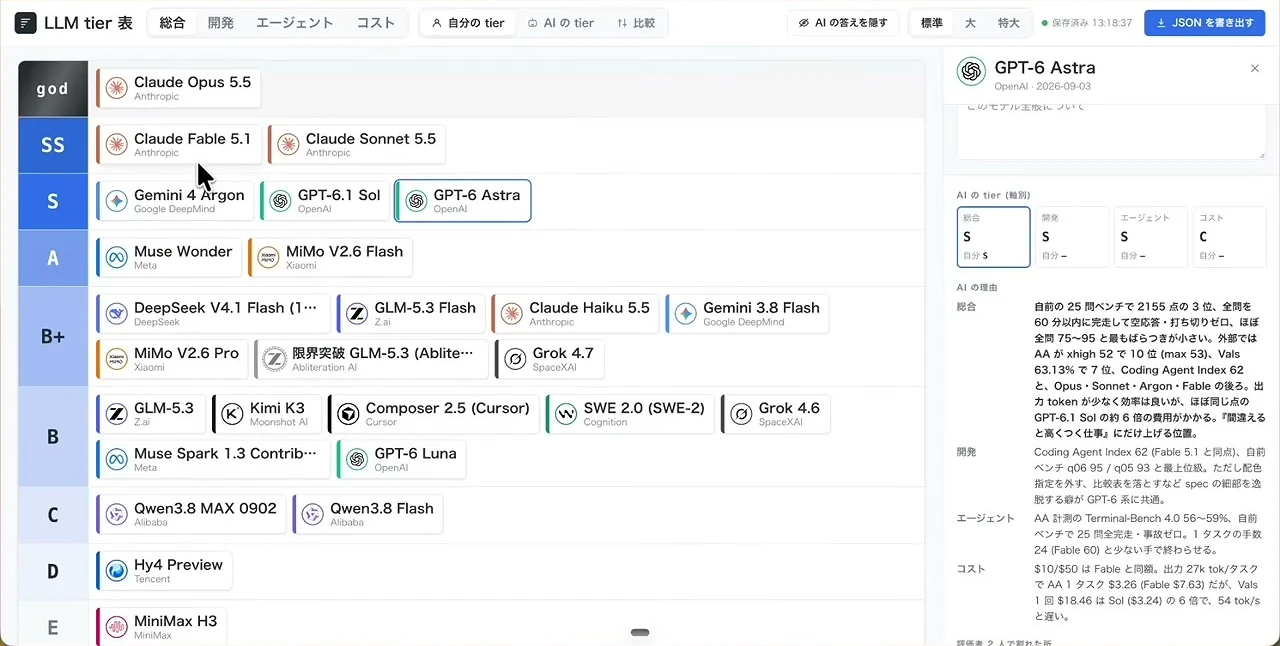
次は、安い席の Haiku 5.5 と Luna、レビュー役に挟みたい Sol と Astra です。段の違いは、使う席の違いでもあります。どの席に、どのモデルを置くのか?
Claude Haiku 5.5 は、登場は嬉しいけれど、厳しめに見ると B か、とまさおさんは話します。画面では、そのひとつ上の B+ に置かれます。
理由は、Opus と Sonnet のコストがかなり改善したこと。だから、わざわざ Haiku を使うのか、という所が出てくる、という話です。
まさおさん(動画の中で・17:08〜)
ま、サブエージェントとかね、ちょっとしたタスクとか外ループとかでね、使っていく、ま、最低限の性能みたいな形で登場しましたけども、とにかく安くはなったし、便利ではあるんですけど、
パネルには、単価が Sonnet 5.5 の20分の1ほど、と出ています。安さと速さは、はっきり強みです。
長い自走は弱く、subagent やログ読み、検索要約で使う位置だ、とパネルにはあります。
GPT-6 Luna は B です。Codex で使えるという意味では B+ や A でもよいけれど、自分は Haiku や DeepSeek のほうが好き、とまさおさんは話します。
GPT-6.1 Sol は、SS をつけたい気持ちもありつつ、S に置かれます。ここは敵が強い、という理由。パネルには、Astra 並みの性能を5分の1の値段で出すモデル、と出ています。
GPT-6 Astra も S です。Opus 5.5 が出るまでは、Astra と言われていたモデル。コストの面では割が悪い、という評価です。
まさおさん(動画の中で・18:12〜)
正直認知ドリフトの部分が僕は気になるんで、そのメインでね、コデックスを使うということはないんですけれども、
認知ドリフトが気になるので、メインで Codex を使うことはない、と話します。それでも、縦の深掘りと視点の違いから、マルチレビューや Best of N で1個挟みたい、とまさおさんは話します。
Astra のパネルには、自前の25問を全問60分以内に完走し、空応答も打ち切りもゼロ、とあります。まちがえると高くつく仕事にだけ上げる位置、という要約です。
安い席は下ごしらえ、高い席はレビュー。この分け方が、この章の芯です。
9月30日には、日報を作る仕組みに足す再発チェックの直し案を、Astra に3回レビューさせました。強さは high。重い指摘は、1回目の8件から、2回目は6件、3回目は0件。3回目は、重い指摘が0件になった代わりに、中くらいの指摘が3件残りました。残った分は直して反映し、4回目の確認はしていません。
Astra の提案のうち2つは、測ってみると実際とは合わなかったので、採用しませんでした。
高い席の指摘でも、採るのは実物で測った後。
10月9日の私の測定では、2つのモデルが字幕の崩れで同じ1問を外しました。2つは Haiku 5.5 と Sonnet 5.5。同じ5問の裏取りを、1回ずつ任せた結果です。
同じ測定は、第8章で紹介した持ち場の違いの記事にも書いています。
使いどころは、Claude Haiku 5.5 の使いどころを、単価と下ごしらえの面から読んだ記事に書きました。
私なら、安い席には下ごしらえを、高い席にはレビューを任せ、最後の確かめは自分の手に残します。
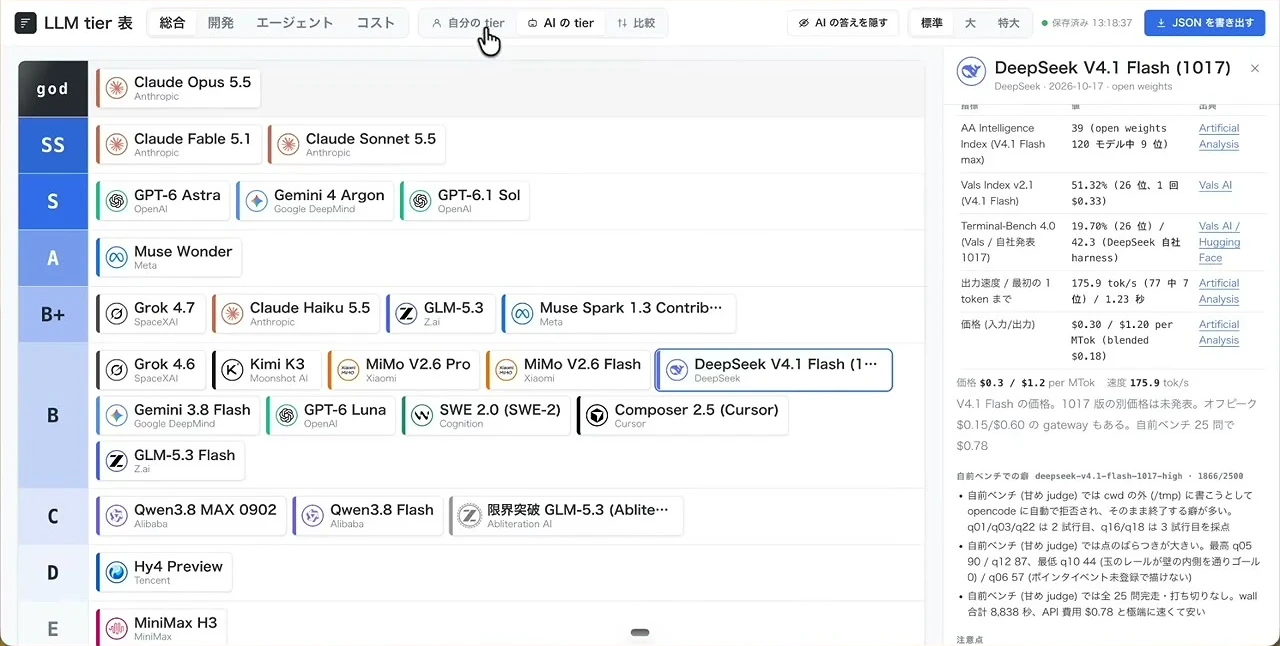
26枚のカードを置き終えると、まさおさんは次の版の話に移ります。まだ出ていない Fable 5.5 の予想と、10月版のまとめです。段表が最後にどう落ち着いたのかを、画面と一緒に見ていきます。
Fable 5.5 はまだ出ていないのでは、という声があります。まさおさんはこれに触れて、自分もそう思うと話します。ここから話は、ほかの会社の動きに移ります。
最初に挙がるのは Kimi です。K3 は結構前に出ていて、K4 や K3.5 が来れば、Composer など他のベースも上がります。DeepSeek は、Opus 5 ぐらいの性能の物を安く出しました。
オープン系のモデルが増えて、GLM も 5.5 などが出れば、ベースラインが上がり、Claude にも余裕がなくなります。そこで Fable 5.5 を出してくるのでは、という見立てです。
ベースラインは MiniMax でも全然いい、と話していた時期もありました。数か月たった今は、軽く使うなら DeepSeek がめちゃくちゃ使える、という状況になった、と振り返ります。
まさおさん(動画の中で・20:43〜)
1ヶ月でもね、全然違うなっていうことを思うんですけれども、
AIの段は、自分の評価に、いつも作るデモのソースコード、Artificial Analysis、外部の評価を照らして作った物です。そのうえで、2つの段は大体一緒だと添えます。
まさおさん(動画の中で・20:58〜)
ま、僕の評価はこういう感じっていうところですかね。ま、大体一緒なんですけどね。
26枚を置き終えた最終の段表は、god が Opus 5.5、SS が Fable 5.1 と Sonnet 5.5。S は Argon・Sol・Astra、A は Muse Wonder と MiMo V2.6 Flash です。
B+ は7枚。DeepSeek V4.1 Flash、GLM-5.3 Flash、Haiku 5.5 に、Gemini 3.8 Flash、MiMo V2.6 Pro、限界突破と付いた GLM-5.3、Grok 4.7 が並びます。
B も7枚です。GLM-5.3、Kimi K3、Composer 2.5、SWE 2.0、Grok 4.6、Muse Spark、GPT-6 Luna が入ります。C は Qwen の2枚、D は Hy4 Preview、E は MiniMax H3 です。
最後にまさおさんは、今は Claude のサブスクが熱く、Sonnet も使いやすい環境だと話します。締めの言葉は、情報が増えるスピードが速い、でした。
この26枚の段表は、10月版の断面。来月には、また別の顔になっているはずです。
入れ替えるのは、1つずつ。まとめて替えると、どの変更で出来が変わったのか分からなくなります。替えたら、実物の出力で確かめます。
Q. まさおさんの段と、AIの段は、何が違いますか。
A. まさおさんが自分の主観で置いたのが自分の段です。AIの段は、いつも作るデモのソースコードや外部の評価を照らして作った物で、2つは大体一緒だと話します。
Q. godに置かれたモデルはどれですか。
A. Claude Opus 5.5 だけです。総合・開発・エージェントのどれでも優れていて、コストだけは A の評価になっています。
Q. 安くて強いと話されたモデルは、どれですか。
A. Sonnet 5.5 が SS、MiMo V2.6 Flash が A、DeepSeek V4.1 Flash が B+ です。安いだけでなく、安くて強力なことが大事だと話します。
Q. 動画や音声を入力に使えるモデルは、どれですか。
A. Muse Wonder と MiMo、それに Gemini 系が挙がります。なかでも Gemini 4 Argon は、動画や音声を入れた時の精度の高さも強みだと話します。
Q. 段は、いつまで通用しますか。
A. 1か月でも全然違う、とまさおさんは話します。Fable 5.5 の登場などで入れ替わるので、月ごとに見直す前提で読むのがよさそうです。
動画は、god の Opus 5.5 から始まります。SS の Fable 5.1 と Sonnet 5.5、DeepSeek と GLM、Muse と MiMo、Grok から Qwen、Gemini、Haiku と GPT-6 系と進み、最後は Fable 5.5 の予想で締まりました。
この動画から私が持ち帰ったのは、段は答えではない、ということです。頼む仕事、入力の形、強さの設定、総量を先に決めます。段は、そのあとで自分の仕事に読み替える物なんです。
私なら、いちばん上のモデルでも、既定は途中の強さにして、高い席は使う場面を絞ります。安い席は総量で測り、書き直しは材料と並べて確かめます。
段を読んだあとにやることは1つです。自分がAIに頼む仕事を3つ書き出し、仕事ごとに、使うモデルと強さを1行ずつ決めます。
関連記事
Opus 5.5・Fable 5.1・GPT-6 に同じアプリを作らせた検証を読んだ記事。
DeepSeek V4.1 Flash の新しい版で、前の版から変わった点を読んだ記事。
Muse Wonder のベンチマークを、Meta の表と外の会社の測定に分けて読んだ記事。
Gemini 4 Argon と Claude Opus 5.5 を、持ち場の違いで比べた記事。
Claude Haiku 5.5 の使いどころを、下ごしらえの面から読んだ記事。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
今回紹介した動画
| チャンネル | まさおAIじっくり解説ch |
| 出演 | まさおさん |
| 公開日 | 2026年10月18日 |
| 長さ | 23分12秒(日本語) |
| URL | https://www.youtube.com/watch?v=dWA977-gKPA |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜日のZOOM(7:00〜)は登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!