WATCH REPORT
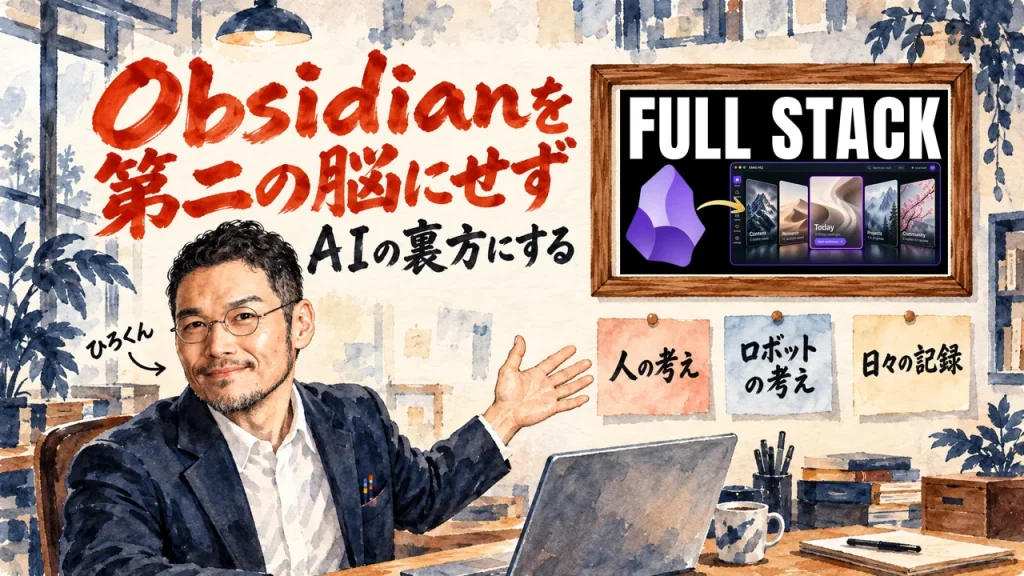
Obsidianを第二の脳にせず、AIの裏方にする。8分の動画と私の見方
2026.10.24
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル Eric Michaud で、Eric Michaud さんが Obsidian を「第二の脳」ではなく「バックエンド」として使う方法を紹介した回を取り上げます。英語の動画で、2026年10月22日の公開、長さは8分25秒です。
Obsidian にメモを溜めてきたのに、集めたまま開いていない方。AI エージェントも使い始めたけれど、ノートと AI の置き場をどう分けるか決めきれない方。英語の動画を通しで見る時間が取れない方。そんな書き手や、小さな会社の経営者に向けて書きました。
Eric さんが、Obsidian を第二の脳にせず、AI の裏方にする作り方を、画面を見せながら話す回です。人とロボットの考えの分け方、日次ノートと収集スクリプト、地図から読ませる工夫、動かせる操作盤まで、動画の順に追います。
読み終えると、動画の流れを順にたどれます。自分の vault に当てはめる前に、何を確かめるか。その見方も持ち帰れるよう、動画の話の横に、私の見方も並んでいます!
SPEAKER
Eric さん
動画の話し手です。YouTube のチャンネル Eric Michaud で、Obsidian の vault をエージェントの裏方(バックエンド)にして、日々の記録と数字を回す形を画面で見せながら話します。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)
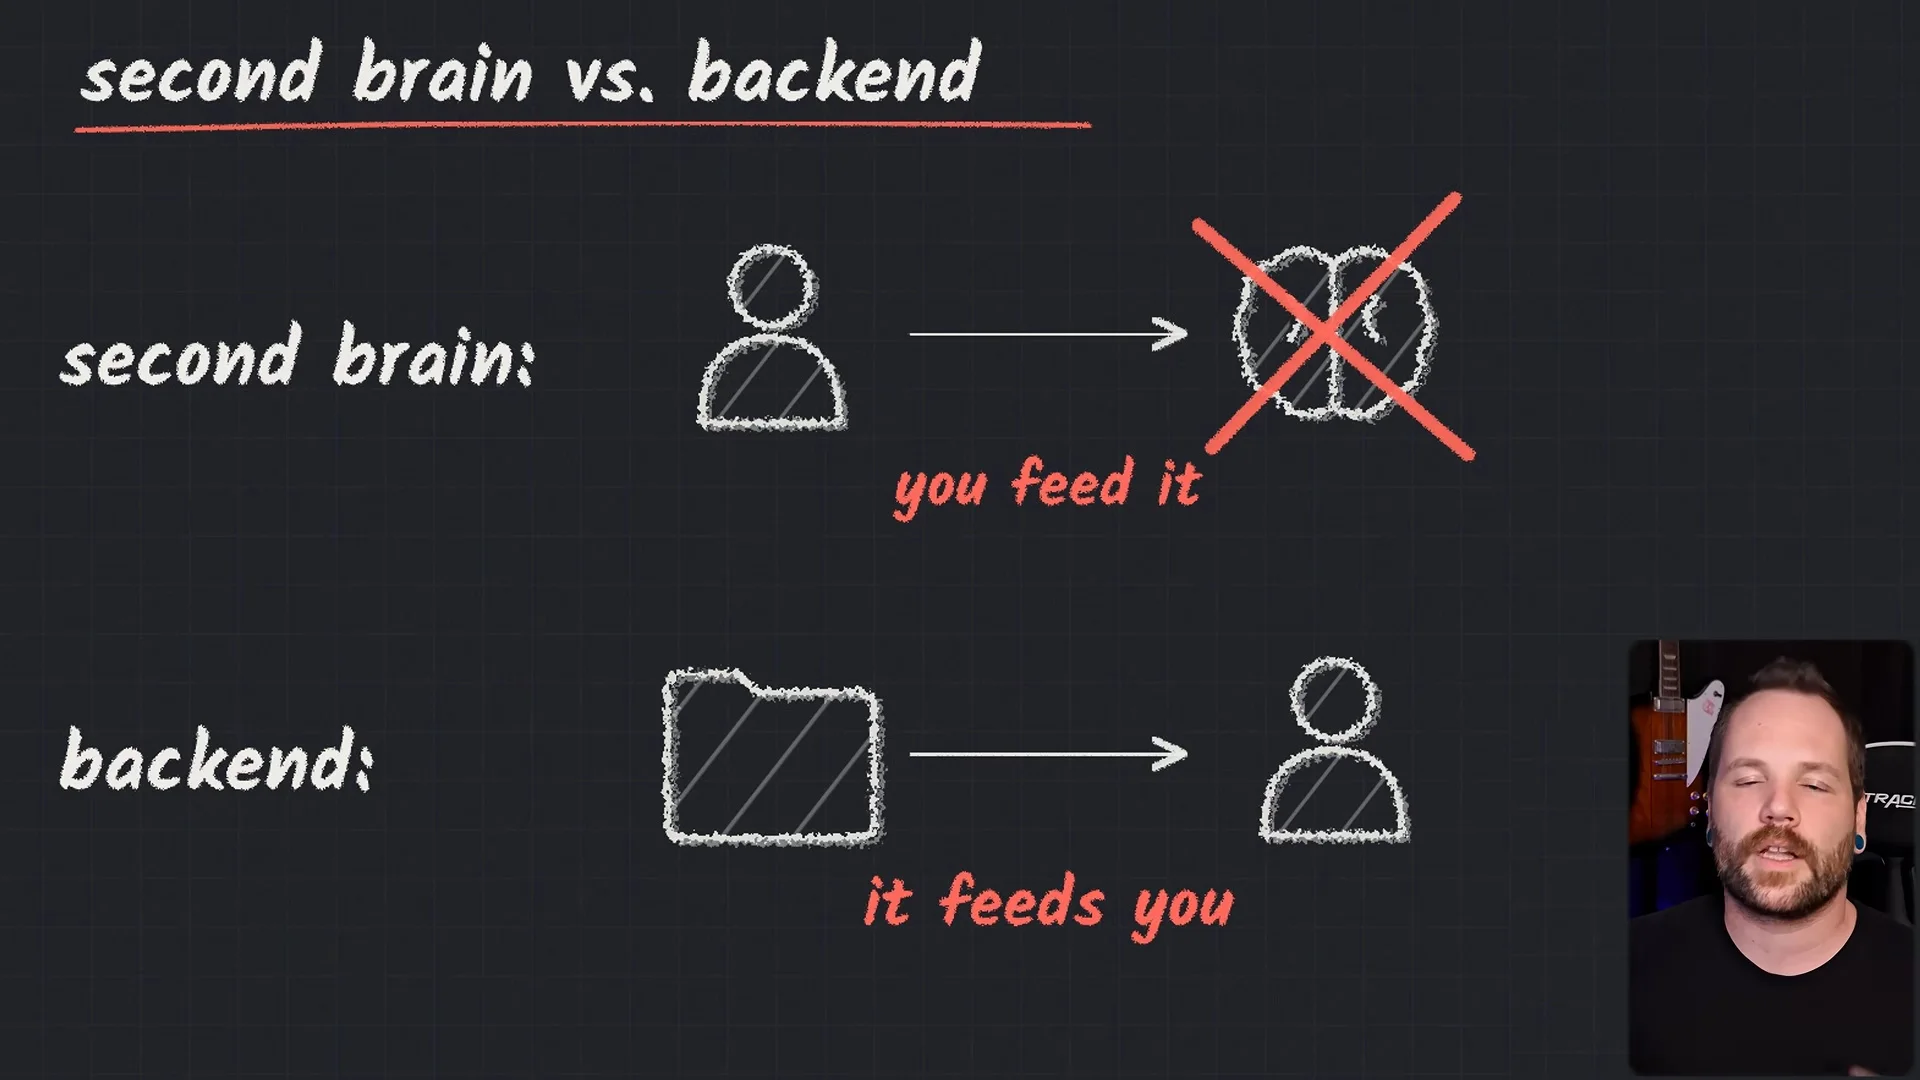
Obsidian に溜めたノート、最近いつ開きました?集めた時は役に立ちそうに思えたのに、気づけば置きっぱなし。動画も、まさにそこから始まります。
動画の頭で Eric さんは、Obsidian と聞くと、ノートアプリ、第二の脳、PKM を思い浮かべる人が多い、と切り出します。
情報を集めて、それきり二度と触らない形。それを自分はやらない、という出だしです。
Eric(動画 0:15〜)
When most people think Obsidian, they think, you know, note-taking app, second brain, PKM, that kind of thing. You collect all of this information and never touch it ever again.
訳: 多くの人は Obsidian というと、ノートアプリ、セカンドブレイン、PKM のようなものを思い浮かべます。情報を集めて、二度と触りません。
Eric さんの Obsidian は、自分を養うバックエンド。見た目の操作盤は、別に作る、と話します。
説明は続きます。vault はただのフォルダの束で、中身は普通のテキスト。だから、動画で名前が挙がった Claude Code や Pi、Hermes など、どのエージェントでも同じ vault を読めて、特定の道具に縛られません。
ノートアプリと AI エージェントを、同じ場所に置けること。そこが出発点、と話は進みます。
集めて終わりにしません。ここで大事なのは、集めた物を、誰かが読んで、また書き足す流れを先に置くかどうかです。その流れがあるかないかで、同じ Obsidian でも、中のノートの役目が変わってきます。
実は私も、Obsidian を蓄える置き場にしています。ここが、分身AIの魂になる場所です。2026年9月22日の私の記事に、その中身を書きました!
私の記事より(Obsidianをメモアプリで終わらせない設計を飯塚浩也さんが解説した視聴レポート・それでも保管庫と呼ぶ理由の節)
私はObsidianに自分の経験・価値観・口癖を全部文字にして蓄積しています。
動画は、見た目の操作盤を後回しにして、読み書きの置き場を先に決めます。私の引用で先に決めているのは、蓄える中身。自分の経験と価値観です。決める順番は違っても、AIが読みに来る前提で蓄える点は同じです。
蓄える先を、AIの読みに来る場所に置き直す。すると、メモの書き方も、人が後で読むだけの形から、AIが読んですぐ動ける形へ寄っていきます。
で、ここからは私の見方です。溜めることが目的なら、集めた時点で仕事は終わり。働かせることが目的なら、誰が読むのか、何を書き戻すのかを、先に決めておく必要があります。
読み手が人なのか、AIなのか。書き戻すのは日々の記録なのか、考えなのか。ここが決まると、フォルダの切り方も自然に決まってきます。
置き場の形より、先に読み手と書き手。順番はこっちですよ!
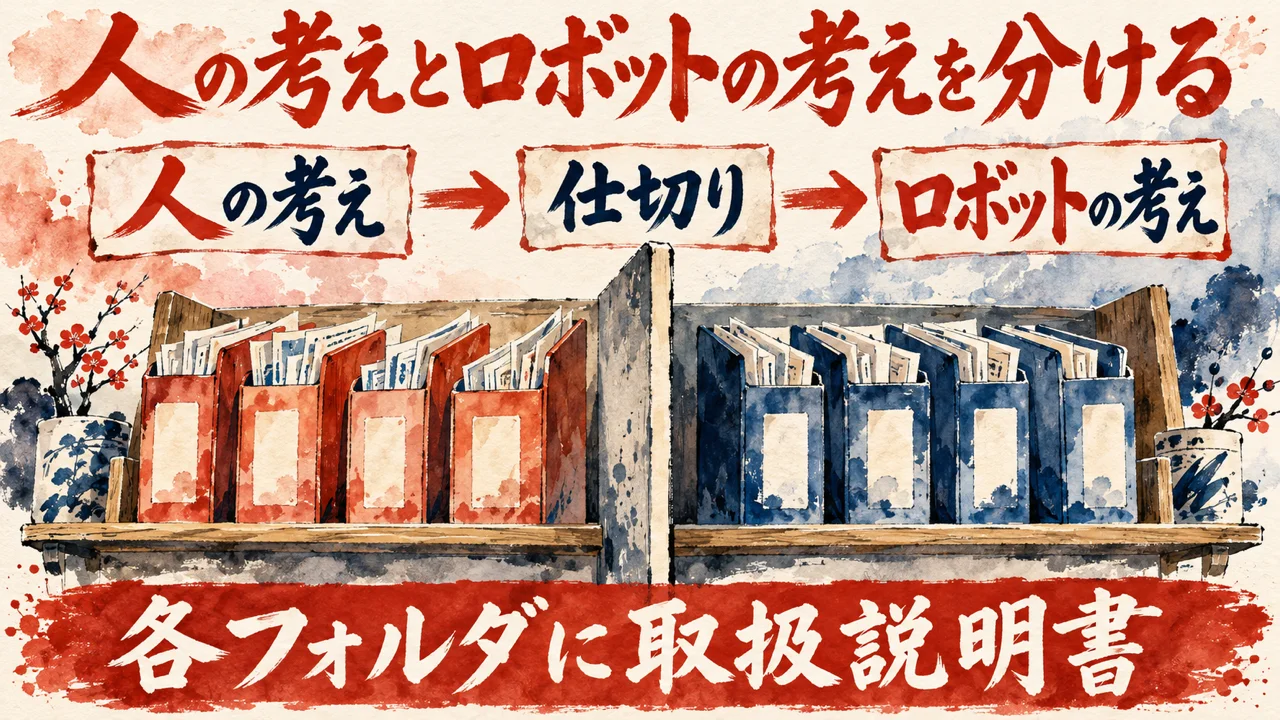
自分のメモと、AI が書いた文を、どこで分けるか。動画の次の話は、その線の引き方です。
Eric さんは、自分のアイデアとロボットのアイデアをきっちり分けておくことが、とても大事だと言います。
Eric(動画 1:25〜)
With that, I think it’s incredibly important to keep your ideas and the robot ideas totally separate because AI has a really bad habit of consolidating and summarizing things that you might not want summarized.
訳: だから、自分のアイデアとロボットのアイデアをきっちり分けるのが、とても大事だと思っています。AI は、要約してほしくないものまで統合して要約してしまう悪い癖があるからです。
理由として挙がるのは、AI の悪い癖です。要約してほしくない物まで、一緒に統合してまとめてしまう、と話します。
人間側は、人が書く場所。機械側は、機械が自由に書いてよい場所。そう分けておけば、機械は遠慮なく書ける、という話です。
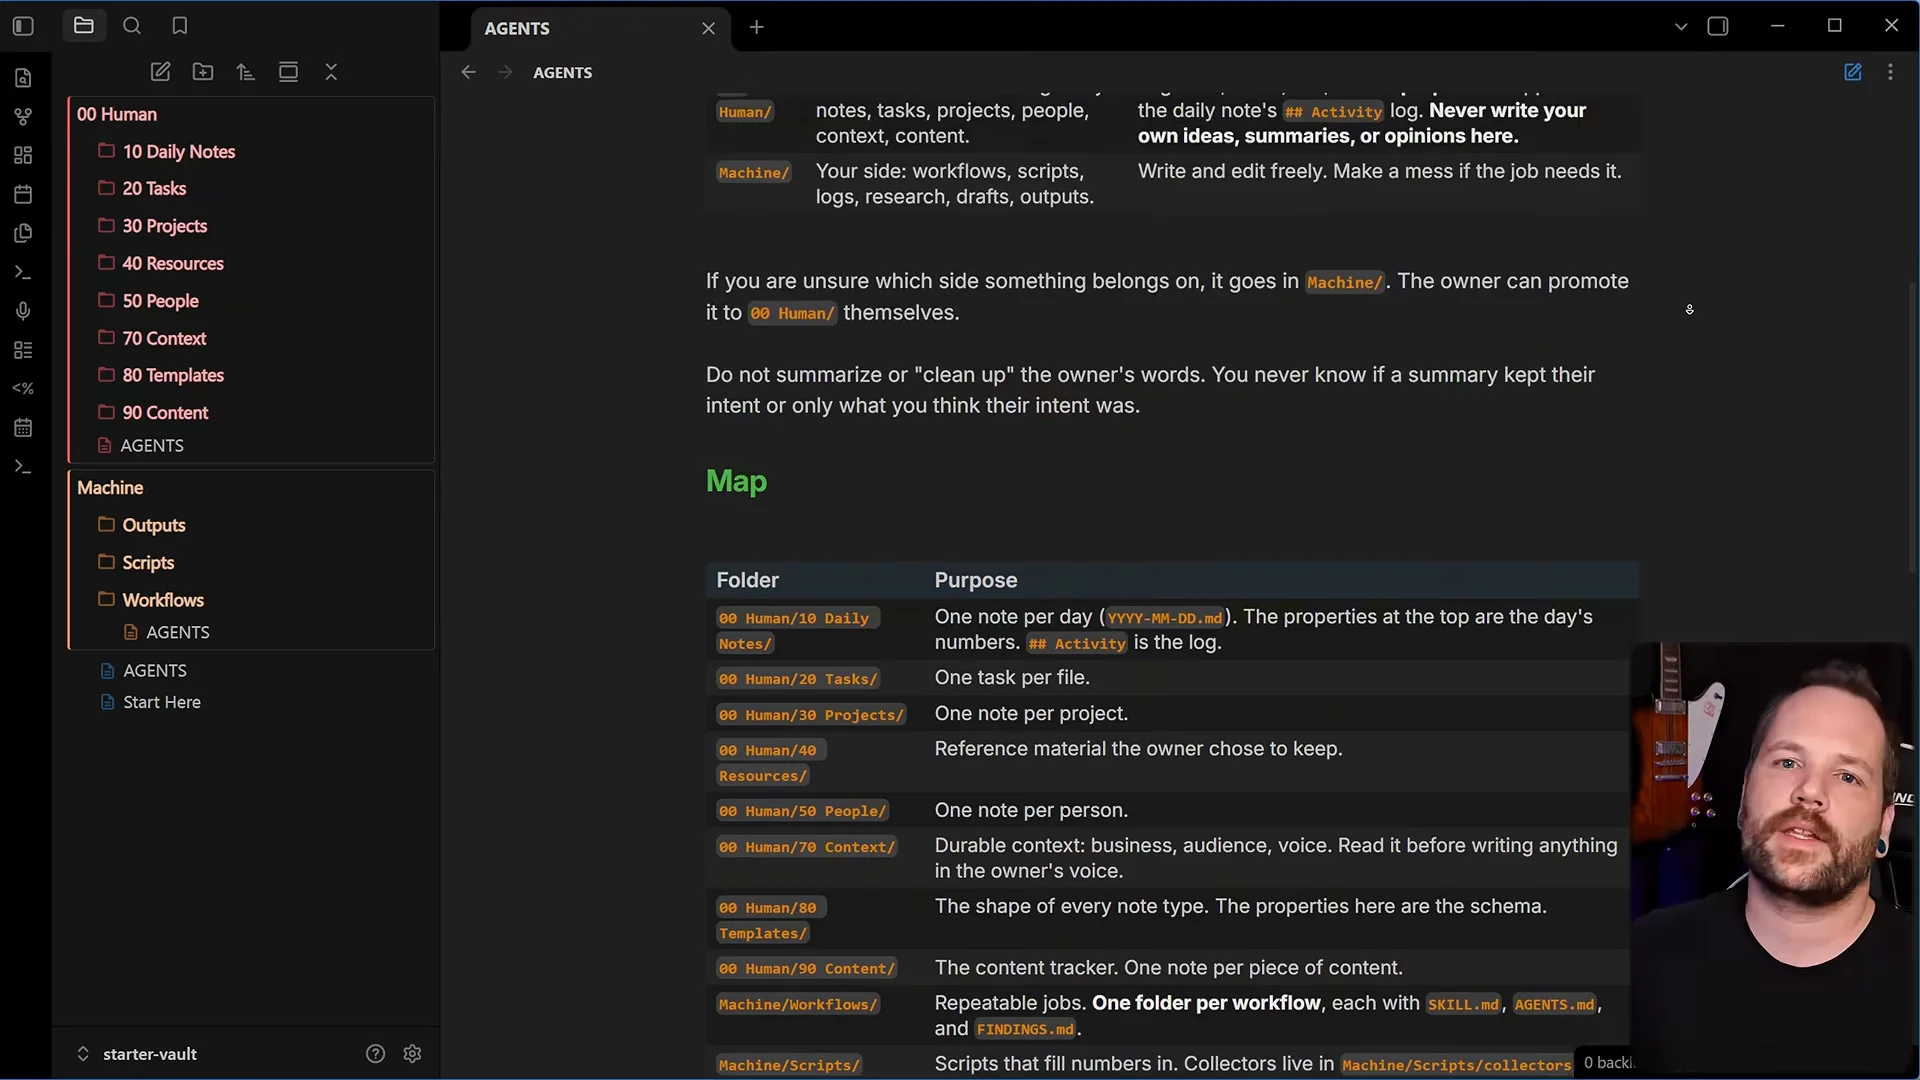
別の工夫が、取扱説明書。vault の中のすべてのフォルダの根元に、vault 自体も含めて、AGENTS.md を置きます。
Eric(動画 2:14〜)
At the root of every folder in the vault, including the vault itself, there is an agent.md file and it’s really just the instruction manual for that section.
訳: vault の中のすべてのフォルダの根元に、vault 自体も含めて、agent.md というファイルがあります。そのセクションの取扱説明書です。
画面にも AGENTS.md と出ていて、これがその区画の取扱説明書になります。エージェントは、フォルダに入るたびに、まずそれを読む流れです。
線を引く時期は、先。
混ざってから分けるのは、思った以上に手間がかかります。機械に好きに書かせる場所を作るなら、人の場所も同時に決まっている必要があります。
私が AI に毎回読ませているルール集には、人の考えを置く場所と、AIが整える記憶の場所について、役割を混ぜない、という1行があります。同じ置き場の中で、役割として分けています。
AIが整える側には、作業の決まりも置いています。元の資料は読むだけで、書き換えはしないこと。書く文には、出どころを付けること。
流れは、人が元の資料を放り込み、AIが派生ページを作り、人が大事なページに一言を足し、怪しい物は別の場所へ回す、という分担です。
フォルダごとの指示ファイルは、必要なフォルダにだけ。
私の記事より(Obsidianをメモアプリで終わらせない設計を飯塚浩也さんが解説した視聴レポート・境界線を引く勇気の節)
AIの生成物と自分の一次情報を、そもそも別の場所・別の道具に分けておく。混ぜないための境界線は、後で引くより先に決めておいた方が絶対に楽なんですよね。
私のは役割で置き場を分ける形で、動画のはフォルダごとに説明書を置く形です。違いは、AIが入る場所ごとに説明書があるかどうか。線を先に引く点だけが重なります。
AI に書かせる場所を決めるのは、人の言葉を守るためです!
機械に自由に書かせるほど、人の側の線は太く。そこが曖昧なままだと、どれが自分の言葉だったのか、後で見分けがつかなくなります。
私なら、AI に何を書かせて、何を人の手元に残すか、その境界は自分で決めます。
毎日の数字を、誰が数えるのか。画面を開いて数字を見て、メモに打ち込んで、翌日もまた同じ作業の繰り返し。第3章は、その写す手間をどこに渡すかの話です。動画の中でも、仕組みの土台にあたる部分ですよ。
Eric さんがエージェントに渡している指示のうち、いちばん大きなものは、やったことを全部、その日の日次ノートに書き残すことだと話します。
Eric(動画 2:38〜)
the biggest single instruction that my agents have is to log everything they do into today’s daily note.
訳: エージェントに出している一番大きな指示は、やったことを全部、今日の日次ノートに記録することです。
日次ノートの先頭にある front matter(ノート冒頭のプロパティ欄)には、数字がずらりと並んでいます。その数字は、収集スクリプトが YouTube の API などから取ってきて埋める、と動画では説明していますね。
スクリプトが走るのは、決まった時間。毎日、まったく同じデータを、まったく同じ方法で集めます。AI の確率的なフィルターを通さないところが利点、という話ですね。
Eric(動画 3:17〜)
and it also means that the exact same data is being collected the exact same way every single day and it doesn’t go through AIs like probabilistic filters.
訳: 毎日、まったく同じデータが、まったく同じ方法で集められます。AI の確率的なフィルターを通りません。
画面を見ても、AI が文章を書く部分と、機械が数字を数える部分は、きちんと分かれています。数字は機械の仕事。動画の線引きは、そこにはっきり置かれていますよ。
数える仕事と、書く仕事。動画はこの2つを、最初から別の担当に分けています。ここ、めちゃ大事な線引きだと私は見ています!
AI に何でも任せたくなる時ほど、この分け方が効いてくるんですよね。文章を書く役と、毎日同じ形で数字を写す役では、求められる力が違うからです。
実は私の手元でも、毎日の数字は、スクリプトが API から集めて1つのファイルに書く仕組みにしています。スクリプトの名前は collect_kpi。
そのファイルは自動で作られるもので、手で編集はしません。形は1つの Markdown ファイルです。
人が写せば書き写す時の取り違えが混ざり、AI に写させれば日ごとに書き方が揺れることもあります。だから、数えるのは毎日同じ手順で動く機械。考えるのは、その数字を前にした人と AI ですね。
誰も数字に手を入れなければ、昨日と今日を同じ物差しで比べられます。ここが崩れると、比べた結果そのものが揺らいでしまいます。
AI の出番は、そのあとですよ!並んだ数字を読んで、何が動いたのか、次に何を試すのかを、人と一緒に考える所です。
数える仕事は機械に、考える仕事は人と AI に。
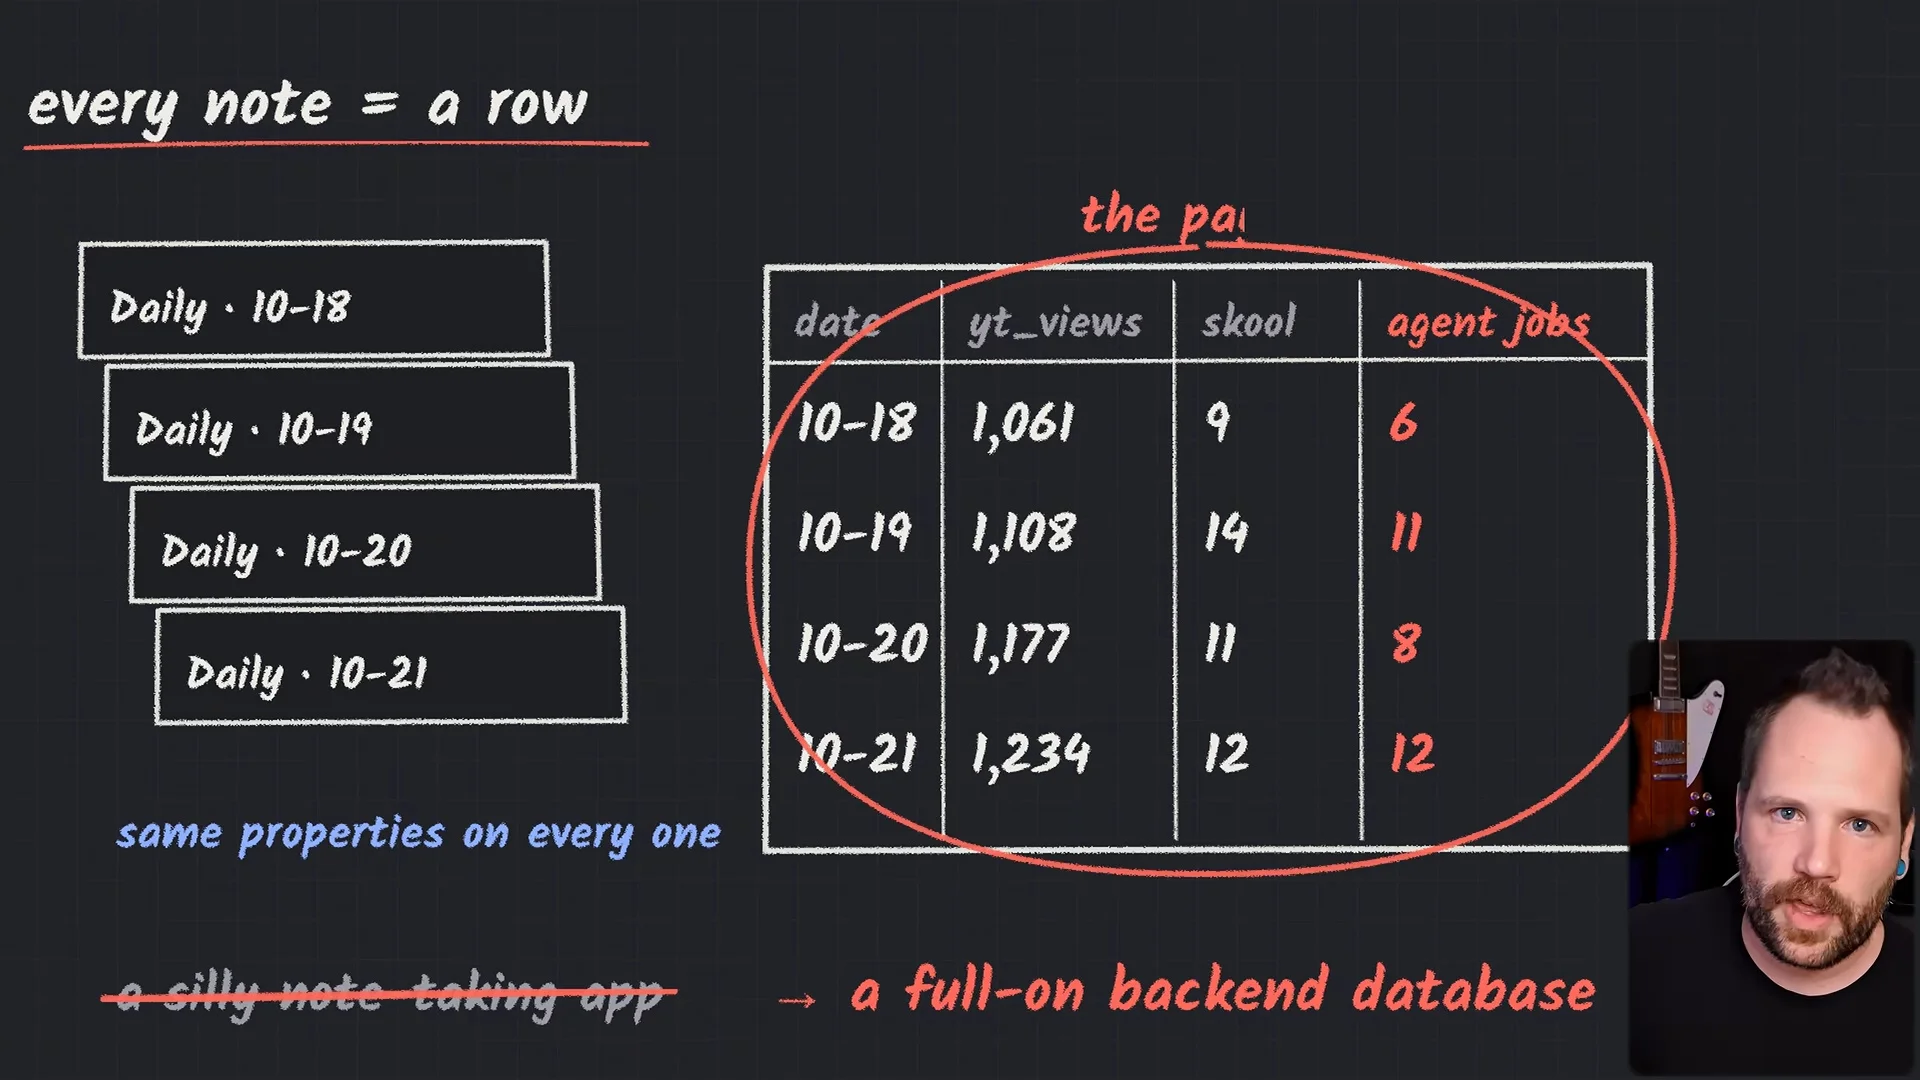
ノートの数と、プロパティの欄。この2つを表の形で並べると、ふだんは見えない姿が出てきます。1枚ずつ開いて読むノートでも、並べ方を変えると別の顔が見えてきます!第4章は、その見方の切り替えの話です。
動画の中で Eric さんは、日次ノートの一枚一枚と、front matter のプロパティを、表のように組み合わせて眺めてみよう、と話します。
Eric(動画 3:38〜)
Okay, so if you think of every one of those daily notes as a column and every one of those front matter properties as a row, Obsidian stops looking like a silly note-taking app and turns into a full-on back-end database.
訳: 日次ノートを列、front matter のプロパティを行と考えると、Obsidian はばかげたノートアプリには見えなくなり、本格的なバックエンドのデータベースになります。
そう見た瞬間、Obsidian はノートアプリの枠を越えて、本格的なバックエンドのデータベースに変わる、という説明です。画面の図でも、ノートとプロパティが表のように並んでいますね。
時間がたつほど蓄積は厚くなり、AI がそれをまとめて見渡せるように。そこが狙いだと、Eric さんは話します。
同じノート、別の読み方。置いてある物は何も変わっていないのに、読む角度を変えるだけで、使い道が変わります。
文章として読むのと、表として読むのは、別の使い方です。文章なら、その日に何を考えたかの流れ。表なら、何日分もの数字を並べて見比べられますよね。
でね、表として読めるのには条件があります。プロパティの名前と書き方が、毎日そろっていること。ここが揃っていて初めて、ノートの束が表の形になります。
ある日は欄の名前が違い、別の日は数字の書き方が違う。それで、表の同じ欄にきれいに並ぶでしょうか?
だから、そろえるには先に欄の名前を決めておく必要があります。決めるのは、書き始める前!名前と書き方が先に決まっていれば、毎日のノートは迷わず同じ欄に入ります。
書いてから表に直そうとすると、名前の揺れを1つずつ拾い直す手間が出ます。AI に頼んでも、どの名前が同じ意味なのかを、毎回推し量らせることになりますよね。
動画の見方が活きるのは、そろった欄が日々積み重なった後なんです。蓄積が厚いほど、AI が見渡せる範囲も広がります!
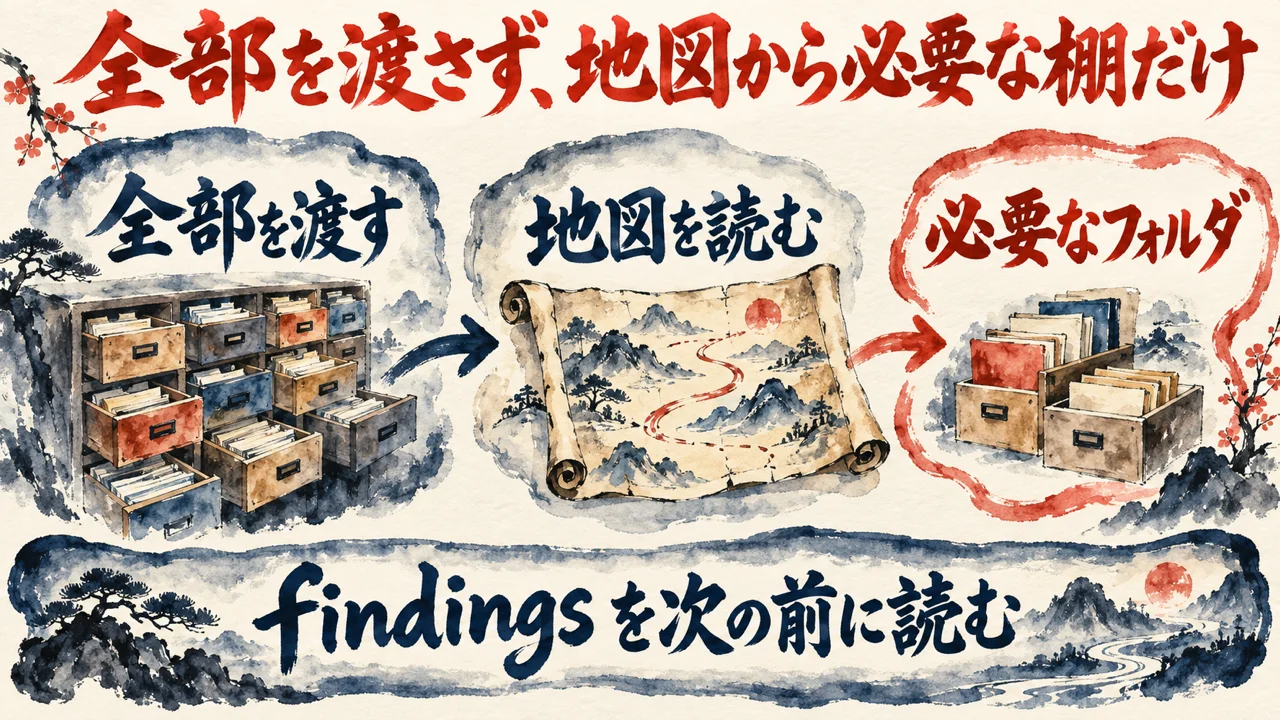
ノート全部を毎回 AI に渡すほうが、取りこぼしは少なく見えます。ただ、肝心な所がどこにあるかは、かえってぼやけやすくなります。この章は、渡す順番の話。
Eric さんは、セカンドブレインの vault でエージェントを使う人が多くやってしまう失敗を挙げます。毎回の会話に、文脈を全部突っ込むこと。
Eric(動画 4:17〜)
The mistake a lot of people make with their agents inside these different second brain vault structures is they dump the entire context into every chat, right?
訳: セカンドブレインの vault でエージェントを使う時、多くの人がやってしまう間違いは、毎回の会話に文脈を全部突っ込むことです。
話は、ここから代わりの形へ進みます。まず読ませるのは地図。地図は、要点をまとめた入口のファイルで、そこから先の行き先を決める役目です。
地図を読んだら、次は必要なフォルダだけへ。用のある棚だけを開く運び、という説明です。
例に挙がるのは、リール用のフォルダ。中には findings ファイルがあって、これまでにやったことが残っていきます。次の実行の前に、エージェントはまずそこから学習。だから出すたびに良くなる、と Eric さんは話します。
Eric(動画 5:20〜)
It tracks what we’ve done already. That all goes into a findings file that the agent has to learn from before the next run.
訳: これまでにやったことを追跡します。それが全部 findings ファイルに入り、エージェントは次の実行の前にそこから学ばなければなりません。
全部より、入口!この章が向いている先は、毎回の会話に何を渡すかより、どこから読ませるか。量を減らす話に見えて、中身は順番の話。
地図を先に置くと、AIは棚の場所を知ってから動けます。迷いながら全部をめくる動きとは、出発点からして別物。読む量が同じでも、届く深さが変わってきます。
実は私が AI に毎回読ませているルール集も、記憶の取りに行き方を1行ずつにしてあります。記録の本文は、私が開かない決まり。図書館の司書のように代わりに探してくれる道具に聞くと、答えだけが返ってきます!
無い時は、無いと言わせる設定にしています。
あ、さらに足しているのが、毎回の作業の初めに memory.md というメモを読む決まり。検索をする時は、範囲を絞って行います。どこでも全部を探す動きにはしていません。
動画の findings ファイルは、やったことが溜まっていく実行の記録。私の memory.md は、作業前に読む入口です。使う場面が少し違います。
地図があると、何が無いかもはっきりします。地図に載っていない棚は、まだ無い棚!分けておけば、知らないことを知っているふりで埋める余地も小さくなります。
もちろん、地図が古いままだと、AIは古い入口から読み始めます。だから地図は、棚が増えたり名前が変わったりしたら、一緒に直すもの。
私なら、分かることは調べさせて2度聞かず、分からないことだけ憶測せずに聞く形にします。
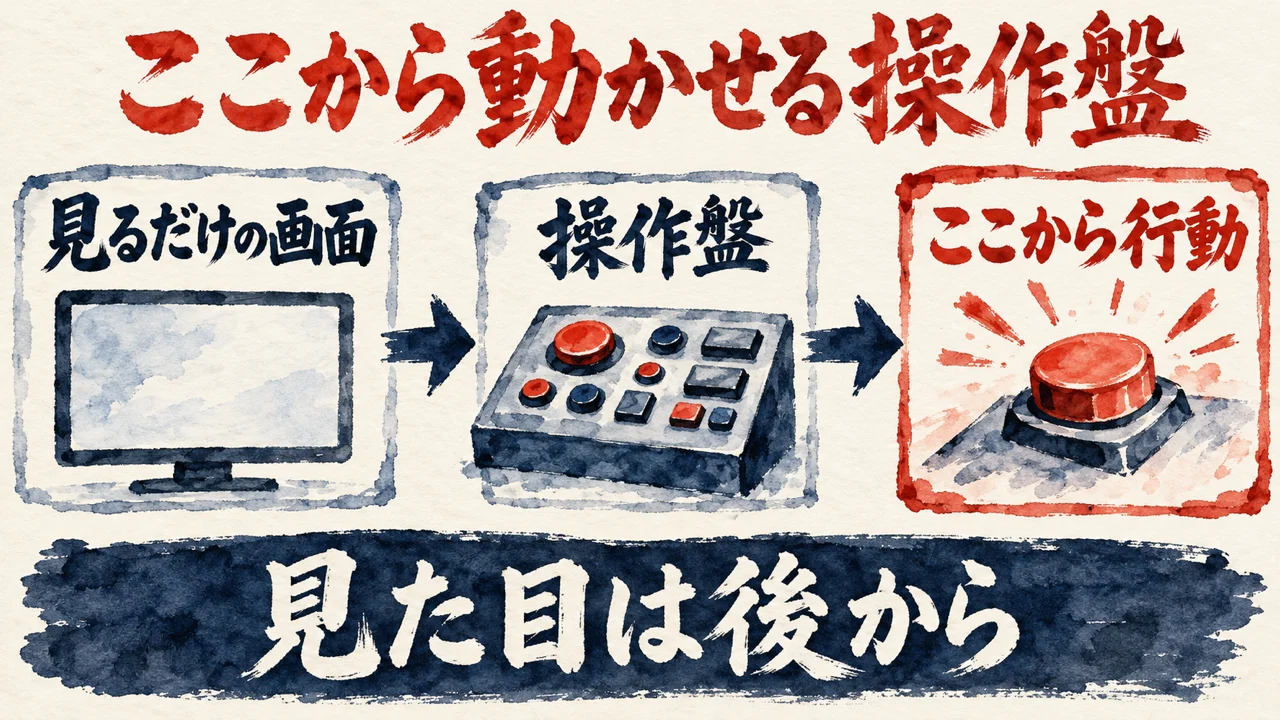
数字が並ぶ画面は、作った時点で一区切りに見えます。でも、見た後に動くのが毎回人の手なら、仕事はその人の元へ戻ってきます。この章は、画面の役目の話。
最初の話は、ターミナルの Claude Code だけでも、この仕組みは動くということ。見た目の画面が無くても回る、と Eric さんは話します。
見た目の画面は、使いやすさのために後から作るもの。参考にしたのは、Apple Music や PlayStation の画面の考え方、という説明です。
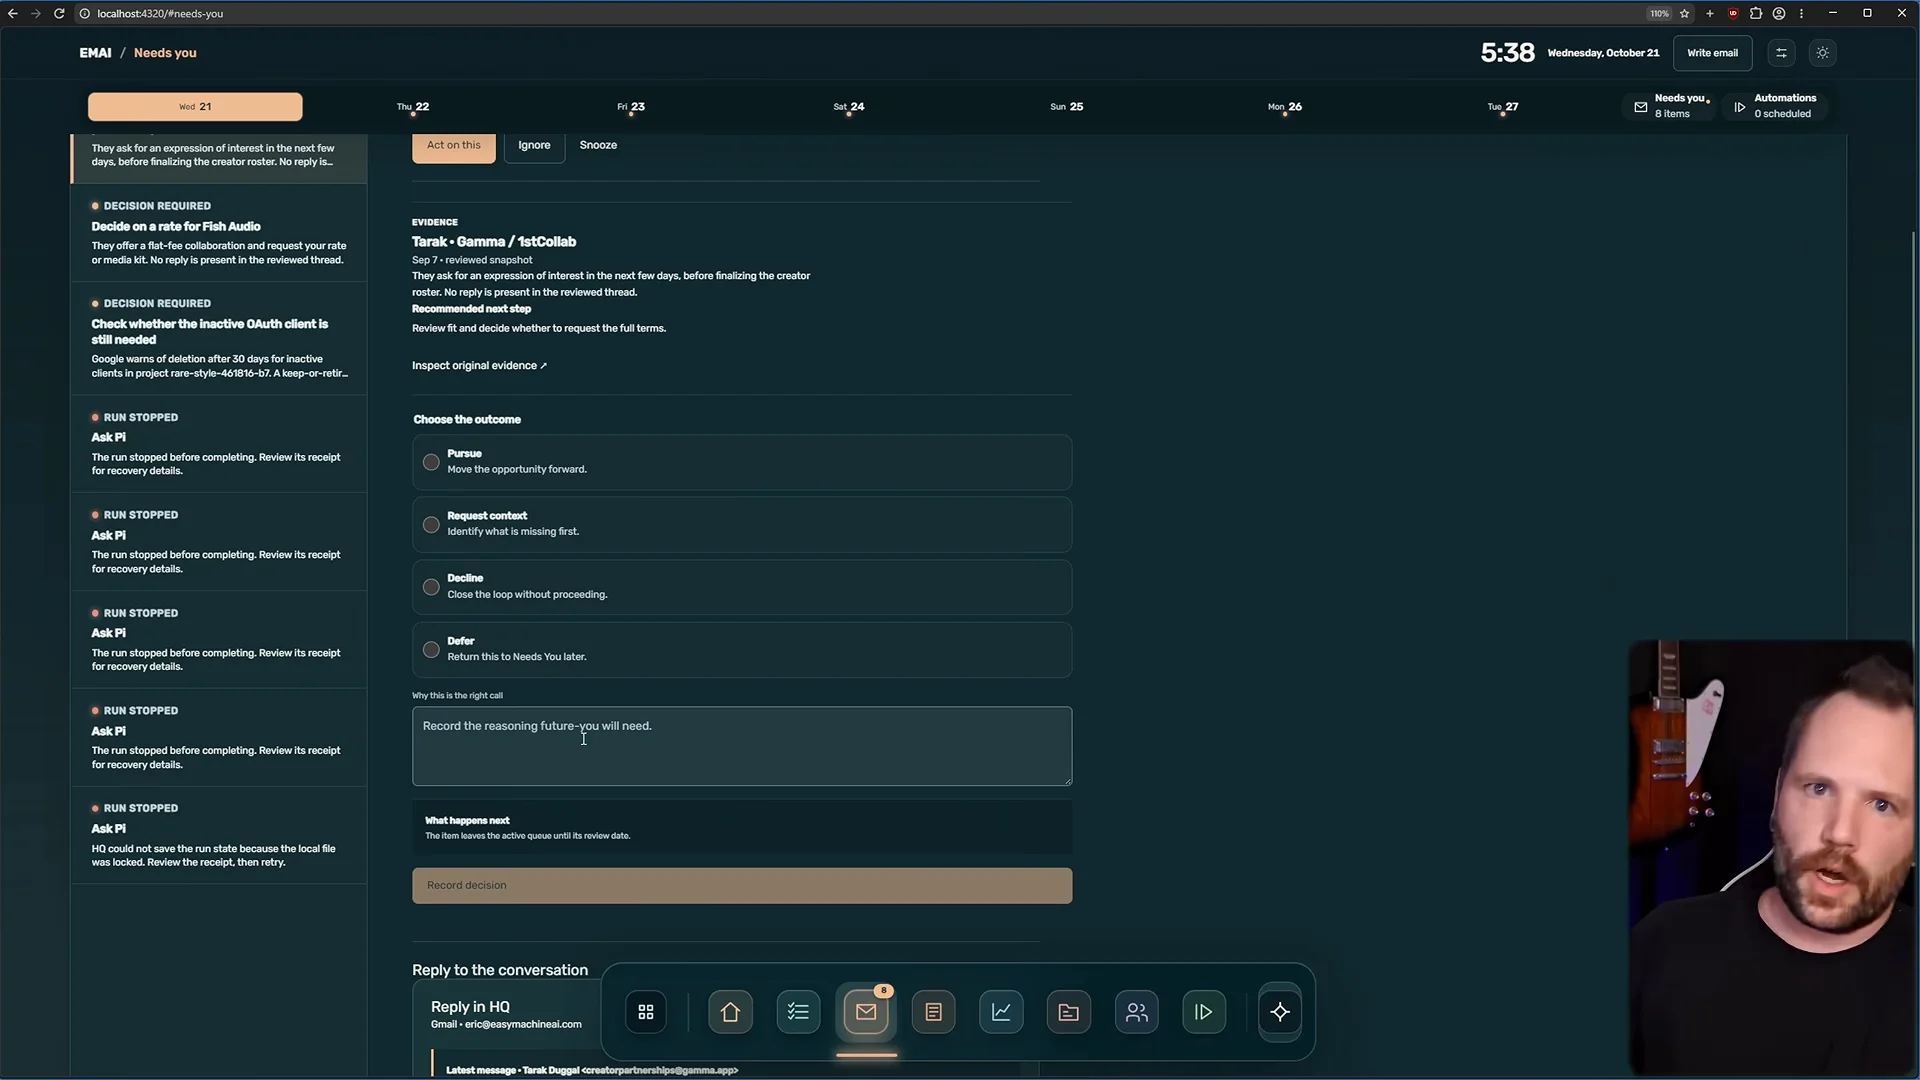
他の人がやっているものとの違いも、動画ははっきり挙げます。見せるだけのダッシュボードではない、という点。前に話した接続が同じなので、ここから実際に行動もできる、と Eric さんは話します。
Eric(動画 6:46〜)
What sets this apart from what I see a lot of other people doing is this isn’t just a dashboard that shows you stuff. You can actually take action through here as well because we’ve got all the same connections that I was talking about before.
訳: 他の人がやっているものとの違いは、見せるだけのダッシュボードではないことです。前に話したのと同じ接続があるので、ここから実際に行動もできます。
例に挙がるのは、メールの下書きや送信、短い動画づくり、コンテンツのリサーチ。画面から、これらの仕事にそのまま手を伸ばせる作りです。
話の最後は、まとめの3点。front matter 付きの Markdown、各フォルダの先頭に置くエージェント用ファイル、発見を残す仕組みです。そして、見た目とバックエンドは別のもの、と締めくくります。
Eric(動画 7:59〜)
if you take a step back and just picture it as a back end, it opens up so many more possibilities for you.
訳: 一歩引いて、バックエンドだと思い描けば、ずっと多くの可能性が開けます。
見る画面と、動かす画面。同じダッシュボードに見えて、設計の出発点は別なんですよね。どちらを作るかで、裏側の接続に要る物がまるごと変わってきます。
画面に出すだけなら、動くのは見た人です。数字を見て判断し、別の道具を開いて手を動かすところまで、毎回人が担う形。画面が増えるほど、見に行く場所も増えていきます。
画面から動かせるなら、動くのは仕組みのほう!人は、何をするかを選ぶ所に立てます。見る場所と動かす場所が一つになるぶん、行き来の手間も減る作り。
といっても、後者にするほど、先に決めておくことが増えます。どの操作を仕組みに任せ、どの操作を人の手元に残すか。ここを決めないまま動かせる画面を作ると、何が外へ出たのか後で追いにくくなります。
特に、送信のように外へ出る操作は別扱い。下書きまでは仕組みに任せても、送るかどうかの最後の一手は、人が持つ形にしておきたいところです!止める場所が決まっていれば、任せる範囲はむしろ広げやすくなる、というのが私の見方。
動かせる画面には、押した結果が見える場所も要ります。何をいつ動かしたかが残っていれば、同じ画面がそのまま振り返りの場所にもなります。
見える化は、途中の駅。見えた後に、誰が、どこから動くのか?そこまで描けて、ようやく裏方の設計が形になります!
Q. Obsidian をバックエンドとして使うとは、どういうことですか?
A. 動画では、AI エージェントが読み書きする置き場として使うこと、と話します。集めて眠らせる第二の脳とは、使い方が別です。見た目の画面は別に作る形です。
Q. なぜ自分の考えとロボットの考えを分けるのですか?
A. AI には、要約してほしくないものまで統合してまとめてしまう癖があるから、と話します。人が書く場所と、機械が自由に書いてよい場所を分ける形です。
Q. front matter の数字は、なぜスクリプトで埋めるのですか?
A. 決まった時間に走るスクリプトなら、毎日同じデータが同じ方法で集まり、AI の確率的なフィルターも通らないから、と説明します。
Q. vault 全部をエージェントに渡さないのはなぜですか?
A. 毎回の会話に文脈を全部入れるのは、多くの人がやってしまう失敗だと話します。先に地図を読み、必要なフォルダだけを読ませる形です。
Q. この仕組みは、ターミナルだけでも動きますか?
A. ターミナルの Claude Code だけでも、この仕組みは動く、と話します。見た目の画面は、使いやすさのために後から作るという説明です。
動画の筋道は、バックエンドとして使う、人とロボットの考えを分ける、日次ノートと収集スクリプト、表として読む、地図から必要な棚だけ、見るだけでなく動かす、の順に進みます。
この動画から私が持ち帰ったのは、溜める置き場より働く置き場にすること、AI に書かせる場所と人が書く場所を分けること、数える仕事は機械に任せること、全部を渡さず入口から読ませること、の4点。
私の手元では、置き場の役割分け、自動で作られる1つのファイル、取りに行く記憶の3つが、すでに動いています。全部を渡さず入口から読ませる考え方は、取りに行く記憶と重なります。
自分の vault で、今日すぐ確かめられるのは1つ。人が書く場所と、AI が自由に書いてよい場所が、フォルダで分かれているかどうかです。
自分のノートは、いま、眠っていますか?それとも、働いていますか?
COLUMN
自分の言葉とAIの言葉を、同じ置き場に混ぜない
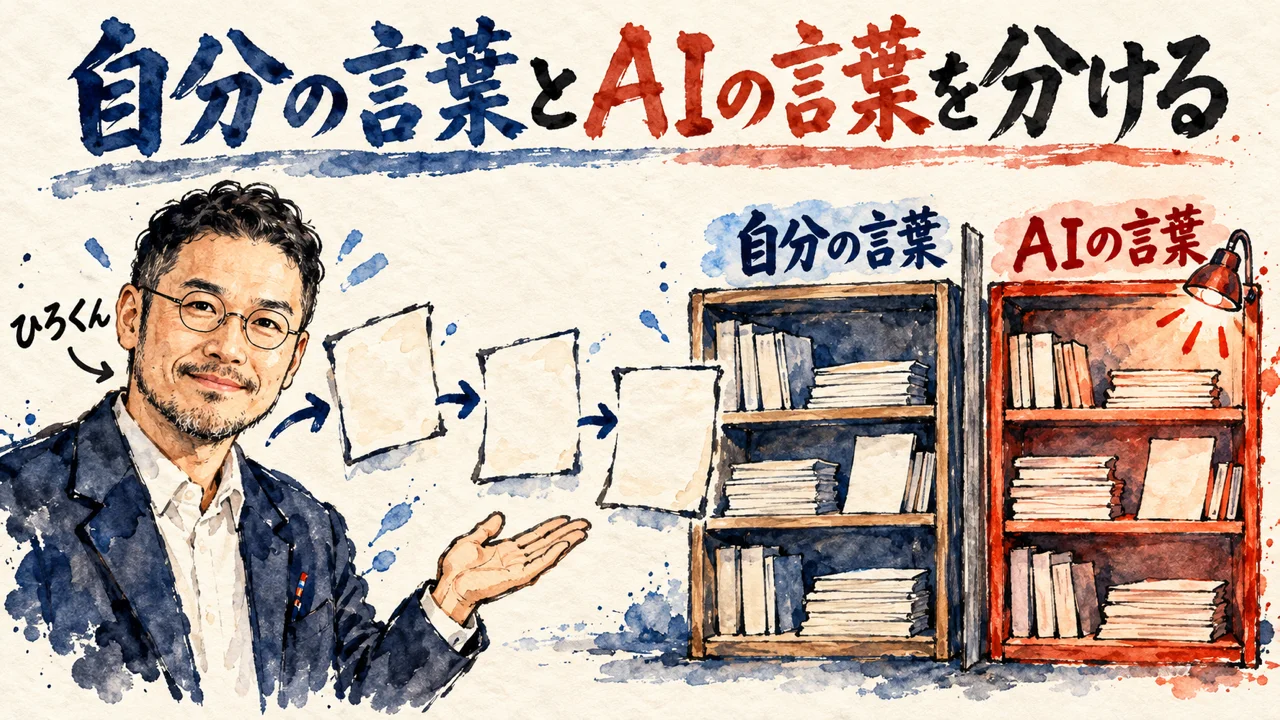
動画の仕組みは、ClaudeとObsidianのセカンドブレインを9か月運用して分かった壁を書いた記事の話と、つながって見えます。AIが自由に読み書きできる置き場を広く取るほど、人の言葉をどこに置くかは、先に決めておきたくなります。道具の選び方や画面の作り方より、さらに手前で決めておく話かな。
私の記事より(ClaudeとObsidianのセカンドブレインを9か月運用して分かった壁を書いた記事・今日から始められる、3つのステップの節)
AIが生成したものと、自分の生の言葉を、物理的に分ける
後で読み返した時に、どの文が自分の口から出たもので、どの文をAIが整えたのかを、迷わずたどれること。混ざってしまうと、整った文の中に自分の声が埋もれて、後で探しても見分けがつかなくなります。
動画の裏方の話に引き寄せると、AIに自由に書かせる棚と、人の言葉を置く棚は、フォルダの段階で先に分けておくことになります。混ざった後で文を一つずつ仕分ける手間は、棚を先に分ける手間よりも大きくなりやすいからです。
今日、自分のノートを1つ開いてみてください。その中の文を、自分の口から出たものと、AIが整えたものに、5秒で指さして分けられるでしょうか?指さしにくいなら、そこが最初の線の引きどころです!
AIがどれだけ書き足しても薄まらない、自分の生の言葉の居場所。これだけは、AIに預けずに自分の手で置いておきたいんですよね。
関連記事
ノートアプリで終わらせず、AI に記憶と出力先を持たせる設計を読める記事。
セカンドブレインを作った後に出てくる壁と、続け方を書いた記事。
AI の出力と人間のメモを、フォルダごとに分けて置く構成を読める記事。
ノートの属性を一覧にして、進み具合を見渡す作り方を読める記事。
Obsidian の画面で、仕事の進み具合を見渡す仕組みを読める記事。
振り返りを AI と続ける形を、5か月の記録から読める記事。
参考リンク
今回紹介した動画の本編です。時刻つきの発言は、ここで確かめられます。
今回紹介した動画
| チャンネル | Eric Michaud |
| 出演 | Eric さん |
| 公開日 | 2026年10月22日 |
| 長さ | 8分25秒(英語) |
| URL | https://www.youtube.com/watch?v=4z2i6UsQG1k |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!