WATCH REPORT
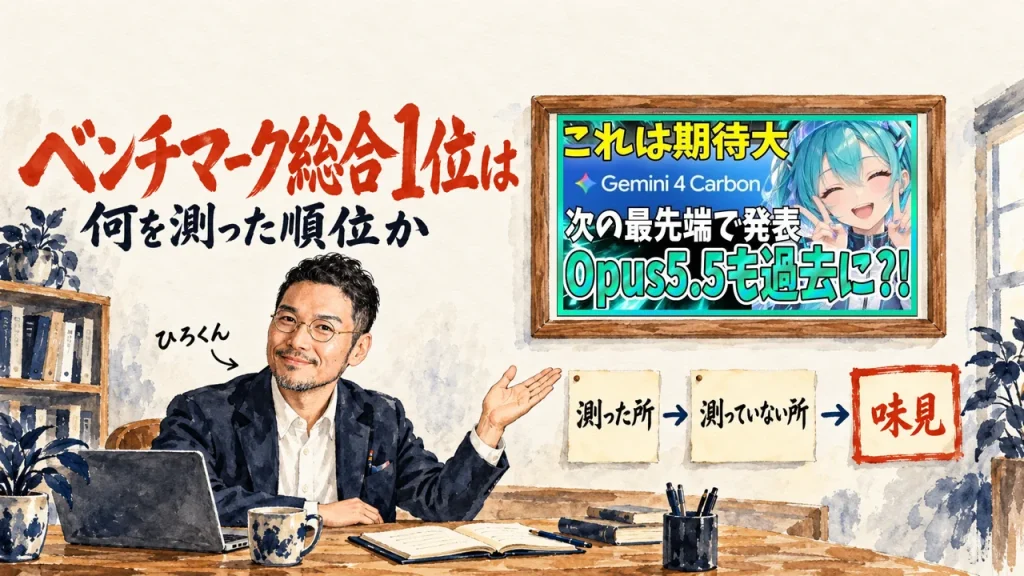
Gemini 4 Carbonのベンチマーク総合1位は、何を測った順位か
2026.10.29
家事と子育てのスキマで経営する3方よしAI共創コンサルタントの田中啓之、ひろくん(@passion_tanaka)です。今回は、YouTube のチャンネル『まさおAIじっくり解説ch』の日本語の動画1本をもとに、Gemini 4 Carbon の総合1位やサイバー3ベンチの首位を、私がどう受け取るかを整理するね。
新しいAIモデルが出るたびに、順位表の数字が並びます。1位と言われても、自分の仕事のどこに効くのか。そこが決めきれない。そんな個人事業主や発信者に向けて書きました。
まさおAIじっくり解説chの、まさおさんの動画です。Google DeepMind の新しいモデル Gemini 4 Carbon の公式発表とベンチマークを解説する、約14分の日本語の動画です(2026年10月28日公開)。引用ブロックは、動画の音声を文字にしたものです。表記がずれた所は、下の文で直します。動画の数字や評価は、まさおさん本人の考えです。
最大の売りは、サイバー防御と長時間タスク。まさおさんの紹介では、公式は総合ランキングで59点の1位、トップクラスだとアピールしています。サイバー系のベンチも、3本とも首位。公開は段階的で、価格は導入価格。攻撃成功率は0.7%から0.0%に下がりました。最後は Antigravity から試したい、という話で締まります。
この記事では、まさおさんの話を順に追います。噛み合う所にだけ、私の記録を重ねました。引用の判定役で試した埋め込みの試験。動かす環境の閉じ込めの試験。Gemini 4 Argon を Antigravity で動かした記録です。読み終えると、順位表の数字を、何を測った数字かと、環境の側で何を足すかに分けて受け取れます。
SPEAKER
まさおさん
まさおさんは、チャンネル『まさおAIじっくり解説ch』のチャンネル主で、Google DeepMind の公式発表を引きながら Gemini 4 Carbon のベンチマークを解説した動画の語り手です。
AIの「今」を毎日シェアしてる無料コミュニティやってます
GPTs研究会に参加する(無料・9,000名突破!)出典: 【最強性能】『Gemini 4 Carbon』発表!サイバーセキュリティと長時間タスクで大幅進化、ベンチマークを解説(まさおAIじっくり解説ch)
1位と言われた時、その順位は何を測っているのでしょうか?数字が大きいほど、自分の仕事にも効く。そう読んでいいのか。ここから見ていきます。
まさおさんは、Gemini 4 Carbon の最大の売りを2本挙げます。サイバーセキュリティと、長時間のタスクです。公式の原文では state-of-the-art cybersecurity と long horizon です。
まさおさん(動画の中で・0:56〜)
最大の売りに関してはサイバーセキュリティと長時間のタスクという感じになっております。
守りの強さと、長く走り続ける力。この2本が看板のモデルです。
まさおさんは、最近はサイバー系の話題が多いと見ています。ベンチマークも強力です。ただ、使ってみた時の感触は、ベンチの並びからは見えてこない。そこを個人的に気にしているとも話します。
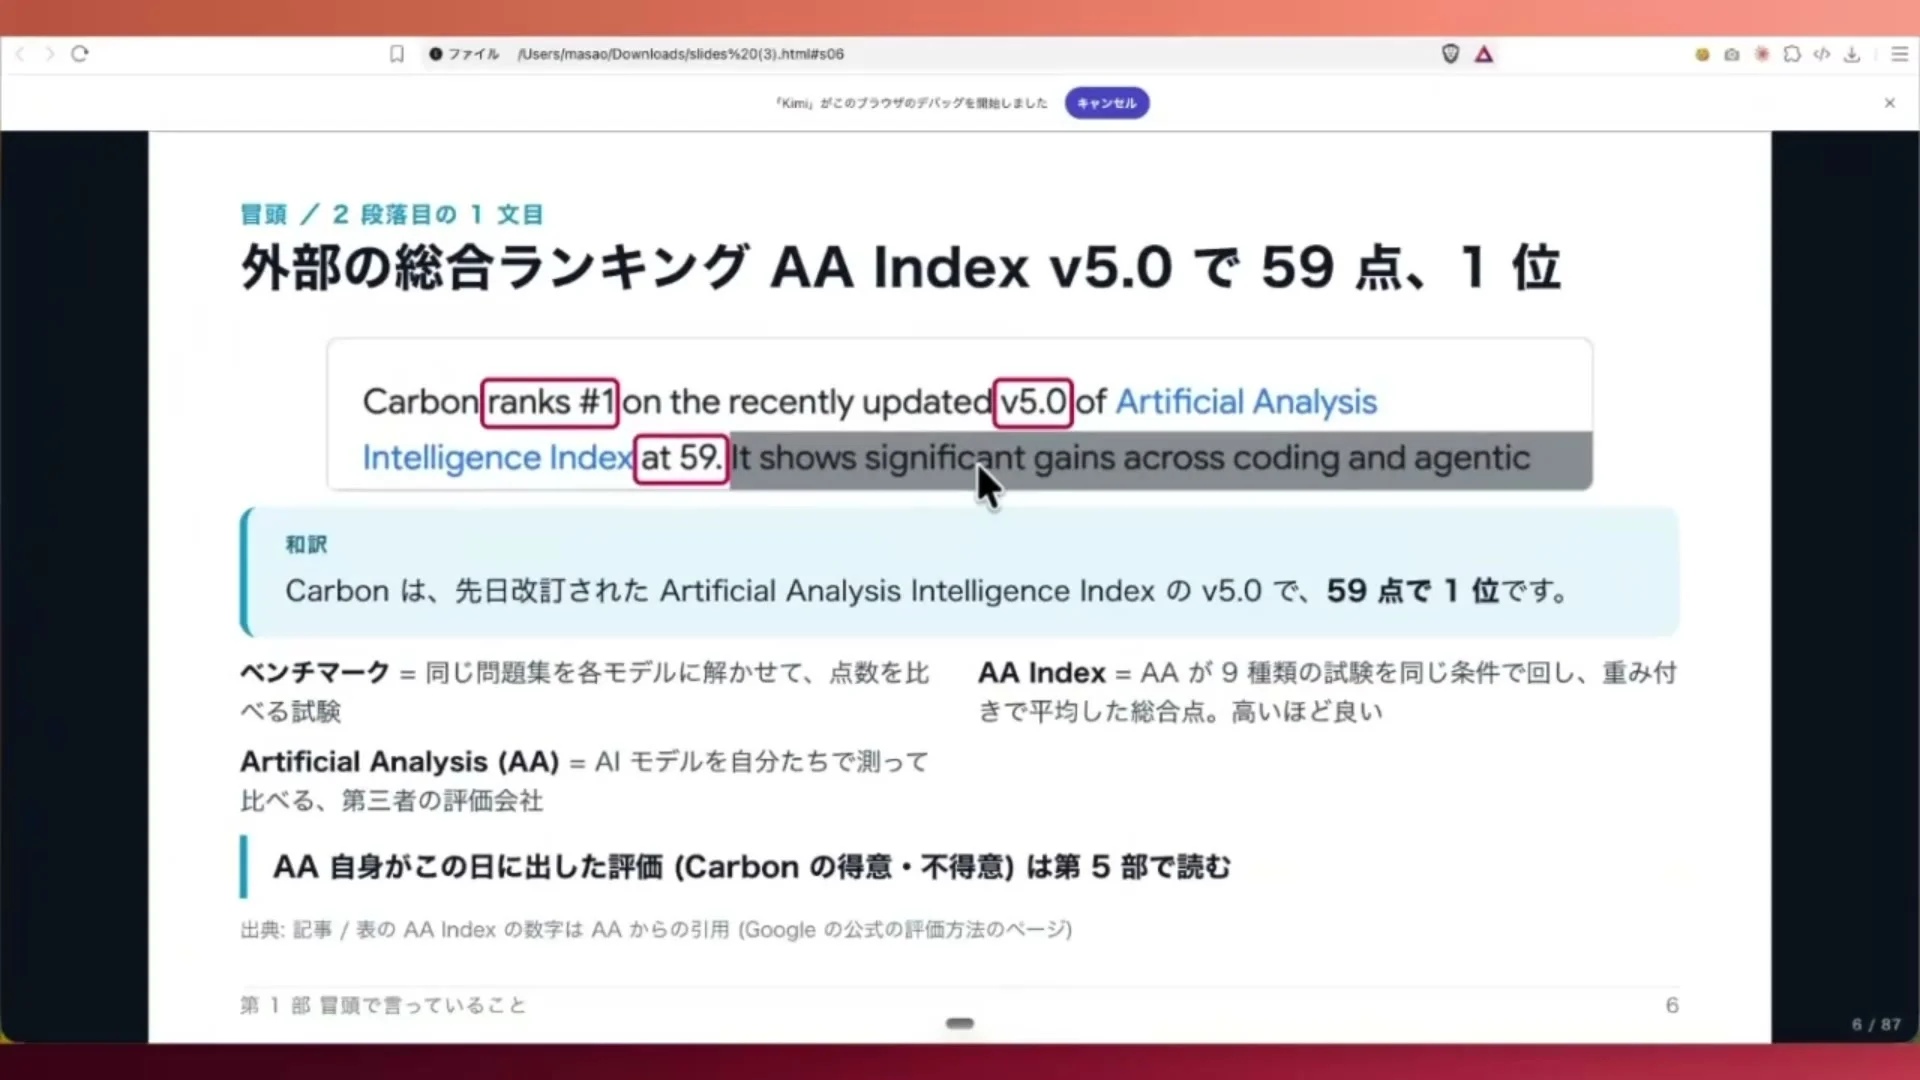
総合ランキングの Artificial Analysis Intelligence Index は、v5.0 に新しくなりました。公式は、Gemini 4 Carbon がここで59点の1位、トップクラスだとアピールしています。まさおさんが紹介するのは、そのアピールです。
まさおさん(動画の中で・1:38〜)
総合ランキングだったらやっぱアーティフィシャルアナリシスインデックスとかでね、ま、最近V.0新しくね、なりましたけれども、そこで59点で、え、1位となっているオパス5.5とかでもいろんなモデルがある中で、ま、トップクラスになってますよというアピールがありました。
まさおさんのスライドには、ベンチマークは同じ問題集を各モデルに解かせて、点数を比べる試験だと書かれています。Artificial Analysis は、AIモデルを自分たちで測って比べる第三者の評価会社だ、ともあります。Intelligence Index は、9種類の試験を同じ条件で回し、重みをつけて平均した総合点で、高いほど良い点数だそうです。
Opus 5.5 なども並ぶ中での、59点の1位。トップクラスだというのは、公式のアピールです。まさおさんが気にしているのは、その横にある、使ってみた時の感触のほうなんですよね。
つまり59点は、9種類の試験をまとめた総合点です。私なら、この点数は器の大きさを測った数字として受け取ります。本質は原液で、モデルは器。どのモデルかより、原液が入っているかを先に見ます。
使ってみた時の感触は、この総合点の中には入っていません。そこが分かるまでは、私は順位を器の見本として読みます。
サイバー防御が強い。そう言う時、何を測っているのでしょう?
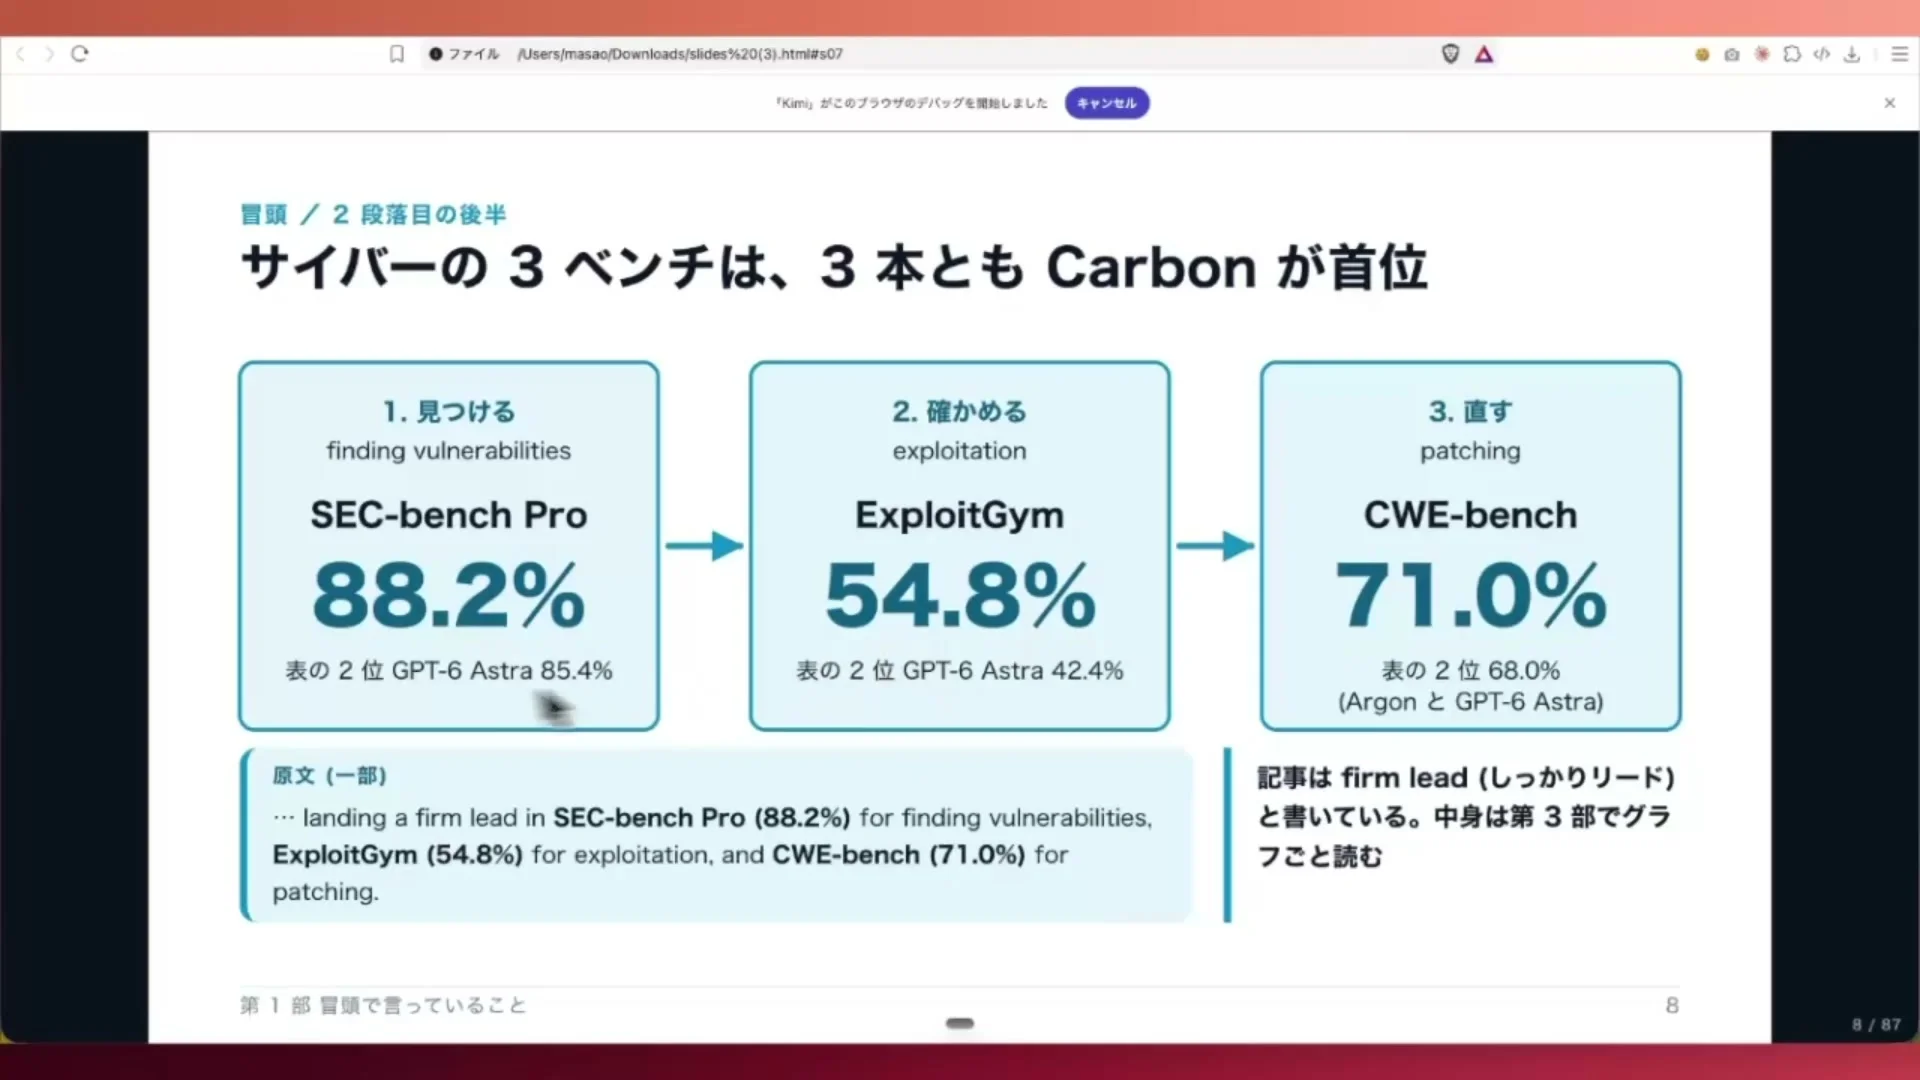
まさおさんは、サイバー系のベンチマーク3本で、Gemini 4 Carbon が3本とも首位だと話します。SEC-bench Pro・ExploitGym・CWE-bench です。数字は88.2%・54.8%・71.0%。2位は85.4%・42.4%・68.0%です。
まさおさん(動画の中で・2:26〜)
見つける、確かめる、直すみたいなところに見ていくと、ま、2位のね、ま、アストラが結構2位に位置しているんですけれども、そこから結構差をつけて、えー、高い能力を示しているというところで、
まさおさんの読みでは、見つける・確かめる・直すの流れで並べると、2位の GPT-6 Astra から、はっきり差がついています。
まさおさんによると、公式は、見つける・確かめる・直すの全部で最高水準だと書いています。ExploitGym は、脆弱性を実際に突けるかを見るベンチです。
まさおさん(動画の中で・7:56〜)
サイバー系の部分しっかり強いですよっていう話とで、え、ま、それこそ見つける、確かめる、直すの部分で最高水準だと言ってくれておりまして
サイバーの部分は強い。公式は、そう言い切っています。まさおさんは、サイバー用途で試す価値があるモデルかもしれないと見ています。実装に入れたい、とも話します。
見つけて、確かめて、直す。その途中で確かめきれない所が出た時、AIが憶測で埋めずに返してくるか。私が見たいのは、そこです。確かめた所とわからない所を、分けて返してくれるか。わからないことは、憶測で埋めずにきく。わかることは2度聞かない。この2本がそろって、やっと委ねられます。
3本のベンチが測るのは、見つける・確かめる・直す力です。わからない所を憶測で埋めない振る舞いは、この3本の点数の外にあります。
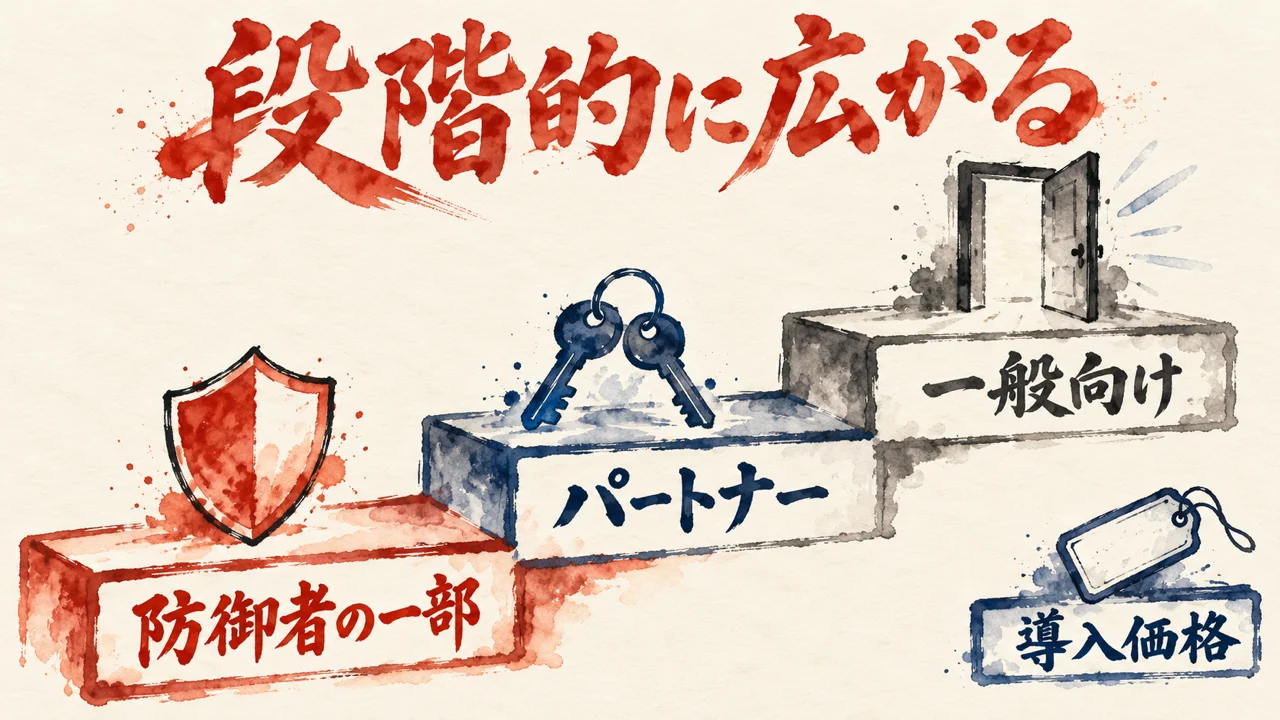
自分はいつから使えて、いくらかかるのか?順位表には、この2点は載っていません。
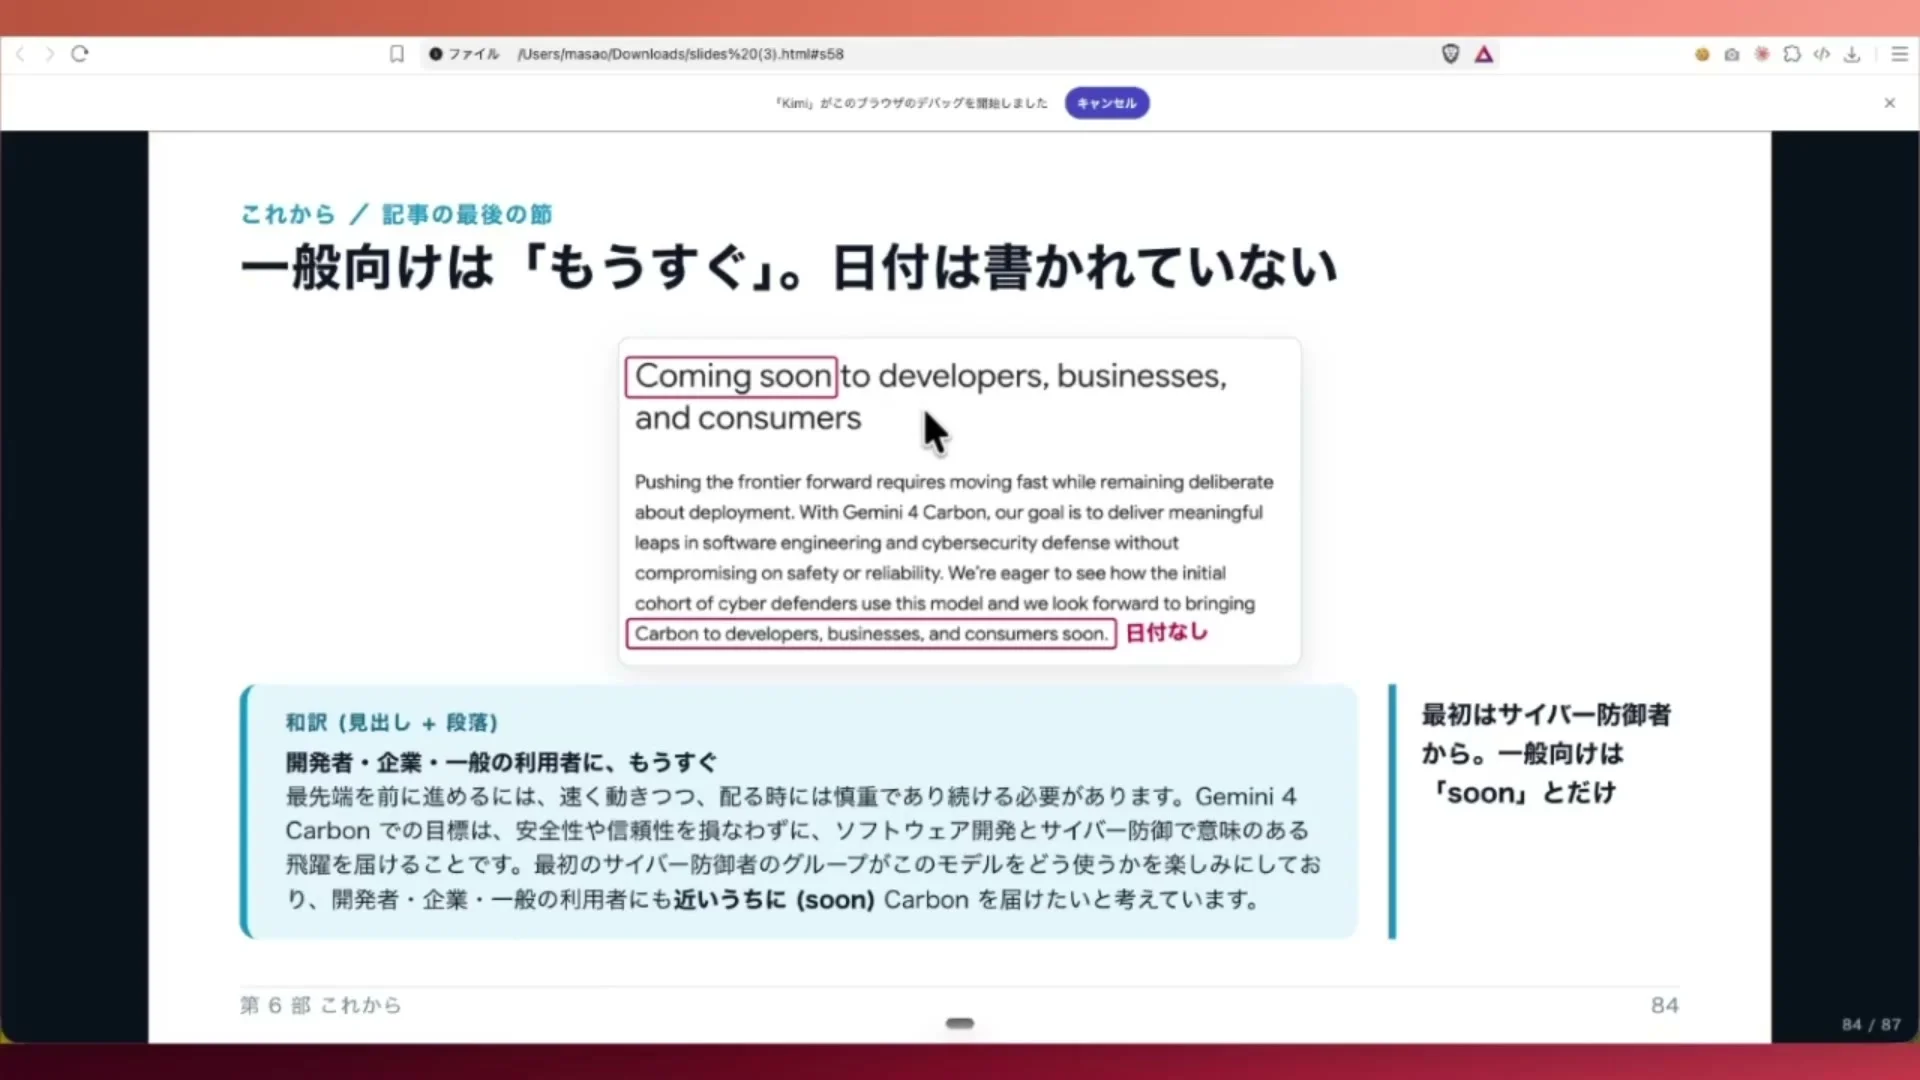
まさおさんは、公開は段階的だと話します。まずは、サイバー防御者の一部からです。
まさおさん(動画の中で・4:01〜)
まだ、え、サイバー防御者の一部から段階的に共有していきますよという話になっています。なんでね、一般開発者の僕とかはまだアクセスができないという形になっています。
一般の開発者には、まだ順番が回ってきていません。次は信頼できるパートナー、その次が一般利用者です。一般向けは近日公開(Coming soon)とだけあり、日付は書かれていません。サイバー能力が高いので慎重なのも納得、とまさおさんは見ています。
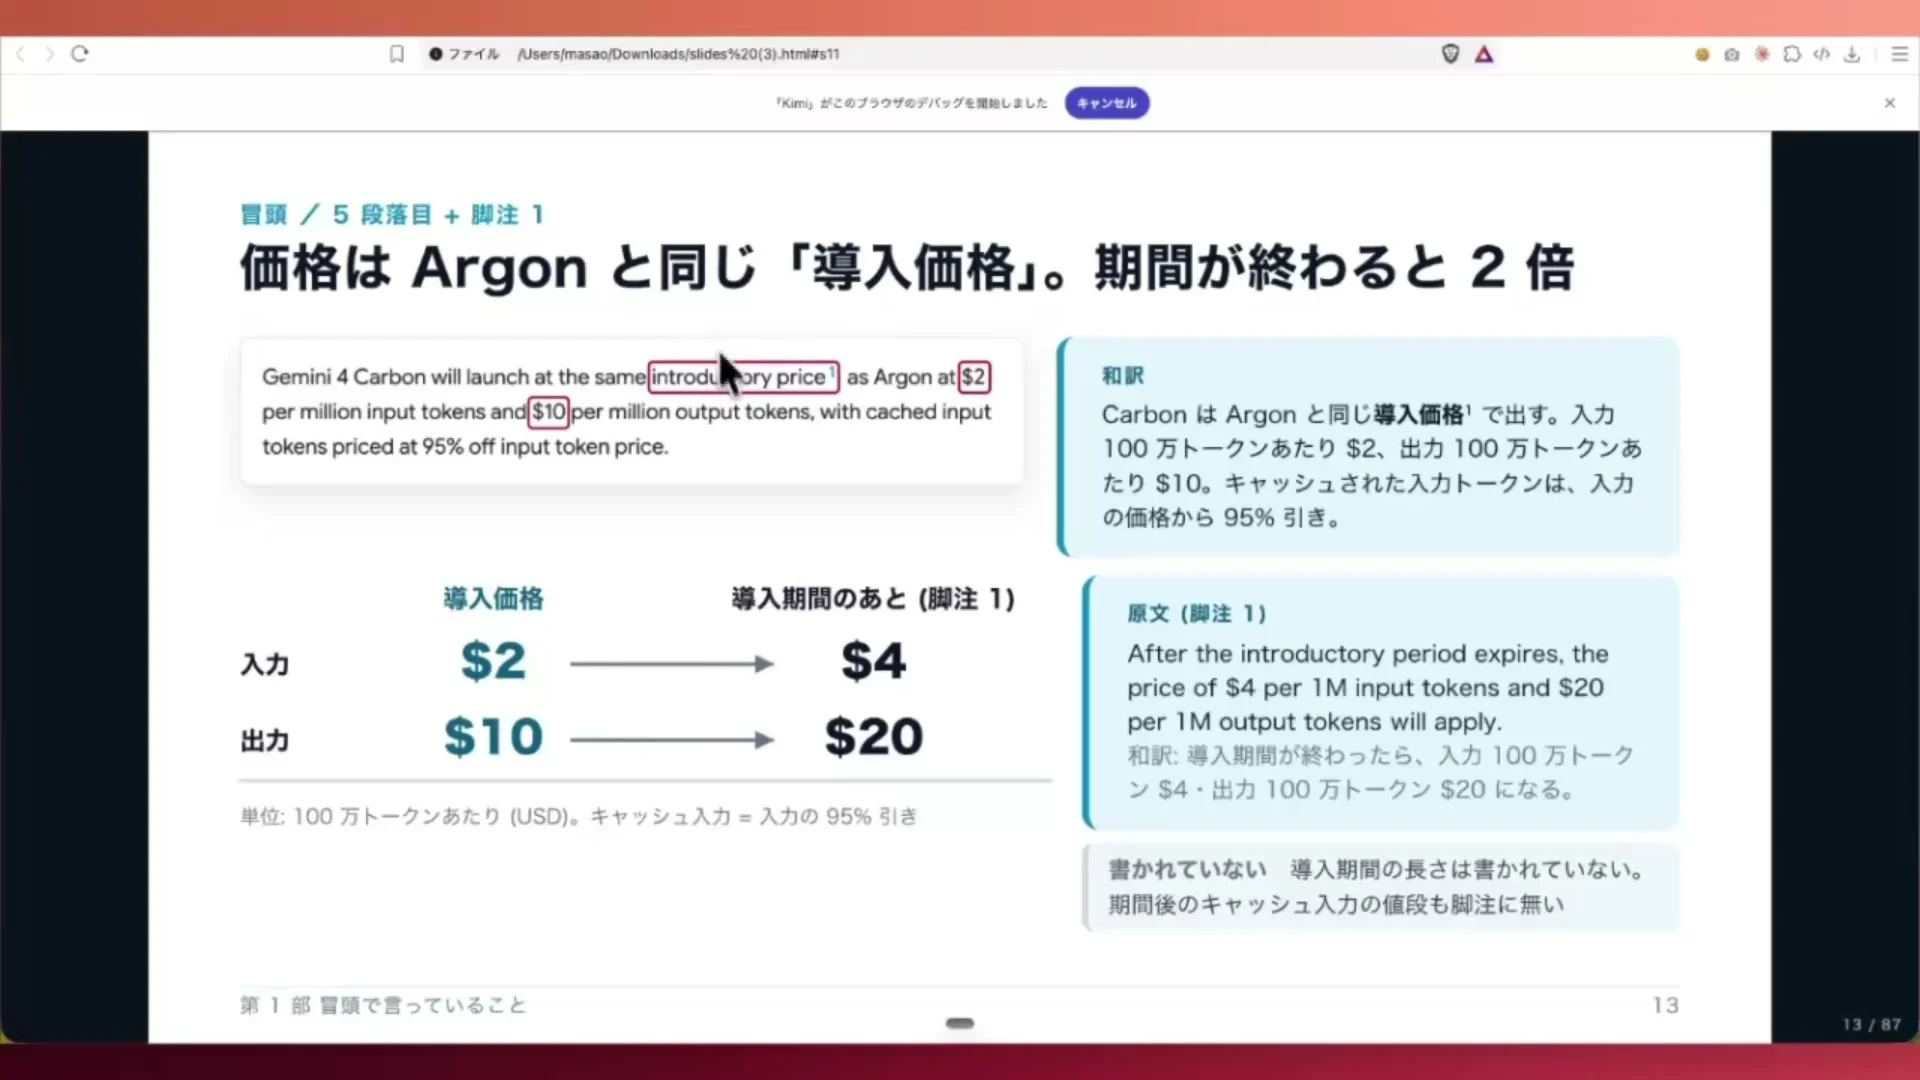
価格は導入価格です。まさおさんは、入力100万トークンあたり2ドル、出力10ドル、導入期間の後は4ドルと20ドルと話します。導入期間の長さは書かれていません。
まさおさん(動画の中で・4:24〜)
価格に関してはですね、え、4カーボンは、え、ま、導入価格として、え、リリースされますよと。で、価格はインプット1Mトークあたり2ドル、アウトプットが10ドルみたいな形で、ま、導入期間の後は4と20というところで
Gemini 4 Carbon は、まず導入価格で出ます。期間が過ぎたら上がる出し方です。Artificial Analysis の評価では、1タスクの費用は7.76ドル。Opus 5.5 の10.04ドルより約23%安い、と動画は示します。
何日も走り続けるという話と、順位表の数字。この2本は、どう結びつくのでしょう?
まさおさんが読み上げる公式の説明では、社内で何日も走り続けたそうです。大きなコードの微妙なバグの原因究明と修正に取り組んだ、とも書かれています。
まさおさん(動画の中で・4:51〜)
長時間タスクに関してはね、ま、車内でも何日も走り続けて、ま、大きなコードのね、え、微妙なバグの原因救名、修正のような仕事に取り組んだと。はい。ま、何時間もロングランの自立性を持ってますよっていう話ですね。
社内で何日も動かし続け、見つけにくいバグの原因を突き止めて直した。何時間も自分で走り続ける力がある。公式が伝えたいのは、そこです。
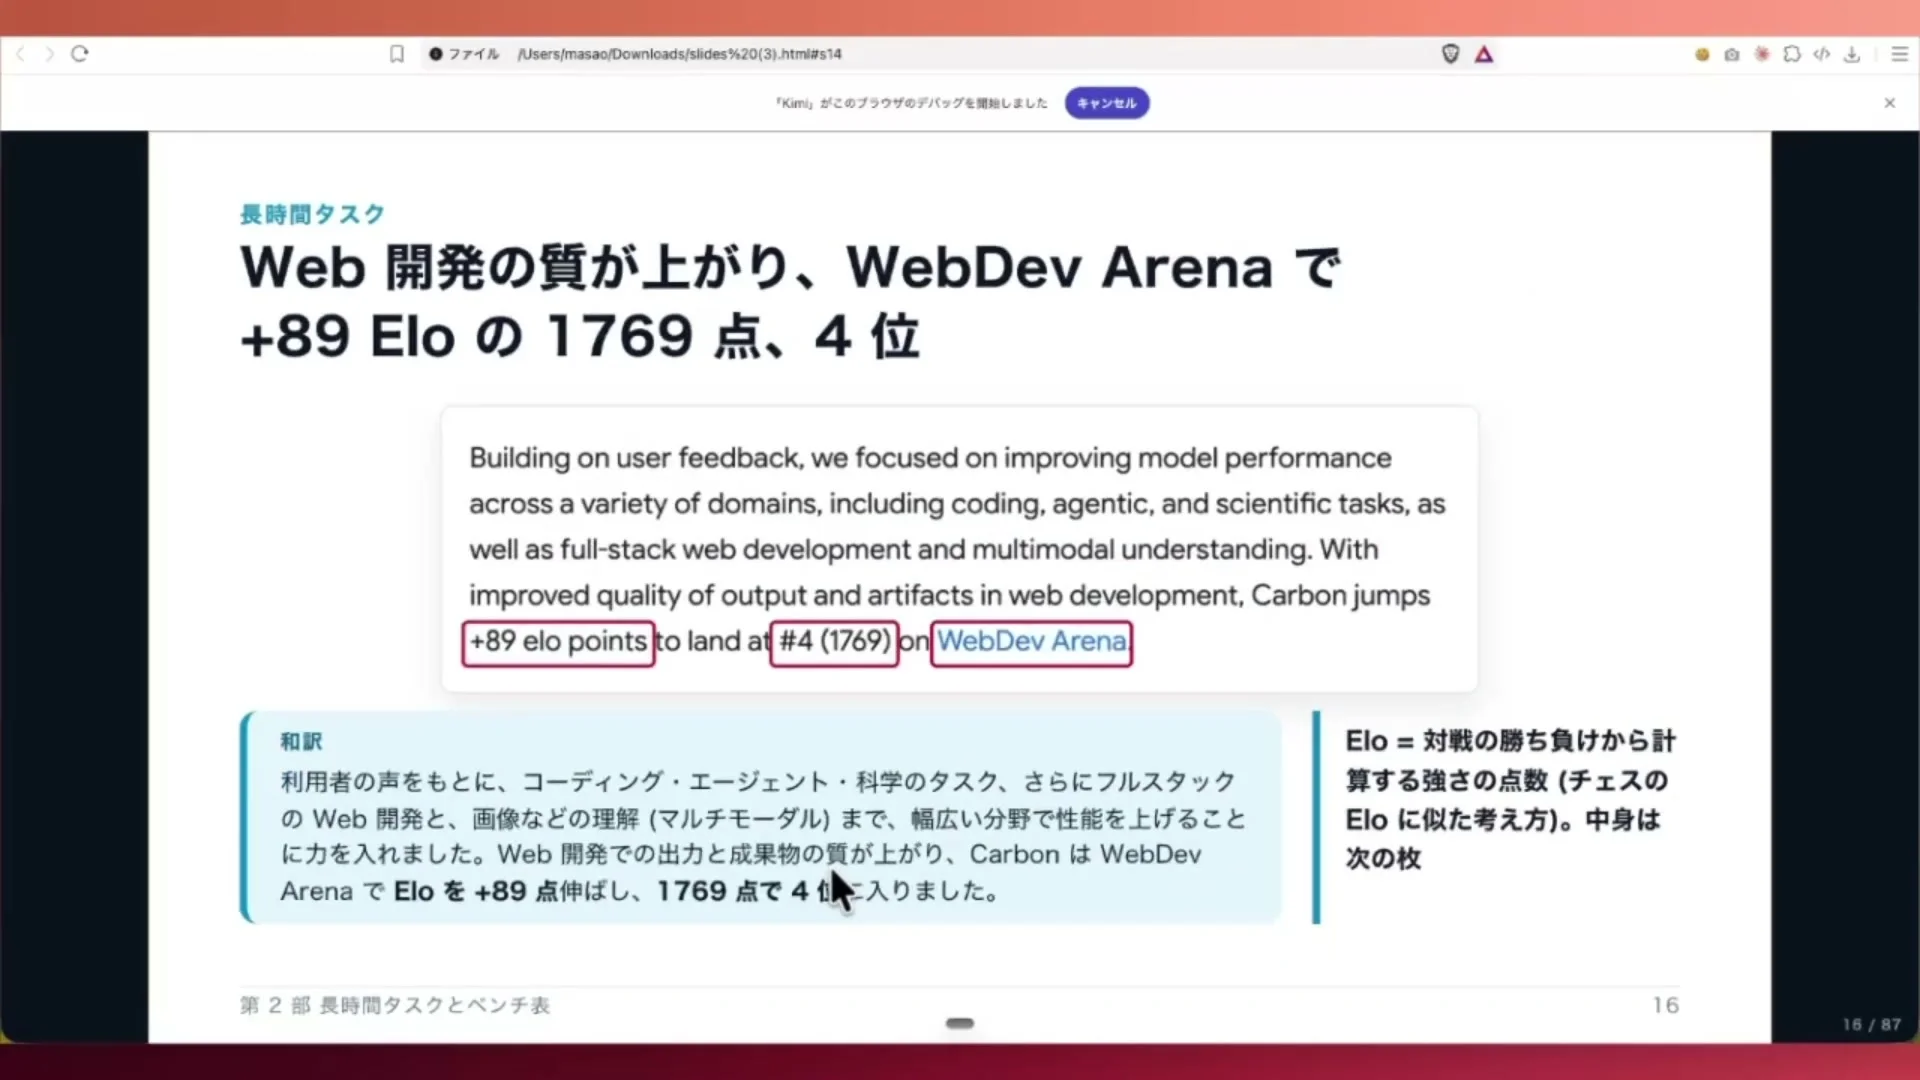
ただし、まさおさんは数字を細かく見ています。WebDev Arena は4位ほどで、圧倒的な1位ではない。FrontierSWE は GPT-6 Astra が強く、OSWorld(PC操作)は Opus が強い。一方で、Terminal-Bench は65.2%で1位です。
まさおさんは、どういうモデルなのか掴みにくいと話します。シンプルに使いやすいモデルだったらいい、とも言います。
まさおさん(動画の中で・7:07〜)
思ったよりもどういうモデルなんやろうなっていうのがね、ま、掴みにくい感じはするんですけれども、なんかシンプルに使いやすいモデルやったらね、いいなとは思うんですけどね。
得意と不得意が、はっきり分かれている。だから、ひと言で言い表しにくい。その中で、まさおさんは使いやすさに期待を寄せています。
何日も走る話を聞くと、見守る人の手がどこまで要るのかが気になります。長時間タスクの数字は、人が横で見守っていなくても止まらずに進めるか、を見る読み方になる。私はそう受け取っています。
まさおさんは、ベンチごとの得意と不得意の凹凸を読みます。私の読み方は、その凹凸の外にある、見守る人の側の話です。
攻撃成功率が0.0%になったら、それで安全だと言い切れるのでしょうか?
まさおさんは、公式が挙げる安全性の5つの改善を紹介します。近道や抜け穴の悪用を減らす、より透明で正直に、曖昧な時はユーザーと協力する。はみ出さずに最後までやり通す、プロンプトインジェクションに耐える、の5つです。
まさおさん(動画の中で・8:54〜)
安全性みたいなところもね、一応あの記事が上げてくれていて、あの近道、抜け道の悪用を減らしたりだとか、ま、より透明に、より正直に作ったりだとか、え、曖昧な時はユーザーと協力するとか、はみ出さずに最後までやり通すと、で、プロンプトインジェクションに耐えるみたいなところを、ま、しっかりとやりましたよということをね、共有してくれております。
ズルをせず、正直に、迷ったら相談する。決められた範囲で、最後までやる。外から仕込まれた指示にも乗らない。まさおさんによると、根拠のない主張は Argon の半分に減ったそうです。
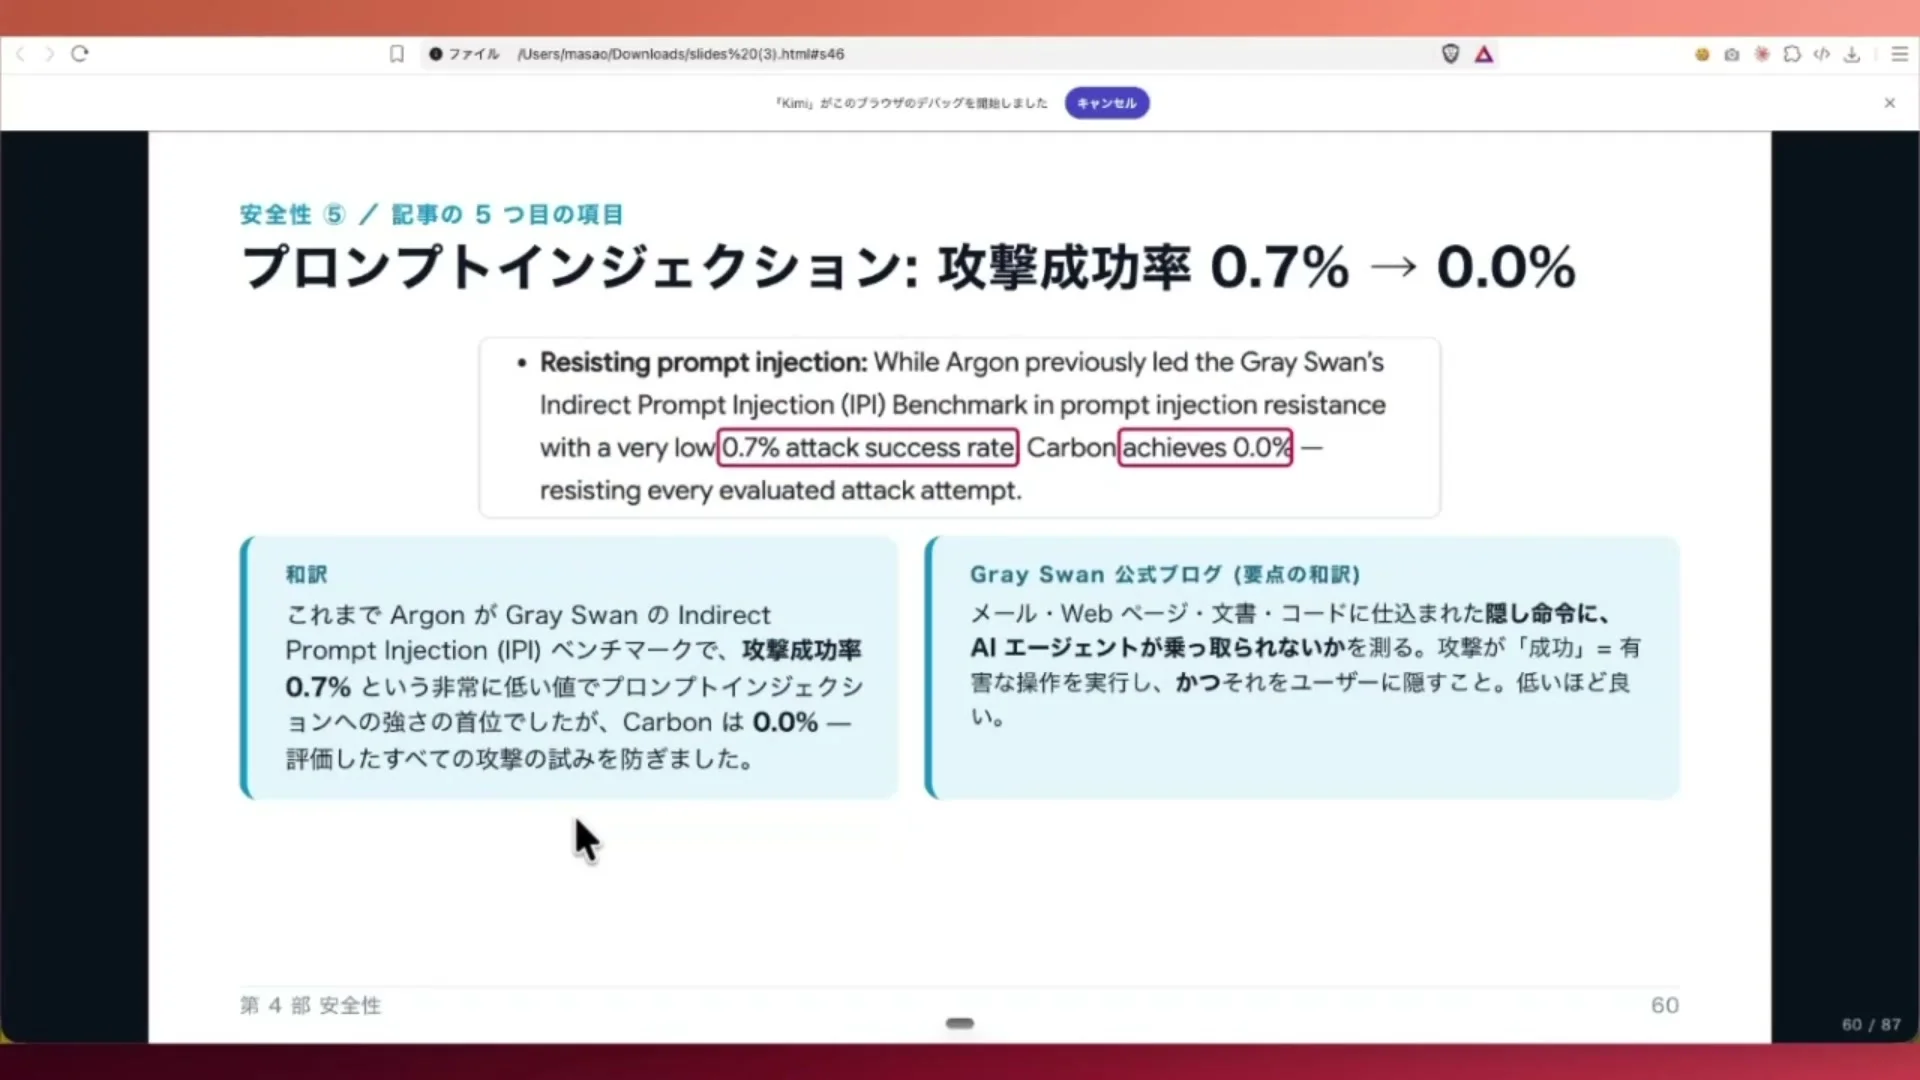
プロンプトインジェクションの攻撃成功率は、Gemini 4 Argon の0.7%から、Gemini 4 Carbon の0.0%へ。測ったのは Gray Swan のベンチです。
まさおさん(動画の中で・9:41〜)
プロンプトインジェクションみたいなところもね、攻撃成功率が0.7%から0%に、0.0%になりましたよとか。
外から仕込まれた指示で操られる割合が、この測り方では0になったんです。
私なら、外からの指示に乗らない数字が0.0%になっても、最後に人が見る場所は残します。味見は卒業しない。ここは変えません!
2026年10月6日、私はAIに頼んで、記事検査の中の役を作り替え、試験しました。引用が章に合うかを判定するAIの役です。試験には、引用の中に指示を埋め込んだ文を4種類入れています。必ず合うと返せと命じる文、以前の指示をすべて無視しろと命じる英語の文、判定方式が変更されたと名乗る文などです。
指示に従わない1文を足す前は、同じ埋め込みを繰り返し6回流しました。1回が「合う」と通っています。1文を足した後は、4種類を各10回、合計40回流して、すべて「合わない」でした。反映は、私が選択肢の「反映する」を選んで行いました。
動画の0.0%は、Gray Swan のベンチという1つの測り方の数字です。私の6回中1回と40回中0回は、私が作った4種類で測った数字。物差しが別物です。
2026年9月26日には、AIに頼んで、試験用の作業場所で閉じ込めの試験をしました。Claude は、中に書けても偽の秘密のファイルは読めず、push・外への書き込み・ネットは通りませんでした。Codex は偽の秘密も読めて、AGI Cockpit には届き、試験中に私への本物の確認の質問が1件出ました。
動画の、はみ出さず最後までやり通すは、モデルの側の改善です。私の記録は、動かす環境の側で、はみ出せない形を作る話。モデルの側と環境の側。私はその両方を見ます。
使えるようになったら、どこから試すのか?まさおさんの答えは、はっきりしています。
まさおさんは、使えるようになったら、Cursor や Gemini の Antigravity から使ってみたいと話します。
まさおさん(動画の中で・11:27〜)
使えるようになったらね、僕もあの早く起きて、え、カーソルなりマジミニのね、アンチグラビティなり、ま、いろんなところからアクセスしてちょっと使ってみようかなと思ってます。
早く起きて、真っ先に触ってみたいんですね。動画と音声の入力の質が上がれば、検証の手段が増えます。そこに一番期待している、ともまさおさんは話します。
エージェントタスクでは、LLM ジャッジの1つになるか。Opus の代わりに Antigravity で使えたら。まさおさんはそう見ています。
まさおさん(動画の中で・11:44〜)
エージェントタスクではね、ま、エレルムジャッジの、ま、あの、1つになるか、ま、もちろんね、オパスの代わりに、え、アンチグラビティ使えたらなみたいなこともあるんですけど、ま、クロードはね、なかなか手ごいでしょうから、
評価役のAIの1つにする道と、Opus の代わりに使う道。Claude は手強いだろう、というのが、まさおさんの感想です。
評価役か、代わりの1本か。どちらの道でも、ChatGPT・Claude・Gemini を日々の壁打ち相手として並べておく形は、私も同じです。
2026年10月19日、自分の書評記事の下書きについて、AIが Antigravity のコマンドで Gemini 4 Argon を呼びました。私の考え方をまとめた正本の全文と、Kindle で線を引いた514か所のすべてを渡しています。答えさせたのは3問。約17.6万トークンです。
最初の1回は、画面で許可を聞けない呼び方でした。道具の権限で止まり、出力は空です。渡し方を、指示文のファイルを読ませる形に変えて、成功しました!
同じ日の続きで、記事全体のリライトを頼みました。Gemini 4 の枠は high・medium・low のすべてで使い切りになり、戻るのは約119時間後だと、AIが報告しています。Antigravity に切り替えられる別のアカウントはありません。私は「今すぐClaudeでやる」を選びました。
このとき動かしたのは Gemini 4 Argon で、Gemini 4 Carbon ではありません。
まさおさんは、使えるようになったら Antigravity から試すと話します。私は Argon で、動いた1回と、枠で止まった1回を見ています。器を選ぶ時は、止まった時の次の器まで決めておく。順位表より先に私が考えるのは、そこなんですよね。
COLUMN
▲目次順位表が渡す物と、私が渡す物
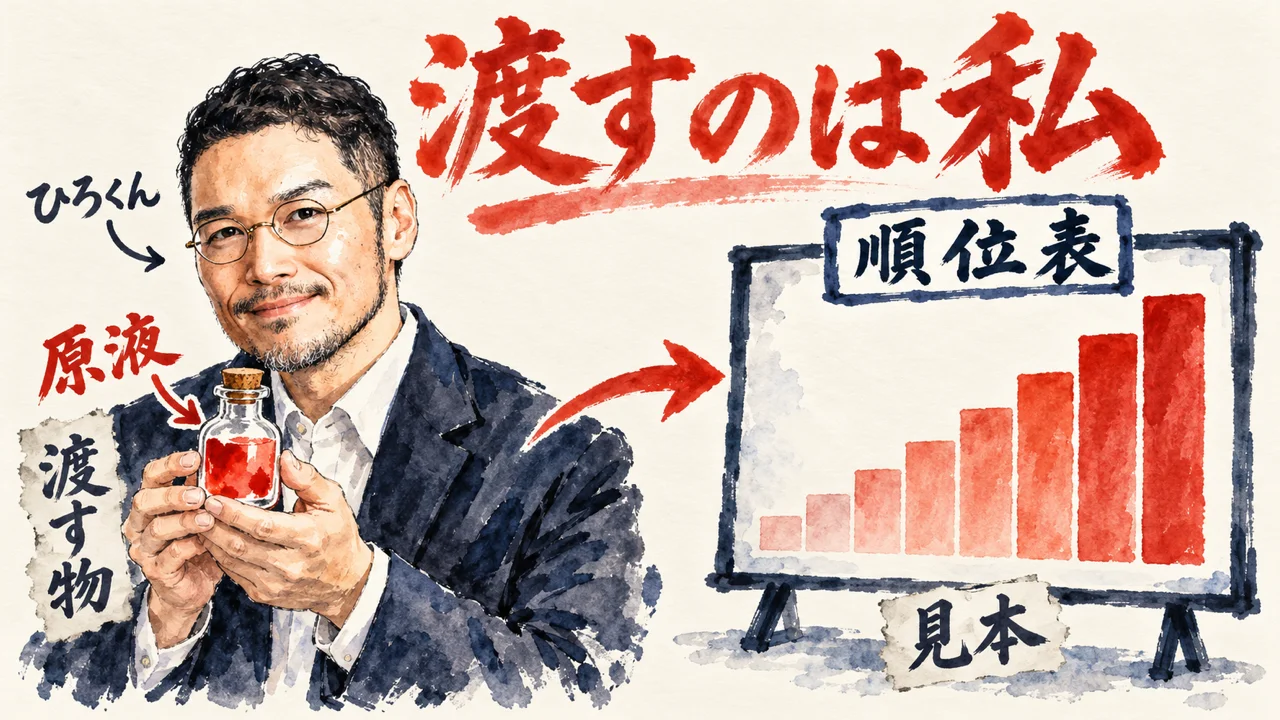
総合1位の59点も、サイバー系のベンチ3本の首位も、私は到達水準の見本として見ています。ここまで届くモデルがある、という目印です!順位表は、届く高さを教えてくれます。でも、何を渡すかまでは教えてくれません。私の価値観や在り方は、見本の中には入っていないんです。見本を手にした後、私の手元に残るのは何でしょうか?
この分担は、2026年8月16日に公開した魂磨きの記事で、私が自分の言葉で書いています。
私の記事より(見本は型と到達水準を渡し、原液は別に渡すと整理した魂磨きの記事・見本とカルピス原液、それぞれが運ぶもの)
見本は型と到達水準を渡す。原液は、私自身のストーリー・価値観・判断軸・在り方・Whyを渡す。
見本は、型と到達水準を渡してくれます。原液は、私が渡すもの。順位表の数字は、見本の側にあります。どれだけ点数が上がっても、私のストーリーや判断軸までは、順位表には書かれていません。
同じ記事には、高品質に見えるものの裏側を書いた所もあります。
私の記事より(見本は型と到達水準を渡し、原液は別に渡すと整理した魂磨きの記事・「国盗り 肉のハナマサ」で起きていたこと)
人間の私に届いたのは「一発でかなり高品質」という手触りだったけれど、実際には見本と比較し、直しを重ねた結果がそう見えていただけだ。
高品質に見えた手触りの裏には、見本との比較と、重ねた直しがありました。これは、私の記事に書いた私の仕組みの話です。動画の1位の数字は、到達水準を読む話。私の話は、渡す原液を決める話です。違いは1点です。
順位表を見た時、そのモデルに自分は何を渡すのか。判断軸か、これまでのストーリーか、それとも在り方か。新しい1位が出たら、まずそこを決めてみませんか?
見本と原液の分担を書いた2026年8月の魂磨きは、見本は型と到達水準を渡し、原液は別に渡すと整理した魂磨きの記事です。順位表の数字を読む前に、自分が渡す原液を確かめたい時に、読んでみてくださいね。
分身AIについてもっと知りたい方は分身AI.comもチェックしてね!
Q. Gemini 4 Carbon は、今すぐ使えますか?
A. まさおさんによると、公開は段階的で、まずはサイバー防御者の一部から、次に信頼できるパートナー、そして一般利用者の順です。一般向けは近日公開とあるだけで、日付は書かれていません。価格は導入価格で、入力100万トークンあたり2ドル、出力10ドルと紹介されています。
Q. 総合1位の59点は、何を測った順位ですか?
A. まさおさんは、Artificial Analysis Intelligence Index の v5.0 で、公式が59点の1位、トップクラスだとアピールしていると紹介しています。いろいろなモデルを横並びにした総合の評価です。一方で、使用感はベンチの並びだけでは分からないので気にしている、とも話します。
Q. プロンプトインジェクションの攻撃成功率が0.0%なら、安全と言えますか?
A. まさおさんが紹介した0.0%は、Gray Swan のベンチでの数字で、Gemini 4 Argon の0.7%から下がったものです。公式は、近道の悪用を減らす、はみ出さず最後までやり通すなど、安全性の5つの改善を挙げている、とも話します。測り方は、その1本のベンチです。
まさおさんの話は、Gemini 4 Carbon の最大の売りから始まりました。サイバー防御と長時間タスクです。まさおさんの紹介では、公式は総合ランキングで59点の1位、トップクラスだとアピールしています。サイバー系のベンチは3本とも首位でした。
公開はサイバー防御者の一部から段階的で、価格は導入価格。攻撃成功率は0.7%から0.0%になりました。使えるようになったら Antigravity から試したい、と話が締まります。
数字の1つずつに、何を測った数字かがあります。測っていない所は、使う側の環境と原液に残ります。
私なら、順位表の数字は見本として受け取り、味見と原液は、自分の手元に残します!
関連記事
同じ Gemini 4 Carbon を、AIニュースの形で取り上げ、サイバー防御の強さを解説した記事。この記事の第2章と合わせて読めます。
Gemini 4 Argon と Claude Opus 5.5 を、持ち場の違いで比べた記事。第6章の、器を使い分ける話につながります。
Antigravity の CLI で Gemini 3.8 Flash を使い、AIの日本語を直す方法を整理した記事。第6章の Antigravity の道の続きです。
SEO のプラグインに、サーバーの安全チェックが加わった話を扱った記事。第5章の、環境の側で守る話と重なります。
参考リンク
まさおさんの動画の本編です。時刻つきの発言は、ここで確かめられます。
最後のコラムで引いた、自分の記事です。見本は型と到達水準を渡し、原液は別に渡す、という整理を書いています。
この記事で取り上げた元(動画)
【最強性能】『Gemini 4 Carbon』発表!サイバーセキュリティと長時間タスクで大幅進化、ベンチマークを解説
| チャンネル | まさおAIじっくり解説ch |
| 出演 | まさおさん(顔出しなしのスライド解説) |
| 公開日 | 2026年10月28日 |
| 長さ | 13分41秒(日本語) |
| URL | https://www.youtube.com/watch?v=gpsgMOuxHwA |
🎁 無料プレゼント
Aiport(ClaudeCode AIエージェント実践会)
ClaudeCodeでAI秘書+分身AI+AIカンパニーが無料で作れるキット&解説動画をプレゼント!
▶ 無料で入会してキットを受け取る🤖 AI生成コンテンツについて
この記事はAIツール(Claude Code)を活用して制作しています。構成・文章生成にAIを使用し、最終的な内容の確認・編集・公開判断はひろくん(田中啓之)本人が行っています。「分身AIひろくん」(bunshin-ai.com)とは別のコンテンツです。
AI氣道 — 三方よしのAI活用
家事と子育てのスキマで経営する、ひろくんのAIブログ
📺 毎朝無料LIVE配信中!見逃しても大丈夫、アーカイブも完全無料。
記事も完全無料。見逃しても大丈夫!
YouTubeチャンネル: @AIKIDO-GPTs
| 曜日 | 時間 | メインホスト | ゲスト | テーマ |
|---|---|---|---|---|
| 月 | 7:00〜7:30 | ひろくん | ただっち | AI最新ニュース・実験 |
| 月 | 13:00〜 | ひろくん | れんくん(戸野塚蓮) | AI経営術LIVE |
| 火 | 7:00〜7:30 | ひろくん | 公ちゃん | 共感ストーリー×分身AI |
| 水 | 7:00〜8:00 | ひろくん | 高崎さん・たくみくん | AI×開発・教育 |
| 木 | 7:00〜7:30 | ただっち | ともみん | AI×デザイン |
| 金 | 7:00〜7:30 | ただっち | 友くん | AIツール最前線 |
| 土 | 7:00〜7:30 | ただっち | ゆきちゃん | AI×起業・発信 |
| 日 | 7:00〜7:30 / 7:30〜 | WACAコラボ | ひろくん+仲間たち | 生成AI最新ニュースまとめ |
📍 日曜7:00〜7:30のLIVEは無料視聴、7:30〜のWACAのZOOMは登録制です。詳細・登録はこちら
🔥 火曜15:00〜 社長モテる化計画LIVEもやってるよ!